
Создание статистики
Вы можете создать статистику оптимизации запросов для столбцов таблицы или индексированного представления в SQL Server с помощью SQL Server Management Studio или Transact-SQL. Для большинства запросов оптимизатор уже создает необходимую статистику для формирования высококачественного плана запроса, но в некоторых случаях нужно создавать дополнительные статистические данные.
ограничения
Прежде чем создавать статистику с помощью инструкции CREATE STATISTICS, убедитесь, что на уровне базы данных установлен параметр AUTO_CREATE_STATISTICS. Это гарантирует, что оптимизатор запросов продолжит регулярно создавать статистику по отдельным столбцам для столбцов предиката запроса.
Каждый объект статистики может содержать до 32 столбцов.
Невозможно удалить, переименовать или изменить определение столбца таблицы, определенного в отфильтрованном предикате статистики.
Разрешения
Пользователь должен быть владельцем таблицы или индексированного представления либо членом одной из следующих ролей: предопределенная роль сервера sysadmin , предопределенная роль базы данных db_owner или предопределенная роль базы данных db_ddladmin .
Использование среды SQL Server Management Studio
- В обозревателе объектов выберите знак плюса, чтобы развернуть базу данных, в которой требуется создать новую статистику.
- Чтобы развернуть папку Таблицы, выберите значок «плюс».
- Щелкните значок «плюс», чтобы развернуть таблицу, в которой хотите создать новую статистику.
- Щелкните правой кнопкой мыши папку Статистика и выберите пункт Создать статистику. . На странице Общие в диалоговом окне Создание статистики по таблицеимя_таблицы отображаются указанные ниже свойства.
Свойство Description Имя таблицы Отображает имя таблицы, которую описывает данная статистика. Имя статистики Отображает имя объекта базы данных, в котором сохранена статистика. Столбцы статистики Сетка отображает столбцы, описанные набором статистических данных. Все значения сетки доступны только для чтения. Наименование Отображает имя столбца, описываемого статистикой. Это может быть один столбец или комбинация столбцов одной таблицы. Тип данных Указывает тип данных столбцов, описываемых статистикой. Размер Отображает размер типа данных для каждого столбца. Identity Если флажок установлен, обозначает столбец идентификаторов. Разрешить значения NULL Указывает, допускает ли столбец значения NULL. Прибавить Добавьте дополнительные столбцы из таблицы в сетку статистики. Удалить Удалите выбранный столбец из сетки статистики. Вверх Переместите выбранный столбец ближе к началу сетки статистики. Расположение в сетке может существенно повлиять на полезность статистики. Вниз Переместить выбранный столбец ближе к концу сетки статистики. Статистика по этим столбцам была обновлена в последний раз Указывает давность статистики. Статистика представляет большую ценность, если она актуальна. Следует обновлять статистику после больших изменений в данных или после добавления нетипичных данных. Статистику для таблиц с равномерным распределением данных можно обновлять реже. Обновить статистику для этих столбцов Установите флажок для обновления статистики после закрытия диалогового окна. На странице Фильтр в диалоговом окне Создание статистики по таблицеимя_таблицы отображается указанное ниже свойство.
Свойство Description Критерий фильтра Определяет столбцы данных, которые будут включены в статистику фильтрации. Пример: Production.ProductSubcategoryID IN ( 1, 2, 3 ) - В диалоговом окне «Новая статистика по таблицеtable_name» на странице «Общие» нажмите кнопку «Добавить«. В диалоговом окне Выбор столбцов будут показаны следующие свойства. Эти данные доступны только для чтения.
Свойство Описание Полное имя Отображает имя столбца, описываемого статистикой. Это может быть один столбец или комбинация столбцов одной таблицы. Тип данных Указывает тип данных столбцов, описываемых статистикой. Размер Отображает размер типа данных для каждого столбца. Identity Указывает на столбец идентификаторов, если этот параметр выбран. Разрешить значения NULL Указывает, допускает ли столбец значения NULL. - В диалоговом окне «Выбор столбцов» установите флажок или флажки для каждого столбца, для которого требуется создать статистику, а затем нажмите кнопку «ОК«.
- В диалоговом окне «Новая статистика по таблице table_name» нажмите кнопку «ОК«.
Использование Transact-SQL
- В обозревателе объектов подключитесь к экземпляру ядра СУБД.
- На стандартной панели выберите пункт Создать запрос.
- Скопируйте приведенный ниже пример в окно запроса и нажмите кнопку Выполнить.
USE AdventureWorks2022; GO -- Create new statistic object called ContactMail1 -- on the BusinessEntityID and EmailPromotion columns in the Person.Person table. CREATE STATISTICS ContactMail1 ON Person.Person (BusinessEntityID, EmailPromotion); GO USE AdventureWorks2022; GO SELECT LastName, FirstName FROM Person.Person WHERE EmailPromotion = 2 ORDER BY LastName, FirstName; GO Далее
Есть ли web-приложение, которое умеет строить графики по sql-запросу?
Если кратко, то есть ли kibana для БД?
Т.е. настраиваю соединение с базой (mysql, mongo) пишу запрос и получаю график по данным этого запроса.
Нужно для отображения статистики небольшого веб проекта. Хочется именно, чтобы данные брались прям из бд, чтобы их не дублировать во что-то другое и соответственно не заниматься синхронизацией.
Что-то мне подсказывает, что такие решения уже есть, может, кто видел?
- Вопрос задан более трёх лет назад
- 3244 просмотра
Комментировать
Решения вопроса 1
Ladygin @Ladygin Автор вопроса
Нашел классную вещь — jdorn.github.io/php-reports
Может строить графики, таблицы и много другое по данным из mysql, mongo или php.
Ответ написан более трёх лет назад
Комментировать
Нравится Комментировать
Ответы на вопрос 0
Ваш ответ на вопрос
Войдите, чтобы написать ответ
- Сетевое администрирование
- +2 ещё
Есть ли сервис или ПО для распознавания блок схем и диаграмм?
- 3 подписчика
- 07 нояб.
- 153 просмотра
Статистика
Оптимизатор запросов использует статистику для создания планов запросов, которые повышают производительность запросов. Для большинства запросов оптимизатор уже создает необходимую статистику, которая позволяет сформировать высококачественный план запроса. Но в некоторых случаях для достижения наилучших результатов нужно создать дополнительную статистику или изменить структуру запроса. В этой статье обсуждаются основные статистические понятия и предоставляются рекомендации по эффективному использованию статистики для оптимизации запросов.
Компоненты и основные понятия
Статистика
Статистика для оптимизации запросов — это большие двоичные объекты (BLOB-объекты), содержащие статистические сведения о распределении значений в одном или нескольких столбцах таблицы или индексированного представления. Оптимизатор запросов использует эти статистические сведения для оценки кратности — числа строк в результатах запроса. Такая оценка кратности позволяет оптимизатору запросов создать высококачественный план запроса. Например, в зависимости от предикатов оптимизатор запросов может использовать оценку кратности, чтобы выбрать оператор index seek вместо оператора index scan, который потребляет больше ресурсов, если благодаря этому повысится производительность запроса.
Каждый объект статистики создается для списка из одного или нескольких столбцов таблицы и содержит гистограмму, на которой отображается распределение значений в первом столбце. Объекты статистики для нескольких столбцов также хранят статистические сведения о корреляции значений между столбцами. Эти статистические данные корреляции называются значениями плотностии получаются из числа уникальных строк значений столбцов.
Гистограмма
Гистограмма измеряет частоту появления каждого различающегося значения в наборе данных. Оптимизатор запросов вычисляет гистограмму для значений столбца в первом ключевом столбце объекта статистики, выбирая значения столбцов путем статистической выборки строк или полного просмотра всех строк в таблице или представлении. Если гистограмма создается на основе выбранного набора строк, то сохраняемые итоговые значения количества строк и количества различающихся значений являются приблизительными и не всегда выражаются целыми числами.
Гистограммы в SQL Server создаются только для одного столбца первого столбца в наборе ключевых столбцов объекта статистики.
Чтобы создать гистограмму, оптимизатор запросов сортирует значения столбцов, вычисляет количество значений, совпадающих с каждым отдельным значением столбца, а затем осуществляет статистическую обработку значений столбцов с получением непрерывных шагов гистограммы, максимальное количество которых составляет 200. Каждый шаг гистограммы включает диапазон значений столбцов, за которым следует значение столбца, представляющее собой верхнюю границу. В этот диапазон входят все возможные значения столбца между граничными значениями, за исключением самих граничных значений. Наименьшим из отсортированных значений столбца является верхнее граничное значение первого шага гистограммы.
Более подробно SQL Server создает гистограмму из отсортированного набора значений столбцов в трех шагах:
- Инициализация гистограммы: на первом шаге обрабатывается последовательность значений, начиная с начала сортированного набора; собирается до 200 значений range_high_key, equal_rows, range_rows и distinct_range_rows (range_rows и distinct_range_rows всегда равны нулю на этом шаге). Первый шаг заканчивается, когда все входные значения обработаны или найдено 200 значений.
- Сканирование со слиянием корзин: каждое дополнительное значение из первого столбца ключа статистики обрабатывается на втором шаге в порядке сортировки; каждое последующее значение либо добавляется в последний диапазон, либо в конце создается новый диапазон (это возможно, потому что входные значения сортированы). Если создается новый диапазон, одна пара существующих, расположенных по соседству диапазонов сворачивается в один. Эта пара диапазонов выбирается с целью уменьшения информационных потерь. Этот способ использует алгоритм максимальной разности для сведения к минимуму числа шагов в гистограмме и вместе с тем максимального увеличения разницы между граничными значениями. Число шагов после сворачивания диапазонов на протяжении этого шага остается равным 200.
- Консолидация гистограммы: на третьем шаге могут быть свернуты дополнительные диапазоны, если это не приведет к значительной потере данных. Число шагов гистограммы может быть меньше, чем количество различающихся значений, даже для столбцов, в которых число граничных точек меньше 200. Таким образом, даже если в столбце содержится более 200 уникальных значений, гистограмма может содержать менее 200 шагов. Для столбца, состоящего только из уникальных значений, консолидированная гистограмма будет содержать как минимум три шага.
Если гистограмма была построена на основе выборки, а не полного сканирования, значения equal_rows, range_rows, distinct_range_rows и average_range_rows будут рассчитаны и не обязательно будут являться целыми числами.
На следующей диаграмме показана гистограмма с шестью шагами. Первый шаг — это область слева от первого верхнего граничного значения.
Для каждого шага гистограммы (см. выше):
- Полужирной линией обозначено верхнее граничное значение (range_high_key) и количество его вхождений (equal_rows).
- Закрашенная область слева от range_high_key обозначает диапазон значений столбца и среднее количество вхождений каждого значения столбца (average_range_rows). В первом шаге гистограммы значение average_range_rows всегда равно 0.
- Пунктирные линии обозначают выбранные значения, которые используются для оценки общего числа различающихся значений (distinct_range_rows) и общего числа значений в диапазоне (range_rows). Оптимизатор запросов использует range_rows и distinct_range_rows для вычисления average_range_rows и не хранит выбранные значения.
Вектор плотности
Плотность определяет число дубликатов в заданных столбце или комбинации столбцов и рассчитывается как 1/(число уникальных значений). Оптимизатор запросов использует плотности для улучшения оценки размерности для запросов, которые возвращают данные нескольких столбцов из одной таблицы или индексированного представления. По мере повышения плотности избирательность значения повышается. Например, в таблице, представляющей автомобили, много автомобилей имеют одного производителя, но каждый автомобиль имеет уникальный идентификационный номер транспортного средства (VIN). Индекс по VIN является более избирательным, чем индекс по производителям, так как VIN с меньшей плотностью, чем производитель.
Частота определяет число вхождений каждого уникального значения в первый ключевой столбец объекта статистики и рассчитывается как (число строк) * плотность. В столбцах с уникальными значениями максимальная частота равна 1.
Вектор плотностей содержит по одной плотности для каждого префикса столбцов объекта статистики. Например, если объект статистики имеет ключевые столбцы CustomerId , ItemId и Price , плотность вычисляется для каждого из следующих префиксов столбцов.
| Префикс столбца | Префикс, по которому вычисляется плотность |
|---|---|
| ( CustomerId ) | Строки с соответствующими значениями для CustomerId |
| ( CustomerId , ItemId ) | Строки с соответствующими значениями для CustomerId и ItemId |
| ( CustomerId , ItemId , Price ) | Строки с соответствующими значениями для CustomerId , ItemId и Price |
Статистика фильтрации
Отфильтрованная статистика может повысить производительность запросов, которые выполняют выборку из четко определенных подмножеств данных. Отфильтрованная статистика использует предикат фильтра для выбора подмножества данных, включенных в статистику. Грамотно отфильтрованная статистика может улучшить план выполнения запроса по сравнению со статистикой по полной таблице. Дополнительные сведения о предикате фильтра см. в статье CREATE STATISTICS (Transact-SQL). Дополнительные сведения об условиях создания отфильтрованной статистики см. в подразделе Условия создания статистики этой статьи.
Параметры статистики
Предусмотрены три параметра, которые влияют на условия и методы создания и обновления статистики. Эти параметры задаются только на уровне базы данных.
Параметр AUTO_CREATE_STATISTICS
Если включен параметр AUTO_CREATE_STATISTICS (автоматическое создание статистики), оптимизатор запросов при необходимости создает статистику по отдельным столбцам в предикате запроса, чтобы улучшить оценку кратности для плана запроса. Такая статистика по отдельным столбцам создается для столбцов, в которых отсутствует гистограмма в существующем объекте статистики. Параметр AUTO_CREATE_STATISTICS не определяет, создается ли статистика для индексов. Кроме того, этот параметр не создает отфильтрованную статистику. Он применяется строго к статистике по отдельным столбцам для всей таблицы.
Если оптимизатор запросов создает статистику при помощи параметра AUTO_CREATE_STATISTICS, имя статистики начинается с _WA . Воспользовавшись запросом ниже, можно определить, создал ли оптимизатор запросов статистику для столбца предиката запроса.
SELECT OBJECT_NAME(s.object_id) AS object_name, COL_NAME(sc.object_id, sc.column_id) AS column_name, s.name AS statistics_name FROM sys.stats AS s INNER JOIN sys.stats_columns AS sc ON s.stats_id = sc.stats_id AND s.object_id = sc.object_id WHERE s.name like '_WA%' ORDER BY s.name; параметр AUTO_UPDATE_STATISTICS
Если включен параметр AUTO_UPDATE_STATISTICS (автоматическое обновление статистики), оптимизатор запросов определяет, устарела ли статистика, и при необходимости обновляет ее, если она используется в запросе. Это действие также называется повторной компиляцией статистики. Статистика становится устаревшей после модификаций в результате операций вставки, обновления, удаления или слияния, которые изменяют распределение данных в таблице или индексированном представлении. Оптимизатор запросов определяет, когда статистика может оказаться устаревшей, подсчитывая операции модификации строк с момента последнего обновления статистики и сравнивая количество изменений строк с пороговым значением. Пороговое значение зависит от кардинальности таблицы, что можно определить как количество строк в таблице или индексированном представлении.
Пометка статистики как устаревшей на основе изменений строк происходит даже в том случае, если параметр AUTO_UPDATE_STATISTICS имеет значение OFF. Если параметр AUTO_UPDATE_STATISTICS имеет значение OFF, то статистика не обновляется, даже если она помечена как устаревшая. В планах и далее будут использоваться устаревшие объекты статистики. Отключение параметра AUTO_UPDATE_STATISTICS может повлечь создание неоптимальных планов запросов и снижение производительности запросов. Рекомендуется включить параметр статистики AUTO_UPDATE.
- До SQL Server 2014 (12.x) ядро СУБД использует порог перекомпиляции на основе количества строк в таблице или индексированном представлении во время вычисления статистики. Пороговое значение будет разным независимо от того, является ли таблица временной или постоянной.
Тип таблицы Кардинальность таблицы (n) Пороговое значение повторной компиляции (количество модификаций) Временные процедуры n< 6 6 Временные процедуры 6 n 500 Постоянный n 500 Временная или постоянная n> 500 500 + (0,20 * n) Например, если таблица содержит 20 000 строк, расчет выполняется так: 500 + (0.2 * 20,000) = 4,500 . В таком случае статистика обновляется через каждые 4500 модификаций.
- Начиная с SQL Server 2016 (13.x) и на уровне совместимости базы данных 130 ядро СУБД также использует снижение порогового значения перекомпиляции динамической статистики, которое корректирует кратность таблицы во время вычисления статистики. Благодаря этому изменению статистика для больших таблиц будет обновляться чаще. Однако если база данных имеет уровень совместимости ниже 130, применяются пороговые значения SQL Server 2014 (12.x).
Тип таблицы Кардинальность таблицы (n) Пороговое значение повторной компиляции (количество модификаций) Временные процедуры n< 6 6 Временные процедуры 6 n 500 Постоянный n 500 Временная или постоянная n> 500 MIN (500 + (0,20 * n), SQRT (1000 * n)) Например, если таблица содержит 2 миллиона строк, значение вычисляется как минимальное значение 500 + (0.20 * 2,000,000) = 400,500 и SQRT(1,000 * 2,000,000) = 44,721 . Это означает, что статистика будет обновляться каждые 44 721 изменений.
В SQL Server 2008 R2 (10.50.x) до SQL Server 2014 (12.x) или в SQL Server 2016 (13.x) и более поздних версий под уровнем совместимости базы данных 120 и ниже включите флаг трассировки 2371 , чтобы SQL Server использовал снижение, пороговое значение динамического обновления статистики.
Хотя это и рекомендуется для всех сценариев, включение флага трассировки 2371 не является обязательным. Однако вы можете использовать следующие рекомендации по включению флага трассировки 2371 в среде до SQL Server 2016 (13.x):
- Если вы используете систему SAP, включите эту трассировку. Дополнительные сведения см. в этой статье блога о флаге трассировки 2371.
- Если обновление статистики происходит в ночное время, так как текущее автоматическое обновление запускается недостаточно часто, попробуйте включить флаг трассировки 2371 для изменения порогового значения в зависимости от кратности таблицы.
Оптимизатор запросов проверяет наличие устаревшей статистики перед компиляцией запроса и до выполнения кэшированного плана запроса. Перед компиляцией запроса оптимизатор запросов с помощью столбцов, таблиц и индексированных представлений в предикате запроса определяет статистические данные, которые могли устареть. Перед выполнением кэшированного плана запроса ядро СУБД проверяет, ссылается ли план запроса на актуальную статистику.
Параметр AUTO_UPDATE_STATISTICS применяется к объектам статистики, создаваемым для индексов, отдельных столбцов в предикатах запросов, и к статистике, создаваемой инструкцией CREATE STATISTICS . Этот параметр также применяется к отфильтрованной статистике.
Вы можете использовать sys.dm_db_stats_properties для точного отслеживания количества строк, измененных в таблице, и принятия решения о возможности обновления статистики вручную.
Параметр AUTO_UPDATE_STATISTICS всегда имеет значение OFF для таблиц с оптимизацией памяти.
AUTO_UPDATE_STATISTICS_ASYNC
Параметр AUTO_UPDATE_STATISTICS_ASYNC (асинхронное обновление статистики) определяет, какой режим обновления статистики использует оптимизатор запросов: синхронный или асинхронный. По умолчанию параметр асинхронного обновления статистики отключен, и оптимизатор запросов обновляет статистику синхронно. Параметр AUTO_UPDATE_STATISTICS_ASYNC применяется к объектам статистики, создаваемым для индексов, отдельных столбцов в предикатах запросов, и к статистике, создаваемой инструкцией CREATE STATISTICS .
Чтобы задать параметр асинхронного обновления статистики в SQL Server Management Studio, на странице «Параметры» окна «Свойства базы данных» необходимо задать значение True для параметра «Статистика автоматического обновления» и «Статистика автоматического обновления«.
Обновление статистики может выполняться синхронно (режим по умолчанию) или асинхронно.
- При синхронном обновлении статистики запросы всегда компилируются и выполняются с актуальной статистикой. Когда статистика устарела, оптимизатор запросов ожидает обновленную статистику перед компиляцией и выполнением запроса.
- При асинхронном обновлении статистики запросы компилируются с существующей статистикой, даже если она устарела. Если статистика при компиляции запроса является устаревшей, оптимизатор запросов может выбрать неоптимальный план запроса. Как правило, статистика обновляется вскоре после этого. Запросы, которые компилируются после обновления статистики, будут использовать обновленную статистику.
Использовать синхронную статистику рекомендуется при выполнении операций, изменяющих распределение данных, таких как усечение таблицы или массовое обновление большой процентной доли строк. Если статистика не была обновлена вручную после выполнения операции, то для выполнения запросов над изменившимися данными следует использовать синхронную статистику. Это гарантирует актуальность статистики.
Асинхронная статистика рекомендуется для достижения более прогнозируемого времени ответа на запросы в следующих сценариях.
- Приложение часто выполняет один и тот же запрос, схожие запросы или схожие кэшированные планы запроса. Асинхронное обновление статистики может обеспечить более прогнозируемое время ответа на запрос по сравнению с синхронным, так как оптимизатор запросов может выполнять входящие запросы, не ожидая появления актуальной статистики. Это устраняет задержку в некоторых запросах, но не влияет на другие запросы.
- Были случаи, когда в приложении истекало время ожидания клиентских запросов в результате ожидания обновленной статистики. В некоторых случаях ожидание синхронной статистики может вызвать аварийное завершение приложений, в которых задано малое время ожидания.
Статистика по локальным временным таблицам всегда обновляется синхронно независимо от параметра AUTO_UPDATE_STATISTICS_ASYNC. Статистика по глобальным временным таблицам обновляется синхронно или асинхронно в соответствии с параметром AUTO_UPDATE_STATISTICS_ASYNC, заданным для пользовательской базы данных.
Обновление асинхронной статистики выполняется с помощью фонового запроса. Когда запрос готов к записи обновленной статистики в базу данных, он пытается получить блокировку изменения схемы для объекта метаданных статистики. Если другой сеанс уже удерживает блокировку того же объекта, обновление асинхронной статистики блокируется до тех пор, пока не появится возможность получить блокировку изменения схемы. Аналогичным образом сеансы, которым требуется получить блокировку стабилизации схемы (Sch-S) для объекта метаданных статистики для компиляции запроса, могут блокироваться фоновым сеансом асинхронного обновления статистики, который уже удерживает блокировку модификации схемы или ожидает ее получение. Таким образом, для рабочих нагрузок с очень частыми компиляциями запросов и частыми обновлениями статистики использование асинхронной статистики может повышать вероятность проблем параллелизма из-за блокирования блокировки.
В Базе данных SQL Azure Управляемый экземпляр SQL Azure и начиная с SQL Server 2022 (16.x) можно избежать потенциальных проблем с параллелизмом с помощью асинхронного обновления статистики, если включить конфигурацию ASYNC_STATS_UPDATE_WAIT_AT_LOW_PRIORITY области базы данных. Если эта конфигурация включена, фоновый запрос будет ожидать получения блокировки модификации схемы (Sch-M) и сохранять обновленную статистику в отдельной низкоприоритетной очереди, что позволяет другим запросам продолжать компиляцию запросов с использованием существующей статистики. Если никакой другой сеанс не удерживает блокировку объекта метаданных статистики, фоновый запрос получит блокировку изменения схемы и обновит статистику. В маловероятном случае, когда фоновый запрос не может получить блокировку в течение времени ожидания, равного нескольким минутам, обновление асинхронной статистики будет прервано, а статистика не будет обновлена до тех пор, пока не будет активировано другое автоматическое обновление статистики или пока статистика не будет обновлена вручную.
Параметр конфигурации базы данных ASYNC_STATS_UPDATE_WAIT_AT_LOW_PRIORITY доступен в Базе данных SQL Azure, Управляемом экземпляре SQL Azure и в SQL Server, начиная с SQL Server 2022 (16.x).
Параметр AUTO_DROP
Применимо к*: База данных SQL Azure, Управляемый экземпляр SQL Azure и начиная с SQL Server 2022 (16.x)
В SQL Server до SQL Server 2022 (16.x), если статистика создается пользователем или сторонним средством в пользовательской базе данных, эти объекты статистики могут блокировать или вмешиваться в изменения схемы, которые клиент может потребовать.
Начиная с SQL Server 2022 (16.x), параметр автоматического удаления включен по умолчанию для всех новых и перенесенных баз данных. Свойство AUTO_DROP позволяет создавать объекты статистики в режиме, чтобы последующее изменение схемы не было заблокировано объектом статистики, но вместо этого статистика будет удалена по мере необходимости. Таким образом, вручную созданная статистика с включенным автоматическим удалением ведет себя как автоматически созданная статистика.
При попытке задать или отменить настройку свойства автоматического удаления в автоматически созданной статистике могут возникнуть ошибки. Автоматически созданная статистика всегда использует автоматическое удаление. В некоторых резервных копиях при восстановлении это свойство может быть настроено неправильно вплоть до следующего обновления объекта статистики (вручную или автоматически). Однако автоматически созданная статистика всегда ведет себя как статистика автоматического удаления. При восстановлении базы данных в SQL Server 2022 (16.x) из предыдущей версии рекомендуется выполнить sp_updatestats в базе данных соответствующие метаданные для функции автоматического удаления статистики.
Например, чтобы вручную создать объект статистики dbo.DatabaseLog в таблице:
CREATE STATISTICS [mystats] ON [dbo].[DatabaseLog]([DatabaseLogID], [PostTime], [DatabaseUser]) WITH AUTO_DROP = ON; Например, чтобы обновить параметр автоматического удаления объекта статистики dbo.DatabaseLog в таблице:
UPDATE STATISTICS [dbo].[DatabaseLog] [mystats] WITH AUTO_DROP = ON; Чтобы оценить параметр автоматического удаления для существующей статистики, используйте auto_drop столбец в sys.stats :
SELECT object_id, [name], auto_drop FROM sys.stats; Дополнительные сведения см. в статье CREATE STATISTICS (Transact-SQL)
INCREMENTAL
Область применения: SQL Server 2014 (12.x) и более поздних версий.
Если параметр INCREMENTAL инструкции CREATE STATISTICS имеет значение ON, статистика создается по секциям. При значении OFF дерево статистики удаляется, SQL Server выполняет повторный пересчет статистики. Значение по умолчанию — OFF. Этот параметр переопределяет свойство уровня базы данных INCREMENTAL. Дополнительные сведения о создании добавочной статистики см. в статье CREATE STATISTICS (Transact-SQL). Дополнительные сведения об автоматическом создании статистики по разделам см. в статьях Свойства базы данных (страница параметров) и Параметры ALTER DATABASE SET (Transact-SQL).
Когда в большую таблицу добавляются новые секции, статистики должны быть обновлены для включения новых секций. Однако время, требуемое для сканирования всей таблицы (параметр FULLSCAN или SAMPLE) может быть весьма большим. Кроме того, в сканировании всей таблицы нет необходимости, поскольку могут требоваться только статистики для новых секций. Параметр добавочных статистик создает и хранит статистические данные для каждой из секций и при обновлении обновляет статистику только для тех секций, которым требуются новые статистики
Если статистика по секциям не поддерживается, параметр пропускается и создается предупреждение. Добавочные статистики не поддерживаются для следующих типов статистических данных.
- Статистики, созданные с индексами, не выровненными по секциям для базовой таблицы.
- Статистики, созданные в доступных для чтения базах данных-получателях AlwaysOn.
- Статистики, созданные в базах данных, доступных только для чтения.
- Статистики, созданные по фильтрованным индексам.
- Статистика, созданная по представлениям.
- Статистики, созданные по внутренним таблицам.
- Статистики, созданные с пространственными индексами или XML-индексами.
Когда создавать статистику
Оптимизатор запросов самостоятельно создает статистику следующим образом:
-
Оптимизатор запросов создает статистику для индексов таблиц или представлений в момент создания индекса. Такая статистика создается по ключевым столбцам индекса. Если индекс является отфильтрованным, оптимизатор запросов создает отфильтрованную статистику по подмножеству строк, которое указано для отфильтрованного индекса. Дополнительные сведения об отфильтрованных индексах см. в статьях Создание отфильтрованных индексов и CREATE INDEX (Transact-SQL).
Заметка Начиная с SQL Server 2014 (12.x), статистика не создается путем сканирования всех строк в таблице при создании или перестроении секционированного индекса. Вместо этого оптимизатор запросов использует для создания статистики алгоритм выборки по умолчанию. После обновления базы данных с секционированными индексами можно заметить разницу в гистограммах для этих индексов. Это изменение в поведении может не влиять на время выполнения запросов. Для получения статистики по секционированным индексам путем сканирования всех строк таблицы используйте инструкции CREATE STATISTICS или UPDATE STATISTICS с предложением FULLSCAN .
Для большинства запросов эти два метода создания статистики обеспечивают создание высококачественного плана запроса. В некоторых случаях план запроса можно усовершенствовать, создав дополнительную статистику с помощью инструкции CREATE STATISTICS . Эта дополнительная статистика может фиксировать статистическую корреляцию, которую не учитывает оптимизатор запросов при создании статистики для индексов или отдельных столбцов. Приложение может иметь дополнительные статистические корреляции в данных таблицы. Если учитывать такие корреляции в объекте статистики, оптимизатор запросов сможет усовершенствовать планы запросов. Например, план запроса можно улучшить путем использования отфильтрованной статистики по подмножеству строк данных или статистики по нескольким столбцам предиката запроса.
Если статистика создается инструкцией CREATE STATISTICS, рекомендуем оставлять параметр AUTO_CREATE_STATISTICS включенным, чтобы оптимизатор запросов продолжал регулярно создавать статистику по отдельным столбцам предиката запроса. Дополнительные сведения о предикатах запросов см. в статье Условие поиска (Transact-SQL).
Создание статистики с помощью инструкции CREATE STATISTICS рекомендуется, когда выполняется любое из следующих условий.
- Помощник по настройке ядра СУБД предлагает создать статистику.
- Предикат запроса содержит несколько коррелирующих столбцов, которые еще не включены в один индекс.
- Запрос выполняет выборку из подмножества данных.
- Для запроса отсутствует статистика.
Сведения, относящиеся к статистике и таблицам, связанным с выполняющейся в памяти OLTP, см. в статье о статистике для таблиц, оптимизированных для памяти.
Предикат запроса содержит несколько коррелирующих столбцов
Если предикат запроса содержит несколько столбцов, между которыми есть связи и зависимости, то статистика по нескольким столбцам может усовершенствовать план запроса. Статистика по нескольким столбцам содержит статистику корреляции между столбцами, называемую плотностью, которая недоступна в статистике по отдельным столбцам. Плотность может повысить точность оценки количества элементов, если результаты запроса зависят от связей между данными из нескольких столбцов.
Если столбцы уже принадлежат одному индексу, то объект статистики по нескольким столбцам уже существует и его не нужно создавать вручную. Если столбцы не принадлежат одному индексу, можно создать статистику по нескольким столбцам, создав индекс по столбцам или воспользовавшись инструкцией CREATE STATISTICS. На поддержание индекса расходуется больше системных ресурсов по сравнению с объектом статистики. Если приложению не нужен индекс по нескольким столбцам, можно сэкономить системные ресурсы, создав объект статистики и не создавая индекс.
Во время создания статистики по нескольким столбцам порядок столбцов в определении объекта статистики влияет на эффективность применения плотности для оценки количества элементов. Объект статистики хранит значения плотности для каждого префикса ключевых столбцов в определении объекта статистики. Дополнительные сведения о плотности см. в разделе Вектор плотности на этой странице.
Чтобы получить значения плотности, полезные для оценки количества элементов, столбцы в предикате запроса должны совпадать с одним из префиксов столбцов в определении объекта статистики. Например, в следующем примере создается объект статистики по нескольким столбцам: LastName , MiddleName и FirstName .
USE AdventureWorks2022; GO IF EXISTS (SELECT name FROM sys.stats WHERE name = 'LastFirst' AND object_ID = OBJECT_ID ('Person.Person')) DROP STATISTICS Person.Person.LastFirst; GO CREATE STATISTICS LastFirst ON Person.Person (LastName, MiddleName, FirstName); GO В этом примере объект статистики LastFirst содержит значения плотности для префиксов следующих столбцов: (LastName) , (LastName, MiddleName) и (LastName, MiddleName, FirstName) . Для (LastName, FirstName) плотность недоступна. Если в запросе используются LastName и FirstName , но не используется MiddleName , то плотность будет недоступна для оценки количества элементов.
При запросе выполняется выборка из подмножества данных
Когда оптимизатор запросов создает статистику по отдельным столбцам и индексам, она создается по значениям во всех строках. Если запросы выполняют выборку из подмножества строк и в этом подмножестве присутствует уникальное распределение данных, то отфильтрованная статистика может улучшить планы запросов. Отфильтрованную статистику можно создать с помощью инструкции CREATE STATISTICS с предложением WHERE, чтобы определить выражение предиката фильтра.
Например, с помощью AdventureWorks2022 каждый продукт в Production.Product таблице принадлежит одной из четырех категорий в Production.ProductCategory таблице: Велосипеды, компоненты, одежда и аксессуары. Каждая из этих категорий содержит различные данные, распределенные по весу: вес велосипеда находится в диапазоне от 13,77 до 30,0, вес запчастей — в диапазоне от 2,12 до 1050,00, иногда встречаются значения NULL, значения веса одежды и аксессуаров также равны NULL.
В примере с категорией Bikes отфильтрованная статистика по весу всех велосипедов предоставит оптимизатору запросов более точную статистику, а также повысит качество плана запроса по сравнению с полнотабличной статистикой или отсутствующей статистикой по столбцу Weight. Столбец с весами велосипедов будет хорошим образцом для отфильтрованной статистики, но необязательно окажется удачным выбором для отфильтрованного индекса, если число уточняющих запросов веса относительно мало. Прирост производительности уточняющих запросов, обеспечиваемый отфильтрованным индексом, может оказаться меньше, чем дополнительные расходы на хранение и сопровождение, сопряженные с добавлением отфильтрованного индекса в базу данных.
Следующая инструкция создает отфильтрованную статистику BikeWeights по всем подкатегориям из категории Bikes. Отфильтрованное выражение предиката определяет велосипеды, выполняя перечисление всех подкатегорий велосипедов со сравнением Production.ProductSubcategoryID IN (1,2,3) . В предикате нельзя использовать имя категории Bikes, поскольку оно хранится в таблице Production.ProductCategory, а все столбцы в критерии фильтра должны быть в одной таблице.
USE AdventureWorks2022; GO IF EXISTS ( SELECT name FROM sys.stats WHERE name = 'BikeWeights' AND object_ID = OBJECT_ID ('Production.Product')) DROP STATISTICS Production.Product.BikeWeights; GO CREATE STATISTICS BikeWeights ON Production.Product (Weight) WHERE ProductSubcategoryID IN (1,2,3); GO Оптимизатор запросов может использовать отфильтрованную статистику BikeWeights для улучшения плана запроса в следующем запросе, при котором выбираются все велосипеды с весом более 25 .
SELECT P.Weight AS Weight, S.Name AS BikeName FROM Production.Product AS P JOIN Production.ProductSubcategory AS S ON P.ProductSubcategoryID = S.ProductSubcategoryID WHERE P.ProductSubcategoryID IN (1,2,3) AND P.Weight > 25 ORDER BY P.Weight; GO При запрос определяется пропущенная статистика
Если в результате ошибки или другого события оптимизатору запросов не удается создать статистику, он формирует план запроса, не используя статистику. Оптимизатор запросов помечает статистику как отсутствующую и пытается восстановить ее перед следующим выполнением запроса.
Отсутствующие статистические данные указываются как предупреждения (имя таблицы в красном тексте) при графическом отображении плана выполнения запроса с помощью SQL Server Management Studio. Кроме того, мониторинг класса событий «Статистика отсутствующих столбцов » с помощью SQL Server Profiler указывает, когда статистика отсутствует. Дополнительные сведения см. в статье Категория событий «Ошибки и предупреждения» (ядро СУБД).
Если статистика отсутствует, выполните следующие действия.
- Убедитесь, что параметры AUTO_CREATE_STATISTICS и AUTO_UPDATE_STATISTICS включены.
- Убедитесь, что база данных доступна не только для чтения. Если база данных доступна только для чтения, новый объект статистики сохранить нельзя.
- Создайте отсутствующую статистику с помощью инструкции CREATE STATISTICS.
Если статистика по базе данных только для чтения или моментальному снимку только для чтения отсутствует или устарела, ядро СУБД создает и сохраняет временную статистику в tempdb . Когда ядро СУБД создает временную статистику, имя статистики добавляется суффиксом _readonly_database_statistic для отличия временной статистики от постоянной статистики. Суффикс _readonly_database_statistic зарезервирован для статистики, создаваемой SQL Server. Скрипты для временной статистики могут создаваться и воспроизводиться в базе данных для чтения и записи. При выполнении скрипта Management Studio изменяет суффикс имени статистики с _readonly_database_statistic на _readonly_database_statistic_scripted.
Только SQL Server может создавать и обновлять временную статистику. Тем не менее можно удалять временную статистику и наблюдать за свойствами статистики с помощью тех же инструментов, которые используются для постоянной статистики:
- Удаление временной статистики осуществляется с использованием инструкции DROP STATISTICS.
- Мониторинг статистики ведется с помощью представлений каталога sys.stats и sys.stats_columns. Представление системного каталога sys.stats включает столбец is_temporary для указания постоянной и временной статистики.
Так как временная статистика хранится в tempdb , перезапуск службы SQL Server приводит к исчезновению всех временных статистических данных.
Когда обновлять статистику
Оптимизатор запросов определяет, устарела ли статистика, а затем при необходимости обновляет ее, если она требуется для плана запроса. В некоторых случаях можно улучшить план запроса и тем самым повысить производительность запроса, обновляя статистику чаще, чем она обновляется при включенном параметре AUTO_UPDATE_STATISTICS. Статистику можно обновить с помощью инструкции UPDATE STATISTICS или хранимой процедуры sp_updatestats .
Обновление статистики гарантирует, что запросы будут компилироваться с актуальной статистикой. Обновление статистики с помощью любого процесса может привести к автоматической перекомпиляции планов запросов. Не рекомендуется слишком часто обновлять статистику вручную, поскольку необходимо найти компромисс в производительности между усовершенствованием планов запросов и количеством времени на перекомпиляцию запросов. Критерии выбора компромиссного решения зависят от приложения.
При обновлении статистики с помощью UPDATE STATISTICS или sp_updatestats рекомендуется оставлять параметр AUTO_UPDATE_STATISTICS включенным, чтобы оптимизатор запросов продолжал регулярно обновлять статистику.
- Дополнительные сведения об обновлении статистики по столбцу, индексу, таблице или индексированному представлению см. в статье UPDATE STATISTICS (Transact-SQL).
- Сведения об обновлении статистики по всем определяемым пользователем таблицам и внутренним таблицам в базе данных см. в описании хранимой процедуры sp_updatestats (Transact-SQL).
- Дополнительные сведения о пороговых значениях для автоматического обновления статистики см. в статье Параметр AUTO_UPDATE_STATISTICS.
Если для AUTO_UPDATE_STATISTICS установлено значение OFF, повторная компиляция плана по-прежнему может выполняться по разным причинам, но не происходит автоматически из-за обновлений устаревшей статистики. Если AUTO_UPDATE_STATISTICS имеет значение OFF, обновления статистики будут выполняться только через другие запланированные вручную процессы, например планы обслуживания. Отключение параметра AUTO_UPDATE_STATISTICS может повлечь создание неоптимальных планов запросов и снижение производительности запросов.
Обнаружение устаревшей статистики
Чтобы определить время последнего обновления статистики, используйте функцию sys.dm_db_stats_properties или STATS_DATE.
Обновление статистики рекомендуется в следующих ситуациях.
- Запросы выполняются медленно.
- Выполняются операции вставки в ключевые столбцы, отсортированные по возрастанию или по убыванию.
- После операций обслуживания.
Примеры обновления статистики вручную см. в этом разделе.
Запросы выполняются медленно
Если время ответа на запросы велико или непрогнозируемо, убедитесь, что для запросов есть актуальная статистика, и только потом выполняйте дальнейшие шаги по диагностике.
Выполняются операции вставки в ключевые столбцы, отсортированные по возрастанию или по убыванию
Для статистики по ключевым столбцам, отсортированным по возрастанию или убыванию (например, столбец IDENTITY или столбцы отметок реального времени), может понадобиться выполнять обновление чаще, чем это делает оптимизатор запросов. Операции вставки добавляют новые значения в столбцы, отсортированные по возрастанию или по убыванию. Число добавляемых строк может оказаться слишком маленьким и не вызвать обновление статистики. Если статистика не является актуальной и запросы выполняют выборку из недавно добавленных строк, то в текущей статистике не будет оценки количества элементов для этих новых значений. Это может привести к неправильной оценке количества элементов и замедлить выполнение запроса.
Например, запрос, который выполняет выборку из дат самых последних заказов на продажу, будет иметь неправильную оценку количества элементов, если статистика не обновлена и не содержит оценки количества элементов для дат самых последних заказов на продажу.
После операций обслуживания
Обновление статистики рекомендуется после выполнения процедур обслуживания, которые изменяют распределение данных, таких как усечение таблицы или массовая вставка большого количества строк (в процентном отношении). В будущем это может предотвратить задержки в обработке запросов, вызванные ожиданием автоматического обновления статистики.
Такие операции, как перестроение, дефрагментация и реорганизация индекса, не изменяют распределение данных, и поэтому после выполнения операций ALTER INDEX REBUILD, DBCC DBREINDEX, DBCC INDEXDEFRAG и ALTER INDEX REORGANIZE не нужно обновлять статистику. Но оптимизатор запросов обновляет статистику, когда выполняется перестройку индекса для таблицы или представления с помощью инструкции ALTER INDEX REBUILD или DBCC DBREINDEX. Такое обновление статистики является побочным эффектом повторного создания индекса. Оптимизатор запросов не обновляет статистику после операций DBCC INDEXDEFRAG и ALTER INDEX REORGANIZE.
Начиная с SQL Server 2016 (13.x); с пакетом обновления 1 и накопительным пакетом обновления 4 используйте параметр PERSIST_SAMPLE_PERCENT для CREATE STATISTICS (Transact-SQL) или UPDATE STATISTICS (Transact-SQL), чтобы задать и сохранить определенный процент выборки для последующих обновлений статистических данных, в которых такой процент явно не указан.
Автоматическое управление индексами и статистикой
Используйте такие решения, как Адаптивная дефрагментация индексов, чтобы автоматически управлять дефрагментацией индексов и обновлениями статистики для одной базы данных или нескольких. Эта процедура автоматически выбирает, следует ли перестроить или реорганизовать индекс, сверяясь с уровнем фрагментации и другими параметрами, и обновляет статистику на основе линейных пороговых значений.
Запросы, использующие статистику эффективно
Некоторые особенности реализации запросов, например использование локальных переменных и сложных выражений в предикате запроса, могут привести к созданию неоптимальных планов запросов. Этого можно избежать, если следовать рекомендациям по конструированию запросов. Дополнительные сведения о предикатах запросов см. в статье Условие поиска (Transact-SQL).
Планы запросов можно усовершенствовать, если выполнить рекомендации по конструированию запросов. Они эффективно применяют статистику для улучшения оценки количества элементов для выражений, переменных и функций, используемых в предикатах запросов. Если оптимизатор запросов не знает значения выражения, переменной или функции, он не знает, какое значение следует искать в гистограмме и поэтому не может получить лучшую оценку кратности из гистограммы. Вместо этого оптимизатор запросов выполняет оценку кратности на основании среднего числа строк на каждое уникальное значение для всех строк гистограммы, включенных в выборку. В результате оценка количества элементов оказывается неоптимальной и производительность запросов может снизиться. Дополнительные сведения о гистограммах см. в разделе Гистограмма на этой странице или в статье sys.dm_db_stats_histogram (Transact-SQL).
Следующие рекомендации показывают, как составлять запросы, чтобы усовершенствовать планы запроса благодаря улучшению оценки количества элементов.
Улучшение оценки кратности для выражений
Чтобы улучшить оценку количества элементов для выражений, выполните следующие рекомендации.
- По возможности упрощайте выражения, содержащие константы. Оптимизатор запросов не вычисляет все функции и выражения, содержащие константы, перед оценкой кратности. Например, следует упростить выражение ABS(-100) до 100 .
- Если выражение использует несколько переменных, попробуйте создать вычисляемый столбец для выражения, а затем создать статистику или индекс в вычисляемом столбце. Например, предикат запроса WHERE PRICE + Tax > 100 может иметь лучшую оценку количества элементов, если создать вычисляемый столбец для выражения Price + Tax .
Улучшение оценки кратности для переменных и функций
Чтобы улучшить оценку количества элементов для переменных и функций, выполните следующие рекомендации.
- Если в предикате запроса используется локальная переменная, рекомендуется переписать запрос так, чтобы вместо локальной переменной в нем использовался параметр. Значение локальной переменной неизвестно в момент, когда оптимизатор запросов создает план выполнения запросов. Если в запросе используется параметр, оптимизатор запросов оценивает кратность для первого фактического значения параметра, передаваемого хранимой процедуре.
- Для хранения результатов функции с табличным значением с несколькими инструкциями рекомендуем использовать стандартную или временную таблицу (mstvf). Оптимизатор запросов не создает статистику для функций с табличным значением с несколькими инструкциями. Такой подход позволяет оптимизатору запросов создавать статистику по столбцам таблицы и использовать ее для формирования улучшенного плана запроса.
- Вместо табличных переменных рекомендуется использовать стандартную или временную таблицу. Оптимизатор запросов не создает статистику для табличных переменных. Такой подход позволяет оптимизатору запросов создавать статистику по столбцам таблицы и использовать ее для формирования улучшенного плана запроса. При выборе между временной таблицей и табличной переменной следует учитывать, что табличные переменные, используемые в хранимых процедурах, вызывают меньше перекомпиляций хранимой процедуры, чем временные таблицы. В зависимости от приложения использование временной таблицы вместо табличной переменной не обязательно приведет к повышению производительности.
- Если хранимая процедура содержит запрос, в котором используется переданный параметр, не следует изменять значение параметра в рамках хранимой процедуры до того, как он будет использоваться в запросе. Оценка количество элементов для запроса основывается на значение переданного параметра, а не на обновленном значении. Чтобы исключить изменение значения параметра, можно переписать запрос так, чтобы использовать две хранимые процедуры. Например, хранимая процедура Sales.GetRecentSales изменяет значение параметра @date , если @date имеет значение NULL.
USE AdventureWorks2022; GO IF OBJECT_ID ( 'Sales.GetRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetRecentSales; GO CREATE PROCEDURE Sales.GetRecentSales (@date datetime) AS BEGIN IF @date IS NULL SET @date = DATEADD(MONTH, -3, (SELECT MAX(ORDERDATE) FROM Sales.SalesOrderHeader)) SELECT * FROM Sales.SalesOrderHeader h, Sales.SalesOrderDetail d WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date END GO Если при первом вызове хранимой процедуры Sales.GetRecentSales для параметра @date передается значение NULL, оптимизатор запросов выполнит компиляцию хранимой процедуры с оценкой кратности для @date = NULL , даже если при вызове предиката запроса не указывалось @date = NULL . Такая оценка количества элементов может значительно отличаться от количества строк в фактическом результате запроса. В итоге оптимизатор запросов может выбрать неоптимальный план запроса. Чтобы избежать подобной ситуации, можно переписать хранимую процедуру, разбив ее на две процедуры следующим образом:
USE AdventureWorks2022; GO IF OBJECT_ID ( 'Sales.GetNullRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetNullRecentSales; GO CREATE PROCEDURE Sales.GetNullRecentSales (@date datetime) AS BEGIN IF @date is NULL SET @date = DATEADD(MONTH, -3, (SELECT MAX(ORDERDATE) FROM Sales.SalesOrderHeader)) EXEC Sales.GetNonNullRecentSales @date; END GO IF OBJECT_ID ( 'Sales.GetNonNullRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetNonNullRecentSales; GO CREATE PROCEDURE Sales.GetNonNullRecentSales (@date datetime) AS BEGIN SELECT * FROM Sales.SalesOrderHeader h, Sales.SalesOrderDetail d WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date END GO Улучшение оценки кратности с помощью подсказок запросов
Чтобы улучшить оценку кратности для локальных переменных, можно использовать указания запросов OPTIMIZE FOR или OPTIMIZE FOR UNKNOWN с параметром RECOMPILE. Дополнительные сведения см. в разделе Указания запросов (Transact-SQL).
Для некоторых приложений повторная компиляция запроса при каждом выполнении может занять слишком продолжительное время. Указание запроса OPTIMIZE FOR может повысить производительность даже в случае, когда параметр RECOMPILE не используется. Например, можно добавить параметр OPTIMIZE FOR к хранимой процедуре Sales.GetRecentSales , чтобы указать определенную дату. В следующем примере к процедуре Sales.GetRecentSales добавляется параметр OPTIMIZE FOR .
USE AdventureWorks2022; GO IF OBJECT_ID ( 'Sales.GetRecentSales', 'P') IS NOT NULL DROP PROCEDURE Sales.GetRecentSales; GO CREATE PROCEDURE Sales.GetRecentSales (@date datetime) AS BEGIN IF @date is NULL SET @date = DATEADD(MONTH, -3, (SELECT MAX(ORDERDATE) FROM Sales.SalesOrderHeader)) SELECT * FROM Sales.SalesOrderHeader h, Sales.SalesOrderDetail d WHERE h.SalesOrderID = d.SalesOrderID AND h.OrderDate > @date OPTION ( OPTIMIZE FOR ( @date = '2004-05-01 00:00:00.000')) END; GO Улучшение оценки кратности с помощью руководств по плану
Для некоторых приложений рекомендации по конструированию запросов могут не применяться из-за невозможности изменения запроса или из-за того, что указание запроса RECOMPILE может вызвать слишком много повторных компиляций. С помощью структур плана можно задавать другие указания, такие как USE PLAN, чтобы управлять работой запроса, пока идет согласование изменений приложения с поставщиком приложения. Дополнительные сведения о структурах планов см. в разделе Руководства планов.
В базе данных SQL Azure рекомендуется использовать указания хранилища запросов для принудительного исполнения планов вместо структур планов. Дополнительные сведения см. в разделе Указания хранилища запросов.
См. также
- Статистика для таблиц, оптимизированных для памяти
- CREATE STATISTICS (Transact-SQL)
- UPDATE STATISTICS (Transact-SQL)
- sp_updatestats (Transact-SQL)
- DBCC SHOW_STATISTICS (Transact-SQL)
- Параметры ALTER DATABASE SET (Transact-SQL)
- DROP STATISTICS (Transact-SQL)
- Инструкция CREATE INDEX (Transact-SQL)
- ALTER INDEX (Transact-SQL)
- Создание отфильтрованных индексов
- Controlling Autostat (AUTO_UPDATE_STATISTICS) behavior in SQL Server (Управление поведением Autostat (AUTO_UPDATE_STATISTICS) в SQL Server)
- STATS_DATE (Transact-SQL)
- sys.dm_db_stats_properties (Transact-SQL)
- sys.dm_db_stats_histogram (Transact-SQL)
- sys.stats
- sys.stats_columns (Transact-SQL)
Далее
- Адаптивная дефрагментация индекса из панели элементов группы Microsoft SQL Server Tiger
25 инструментов для анализа и визуализации данных
Если нужны достаточно простые отчеты и диаграммы, то, как правило, хватает обычных систем веб-аналитики и функций Google Таблиц / Excel.
Но для построения полноценных дашбордов (интерактивных инструментов с автоматической загрузкой данных из разных источников) и красивых визуализаций (для презентаций, книг, медиа) лучше подойдут специальные решения.
Рассказываем о 25 средствах (сервисов, систем) для анализа и визуализации данных. По каждому — функциональность, тарифы, скриншот/видео. Подборка пригодится руководителям и владельцам бизнеса, маркетологам, аналитикам, дата-журналистам.
Ключевая составляющая роста в профессии и увеличения заработка — постоянное самообучение. Приглашаем в обучающий центр CyberMarketing всех, кто хочет прокачиваться в SEO, PPC, веб-аналитике, CPA, SMM. У нас есть самые разные форматы: статьи, вебинары, видеокурсы.
Многофункциональные продукты: BI-системы, решения для создания интерактивных дашбордов
Google Data Studio
Google Data Studio — часть Google Marketing Platform, единой платформы для рекламы и аналитики. Этот сервис может объединять данные из нескольких источников и создавать интерактивные отчеты. Можно использовать для сквозной аналитики, автоматической отчетности, оценки эффективности рекламных кампаний.
Возможности:
- 350+ коннекторов для подключения к данным Search Console, PostgreSQL, Adobe Analytics, Google AdSense, YouTube и др.
- 130+ готовых шаблонов для отчетов по Google Ads, Google Analytics, Facebook Ads и др.
- Большой выбор визуализаций: диаграмма Ганта, тепловая карта, диаграмма waterfall и не только.
- Объединение до 5 источников данных по одному или нескольким ключам (параметр, по которому данные совмещаются, например, это может быть URL).
- Легко расшарить отчет для команды или отдельных людей, а также работать над ним с коллегами в режиме реального времени.
Стоимость. Сервис бесплатный, но есть платные сторонние решения, например, для подключения к Яндекс.Метрике через Supermetrics.
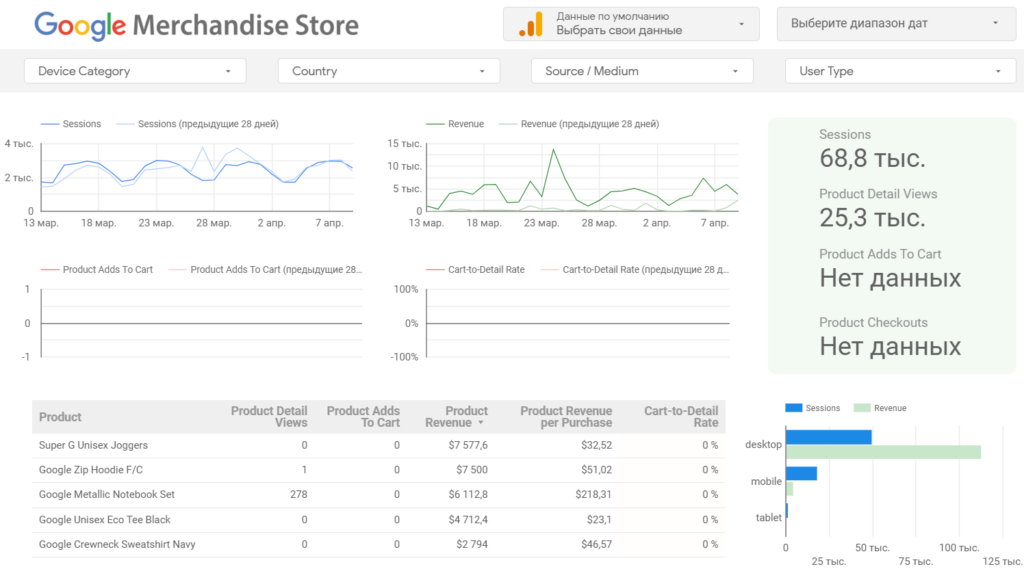
Один из шаблонов Data Studio для работы с Google Analytics
Yandex Datalens
Yandex Datalens — продукт Яндекса для визуализации и анализа данных, достойный конкурент Google Data Studio. Сервис позволяет напрямую подключаться к различным источникам, отслеживать продуктовые и бизнес-метрики, строить визуализации и дашборды.
Функциональность:
- Подключение к ClickHouse, PostgreSQL, MySQL, MS SQL Server, Oracle Database, Google Sheets, Metrica и AppMetrica, еще можно загружать данные из CSV-файлов. (Дополнительные коннекторы — а также дашборды и геослои — можно поискать в маркетплейсе, некоторые варианты платные.)
- Комбинация данных из разных источников в рамках одного дашборда или графика. (Связь между таблицами происходит автоматически — по первому совпадению имени и типу данных полей. Можно использовать агрегирующие функции и вычисляемые поля.)
- Есть все необходимые виды чартов: линейная, столбчатая и круговая диаграммы, таблицы, индикаторы и др.
- Как целые дашборды, так и отдельные визуализации, можно публиковать в открытом доступе, встраивать на сайты.
Стоимость. Есть бесплатный тариф, на котором нет ограничений на внутренние сессии — это, например, сессии с запросами к Metrica, AppMetrica, CSV, ClickHouse, PostgreSQL, MySQL. Но должно быть не больше 100 внешних сессий — то есть сессий с запросами к источникам, которые не относятся к Яндексу и Яндекс.Облаку. А объем БД для материализованных данных (материализация — это процесс загрузки данных из источника в базу данных DataLens) ограничен 500 МБ. Этого достаточно для небольших команд и обучения, а в остальных случаях продукт обойдется в 1 900 руб./мес.
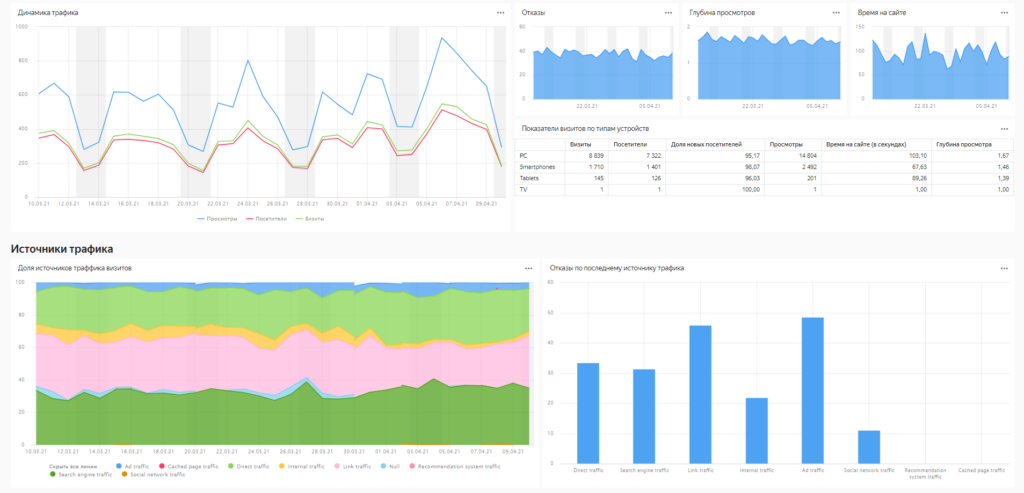
Фрагмент дашборда по данным Яндекс.Метрики
Power BI
Power BI — платформа от Microsoft для бизнес-аналитики, анализа и визуализации данных, необходимых для принятия решений. Можно разобраться как самостоятельно, так и с помощью встроенных средств искусственного интеллекта. Больше подходит среднему и крупному бизнесу.
Инструментарий:
- Поддержка 100+ источников: Google Analytics, MailChimp, GitHub, Oracle, MySQL и др. Автообновление — по расписанию.
- Как и в вышеперечисленных сервисах, здесь можно настраивать типы данных, объединять информацию из разных источников, рассчитывать дополнительные показатели. (Но если в Datalens можно использовать Markdown, в Power BI придется работать со специальным языком DAX.)
- 25+ типов визуализаций: каскадные диаграммы, срезы, матрицы, графики, карты и др.
- Совместный доступ с разграничением прав. Возможность делиться публикациями и встраивать их на сайты.
- Бесплатное мобильное приложение Power BI для Android, iOS и Windows Mobile.
Стоимость. Есть бесплатный тариф без ограничений с точки зрения доступных визуализаций, служб, источников данных. Платный пакет — от 625 руб. за пользователя — может понадобиться, если необходимо работать над отчетами без выгрузки в интернет, обрабатывать огромные массивы данных.
SAP Analytics Cloud
SAP Analytics Cloud — облачная BI-система, которая включает не только визуализацию, но и планирование, прогнозирование, JS-разработку; использует машинное обучение и искусственный интеллект. Комплексное решения для аналитики на разных уровнях.
Среди функций:
- Подготовка и моделирование данных в браузере, добавление расчетных показателей, объединение. В числе источников различные решения SAP, SuccessFactors, Google Drive, MySQL, Salesforce, Oracle, Google Sheets и др.
- Создание «историй» — набора графических и табличных элементов — и использование геоданных. Настройка необходимых KPI, отчётов, процессов для симуляции результатов возможных решений.
- Возможность подключения удалённых пользователей к обсуждению, разграничение прав доступа.
- Инструменты Smart Discovery и Smart Insights для поиска новых идей и изучения скрытых зависимостей, ответов с помощью естественного языка, сводки по большому объему данных, информации об основных факторах.
- Большой набор виджетов: кнопки, выпадающие меню, попапы и прочее; функциональный редактор, интуитивно понятный интерфейс, расширения SDK.
Еще есть мобильные приложения для iPhone и iPad, а также специальное решение для совещаний на основе интерактивных презентаций.
Стоимость. По запросу. Есть пробная версия с ограниченным функционалом на 90 дней.
Обзор дашборда в SAP Analytics Cloud | Гайд по BI
OWOX BI
OWOX BI — платформа для комплексной маркетинговой аналитики. Умеет собирать, очищать и объединять данные из разных источников, настраивать модели атрибуции на основе воронки продаж, строить отчеты по сырым данным.
Возможности:
- Интеграции с Google Analytics, Facebook Ads, Яндекс.Директ, Google BigQuery, Google Sheets, MyTarget и др., в том числе популярными системами коллтрекинга и CRM-системами.
- Нет семплирования и ограничений на собираемые данные. Еще можно их полностью контролировать, потому что они хранятся в Google BigQuery.
- Есть все базовые типы визуализаций: линейчатая, круговая, точечная и столбчатая, график и тепловая карта.
- Около 30 шаблонов для изучения различных срезов: среднее время по типам устройств; доход по дням, источникам трафика и каналам; последовательность шагов воронки по количеству заказов в GA; и др.
- Простой конструктор, где можно настроить нужные параметры и показатели без знаний SQL или других языков. Готовые отчеты можно экспортировать в Google Data Studio, CSV, Google Spreadsheets. (А сегменты, полученные на основе собранных данных или полученных отчетов, — прямо в рекламные системы.)
Стоимость. Сбор данных в Google BigQuery для сквозной аналитики стоит от 42$ в месяц, а маркетинговые отчеты и атрибуция — от 970$/мес. Можно попробовать бесплатно в течение 7 дней, а также записаться на демо.
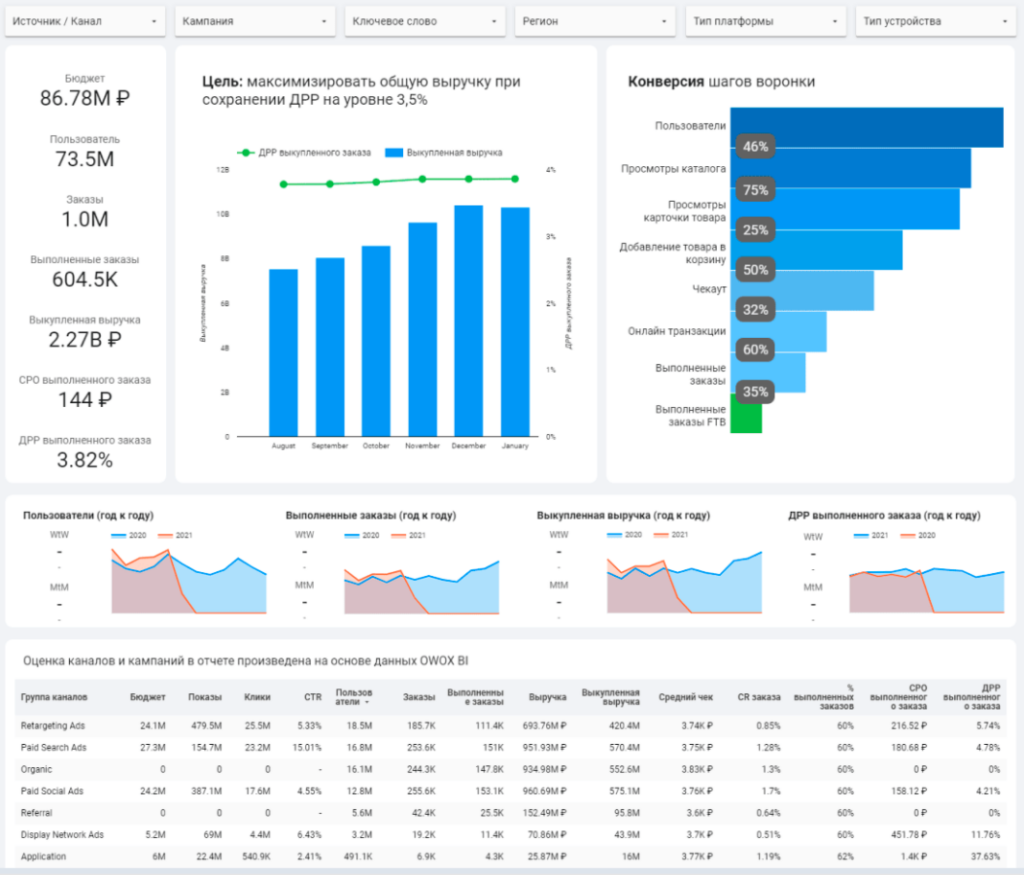
Пример performance-отчета от OWOX BI
Tableau
Tableau — платформа бизнес-аналитики с упором на визуализацию. Миссия: помочь людям — аналитикам, датасайентистам, студентам, руководителям, владельцам бизнеса — видеть и понимать данные, облегчить изучение и управление ими.
Функциональность:
- Простой, интуитивно понятный интерфейс, где множество операций можно сделать в пару кликов, по принципу drag-and-drop.
- Поддержка множества источников: таблицы Excel и Google, базы данных MySQL, Google Analytics, Dropbox и другие. (Можно создать прямое подключение — чтобы новые данные подгружались сразу — или настроить обновление через определенный промежуток времени.)
- Все способы соединения данных: внутреннее и три вида внешних (левое, правое, полное). Еще есть юнионы — с добавлением строк, а не столбцов — между таблицами Excel и Google Sheets, MySQL и PostgreSQL и др. (Как и в других похожих решениях, можно создавать вычисляемые поля, добавлять фильтры и прочее.)
- Большой выбор визуализаций: джаттерчарт, слоупграф, боксплот, буллетчарт, диаграмма Ганта и так далее. Они помогут быстро найти связи между переменными, тенденции, скрытые закономерности. А еще пользователи могут сами создавать инструменты и приложения для дашбордов.
- Разные варианты экспорта: в картинки, PDF, Excel, встраивание на сайт и др.
(Линейка продуктов Tableau включает не только инструменты для анализа и визуализации, но и для подготовки данных. Есть и десктопные, и веб-, и мобильные приложения, серверная версия для крупных компаний.)
Стоимость. От 70 $ в месяц, также есть пробный период 14 дней и бесплатная версия Tableau Public.
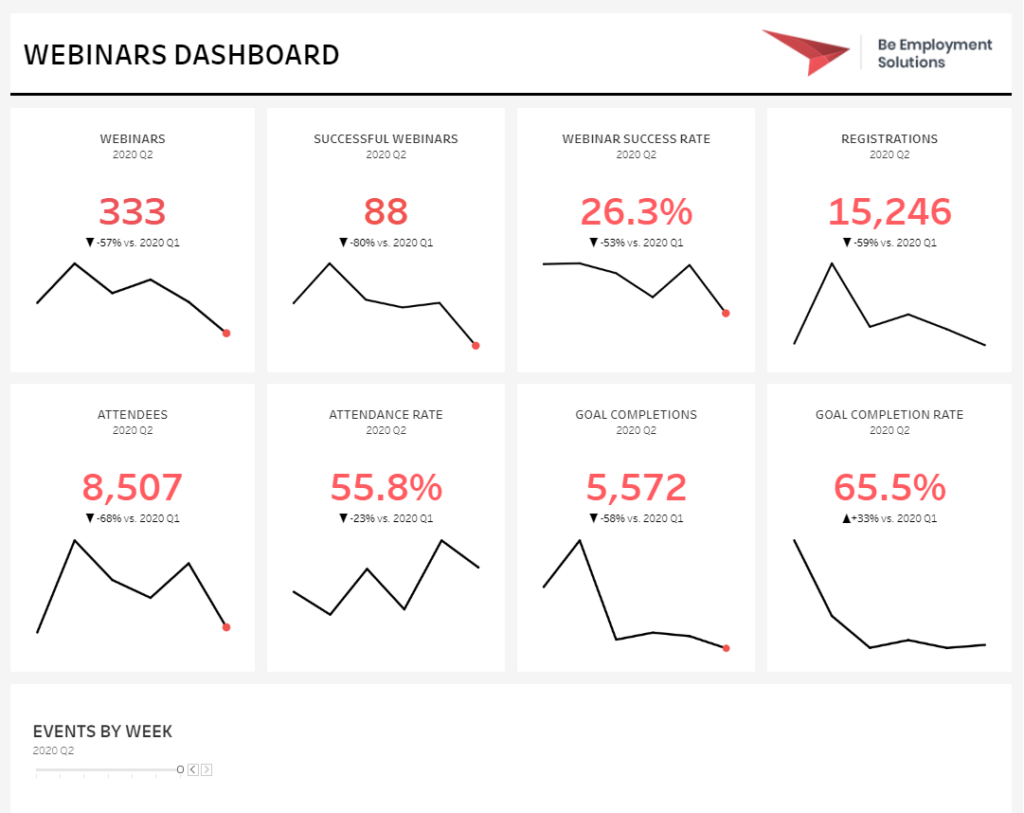
Пример дашборда, сделанного с помощью Tableau
Qlik
Qlik — платформа для бизнес-анализа, которая предлагает превратить сырые данные в ценные инсайты и результаты. Более 5 000 клиентов: PayPal, Airbus, Deloitte и другие.
Особенности:
- Все три компонента аналитической системы: создание аналитических данных (ETL), их хранение и каталогизация, а также визуализация.
- Упрощенное подключение к сотням источников данных: Amazon Redshift, CSV, Google Analytics, JIRA, Google BigQuery, MailChimp, Google Search Console и многим другим.
- Ассоциативная модель, которая автоматически, без искажений и потерь, сводит данные из нескольких источников. Встроенный искусственный интеллект.
- Простые настройки визуализации и большие возможности для автоматизации кодинга. Синтаксис скриптов и формул проще, чем SQL и DAX соответственно.
- Полный набор API-интерфейсов для гибкой настройки аналитических решений: быстрой разработки пользовательских приложений, новых визуализаций и расширений.
- Мощные возможности картографирования и анализа местоположения. Легко добавить многослойные карты с автоматическим поиском геоданных.
(Вообще Qlik — это не один продукт: так, Qlik Sense — облачная платформа BI-аналитики, Qlik View — классическое аналитическое решение с гибкой средой разработки, Qlik Catalog — корпоративное решение с поддержкой ускоренной репликации.)
Стоимость решений для интеграции данных (Qlik Replicate, Qlik Compose и др.) и Qlik Sense Enterprise SaaS — по запросу. Подписка на Qlik Sense Business стоит 30 $ в месяц на одного пользователя. Есть бесплатный пробный период.
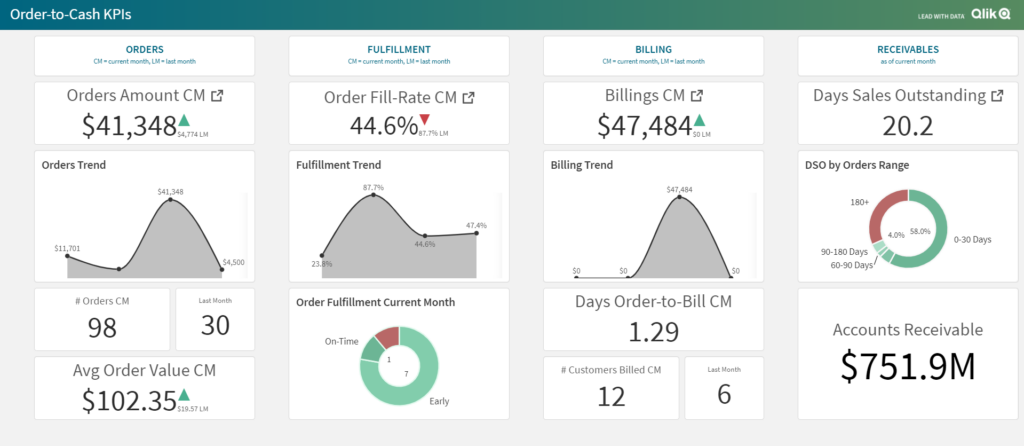
Пример дашборда Qlik Sense
Metabase
Metabase — инструмент бизнес-аналитики с открытым исходным кодом. Разработчики уверяют, что даже сотрудник поддержки и генеральный директор могут получить здесь ответы в пару кликов мышкой — без знаний SQL.
Инструментарий:
- X-Rays — быстрый и простой способ автоматического анализа данных.
- 20+ подключений: PostgreSQL, BigQuery, Google Analytics, CSV, ClickHouse и др.
- 15+ визуализаций. Нет ограничений на количество чартов и дашбордов.
- Создание собственных сегментов (наборов фильтров) и пользовательских метрик.
- Автоматическое обновление (интервал от 1 до 60 минут). Оповещения и отчеты по расписанию.
- Интеграция со Slack.
Стоимость. Подписка на облачный Metabase обойдется минимум в 85 $ в месяц (на 5 пользователей). Коробочный пакет BI для самостоятельного развертывания — бесплатно, так как это продукт с открытым исходным кодом. Enterprise Edition — с встраиваемой аналитикой, настройкой фирменного стиля, инструментами аудита и комплаенса — стоит уже от 15 000 $ в год.
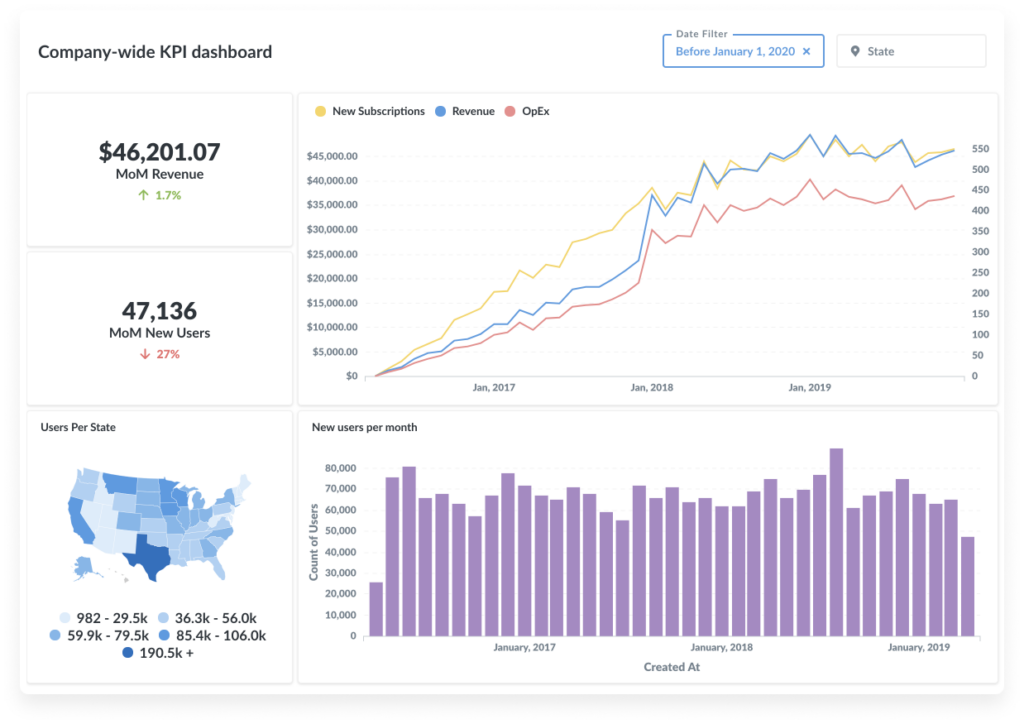
Пример дашборда в Metabase
Looker
Looker — платформа дата-аналитики, на рынке с 2012 года, сейчас часть Google Cloud. Этими решениями для BI и визуализации данных пользуются уже 2 000+ компаний.
В числе преимуществ:
- Всегда свежие данные за счет прямых запросов к базам. Ускорение сложных запросов за счет кеширования.
- Дата-инженер работает с достаточно простым языком Look-ML (что-то среднее между CSS и SQL), а обычный бизнес-пользователь может получать данные вообще без знаний SQL.
- Настройка оповещений обо всех важных событиях: падениях продаж, мошеннических заказах, сбоях.
- Большой выбор интеграций и подключений: Slack, Dropbox, Zapier, Google Analytics, MySQL, Oracle, Google Ads и другие.
- Можно ссылаться на другие отчеты и передавать динамический параметр через ссылку.
(Из минусов, как отмечает бизнес-аналитик Николай Валиотти, — отсутствие поддержки ClickHouse и невозможность построить модель данных, которая бы обращалась в разные СУБД.)
Стоимость — по запросу (еще можно запросить демо).
Как использовать Looker бизнес-пользователям
Redash
Redash — в нашей подборке это еще одно аналитическое решение с открытым исходным кодом. В числе клиентов: Atlassian, Cloudflare, Mozilla.
Инструментарий:
- Мощный и удобный редактор SQL-запросов с автозаполнением, сниппетами, мультфильтрами, кешированием и другими фичами.
- Много интеграций и источников данных: ClickHouse, Databricks, BigQuery, Google Spreadsheets, Яндекс.Метрика и другие.
- 10 типов визуализации: боксплот, диаграмма, воронка, сводная таблица и так далее.
- Доступ через API, автообновление дашбордов и чартов, настройка оповещений, командная работа и расшаривание отчетов по ссылке.
Стоимость. Минимум — 49 $ в месяц за тариф Starter (неограниченное число пользователей, 3 источника, 5 дашбордов, 100 сохраненных запросов, обновление каждые полчаса). Бесплатный пробный период — 30 дней, без ограничений по функциям. Есть скидки для образовательных и некоммерческих организаций.
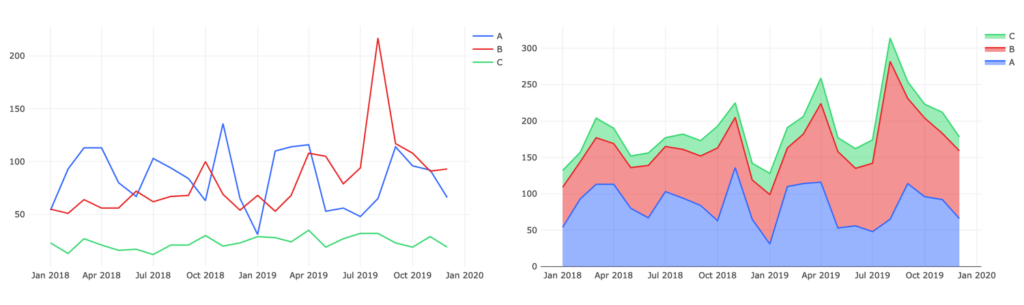
Примеры визуализаций Redash
Klipfolio
Klipfolio — облачная BI-платформа для создания отчетов и дашбордов в режиме реального времени, один из самых старых игроков на рынке. Пользуются American Red Cross, Electrolux и еще 50 000+ компаний.
Функциональность:
- Более 300 коннекторов: Google Sheets, Kissmetrics, Facebook Ads, Dropbox и многие другие. (Еще есть REST API, через который можно подключить любой другой источник данных.)
- 10+ готовых шаблонов для разных целей: анализа контент-маркетинга, конкурентов в SEO, ключевых слов в Google Ads и др. И сотни примеров целых дашбордов и отдельных KPI’s (чартов).
- Десятки типов графиков: пайчарты, гистограммы и многие другие. Настройка оформления с помощью CSS. (Более сложные элементы можно добавить с помощью различных формул и функций.)
- Расшаривание по ссылке и сохранение в PDF. (К отчетам также можно добавить удобные аннотации.)
(Есть еще дополнительные бесплатные продукты от Klipfolio: PowerMetrics — легкая аналитика данных для руководителей и менеджеров; MetricHQ — онлайн-словарь показателей и KPI для всех.)
Стоимость. Подписка стоит от 49 $ в месяц (на сумму, к примеру, влияют количество дашбордов и пользователей, частота обновления данных.) Бесплатный пробный период — 14 дней, также можно запросить демонстрацию.
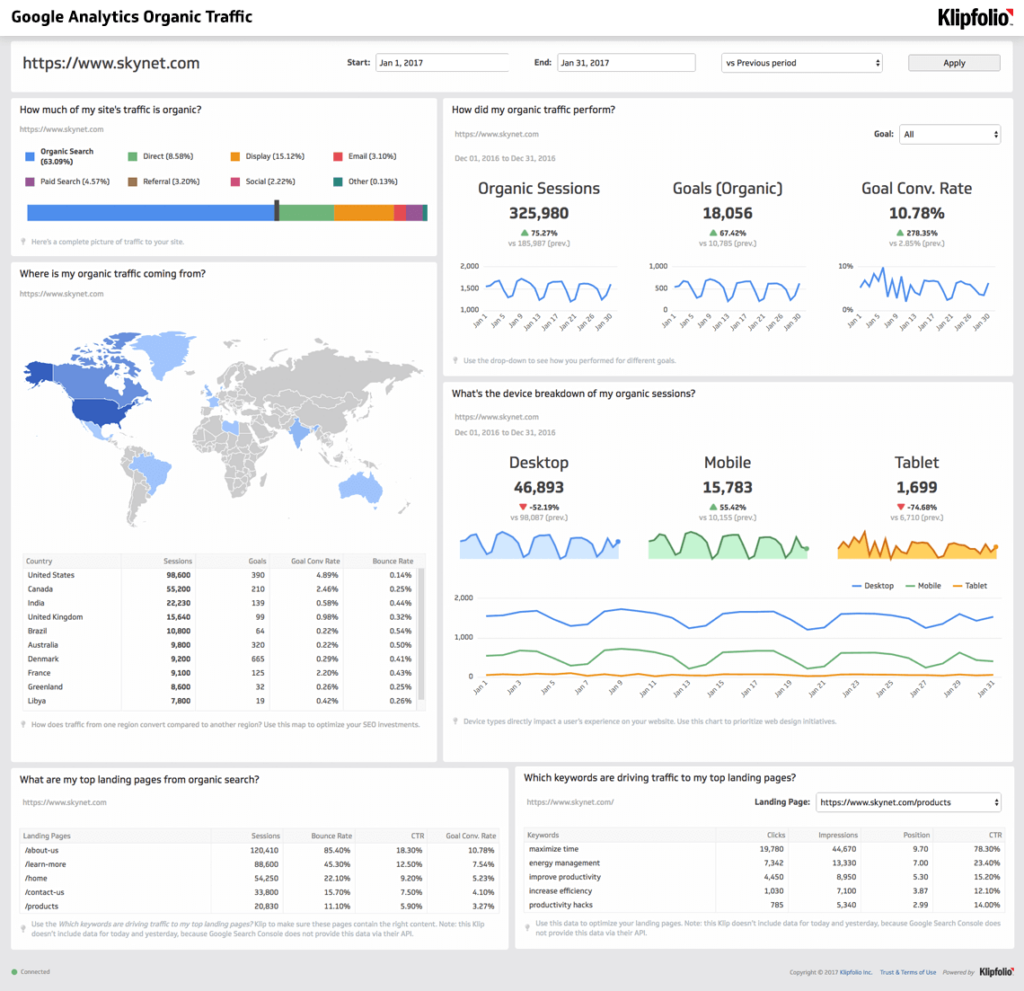
Пример дашборда Klipfolio для изучения органического трафика в Google Analytics
Более простые и специализированные инструменты для красивых визуализаций: диаграмм, графиков, таблиц, карт
Datadeck
Datadeck — продукт для команд, ориентированных на достижение целей, и бизнеса, который практикует data-driven подход.
Инструментарий:
- Интуитивно понятный интерфейс, простая и быстрая настройка.
- Подключение к 100+ источникам данных: Google Analytics, Facebook Ads, MailChimp, YouTube, Google BigQuery, Zapier и другим. Поддержка ETL для объединения данных.
- Десятки готовых шаблонов: топовые источники, сводка по трафику, SEO дашборд и так далее.
- Весь необходимый набор для визуализации: таблица, столбчатая диаграмма, график, круговая диаграмма, прогресс-бар и прочие.
- Совместная работа, интеграция со Slack.
Стоимость. У сервиса есть бесплатная и платная версии. Можно оплачивать 29 $ ежемесячно или купить полноценную лицензию.
Видео о том, как использовать шаблон GA в Datadeck
Datawrapper
Datawrapper — мощный инструмент для визуализации данных, который не требует специальных знаний в программировании и дизайне. Особенно востребован в медиа — например, им пользуются The New York Times, Vox, Spiegel, а из наших — «Тинькофф Журнал». (Создатели сервиса сами раньше работали в таких изданиях, как Deutsche Welle, Bloomberg и т. п.).
Особенности. Максимально простой процесс (не обязательна даже регистрация):
- Загрузить файл, сослаться на Google Sheets или просто скопировать-вставить нужные данные. (Чтобы попробовать, можно взять готовые образцы.)
- Проверить ошибки, транспонировать таблицу и/или добавить еще данные.
- Выбрать один из 20+ типов диаграмм, карт, таблиц (все они интерактивные и адаптивные). Если нужно — кастомизировать, добавить аннотации, настроить дизайн.
- Скачать готовую визуализацию или опубликовать для встраивания на сайт. (Если сослаться на внешний CSV-файл или таблицу Google, данные будут автоматически обновляться.)
Стоимость. Даже на бесплатном тарифном плане нет ограничений на создание, публикацию, встраивание на сайты и экспорт в PNG. Если нужно сохранять файлы еще в SVG и PDF, убрать указание Datawrapper и ссылку на сайт, максимально кастомизировать дизайн под фирменный стиль — понадобится подписка. Она стоит 599 $ в месяц.
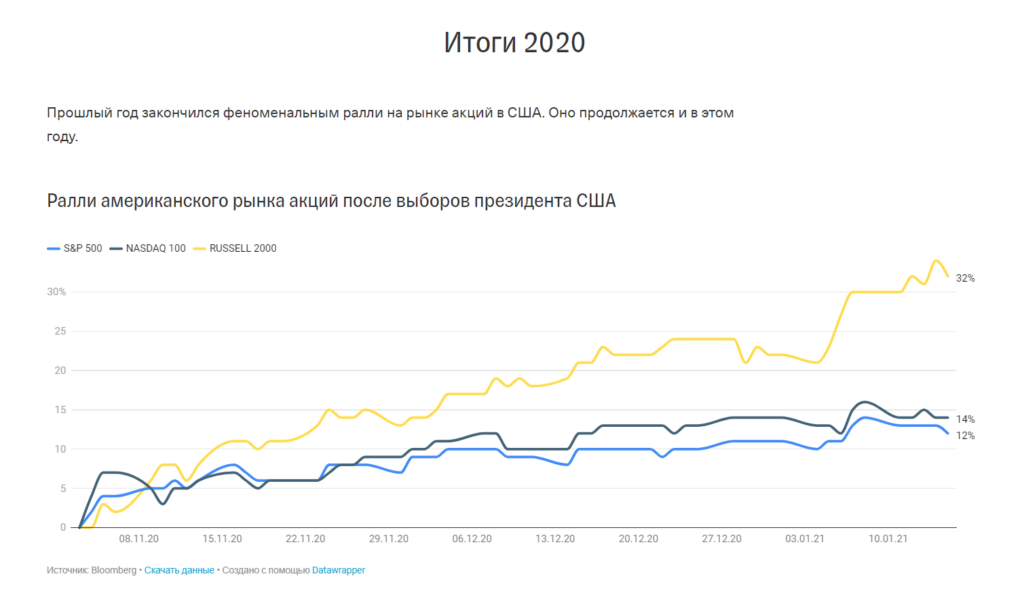
Пример визуализации Datawrapper, встроенной на tinkoff.ru
Datamatic
Datamatic — онлайн-сервис для создания интерактивных графиков и диаграмм. Часть экосистемы Google Drive.
Функциональность:
- Простой и интуитивно понятный интерфейс. (Ненамного сложнее, чем вышеупомянутый Datawrapper. Для начала работы достаточно авторизации через аккаунт Google.)
- 70+ шаблонов: столбчатые диаграммы, гистограммы, географические карты, диаграмма прогресса и другие. (Правда, большинство — премиум, то есть доступны только по подписке.)
- Гибкие настройки внешнего вида визуализации: можно менять цвет фона, размер заголовка, ширину рамки, положение ватермарки и многое другое.
- Диаграммы, графики и карты можно публиковать с доступом по ссылке или встраивать на сайты.
Стоимость. Есть бесплатный тариф с ограничениями по количеству доступных шаблонов и обязательной атрибуцией на dramatic.io. Подписка 10 $ в месяц открывает все премиум-варианты, а от 45 $ в месяц можно публиковать диаграммы и графики без обязательной ссылки на сервис, работать через API, создавать пользовательские визуализации. Если хочется сначала попробовать, а потом платить, есть пробный период в 14 дней.
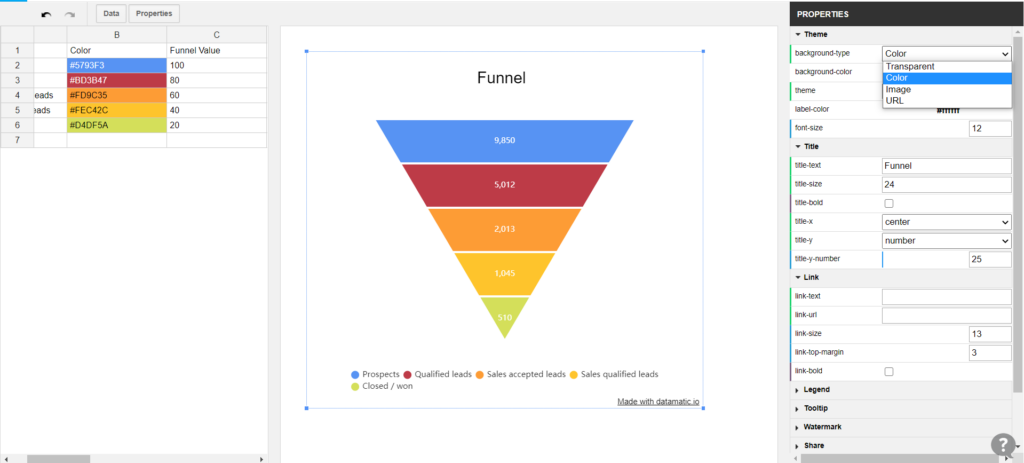
Редактирование бесплатного шаблона Funnel в Datamatic
RAWGraphs
RAWGraphs — платформа визуализации данных с открытым исходным кодом. Позиционируются как недостающее звено между приложениями электронных таблиц (например, Microsoft Excel, Apple Numbers, OpenRefine) и редакторами векторной графики (например, Adobe Illustrator, Inkscape, Sketch).
Особенности:
- Работает с файлами CSV и TSV, API и CORS, и просто текстом, который скопировали и вставили из Microsoft Excel, Google Spreadsheets или других редакторов. (JSON и XML не поддерживаются.)
- Все данные остаются в браузере пользователя — нет никаких хранилищ и операций на стороне сервера.
- Визуализации создаются на основе формата SVG, то есть их легко можно отредактировать через инструменты для обработки векторной графики. Еще их можно экспортировать в растровые изображения (PNG) и встраивать на сайт.
- 20+ доступных типов: скаттерплот, тримап, бар- и пайчарт и другие. RAWGraphs поставляется с API для создания и редактирования диаграмм, поэтому не обязательно ограничиваться этим стандартным набором. Для работы достаточно базовых знаний библиотеки JavaScript D3.js.
- Можно свободно делиться, публиковать и изменять визуализации, созданные с помощью RAWGraphs.
Стоимость. Бесплатно.

Пример визуализации из галереи RAWGraphs
RStudio
RStudio — программная среда для статистических вычислений и графики. Работает на Unix, Windows, MacOS. Есть как десктопное, так и серверное приложение. (R — открытый кроссплатформенный язык статистического программирования, доступно более 10 000 пакетов для решения различных задач.)
Возможности ПО и самого языка R включают:
- Импорт данных из самых разных источников, в том числе из текстовых файлов, систем управления базами данных, других статистических программ и специализированных хранилищ. (R может также записывать данные в форматах всех этих систем.)
- Объем обрабатываемых данных ограничен только оперативной памятью компьютера. R работает с самыми разными структурами данных, включая скаляры, векторы, матрицы, массивы данных, таблицы данных и списки.
- Современные графические возможности, разнообразные и мощные методы анализа данных для сложных визуализаций. Дополнительные пакеты (такие как grid, lattice, ggplot2, playwith, latticist, iplots и др.) позволяют создавать и многомерные, и интерактивные диаграммы. Естественно, есть все базовые типы: гистограммы, линейные графики и так далее.
Стоимость. Бесплатно, если пользоваться версиями с открытым исходным кодом. Есть и коммерческие — с дополнительными возможностями для организаций. Например, RStudio Desktop Pro стоит 995 $ в год.
Алексей Селезнев о том, как с помощью R-studio автоматизировать работу с данными Яндекс.Метрики
Count
Count — BI-инструмент, чтобы заниматься аналитикой быстро и эффективно (и самому, и с коллегами).
Особенности:
- Пожалуй, можно назвать это Notion для бизнес-аналитиков, который сочетает в себе элементы IDE SQL, средств разработки Notebook и инструментов визуализации данных.
- Поддержка BigQuery, MySQL, PostgreSQL, Redshift, Snowflake, SQL Server.
- Большие возможности для создания и настройки визуализаций. Гистограммы, пузырьковые диаграммы, тепловые карты и не только.
- Разные настройки шеринга: можно использовать ноутбук совместно в рамках проекта, открыть доступ по имейлу или опубликовать для всех в интернете без необходимости регистрироваться.
Стоимость. Есть бесплатный план для индивидуального использования, который не предусматривает шеринг и командную работу, а также разрешает только одно подключение к базе данных. А подписка для одного пользователя с правом на редактирование стоит 29 $ в месяц. Еще есть пробный период 2 недели.
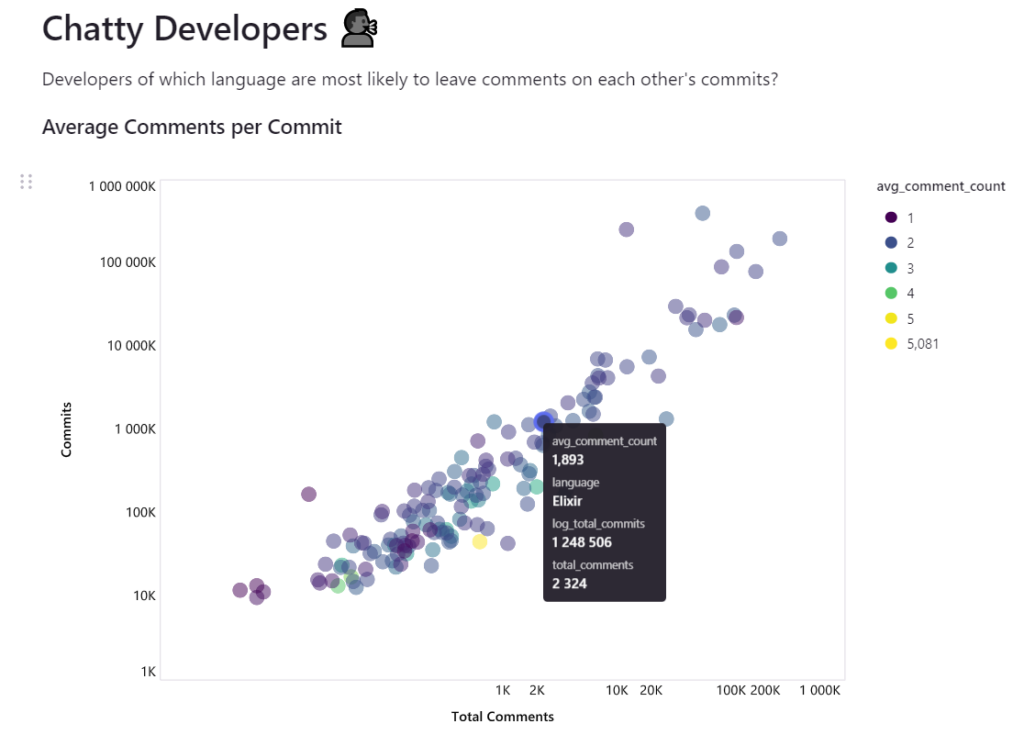
Из примеров использования Count
Chart Studio (Plotly)
Chart Studio (Plotly) — инструмент для быстрого создания и редактирования диаграмм прямо в браузере. Интерактивные материалы Chart Studio использовали Wired, Forbes, Wall Street Journal, Nature, Washington Post и Medium.
Функциональность:
- Самые разные способы импорта данных: прямое копирование; из файлов .xls, .xlsx или .csv; по ссылке. (Поддерживаются целых 400 форматов дат и времени.)
- Максимально простое изменение масштабов и положений элементов. Кастомизация внешнего вида отчетов под требования фирменного стиля.
- Легкий шеринг картинки или интерактивной версии. Экспорт кода — в HTML, Python и R, визуализаций — в форматах PNG, PDF, SVG или ESP. А сами данные тоже можно выгрузить в CSV или Excel.
- Десятки доступных вариантов визуализаций: гистограмма, боксплот, хороплет, тепловая карта, таблица и др. Из нескольких диаграмм можно составить информационную панель, то есть дашборд.
- Библиотеки Python, Matlab, R для работы через API.
Стоимость. Есть бесплатная версия, которая ограничена 100 вызовами API и 1 000 просмотров опубликованной диаграммы в день. Тарифы Enterprise стоят от 25 000 $ в год.
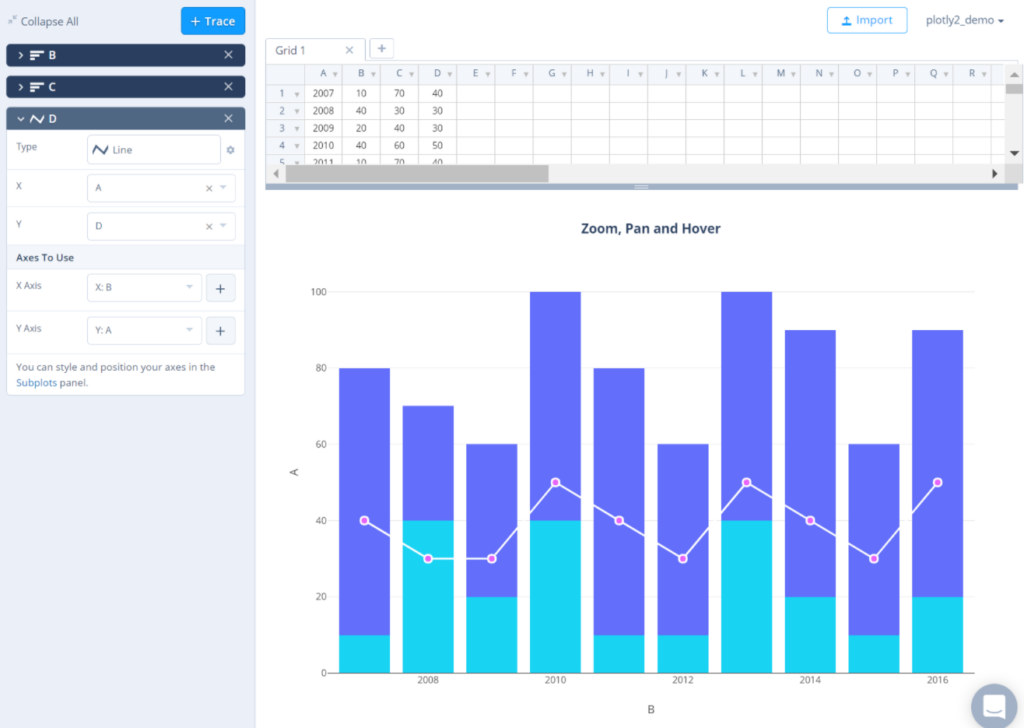
В процессе работы с Chart Studio
Flourish
Flourish обещают быстрое и легкое превращение данных в красивые диаграммы, карты и интерактивные истории — без программистов и дизайнеров. В качестве социального доказательства — упоминание тысяч организаций, которые используют этот продукт, в числе которых BBC, Google, Shopify и др. (И этого удалось достичь всего за пару лет.)
Возможности:
- Максимально простой и понятный интерфейс, где все делается по принципу drag-and-drop.
- Импорт данных в форматах Excel, CSV, TSV, JSON, GeoJSON. Причем Flourish может не только загрузить готовую базу, но и объединить с имеющейся. (А если своих данных пока нет, но хочется попробовать — в каждом шаблоне уже есть тестовый датасет.)
- Богатый ассортимент возможных визуализаций: столбчатые диаграммы, карты, пайчарты, скаттерплоты и др. Плюс есть более специализированные шаблоны для визуализации результатов опросов, спортивных мероприятий и др.
- А с использованием специальных библиотек JavaScript, а также базовых знаний HTML и CSS, можно создавать более сложные штуки, например, скроллителлинг — когда при прокрутке меняется не все содержимое страницы, а только его часть.
- Гибкие настройки самих чартов: можно менять высоту, режим сортировки, цвета, подписи, форматы данных, всплывающие подсказки и многое другое.
- Готовый результат можно скачать как изображение или в формате HTML, а также встроить на сайт через embed.
- Автоматическое обновление и повторная публикация визуализаций, созданных из онлайн-файлов CSV или Google Таблиц. (Но только на платных тарифах.)
Стоимость. Бесплатный аккаунт — публичный, то есть все созданные графики/диаграммы и данные будут в открытом доступе. Это хороший вариант для медиа и блогеров, но не всегда подходит для бизнеса и специалистов. Тариф Personal обойдется в 69 $ в месяц, а Business Lite — где есть командная работа, кастомная тема, приоритетная поддержка — стоит уже почти 5 000 $ в год.
«Важные истории» рассказывают, как сделать крутую визуализацию для сайта за 5 минут в Flourish
ChartBlocks
ChartBlocks — онлайн-инструмент для построения диаграмм, позиционируется как самый простой в мире.
Функциональность:
- Импорт данных практически из любого источника: электронных таблиц, БД, а в планах даже загрузка из прямых трансляций. Плюс можно добавить расчетные показатели: суммирование, среднее и др.
- Создание всех основных типов визуализаций: столбчатых и линейных, круговых и точечных диаграмм.
- Настройка почти всех элементов: цвет, размер, шрифт, масштаб, толщина линий и т. п. Также можно добавить сортировку, фильтрацию и др.
- Адаптивность, удобство просмотра на всех экранах благодаря использованию HTML5 и D3.js.
- Встраивание диаграмм на сайт, прямая публикация в Facebook, Pinterest и Twitter, экспорт в виде векторной графики.
- API и ChartBlocks SDK для быстрого и легкого создания диаграмм, удаления наборов данных, извлечения в SVG, PNG, JPEG или PDF и других задач.
Стоимость. Есть бесплатный тарифный план, в котором действуют следующие ограничения: 50 наборов данных, 50 графиков, 50 000 просмотров в месяц, 1 пользователь, обязательное брендирование. При этом разрешается приватность и скачивание картинок в растровом или векторном формате. Если есть необходимость расширить функциональность, нужно будет купить подписку от 20 $ в месяц.
Выбор шаблона барчарта в ChartBlocks
Infogram
Infogram — еще один зарубежный сервис для создания инфографики, отчетов, карт. С 2012 года у компании уже 4 млн пользователей.
Инструментарий:
- Импорт из Google Sheets, JSON, Dropbox, Excel, Google Analytics и пр. Еще есть интеграции с SlideShare, YouTube, Flickr и другими медиа.
- Более 200 шаблонов инфографики, отчетов, слайдов, дашбордов, плакатов, эскизов YouTube и др.
- 20+ готовых тем оформления, а также возможность настройки внешнего вида в соответствии с фирменным стилем.
- Анимации и улучшенная интерактивность: всплывающие подсказки, скольжение и др.
- Библиотека из 1 млн стоковых картинок, гифок, иконок и др.
- Экспорт в PNG, JPG, GIF, PDF, HTML.
- Командная работа в режиме реального времени.
- Мощная аналитика: демографические данные о зрителях, средняя частота показа, количество людей, расшаривших контент.
Стоимость. Есть бесплатный тарифный план с такими лимитами: 37+ доступных типов интерактивных диаграмм, 10 проектов и 5 страниц на проект, 13 типов карт. Если нужно существенно увеличить эти лимиты, а также включить дополнительные возможности (установка цветов и шрифтов, расширенное редактирование изображений, скачивание в высоком качестве), придется платить. От 19 $ в месяц.
Один из примеров с сайта infogram.com
FastCharts
FastCharts — минималистичный инструмент от Financial Times, как следует из названия, для быстрого создания чартов. Для этого даже не требуется регистрация.
Возможности:
- Никаких сложных подключений к БД. Достаточно просто скопировать и вставить данные в CSV или TSV формате. Или воспользоваться пробными датасетами. (Кстати, отдельные данные удобно править вручную прямо в интерфейсе FastCharts.)
- Только четыре вида визуализации: линейная, столбчатая, линейчатая диаграммы, а также график области.
- Базовая настройка чарта: задание размеров и форматов, добавление аннотаций, указание источника и заголовка, минимальных и максимальных значений и др. Еще есть кастомизация оформления.
- Скачивание готовой графики в PNG или SVG.
Стоимость. Бесплатно.
В процессе работы с FastCharts
Graph Commons
Graph Commons — специализированный инструмент для работы с диаграммами (графами) связей, которые нужны для визуализации отношений между людьми и организациями.
Инструментарий:
- Визуальный редактор данных.
- Импорт из электронных таблиц Google и Excel.
- Продвинутые алгоритмы для поиска скрытых закономерностей, косвенных связей, кластеризации.
- Поиск данных на графиках, фильтры.
- Совместная работа над проектом, доступ через API.
- Экспорт в CSV, JSON, GraphML, Cypher; возможность встраивания интерактивных графиков и карточек на сайт.
Стоимость. Есть бесплатная версия, и ее должно хватить для тех, кто готов делать только публичные графики. Чтобы создавать приватные графы, придется платить от 9 $ в месяц.
Так работает Graph Commons
Mapbox Studio
Mapbox Studio — решение для создания карт и управления геоданными. Что-то типа Adobe Photoshop, только для карт.
Возможности:
- Интуитивно-понятный интерфейс.
- Редактор датасетов, где можно добавить точечные, линейные и полигональные объекты с помощью инструментов рисования.
- Мощный редактор стилей, где можно настроить цвет и шрифт, или создать свой стиль с нуля, используя пользовательские данные и тщательно продуманные стили слоев.
- Мгновенное создание реалистичных трёхмерных ландшафтов c фоновым небом. Также можно добавить на карту 3D-здания.
- Импорт шейпфайлов, geoJSON, CSV и других.
(А еще Mapbox это SDK для навигации, поиска достопримечательностей и мобильных карт, инструмент для преобразования геопространственных данных в вектор, Streets — для логистики и бизнес-аналитики и не только.)
Стоимость. У всех продуктов Mapbox есть бесплатные уровни, но за превышение лимитов — по количеству пользователей, загрузок карт, запросов через API и др. — придется платить. Система сложная, и ее нет смысла расписывать подробно.
Cтиль Blueprint из галереи Mapbox
MapChart
MapChart — уже другой сервис для создания карт, причем очень простой в использовании. Создан внештатным разработчиком-самоучкой.
Особенности работы:
- Сначала нужно выбрать одну из множества карт (карты мира, Европа и Америка, Германия и еще 20+ стран, фентезийные карты).
- Затем раскрасить нужные области, добавить заголовок и описание для каждой цветовой группы. Можно менять цвет фона, шрифт легенды и др.
- Готовая карта скачивается в формате PNG в высоком разрешении. Изображения легко можно использовать и для коммерческих целей, если соблюдаются условия лицензии Creative Commons Attribution-ShareAlike 4.0.
Стоимость. Бесплатно.
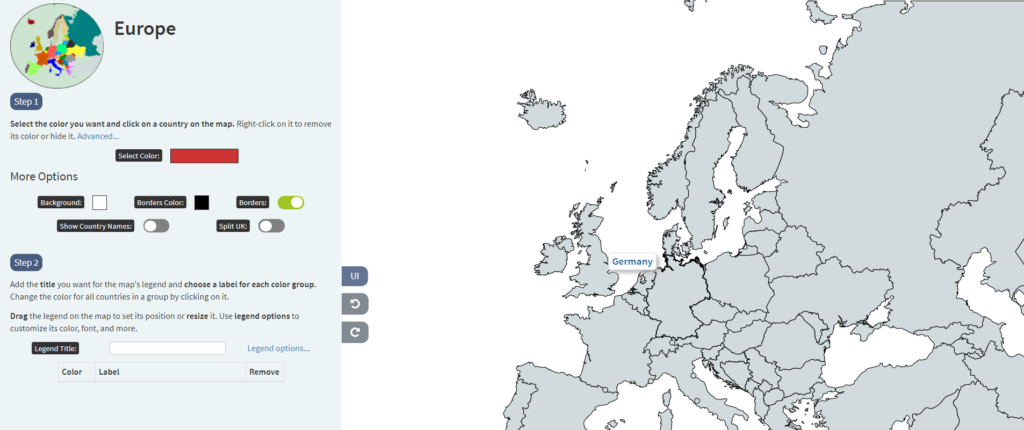
Начало работы с MapChart