
Запросы
С помощью оператора DISTINCT можно выбрать уникальные данные по определенным столбцам.
К примеру, разные товары могут иметь одних и тех же производителей, и, допустим, у нас следующая таблица товаров:
USE productsdb; DROP TABLE IF EXISTS Products; CREATE TABLE Products ( Id INT AUTO_INCREMENT PRIMARY KEY, ProductName VARCHAR(30) NOT NULL, Manufacturer VARCHAR(20) NOT NULL, ProductCount INT DEFAULT 0, Price DECIMAL NOT NULL ); INSERT INTO Products (ProductName, Manufacturer, ProductCount, Price) VALUES ('iPhone X', 'Apple', 3, 71000), ('iPhone 8', 'Apple', 3, 56000), ('Galaxy S9', 'Samsung', 6, 56000), ('Galaxy S8', 'Samsung', 2, 46000), ('Honor 10', 'Huawei', 3, 26000);
Выберем всех производителей:
SELECT Manufacturer FROM Products;
Однако при таком запросе производители повторяются. Теперь применим оператор DISTINCT для выборки уникальных значений:
SELECT DISTINCT Manufacturer FROM Products;
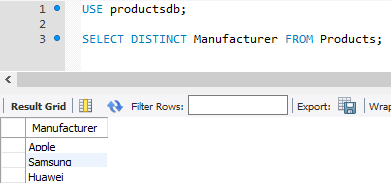
Также мы можем задавать выборку уникальных значений по нескольким столбцам:
SELECT DISTINCT Manufacturer, ProductCount FROM Products;
В данном случае для выборки используются столбцы Manufacturer и ProductCount. Из пяти строк только для двух строк эти столбцы имеют повторяющиеся значения. Поэтому в выборке будет 4 строки:
Как в sql выбрать уникальные значения
С помощью DISTINCT можно получить только уникальные значения из столбца таблицы.
SELECT DISTINCT first_name FROM users; first_name ------------ Roman Sean Alex Michal Britney Кроме того, DISTINCT можно использовать и с несколькими полями сразу:
SELECT DISTINCT first_name, last_name FROM users; first_name | last_name ------------+--------------- Bruce | Williss Sean | Connery Robin | Williams уникальные значения в столбцах, как их выбрать?
@Oleg Поскольку структура не описана, я исхожу из того, что дубликатов строк быть не должно. А лишняя сортировка — это потеря производительности. Так что я дистинкт ставить не буду по принципиальным соображениям. 🙂
19 янв 2016 в 6:01
В одно чтение это просто решается:
SELECT hash FROM table GROUP BY hash HAVING --обязательно должна быть строка, где name_val='number' AND value='5' MAX(CASE WHEN name_val='number' AND value='5' THEN 1 ELSE 0 END) = 1 AND --не должно быть строки, где name_val='text' AND value='hello' MAX(CASE WHEN name_val='text' AND value='hello' THEN 1 ELSE 0 END) = 0 Причем если у некоторого hash отсутствует свойство text — запрос вернёт этот hash. А если отсутствует свойство number — то такой hash не вернётся. Как я понял именно так и требуется.
Отслеживать
ответ дан 18 янв 2016 в 17:03
3,470 14 14 серебряных знаков 51 51 бронзовый знак
declare @t table (id int, [hash] varchar(5), [name_var] varchar(20), value varchar(20)) insert into @t(id,[hash], [name_var], [value]) values(1, 'a', 'number', '5'), (2, 'a', 'text', 'hello'), (3, 'b', 'number', '5'), (4, 'b', 'text', 'goodbye'), (5, 'с', 'number', '6'), (6, 'с', 'text', 'apple'), (7, 'd', 'number', '6'), (8, 'd', 'text', 'orange') select A.* from @t A INNER JOIN (select N.hash from @t N where N.[name_var] = 'number' and N.[value] = '5') B ON A.hash = B.hash where A.name_var = 'text' And A.value <> 'hello' Отслеживать
ответ дан 18 янв 2016 в 14:25
1,938 1 1 золотой знак 11 11 серебряных знаков 9 9 бронзовых знаков
SELECT t1.hash FROM table t1 JOIN table t2 ON t1.hash=t2.hash WHERE t1.value=5 AND t1.name_var='number' AND t2.value<>'hello' AND t2.name_var='text' GROUP BY t1.hash Отслеживать
ответ дан 18 янв 2016 в 14:17
7,015 1 1 золотой знак 17 17 серебряных знаков 31 31 бронзовый знак
это все одна таблица
18 янв 2016 в 14:18
Ну так таблицу саму с собой и объединяете.. Если таблица называется eta_tablitsa , то Ваш запрос будет выглядеть вот так: SELECT t1.* FROM eta_tablitsa t1 JOIN eta_tablitsa t2 и т.д.
18 янв 2016 в 14:20
В зависимости от того, что Вам нужно — может понадобиться еще GROUP BY
18 янв 2016 в 14:21
поправил вопрос
18 янв 2016 в 14:24
поправил ответ.
18 янв 2016 в 14:26
Для случая если Вам надо найти несколько равенств и несколько неравенств, можно использовать следующий запрос (корректно для MySQL и Oracle, для других СУБД не проверял):
select hash from alldata T1 where (name_var,value) in (('number','5'),('abcd','xyz')) and not exists( select 1 from alldata T2 where T2.hash=T1.hash and (T2.name_var,T2.value) in (('text','hello'),('text','apple'),('param','2')) ) group by hash having count(1)=2 Данный запрос даст все hash для которых есть строки с number=5 И abcd=’xyz’ при этом для которых не существует ни одной записи c: text=’hello’ или text=’apple’ или param!=’2′ .
Число 2 в строке having count(1)=2 — это количество условий которые должны совпасть в первой части sql запроса. Оно должно точно соответствовать количеству различных name_var, упомянутых в первой части запроса.
В первой части нельзя в in указывать проверку одного и того же поля на несколько разных значений. Если такое встречается, то in, написанный для удобства, надо разворачивать в полноценные проверки. Например в первой части для выбора number=5 или number=6 нельзя написать (name_var,value) in ((‘number’,’5′),(‘number’,’6′),(‘abcd’,’xyz’)) т.к. в этом случае count(1) даст неверный результат. В таком случае надо писать что то типа ( (name_var=’number’ and (value=’5′ or value=’6′) ) OR (name_var=’abcd’ and ‘value’=’xyz’) )
Напротив, во вложенном запросе (который в not exists) можно перечислять любые недопустимые значения, что и показано в основном примере.
Команда DISTINCT
Команда DISTINCT позволяет выбирать только уникальные значения из базы данных (то есть отсеивает дубли: к примеру, в таблице есть две Маши — тогда запрос выведет только первую).
Синтаксис
SELECT DISTINCT поле FROM имя_таблицы WHERE условие
SELECT COUNT(DISTINCT поле) FROM имя_таблицы WHERE условие
SELECT SUM(DISTINCT поле) FROM имя_таблицы WHERE условие
Таблицы для примеров
| id айди |
name имя |
age возраст |
salary зарплата |
|---|---|---|---|
| 1 | user1 | 23 | 400 |
| 2 | user2 | 25 | 500 |
| 3 | user3 | 23 | 500 |
| 4 | user4 | 30 | 900 |
| 5 | user5 | 27 | 500 |
| 6 | user6 | 28 | 900 |
Пример
Давайте выберем все уникальные значения зарплат из таблицы:
SELECT DISTINCT salary FROM employees
Результат выполнения кода:
| salary зарплата |
|---|
| 400 |
| 500 |
| 900 |
Пример
Давайте подсчитаем все уникальные значения зарплат из таблицы (их будет 3 штуки: 400 , 500 и 1000):
SELECT COUNT(DISTINCT salary) as count FROM employees
Результат выполнения кода:
| count количество |
|---|
| 3 |
Пример
Давайте подсчитаем одновременно все уникальные значения зарплат и уникальные значения возрастов и запишем их в разные поля:
SELECT COUNT(DISTINCT salary) as salary_count, COUNT(DISTINCT age) as age_count FROM employees
Результат выполнения кода:
| salary_count зарплата |
age_count возраст |
|---|---|
| 3 | 5 |
Пример
Давайте просуммируем все уникальные значения зарплат из таблицы employees :
SELECT SUM(DISTINCT salary) as sum FROM employees
Результат выполнения кода:
| sum суммарная зарплата |
|---|
| 1900 |