
Стандартизация и нормализация: в чем разница?
Стандартизация и нормализация — это два способа масштабирования данных.
Стандартизация изменяет масштаб набора данных, чтобы иметь среднее значение 0 и стандартное отклонение 1. Для этого используется следующая формула:
х новый = (х я — х ) / с
- x i : i -е значение в наборе данных
- x : Среднее значение выборки
- s : Стандартное отклонение выборки
Нормализация масштабирует набор данных таким образом, чтобы каждое значение находилось в диапазоне от 0 до 1. Для этого используется следующая формула:
x новый = (x i – x мин ) / (x макс – x мин )
- x i : i -е значение в наборе данных
- x min : минимальное значение в наборе данных
- x max : максимальное значение в наборе данных
В следующих примерах показано, как стандартизировать и нормализовать набор данных на практике.
Пример: как стандартизировать данные
Предположим, у нас есть следующий набор данных:
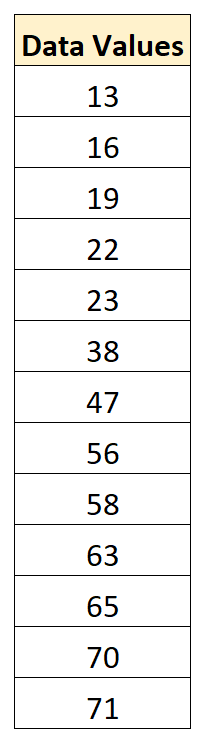
Среднее значение в наборе данных составляет 43,15, а стандартное отклонение — 22,13.
Чтобы нормализовать первое значение 13 , мы должны применить формулу, которую использовали ранее:
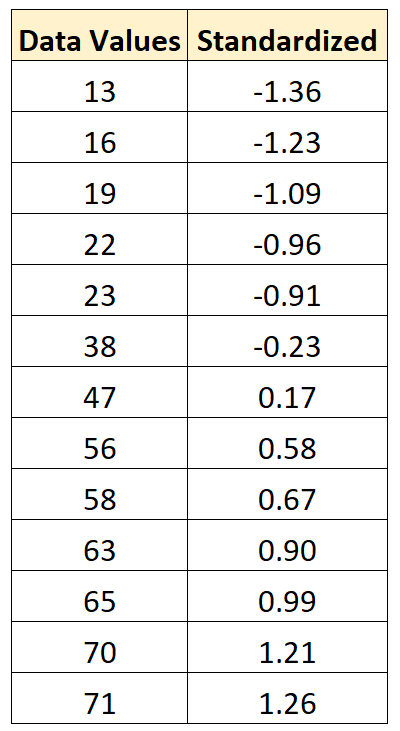
- x новый = (x i — x ) / s = (13 — 43,15) / 22,13 = -1,36
Чтобы нормализовать второе значение 16 , мы будем использовать ту же формулу:
- x новый = (x i — x ) / s = (16 — 43,15) / 22,13 = -1,23
Чтобы нормализовать третье значение 19 , мы будем использовать ту же формулу:
- x новый = (x i — x ) / s = (19 — 43,15) / 22,13 = -1,09
Мы можем использовать эту же формулу для стандартизации каждого значения в исходном наборе данных:
Пример: как нормализовать данные
Еще раз предположим, что у нас есть следующий набор данных:
Минимальное значение в наборе данных — 13, максимальное — 71.
Чтобы нормализовать первое значение 13 , мы должны применить формулу, которую использовали ранее:
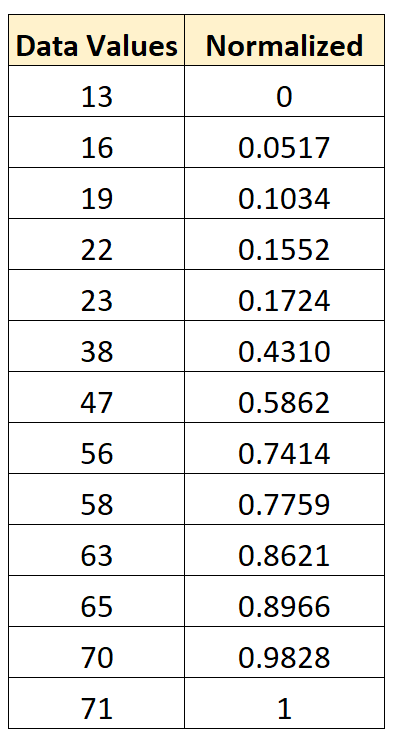
- x new = (x i – x min ) / (x max – x min ) = (13 – 13) / (71 – 13) = 0
Чтобы нормализовать второе значение 16 , мы будем использовать ту же формулу:
- x new = (x i – x min ) / (x max – x min ) = (16 – 13) / (71 – 13) = 0,0517
Чтобы нормализовать третье значение 19 , мы будем использовать ту же формулу:
- x new = (x i – x min ) / (x max – x min ) = (19 – 13) / (71 – 13) = 0,1034
Мы можем использовать эту же формулу, чтобы нормализовать каждое значение в исходном наборе данных между 0 и 1:
Стандартизация против нормализации: когда использовать каждый
Обычно мы нормализуем данные при выполнении некоторого типа анализа, в котором у нас есть несколько переменных, измеряемых в разных масштабах, и мы хотим, чтобы каждая из переменных имела одинаковый диапазон.
Это предотвращает чрезмерное влияние одной переменной, особенно если она измеряется в разных единицах (например, если одна переменная измеряется в дюймах, а другая — в ярдах).
С другой стороны, мы обычно стандартизируем данные, когда хотим знать, на сколько стандартных отклонений каждое значение в наборе данных отличается от среднего.
Например, у нас может быть список результатов экзаменов для 500 учащихся определенной школы, и мы хотели бы знать, на сколько стандартных отклонений каждый результат экзамена отличается от среднего балла.
В этом случае мы могли бы стандартизировать необработанные данные, чтобы узнать эту информацию. Тогда стандартизированный балл 1,26 говорит нам о том, что экзаменационный балл этого конкретного учащегося на 1,26 стандартного отклонения выше среднего экзаменационного балла.
Если вы решите нормализовать или стандартизировать свои данные, имейте в виду следующее:
- Нормализованный набор данных всегда будет иметь значения в диапазоне от 0 до 1.
- Стандартизированный набор данных будет иметь среднее значение 0 и стандартное отклонение 1, но нет конкретных верхней или нижней границы для максимального и минимального значений.
В зависимости от вашего конкретного сценария может иметь смысл нормализовать или стандартизировать данные.
Дополнительные ресурсы
В следующих руководствах объясняется, как стандартизировать и нормализовать данные в различных статистических программах:
Стандартизация данных (Data standardization)
В широком смысле стандартизация данных представляет собой этап их предобработки с целью приведения к определённому формату и представлению, которые обеспечивают их корректное применение в многомерном анализе, совместных исследованиях, сложных технологиях аналитической обработки.
В статистике целью стандартизации является обеспечение возможности корректного сравнения значений наблюдений, собранных одними и теми же методами, но в различных условиях. Например, в магазине, расположенном в курортном городе, число посетителей в сезон отпусков и в «мёртвый» сезон может различаться в сотни раз, поэтому выполнить корректный анализ продаж на таких данных проблематично. Кроме этого, наблюдения, собранные в различных условиях, могут происходить из различных вероятностных распределений с различными параметрами, что также усложняет процесс анализа.
В процессе стандартизации происходит формирование стандартизированных шкал. Стандартизация позволяет устранить возможное влияние отклонений по какому-либо признаку. Стандартизация приводит все исходные значения набора данных, независимо от их начальных распределений и единиц измерения, к набору значений из распределения с нулевым средним и стандартным отклонением, равным 1. В результате формируется так называемая стандартизированная шкала, которая определяет место каждого значения в наборе данных, измеряя его отклонение от среднего в единицах стандартного отклонения. Значения стандартизированной шкалы определяются следующим образом:
z i = x i − ¯ ¯¯ ¯ X σ x ,
где x i — исходное значение признака, ¯ ¯¯¯ ¯ X и σ x — среднее значение и стандартное отклонение признака, оцененные по набору данных. В стандартизированных шкалах среднее значение величин ¯ ¯¯ ¯ Z = 0 , стандартное отклонение σ z = 1 .
Недостатком стандартизированных Z -шкал является возможность присутствия в них отрицательных значений, что в некоторых случая противоречит логике анализа данных. Отрицательные значения могут исключаться путём дополнительных преобразований.
Упрощение стандартизации данных с помощью автоматизации
Современные компании в значительной степени полагаются на данные для управления процессами принятия решений. Однако низкая согласованность и качество данных могут привести к неточным выводам. Gartner, В отчете за 2018 год отмечается, что организации несут в среднем 15 миллионов долларов в год из-за низкого качества данных. Это существенное финансовое воздействие, которого можно избежать посредством стандартизации данных.
Что такое стандартизация данных?
Стандартизация данных — это процесс преобразования данных из различных источников в согласованный формат. Он включает в себя определение и внедрение общих стандартов и протоколов данных для сбора, хранения и обмена данными. Процесс стандартизации данных устанавливает руководящие принципы для элементов данных, таких как соглашения об именах, единицы измерения и категориальные значения, чтобы облегчить интеграцию и интерпретацию данных.
Типы несоответствий наборов данных
Ошибки набора данных могут возникать по разным причинам, влияя на качество и надежность данных. В таблице ниже показаны некоторые несоответствия наборов данных, которые можно устранить путем стандартизации данных.
| Форматы даты | Различные интерпретации дат (например, «01» и «02 st 23 февраля») |
| Числовые форматы | Разница в десятичных разделителях (например, «1,000.50» и «1000.50») |
| Единицы и измерения | Метрическая система против британской: неправильное использование единиц измерения (например, метры вместо футов). |
| Непоследовательное написание | Различные варианты написания одной и той же категории (например, «США» и «Соединенные Штаты»). |
| Варианты аббревиатур | Непоследовательные сокращения (например, «ул.» вместо «улица» вместо «ул.») |
| Чувствительность к регистру | Неправильная классификация из-за чувствительности к регистру (например, «яблоко» вместо «Яблоко») |
| Типы данных | Неподходящие типы данных для атрибутов (например, обработка чисел как строк). |
| Формат данных | Номера телефонов хранятся непоследовательно с разделителями и без них, например «+1 316-465-3322» и «3164653322». |
Важность стандартизации данных
Стандартизация данных обеспечивает согласованный обмен данными между различными системами. Это означает, что организации могут гарантировать, что все говорят на одном языке данных, стандартизируя данные в различных системах, отделах и внешних партнерах, обеспечивая целостное представление о деятельности компании, клиентах и рынках.
Такой подход способствует совместимости между различными системами и платформами. Когда данные стандартизированы, становится легче интегрировать и синхронизировать информацию в различных программных приложениях и базах данных. Выявлять и исправлять ошибки также становится проще, что снижает риск принятия решений на основе неверной или неполной информации.
Таким образом, стандартизация данных помогает улучшить качество данных, обеспечивая точный анализ, надежную отчетность и принятие обоснованных решений.
Процесс стандартизации данных
Процесс стандартизации данных включает в себя несколько этапов, которые преобразуют данные в согласованный формат, обеспечивающий точный анализ и интерпретацию.
1. Определение источников данных
Первым шагом в процессе стандартизации данных является идентификация всех источников данных, которые могут включать внутренние базы данных, внешних поставщиков данных и API. Это позволяет организациям получить представление о ландшафте данных и определить объем усилий по стандартизации. Они могут оценить надежность и точность данных, определить частоту добавления новой информации в набор данных и определить элементы данных, которые требуют стандартизации, среди других факторов.
2. Определение стандартов данных
Также важно определить правила и рекомендации для каждого элемента данных и обеспечить согласованность, достоверность и надежность данных. Эти стандарты могут включать форматы данных, допустимые значения, правила проверки и требования к преобразованию. Определение четких стандартов позволяет организациям гарантировать, что данные интерпретируются согласованно в различных системах и процессах.
3. Очистка данных
Очистка данных означает выявление и исправление ошибок в данных., несоответствия и неточности. Этот процесс включает в себя удаление повторяющихся записей, исправление орфографических ошибок и исправление отсутствующих или неполных данных. Очистка данных — это не разовая задача, а повторяющийся процесс, требующий постоянного мониторинга и обслуживания для обеспечения постоянной точности и качества данных.
4. Выполнение преобразования данных
Следующим шагом является преобразование данных в согласованный формат и структуру, чтобы все данные можно было легко сравнивать и анализировать. Сюда входят такие задачи, как изменение дат в стандартизированном формате или преобразование единиц измерения в общий стандарт. В процессе преобразования данных организациям также может потребоваться решить такие проблемы, как нормализация данных, когда данные масштабируются или корректируются для устранения избыточности и улучшения целостности данных.
5. Проверка данных
Следующим важным шагом является проверка данных путем запуска тестов и проверок данных, таких как проверка целостности данных, проверка на наличие выбросов или аномалий, а также проверка на соответствие заранее определенным правилам или ограничениям. Пользователи должны незамедлительно исправлять любые несоответствия или ошибки, выявленные в процессе проверки. Это может включать в себя пересмотр предыдущих этапов процесса стандартизации данных, таких как очистка или преобразование данных, чтобы обеспечить точность и надежность данных.
Традиционный метод стандартизации с использованием Excel
Ручная стандартизация с использованием Excel — один из наиболее распространенных методов стандартизации данных. Этот традиционный метод требует обширных вычислений и применения формул для проверки данных вручную.

Внимание : Функции «Z-тест» и «Стандартизация» выполняют стандартизацию данных в Excel.
Этот ручной подход к стандартизации данных требует вмешательства человека, внимания к деталям и опыта для преобразования и проверки данных. Аналитики должны тщательно проверять данные, чтобы обеспечить согласованность и точность, поэтому этот подход может занять много времени. Хотя этот метод полезен для небольших проектов, требующих более быстрого анализа небольших наборов данных, ручной характер процесса делает его менее эффективным при работе с большими объемами данных.
Автоматизированные инструменты самообслуживания: лучшая альтернатива
Другой современный подход к стандартизации данных — использование автоматизированных инструментов, которые используют алгоритмы машинного обучения и искусственный интеллект для очистки, преобразования и проверки данных. Программное обеспечение для автоматической стандартизации данных позволяет организациям автоматизировать применение стандартов данных. Эти инструменты могут идентифицировать элементы данных, применять заранее определенные правила и преобразования, а также автоматически очищать и преобразовывать данные. Использование этих инструментов помогает организациям сэкономить время и усилия в процессе стандартизации данных, обеспечивая согласованность и надежность данных.
В этой сравнительной таблице показаны преимущества инструментов автоматизированной стандартизации данных по сравнению с Excel:
| Автоматизированные инструменты | Excel | |
| Объем данных | Эффективен для больших и сложных наборов данных. | Подходит для небольших и средних наборов данных |
| Ручное усилие | Автоматизирует преобразование и очистку данных | Требует ручной обработки данных |
| Стандартизация | Предлагает передовые алгоритмы стандартизации | Ограниченные встроенные функции стандартизации |
| Масштабируемость | Хорошо масштабируется для обработки больших объемов данных. | Не масштабируется для обработки больших объемов данных. |
| Эффективность времени | Быстрая обработка данных, экономия времени | Занимает значительное количество времени для повторяющихся задач |
| Сложные преобразования | Легко справляется со сложными преобразованиями | Не подходит для сложных преобразований |
| Обработка ошибок | Встроенное обнаружение ошибок и отчетность | Ограниченное обнаружение и обработка ошибок |
| Контроль версий | Предлагает контроль версий для процессов обработки данных. | Не хватает надлежащих механизмов контроля версий. |
| Согласованность | Обеспечивает стабильные результаты каждый раз | Трудно обеспечить стабильные результаты неоднократно. |
. Astera для автоматизированной стандартизации данных
AsteraУнифицированная платформа управления данными компании имеет возможности автоматизированной стандартизации данных, включая строгие и гибкие функции очистки, преобразования и проверки данных. Интерфейс «укажи и щелкни» позволяет легко быстро исправить неполные или неточные данные, обеспечивая точность и согласованность данных.
Astera также предлагает динамическое представление сетки, которое позволяет пользователям исследовать, визуализировать, взаимодействовать и анализировать данные в режиме реального времени, обеспечивая мгновенную обратную связь о качестве данных. Вот пошаговое руководство о том, как пользователи могут использовать Astera для своих вариантов использования стандартизации данных:
1. Прочтите файл .csv в Astera Артефакт подготовки данных.

Раскройте истинный потенциал данных для более эффективной экосистемы данных и получения точной информации. Контакты Astera Сегодня или РЕГИСТРАЦИЯ бесплатно 14 день.
Другие статьи по теме
- 10 лучших инструментов управления API на 2024 год
- CRUD API: преимущества и методы обработки данных
- Создайте гибкое хранилище данных с помощью итеративного подхода
- Вызовы API и как они работают? Полное руководство
Умная нормализация данных
Во-первых, в подавляющем большинстве книг, интернет-ресурсов и уроков по Data Science нюансы, изъяны разных типов нормализации данных и их причины либо не рассматриваются вообще, либо упоминаются лишь мельком и без раскрытия сути.
Во-вторых, имеет место «слепое» использование, например, стандартизации для наборов с большим количеством признаков — “чтобы для всех одинаково”. Особенно у новичков (сам был таким же). На первый взгляд ничего страшного. Но при детальном рассмотрении может выясниться, что какие-то признаки были неосознанно поставлены в привилегированное положение и стали влиять на результат значительно сильнее, чем должны.
И, в-третьих, мне всегда хотелось получить универсальный метод учитывающий проблемные места.
Повторение — мать учения
Нормализация — это преобразование данных к неким безразмерным единицам. Иногда — в рамках заданного диапазона, например, [0..1] или [-1..1]. Иногда — с какими-то заданным свойством, как, например, стандартным отклонением равным 1.
Ключевая цель нормализации — приведение различных данных в самых разных единицах измерения и диапазонах значений к единому виду, который позволит сравнивать их между собой или использовать для расчёта схожести объектов. На практике это необходимо, например, для кластеризации и в некоторых алгоритмах машинного обучения.
Аналитически любая нормализация сводится к формуле
где — текущее значение,
— величина смещения значений,
— величина интервала, который будет преобразован к “единице”
По сути всё сводится к тому, что исходный набор значений сперва смещается, а потом масштабируется.
Минимакс (MinMax). Цель — преобразовать исходный набор в диапазон [0..1]. Для него:
= , минимальное значение исходных данных.
= — , т.е. за “единичный” интервал берется исходный диапазон значений.
Стандартизация. Цель — преобразовать исходный набор в новый со средним значением равным 0 и стандартным отклонением равным 1.
= , среднее значение исходных данных.
— равен стандартному отклонению исходного набора.
Для других методов всё аналогично, но со своими особенностями.
В большинстве методов кластеризации или, например, классификации методом ближайших соседей необходимо рассчитывать меру “близости” между различными объектами. Чаще всего в этой роли выступают различные вариации евклидового расстояния.
Представим, что у Вас есть какой-то набор данных с несколькими признаками. Признаки отличаются и по типу распределения, и по диапазону. Чтобы можно было с ними работать, сравнивать, их нужно нормализовать. Причём так, чтобы ни у какого из них не было преимуществ перед другими. По крайней мере, по умолчанию — любые такие предпочтения Вы должны задавать сами и осознанно. Не должно быть ситуации, когда алгоритм втайне от Вас сделал, например, цвет глаз менее важным, чем размер ушей*
* нужно сделать небольшое примечание — здесь речь идёт не о важности признака для, например, результата классификации (это определяется на основе самих данных при обучении модели), а о том, чтобы до начала обучения все признаки были равны по своему возможному влиянию.
Итого, главное условие правильной нормализации — все признаки должны быть равны в возможностях своего влияния.
Шаг 1 — определяем смещение
Чаще всего данные центрируют — т.е. определяют, значение, которое станет новым 0 и “сдвигают” данные относительно него.
Что лучше взять за центр? Некоего «типичного представителя» Ваших данных. Так при использовании стандартизации используется среднее арифметическое значение.
Здесь проявляется проблема № 1 — различные типы распределений не позволяют применять к ним методы, созданные для нормального распределения.
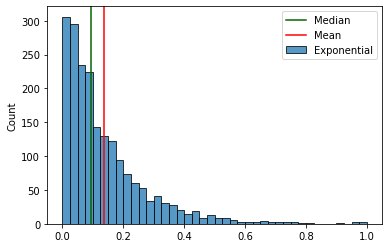
Если Вы спросите любого специалиста по статистике, какое значение лучше всего показывает “типичного представителя” совокупности, то он скажет, что это — медиана, а не среднее арифметическое. Последнее хорошо работает только в случае нормального распределения и совпадает с медианой (алгоритм стандартизации вообще оптимален именно для нормального распределения). А у Вас распределения разных признаков могут (и скорее всего будут) кардинально разные.
Вот, например, различия между медианой и средним арифметическим значением для экспоненциального распределения.
А вот так выглядят эти различия при добавлении выброса:
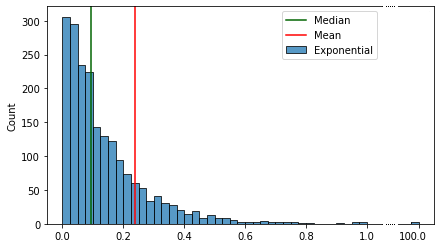
В отличии от среднего значения медиана практически не чувствительна к выбросам и асимметрии распределения. Поэтому её оптимально использовать как “нулевое” значение при центрировании.
В случае, когда нужно не центрировать, а вписать в заданный диапазон, смещением является минимальное значение данных. К этому вернёмся чуть позже.
Шаг 2 — масштабируем
Мы определили нужные величины смещения для всех признаков. Теперь нужно сделать признаки сравнимыми между собой.
Степень возможного влияния признаков определяется величиной их диапазонов после масштабирования. Если оба признака распределены в одинаковых интервалах, например, [-1..1], то и влиять они могут одинаково. Если же изначально один из признаков лежит в диапазоне [-1..1], а второй — в [-1..100], то очевидно, что изменения второго могут оказывать существенно большее влияние. А значит он будет в привилегированном положении по сравнению с первым.
Стандартное отклонение
Вернёмся к примеру стандартизации. В её случае новый диапазон определяется величиной стандартного отклонения. Чем оно меньше, тем диапазон станет “шире”.
Посмотрим на гипотетические распределения различных признаков с одинаковыми начальными диапазонами (так будет нагляднее):

Для второго признака (бимодальное распределение) стандартное отклонение будет больше, чем у первого.
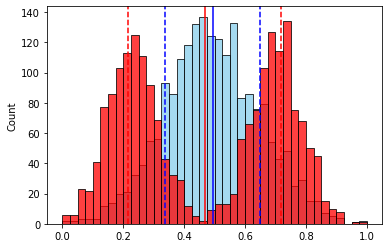
А это значит, что у второго признака новый диапазон после масштабирования (стандартизации) будет “уже”, и его влияние будет меньше по сравнению с первым.

Итог — стандартное отклонение не удовлетворяет начальным требованиям по одинаковому влиянию признаков (величине интервала). Даже не говоря о том, что и наличие выбросов может исказить “истинную” величину стандартного отклонения.
Межквартильный интервал
Другим часто используемым кандидатом является разница между 75-м и 25-м процентилями данных — межквартильный интервал. Т.е. интервал, в котором находятся “центральные” 50% данных набора. Эта величина уже устойчива к выбросам и не зависит от “нормальности” распределения наличия/отсутствия асимметрии.
Но и у неё есть свой серьезный недостаток — если у распределения признака есть значимый “хвост”, то после нормализации с использованием межквартильного интервала он добавит “значимости” этому признаку в сравнении с остальными.
Проблема № 2 — большие “хвосты” распределений признаков.
Пример — два признака с нормальным и экспоненциальным распределениями. Интервалы значений одинаковы
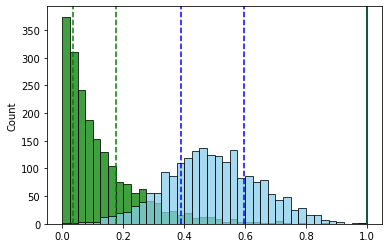
После нормализации с использованием межквартильного интервала (для наглядности оба интервала смещены к минимальным значениям равным нулю).

В итоге интервал у признака с экспоненциальным распределением из-за большого “хвоста” стал больше. А, следовательно, и сам признак стал “влиятельнее”.
Размах значений
Очевидным решением проблемы межквартильного интервала выглядит просто взять размах значений признака. Т.е. разницу между максимальным и минимальным значениями. В этом случае все новые диапазоны будут одинаковыми — равными 1.
И здесь максимально проявляется, наверное, самая частая проблема в подготовке данных, проблема № 3 — выбросы. Присутствие одного или нескольких аномальных (существенно удалённых) значений за пределами диапазона основных элементов набора может ощутимо повлиять на его среднее арифметическое значение и фиктивно увеличить его размах.
Это, пожалуй, самый наглядный пример из всех. К уже использовавшемуся выше набору из 2-х признаков добавим немного выбросов для одного признака
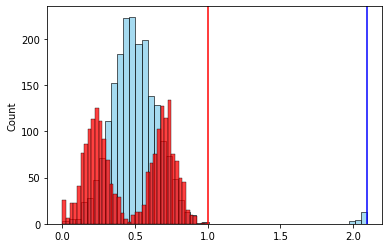
После нормализации по размаху
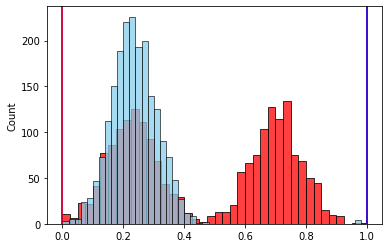
Наличие выброса, который вдвое увеличил размах признака, привело к такому же уменьшению значимого интервала его значений после нормализации. Следовательно влияние этого признака уменьшилось.
Работаем с выбросами
Решением проблемы влияния выбросов при использовании размаха является его замена на интервал, в котором будут располагаться “не-выбросы”. И дальше — масштабировать по этому интервалу.
Искать и удалять выбросы вручную — неблагодарное дело, особенно когда количество признаков ощутимо велико. А иногда выбросы и вовсе нельзя удалять, поскольку это приведёт к потере информации об исследуемых объектах. Вдруг, это не ошибка в данных, а некое аномальное явление, которое нужно зафиксировать на будущее, а не отбрасывать без изучения? Такая ситуация может возникнуть при кластеризации.
Пожалуй, самым массово применяемым методом автоматического определения выбросов является межквартильный метод. Его суть заключается в том, что выбросами “назначаются” данные, которые более чем в 1,5 межквартильных диапазонах (IQR) ниже первого квартиля или выше третьего квартиля.*
* — в некоторых случаях (очень большие выборки и др.) вместо 1,5 используют значение 3 — для определения только экстремальных выбросов.
Схематично метод изображен на рисунке снизу.
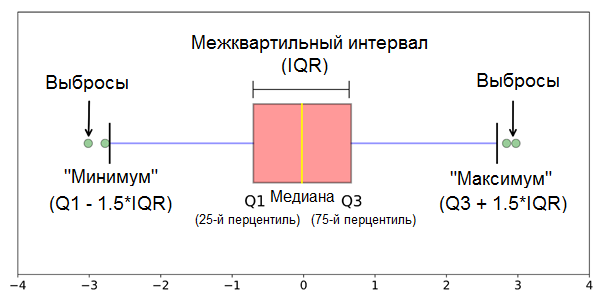
Вроде бы все отлично — наконец-то есть инструмент, и можно приступать к работе.
Но и здесь есть своя ложка дёгтя. В случае наличия длинных хвостов (как, например, при экспоненциальном распределении) слишком много данных попадают в такие “выбросы” — иногда достигая значений более 7%. Избирательное использование других коэффициентов (3 * IQR) опять приводит к необходимости ручного вмешательства — не для каждого признака есть такая необходимость. Их потребуется по отдельности изучать и подбирать коэффициенты. Т.е. универсальный инструмент опять не получается.
Ещё одной существенной проблемой является то, что этот метод симметричный. Полученный “интервал доверия” (1,5 * IQR) одинаков как для малых, так и для больших значений признака. Если распределение не симметричное, то многие аномалии-выбросы с “короткой” стороны просто будут скрыты этим интервалом.
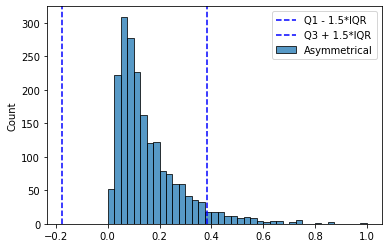
Скорректированный интервал
Красивое решение этих проблем предложили Миа Хаберт и Елена Вандервирен (Mia Hubert and Ellen Vandervieren) в 2007 г. в статье “An Adjusted Boxplot for Skewed Distributions”.
Их идея заключается в вычислении границ “интервал доверия” с учетом асимметрии распределения, но чтобы для симметричного случая он был равен всё тому же 1,5 * IQR.
Для определения некоего “коэффициента асимметрии” они использовали функцию medcouple (MC), которая определяется так:
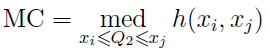
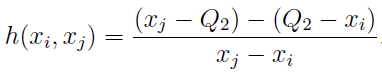
Поиск подходящей формулы для определения границ “интервала доверия” производился с целью сделать долю, приходящуюся на выбросы, не превышающей такую же, как у нормального распределения и 1,5 * IQR — приблизительно 0,7%
В конечном итоге они получили такой результат:

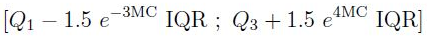
Более подробно про этот метод и его эффективность лучше прочитать в самой статье. Найти ее по названию не составляет труда.
Универсальный инструмент
Теперь, объединяя все найденные плюсы и учитывая проблемы, мы получаем оптимальное решение:
- Центрирование, если оно требуется, производить по медиане.
- Масштабировать набор данных по величине скорректированного интервала.
- (Опционально) — если центрирование не требуется, то смещать масштабированные данные так, чтобы границы скорректированного интервала приходились на [0..1]
Назовем его методом… скорректированного интервала — по названию статьи Mia Hubert и Ellen Vandervieren
Теперь сравним результаты обычных методов с новым. Для примера возьмем уже использовавшиеся выше три распределения с добавлением выбросов.
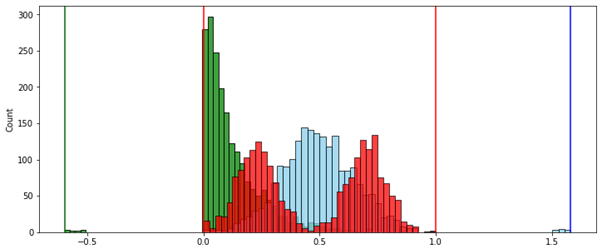
Сравнивать новый инструмент будем с методами стандартизации, робастной нормализации (межквартильный интервал) и минимакса (MinMax — с помощью размаха).
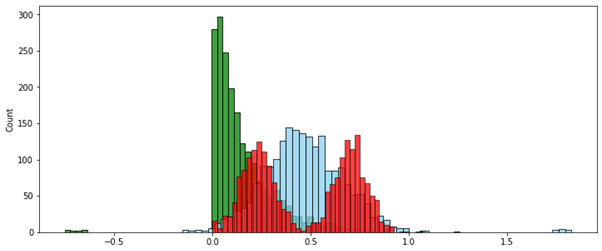
Ситуация № 1 — данные необходимо центрировать. Это используется в кластеризации и многих методах машинного обучения. Особенно, когда необходимо определять меру “близости” объектов.
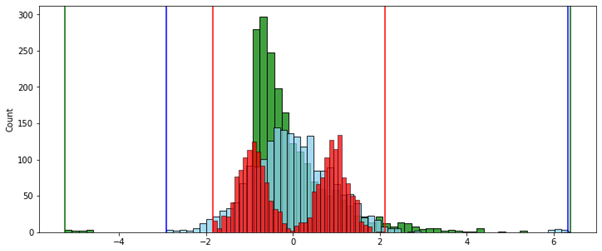
Робастная нормализация (по межквартильному интервалу):


Преимущество использования метода скорректированного интервала в том, что каждый из признаков равен по своему возможному влиянию — величина интервала, за пределами которого находятся выбросы, одинакова у каждого из них.
Ситуация № 2 — данные необходимо вписать в заданный интервал. Обычно это [0..1]. Это используется, например, при подготовке данных для входов нейронной сети.
MinMax (по размаху):
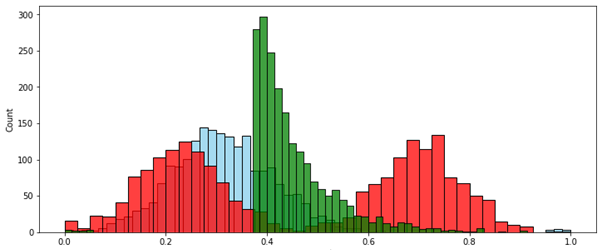
В этом случае метод скорректированного интервала вписал в нужный диапазон только значения без выбросов. Значения-выбросы, выходящие за границы этого диапазона, в зависимости от постановки задачи можно удалить или принудительно приравнять ближайшей границе нужного диапазона — т.е. 0 или 1.
То, что только “нормальные” данные попадают в единичный диапазон [0..1], а выбросы не удаляются, но пропорционально выносятся за его пределы — это крайне полезное свойство, которое сильно поможет при кластеризации объектов со смешанными признаками, как числовыми, так и категорийными. Подробно об этом я напишу в другой статье.
Напоследок, для возможности пощупать руками этот метод, Вы можете попробовать демонстрационный класс AdjustedScaler из моей библиотеки AdjDataTools.
Он не оптимизирован под работу с очень большим объемом данных и работает только с pandas DataFrame, но для пробы, экспериментов или даже заготовки под что-то более серьезное вполне подойдет. Пробуйте.
- Нормализация
- Стандартизация
- Data Science
- Центрирование
- Масштабирование
- Adjusted boxplot
- Python
- AdjustedScaler
- Python
- Алгоритмы
- Машинное обучение
- Искусственный интеллект
- Data Engineering