
Распознавание аудио перевести аудио в текст машинный перевод En – Ru
Мне нужно чтобы принималось аудио на языках en, ru и перевели в текст, но в моем коде не правильно перевели в текст аудио на en, как это исправить?
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26
# D:/Data Analysys Pr/golos/ import os import speech_recognition as sr # Создаем объект Recognizer r = sr.Recognizer() # Папка с аудиофайлами audio_folder = "D:/Data Analysys Pr/golos/" # Проходимся по всем файлам в папке и распознаем речь в каждом файле for filename in os.listdir(audio_folder): if filename.endswith(".wav") or filename.endswith(".mp3") or filename.endswith(".flac"): audio_file = os.path.join(audio_folder, filename) # Открываем файл и записываем аудио в объект AudioFile with sr.AudioFile(audio_file) as source: audio = r.record(source) # Пытаемся распознать речь с помощью Google Speech Recognition try: text = r.recognize_google(audio, language="ru-RU,en-US") print(f"Распознанный текст из файла :") print(text) except sr.UnknownValueError: print(f"Не удалось распознать речь в файле ")
94731 / 64177 / 26122
Регистрация: 12.04.2006
Сообщений: 116,782
Ответы с готовыми решениями:
Перевод аудио в текст
Всем привет, ребят. Нужно сделать веб-приложение, чтобы записывалось голосовое, и потом переводить.
Распознавание аудио
Здравствуйте, подскажите пожалуйста как распознать аудио в текст? Какие варианты есть? Мне знаком.
Распознавание текста с аудио
Добрый день, необходим алгоритм для распознавания числового кода из аудио дорожки: Он начинается.
Остановка аудио плеера при клике на другой аудио плеер
Всем привет. На сайт добавил такой вот плеерочек. На странице стоит много таких плееров и нужно.
Запись аудио файла используя распознавание речи
Возможно ли в андроид студио на котлине записывать речь когда человек начинает говорить до тех пор.
108 / 34 / 6
Регистрация: 15.05.2019
Сообщений: 126
В вашей программе нужно закинуть несколько файлов (английских и русских) в любом из трёх форматов. Я надиктовал несколько файлов на английском (две штуки) и русском, и с записью на электронных стандартных голосах (т.е. в файлах не мой голос, а движковые).
Потом закинул их в директорию (из которой их берёт Ваша программа) и запустил программу. Программа у Вас работает. Если Ваши файлы записаны также (движковыми голосами), то распознавание английского движка очень «жесткое» — т.е. мне пришлось перебрать несколько движков английского голоса, чтобы добиться распознавания английского.
(из массива я поставил, в конце концов, voices[0].id — это по-моему голос Microsoft Hazel. И он его распознал в только в одном английском файле из двух.
Если Ваши английские аудио файлы записаны живым голосом — например Вы сами записывали, то это значит только одно — у Вас очень плохое английское произношение — т.е. не носители английского языка поймут, а англичане (американцы или австралийцы) и машина spechrecognition — НЕТ.
Но программа у Вас рабочая.
ps: попробуйте найти несколько предложений в .mp3 из каких-то обучалок английского, где читают носители языка (для проверки).
108 / 34 / 6
Регистрация: 15.05.2019
Сообщений: 126
Мне даже стало интересно будет ли это так как я выше предположил.
Я скачал короткий файл в формате .wav — но видимо из-за кодека выдавало ошибку. Тогда я конвертировал этот же файл в формат .flac (on line).
Всё распознало (более менее — фразы всё же были длиннее на английском) — и мои начитки, и native. Т.е. в английских записях распознало не всё, но зато без ошибок.
108 / 34 / 6
Регистрация: 15.05.2019
Сообщений: 126
Понимаете, мне не только удалось (в отличие от всех остальных) сделать запись без ошибок и в файл с помощью speechrecogintion (кстати, я это сейчас использую в любой проге типа telegram, viber, skype, whatsup и любой другой без ограничений вообще. и без всяких там ботов — дикость какая. — я просто пишу в строку без всяких api . ), и с помощью offline pocketsphinx (с распознаванием почти 100% ) , но и получить ответы, но это другая история. .
108 / 34 / 6
Регистрация: 15.05.2019
Сообщений: 126
А вообще,
Мне удалось написать программу по распознаванию английской и русской речи на лету (не только на speechrecognition, no и на pocketsphinx, т.е. offline). А также, в соответствие с командой, включить что угодно (если это умный дом), или ответить на нужный вопрос (хотя с этим есть проблемы, т..к я не знаю где здесь создать вопрос по Artificial Intelligence. ) я не вижу подходящего раздела.
Я придумал удивительный (как мне кажется )))) ) алгоритм поведения и размышления (точнее наоборот). (типа — поля тетрадки не могут уместить этого доказательства). ))))))))))
ps: это благодаря Вашему посту. Поэтому я поставил Вам плюсик. ))))
pps: как говорят греки — не бывает глупых вопросов. Бывают только глупые ответы. )))
87844 / 49110 / 22898
Регистрация: 17.06.2006
Сообщений: 92,604
Помогаю со студенческими работами здесь

Английский язык. Прослушайте аудио и в доказательство правильности ответа, приведите слова из аудио
помогите пожалуйста, нужно доказать каждый вариант ответа(см. ниже на скрине) какими.
Английский язык. Прослушайте аудио и просто в доказательство правильности ответа, приведите слова из аудио
помогите пожалуйста, нужно доказать каждый вариант ответа(см. ниже на скрине) какими.
Аудио 3.5 и HDMI как единая аудио система
Есть колонки, с сабуфером подключенные через обычный 3.5 аудио. Есть телевизор (С двумя.
Перевести аудио поток
Вообщем ситуация такая есть mp3 файл по адресу к примеру.
Аудио в текст
Добрый день! Как сделать голосовой ввод текста с помощью MIcrosoft speech,например в textbox.
Переводим аудио в текст. Часть 2
Продолжаем мегапроект, в котором поставим себе на службу безразмерное облако Яндекса. Задача — воспользоваться облачным сервисом Яндекса, который отвечает за расшифровку текста из аудиофайла.
Вчера мы подготовили «Яндекс.Облако» и разобрались с технологиями, которые будем использовать. Теперь можно отправлять файлы на сервер и получать текст.
Технические детали
В проекте мы будем распознавать длинные аудио. Яндекс считает длинными записи от 30 секунд и больше одного мегабайта, но никто не мешает отправить на распознавание файл с меньшей длительностью записи. Так тоже можно.
Форматы аудио, которые понимает нейросеть Яндекса на момент написания статьи, — LPCM и OggOpus. Мы будем работать со вторым: он занимает меньше места и проще в обработке. MP3 пока не поддерживается.
Распознаётся только русская речь.
Готовим файл
Нам нужен файл в формате OggOpus и расширением .ogg. Если ваш диктофон, телефон или компьютер не умеют сохранять аудио в таком формате, используйте любой аудиоконвертер — онлайн-сервис или в виде программы на компьютере.
Например, это может работать так: находите в интернете любой сервис конвертации аудио, выбираете формат Opus (просто Ogg не пойдёт — не тот кодек) и сохраняете файл в этом формате. Затем меняете расширение на .ogg вместо .opus — и у вас получился файл нужного формата.
Если аудиозаписей пока никаких нет, используйте тестовый файл speech.ogg, потренируйтесь на нём.
Загружаем файл на сервер
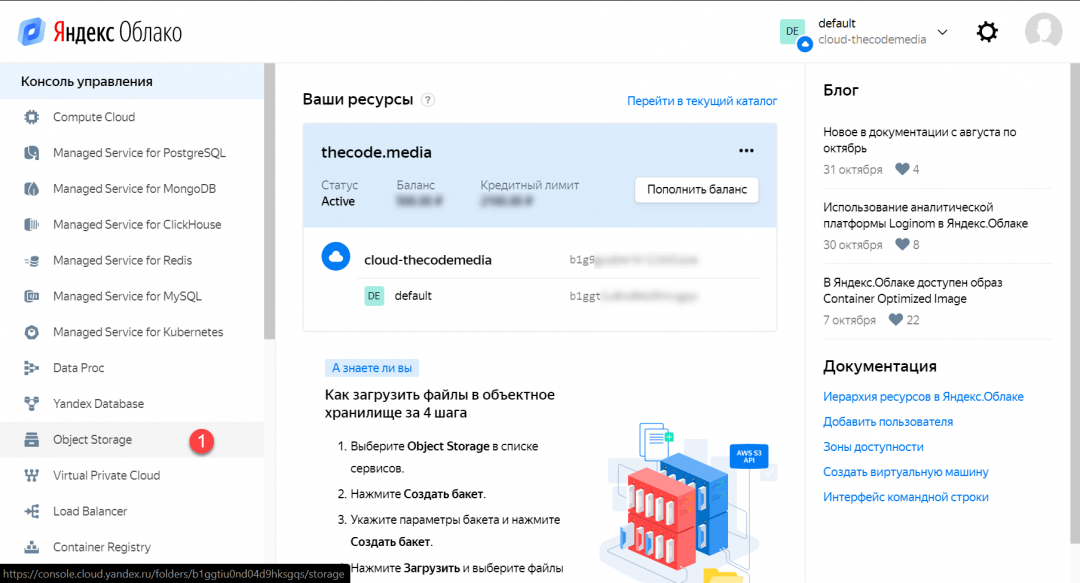
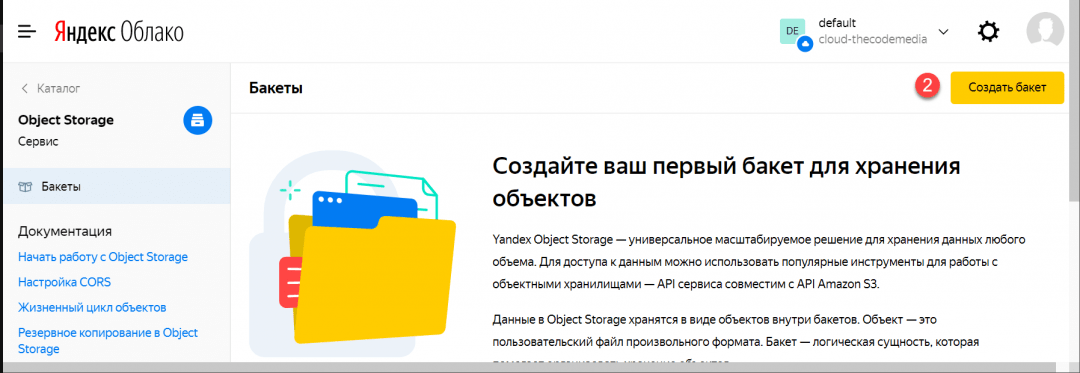
Теперь нужно готовый файл отправить в «Яндекс.Облако». Место, где хранятся файлы в облачном сервисе, называется «бакет» («ведро» по-нашему). Чтобы сделать новое ведро, заходим в консоль, переходим в раздел Object Storage и нажимаем «Создать бакет»:
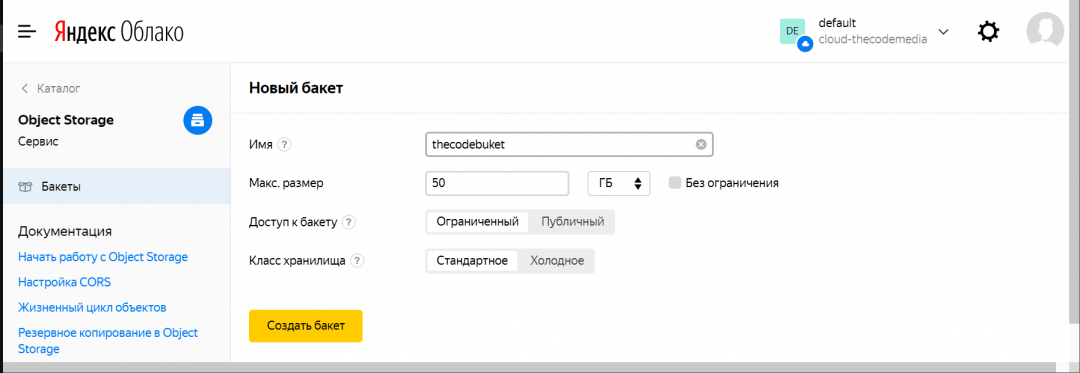
В появившемся окне придумываем имя и нажимаем «Создать бакет»:
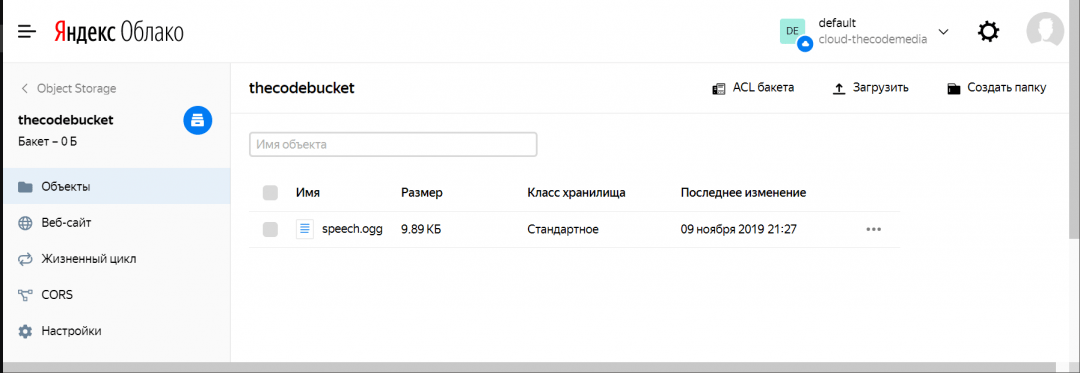
Нам нужно загрузить файл в этот бакет. Для этого заходим в него и перетаскиваем туда мышкой наш файл:
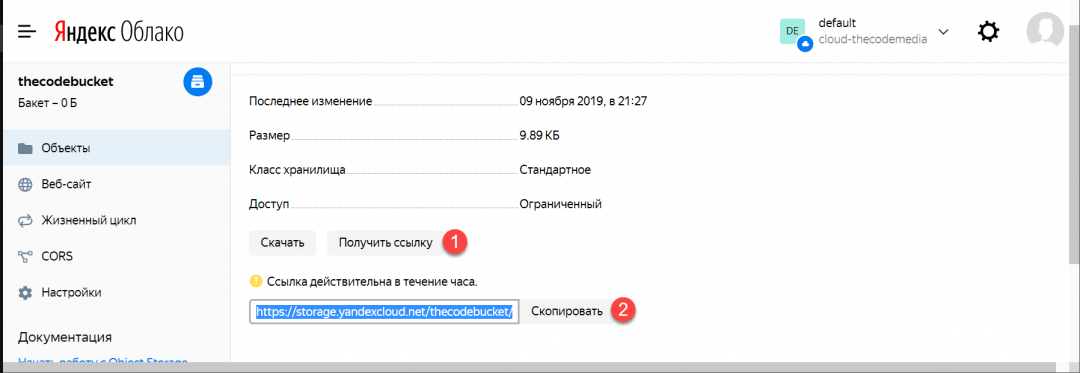
Последнее, что осталось, — узнать путь к файлу. Для этого нажимаем на сам файл, выбираем «Получить ссылку» и копируем её. Она нам пригодится на последнем этапе:
Добавляем нужные библиотеки в Python
Мы будем писать программу-обработчик на Python, поэтому перед началом убедитесь, что он есть у вас на компьютере.
Чтобы отправлять запросы на сервер и принимать в ответ готовый текст, нам нужна python-библиотека requests . Установим её из командной строки в PowerShell. Если у вас Мак — то через Терминал:
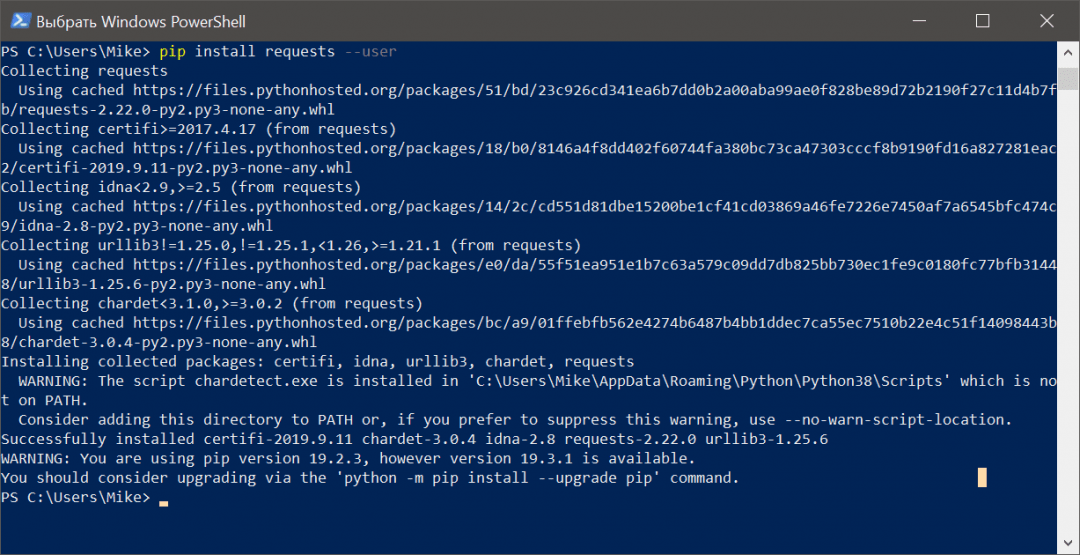
pip install requests —user
Пишем программу
К этому моменту у нас уже есть аудиофайл в нужном формате, он залит в хранилище, осталось только распознать его. Вот что нам для этого нужно:
- API-ключ → его мы получали в первой части.
- Путь к файлу в бакете → получили, когда заливали файл в хранилище.
Эти данные мы вставим в наш код на Python. Логика программы простая: подготавливаем все данные и отправляем запрос на распознавание. Пока сервер не ответит, что всё готово, ждём. Как только приходит ответ — выводим готовый текст на экран.
# -*- coding: utf-8 -*- # Подключаем нужные библиотеки import requests import time import json # Вставьте свой API-ключ key = 'AQVNsdKJKgeu[IUyRRERhjkOUiiu9Jo6' # Вставьте свой путь к файлу в бакете. Всё, что в ссылке стоит после знака вопроса, можно стереть — сервер всё равно это проигнорирует filelink = 'https://storage.yandexcloud.net/bucketname/speech.ogg' # Показываем «Облаку», что мы будем распознавать именно длинное аудио POST = "https://transcribe.api.cloud.yandex.net/speech/stt/v2/longRunningRecognize" # Формируем сам текст запроса body = < "config": < "specification": < "languageCode": "ru-RU" >>, "audio": < "uri": filelink >> # Формируем заголовок запроса, в котором ссылаемся на API-ключ header = '.format(key)> # Отправляем запрос на распознавание req = requests.post(POST, headers=header, json=body) # Получаем технический ответ от сервера и выводим его data = req.json() print(data) # Получаем идентификатор запроса id = data['id'] # Запрашиваем на сервере статус операции, пока распознавание не будет завершено while True: # Ждём одну секунду time.sleep(1) # Пытаемся получить ответ по нашему идентификатору запроса GET = "https://operation.api.cloud.yandex.net/operations/" req = requests.get(GET.format(id=id), headers=header) req = req.json() # Если готово — выходим из цикла if req['done']: break # Если не вышли из цикла — выводим сообщение print("Ещё не готово") # Выводим готовый текст print("Текст:") for chunk in req['response']['chunks']: print(chunk['alternatives'][0]['text'])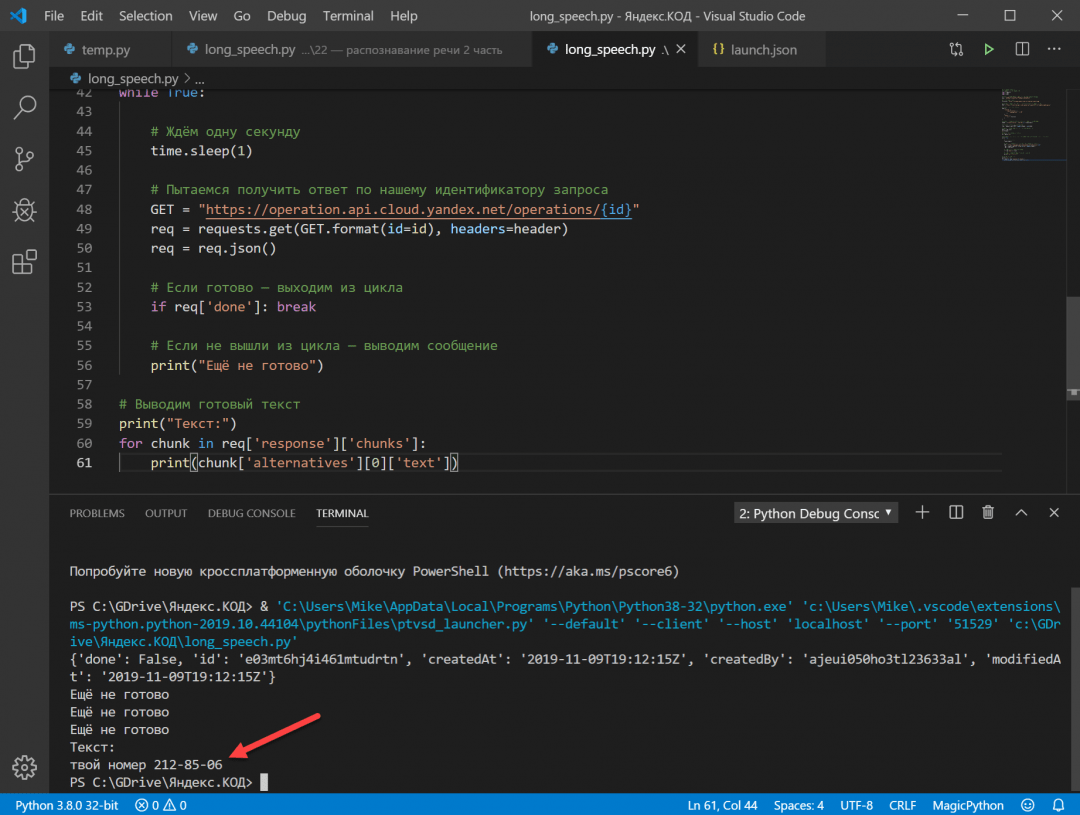
Что дальше
Дальше будем создавать аудиокниги и раскрывать весь потенциал движка SpeechKit. Ну и заодно будем программировать на Python 🙂
Любишь Python? Зарабатывай на нём!
Изучите самый модный язык программирования и станьте крутым бэкенд-разработчиком. Старт — бесплатно.
Получите ИТ-профессию
В «Яндекс Практикуме» можно стать разработчиком, тестировщиком, аналитиком и менеджером цифровых продуктов. Первая часть обучения всегда бесплатная, чтобы попробовать и найти то, что вам по душе. Дальше — программы трудоустройства.
Как находить слова у аудио через python

Далее необходимо поставить зависимости для Python:
apt install python3-pip pip3 install ffmpeg pip3 install pydub pip3 install vosk pip3 install torch pip3 install transformers Также скачиваем и распаковываем модель для распознавания русской речи, выполнив команды:
curl -o ./model.zip https://alphacephei.com/vosk/models/vosk-model-ru-0.22.zip unzip model.zip mv vosk-model-ru-0.22/ model rm -rf model.zip В результате этих действий мы скопировали к себе модель, разархивировали ее и переименовали директорию. Также удалили скачанный архив. Всё-таки он весит 1.5 Гб. Для расстановки пунктуации делаем похожие действия: скачиваем еще одну модель весом 1.5 Гб.
curl -o recasepunc.zip https://alphacephei.com/vosk/models/vosk-recasepunc-ru-0.22.zip unzip recasepunc.zip mv vosk-recasepunc-ru-0.22/ recasepunc rm -rf recasepunc.zip Код файла app.py , который выполняет перевод аудио в текст.
from vosk import Model, KaldiRecognizer, SetLogLevel from pydub import AudioSegment import subprocess import json import os SetLogLevel(0) # Проверяем наличие модели if not os.path.exists("model"): print ("Please download the model from https://alphacephei.com/vosk/models and unpack as 'model' in the current folder.") exit (1) # Устанавливаем Frame Rate FRAME_RATE = 16000 CHANNELS=1 model = Model("model") rec = KaldiRecognizer(model, FRAME_RATE) rec.SetWords(True) # Используя библиотеку pydub делаем предобработку аудио mp3 = AudioSegment.from_mp3('Song.mp3') mp3 = mp3.set_channels(CHANNELS) mp3 = mp3.set_frame_rate(FRAME_RATE) # Преобразуем вывод в json rec.AcceptWaveform(mp3.raw_data) result = rec.Result() text = json.loads(result)["text"] # Добавляем пунктуацию cased = subprocess.check_output('python3 recasepunc/recasepunc.py predict recasepunc/checkpoint', shell=True, text=True, input=text) # Записываем результат в файл "data.txt" with open('data.txt', 'w') as f: json.dump(cased, f, ensure_ascii=False, indent=4) Последний штрих – разместить файл Song.mp3 в нашей директории с исполняемым файлом app.py . Затем запускаем app.py . В результате наша программа обработает файл .mp3 и на основе натренированных моделей из библиотеки Vosk сделает транскрибацию аудио в текст с сохранением результата в файл data.txt .
Наша реализация решает поставленные задачи в начале статьи. Но это скорее MVP, чем продуманное решение для продакшена. Если мы начнем углубляться, то перед нами встанут задачи обработки больших аудио (от часа и более), организации многопоточности, балансировки и горизонтального масштабирования и много чего интересного. Библиотека VOSK позволяет со всем этим справиться. Но это уже другая история 🙂
Материалы по теме
- �� NLP и визуализация текста на примере твитов о президентских выборах в США
- �� Практическое руководство по NLP: изучаем классификацию текстов с помощью библиотеки fastText
- Обзор четырёх популярных NLP-моделей �� ��
- NLP – это весело! Обработка естественного языка на Python
Пишем голосового ассистента на Python
Технологии в области машинного обучения за последний год развиваются с потрясающей скоростью. Всё больше компаний делятся своими наработками, тем самым открывая новые возможности для создания умных цифровых помощников.
В рамках данной статьи я хочу поделиться своим опытом реализации голосового ассистента и предложить вам несколько идей для того, чтобы сделать его ещё умнее и полезнее.
Что умеет мой голосовой ассистент?
| Описание умения | Работа в offline-режиме | Требуемые зависимости |
| Распознавать и синтезировать речь | Поддерживается | pip install PyAudio (использование микрофона) |
pip install pyttsx3 (синтез речи)
Для распознавания речи можно выбрать одну или взять обе:
- pip install SpeechRecognition (высокое качество online-распознавания, множество языков)
- pip install vosk (высокое качество offline-распознавания, меньше языков)
Шаг 1. Обработка голосового ввода
Начнём с того, что научимся обрабатывать голосовой ввод. Нам потребуется микрофон и пара установленных библиотек: PyAudio и SpeechRecognition.
Подготовим основные инструменты для распознавания речи:
import speech_recognition if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи voice_input = record_and_recognize_audio() print(voice_input) Теперь создадим функцию для записи и распознавания речи. Для онлайн-распознавания нам потребуется Google, поскольку он имеет высокое качество распознавания на большом количестве языков.
def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит выброс ошибки except speech_recognition.RequestError: print("Check your Internet Connection, please") return recognized_data А что делать, если нет доступа в Интернет? Можно воспользоваться решениями для offline-распознавания. Мне лично безумно понравился проект Vosk.
На самом деле, необязательно внедрять offline-вариант, если он вам не нужен. Мне просто хотелось показать оба способа в рамках статьи, а вы уже выбирайте, исходя из своих требований к системе (например, по количеству доступных языков распознавания бесспорно лидирует Google).
Теперь, внедрив offline-решение и добавив в проект нужные языковые модели, при отсутствии доступа к сети у нас автоматически будет выполняться переключение на offline-распознавание.
Замечу, что для того, чтобы не нужно было два раза повторять одну и ту же фразу, я решила записывать аудио с микрофона во временный wav-файл, который будет удаляться после каждого распознавания.
Таким образом, полученный код выглядит следующим образом:
Полный код для работы распознавания речи
from vosk import Model, KaldiRecognizer # оффлайн-распознавание от Vosk import speech_recognition # распознавание пользовательской речи (Speech-To-Text) import wave # создание и чтение аудиофайлов формата wav import json # работа с json-файлами и json-строками import os # работа с файловой системой def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) with open("microphone-results.wav", "wb") as file: file.write(audio.get_wav_data()) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит попытка # использовать offline-распознавание через Vosk except speech_recognition.RequestError: print("Trying to use offline recognition. ") recognized_data = use_offline_recognition() return recognized_data def use_offline_recognition(): """ Переключение на оффлайн-распознавание речи :return: распознанная фраза """ recognized_data = "" try: # проверка наличия модели на нужном языке в каталоге приложения if not os.path.exists("models/vosk-model-small-ru-0.4"): print("Please download the model from:\n" "https://alphacephei.com/vosk/models and unpack as 'model' in the current folder.") exit(1) # анализ записанного в микрофон аудио (чтобы избежать повторов фразы) wave_audio_file = wave.open("microphone-results.wav", "rb") model = Model("models/vosk-model-small-ru-0.4") offline_recognizer = KaldiRecognizer(model, wave_audio_file.getframerate()) data = wave_audio_file.readframes(wave_audio_file.getnframes()) if len(data) > 0: if offline_recognizer.AcceptWaveform(data): recognized_data = offline_recognizer.Result() # получение данных распознанного текста из JSON-строки # (чтобы можно было выдать по ней ответ) recognized_data = json.loads(recognized_data) recognized_data = recognized_data["text"] except: print("Sorry, speech service is unavailable. Try again later") return recognized_data if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) Возможно, вы спросите «А зачем поддерживать offline-возможности?»
Я считаю, что всегда стоит учитывать, что пользователь может быть отрезан от сети. В таком случае, голосовой ассистент всё еще может быть полезным, если использовать его как разговорного бота или для решения ряда простых задач, например, посчитать что-то, порекомендовать фильм, помочь сделать выбор кухни, сыграть в игру и т.д.
Шаг 2. Конфигурация голосового ассистента
Поскольку наш голосовой ассистент может иметь пол, язык речи, ну и по классике, имя, то давайте выделим под эти данные отдельный класс, с которым будем работать в дальнейшем.
Для того, чтобы задать нашему ассистенту голос, мы воспользуемся библиотекой для offline-синтеза речи pyttsx3. Она автоматически найдет голоса, доступные для синтеза на нашем компьютере в зависимости от настроек операционной системы (поэтому, возможно, что у вас могут быть доступны другие голоса и вам нужны будут другие индексы).
Также добавим в в main-функцию инициализацию синтеза речи и отдельную функцию для её проигрывания. Чтобы убедиться, что всё работает, сделаем небольшую проверку на то, что пользователь с нами поздоровался, и выдадим ему обратное приветствие от ассистента:
Полный код основы голосового ассистента (синтез и распознавание речи)
from vosk import Model, KaldiRecognizer # оффлайн-распознавание от Vosk import speech_recognition # распознавание пользовательской речи (Speech-To-Text) import pyttsx3 # синтез речи (Text-To-Speech) import wave # создание и чтение аудиофайлов формата wav import json # работа с json-файлами и json-строками import os # работа с файловой системой class VoiceAssistant: """ Настройки голосового ассистента, включающие имя, пол, язык речи """ name = "" sex = "" speech_language = "" recognition_language = "" def setup_assistant_voice(): """ Установка голоса по умолчанию (индекс может меняться в зависимости от настроек операционной системы) """ voices = ttsEngine.getProperty("voices") if assistant.speech_language == "en": assistant.recognition_language = "en-US" if assistant.sex == "female": # Microsoft Zira Desktop - English (United States) ttsEngine.setProperty("voice", voices[1].id) else: # Microsoft David Desktop - English (United States) ttsEngine.setProperty("voice", voices[2].id) else: assistant.recognition_language = "ru-RU" # Microsoft Irina Desktop - Russian ttsEngine.setProperty("voice", voices[0].id) def play_voice_assistant_speech(text_to_speech): """ Проигрывание речи ответов голосового ассистента (без сохранения аудио) :param text_to_speech: текст, который нужно преобразовать в речь """ ttsEngine.say(str(text_to_speech)) ttsEngine.runAndWait() def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) with open("microphone-results.wav", "wb") as file: file.write(audio.get_wav_data()) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google # (высокое качество распознавания) try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит # попытка использовать offline-распознавание через Vosk except speech_recognition.RequestError: print("Trying to use offline recognition. ") recognized_data = use_offline_recognition() return recognized_data def use_offline_recognition(): """ Переключение на оффлайн-распознавание речи :return: распознанная фраза """ recognized_data = "" try: # проверка наличия модели на нужном языке в каталоге приложения if not os.path.exists("models/vosk-model-small-ru-0.4"): print("Please download the model from:\n" "https://alphacephei.com/vosk/models and unpack as 'model' in the current folder.") exit(1) # анализ записанного в микрофон аудио (чтобы избежать повторов фразы) wave_audio_file = wave.open("microphone-results.wav", "rb") model = Model("models/vosk-model-small-ru-0.4") offline_recognizer = KaldiRecognizer(model, wave_audio_file.getframerate()) data = wave_audio_file.readframes(wave_audio_file.getnframes()) if len(data) > 0: if offline_recognizer.AcceptWaveform(data): recognized_data = offline_recognizer.Result() # получение данных распознанного текста из JSON-строки # (чтобы можно было выдать по ней ответ) recognized_data = json.loads(recognized_data) recognized_data = recognized_data["text"] except: print("Sorry, speech service is unavailable. Try again later") return recognized_data if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() # инициализация инструмента синтеза речи ttsEngine = pyttsx3.init() # настройка данных голосового помощника assistant = VoiceAssistant() assistant.name = "Alice" assistant.sex = "female" assistant.speech_language = "ru" # установка голоса по умолчанию setup_assistant_voice() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) # отделение комманд от дополнительной информации (аргументов) voice_input = voice_input.split(" ") command = voice_input[0] if command == "привет": play_voice_assistant_speech("Здравствуй") На самом деле, здесь бы хотелось самостоятельно научиться писать синтезатор речи, однако моих знаний здесь не будет достаточно. Если вы можете подсказать хорошую литературу, курс или интересное документированное решение, которое поможет разобраться в этой теме глубоко — пожалуйста, напишите в комментариях.
Шаг 3. Обработка команд
Теперь, когда мы «научились» распознавать и синтезировать речь с помощью просто божественных разработок наших коллег, можно начать изобретать свой велосипед для обработки речевых команд пользователя 😀
В моём случае я использую мультиязычные варианты хранения команд, поскольку у меня в демонстрационном проекте не так много событий, и меня устраивает точность определения той или иной команды. Однако, для больших проектов я рекомендую разделить конфигурации по языкам.
Для хранения команд я могу предложить два способа.
1 способ
Можно использовать прекрасный JSON-подобный объект, в котором хранить намерения, сценарии развития, ответы при неудавшихся попытках (такие часто используются для чат-ботов). Выглядит это примерно вот так:
config = < "intents": < "greeting": < "examples": ["привет", "здравствуй", "добрый день", "hello", "good morning"], "responses": play_greetings >, "farewell": < "examples": ["пока", "до свидания", "увидимся", "до встречи", "goodbye", "bye", "see you soon"], "responses": play_farewell_and_quit >, "google_search": < "examples": ["найди в гугл", "search on google", "google", "find on google"], "responses": search_for_term_on_google >, >, "failure_phrases": play_failure_phrase > Такой вариант подойдёт тем, кто хочет натренировать ассистента на то, чтобы он отвечал на сложные фразы. Более того, здесь можно применить NLU-подход и создать возможность предугадывать намерение пользователя, сверяя их с теми, что уже есть в конфигурации.
Подробно этот способ мы его рассмотрим на 5 шаге данной статьи. А пока обращу ваше внимание на более простой вариант
2 способ
Можно взять упрощенный словарь, у которого в качестве ключей будет hashable-тип tuple (поскольку словари используют хэши для быстрого хранения и извлечения элементов), а в виде значений будут названия функций, которые будут выполняться. Для коротких команд подойдёт вот такой вариант:
commands =
Для его обработки нам потребуется дополнить код следующим образом:
def execute_command_with_name(command_name: str, *args: list): """ Выполнение заданной пользователем команды с дополнительными аргументами :param command_name: название команды :param args: аргументы, которые будут переданы в функцию :return: """ for key in commands.keys(): if command_name in key: commands[key](*args) else: pass # print("Command not found") if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) # отделение комманд от дополнительной информации (аргументов) voice_input = voice_input.split(" ") command = voice_input[0] command_options = [str(input_part) for input_part in voice_input[1:len(voice_input)]] execute_command_with_name(command, command_options) В функции будут передаваться дополнительные аргументы, сказанные после командного слова. То есть, если сказать фразу «видео милые котики«, команда «видео» вызовет функцию search_for_video_on_youtube() с аргументом «милые котики» и выдаст вот такой результат:
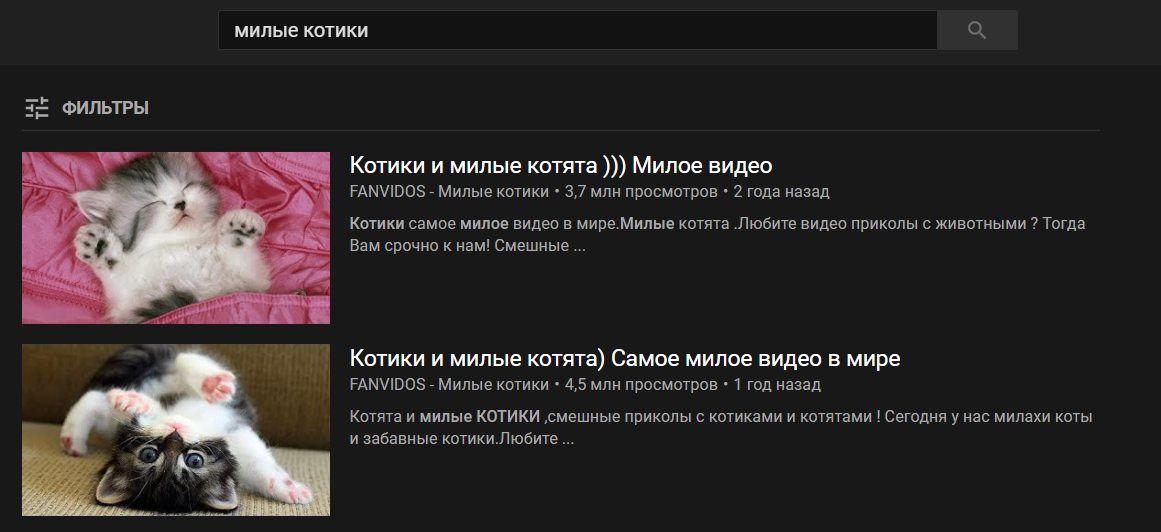
Пример такой функции с обработкой входящих аргументов:
def search_for_video_on_youtube(*args: tuple): """ Поиск видео на YouTube с автоматическим открытием ссылки на список результатов :param args: фраза поискового запроса """ if not args[0]: return search_term = " ".join(args[0]) url = "https://www.youtube.com/results?search_query=" + search_term webbrowser.get().open(url) # для мультиязычных голосовых ассистентов лучше создать # отдельный класс, который будет брать перевод из JSON-файла play_voice_assistant_speech("Here is what I found for " + search_term + "on youtube") Ну вот и всё! Основной функционал бота готов. Далее вы можете до бесконечности улучшать его различными способами. Моя реализация с подробными комментариями доступна на моём GitHub.
Ниже мы рассмотрим ряд улучшений, чтобы сделать нашего ассистента ещё умнее.
Шаг 4. Добавление мультиязычности
Чтобы научить нашего ассистента работать с несколькими языковыми моделями, будет удобнее всего организовать небольшой JSON-файл с простой структурой:
< "Can you check if your microphone is on, please?": < "ru": "Пожалуйста, проверь, что микрофон включен", "en": "Can you check if your microphone is on, please?" >, "What did you say again?": < "ru": "Пожалуйста, повтори", "en": "What did you say again?" >, > В моём случае я использую переключение между русским и английским языком, поскольку мне для этого доступны модели для распознавания речи и голоса для синтеза речи. Язык будет выбран в зависимости от языка речи самого голосового ассистента.
Для того, чтобы получать перевод мы можем создать отдельный класс с методом, который будет возвращать нам строку с переводом:
class Translation: """ Получение вшитого в приложение перевода строк для создания мультиязычного ассистента """ with open("translations.json", "r", encoding="UTF-8") as file: translations = json.load(file) def get(self, text: str): """ Получение перевода строки из файла на нужный язык (по его коду) :param text: текст, который требуется перевести :return: вшитый в приложение перевод текста """ if text in self.translations: return self.translations[text][assistant.speech_language] else: # в случае отсутствия перевода происходит вывод сообщения # об этом в логах и возврат исходного текста print(colored("Not translated phrase: <>".format(text), "red")) return text В main-функции до цикла объявим наш переводчик таким образом: translator = Translation()
Теперь при проигрывании речи ассистента мы сможем получить перевод следующим образом:
play_voice_assistant_speech(translator.get( "Here is what I found for <> on Wikipedia").format(search_term)) Как видно из примера выше, это работает даже для тех строк, которые требуют вставки дополнительных аргументов. Таким образом можно переводить «стандартные» наборы фраз для ваших ассистентов.
Шаг 5. Немного машинного обучения
А теперь вернёмся к характерному для большинства чат-ботов варианту с JSON-объектом для хранения команд из нескольких слов, о котором я упоминала в пункте 3. Он подойдёт для тех, кто не хочет использовать строгие команды и планирует расширить понимание намерений пользователя, используя NLU-методы.
Грубо говоря, в таком случае фразы «добрый день«, «добрый вечер» и «доброе утро» будут считаться равнозначными. Ассистент будет понимать, что во всех трёх случаях намерением пользователя было поприветствовать своего голосового помощника.
С помощью данного способа вы также сможете создать разговорного бота для чатов либо разговорный режим для вашего голосового ассистента (на случаи, когда вам нужен будет собеседник).
Для реализации такой возможности нам нужно будет добавить пару функций:
def prepare_corpus(): """ Подготовка модели для угадывания намерения пользователя """ corpus = [] target_vector = [] for intent_name, intent_data in config["intents"].items(): for example in intent_data["examples"]: corpus.append(example) target_vector.append(intent_name) training_vector = vectorizer.fit_transform(corpus) classifier_probability.fit(training_vector, target_vector) classifier.fit(training_vector, target_vector) def get_intent(request): """ Получение наиболее вероятного намерения в зависимости от запроса пользователя :param request: запрос пользователя :return: наиболее вероятное намерение """ best_intent = classifier.predict(vectorizer.transform([request]))[0] index_of_best_intent = list(classifier_probability.classes_).index(best_intent) probabilities = classifier_probability.predict_proba(vectorizer.transform([request]))[0] best_intent_probability = probabilities[index_of_best_intent] # при добавлении новых намерений стоит уменьшать этот показатель if best_intent_probability > 0.57: return best_intent А также немного модифицировать main-функцию, добавив инициализацию переменных для подготовки модели и изменив цикл на версию, соответствующую новой конфигурации:
# подготовка корпуса для распознавания запросов пользователя с некоторой вероятностью # (поиск похожих) vectorizer = TfidfVectorizer(analyzer="char", ngram_range=(2, 3)) classifier_probability = LogisticRegression() classifier = LinearSVC() prepare_corpus() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() if os.path.exists("microphone-results.wav"): os.remove("microphone-results.wav") print(colored(voice_input, "blue")) # отделение команд от дополнительной информации (аргументов) if voice_input: voice_input_parts = voice_input.split(" ") # если было сказано одно слово - выполняем команду сразу # без дополнительных аргументов if len(voice_input_parts) == 1: intent = get_intent(voice_input) if intent: config["intents"][intent]["responses"]() else: config["failure_phrases"]() # в случае длинной фразы - выполняется поиск ключевой фразы # и аргументов через каждое слово, # пока не будет найдено совпадение if len(voice_input_parts) > 1: for guess in range(len(voice_input_parts)): intent = get_intent((" ".join(voice_input_parts[0:guess])).strip()) if intent: command_options = [voice_input_parts[guess:len(voice_input_parts)]] config["intents"][intent]["responses"](*command_options) break if not intent and guess == len(voice_input_parts)-1: config["failure_phrases"]() Однако, такой способ сложнее контролировать: он требует постоянной проверки того, что та или иная фраза всё ещё верно определяется системой как часть того или иного намерения. Поэтому данным способом стоит пользоваться с аккуратностью (либо экспериментировать с самой моделью).
Заключение
На этом мой небольшой туториал подошёл к концу.
Мне будет приятно, если вы поделитесь со мной в комментариях известными вам open-source решениями, которые можно внедрить в данный проект, а также вашими идеями касательно того, какие ещё online и offline-функции можно реализовать.
Документированные исходники моего голосового ассистента в двух вариантах можно найти здесь.
P.S: решение работает на Windows, Linux и MacOS с незначительными различиями при установке библиотек PyAudio и Google.
Кстати, тех, кто планирует строить карьеру в IT, я буду рада видеть на своём YouTube-канале IT DIVA. Там вы сможете найти видео по тому, как оформлять GitHub, проходить собеседования, получать повышение, справляться с профессиональным выгоранием, управлять разработкой и т.д.
- голосовой ассистент
- python
- offline
- мультиязычный
- natural language understanding