
CHAR или VARCHAR? А может быть BLOB?
На диске запись всегда упаковывается. То есть, концевые пробелы не имеют никакого значения с точки зрения дискового пространства.
Количество концевых пробелов учитывается только для varchar. Значение char «добивается» пробелами до объявленной длины только тогда, когда с ним производятся операции присвоения или передача данных на сторону клиента.
Поэтому с точки зрения эффективности хранения различия между char и varchar практически нет. И для работы нужно выбирать то, что удобнее. Как правило это varchar.
Клиентские компоненты могут (или не могут) осуществлять обрезание концевых пробелов для столбцов CHAR. В зависимости от склонностей разработчика такого набора обрезание пробелов может быть по умолчанию, а может и потребовать установки в True какого-либо свойства или на уровне DataSet, или на уровне конкретного поля (TStringField). Поэтому, если вас замучили концевые пробелы в строках, посмотрите на свойства компонент.
Нужно отметить, что ни BDE ни dbExpress не могут выполнять обрезание концевых пробелов у строк.
Поля типа BLOB
Поля этого типа позволяют хранить безразмерную произвольную двоичную информацию (поэтому поля типа BLOB не имеют свойства «набор символов»). Запись на диск производится сегментами. Дисковый сегмент блоба это вовсе не то, что имеется в виду при объявлении столбца BLOB (SEGMENT SIZE xx). Сервер сам разбирается, как хранить конкретное значение blob на диске. Указание размера сегмента при объявлении столбца BLOB не даст никакого выигрыша или проигрыша в производительности. Оно нужно только для приложений, написанных на C (Embedded SQL) при помощи GPRE. Например, в IBX размер буфера для чтения-записи blob определен жестко в 16К, и именно такими «сегментами» оперирует IBX. Поэтому определять размер сегмента при объявлении blob не имеет смысла.
Существуют предопределенные подтипы (SUB_TYPE) BLOB: 0 – двоичные данные, 1 – текстовые данные. На самом деле разницы между ними нет, и подтип имеет значение только для вашего приложения (или при написании фильтров BLOB). Пользовательские подтипы можно определить, указав SUB_TYPE с отрицательным знаком – -1, -2, -10, -200 и т. д., и опять же это имеет значение только для приложения, работающего с данными или для фильтра.
Сегменты BLOB всегда записываются на свободное пространство, и занимают только действительный объем данных BLOB.
Если размер BLOB превышает размер страницы, то создается массив указателей на страницы BLOB. При очень больших размерах BLOB могут появиться указатели на страницы указателей BLOB.
При изменении записи, если содержимое blob не менялось, его blobID остается тем же самым. Собственно, в новой версии записи пишутся только те поля, которые были изменены. Следовательно, при модификации записи, если не затронуто поле BLOB, данные blob не «дублируются». Если же блоб меняется, то как и версия записи, он находится на диске в двух экземплярах – старом и новом. Учитывайте это для блобов, хранящих большой объем данных.
Примечание. Индексировать по полям BLOB невозможно.
CHAR или BLOB?
- Если длина поля < 255 символов, то
- лучше использовать VARCHAR – по хранению varchar на 2 байта больше char, зато в приложениях не надо писать отрезание концевых пробелов у строк.
- в старых версиях IB при использовании VARCHAR могут возникнуть проблемы с производительностью при использовании протокола TCP/IP.
- не имеет смысла использовать BLOB – выборка BLOB осуществляется по его идентификатору, поэтому происходит чуть дольше и требует немного больше затрат на программирование.
- Можно использовать как CHAR или VARCHAR, так и BLOB. Индексирование по полями такой длины невозможно, к тому же есть шанс что однажды записываемые данные превысят 10000 символов, и может быть BLOB подойдет больше. Ориентируйтесь только на удобство работы с такими данными в приложении.
- лучше использовать BLOB. Подтип может быть любой, информацию в таком поле можно хранить произвольную и не беспокоиться о размере данных. Стоимость доступа к данным такого размера полностью компенсирует разницу в способах хранения и извлечения полей типа CHAR и BLOB.
Конвертация данных
В Firebird и Yaffil, в 3-м диалекте появилась возможность при insert (update?) содержимое блоба задавать обычной строкой. В остальных серверах при подобных действиях будет выдано стандартное сообщение о невозможности конвертации данных.
Вместе с тем уже давно существуют UDF перевода блоба в строку и обратно (FreeUDFLib и другие).
Возможные проблемы
Индексирование
- Строковые независимо от типа поля имеют ограничение на длину индекса – 84 байта при указании COLLATE и 252 байта – без COLLATE.
- BLOB-поля не могут быть проиндексированы.
Поиск
- Для поиска по полям типа CHAR, VARCHAR и BLOB можно использовать операторы STARTING WITH (начинается с), LIKE (начинается, содержит, или заканчивается на) и CONTAINING (содержит). В BLOB этими операторами можно искать произвольную информацию (необязательно текстовую), однако необходимо учитывать что поиск в BLOB может осуществляться только перебором записей.
- Если поиск производится по окончанию, например, LIKE ‘%ов’, то такой запрос по полю CHAR выдаст 0 записей, если длина значения поля хотя бы на один символ меньше объявленной длины поля. Это происходит потому, что CHAR при сравнении добивается до длины поля пробелами, и получается, что ‘Иванов ‘ не подходит под условие поиска ‘%ов’. Для решения этой проблемы нужно пользоваться VARCHAR
- Поиск или упорядочивание (ORDER BY) с использованием функции UPPER возможен только для полей типа CHAR или VARCHAR, т. к. только они имеют свойство CHARACTER SET (BLOB содержит только произвольную двоичную информацию, т. е. необязательно текстовую). Кроме того, для UPPER поля CHAR и VARCHAR должны иметь соответствующий COLLATE либо в объявлении типа поля, либо в выражении поиска или сортировки.
Примечание. Вы можете написать собственную функцию, аналогичную UPPER, и избежать указанной проблемы.
Выборка данных
- При конкатенации строковых полей в запросе нужно учитывать, что CHAR-поля будут «расширены» до указанной длины пробелами, а VARCHAR – нет. Например, если в запросе производится «сборка» фамилии, имени и отчества
select last_name||first_name||middle_name from clients
то результат будет приблизительно такой: «Иванов Иван Иванович». А если это будут VARCHAR-поля, то такой же запрос выдаст результат в виде «ИвановИванИванович».
Для решения этой проблемы можно для CHAR использовать UDF (типа RTrim), а для VARCHAR – вставлять дополнительные пробелы (||» «||).
- Для многоязыковых баз данных BLOB не могут быть перекодированы из одной кодировки в другую. Например, если сервер поддерживает кодировки WIN1251 и KOI8R, и база создана в WIN1251, возможно подключиться (через компоненты прямого доступа) указывая lc_ctype=KIO8R в параметрах коннекта. При этом информация будет перекодироваться из win1251 в koi8r и наоборот для всех строковых типов данных, кроме BLOB. Для конвертации данных blob хотя бы при выборке придется написать собственную UDF.
Вставка и модификация данных
- Поля BLOB невозможно передавать как параметр запроса или хранимой процедуры в BDE 2.5x и 3.x (такая возможность появилась только в BDE 4.0 и у компонент Delphi 3.0). Это приводит к необходимости использования TQuery и передачи данных в BLOB-поля через TBlobStream. Сам сервер не имеет проблем с получением или передачей blob в виде параметров запроса или параметров процедур.
Создание переносимой базы данных
- Стандарт ANSI SQL в частности определяет типы полей, но безусловно реализация этих типов, способ хранения и обработки определяет изготовитель конкретного SQL-сервера. Для обеспечения хоть какой-то возможной переносимости следует пользоваться совместимыми типами, игнорируя преимущества использовани типов данных (например CHAR в InterBase). Вам необходимо обратиться к документации или справочным файлам BDE (BDE32.HLP), для того чтобы определить совместимость различных типов между выбранными вами SQL-серверами.
Copyright iBase.ru © 2002-2023
Что такое varchar в sql
Типы данных CHAR и VARCHAR очень схожи между собой, но различаются по способам их хранения и извлечения.
В столбце типа CHAR длина поля постоянна и задается при создании таблицы. Эта длина может принимать любое значение между 1 и 255 (что же касается версии MySQL 3.23, то в ней длина столбца CHAR может быть от 0 до 255 ). Величины типа CHAR при хранении дополняются справа пробелами до заданной длины. Эти концевые пробелы удаляются при извлечении хранимых величин.
Величины в столбцах VARCHAR представляют собой строки переменной длины. Так же как и для столбцов CHAR , можно задать столбец VARCHAR любой длины между 1 и 255 . Однако, в противоположность CHAR , при хранении величин типа VARCHAR используется только то количество символов, которое необходимо, плюс один байт для записи длины. Хранимые величины пробелами не дополняются, наоборот, концевые пробелы при хранении удаляются (описанный процесс удаления пробелов отличается от предусмотренного спецификацией ANSI SQL).
Если задаваемая в столбце CHAR или VARCHAR величина превосходит максимально допустимую длину столбца, то эта величина соответствующим образом усекается.
Различие между этими двумя типами столбцов в представлении результата хранения величин с разной длиной строки в столбцах CHAR(4) и VARCHAR(4) проиллюстрировано следующей таблицей:
Величина CHAR(4) Требуемая память VARCHAR(4) Требуемая память » ‘ ‘ 4 байта » 1 байт ‘ab’ ‘ab ‘ 4 байта ‘ab’ 3 байта ‘abcd’ ‘abcd’ 4 байта ‘abcd’ 5 байтов ‘abcdefgh’ ‘abcd’ 4 байта ‘abcd’ 5 байтов Извлеченные из столбцов CHAR(4) и VARCHAR(4) величины в каждом случае будут одними и теми же, поскольку при извлечении концевые пробелы из столбца CHAR удаляются.
Если при создании таблицы не был задан атрибут BINARY для столбцов, то величины в столбцах типа CHAR и VARCHAR сортируются и сравниваются без учета регистра. При задании атрибута BINARY величины в столбце сортируются и сравниваются с учетом регистра в соответствии с порядком таблицы ASCII на том компьютере, где работает сервер MySQL. Атрибут BINARY не влияет на процессы хранения или извлечения данных из столбца.
Атрибут BINARY является «прилипчивым». Это значит, что, если в каком-либо выражении использовать столбец, помеченный как BINARY , то сравнение всего выражения будет выполняться как сравнение величины типа BINARY .
MySQL может без предупреждения изменить тип столбца CHAR или VARCHAR во время создания таблицы. See section 6.5.3.1 Молчаливые изменения определений столбцов.
Сравнение типов данных VARCHAR(max) и VARCHAR(n) в SQL Server
Тип varchar(max) часто используется как в обычных, так и во временных таблицах. Да, с ним можно не беспокоиться о длине строк или появления ошибки «Произойдет усечение строковых или двоичных данных» (String or binary data would be truncated).
Но стоит ли использовать varchar(max) повсюду?
Подробнее о varchar(n) вы можете прочитать здесь, а в этой статье мы сравним типы varchar(max) и varchar(n) .
Общее описание VARCHAR(max)
Тип данных varchar(max) появился в SQL Server 2005. Он пришел на смену устаревшим типам для работы с большими бинарным данными (blob): text, ntext и image. Во всех этих типах можно хранить до 2 ГБ данных. Как вы, возможно, знаете, базовой единицей хранения в SQL Server является страница. Размер страницы фиксирован и составляет 8 КБ (8192 байта). Для заголовка страницы используется 96 байта, в остальных 8096 байтах (8192 — 96 байт) можно хранить данные. Но, помимо этого, страница еще содержит таблицу смещения строк (row offset) и на данные остается 8000 байт. Поэтому в varchar(8000) можно хранить до 8000 байт.
Давайте создадим несколько таблиц с varchar(max) и varchar(n) разной допустимой длины.
CREATE TABLE dbo.Employee_varchar_2000 (id INT IDENTITY PRIMARY KEY, Col1 VARCHAR(2000) ); CREATE TABLE dbo.Employee_Varchar_4500 (id INT IDENTITY PRIMARY KEY, Col1 VARCHAR(4500) ); CREATE TABLE dbo.Employee_Varchar_8000 (id INT IDENTITY PRIMARY KEY, Col1 VARCHAR(8000) ); CREATE TABLE dbo.Employee_Varchar_Max (id INT IDENTITY PRIMARY KEY, Col1 VARCHAR(MAX) );Далее вставим в эти таблицы несколько записей.
INSERT INTO Employee_varchar_2000 (Col1) SELECT REPLICATE('A', 2000); INSERT INTO Employee_varchar_4500 (Col1) SELECT REPLICATE('A', 4500); INSERT INTO Employee_varchar_8000 (Col1) SELECT REPLICATE('A', 8000); INSERT INTO Employee_varchar_max (Col1) SELECT REPLICATE('A', 8000);Посмотрим длину строк в этих таблицах, используя следующие запросы:
Use SQLShackDemo go SELECT LEN(col1) AS columnlength FROM Employee_varchar_2000; SELECT LEN(col1) AS columnlength FROM Employee_varchar_4500; SELECT LEN(col1) AS columnlength FROM Employee_varchar_8000; SELECT LEN(col1) AS columnlength FROM Employee_varchar_max;И убедимся, что длина строк равна длине, указанной в определении столбца.

Теперь посмотрим количество страниц, количество строк и единицу распределения (allocation unit) для наших таблиц, используя DMV sys.dm_db_index_physical_stats .
SELECT OBJECT_NAME([object_id]) AS TableName, alloc_unit_type_desc, record_count, page_count, round(avg_page_space_used_in_percent,0) as avg_page_space_used_in_percent , min_record_size_in_bytes, max_record_size_in_bytes FROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'DETAILED') WHERE OBJECT_NAME([object_id]) LIKE 'Employee_varchar%';Данные во всех таблицах хранятся в единице распределения IN_ROW_DATA.

В колонке с varchar(n) нельзя хранить более 8000 байт, но давайте попробуем вставить больше.
INSERT INTO Employee_varchar_8000 (Col1) SELECT REPLICATE('A', 8001); Go INSERT INTO Employee_varchar_8000 (Col1) SELECT REPLICATE('A', 10000);Запрос выполняется успешно, но данные усекаются до 8000 символов. Аналогичное усечение происходит и для таблицы Employee_varchar_max , хотя там тип varchar(max) .

Чтобы вставить более 8000 символов в колонку varchar(max) нужно привести значение к типу varchar(max) .
INSERT INTO Employee_varchar_8000 (Col1) SELECT REPLICATE(CONVERT(VARCHAR(max), 'x'), 8001);При попытке вставить такую запись в таблицу Employee_varchar_8000 мы получим сообщение об ошибке. В таблицу Employee_varchar_max записи будут успешно вставлены.

Выполним повторно запрос, отображающий информацию о единицах распределения.

Мы видим, что в таблице Employee_Varchar_Max появилась единица распределения LOB_DATA для хранения данных размером более 8000 байт. В единице распределения IN_ROW_DATA находится указатель на эти данные.
Можно сделать следующие выводы для varchar(max) :
- Если данных меньше или равны 8000 байт, то SQL Server использует страницу IN_ROW_DATA.
- Если данных больше 8000 байт, то SQL Server использует страницу LOB_DATA.
Сравнение производительности varchar(max) и varchar(n)
Давайте вставим по 10 000 записей в каждую из созданных ранее таблиц и измерим время вставки данных. Для этого можно использовать ApexSQL Generate.
У меня получились следующие результаты:

- Время вставки Employee_varchar_2000 0,08 секунды
- Время вставки Employee_varchar_4500 0,19 секунды
- Время вставки Employee_varchar_8000 0,31 секунды
- Время вставки Employee_varchar_Max 2,72 секунды
Индексы на VARCHAR(N) и VARCHAR(MAX)
Как администратор баз данных вы, скорее всего, не будете иметь возможности изменять структуру таблиц. Однако вы можете создавать индексы.
На колонке varchar(n) можно создать индекс.
CREATE INDEX IX_Employee_varchar_2000_1 ON dbo.Employee_varchar_2000(col1) GOПопытка сделать то же самое для varchar(max) приведет к ошибке.
CREATE INDEX IX_Employee_varchar_max ON dbo.Employee_varchar_max(col1) GOMsg 1919, Level 16, State 1, Line 23 Column ‘col1’ in table ‘dbo.Employee_varchar_max’ is of a type that is invalid for use as a key column in an index.
Хотя столбец varchar(max) можно использовать в качестве включенного (INCLUDE) в индекс, но искать по нему нельзя. Кроме того, для него потребуется дополнительное место. Поэтому стоит избегать индексов с varchar(max) .
Сравнение планов выполнения
Сначала выполним запрос для таблицы Employee_Varchar_2000 и посмотрим фактический план выполнения.

В фактическом плане выполнения мы видим оператор Index Seek .
Далее запустим такой же запрос для таблицы с varchar(max) .
select col1 from Employee_varchar_max where col1 like ‘xxxx%’

Здесь уже видим оператор Clustered Index Scan , а он может быть весьма ресурсоемким в зависимости от количества строк в таблице.
Давайте сравним планы, используя Compare Showplan в SSMS. Чтобы сравнить два плана, сохраните один из, щелкнув правой кнопкой мыши на плане, выбрав «Save Execution Plan As…», и указав место сохранения.
В другом плане щелкните правой кнопкой мыши и выберите «Compare Showplan». Откроется окно, в котором можно выбрать ранее сохраненный план.
На скриншоте ниже показан результат сравнения планов.

- Оценка стоимости процессора (estimated CPU cost) для оператора выборки данных для varchar(max) больше, чем для varchar(2000) .
- Для varchar(max) используется оператор Clustered Index Scan — сканируются все записи. Предполагаемое количество строк (estimated number of rows) 10000. В то время как для varchar (2000) используется оператор Index Seek и предполагаемое количество строк составляет 1,96078.
- Предполагаемый размер строки (estimated row size) у varchar(max) 4035 байт, varchar(2000) — 1011 байт.
Разница между varchar(max) и varchar(n)
varchar(max)
varchar(n)
Можно хранить до 2 ГБ данных
Можно хранить до 8000 байт данных
До 8000 байт используется единица распределения IN_ROW_DATA. Если данных больше 8000 байт, то используется страница LOB_DATA с указателем на нее на странице IN_ROW_DATA.
Данные хранятся на стандартной странице данных IN_ROW_DATA
Нельзя создать индекс
Можно создать индекс
Нельзя сжимать данные LOB
Можно сжимать данные
Извлечение и обновление LOB-данных происходит относительно медленно
Не сталкиваемся с такой проблемой для varchar(n)
Выводы
В этой статье мы поговорили о типе данных varchar(max) , а также рассмотрели несколько различий между varchar(max) и varchar(n) . Используйте правильные типы данных. Учитывайте схему базы данных, производительность, возможность сжатия и использования индексов. Проанализируйте используемые типы данных в ваших БД и при необходимости измените их, конечно, с тщательным тестированием.
Перевод подготовлен для будущих учащихся на курсе «MS SQL Server Developer». Также приглашаем всех желающих на открытый урок «Основы анализа производительности и оптимизации запросов в MS SQL Server». Тормозит база? Медленно выполняется запрос? На занятии рассмотрим основы анализа производительности и оптимизации запросов в MS SQL Server.
- sql server
- VARCHAR(max)
- VARCHAR(n)
- типы данных
- производительность
- ms sql server
- оптимизация запросов
- Блог компании OTUS
- SQL
- Microsoft SQL Server
SQL varchar data type deep dive

Let’s move ahead and see the aforementioned in action.
So what is varchar in SQL?
As the name suggests, varchar means character data that is varying. Also known as Variable Character, it is an indeterminate length string data type. It can hold numbers, letters and special characters. Microsoft SQL Server 2008 (and above) can store up to 8000 characters as the maximum length of the string using varchar data type. SQL varchar usually holds 1 byte per character and 2 more bytes for the length information. It is recommended to use varchar as the data type when columns have variable length and the actual data is way less than the given capacity. Let’s switch to SSMS and see how varchar works.
The following example creates three variables (name, gender and age) with varchar as the data type and different values being assigned to them. As evident from the result sets shown below, by default, the string length of the SQL varchar columns is 1 and it returns only the first value of the variables(rest of the string being truncated) when no string length is passed for the varchar data type. Function len() is used to determine the number of characters stored in the varchar column.
DECLARE @ name AS varchar = ‘john parker d’ ‘souza’ ;
DECLARE @ gender AS varchar = ‘M’
DECLARE @ age AS varchar = ’23’
SELECT @ name Name , @ gender Gender , @ age Age
SELECT len ( @ name ) namelen , len ( @ gender ) genderlen , len ( @ age ) agelen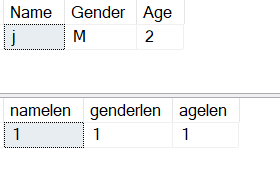
How SQL varchar(max) is different from varchar(n)?
There are times where SQL developers (including myself) usually define varchar datatype without a length, and subsequently, are failed to insert string records in the SQL table, this is because SQL Server allocates 1 character space as the default value to the varchar column that is defined without any length. In practical scenarios, varchar(n) is used to store variable length value as a string, here ‘n’ denotes the string length in bytes and it can go up to 8000 characters. Now, let’s proceed further and see how we can store SQL varchar data with a string length into the column of a SQL table. Below script creates the table Demovarchar with some data in it. And the result screen shows records of 7 employees based on their departments, age etc.
CREATE TABLE Demovarchar
Id int NOT NULL IDENTITY ( 1 , 1 ) ,
LastName varchar ( 10 ) ,
FirstName varchar ( 10 ) ,
Gender varchar ,
DepartmentName varchar ( 20 ) ,
INSERT INTO Demovarchar VALUES ( ‘Gilbert’ , ‘Kevin’ , ‘M’ , ‘Tool Design’ , 33 )
INSERT INTO Demovarchar VALUES ( ‘Tamburello’ , ‘Andrea’ , ‘F’ , ‘Marketing’ , 45 )
INSERT INTO Demovarchar VALUES ( ‘Johnson’ , ‘David’ , ‘M’ , ‘Engineering’ , 66 )
INSERT INTO Demovarchar VALUES ( ‘Sharma’ , ‘Bradley’ , ‘M’ , ‘Production’ , 27 )
INSERT INTO Demovarchar VALUES ( ‘Rapier’ , ‘Abigail’ , ‘F’ , ‘Human Resources’ , 38 )
INSERT INTO Demovarchar VALUES ( ‘Martin’ , ‘Kelly’ , ‘F’ , ‘Information Services’ , 54 )
INSERT INTO Demovarchar VALUES ( ‘Poland’ , ‘Carole’ , ‘F’ , ‘Production Control’ , 29 )
SELECT * FROM Demovarchar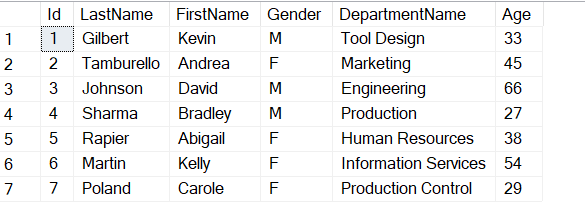
Suppose, there is a new addition of an employee in the organization and we, as SQL data developers, would have to insert this new record into the above table using INSERT SQL Statement. Below is one such example shown.
INSERT INTO Demovarchar VALUES ( ‘Newton Hamilton’ , ‘Isaac’ , ‘M’ , ‘Design Head’ , 69 )

Oops, SQL Server encountered an error and terminated the statement saying string or binary data would be truncated. This has occurred because, column LastName varchar(10) can hold up to 10 characters and here we are attempting to insert a new record with string length(‘Newton Hamilton’) which is clearly greater than 10 characters. As a quick fix, we can alter the table and increase the data type of the SQL varchar column, say to varchar(50) to insert the new row. Execute the below script to ALTER and INSERT a new record into the table. Additionally, you can use LEN() and DATALENGTH() functions to determine the number of characters and the storage size in bytes respectively that are stored in the varchar column.
ALTER TABLE Demovarchar
ALTER COLUMN LastName varchar ( 50 )
INSERT INTO Demovarchar VALUES ( ‘Newton Hamilton’ , ‘Isaac’ , ‘M’ , ‘Design Head’ , 69 )
SELECT * FROM Demovarchar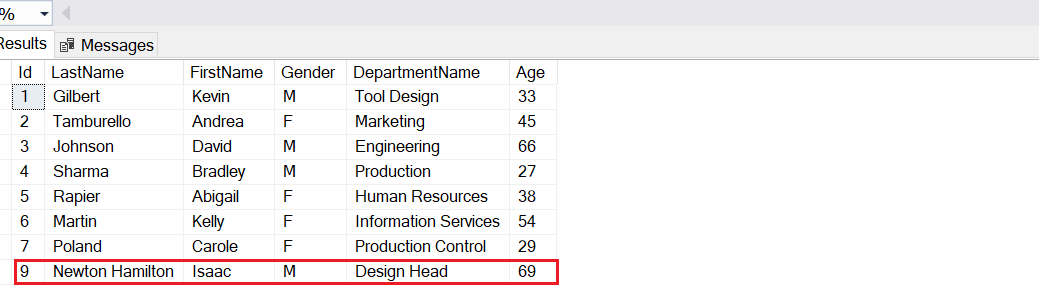
We observed above how we can set or alter the string length in the SQL varchar column to meet the business needs. However, consider a scenario, where we are unsure of the data size that is going to be loaded into our SQL tables, in such circumstances, inspecting and altering data type size for each and every column is not a viable choice. One of the options to handle this could be is to set the string length on the higher bar in the SQL Server varchar column (provided you have a rough estimation of what length of the string column would be approximately).
An important point to keep in consideration, we can use string length up to varchar(8000) only as this is the maximum number of characters that SQL varchar(n) data type can hold. So in cases when there are chances that the string length of the varchar column might exceed 8000 bytes, using varchar(8001) or anything higher will result into an error. One short example demonstrating this fact is shown below.
DECLARE @ name AS varchar ( 8001 ) = ‘john parker d’ ‘souza’ ;
SELECT @ name Name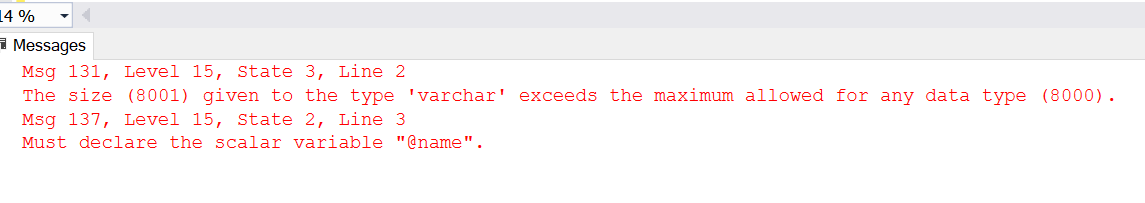
SQL Server 2005 got around this limitation of 8KB storage size and provided a workaround with varchar(max). It is a non-Unicode large variable-length character data type and can store a maximum of 2^31-1 bytes (2 GB) of non-Unicode characters.
We can refer to the DMV sys.dm_db_index_physical_stats to see what kind of page allocation (IN_ROW_DATA data/LOB_DATA/ ROW_OVERFLOW_DATA) is performed. You can also check out this link in case you want detailed explanation on how SQL Server exercises row and page limits with both varchar(n) and varchar(max) data types.
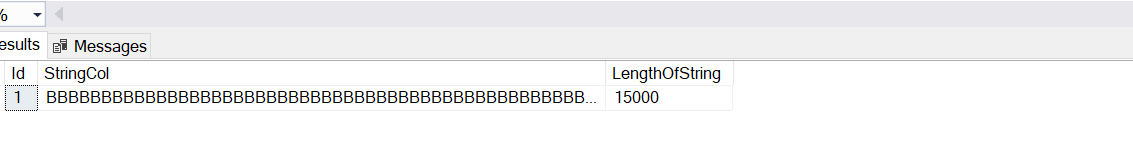
Let’s quickly jump over to SSMS and see how we can use varchar(max). Execute the following script to insert 1 record where StringCol column value in each row is 15,000 B characters (i.e. 15,000 bytes).
CREATE TABLE Demovarcharmax
ID INT IDENTITY ( 1 , 1 ) ,
StringCol VARCHAR ( MAX )INSERT INTO Demovarcharmax ( StringCol ) VALUES ( REPLICATE ( CAST ( ‘B’ AS VARCHAR ( MAX ) ) , 15000 ) )
SELECT Id , StringCol , len ( StringCol ) AS LengthOfString FROM Demovarcharmax
One limitation of using varchar(max) is we cannot create an index that has a varchar(max) as a key column, instead, it is advisable to do a Full-text index on that column.
A quick note to make – From here to the last leg of this article, we will mention varchar in place of varchar(n). Do NOT consider it as the varchar with default value = 1.
To learn some more interesting differences between varchar(n) and varchar(max) in SQL Server, consider going through this article, Comparing VARCHAR(max) vs VARCHAR(n) data types in SQL Server.
UTF-8 support with SQL Server 2019 CTP
Before we dig in what SQL Server 2019 preview feature has to offer for SQL varchar, let’s quickly look at one more interesting data type – ‘nvarchar’ first. Like SQL Server varchar [(n|max)], we have SQL nvarchar [(n|max)], the prefix n in nvarchar denotes Unicode, i.e. it stores both Unicode and non-Unicode data. The key difference between varchar and nvarchar is the way they are stored, varchar is stored as regular 8-bit data(1 byte per character) and nvarchar stores data at 2 bytes per character. Due to this reason, nvarchar can hold upto 4000 characters and it takes double the space as SQL varchar. You can go through this link to learn more about nvarchar in SQL Server.
With the public preview of SQL Server 2019, Microsoft has announced the support for UTF-8 character encoding to the existing data types (varchar and char). For those, who are not aware of UTF-8, it stands for Unicode Transformation Format and is a Unicode-based encoding that supports many languages. The 8 in UTF-8 means it uses 1 byte (8-bits) to represent a character in memory. Likewise, UTF-16 uses 16 bits (2 bytes) to represent a character. We will limit the scope of this new SQL Server 2019 CTP enhancement to ‘SQL varchar’ only in this article.
This enhancement has the following impact in SQL Server: is
- Improves Data compatibility Until SQL Server 2019 CTP, SQL varchar data type had the capacity to store only Non-Unicode data and with this preview, we can now create a varchar column to store Unicode data under UTF-8 enabled collations (_UTF8). UTF-8 is allowed in the varchar datatypes and is enabled when creating or changing an object’s collation to a collation with the UTF8 suffix. This helps in minimizing character conversion issues.
- Reduction in storage and performance improvements UTF-8 support for varchar data type provides substantial storage savings depending on the character set in use. For eg, using an UTF-8 enabled collation, changing the column data type from nvarchar(20) to varchar(20) offers a significant drop in storage requirements since nvarchar(20) requires 40 bytes for storage and varchar(20) needs 20 bytes for the same Unicode string.
Important side note – Since this enhancement is still in preview, we can expect more progressions on this front in the near future. However, existing Unicode (UTF-16) data types (nchar, nvarchar and ntext) remain unchanged in SQL Server 2019 preview.
Collation with SQL varchar in SQL Server 2019 CTP
Collation in SQL Server defines configurations to determine various rules like case sensitivity, accent sensitivity, sorting, character types and width etc. Understanding all these properties and how do they work with your data become very important. Collation can be set at server, database, expression or column level. UTF-8 supports database-level or column-level collation in SQL Server 2019 CTP and is enabled when you create or change Database or column collation to a collation with UTF8 suffix.
If you execute the below query against SQL Server 2019 CTP, you will be able to see all the UTF-8 supported collations on your instance of SQL Server using function (fn_helpcollations()).