
Как своровать css сайта?
воров на этом форуме не любят. к тому же, если вы не знаете как найти css файл, то скорее всего вы его и использовать-то не сможете.
Конвертирую трафик CPA, доход 15000 руб. в сутки (http://goo.gl/fRqIh), CPM=166.65 руб. Покупаю качественные сайты (/ru/forum/734320) (порталы, контент-проекты, сервисы, форумы).
На сайте с 14.10.2008
25 ноября 2009, 12:28
Ну и пусть не любят. Человеку нужно бабло набить. Так что не надо нравоучений)
На сайте с 28.01.2007
25 ноября 2009, 12:34
CTACEBu4:
воров на этом форуме не любят.
протестую, это не воровство 🙂 Вариант для нуба в Опере — Сохранить как -> тип файла: HTML-файл с изображениями -> сохранить. При таком способе CSS-файлы сохраняются в соответствующей для документа папке.
На сайте с 07.05.2006
25 ноября 2009, 13:17
Loko:
протестую, это не воровство
Вариант для нуба в Опере — Сохранить как -> тип файла: HTML-файл с изображениями -> сохранить. При таком способе CSS-файлы сохраняются в соответствующей для документа папке.
Поддерживаю, это не воровство, но ТС интересует именно «Как своровать». Поэтому надо сделать так: взять чистый ноут, сменить обои на черный или темно-синий тон, поменять прокси, дождаться ночи, зайти на сайт-жертву под видом обычного посетителя и полистать странички, подождать пока на сайте не будет посетителей, резко открыть исходный текст страницы, узнать адрес css, открыть и сохранить css на флешку, ноут отформатировать и сжечь, флешку положить в камеру хранения на вокзале и залечь на дно на месяц-два. По истечении опасного срока достать флешку, изменить в css названия всех стилей, картинок и цвета, а также значения ширины, высоты и отступов. Вуаля — у вас ворованный css и вы на свободе.
На сайте с 08.08.2005
25 ноября 2009, 13:22
Ёхан Палыч:
Поэтому надо сделать так: взять чистый ноут, сменить обои на черный или темно-синий тон, поменять прокси, дождаться ночи, зайти на сайт-жертву под видом обычного посетителя и полистать странички, подождать пока на сайте не будет посетителей, резко открыть исходный текст страницы, узнать адрес css, открыть и сохранить css на флешку, ноут отформатировать и сжечь, флешку положить в камеру хранения на вокзале и залечь на дно на месяц-два. По истечении опасного срока достать флешку, изменить в css названия всех стилей, картинок и цвета, а также значения ширины, высоты и отступов. Вуаля — у вас ворованный css и вы на свободе.
Не согласен только с обоями. Дефолтные виндовые тоже трудно запалить — слишком распространены. А в остальном — отличные рекоммендации для начинающих!
На сайте с 22.11.2009
25 ноября 2009, 13:23
Ёхан Палыч:
Поддерживаю, это не воровство, но ТС интересует именно «Как своровать».
Поэтому надо сделать так: взять чистый ноут, сменить обои на черный или темно-синий тон, поменять прокси, дождаться ночи, зайти на сайт-жертву под видом обычного посетителя и полистать странички, подождать пока на сайте не будет посетителей, резко открыть исходный текст страницы, узнать адрес css, открыть и сохранить css на флешку, ноут отформатировать и сжечь, флешку положить в камеру хранения на вокзале и залечь на дно на месяц-два. По истечении опасного срока достать флешку, изменить в css названия всех стилей, картинок и цвета, а также значения ширины, высоты и отступов. Вуаля — у вас ворованный css и вы на свободе.
:p И при малейшей опасности сдаться властям. И заявить что это ты украл CSS с сайта %sitename%
На сайте с 08.08.2005
25 ноября 2009, 13:34
PyMbIH:
:p И при малейшей опасности сдаться властям. И заявить что это ты украл CSS с сайта %sitename%
Нелепость! Русские не сдаются. (с) «Брат 2»
На сайте с 25.11.2009
25 ноября 2009, 13:43
Ёхан Палыч:
Поддерживаю, это не воровство, но ТС интересует именно «Как своровать».
Поэтому надо сделать так: взять чистый ноут, сменить обои на черный или темно-синий тон, поменять прокси, дождаться ночи, зайти на сайт-жертву под видом обычного посетителя и полистать странички, подождать пока на сайте не будет посетителей, резко открыть исходный текст страницы, узнать адрес css, открыть и сохранить css на флешку, ноут отформатировать и сжечь, флешку положить в камеру хранения на вокзале и залечь на дно на месяц-два. По истечении опасного срока достать флешку, изменить в css названия всех стилей, картинок и цвета, а также значения ширины, высоты и отступов. Вуаля — у вас ворованный css и вы на свободе.
А для особо параноидальных сделать это все через третьих лиц, в идеале конкурентов и недругов (при наличиии задатков злого гения, конечно же), а да еще можно тупо паработить мир и тогда никакие законы не страшны, будут ли нужны эти самые css это уже другой вопрос 🙂
список полезных сервисов для работы с ключевиками (http://blackpig.ru/keyword-tools/)
На сайте с 17.03.2008
25 ноября 2009, 14:32
-МОЙ Скрипт портала Flash игр с автонаполнением (/ru/forum/733320) -МОЙ Скрипт адалт портала с продажей онлайн видео (платник) (/ru/forum/733327)
Как утащить простой сайт за 5 минут
Когда начинаешь практиковаться в вёрстке сайтов, может быть очень полезно разобраться, как устроены сайты у других ребят. Вот как это сделать.
�� Всё, что мы делаем в этой статье, мы делаем в учебных целях. Если вы просто скопируете себе чужой сайт и будете выдавать его за свой, это может плохо кончиться.
�� На самом деле всё сказанное в этой статье нужно для тех, кто боится отключения интернета и хочет сохранить у себя на компьютере самую важную информацию. Но эта мысль бредовая сразу на стольких уровнях, что мы стесняемся её произносить вслух. Разве что шёпотом.
В чём идея
Мы будем копировать чужой сайт, чтобы его можно было запустить на своём сервере или на домашнем компьютере. Задача — не просто открыть сайт в браузере и посмотреть его код, а забрать из него все важные файлы — и стили, и скрипты, и изображения. Чтобы было проще, мы будем практиковаться на одностраничном сайте, но всё то же самое будет работать и на многостраничном.
❌ Мы не сможем утащить чужие PHP-скрипты и страницы, связанные с данными пользователя (например, не сможем утащить из интернет-магазина рабочую версию корзины с покупками). Для этого нужен доступ к файлам сервера, а этого у нас нет.
Главный принцип этой работы: когда ваш браузер запрашивает страницу чужого сайта, веб-сервер отправляет ему эту страницу, в буквальном смысле. То же с картинками, стилями и скриптами: каждый раз, когда вы посещаете сайт, вы как будто делаете его копию у себя на компьютере. Браузер получает страницу от сервера и выводит её копию на экран, а в памяти держит исходный код. Разве что он не сохраняет эту страницу на диск, чтобы вы могли её редактировать.
Вот этот последний этап мы и исправим: теперь мы будем сохранять чужие сайты к себе на диск.
Весь процесс покажем на примере сайта ux-posters.ru – простом одностраничном сайте, где есть картинки, стили и скрипты. Автору этого текста пришлось помогать авторам этого сайта с похожей задачей, так что пример свеженький.
Быстрый путь: грабберы
Есть категория программ под названием «веб-грабберы», или «веб-рипперы». Они работают так:
- Ты говоришь программе, на какую страницу сайта зайти.
- Программа собирает все ссылки с этой страницы, переходит по этим ссылкам и строит себе виртуальную карту сайта — то есть пытается понять, сколько на этом сайте страниц и как они связаны.
- Потом граббер начинает ползать по этим страницам подряд, запрашивать их у сервера, получать ответы и сохранять ответы на вашем жёстком диске.
- В какой-то момент граббер останавливается, потому что он скачал все доступные ему страницы с этого сайта.
После работы граббер оставляет у вас на диске гору файлов, которые представляют собой статичный отпечаток чужого сайта. Эту гору можно загрузить на собственный сервер, и издалека это будет похоже на чужой сайт.
✅ Плюсы: граббер может быстро охватить много страниц и скачать из них огромное количество стилей, картинок и всего подряд. Работа очень быстрая и хорошо автоматизирована.
❌ Минусы: часто он качает всё без разбора, оставляя на диске много дублей. Также он бессилен с сайтами, в которых контент выводится динамически или имеет нестандартную систему адресации.
�� В целом грабберы можно использовать, чтобы скачивать сайты библиотек, архивов и других мест, где документов много и всё устроено логично. Например, с помощью граббера можно скачать какую-нибудь классическую книгу из онлайн-библиотеки.
Вот ссылки на грабберы для разных платформ:
- HTTrack — старый интерфейс из нулевых, но свою задачу выполняет полностью. Бесплатный и надёжный, работает везде.
- Getleft — мультиплатформенный граббер, который пытается выкачивать всё, до чего дотянется, включая PHP-скрипты.
- Cyotek WebCopy — для тех, кто любит только Windows, тоже бесплатный.
Сложный путь: ручное сохранение
Допустим, мы хотим сохранить какую-то отдельную страницу сайта или конкретные её части (например, картинки). Но эти картинки как-то так хитро встроены, что вы не можете просто нажать «Сохранить картинку как. ». Тогда потребуется ручной метод.
Заходим на страницу и нажимаем в браузере Ctrl + I (в Виндоус) или ⌥ + ⌘ + I (если у вас мак). Появляется окно «Инспектора», где видна внутренняя структура страницы:
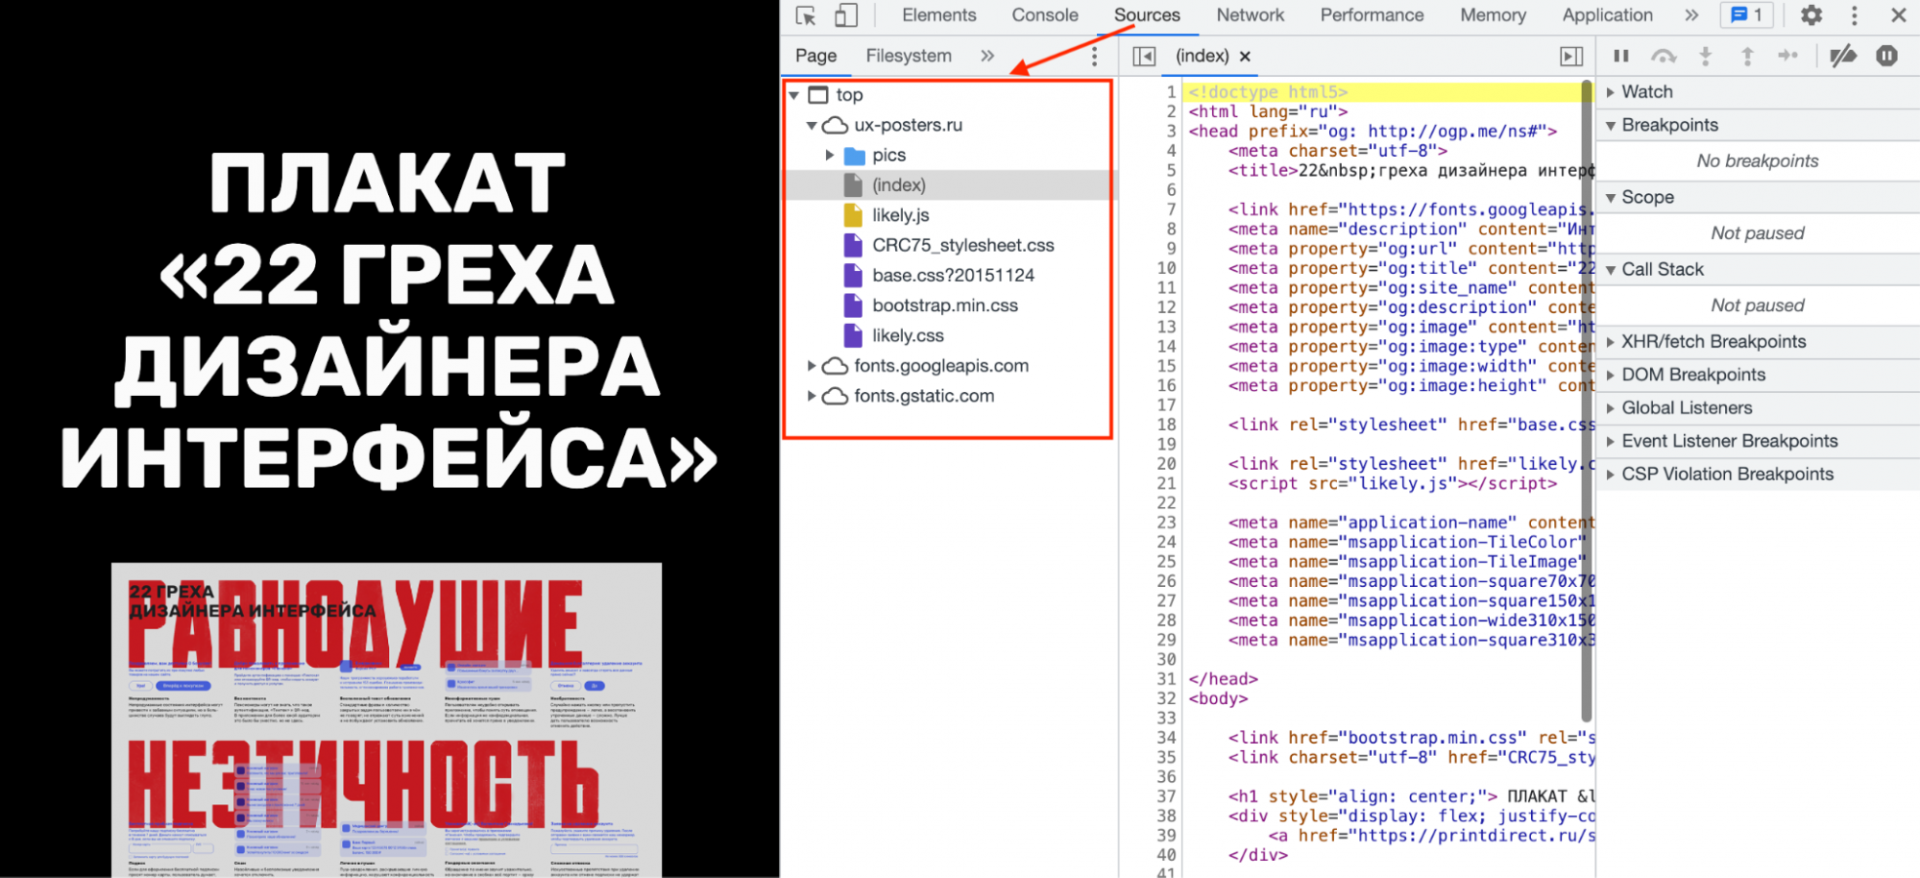
Мы видим, что текущий документ в браузере состоит:
- из страницы index.html;
- скрипта likely.js;
- четырёх таблиц стилей;
- шрифтов, подключённых через сервис Google;
- папки с картинками.
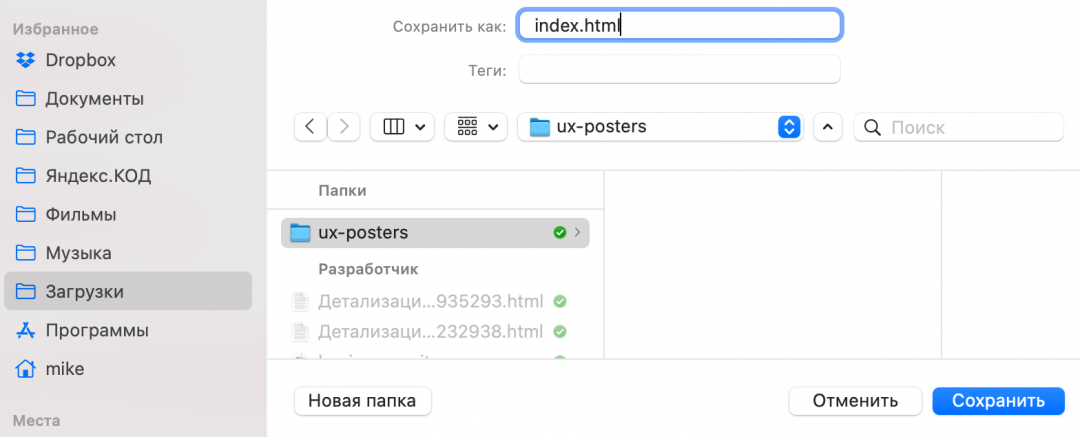
Шрифты нам скачивать необязательно — сайт и так их подключит с сервера гугла, а всё остальное скачать нужно. Чтобы не создавать хаос на компьютере, создадим сначала папку ux-posters — в ней будет храниться наш сайт. Потом в эту папку сохраняем все файлы таким способом:
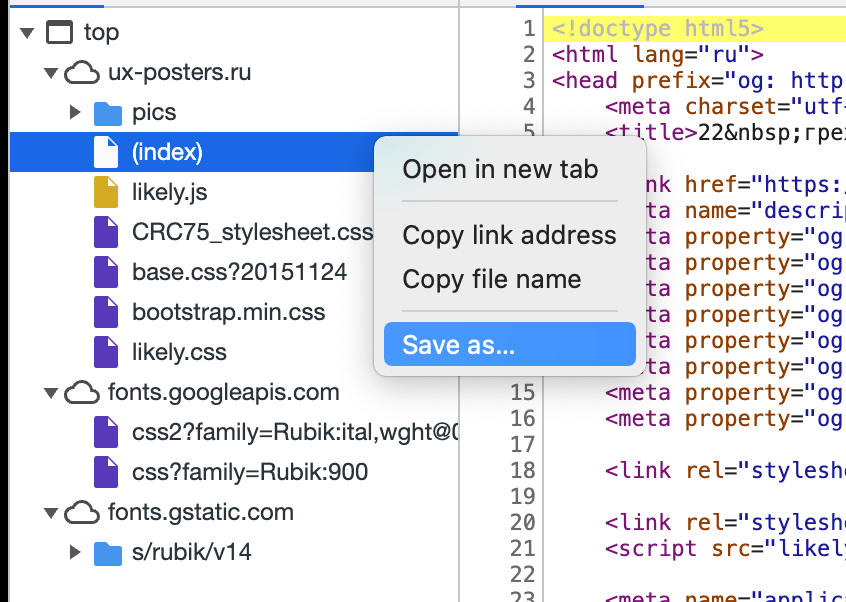
- Нажимаем правой кнопкой мыши на очередной файл.
- Выбираем пункт Save as, или «Сохранить как».
- Пишем имя и расширение файла — точно так, как указано в списке.
- Если лень писать самому — скопируйте перед этим название файла, нажав правую кнопку мыши и выбрав Copy file name, или «Скопировать имя файла».
- Чаще всего название файла подставится само, но если нет — смотрите пункт 4.
Исключения в названии файлов два:
- (index) — это index.html.
- В любом файле знак вопроса и всё, что после него, писать не нужно.
Скачать можно всё, а можно только то, что вам нужно для работы и экспериментов. Например, если вам нужны только стили и код страницы, сохраняйте файлы .css и (index). Если нужны картинки, заходите в папку pics и сохраняйте всё оттуда.
Что в итоге
Если мы пройдёмся по всем папкам и сохраним в них всё нужное нам, у нас получится локальный слепок сайта. Теперь можно:
- Изучить, как он устроен, что-то отредактировать и увидеть результат у себя на компьютере.
- Открыть файл index.html в браузере, и будет ощущение, что вы зашли на сайт, но с локального компьютера. Сайт откроется по протоколу file:// — это так браузер говорит нам, что файл взялся с нашего компьютера, а не из интернета.
- Запустить MAMP и завести на нём локальную копию сайта для экспериментов. Тогда браузер будет думать, что ходит за этим сайтом в интернет. Можно написать какие-нибудь php-скрипты и оживить сайт.
�� Важно понимать, что перед нами именно «слепок» — то, что мы бы увидели, если бы сервер сегодня ответил на наш запрос. Если завтра сервер будет отвечать по-другому, мы этого в своей локальной копии не увидим.
Когда ещё это пригодится
Защитить сайт перед наплывом пользователей. С помощью грабберов можно быстро создать неубиваемую статическую копию сайта и временно подменить ей динамическую версию сайта. Это полумера, но может сработать. А вообще вместо этого есть специальные надстройки, которые делают почти то же самое, но более умно, — поищите слово «кеширование».
Сделать копию своего блога, личного сайта или ещё чего-то важного вам, если вы потеряли к нему доступ, но сайт всё ещё на ходу.
Если вы едете туда, где не будет интернета, а вам нужна информация с сайта (например, путеводитель по чужой стране). Помните, что динамические карты и видеоролики так не сохранятся.
Сделать собственный «веб-архив» — это сервис, который ползает по сайтам и делает их «слепки» для истории. Благодаря этому сервису можно посмотреть, как выглядели ваши любимые сайты много лет назад — например, Яндекс.
Как скачать сайт полностью для дальнейшей корректировки кода?
Добрый день, ребята!
Я дизайнер, учащий бутстрап. Был заказ на небольшой сайт, который сверстал сторонний верстальщик. Мне не нравиться результат, хочу чисто для себя допилить его, так как я задумала. Заказчик отказывается предоставлять исходники. Как я могу его скачать, полностью для дальнейшей корректировки?
- Вопрос задан более трёх лет назад
- 11839 просмотров
Комментировать
Решения вопроса 2
Скачайте программу wget, а потом одной строкой в командной строке выкачивайте весь сайт. Вот видео инструкция, как это сделать.
Вот несколько команд, их хватит с головой Вам.
wget —page-requisites адресс сайта — так выкачается только одна страница
wget —page-requisites -r -l 10 адресс сайта — так выкачаются все страницы
wget —page-requisites —no-check-certificate -r -l 10 адрес сайта — если неизвестен сертификат сайта
Но, Вы должны понимать, что если файлы были объединены, сжаты и т.д., то скачаются они именно в таком виде, а в большинстве случаев, при нынешних оптимизаторах это почти бесполезный код, особенно скрипты, т.к. туда выводится только конечный результат.
Как скопировать любой сайт целиком: 7 способов
Можно ли скопировать любой сайт в интернете? Да, конечно. Для этого потребуется всего пара минут и несколько кликов. Но с одной оговоркой — вы получите его html-код, внешний вид сайта, без сложных скриптов (для их реализации потребуется программист). Этот вариант подойдет для тех, кому нужно скопировать несложный сайт — например, лендинг конкурента и быстро запустить рекламу.
Скопировать сайт целиком и переделать?
Стоит понимать, что, копируя сайт, вы с большой вероятностью столкнетесь с “сюрпризами”, которые обязательно нужно проверить перед работой:
- корректная верстка (все элементы на своих местах, работает исправно и мобильная версия, и десктоп),
- все картинки загружаются (при копировании, возможно, что-то не сохранилось, неправильно указан путь файла в коде),
- активные элементы работают исправно (кнопки, формы).
Все эти мелочи исправляются за несколько минут самостоятельно, либо с помощью фрилансеров, если речь идет о скриптах.
Для самостоятельной работы с кодом рекомендуем: Sublime Text, Visual Studio Code, Atom.
Далее, все что вам останется — перенести сайт на ваш хостинг с доменом.
Так чем же скопировать сайт?
7 способов бесплатно скопировать сайт
Самый простой способ: “Ctrl+S” — команда в браузере, которая сохраняет текущую страницу. Быстро, без посторонних сервисов, но с высокой вероятностью потерять часть сайта (динамические элементы, скрипт, формы) — больше подойдет для копирования контента страниц.
Если вам нужно скопировать работоспособный одностраничный сайт, то лучше обратиться к специальным сервисам, которые помимо HTML, копируют CSS, JavaScript, все изображения, анимации, ссылки и формы. Тем более, что часть из них полностью бесплатна.
Web2zip
https://web2zip.ru/ — бесплатный онлайн сервис с простым интерфейсом. Вводим нужный нам url сайта, нажимаем скопировать и получаем сайт в архиве с возможностью предпросмотра онлайн.
Сервис копирует HTML, CSS, JavaScript, изображения и шрифты.
Saveweb2zip
https://saveweb2zip.com/ru — онлайн-сервис с бесплатной возможностью скачать сайт, сохраняя HTML, CSS, JavaScript, изображения и шрифты. За дополнительную плату можно заказать настройку форм и решение других вопросов.
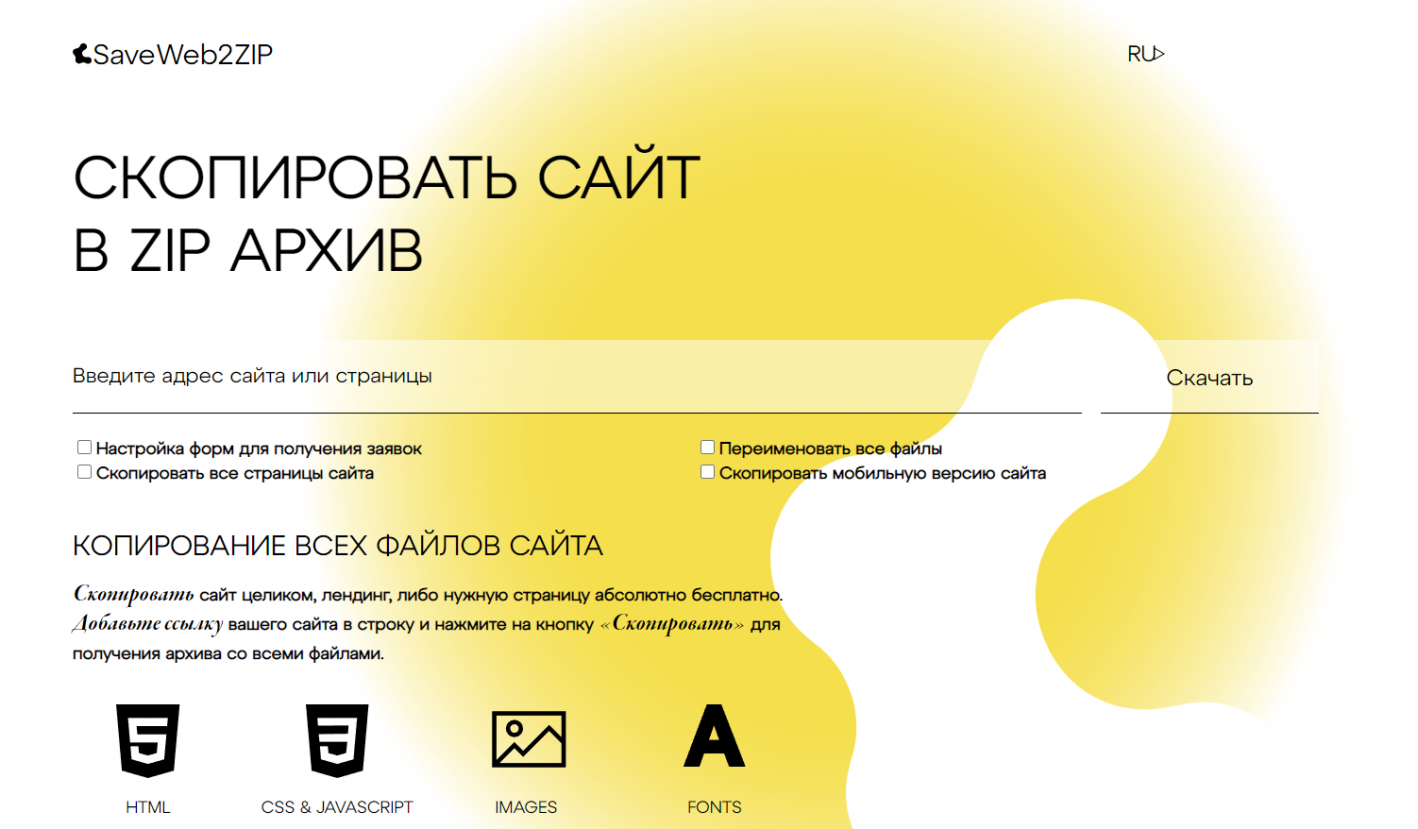
При скачивании есть возможность автоматически переименовать названия файлов, скопировать мобильную версию сайта.
CopySite
https://copysite.link/ — онлайн-сервис уже с платной подпиской, но более широким функционалом. При скачивании есть возможность использовать прокси, заменять слова, ссылки, автоматически удалять теги, счетчики метрик и форматировать код.
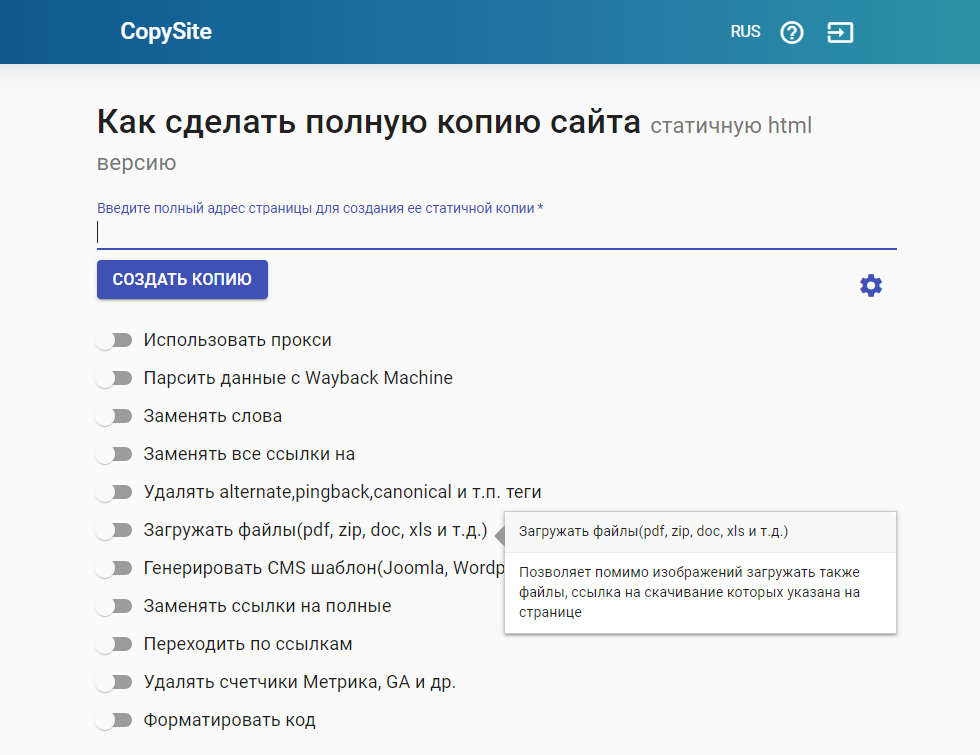
Стоимость — 300 руб./мес., 200 руб./неделя, 75 руб./сутки.
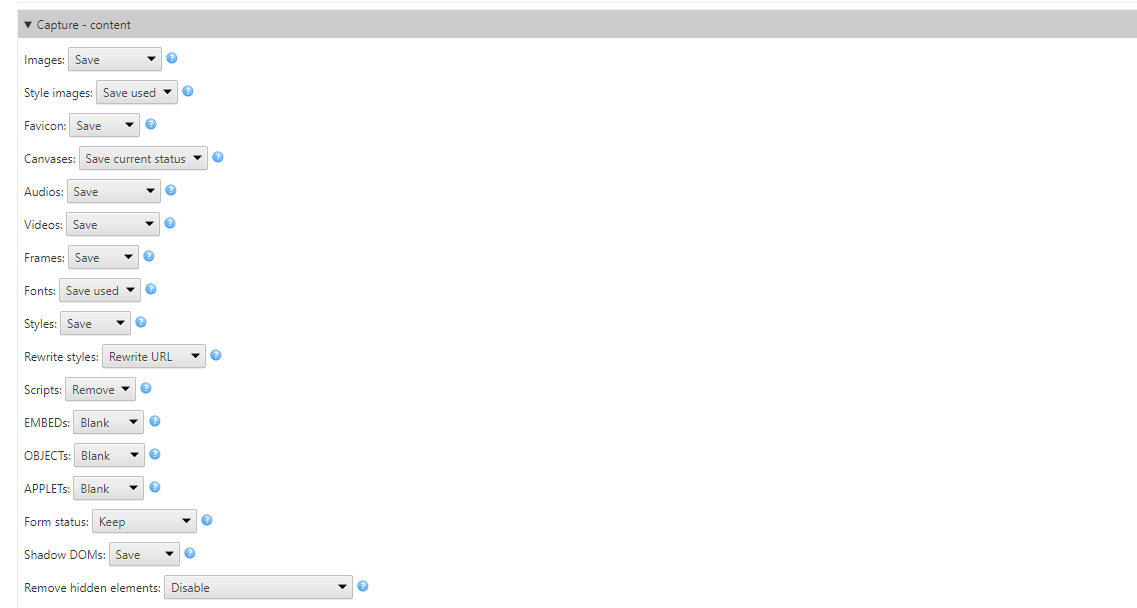
Web ScrapBook
Web ScrapBook — бесплатное браузерное расширение, которое позволяет скачивать необходимые страницы сайта не покидая целевую страницу.
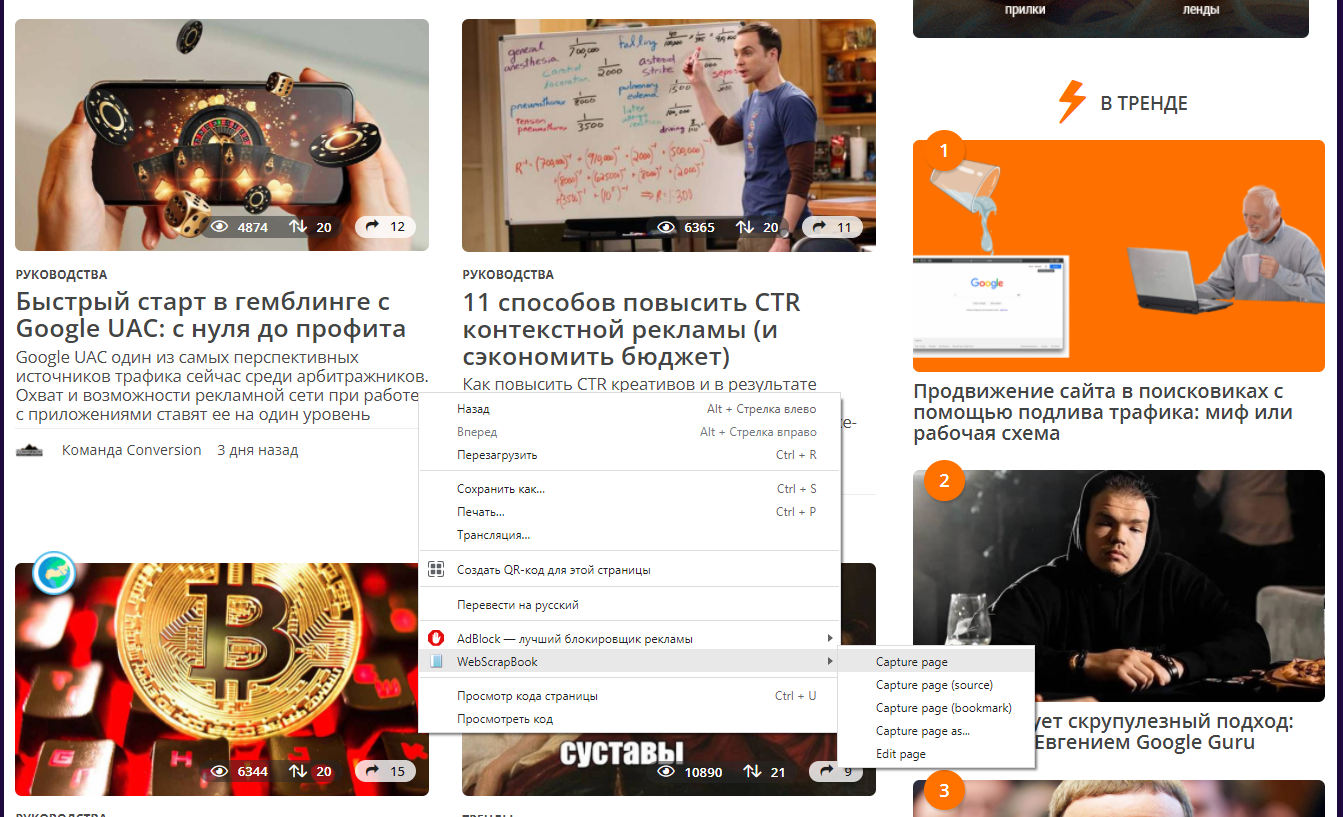
Сервис имеет широкий опционал для настройки, позволяющий работать с мультимедийными файлами и скриптами: скачивать, вырезать, заменять, пропускать.
Httrack
Httrack — бесплатный локальный сервис, для работы нужно устанавливать на компьютер. С задачей справляется отлично, основное преимущество — можно скачивать несколько сайтов одновременно (списком загружать url), всегда готов к работе (не зависит от работоспособности онлайн-сервисов), менее удобен, чем решения выше.
Cyotek WebCopy
Cyotek WebCopy — один из сервисов компании Cyotek, требует установки, но абсолютно бесплатный. Копирует контент, а также стили, но теряет JavaScript.
Отлично подойдет для парсинга контента сайтов и копировании простых сайтов.
wget
wget — консольная утилита, которая позволяет копировать сайты без графического интерфейса, используя команду типа “wget -r -k -l 7 -p -E -nc http:/vash.site/”
Параметры отвечают за:
- -r — указывает на то, что нужно переходить по ссылкам на сайте, чтобы скачивать все подкаталоги и все файлы в подкаталогах.
- -k — преобразует все ссылки в скаченных файлах, чтобы по ним можно было переходить на локальном компьютере в автономном режиме.
- -p — указывает на то, что нужно загрузить все файлы, которые требуются для отображения страниц (изображения, css и т.д.).
- -l — определяет максимальную глубину вложенности страниц, которые нужно скачать. Обычно сайты имеют страницы с большой степенью вложенности и чтобы wget не начал «закапываться», скачивая страницы, можно использовать этот параметр.
- -E — добавлять к загруженным файлам расширение .html.
- -nc — указывает на то, что существующие файлы не будут перезаписаны — например, при продолжении ранее прерванной загрузки сайта.
Среди платных решений стоит выделить также: RoboTools (2$ — 250 стр), Teleport Pro ($50).
Итог
Скопировать любой сайт в 2021 году может абсолютно каждый пользователь, который даже не знает про программирование, код и прочее — для этого есть широкий выбор сервисов. Они отлично решают вопрос скачивания одностраничных лендингов, сохраняя их работоспособность, но далеко не всегда могут справиться с сложными сайтами.
Если вам нужен качественный сайт или его копия, то рекомендуем все же обратиться к специалистам — тогда значительно повысится вероятность, что все элементы будут корректно работать, сайт — выполнять свою задачу, а трафик — приносить вам деньги.
Чтобы не было сюрпризов, обязательно проверяйте работоспособность сайта перед работой со всех устройств!