
СТАНДОТКЛОНА (функция СТАНДОТКЛОНА)
Excel для Microsoft 365 Excel для Microsoft 365 для Mac Excel для Интернета Excel 2021 Excel 2021 для Mac Excel 2019 Excel 2019 для Mac Excel 2016 Excel 2016 для Mac Excel 2013 Excel 2010 Excel 2007 Excel для Mac 2011 Excel Starter 2010 Еще. Меньше
В этой статье описаны синтаксис формулы и использование функции СТАНДОТКЛОНА в Microsoft Excel.
Описание
Оценивает стандартное отклонение по выборке. Стандартное отклонение — это мера того, насколько широко разбросаны точки данных относительно их среднего.
Синтаксис
Аргументы функции СТАНДОТКЛОНА описаны ниже.
- Значение1,значение2. Аргумент «значение1» является обязательным, последующие значения необязательные. От 1 до 255 значений, соответствующих выборке из генеральной совокупности. Вместо аргументов, разделяемых точкой с запятой, можно использовать массив или ссылку на массив.
Замечания
- Функция СТАНДОТКЛОНА предполагает, что аргументы являются только выборкой из генеральной совокупности. Если данные представляют всю генеральную совокупность, то стандартное отклонение следует вычислять с помощью функции СТАНДОТКЛОНПА.
- Стандартное отклонение вычисляется с использованием «n-1» метода.
- Допускаются следующие аргументы: числа; имена, массивы или ссылки, содержащие числа; текстовые представления чисел; логические значения, такие как ИСТИНА и ЛОЖЬ, в ссылке.
- Аргументы, содержащие значение ИСТИНА, интерпретируются как 1; аргументы, содержащие текст или значение ЛОЖЬ, интерпретируются как 0 (ноль).
- Если аргументом является массив или ссылка, учитываются только значения массива или ссылки. Пустые ячейки и текст в массиве или ссылке игнорируются.
- Аргументы, представляющие собой значения ошибок или текст, не преобразуемый в числа, вызывают ошибку.
- Чтобы не включать логические значения и текстовые представления чисел в ссылку как часть вычисления, используйте функцию СТАНДОТКЛОН.
- Функция СТАНДОТКЛОНА вычисляется по следующей формуле: где x — выборочное среднее СРЗНАЧ(значение1,значение2,…), а n — размер выборки.
Пример
Скопируйте образец данных из следующей таблицы и вставьте их в ячейку A1 нового листа Excel. Чтобы отобразить результаты формул, выделите их и нажмите клавишу F2, а затем — клавишу ВВОД. При необходимости измените ширину столбцов, чтобы видеть все данные.
6. Формула для вычисления дисперсии.
Среднее квадратическое отклонение. Коэффициент вариации
В первой части урока мы рассмотрели размах вариации, среднее линейное отклонение и дисперсию, и продолжение темы в заголовке. Многие из этих показателей фигурируют в теории вероятностей, и если вы зашли с поисковика именно за ними, то сразу ссылка на нужную статью: Дисперсия дискретной случайной величины – там же всё остальное.
Ну а здесь на повестке дня Математическая статистика (организационный урок для «чайников»), и мы продолжаем изучать показатели вариации:
- Формула для вычисления дисперсии
- Среднее квадратическое отклонение, которое также называют среднеквадратическим или стандартным отклонением. Тут же исправленное среднее квадратическое отклонение.
- Коэффициент вариации
Всё с формулами, примерами решений и техникой рациональных вычислений.
И снова о дисперсии.
На предыдущем занятии мы рассчитывали дисперсию по определению:
– для несгруппированных данных и
– для дискретного либо интервального вариационного ряда.
Если известно, генеральная ли нам дана совокупность или выборочная, то хорошим тоном считается поставить подстрочные индексы: либо .
Расчёт дисперсии по определению прост и реально используется на практике, но существует ещё более простой и удобный способ вычисления – по формуле, которую несложно вывести из определения:
– дисперсия равна разности средней арифметической квадратов всех вариант статистической совокупности и квадрата средней самих этих вариант.
ОСМЫСЛЕННО повторяем ВСЛУХ и вникаем! … Карл украл у Клары кораллы, а Клара украла у Карла кларнет 🙂
Если что-то не очень понятно, то сейчас всё станет на свои места:
Для несгруппированных вариант выборочной совокупности формула детализируется следующим образом:
и для готового вариационного ряда – так:
, где – кратные (одинаковые) варианты дискретного ряда либо середины интервалов интервального ряда, а – соответствующие частоты.
Для генеральной дисперсии формулы те же, только с буквами вместо . Во многих случаях удобно использовать просто значок суммирования – без переменной-«счётчика», поскольку в контексте той или иной задачи и так понятно, что суммируется.
И начнём мы со знакомой подопытной задачи:
В результате 10 независимых измерений получены опытные данные, которые представлены в таблице:
Это данные из Примера 13, и на этот раз нам требуется вычислить дисперсию с помощью формулы. Напоминаю, что там мы её рассчитали по определению и получили результат , таким образом, ответ известен заранее, и это всегда круто. Всегда, когда он правильный.
Решение: используем формулу .
Для этого нужно найти выборочную среднюю, повторим действие: ,
вычислить квадраты всех вариант:

и их сумму:
Результаты вычислений удобно заносить в таблицу:
Осталось применить формулу:
, что и требовалось увидеть.
Ответ:
Теперь случай сформированного вариационного ряда. В Примере 14 мы потренировались на дискретном ряде, и сейчас очередь интервального:

С целью изучения вкладов в Сбербанке города проведено выборочное исследование, в результате которого получены следующие данные:
Вычислить выборочную дисперсию и среднее квадратическое отклонение, оценить соответствующие показатели генеральной совокупности.
Автор задачи заботливо подсчитал объем выборки , но не «закрыл» крайние интервалы. Такая вещь уже встречалась, и решение мы начинаем с этого закрытия. Поскольку длины внутренних интервалов составляют д.е., то логично рассмотреть такую же длину и по краям, то бишь, интервалы от 200 до 400 и от 1000 до 1200 денежных единиц.
…Возможно, у вас возник вопрос, а как быть, если даны интервалы разной длины? В этом случае принимаем за «эталон» среднюю длину известных интервалов.

Для расчёта числовых характеристик перейдём к дискретному вариационному ряду, выбрав в качестве вариант середины интервалов, которые здесь видны устно:
В тяжёлых случаях суммируем концы интервалов и делим их пополам, например: .
Кроме того, варианты целесообразно уменьшить в 1000 раз, поскольку в ходе дальнейших вычислений будут получаться гигантские числа. С современными вычислительными мощностями, это, конечно, не проблема, но смотреться будет некрасиво.

Сначала вычислим выборочную среднюю. Этот алгоритм уже обкатан: находим произведения , их сумму:
и по соответствующей формуле:
тыс. д.е. или 780 д.е. – средний размер вклада.
Примечание: далее для компактной записи я буду использовать просто значок – без переменной-«счётчика».
Теперь дисперсия. Её никто не запрещает рассчитать по определению , но заметьте, насколько легче формула – для её применения всего-то лишь нужно рассчитать произведения и их сумму (правый столбец таблицы). Несмотря на то, что многие читатели уже освоили технику вычислений в Экселе, я продолжу записывать ролики – мало ли, кто что запамятовал:
Итак, по формуле вычисления дисперсии, получаем:
тыс. д.е. в квадрате (т.к. по определению, дисперсия – есть величина квадратичная).
И, чтобы вернуться в размерность задачи, из дисперсии следует извлечь квадратный корень:
тыс. д.е. или 240 денежных единиц. Полученный показатель называется
среднее квадратическое отклонение
Или стандартное отклонение. Оно обозначается греческой буквой «сигма», и коль скоро у нас выборочная совокупность, то добавляем соответствующий подстрочный индекс:
– выборочное среднее квадратическое отклонение.
Чем меньше стандартное отклонение (и дисперсия), тем меньше вариация – тем бОльшее количество вариант находится вблизи выборочной средней. Но у нас, как нетрудно «прикинуть на глазок», разброс довольно-таки велик – значительное количество вкладов расположено далековато от , и поэтому значение получилось немалым.
Следующая часть задачи состоит в том, чтобы корректно оценить генеральную дисперсию и генеральное среднее квадратическое отклонение .
В 1-й части урока я рассказал о том, что выборочная дисперсия представляет собой смещённую оценку генеральной дисперсии. Это означает, что если мы будем проводить неоднократные выборки из той же генеральной совокупности, то полученные значения будут систематически занижено оценивать . Обращаю ваше внимание, что это не значит, что будет всегда меньше, чем .
И поэтому выборочную дисперсию, как намекает условие, нужно поправить:
– исправленная выборочная дисперсия
и, соответственно:
или 240,30 д.е. – исправленное среднее квадратическое отклонение.
и – это уже несмещённые оценки генеральной дисперсии и генерального стандартного отклонения соответственно.
Ввиду большого объёма выборки (более 100 вариант) этой поправкой можно пренебречь, но всё же мы не будем «разбрасываться» 30 «копейками».
Ответ: ; в качестве оценки соответствующих генеральных показателей принимаем и .
Рассмотренные выше показатели (размах вариации, среднее линейное отклонение, дисперсия, стандартное отклонение) входят в группу абсолютных показателей вариации, которые обладают рядом неудобств. Так, если в прорешанной задаче не уменьшать варианты в 1000 раз, то дисперсия получится в миллион раз больше! Да-да, не , а . И возникает естественное желание привести результаты к некому единому стандарту.
Для этого существуют показатели относительные, и самым известным из них является
коэффициент вариации
– это отношение стандартного отклонения к средней, выраженное в процентах:
И вот теперь совершенно без разницы, в д.е. мы считали:
или в тысячах д.е.:
Примечание: на практике часто считают именно через , но для оценки коэффициента вариации всей генеральной совокупности, конечно же, корректнее использовать исправленное стандартное отклонение .
В статистике существует следующий эмпирический ориентир:
– если показатель вариации составляет примерно 30% и меньше, то статистическая совокупность считается однородной. Это означает, что большинство вариант находится недалеко от средней, и найденное значение хорошо характеризует центральную тенденцию совокупности.
– если показатель вариации составляет существенно больше 30%, то совокупность неоднородна, то есть, значительное количество вариант находятся далеко от , и выборочная средняя плохо характеризует типичную варианту. В таких случаях целесообразно рассмотреть квартили, децили, а иногда и перцентили, которые делят вариационный ряд на части, и для каждого участка рассчитать свои показатели. Но это уже немного дебри статистики.
Другое преимущество относительных показателей – это возможность сравнивать разнородные статистические совокупности. Например, множество слонов и множество хомячков. Совершенно понятно, что дисперсия веса слонов по отношению к дисперсии веса хомяков будет просто конской, и их сопоставление не имеет смысла. Но вот анализ коэффициентов вариации веса вполне осмыслен, и может статься, что у слонов он составляет 10%, а у хомячков 40% (пример, конечно, условный). Это говорит о сбалансированном питании и размеренной жизни слонов. А вот хомяки там, то носятся с голодухи по полям, то отъедаются и спят в норах, и поэтому среди них есть много худощавых и много упитанных особей 🙂
Кроме коэффициента вариации, существуют и другие относительные показатели, но в реальных студенческих работах они почти не встречаются, и поэтому я не буду их рассматривать в рамках данного курса.
И сейчас, конечно же, задачки для самостоятельного решения:
Пример 17, на отработку терминов и формул:
а) Стандартное отклонение выборочной совокупности равно 5, а средний квадрат её вариант – 250. Найти выборочную среднюю.
б) Определите среднее квадратическое отклонение, если известно, что средняя равна 260, а коэффициент вариации составляет 30%.
и Пример 18, творческий:

Производство стальных труб на предприятии (тонн) в 1-м полугодии составило:
Определить:
– среднемесячный объем производства;
– среднее квадратическое отклонение;
– коэффициент вариации.
Сделать краткие содержательные выводы. – Да, это тоже типичный пункт статистической задачи!
Обратите внимание, что здесь не понятно, выборочной ли считать эту совокупность или генеральной. И в таких случаях лучше не заниматься домыслами, просто используем обозначения без подстрочных индексов.
Вообще, задачи на экономическую и промышленную тематику – самые популярные в статистике, и в моей коллекции их сотни. Но все они до ужаса однотипны, и поэтому я предлагаю их в терапевтической дозировке 🙂
Выполнить расчёты в Экселе – числа уже там, ну а инструкцию я на этот раз не привёл, поскольку люди вы уже опытные.
Краткое решение и ответ в конце урока, который подошёл к концу.
Следующее занятие не за горами, а уже за кочкой:
Решения и ответы:
Пример 17. Решение:
а) Используем формулу . По условию, , . Таким образом:
б) Используем формулу . По условию, , . Таким образом:

Пример 18. Решение: вычислим сумму вариант и сумму их квадратов:
Найдём среднюю:
тонны – среднемесячный объем производства за полугодие.
Дисперсию вычислим по формуле:
Среднее квадратическое отклонение:
тонн.
Коэффициент вариации:
Ответ: тонны, тонн,
Краткие выводы: за первое полугодие среднемесячный объём производства труб составил тонны. Низкие показатели вариации говорят о стабильной ситуации на производстве.
Автор: Емелин Александр
(Переход на главную страницу)

Zaochnik.com – профессиональная помощь студентам,
cкидкa 15% на первый зaкaз, при оформлении введите прoмoкoд: 5530-hihi5
© Copyright mathprofi.ru, Александр Емелин, 2010-2023. Копирование материалов сайта запрещено
Как рассчитать среднее и стандартное отклонение в Excel
Среднее значение представляет собой среднее значение в наборе данных. Это дает нам хорошее представление о том, где находится центр набора данных.
Стандартное отклонение показывает, насколько разбросаны значения в наборе данных. Это дает нам представление о том, насколько близко наблюдения сгруппированы вокруг среднего значения.
Используя только эти два значения, мы можем многое понять о распределении значений в наборе данных.
Чтобы вычислить среднее значение набора данных в Excel, мы можем использовать функцию = СРЗНАЧ (диапазон) , где диапазон — это диапазон значений.
Чтобы вычислить стандартное отклонение набора данных, мы можем использовать функцию =STDEV.S(Range) , где Range — это диапазон значений.
В этом руководстве объясняется, как использовать эти функции на практике.
Техническое примечание
Обе функции СТАНДОТКЛОН() и СТАНДОТКЛОН.С() вычисляют стандартное отклонение выборки .
Вы можете использовать функцию STDEV.P() для вычисления стандартного отклонения совокупности , если ваш набор данных представляет всю совокупность значений.
Однако в большинстве случаев мы работаем с выборочными данными, а не со всей совокупностью, поэтому мы используем функцию СТАНДОТКЛОН.С().
Пример 1: Среднее и стандартное отклонение одного набора данных
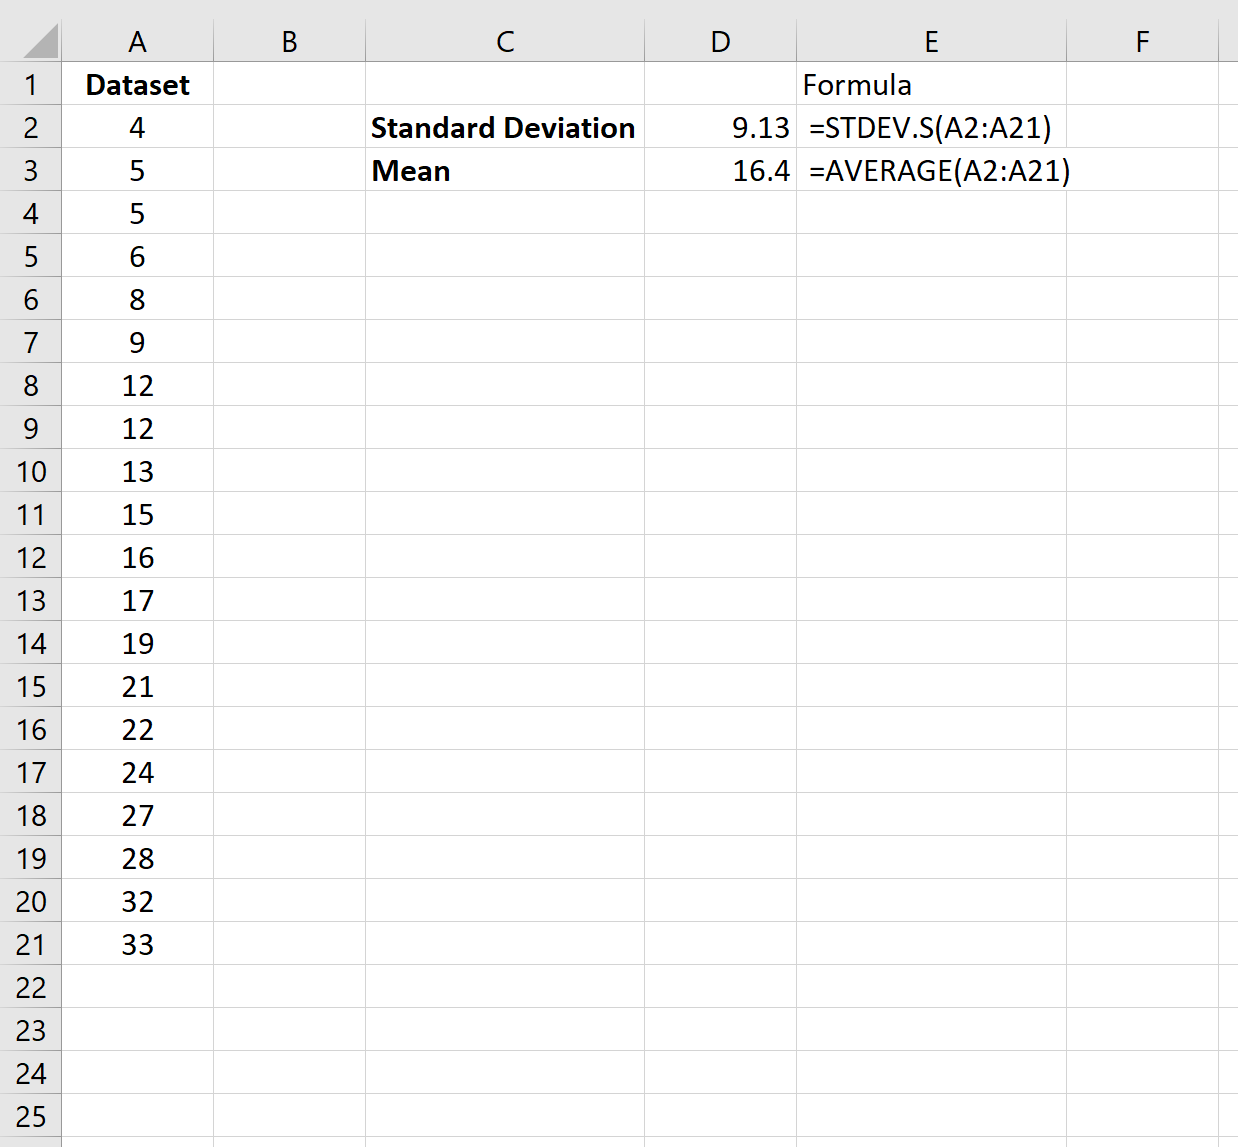
На следующем снимке экрана показано, как рассчитать среднее значение и стандартное отклонение одного набора данных в Excel:
Среднее значение набора данных составляет 16,4 , а стандартное отклонение — 9,13 .
Пример 2: Среднее и стандартное отклонение нескольких наборов данных
Предположим, у нас есть несколько наборов данных в Excel:
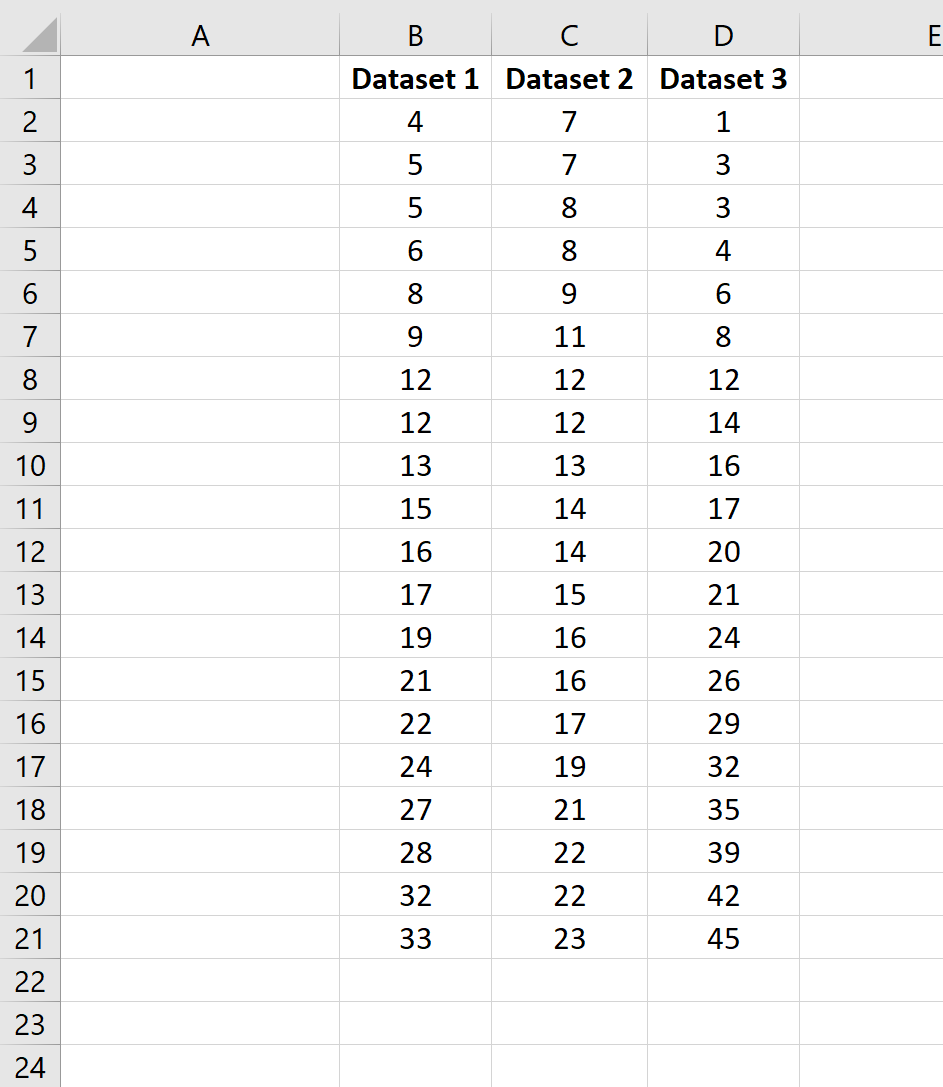
Чтобы вычислить среднее значение и стандартное отклонение первого набора данных, мы можем использовать следующие две формулы:
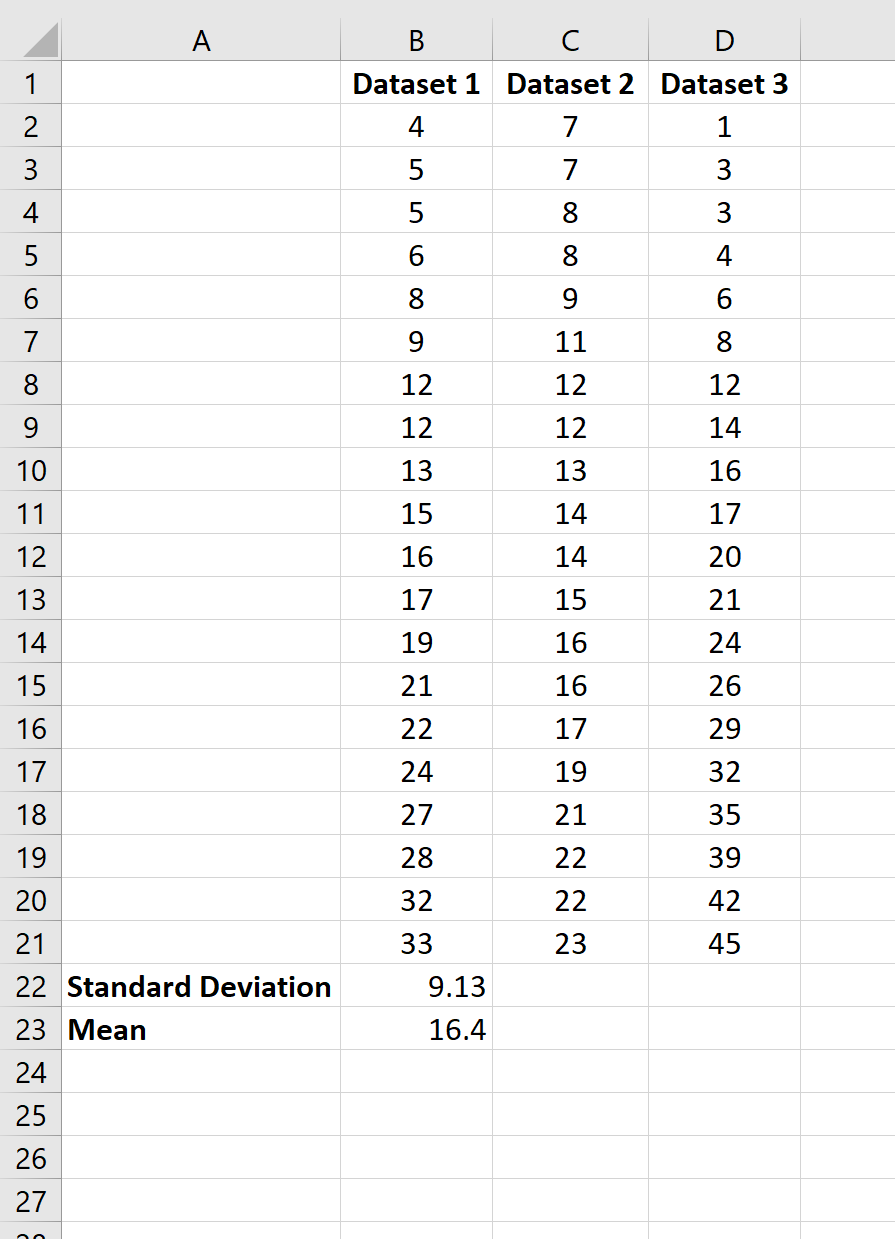
- Среднее значение: =СРЗНАЧ(B2:B21)
- Стандартное отклонение: =STDEV.S(B2:B21)
Затем мы можем выделить ячейки B22: B23 и навести указатель мыши на правый нижний угол ячейки B23, пока не появится крошечный +.Затем мы можем щелкнуть и перетащить формулы в следующие два столбца:
Разбираем формулы среднеквадратического отклонения и дисперсии в Excel
Цель данной статьи показать, как математические формулы, с которыми вы можете столкнуться в книгах и статьях, разложить на элементарные функции в Excel.
В данной статье мы разберем формулы среднеквадратического отклонения и дисперсии и рассчитаем их в Excel.
Перед тем как переходить к расчету среднеквадратического отклонения и разбирать формулу, желательно разобраться в элементарных статистических показателях и обозначениях.
Рассматривая формулы моделей прогнозирования, мы встретимся со следующими показателями:
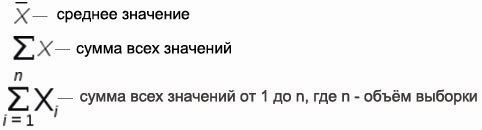
Например, у нас есть временной ряд — продажи по неделям в шт.
Для этого временного ряда i=1, n=10 , ,
Рассмотрим формулу среднего значения:
Для нашего временного ряда определим среднее значение
Также для выявления тенденций помимо среднего значения представляет интерес и то, насколько наблюдения разбросаны относительно среднего. Среднеквадратическое отклонение показывает меру отклонения наблюдений относительно среднего.
Формула расчета среднеквадратического отклонение для выборки следующая:
Разложим формулу на составные части и рассчитаем среднеквадратическое отклонение в Excel на примере нашего временного ряда.
1. Рассчитаем среднее значение для этого воспользуемся формулой Excel =СРЗНАЧ(B11:K11)
= СРЗНАЧ(ссылка на диапазон) = 100/10=10
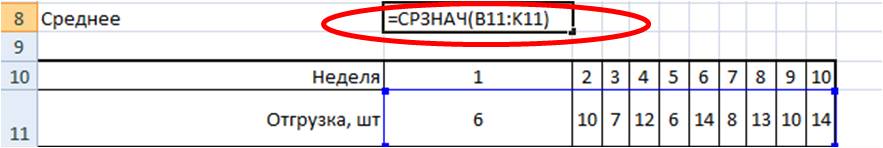

2. Определим отклонение каждого значения ряда относительно среднего
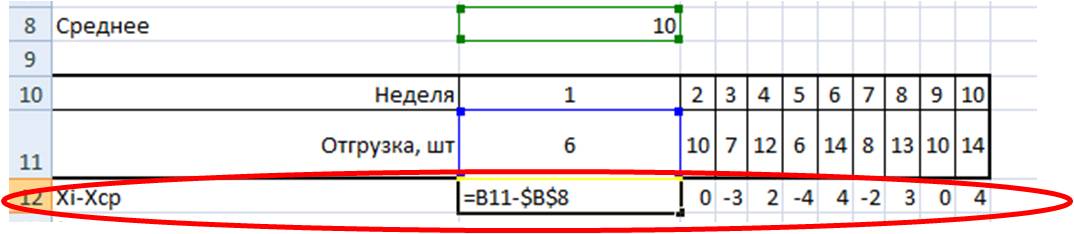
для первой недели = 6-10=-4
для второй недели = 10-10=0
для третей = 7-1=-3 и т.д.
3. Для каждого значения ряда определим квадрат разницы отклонения значений ряда относительно среднего
для первой недели = (-4)^2=16
для второй недели = 0^2=0
для третей = (-3)^2=9 и т.д.
4. Рассчитаем сумму квадратов отклонений значений относительно среднего с помощью формулы =СУММ(ссылка на диапазон (ссылка на диапазон с )
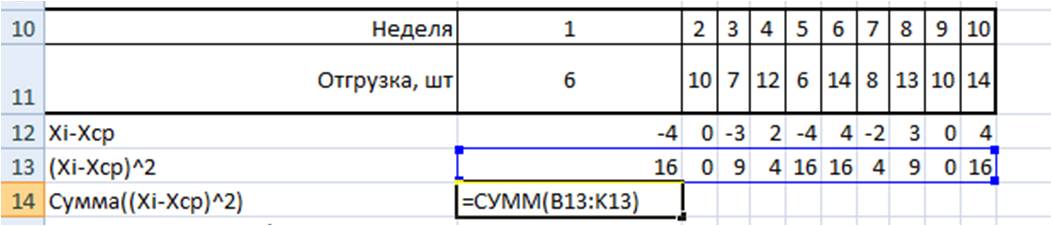
=16+0+9+4+16+16+4+9+0+16=90
5. , для этого сумму квадратов отклонений значений относительно среднего разделим на количество значений минус единица (Сумма((Xi-Xср)^2))/(n-1)
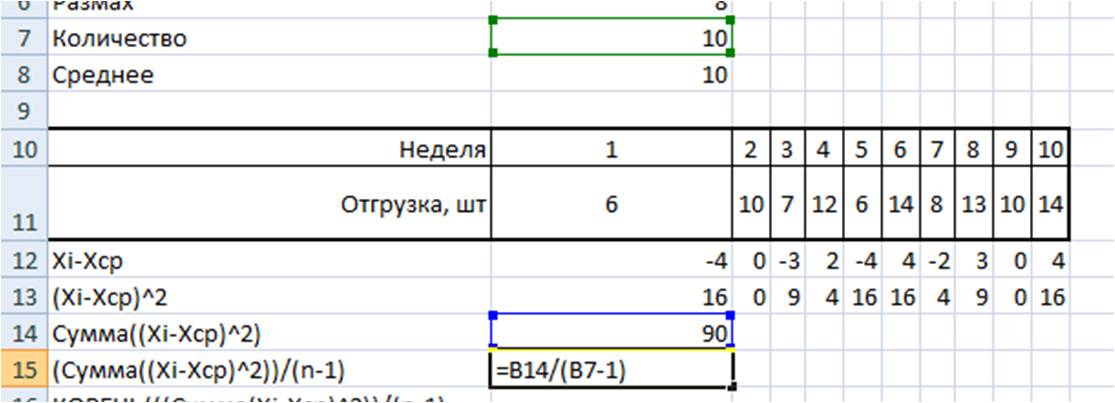
= 90/(10-1)=10
6. Среднеквадратическое отклонение равно = корень(10)=3,2
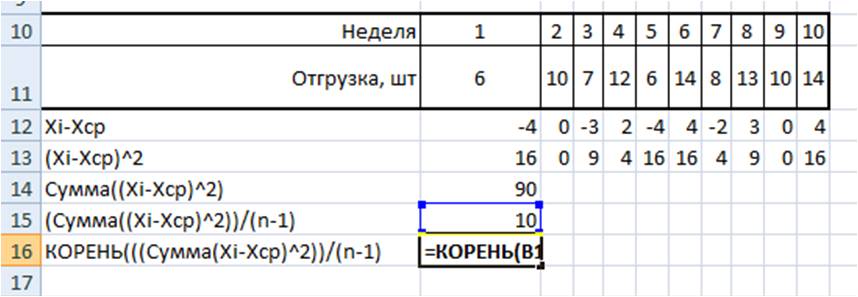
Итак, в 6 шагов мы разложили сложную математическую формулу, надеюсь вам удалось разобраться со всеми частями формулы и вы сможете самостоятельно разобраться в других формулах.
Рассмотрим еще один показатель, который в будущем нам понадобятся — дисперсия.
Как рассчитать дисперсию в Excel?
Дисперсия — квадрат среднеквадратического отклонения и отражает разброс данных относительно среднего.
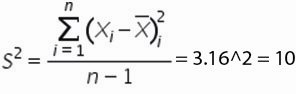
Рассчитаем дисперсию:
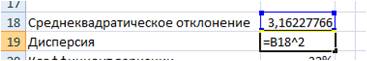
Итак, теперь мы умеем рассчитывать среднеквадратическое отклонение и дисперсию в Excel. Надеемся, полученные знания пригодятся вам в работе.
Точных вам прогнозов!
Присоединяйтесь к нам!
Скачивайте бесплатные приложения для прогнозирования и бизнес-анализа:
- Novo Forecast Lite — автоматический расчет прогноза в Excel .
- 4analytics — ABC-XYZ-анализ и анализ выбросов в Excel.
- Qlik Sense Desktop и QlikView Personal Edition — BI-системы для анализа и визуализации данных.
Тестируйте возможности платных решений:
- Novo Forecast PRO — прогнозирование в Excel для больших массивов данных.
Получите 10 рекомендаций по повышению точности прогнозов до 90% и выше.