
Мне нужно ускорить рекурсию
Мне задали решить задачу. Я написал код, но он работает медленно. Мне нужно ускорить рекурсию. Если n будет равен даже 70 расчеты займет очень много времени. Помогите мне улучшить мой код. Максимальное n может быть 500!
def a(n): if n == 1: return 1 if n == 2: return 2 return 1 + a(n - a(a(n - 1))) Отслеживать
задан 29 окт 2020 в 19:01
130 15 15 бронзовых знаков
вы бы еще сказали что эта рекурсия делает, может можно было бы обойтись и без рекурсии
29 окт 2020 в 19:05
2 ответа 2
Сортировка: Сброс на вариант по умолчанию
дело в том, что функция a(n) вызывается многократно, а значит рекурсий больше, чем нужно
можно вычислить a(n) однократно и дальше только использовать уже вычисленные значения
res = [0 for _ in range(1000)] def a(n): if res[n] == 0: if n > 2: res[n] = 1 + a(n - a(a(n - 1))) elif n == 1: res[n] = 1 elif n == 2: res[n] = 2 return res[n] print(a(900)) a(900) работает мгновенно, так что можно считать это оптимизацией 🙂
только учтите одну важную вещь, я не знаю как у питона, но при рекурсии у того же c++ вызовы запихиваются в стек и стек может просто переполниться
в моем примере при n = 1000 питон уже ругается
RecursionError: maximum recursion depth exceeded in comparison P.S.
в коде много if, поэтому лучше сделать ее покороче
res = [0, 1, 2] + [0 for _ in range(10)] def a(n): if res[n] == 0: res[n] = 1 + a(n - a(a(n - 1))) return res[n] print(a(10)) да и вообще зачем нам эти if?
res = [0, 1, 2] + [0 for _ in range(20)] def a(n): res[n] = res[n] or (1 + a(n - a(a(n - 1)))) return res[n] print(res) Мемоизация в Python для ускорения медленных функций
В данном руководстве мы рассмотрим использование функций lru_cache и cache для оптимизации расчетов в функциях Python.
Введение
Мемоизация — это техника оптимизации, которая ускоряет работу программ за счет кэширования результатов предыдущих вызовов функций. Это позволяет последующим вызовам повторно использовать кэшированные результаты, избегая трудоемкого пересчета.
Числа Фибоначчи
Числа Фибоначчи — это последовательность целых чисел, где каждое число является суммой двух предыдущих чисел, начиная с чисел 0 и 1.
Функция, которая вычисляет n-ое число Фибоначчи, часто реализуется рекурсивно.
Посмотрим на пример реализации
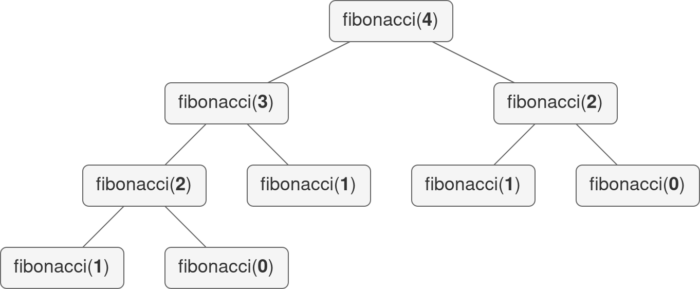
def fibonacci(n): if nВызовы функций fibonacci(4) можно визуализировать с помощью дерева рекурсии.
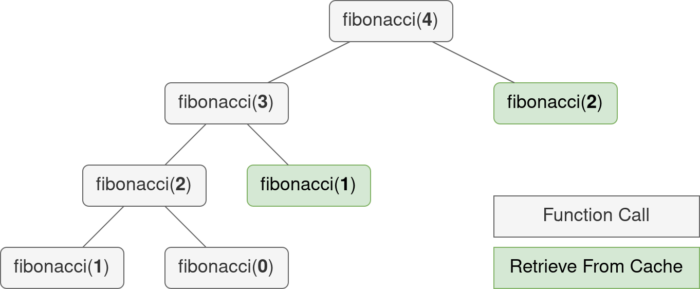
Обратите внимание, что функция вызывается с одним и тем же входом несколько раз. В частности, fibonacci(2) вычисляется с нуля дважды. По мере увеличения входных данных время работы растет экспоненциально. Это неоптимальный вариант, который можно значительно улучшить с помощью мемоизации.
Мемоизация в Python
В Python 3 запоминать функции невероятно просто. Модуль functools, входящий в стандартную библиотеку Python, предоставляет два полезных декоратора для мемоизации: lru_cache (новый в Python 3.2) и cache (новый в Python 3.9). Эти декораторы используют кэш с наименьшим последним использованием (LRU), который хранит элементы в порядке их использования, отбрасывая наименее недавно использованные элементы, чтобы освободить место для новых.
Чтобы избежать дорогостоящих повторных вызовов функций, fibonacci может быть обернут lru_cache, который сохраняет значения, которые уже были вычислены. Предельный размер lru_cache можно задать с помощью параметра maxsize, значение которого по умолчанию равно 128.
from functools import lru_cache @lru_cache(maxsize=64) def fibonacci(n): if nТеперь дерево рекурсии для fibonacci(4) не имеет узлов, которые встречаются более двух раз. Время работы теперь растет линейно, что гораздо быстрее экспоненциального роста.
Декоратор cache эквивалентен lru_cache(maxsize=None).
from functools import cache @cache def fibonacci(n): if nПоскольку cache не нуждается в отбрасывании последних использованных элементов, он одновременно меньше и быстрее, чем lru_cache с ограничением размера.
Заключение
Мемоизация повышает производительность за счет кэширования результатов вызовов функций и возврата кэшированного результата при повторном вызове функции с теми же входными данными.
Python 3 позволяет легко реализовать мемоизацию. Просто импортируйте lru_cache или cache из functools и примените декоратор.
Устранение рекурсии в Python
Привет, Хабр! Представляю вашему вниманию перевод статьи "Removing a recursion in Python, part 1" автора Эрика Липперта (Eric Lippert).
На протяжении последних 20 лет я восхищался простоте и возможностям Python, хотя на самом деле никогда не работал с ним и не изучал подробно.
В последнее время я присмотрелся к нему поближе — и он оказался действительно приятным языком.
Недавний вопрос на StackOverflow заставил меня задуматься, как преобразовать рекурсивный алгоритм в итеративный, и оказалось, что Python довольно подходящий язык для этого.
Проблема с которой столкнулся автор вопроса заключалась в следующем:
- Игрок находится в произвольной клетке на пронумерованном поле;
- Цель вернуться в клетку №1;
- Если игрок находится на чётной клетке, он платит одну монету и проходит половину пути к клетке №1;
- Если игрок находится на нечётной клетке, он может заплатить 5 монет и сразу перейти на первую клетку или заплатить одну монету и сделать один шаг к клетке №1 — на чётную клетку.
Вопрос заключается в следующем: какое наименьшее количество монет необходимо заплатить, чтобы вернуться из текущей клетки в первую.
Задача имеет очевидное рекурсивное решение:
def cost(s): if s Однако эта программа падала, достигая максимальной глубины рекурсии, вероятнее всего из-за того, что автор вопроса экспериментировал с очень большими числами.
Следовательно возникает вопрос: как превратить рекурсивный алгоритм в итерационный на Python?
Перед тем как мы начнем, хочу отметить, что конечно существуют более быстрые решения этой конкретной задачи, сама по себе она не очень интересна.
Скорее эта задача послужила лишь отправной точкой в вопросе, как в общем случае избавиться от единственного рекурсивного вызова в программе на Python.
Смысл в том, что можно преобразовать любой простой рекурсивный метод и избавиться от рекурсии, а это всего лишь пример, который оказался под рукой.
Техника, которую я собираюсь показать, конечно не совсем соответствует тому, как принято писать на Python, вероятно решение в Python-стиле использовало бы генераторы или другие возможности языка.
Что я хочу показать здесь, так это как избавиться от рекурсии, используя последовательность маленьких и безопасных преобразований, приводящих функцию к такой форме, в которой легко произвести замену рекурсии на итерацию.
Для начала давайте посмотрим как привести программу к такой форме.
На первом шаге нашего преобразования я хочу чтобы вычисления производимые до рекурсивного вызова сводились к вычислению аргумента, а вычисления, после рекурсивного вызова, производились в отдельном методе, который принимает результат рекурсивного вызова.
def add_one(n): return n + 1 def get_min(n): return min(n + 1, 5) def cost(s): if s Вторым шагом я хочу вынести вычисление аргумента в отдельную функцию:
# . def get_argument(s): if s % 2 == 0: return s // 2 return s - 1 def cost(s): if s На третьем шаге, я хочу добавить вспомогательную функцию, которая будет выбирать функцию-продолжение, вызываемую после возврата из рекурсии.
Обратите внимание, что вспомогательная функция возвращает функцию.
#. def get_after(s): if s % 2 == 0: return add_one return get_min def cost(s): if s Теперь запишем это в более общей и краткой форме:
#. def is_base_case(s): return s Видно, что каждое проделанное изменение сохраняло смысл программы.
Сейчас проверка на чётность числа выполняется дважды, хотя до изменений проверка была одна.
Если мы захотим, то можем решить эту проблему объединив две вспомогательные функции в одну, возвращающую кортеж.
Но давайте не будем беспокоиться об этом в рамках решения этой задачи.
Мы свели наш рекурсивный метод до максимально общей формы.
- В базовом случае:
- вычисляем значение, которое нужно вернуть;
- возвращаем его.
- вычисляем аргумент рекурсии;
- производим рекурсивный вызов;
- вычисляем возвращаемое значение;
- возвращаем его.
Кое-что важное на что необходимо обратить внимание на этом шаге — это то, что after не должен сам содержать вызовов cost .
Способ, который я показываю здесь, удаляет единственный рекурсивный вызов.
Если у вас 2 и более рекурсии, то нам понадобится другое решение.
Как только мы привели наш рекурсивный алгоритм к такой форме, преобразовать его в итеративный уже просто.
Хитрость в том, чтобы представить, что происходит в рекурсивной программе.
Как мы делаем рекурсивный спуск: мы вызываем get_argument перед рекурсивным вызовом и вызываем функцию after после возврата из рекурсии.
То есть, все вызовы get_argument происходят перед всеми вызовами after.
Поэтому мы можем преобразовать это в 2 цикла: первый вызывает get_argument и формирует список функций after, а второй вызывает все функции after:#. def cost(s): # Создаём стек из функций "after". Все эти функции # принимают результат рекурсивного вызова и возвращают # значение, которое вычисляет рекурсивный метод. afters = [ ] while not is_base_case(s): argument = get_argument(s) after = get_after(s) afters.append(after) s = argument # Теперь у нас есть стек функций "after" : result = base_case_value(s) while len(afters) != 0: after = afters.pop() result = after(result) return resultБольше никакой рекурсии!
Выглядит как магия, но все что мы здесь делаем — то же самое, что делала рекурсивная версия программы и в том же порядке.
Этот пример отражает мысль, которую я часто повторяю о стеке вызовов: его цель сообщить то, что произойдёт дальше, а не то, что уже произошло!
Единственная полезная информация в стеке вызовов в рекурсивной версии программы — это какое значение имеет after, поскольку эта функция вызывается следующей, а все остальное на стеке не важно.
Вместо использования стека вызовов, как неэффективного и громоздкого способа хранения стека after, мы можем просто хранить стек функций after.
В следующий раз мы рассмотрим более сложный способ удаления рекурсии на Python.
Как ускорить рекурсию питон
Напомним, что в математике факториал числа n определяется как Например, Ясно, что факториал можно легко посчитать, воспользовавшись циклом for. Представим, что нам нужно в нашей программе вычислять факториал разных чисел несколько раз (или в разных местах кода). Конечно, можно написать вычисление факториала один раз, а затем используя Copy-Paste вставить его везде, где это будет нужно.
# вычислим 3! res = 1 for i in range(1, 4): res *= i print(res) # вычислим 5! res = 1 for i in range(1, 6): res *= i print(res)
Однако, если мы ошибёмся один раз в начальном коде, то потом эта ошибка попадёт в код во все места, куда мы скопировали вычисление факториала. Да и вообще, код занимает больше места, чем мог бы. Чтобы избежать повторного написания одной и той же логики, в языках программирования существуют функции.
Функции — это такие участки кода, которые изолированы от остальный программы и выполняются только тогда, когда вызываются. Вы уже встречались с функциями sqrt(), len() и print(). Они все обладают общим свойством: они могут принимать параметры (ноль, один или несколько), и они могут возвращать значение (хотя могут и не возвращать). Например, функция sqrt() принимает один параметр и возвращает значение (корень числа). Функция print() принимает переменное число параметров и ничего не возвращает.
Покажем, как написать функцию factorial(), которая принимает один параметр — число, и возвращает значение — факториал этого числа.
def factorial(n): res = 1 for i in range(1, n + 1): res *= i return res print(factorial(3)) print(factorial(5))
Дадим несколько объяснений. Во-первых, код функции должен размещаться в начале программы, вернее, до того места, где мы захотим воспользоваться функцией factorial(). Первая строчка этого примера является описанием нашей функции. factorial — идентификатор, то есть имя нашей функции. После идентификатора в круглых скобках идет список параметров, которые получает наша функция. Список состоит из перечисленных через запятую идентификаторов параметров. В нашем случае список состоит из одной величины n. В конце строки ставится двоеточие.
Далее идет тело функции, оформленное в виде блока, то есть с отступом. Внутри функции вычисляется значение факториала числа n и оно сохраняется в переменной res. Функция завершается инструкцией return res, которая завершает работу функции и возвращает значение переменной res.
Инструкция return может встречаться в произвольном месте функции, ее исполнение завершает работу функции и возвращает указанное значение в место вызова. Если функция не возвращает значения, то инструкция return используется без возвращаемого значения. В функциях, которым не нужно возвращать значения, инструкция return может отсутствовать.
Приведём ещё один пример. Напишем функцию max(), которая принимает два числа и возвращает максимальное из них (на самом деле, такая функция уже встроена в Питон).
10 20
def max(a, b): if a > b: return a else: return b print(max(3, 5)) print(max(5, 3)) print(max(int(input()), int(input())))
Теперь можно написать функцию max3(), которая принимает три числа и возвращает максимальное их них.
def max(a, b): if a > b: return a else: return b def max3(a, b, c): return max(max(a, b), c) print(max3(3, 5, 4))
Встроенная функция max() в Питоне может принимать переменное число аргументов и возвращать максимум из них. Приведём пример того, как такая функция может быть написана.
def max(*a): res = a[0] for val in a[1:]: if val > res: res = val return res print(max(3, 5, 4))
Все переданные в эту функцию параметры соберутся в один кортеж с именем a, на что указывает звёздочка в строке объявления функции.
2. Локальные и глобальные переменные
Внутри функции можно использовать переменные, объявленные вне этой функции
def f(): print(a) a = 1 f()
Здесь переменной a присваивается значение 1, и функция f() печатает это значение, несмотря на то, что до объявления функции f эта переменная не инициализируется. В момент вызова функции f() переменной a уже присвоено значение, поэтому функция f() может вывести его на экран.
Такие переменные (объявленные вне функции, но доступные внутри функции) называются глобальными.
Но если инициализировать какую-то переменную внутри функции, использовать эту переменную вне функции не удастся. Например:
def f(): a = 1 f() print(a)
Получим ошибку NameError: name 'a' is not defined . Такие переменные, объявленные внутри функции, называются локальными. Эти переменные становятся недоступными после выхода из функции.
Интересным получится результат, если попробовать изменить значение глобальной переменной внутри функции:
def f(): a = 1 print(a) a = 0 f() print(a)
Будут выведены числа 1 и 0. Несмотря на то, что значение переменной a изменилось внутри функции, вне функции оно осталось прежним! Это сделано в целях “защиты” глобальных переменных от случайного изменения из функции. Например, если функция будет вызвана из цикла по переменной i , а в этой функции будет использована переменная i также для организации цикла, то эти переменные должны быть различными. Если вы не поняли последнее предложение, то посмотрите на следующий код и подумайте, как бы он работал, если бы внутри функции изменялась переменная i.
def factorial(n): res = 1 for i in range(1, n + 1): res *= i return res for i in range(1, 6): print(i, '! = ', factorial(i), sep='')
Если бы глобальная переменная i изменялась внутри функции, то мы бы получили вот что:
5! = 1 5! = 2 5! = 6 5! = 24 5! = 120
Итак, если внутри функции модифицируется значение некоторой переменной, то переменная с таким именем становится локальной переменной, и ее модификация не приведет к изменению глобальной переменной с таким же именем.
Более формально: интерпретатор Питон считает переменную локальной для данной функции, если в её коде есть хотя бы одна инструкция, модифицирующая значение переменной, то эта переменная считается локальной и не может быть использована до инициализации. Инструкция, модифицирующая значение переменной — это операторы = , += , а также использование переменной в качестве параметра цикла for . При этом даже если инструкция, модицифицирующая переменную никогда не будет выполнена, интерпретатор это проверить не может, и переменная все равно считается локальной. Пример:
def f(): print(a) if False: a = 0 a = 1 f()
Возникает ошибка: UnboundLocalError: local variable 'a' referenced before assignment . А именно, в функции f() идентификатор a становится локальной переменной, т.к. в функции есть команда, модифицирующая переменную a , пусть даже никогда и не выполняющийся (но интерпретатор не может это отследить). Поэтому вывод переменной a приводит к обращению к неинициализированной локальной переменной.
Чтобы функция могла изменить значение глобальной переменной, необходимо объявить эту переменную внутри функции, как глобальную, при помощи ключевого слова global :
def f(): global a a = 1 print(a) a = 0 f() print(a)
В этом примере на экран будет выведено 1 1, так как переменная a объявлена, как глобальная, и ее изменение внутри функции приводит к тому, что и вне функции переменная будет доступна.
Тем не менее, лучше не изменять значения глобальных переменных внутри функции. Если ваша функция должна поменять какую-то переменную, пусть лучше она вернёт это значением, и вы сами при вызове функции явно присвоите в переменную это значение. Если следовать этим правилам, то функции получаются независимыми от кода, и их можно легко копировать из одной программы в другую.
Например, пусть ваша программа должна посчитать факториал вводимого числа, который вы потом захотите сохранить в переменной f. Вот как это не стоит делать:
def factorial(n): global f res = 1 for i in range(2, n + 1): res *= i f = res n = int(input()) factorial(n) # дальше всякие действия с переменной f
Этот код написан плохо, потому что его трудно использовать ещё один раз. Если вам завтра понадобится в другой программе использовать функцию «факториал», то вы не сможете просто скопировать эту функцию отсюда и вставить в вашу новую программу. Вам придётся поменять то, как она возвращает посчитанное значение.
Гораздо лучше переписать этот пример так:
# начало куска кода, который можно копировать из программы в программу def factorial(n): res = 1 for i in range(2, n + 1): res *= i return res # конец куска кода n = int(input()) f = factorial(n) # дальше всякие действия с переменной f
Если нужно, чтобы функция вернула не одно значение, а два или более, то для этого функция может вернуть список из двух или нескольких значений:
return [a, b]
Тогда результат вызова функции можно будет использовать во множественном присваивании: