
SQL-Ex blog
Как думать подобно SQL Server: использование статистики при построении планов запроса
Добавил smois on Суббота, 14 марта. 2020
В последнем случае SQL Server выбирал между поиском по индексу и сканированием таблицы, балансируя вокруг точки перехода, чтобы выяснить, какой из вариантов будет более эффективным для выполнения запроса.
- К каким таблицам пытается обратиться ваш запрос (что может быть скрыто за представлениями, функциями и вложениями).
- Как много строк будет возвращено из таблиц, которые вы фильтруете.
- Сколько строк будет затем возвращено из других соединяемых таблиц.
- Какие индексы имеются на всех этих таблицах.
- Какие индексы должны быть обработаны в первую очередь.
- Каким образом должен осуществляться доступ к этим индексам (поиск или сканирование).
- Как должны соединяться данные этих таблиц.
- Сколько памяти потребуется каждому оператору.
- Имеет ли смысл выделять несколько ядер CPU на каждый оператор.
Чтобы принять эти решения, SQL Server использует статистику.
Каждый индекс имеет связанную с ним статистику с тем же именем, и каждая статистика представляет собой единственную 8-килобайтную страницу метаданных, которые описывают содержание ваших индексов. Статистика существует вечно (и, по большей части, не менялась), так что это одно из тех мест документации SQL Server, которое действительно блестит: Books Online содержит тонну информации о статистике. Вам, честно говоря, не нужно знать её большую часть — но если вы хотите сделать вдумчивую настройку производительности, там есть масса отличного материала.
А сейчас давайте просто остановимся и почитаем содержимое нашей статистики с помощью DBCC SHOW_STATISTICS:
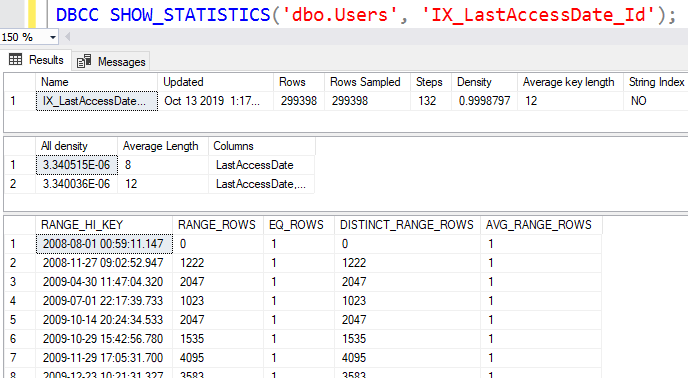
Я не ожидаю, что вы знаете об этой команде или используете её часто (если вообще используете), но знание хотя бы того, что здесь происходит, начнет формировать ваше представление о том, как выполняется запрос.
- Updated — дата/время последнего обновления этой статистики, либо автоматически, либо с помощью заданий обслуживания индексов.
- Rows — число строк в объекте на время обновления статистики.
- Rows Sampled — как и в политике, с ростом численности населения SQL Server прибегает к выборке, чтобы получить общее представление о том, что представляет собой население.
Гистограммы кажутся сложными, но не все так плохо. Я проведу вас по первым двум строкам:
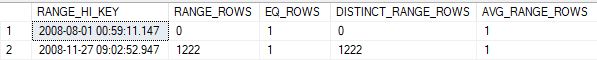
Каждая строка подобна ведру.
Первая строка сообщает: «Первое значение LastAccessDate — 1 августа 2008 года около полуночи. Этой дате соответствует точно одна строка.»
- Range_Hi_Key = 2008-11-27 — это означает, что в ведре находятся все пользователи, для которых LastAccessDate > значения для предыдущего ведра (2008-08-01) и до значения 2008-11-27 включительно.
- Eq_Rows — только у одного пользователя LastAccessDate = 2008-11-27 09:02:52:947.
- Range_Rows — в этом ведре находится еще 1222 других строк.
- Distinct_Range_Rows — все из этих 1222 строк имеют отличные значения LastAccessDates. Это возможно, т.к. пользователи не логинятся одновременно.
- Avg_Range_Rows — для любого заданного значения в этом диапазоне имеется только одна совпадающая строка. Поэтому, если вы фильтруете, например, так WHERE LastAccessDate = ‘2008-10-15’, то SQL Server будет давать оценку 1 для соответствующих строк.
Вот откуда берется значение Estimated Number of Rows.
Для вашего запроса:
SELECT LastAccessDate, Id, DisplayName, Age
FROM dbo.Users
WHERE LastAccessDate > '2018-09-02 04:00'
ORDER BY LastAccessDate;
SQL Server открывает гистограмму и выполняет ее скроллинг вниз, чтобы найти знания о данных на момент последнего обновления статистики:
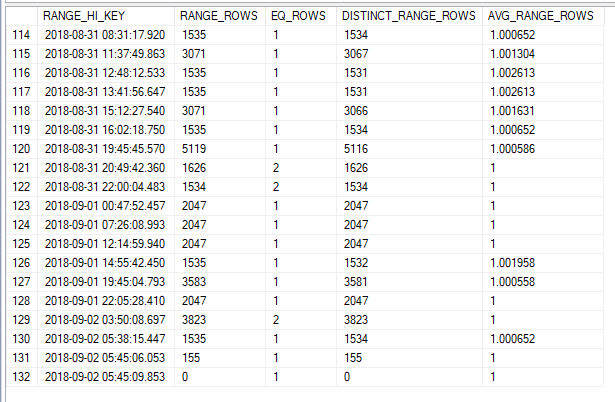
Он доходит до конца и говорит: «Итак, мы ищем 2018-09-02 04:00. У меня нет именно такого ведра, но я знаю, что:
- Некоторые строки в ряду 130 могут соответствовать.
- Все строки в рядах 131 и 132 будут соответствовать.
Он суммирует данные и выдает примерное количество строк. Чтобы увидеть его, наведите мышку на Index Seek и посмотрите внизу справа:
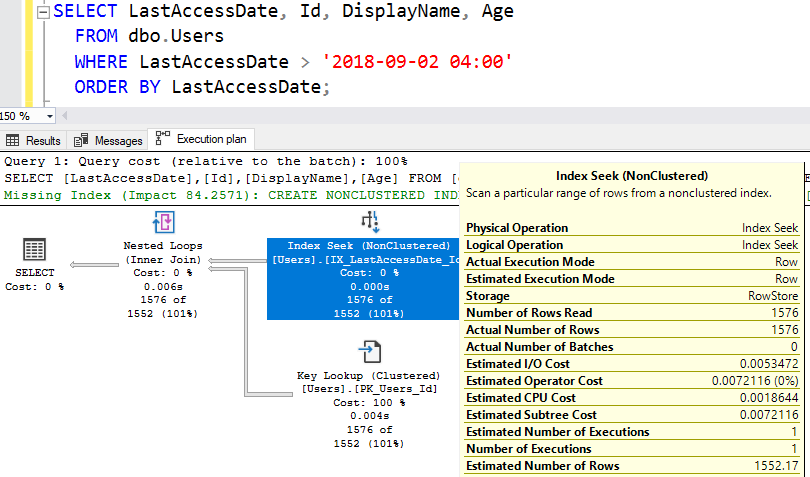
Это довольно хорошая оценка: 1552 строк при фактическом числе возвращаемых строк 1576. Хорошая работа, SQL Server.
Чем проще SQL Server’у интерпретировать ваш запрос, тем лучше он работает. Если ваш запрос пытается все спрятать, используя функции или сравнения, тогда все меняется, что мы увидим в следующем выпуске.
Темпоральные таблицы
Темпоральные таблицы (также известные, как темпоральные таблицы с системным управлением версиями) являются компонентом базы данных, который позволяет предоставлять данные, хранящиеся в таблице, в любой момент времени, а не только в текущий.
Что такое темпоральная таблица с системным управлением версиями?
Темпоральная таблица с системным управлением версиями — это тип пользовательской таблицы, предназначенный для ведения журнала всех изменений данных, что позволяет легко выполнять анализ для определенной точки во времени. Этот тип темпоральной таблицы называется временной таблицей с системным управлением версиями, так как периодом действия каждой строки управляет система (т. е. ядро СУБД).
В каждой темпоральной таблице есть два явно определенных столбца, каждый из которых имеет тип данных datetime2 . Эти столбцы называются столбцами периода. Столбцы периода используются исключительно системой для записи периода действия каждой строки при ее изменении. Главная таблица, в которой хранятся текущие данные, называется текущей таблицей, или просто темпоральной таблицей.
Помимо столбцов периода, в темпоральной таблице также содержится ссылка на другую таблицу с отзеркаленной схемой, которая называется таблицей журнала. Она используется в системе для автоматического сохранения предыдущей версии строки при каждом ее обновлении или удалении в темпоральной таблице. Во время создания темпоральной таблицы можно указать существующую таблицу журнала (соответствующую схеме) или позволить системе создать таблицу журнала по умолчанию.
Зачем нужны темпоральные таблицы?
Реальные источники данных являются динамическими, и в бизнес-решениях чаще всего используются сведения, которые аналитики могут получить из развития данных. Варианты использования темпоральных таблиц включают следующее.
- Аудит всех изменений данных и выполнение экспертизы данных при необходимости.
- Восстановление состояния данных на любой момент времени в прошлом.
- Вычисление тенденций во времени.
- Поддержка медленно изменяющегося измерения для приложений, связанных с поддержкой принятия решений.
- Восстановление после случайных данных изменений и ошибок приложений.
Как работают темпоральные таблицы?
Системное управление версиями для таблицы реализовано в виде пары таблиц — текущей таблицы и таблицы журнала. В каждой из этих таблиц используются два дополнительных столбца datetime2 для определения периода действия каждой строки:
- Столбец начала периода: система записывает время начала строки в этом столбце, обычно обозначаемую ValidFrom как столбец.
- Конечный столбец периода: система записывает время окончания строки в этом столбце, обычно обозначаемую ValidTo как столбец.
В текущей таблице содержится текущее значение для каждой строки. В таблице журнала содержатся все предыдущие значения (старые версии) для каждой строки и время начала и окончания промежутка, в котором действовали эти значения (если они заданы).
В следующем скрипте описан сценарий с данными сотрудника:
CREATE TABLE dbo.Employee ( [EmployeeID] INT NOT NULL PRIMARY KEY CLUSTERED, [Name] NVARCHAR(100) NOT NULL, [Position] VARCHAR(100) NOT NULL, [Department] VARCHAR(100) NOT NULL, [Address] NVARCHAR(1024) NOT NULL, [AnnualSalary] DECIMAL(10, 2) NOT NULL, [ValidFrom] DATETIME2 GENERATED ALWAYS AS ROW START, [ValidTo] DATETIME2 GENERATED ALWAYS AS ROW END, PERIOD FOR SYSTEM_TIME(ValidFrom, ValidTo) ) WITH (SYSTEM_VERSIONING = ON (HISTORY_TABLE = dbo.EmployeeHistory)); - Вставка. Система задает значение ValidFrom столбца на время начала текущей транзакции (в часовом поясе UTC) на основе системных часов и назначает значение ValidTo столбца максимальному значению 9999-12-31 . При этом строка помечается как открытая.
- Обновления: Система сохраняет предыдущее значение строки в таблице журнала и задает для ValidTo столбца время начала текущей транзакции (в часовом поясе UTC) на основе системных часов. При этом строка помечается как закрытая с записью периода, в течение которого строка была действительной. В текущей таблице строка обновляется со своим новым значением, а система задает значение ValidFrom столбца для времени начала транзакции (в часовом поясе UTC) на основе системных часов. Значение обновленной строки в текущей таблице столбца ValidTo остается максимальным. 9999-12-31
- Удаляет: система сохраняет предыдущее значение строки в таблице журнала и задает значение ValidTo для столбца время начала текущей транзакции (в часовом поясе UTC) на основе системных часов. При этом строка помечается как закрытая с записью периода, в течение которого была действительной предыдущая строка. Строка в текущей таблице удаляется. Запросы текущей таблицы не возвращают эту строку. Только запросы, которые имеют дело с данными журнала, возвратят данные, строка для которых была закрыта.
- Слияние: операция ведет себя точно так же, как если бы в инструкции выполнялось до трех операторов (а UPDATE INSERT , а, или или) DELETE в зависимости от того, что указано как действия в инструкции MERGE .
Время, записанное в системных столбцах datetime2, основано на времени начала выполнения самой транзакции. Например, все строки, вставляемые в одну транзакцию, имеют одинаковое время в формате UTC, записанное в столбце, соответствующем началу SYSTEM_TIME периода.
При выполнении запросов на изменение данных в темпоральной таблице ядро СУБД добавляет строку в таблицу журнала, даже если значения столбцов не изменяются.
Как выполнить запрос для темпоральных данных?
При выполнении запроса с помощью предложения с помощью FOR SYSTEM_TIME одного из пяти подклаузов будут включены исторические данные из темпоральной таблицы, как показано на следующем рисунке.
Приведенный ниже запрос ищет версии строк о сотруднике с условием фильтра WHERE EmployeeID = 1000 , которые были активны хотя бы часть промежутка между 1 января 2021 г. и 1 января 2022 г. (включая верхнюю границу промежутка):
SELECT * FROM Employee FOR SYSTEM_TIME BETWEEN '2021-01-01 00:00:00.0000000' AND '2022-01-01 00:00:00.0000000' WHERE EmployeeID = 1000 ORDER BY ValidFrom; FOR SYSTEM_TIME фильтрует строки с периодом действия с нулевой длительностью ( ValidFrom = ValidTo ).
Эти строки будут созданы, если выполнить несколько изменений одного и того же первичного ключа в одной и той же транзакции. В этом случае темпоральные запросы возвращают только версии строк до выполнения транзакций и текущие версии строк после их выполнения.
Если необходимо включить эти строки в анализ, выполните запрос к таблице журнала напрямую.
В следующей таблице ValidFrom в столбце «Квалифицирующие строки» отображается значение ValidFrom в столбце в таблице, запрашиваемой таблице, и ValidTo представляет значение ValidTo в столбце в запрашиваемой таблице. Полный синтаксис и примеры см. в разделе FROM (Transact-SQL) и запрос данных в системной темпоральной таблице.
| Expression | Подходящие строки | Примечание. |
|---|---|---|
| AS OF date_time | ValidFrom AND ValidTo > date_time date_time | Возвращает таблицу со строками, содержащими значения, которые являлись текущими в указанный момент времени в прошлом. На внутреннем уровне объединение выполняется между темпоральной таблицей и соответствующей таблицей журнала, и результаты отфильтровываются так, чтобы возвращались значения в строке, которая была действительной на момент времени, определяемый параметром дата_время. Значение для строки считается действительным, если значение system_start_time_column_name меньше или равно значению параметра дата_время, а значение system_end_time_column_name больше значения параметра дата_время. |
| FROM TO start_date_time end_date_time | ValidFrom AND ValidTo > end_date_time start_date_time | Возвращает таблицу со значениями для всех версий строк, которые были активны в течение указанного диапазона времени, независимо от того, начали ли они активны до значения параметра start_date_time аргумента FROM или перестали быть активными после значения параметра end_date_time для аргумента TO . Внутри системы объединение выполняется между темпоральной таблицей и таблицей журнала. Результаты фильтруются, чтобы возвращать значения для всех версий строк, которые были активными в любое время в течение указанного диапазона времени. Строки, которые перестали быть активными точно на нижней границе, определенной FROM конечной точкой, не включаются, а записи, которые стали активными точно на верхней границе, определенной TO конечной точкой, также не включаются. |
| BETWEEN AND start_date_time end_date_time | ValidFrom AND ValidTo > end_date_time start_date_time | Аналогично предыдущему описанию FOR SYSTEM_TIME FROM start_date_time TO end_date_time, кроме таблицы возвращаемых строк, содержатся строки, которые стали активными на верхней границе, определенной конечной точкой end_date_time. |
| CONTAINED IN (start_date_time, end_date_time) | ValidFrom >= AND ValidTo start_date_time end_date_time | Возвращает таблицу со значениями для всех открытых и закрытых версий строк в течение указанного диапазона времени, определенного двумя значениями периода для аргумента CONTAINED IN . В эти строки включаются те, которые стали активными точно в нижнюю границу периода времени, и те, которые перестали быть активными точно в верхнюю границу периода времени. |
| ALL | Все строки | Возвращает объединение строк, принадлежащих текущей таблице и таблице журнала. |
Как скрыть столбцы периода
Чтобы вернуть скрытый столбец, явно укажите его в запросе. INSERT Аналогично и BULK INSERT операторы продолжаются так же, как если бы эти новые столбцы периода не присутствовали (и значения столбцов заполняются автоматически).
Дополнительные сведения об использовании HIDDEN предложения см. в статье CREATE TABLE и ALTER TABLE.
Примеры
ASP.NET
Чтобы научиться создавать темпоральное приложение с помощью темпоральных таблиц, см. ссылку веб-приложение ASP.NET Core.
Скачайте пример базы данных Adventure Works
Можно скачать базу данных AdventureWorks для SQL Server, которая включает возможности темпоральной таблицы.
Скрыть таблицы в SQL Server Management Studio (SSMS)
Бывают моменты, когда необходимо показывать не все таблицы БД. Предположим, что у нас есть таблица Person.Address и мы хотим её скрыть:

Для этого нам потребуется добавить расширенное свойство на неё:
Transact-SQL
EXEC sp_addextendedproperty
@ name = N ‘microsoft_database_tools_support’ ,
@ value = ‘Hide’ ,
@ level0type = N ‘Schema’ , @ level0name = ‘Person’ ,
@ level1type = N ‘Table’ , @ level1name = ‘Address’ ;
После чего результат будет следующим:

Вы можете вернуть видимость таблицы следующим образом:
Transact-SQL
EXEC sp_dropextendedproperty
@ name = N ‘microsoft_database_tools_support’ ,
@ level0type = N ‘Schema’ , @ level0name = ‘Person’ ,
@ level1type = N ‘Table’ , @ level1name = ‘Address’ ;
Я попытался применить расширенное свойство к колонкам и схемам, но так это не работает.
Благодаря расширенным свойствам, вы можете скрыть таблицы из SSMS, не ограничивая к ним доступа.
DENY VIEW DEFINITION
Другим способом скрыть таблицы в SSMS является VIEW DEFINITION:
Transact-SQL
DENY VIEW DEFINITION ON Schema . Table TO UserName ;
Теперь пользователь не будет видеть таблицы в SSMS. На самом деле он не сможет получить список таблиц из sys.tables или INFORMATION_SCHEMA.TABLES.
Filtering
Можно воспользоваться фильтром таблиц в любой БД:


Чтобы удалить фильтр необходимо:

Сравнение подходов
VIEW DEFINITION более гибкий. Вы можете ограничить видимость всей схемы или отдельной таблицы. Вы так же можете ограничить view или только одного пользователя или роль. Оно так же влияет на системные view, что хорошо.
С другой стороны, VIEW DEFINITION требует явного запрета доступа. В моей практике были случаи, когда кто-то запретил доступ одним и забыл запретить другим, что вызывало противоречия.
Расширенные свойства более строгие ограничения действуют на всех и не требуют явного запрета для каждого пользователя. Так же расширенные свойства влияют и на sysadmins.
Как полностью очистить таблицу sql
Полностью очистить таблицу, не удаляя её можно с помощью запроса DELETE . Мы указываем имя таблицы, но опускаем блок WHERE . Тогда удаляются абсолютно все записи, вне зависимости от условий, ведь их нет. 🙂
DELETE FROM wiped_table_name; -- Мы очистили таблицу wiped_table_name Кроме DELETE без условий можно использовать TRUNCATE . У неё есть свои особенности. Самая главная, она быстрее DELETE , так как не сканирует таблицы перед очисткой и наиболее полезна для очистки больших таблиц.
TRUNCATE cars, cups, parrots; -- Тут можно перечислять сколько угодно таблиц