
Подсчет уникальных значений
Есть таблица org (name, emp_id). Для каждого возможного значения name , необходимо вывести количество уникальных emp_id . Можно ли это сделать с помощью count() или как ещё? UPD: Немного расшифрую. Допустим
(name) (emp_id) apple 85962 apple 14654 intel 14654 intel 14654 В результате необходимо получить что-то вроде
(name) count(emp_id) apple 2 intel 1 т.е. если emp_id повторяется в разных name , то их необходимо подсчитывать
Отслеживать
задан 6 ноя 2012 в 20:53
579 1 1 золотой знак 7 7 серебряных знаков 22 22 бронзовых знака
4 ответа 4
Сортировка: Сброс на вариант по умолчанию
Первая интерпретация вашего вопроса Для каждого name подсчитать уникальное количество emp_id
SELECT name, COUNT(DISTINCT emp_id) AS qty FROM org GROUP BY name Вторая интерпретация, подсчитать так, что бы исключить emp_id встречающиеся у разных name Для этого пойдем от обратного подсчитаем количество name у emp_id , то есть нам необходимо исключить из выборки emp_id встречающиеся у нескольких name
SELECT name, COUNT(DISTINCT emp_id) AS qty FROM org WHERE NOT emp_id IN ( SELECT emp_id FROM org GROUP BY emp_id HAVING COUNT(DISTINCT name) > 1 ) GROUP BY name Унифицировать или нет дело ваше, смотря что там лежит и как
Как посчитать уникальные значения в sql
Используем DISTINCT и COUNT() . Первый удалит дубликаты, а вторая посчитает количество строк.
SELECT COUNT(DISTINCT car_id) FROM orders; -- покажет количество уникальных car_id в таблице orders Запросы
С помощью оператора DISTINCT можно выбрать уникальные данные по определенным столбцам.
К примеру, разные товары могут иметь одних и тех же производителей, и, допустим, у нас следующая таблица товаров:
USE productsdb; DROP TABLE IF EXISTS Products; CREATE TABLE Products ( Id INT AUTO_INCREMENT PRIMARY KEY, ProductName VARCHAR(30) NOT NULL, Manufacturer VARCHAR(20) NOT NULL, ProductCount INT DEFAULT 0, Price DECIMAL NOT NULL ); INSERT INTO Products (ProductName, Manufacturer, ProductCount, Price) VALUES ('iPhone X', 'Apple', 3, 71000), ('iPhone 8', 'Apple', 3, 56000), ('Galaxy S9', 'Samsung', 6, 56000), ('Galaxy S8', 'Samsung', 2, 46000), ('Honor 10', 'Huawei', 3, 26000);
Выберем всех производителей:
SELECT Manufacturer FROM Products;
Однако при таком запросе производители повторяются. Теперь применим оператор DISTINCT для выборки уникальных значений:
SELECT DISTINCT Manufacturer FROM Products;
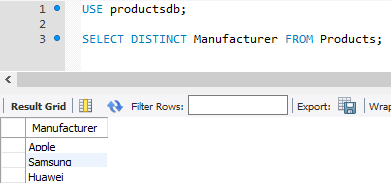
Также мы можем задавать выборку уникальных значений по нескольким столбцам:
SELECT DISTINCT Manufacturer, ProductCount FROM Products;
В данном случае для выборки используются столбцы Manufacturer и ProductCount. Из пяти строк только для двух строк эти столбцы имеют повторяющиеся значения. Поэтому в выборке будет 4 строки:
Количество уникальных значений
У функции count есть еще одна форма — count(DISTINCT выражение) . При такой форме записи функция вернет количество уникальных значений, при этом NULL значения по прежнему не учитываются. Например:
SELECT * FROM table1 | value |
|---|
| 1 |
| 2 |
| 2 |
| 2 |
| 3 |
| 3 |
| NULL |
| NULL |
SELECT count(value) AS count_value, count(DISTINCT value) AS count_distinct_value FROM table1 | count_value | count_distinct_value |
|---|---|
| 6 | 3 |
Уникальными значениями value таблицы table1 являются 1, 2 и 3.
Практика Количество уникальных значений
4.2 NULL значения в агрегатных функциях