Кросс-валидация
Кросс-валидация или скользящий контроль — процедура эмпирического оценивания обобщающей способности алгоритмов. С помощью кросс-валидации эмулируется наличие тестовой выборки, которая не участвует в обучении, но для которой известны правильные ответы.
Определения и обозначения
Пусть [math] X [/math] — множество признаков, описывающих объекты, а [math] Y [/math] — конечное множество меток.
[math]T^l = <(x_i, y_i)>_^, x_i \in X, y_i \in Y[/math] — обучающая выборка,
[math]Q[/math] — мера качества,
[math]\mu: (X \times Y)^l \to A, [/math] — алгоритм обучения.
Разновидности кросс-валидации
Валидация на отложенных данных (Hold-Out Validation)
Обучающая выборка один раз случайным образом разбивается на две части [math] T^l = T^t \cup T^ [/math]
После чего решается задача оптимизации:
[math]HO(\mu, T^t, T^) = Q(\mu(T^t), T^) \to min [/math] ,
Метод Hold-out применяется в случаях больших датасетов, т.к. требует меньше вычислительных мощностей по сравнению с другими методами кросс-валидации. Недостатком метода является то, что оценка существенно зависит от разбиения, тогда как желательно, чтобы она характеризовала только алгоритм обучения.
Полная кросс-валидация (Complete cross-validation)
- Выбирается значение [math]t[/math] ;
- Выборка разбивается всеми возможными способами на две части [math] T^l = T^t \cup T^ [/math] .

Здесь число разбиений [math]C_l^[/math] становится слишком большим даже при сравнительно малых значениях t, что затрудняет практическое применение данного метода.
k-fold кросс-валидация
- Обучающая выборка разбивается на [math] k [/math] непересекающихся одинаковых по объему частей;
- Производится [math] k [/math] итераций. На каждой итерации происходит следующее:
- Модель обучается на [math] k — 1 [/math] части обучающей выборки;
- Модель тестируется на части обучающей выборки, которая не участвовала в обучении.
Каждая из [math]k[/math] частей единожды используется для тестирования. Как правило, [math]k = 10[/math] (5 в случае малого размера выборки).
[math]T^l = F_1 \cup \dots \cup F_k, |F_i| \approx \frac, \\ CV_k = \frac \sum_^ Q(\mu(T^l \setminus F_i),F_i) \to min [/math] .
# Пример кода для k-fold кросс-валидации: # Пример классификатора, cпособного проводить различие между всего лишь двумя # классами, "пятерка" и "не пятерка" из набор данных MNIST import numpy as np from sklearn.model_selection import StratifiedKFold from sklearn.datasets import fetch_openml from sklearn.base import clone from sklearn.linear_model import SGDClassifier mnist = fetch_openml('mnist_784', version=1) X, y = mnist["data"], mnist["target"] y = y.astype(np.uint8) X_train, X_test, y_train, y_test = X[:60000], X[60000:], y[:60000], y[60000:] y_train_5 = (y_train == 5) # True для всех пятерок, False для всех остальных цифр. Задача опознать пятерки y_test_5 = (y_test == 5) sgd_clf = SGDClassifier(random_state=42) # классификатор на основе метода стохастического градиентного спуска (Stochastic Gradient Descent SGD) # Разбиваем обучающий набора на 3 блока # выработку прогнозов и их оценку осуществляем на каждом блоке с использованием модели, обученной на остальных блоках skfolds = StratifiedKFold(n_splits=3, random_state=42) for train_index, test_index in skfolds.split(X_train, y_train_5): clone_clf = clone(sgd_clf) X_train_folds = X_train[train_index] y_train_folds = y_train_5[train_index] X_test_fold = X_train[test_index] y_test_fold = y_train_5[test_index] clone_clf.fit(X_train_folds, y_train_folds) y_pred = clone_clf.predict(X_test_fold) n_correct = sum(y_pred == y_test_fold) print(n_correct / len(y_pred)) # print 0.95035 # 0.96035 # 0.9604t×k-fold кросс-валидация
- Процедура выполняется [math]t[/math] раз:
- Обучающая выборка случайным образом разбивается на [math]k[/math] непересекающихся одинаковых по объему частей;
- Производится [math] k [/math] итераций. На каждой итерации происходит следующее:
- Модель обучается на [math] k — 1 [/math] части обучающей выборки;
- Модель тестируется на части обучающей выборки, которая не участвовала в обучении.
[math]T^l = F_ \cup \dots \cup F_ = \dots = F_ \cup \dots \cup F_, |F_| \approx \frac [/math] ,
Кросс-валидация по отдельным объектам (Leave-One-Out)
Выборка разбивается на [math]l-1[/math] и 1 объект [math]l[/math] раз.
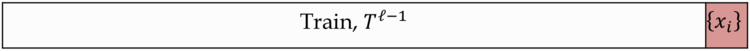
[math]LOO = \frac \sum_^ Q(\mu(T^l \setminus p_i),p_i) \to min [/math] , где [math]p_i = (x_i, y_i)[/math] .
Преимущества LOO в том, что каждый объект ровно один раз участвует в контроле, а длина обучающих подвыборок лишь на единицу меньше длины полной выборки.
Недостатком LOO является большая ресурсоёмкость, так как обучаться приходится [math]L[/math] раз. Некоторые методы обучения позволяют достаточно быстро перенастраивать внутренние параметры алгоритма при замене одного обучающего объекта другим. В этих случаях вычисление LOO удаётся заметно ускорить.
Случайные разбиения (Random subsampling)
Выборка разбивается в случайной пропорции. Процедура повторяется несколько раз.
Критерий целостности модели (Model consistency criterion)
Не переобученый алгоритм должен показывать одинаковую эффективность на каждой части.

Метод может быть обобщен как аналог [math] CV_ [/math] .
См. также
- Общие понятия
- Модель алгоритма и ее выбор
- Мета-обучение
Примечания
Источники информации
- Скользящий контроль — статья на MachineLearning.ru
- Model assessment and selection
Что такое кросс-валидация и зачем она нужна
Узнайте, что такое кросс-валидация, зачем она нужна и как она помогает в оценке качества моделей машинного обучения.

Алексей Кодов
Автор статьи
23 июня 2023 в 18:28Кросс-валидация – это метод оценки производительности модели машинного обучения, используемый для проверки ее способности обобщать данные на новых, ранее не встречавшихся случаях. В этой статье мы рассмотрим основные принципы кросс-валидации и примеры ее применения.
Принцип работы кросс-валидации
Кросс-валидация заключается в разделении имеющегося набора данных на две или более части. Одна часть используется для обучения модели, а другая – для проверки ее качества. Этот процесс повторяется несколько раз с использованием разных разбиений данных, чтобы получить более надежную оценку производительности модели.
Пример разбиения данных на 5 частей:
Данные: A B C D E Обучение: A B C D | Валидация: E Обучение: A B C E | Валидация: D Обучение: A B D E | Валидация: C Обучение: A C D E | Валидация: B Обучение: B C D E | Валидация: AТипы кросс-валидации
Существует несколько типов кросс-валидации, среди которых:
- K-блочная кросс-валидация (K-fold cross-validation): датасет делится на K равных частей (блоков), один из блоков используется для валидации, остальные – для обучения. Процесс повторяется K раз, каждый раз с новым блоком для валидации.
- Стратифицированная K-блочная кросс-валидация (Stratified K-fold cross-validation): аналогично K-блочной кросс-валидации, но с учетом пропорции классов в каждом блоке. Используется в случае несбалансированных данных.
- Оставить-P-выборок (Leave-P-Out cross-validation): на каждой итерации из датасета удаляется P объектов для валидации, остальные используются для обучения. Процесс повторяется для всех возможных комбинаций выборок размера P.
Аналитик данных: новая работа через 5 месяцев
Получится, даже если у вас нет опыта в IT
Зачем нужна кросс-валидация
- Оценить производительность модели на новых данных.
- Выявить переобучение модели и настроить гиперпараметры.
- Сравнить различные алгоритмы машинного обучения и выбрать наиболее подходящий.
Пример применения кросс-валидации
Предположим, у нас есть набор данных с информацией о клиентах банка и их кредитной истории. Мы хотим создать модель, которая предсказывает вероятность невозврата кредита для новых клиентов.
Сначала мы разделим данные на обучающую и валидационную выборки, затем проведем K-блочную кросс-валидацию и оценим производительность модели с помощью таких метрик, как точность, полнота и AUC-ROC. Это поможет нам выбрать наиболее подходящий алгоритм и оптимальные гиперпараметры.
В заключение, кросс-валидация является важным инструментом аналитика данных для оценки качества моделей машинного обучения и выбора наиболее подходящего алгоритма. Надеемся, что данная статья помогла вам лучше понять принципы и применение кросс-валидации. ��
Кросс-валидация в машинном обучении: Часть 1
Чтобы наглядно показать особенности и эффективность кросс валидации стоит взглянуть на то как она появилась. То есть вспомнить предшествующие подходы.
Для чего мы вообще разделяем датасет на тренировочный и тестовый?
Модель нужно оценивать, дабы понять на сколько хорошо она работает, если мы обучим модель на всех данных, то мы не узнаем, на сколько хорошо она делает предсказания. Даже если мы потом будем делать тесты на тех же данных, на которых обучилась модель, то она выдаст прекрасный результат, но по сути мы и так знаем значения таргета в имеющихся данных, главная же задача — предсказывать значения целевой переменной на новых данных.
Отсюда вытекает первое правило — модель должна тестироваться на данных, которые она не знает. Это будет гарантировать проверку её реальных способностей.
Есть наблюдения или объекты, которые влияют друг на друга во времени, как погода сегодня влияет на погоду завтра и есть объекты, порядок которых является независимыми — как, например, объявления о продаже автомобилей в Авито.
Рассмотрим вариант, когда каждый объект выборки является независимым друг от друга во времени.
TRAIN/TEST
Одна тренировочная подвыборка и одна тестовая — самое простое и часто используемое решение. Данные разбиваются на две части с выбранным соотношением, типичные из
которых 2/1 или 4/1
Теперь модель проверяется на реальных данных и можно получить более достоверный результат.
Почему более достоверный а не достоверный?
Разберём наглядную ситуацию, когда у нас выборка состоит из 12 красных яблок и 4 зелёных. Модель учиться отделять яблоки красного цвета от зелёного.
Может появиться ситуация, когда в тренировочной выборке окажутся только красные яблоки, а в тестовой — только зелёные.
В таком случае модель не успела познакомиться с отличительными чертами зелёных яблок и на тесте окажется, что модель ничему не научилась.
Именно поэтому данные нужно перемешивать так гораздо больше шансов на то, что целевые признаки будут распределены равномерно и тренировочная и тестовая выборка будут вместе отражать выборку, из которой они были получены.
Вот так была решена проблема неравномерного распределения в данных.
Но всегда есть вероятность неправильного разбиения выборки даже с перемешиванием.
Как нам точно и правильно распределить класс зеленого и красного яблока?
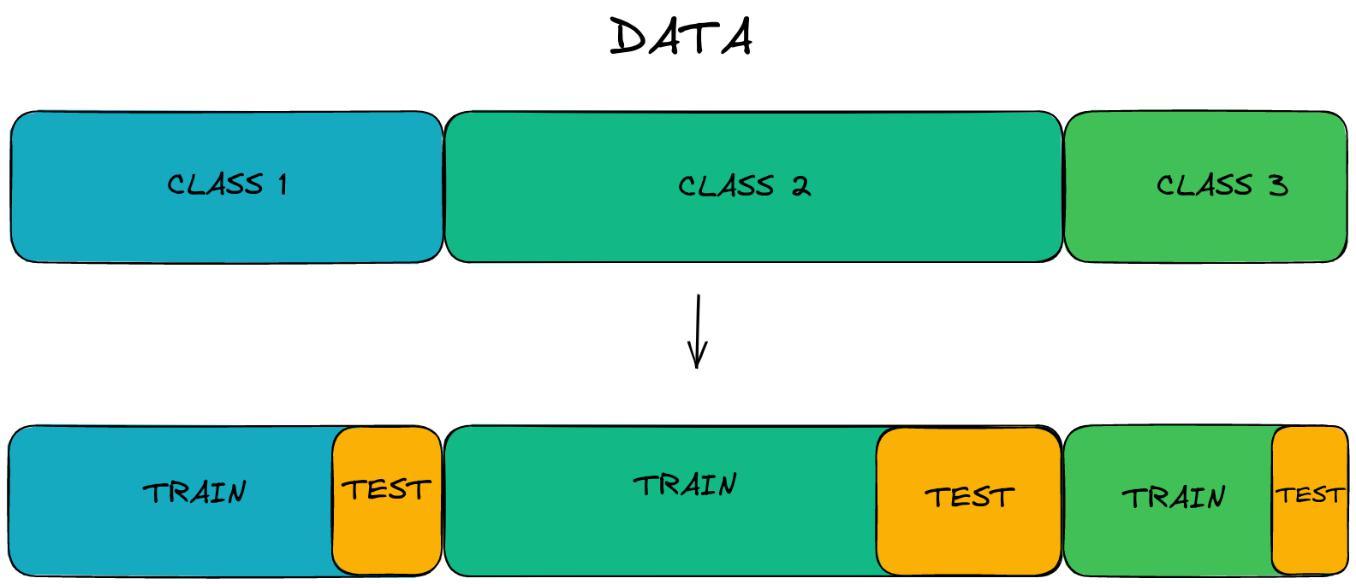
Нужно посчитать количество зелёных и красных яблок, а затем уже в каждом классе сделать разделение на тренировочную и тестовую часть. В данном случае получится два трейн теста — (9/3) красных яблок и (3/1) зелёных.
Вот так, чтобы решить задачу уравнивания классов, стоит просто их подсчитывать и делать мини трейн-тест подвыборку для каждого класса, а потом просто объединить трейны и тесты в итоговую валидационную выборку.
Однако даже если данные были идеально распределены по выборкам, по факту модель предсказывала только 4 определённых яблока из 16. То есть она не пробовала классифицировать остальные 12 вариантов, да так, чтобы она на них не обучалась. За этим скрывается неизвестность. Мы не можем точно говорить, что модель справилась со всеми данными, ведь мы проверили только одну комбинацию.
Вариантом задействования большего количества данных является последовательное перемешивание выборки и обучение, но так нельзя быть на 100% уверенным, что на определенной итерации мы точно испробовали все варианты, поэтому способ ещё и накладный.
Эволюцией этой идеи является кросс-валидация — когда на одном и том же порядке и наборе данных делаются последовательные трейн и тесты. Да таким образом, полученные модели в своей совокупности обучались на всех данных и тестировались тоже на всех данных.
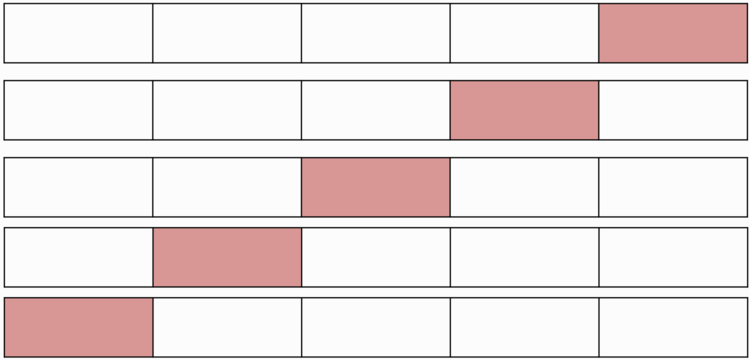
Полное название подхода — k-fold cross-validation . Он подразумевает, что датасет делится на k кусочков, один из которых тестовый, а остальные — тренировочные.
Далее тестовый фолд последовательно меняется местами с фолдами тренировочными таким образом, чтобы были перебранны все возможные местоположения тестового чанка. Всего получается k комбинаций.
На картинке выше k=5. Обучается и тестируется
5 одинаковых моделей, а затем находится среднее их результатов. Все данные были использованы, а средний результат является наиболее точной оценкой модели, подобранной для этих данных.
Если объединить этот подход с уравниванием соотношения трейн-тест для каждого класса, то получится стратифицированная кросс-валидация
Если наш целевой признак — три неравномерно распределённых класса, то применив k-fold кросс валидацию можно увидеть, как как классы в трейнах и тестах будут серьезно варьироваться, где-то вообще не будет одного из классов — следовательно и модели обученные на таких данных будут плохими.
Стратифицированная кросс-валидация разделит выборки сохранив процентное содержание объектов для каждого класса.
Таким образом, стратифицированная кросс-валидация объединяет в себе несколько подходов и является наиболее эффективным методом разбиния датасета для валидации.
В следующей статье я продолжу раскрывать тему валидации и объясню особенности её применения на временных рядах.
Автор: Андрей Епифановский
Кросс-валидация (Cross-validation)
Кросс-валидация — это метод оценки аналитической модели и её поведения на независимых данных с наиболее равномерным использованием имеющихся данных.
В основе метода лежит разделение исходного множества данных на k примерно равных блоков, например k = 5 . Затем на k − 1 , т.е. на 4-х блоках, производится обучение модели, а 5-й блок используется для тестирования. Процедура повторяется k раз, при этом на каждом проходе для проверки выбирается новый блок, а обучение производится на оставшихся.
Перекрестная проверка имеет важное преимущества перед применением одного множества для обучения и одного для тестирования модели: если при каждом проходе оценить выходную ошибку модели и усреднить ее по всем проходам, то полученная ее оценка будет более достоверной.
На практике чаще всего выбирается k = 10 (10-ти проходная перекрестная проверка), когда модель обучается на 9/10 данных и тестируется на 1/10. Исследования показали, что в этом случае получается наиболее достоверная оценка выходной ошибки модели.