
Функции систем управления базами данных (СУБД)
К основным функциям, которые выполняются системами управления базами данных относятся:
- непосредственное управление данными во внешней памяти;
- управление буферами оперативной памяти;
- управление транзакциями;
- ведение журнала или протокола выполненных операций в базе данных;
- поддержка языков баз данных.
2. Что означает непосредственное управление данными во внешней памяти?
Как известно, для сохранности данных и работы с ними, в базе данных нужно иметь в наличии постоянные запоминающие устройства (носители информации), например магнитные диски (жесткие диски).
Носители информации нужны в двух случаях:
- для сохранения непосредственных данных самой базе данных;
- для служебных целей. Например, для обеспечения быстрого доступа к данным с помощью индексов.
Как правило, система управления базами данных использует собственный механизм работы с устройствами внешней памяти (внешними запоминающими устройствами). Для любой СУБД важна работа с файловой системой некоторого устройства внешней памяти. Пользователь не должен задумываться над особенностями работы СУБД на нижнем уровне.
Для обеспечения непосредственного управления данными во внешней памяти современные СУБД:
- имеют собственную систему наименования объектов;
- могут использовать возможности существующих файловых систем (запоминающих устройств);
- могут использовать низкоуровневые операции при работе с внешними запоминающими устройствами.
3. Что означает управление буфером оперативной памяти?
Одной из важных характеристик системы управление базами данных есть скорость обработки информации в базе данных. Скорость обработки информации существенно зависит от размера базы данных.
Чтобы повысить скорость взаимодействия пользователя с базой данных, используется так называемая буферизация данных в оперативной памяти. Для этого в оперативной памяти создается буфер (кеш) с данными, которые на данный момент используются. И обмен информацией осуществляется через этот буфер. Поскольку, скорость чтения из оперативной памяти значительно выше скорости чтения из внешних запоминающих устройств, то таким образом обеспечивается ускорение работы с базой данных.
4. Что называется транзакцией? В чем состоит суть управления транзакциями?
При работе с любой базой данных выполняется бесконечная последовательность операций. Если последовательность операций объединена в единое целое (с точки зрения СУБД), то эта последовательность называется транзакцией.
В этом случае важно успешное выполнение транзакции. Если транзакция выполняется успешно, то система управления базами данных фиксирует все изменения данных с помощью инструкции COMMIT. Изменения заносятся во внешнюю память.
Если хотя бы одна из операций транзакции заканчивается неудачно, то транзакция считается невыполненной. В этом случае происходит откат транзакции (ROLLBACK). При откате транзакции база данных возвращается в состояние, которое было до начала выполнения транзакции.
5. Для чего нужно управление транзакциями в базе данных?
Поддержка транзакций есть важным условием для логической целостности базы данных. Это касается как однопользовательских так и многопользовательских СУБД.
Задача механизма транзакций – повлиять на пользователя таким образом, чтобы он ощущал себя единым пользователем СУБД. Даже в случае, если с СУБД параллельно работает большое количество пользователей. Фактически, транзакция есть единицей активности пользователя по отношению к базе данных.
6. Что такое сериализация и серийный план транзакций?
Сериализация транзакций необходима при параллельном выполнении транзакций. Она используется в многопользовательских базах данных. Сериализация транзакций это: планирование работы параллельных транзакций таким образом, чтобы при параллельном обращении эти транзакции выполнялись последовательно одна за другой.
Для обеспечения сериализации транзакций строится некий серийный план транзакций. В идеальном случае, при хорошем серийном плане транзакций, пользователь не ощутит присутствие других транзакций в базе данных. Возможно только небольшое замедление работы базы данных.
Рис. 1. Пример сериализации транзакций в случае трех пользователей
7. Что происходит, если две транзакции хотят иметь доступ к одному и тому же объекту базы данных?
Такая ситуация есть конфликтной и может возникнуть в многопользовательской базе данных. В этом случае происходит откат (ROLLBACK) одной из транзакций. Это необходимо для обеспечения сериализации в базе данных.
8. Что такое журнализация или ведение протокола в базе данных?
Журнализация или ведение протокола выполненных команд необходима для восстановления последнего согласованного состояния базы данных после аппаратного или программного сбоя.
Журнализация необходима для обеспечения надежности сохранения данных во внешней памяти (на носителях информации).
Аппаратные сбои возникают вследствие:
- мгновенной остановки компьютера (например, отключение питание, «зависание» операционной системы). Такой аппаратный сбой еще называют «мягкий» сбой;
- потерей информации на носителях внешней памяти. Такой вид сбоя называется «жесткий сбой».
Программные сбои – это, как правило, ошибки в самых программах. Программные сбои могут возникать как в пользовательских программах, так и в самой СУБД.
Журнализация служит дополнительной информацией, которая облегчает восстановление информации в базе данных. В базе данных ведется журнал изменений.
9. Какие требования к сохранению журнала изменений базы данных?
Журнал изменений в базе данных ведется особенно надежно. Журнал изменений есть недоступен для пользователей СУБД. Часто ведутся две копии журнала изменений, которые размещаются на разных носителях.
10. Что такое стратегия «упреждающей» записи при ведении журнала изменений?
Стратегия упреждающей записи (Write Ahead Log – WAL) есть своеобразным протоколом, который работает по следующему принципу: прежде чем изменить объект базы данных, предварительно в журнале надо сформировать запись об изменении данного объекта.
Если придерживаться этой стратегии, то после любого сбоя можно восстановить базу данных с помощью журнала, поскольку запись об изменениях в БД будет сформирована до начала изменения объекта.
11. Что такое локальный журнал транзакций? Какое отличие локального журнала транзакций от общесистемного?
Локальный журнал транзакций отображает операции модификации базы данных, выполненных в данной (конкретной) транзакции. Ведение такого журнала есть простейшим случаем для восстановления БД в случае сбоев. Чтобы восстановить БД после сбоя достаточно осуществить откат транзакции путем выполнения операций транзакции в обратном порядке (с начала до конца), которые записаны в локальном журнале.
Ведение локального журнала транзакций поддерживается в некоторых СУБД.
Общесистемный журнал отличается от локального журнала транзакций тем, что в нем описываются операции, выполненные всеми транзакциями, а не только конкретной транзакцией. В общесистемном журнале записи, которые отвечают одной транзакции, связаны между собою с помощью списка. При возникновении сбоя, происходит восстановление всех операций заданной транзакции в обратном порядке (от конца к началу).
12. Какие основные шаги выполняются СУБД для восстановления базы данных при «мягком» сбое?
«Мягкий сбой» – это случай, когда произошла мгновенная остановка работы компьютера. Примеры «мягких» сбоев:
- отключение питания компьютера (аппаратный сбой);
- «зависание» операционной системы;
- ошибки программирования программ, которые взаимодействуют с базой данных.
При «мягком» сбое могут отсутствовать:
- объекты, которые были модифицированы транзакциями, но эти транзакции еще не завершились на момент сбоя (измененные объекты незавершенных транзакций);
- объекты, которые на момент сбоя размещались в буфере оперативной памяти и которые были модифицированы завершенными транзакциями. Но эти объекты, в результате сбоя, еще не успели сохраниться на внешних носителях, и все равно исчезли бесследно. Как известно, информация из оперативной памяти при выключении питания исчезает бесследно.
После мягкого сбоя СУБД выполняет следующие основные шаги:
- откат незавершенных транзакций;
- воссоздаются операции завершенных транзакций, которые еще не успели зафиксироваться во внешней памяти (исчезли бесследно из буфера оперативной памяти).
13. Какие основные шаги выполняются при «жестком» сбое для восстановления базы данных?
Жесткий сбой характеризуется потерей информации на носителях внешней памяти.
В этом случае, для восстановления базы данных используют:
- журнал операций;
- архивную копию базы данных. Архивная копия базы данных – это полная копия базы данных, которая была сделана на некоторый момент ведения журнала. Если удачно создается архивная копия базы данных, то на данный момент, предшествующие операции в журнале фиксируются и новый учет в журнале начинается из этой позиции.
Важным здесь есть наличие самого журнала.
14. Что такое избыточность данных в базе данных?
Избыточность данных в базе данных – это когда кроме самих данных в базе данных сохраняется еще и другая необходимая информация. Эта информация используется системой управления базами данных.
Например. Для обеспечения надежности в базе данных, ведется журнал изменений базы данных. Для сохранности самого журнала нужно также место на внешних носителях. Таким образом, база данных, кроме самых данных сохраняет еще и другую информацию (журнал, связи между таблицами, индексирование и т.п.). Это и есть избыточность данных.
15. Что собою представляет функция поддержки языков баз данных?
Любая СУБД должна поддерживать языки баз данных. Это означает, что для работы с данными в базе данных, должны использоваться специальные языки. Эти языки называются языками баз данных (например, SQL, MDX, SPARQL, FoxPro, PL/Perl и т.д.).
Для современных баз данных в основном выделяются два языка:
- язык определения схем данных (Schema Definition Language, SDL). Этот язык используется для определения логической структуры базы данных;
- язык манипулирования данными (Data Manipulation Language, DML). Такой язык содержит набор операторов манипулирования данными (добавление, удаление и изменение данных) и выборки данных из базы данных.
Для современных реляционных баз данных стандартным языком использования есть язык SQL (Stuctured Query Language). Этот язык позволяет определять схему данных и манипулировать этими данными.
Связанные темы
- Общие сведения о базах данных. История развития систем управления базами данных
- Базовые понятия реляционной модели данных
- Реляционные базы данных. Понятие ключа. Виды ключей. Отношения. Главная и подчиненная таблицы
- Понятие системы баз данных. Схема базы данных. Данные. Аппаратное и программное обеспечение. Пользователи баз данных
Виды баз данных. Большой обзор типов СУБД
Часто, в обзорах видов баз данных упоминают реляционные и “другие”, “NoSQL” и т.д., либо приводят самые основные типы СУБД (базы данных), забывая о редких. В данной статье я постараюсь описать максимально полно виды баз данных и привести примеры конкретных реализаций. Разумеется, статья не претендует на всеохватность и классифицировать базы данных можно по разному, в том числе по типам оптимальной нагрузки и т.д., и все виды баз данных будут рассмотрены очень кратко. Но надеюсь, статья даст базовое представление о видах СУБД и принципах их работы.
В статье мы рассмотрим следующие типы баз данных:
- Реляционные
- Ключ-значение
- Документо-ориентированные
- Базы данных временных рядов
- Графовые базы данных
- Поисковые базы данных (Search Engines)
- Объектно-ориентированные базы данных
- RDF (Resource Description Framework)
- Wide Column Stores
- Мультимодальные СУБД
- Native XML СУБД
- GEO/GIS (пространственные) и специализированные СУБД
- Event СУБД (баз данных переходов состояний)
- Контентные СУБД
- Навигационные (Navigational) СУБД
- Векторные базы данных
Начнем с самого распространенного типа — реляционных СУБД.
Реляционные базы данных
Наиболее известными реляционными базами данных являются Open Source проекты PostgreSQL, MySQL и SQLite, а также проприетарные решения Oracle, Microsoft SQL Server и IBM Db2Relational.
Суть реляционных баз в хранении данных в связанных таблицах.
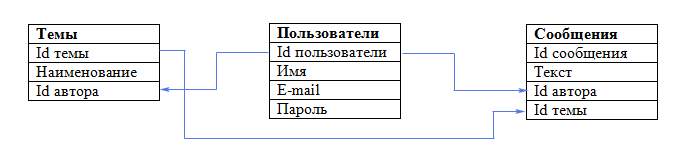
Стоит заметить, что реляционные базы бывают с хранением данных по строкам (PostgreSQL) и по столбцам/колонкам (ClickHouse, Vertica). Колоночные/столбцовые базы лучше подходят для аналитики, в то время как ориентация на строки лучше подходит для транзакционных нагрузок.

Реляционные СУБД — самый распространенный тип баз данных. В подкате таблица из более чем 150 вариантов. Источником данного списка является данный сайт-агрегатор информации по базам данных.
Список реляционных баз данных (и инструментов, содержащих функционал, присущий базам данных, таких как SQL-движки и т.д.) и поддерживаемый тип данных.
Полный список из 166 реляционных СУБД
- Oracle — реляционная, мультимодальная
- MySQL — реляционная, мультимодальная
- Microsoft SQL Server -реляционная, мультимодальная
- PostgreSQL — реляционная, мультимодальная
- IBM Db2Relational — мультимодальная
- Microsoft Access — реляционная
- SQLite — реляционная
- Snowflake — реляционная
- MariaDB — реляционная, мультимодальная
- Microsoft Azure SQL Database — реляционная, мультимодальная
- Hive — реляционная
- Databricks — мультимодальная
- Teradata — реляционная, мультимодальная
- Google BigQuery — реляционная
- FileMaker — реляционная
- SAP HANA — реляционная, мультимодальная
- SAP Adaptive Server — реляционная
- Microsoft Azure Synapse Analytics — реляционная
- Firebird — реляционная
- Informix — реляционная, мультимодальная
- Amazon Redshift — реляционная
- Impala — реляционная, мультимодальная
- Spark SQL — реляционная
- ClickHouse — реляционная, мультимодальная
- Netezza — реляционная
- Vertica — реляционная
- Presto — реляционная
- dBASE — реляционная
- Apache Flink — реляционная
- Greenplum — реляционная, мультимодальная
- Amazon Aurora — реляционная, мультимодальная
- H2 — реляционная, мультимодальная
- Oracle Essbase — реляционная
- Microsoft Azure Data Explorer — реляционная, мультимодальная
- Microsoft Azure Data Explorer — реляционная, мультимодальная
- CockroachDB — реляционная
- Derby — реляционная
- Interbase — реляционная
- Trino — реляционная, мультимодальная
- SingleStore — реляционная, мультимодальная
- SAP SQL Anywhere — реляционная
- Ingres — реляционная
- HyperSQL — реляционная
- Ignite — мультимодальная
- SAP IQ — реляционная
- Virtuoso — мультимодальная
- OpenEdge — реляционная
- Oracle NoSQL — мультимодальная
- Google Cloud Spanner — реляционная
- YugabyteDB — реляционная, мультимодальная
- MaxDB — реляционная
- TiDB — реляционная, мультимодальная
- Apache Druid — мультимодальная
- InterSystems Caché — мультимодальная
- InterSystems IRIS — мультимодальная
- DuckDB — реляционная
- SAP Advantage Database Server — реляционная
- HEAVY.AI — реляционная, мультимодальная
- 4D — реляционная
- Percona Server for MySQL — реляционная
- EDB Postgres — реляционная
- Apache Drill — мультимодальная
- EXASOL — реляционная
- Apache Phoenix — реляционная
- Citus — реляционная, мультимодальная
- Datomic — реляционная
- Empress — реляционная
- GridGain — мультимодальная
- OceanBase — реляционная, мультимодальная
- MonetDB — реляционная, мультимодальная
- VoltDB — реляционная
- Tibero — реляционная
- TimesTen — реляционная
- IBM Db2 warehouse — реляционная
- SQLBase — реляционная
- Firebolt — реляционная
- Fauna — мультимодальная
- mSQL — реляционная
- MatrixOne — реляционная
- DataEase — реляционная
- Oracle Rdb — реляционная
- Altibase — реляционная
- PlanetScale — реляционная, мультимодальная
- NonStop SQL — реляционная
- Cubrid — реляционная
- Infobright — реляционная
- Apache Kylin — реляционная
- GBase — реляционная
- Apache HAWQ — реляционная
- NuoDB — реляционная
- Dolt — реляционная, мультимодальная
- solidDB — реляционная
- FoundationDB — мультимодальная
- 1010data — реляционная
- openGauss — реляционная, мультимодальная
- HFSQL — реляционная
- Actian Vector — реляционная
- SQL.JS — реляционная
- OpenBase — реляционная
- Vitess — реляционная, мультимодальная
- Kognitio — реляционная
- StarRocks — реляционная
- TDSQL for MySQL — реляционная, мультимодальная
- DBISAM — реляционная
- FrontBase — реляционная
- TypeDB — мультимодальная
- NexusDB — реляционная
- Datacom/DB — реляционная
- Kinetica — реляционная, мультимодальная
- eXtremeDB — мультимодальная
- ScaleArc — реляционная
- VistaDB — реляционная
- Yellowbrick — реляционная
- Splice Machine — реляционная
- Postgres-XL — реляционная, мультимодальная
- Alibaba Cloud MaxCompute — реляционная
- AlaSQL — мультимодальная
- Apache Pinot — реляционная
- Alibaba Cloud AnalyticDB for MySQL — реляционная, мультимодальная
- SQream DB — реляционная
- Sequoiadb — мультимодальная
- Kingbase — реляционная, мультимодальная
- Trafodion — реляционная
- R:BASE — реляционная
- Apache Doris — реляционная
- Transbase — реляционная
- Lovefield — реляционная
- Raima Database Manager — мультимодальная
- Alibaba Cloud AnalyticDB for PostgreSQL — реляционная
- Tajo — реляционная
- Mimer SQL — реляционная
- Kyligence Enterprise — реляционная
- YDB — мультимодальная
- Databend — реляционная
- Actian PSQL — реляционная
- Alibaba Cloud ApsaraDB for PolarDB — реляционная
- Brytlyt — реляционная
- XtremeData — реляционная
- TransLattice — реляционная
- ElevateDB — реляционная
- Comdb2 — реляционная
- Linter — реляционная, мультимодальная
- AntDB — реляционная
- FeatureBase — реляционная
- LeanXcale — Multi-model
- PipelineDB — реляционная
- GeoSpock — реляционная, мультимодальная
- Faircom DB — мультимодальная
- Tibco ComputeDB — реляционная
- Valentina Server — реляционная
- PieCloudDB — реляционная
- BigObject — реляционная
- Edge Intelligence — реляционная
- Fujitsu Enterprise Postgres — реляционная, мультимодальна
- EsgynDB — реляционная
- Transwarp KunDB — реляционная
- JethroData — реляционная
- MyScale — мультимодальная
- OushuDB — реляционная
- AgensGraph — мультимодальная
- SmallSQL — реляционная
- ActorDB — реляционная
- DaggerDB — реляционная
- EdgelessDB — реляционная
- K-DB — реляционная
- Sadas Engine — реляционная
Из отечественных игроков можно выделить
- Postgres Pro — доработанный под корпоративные задачи PostgreSQL.
- Jatoba — как и вариант выше, основана на PostgreSQL.
- Квант-Гибрид — еще один вариант PostgreSQL.
- Ред — СУБД на базе Interbase/Firebird
- ProximaBD — на основе PostgreSQL.
- Arenadata DB — корпоративное решение на основе Greenplum
- YDB — serverless решение от Яндекса. Это Open Source продукт, который доступен в том числе как для on-premise инсталляций, так и как управляемый сервис с dedicated/serverless моделью потребления.
Вы можете развернуть реляционные базы данных PostgreSQL и MySQL в облаке Amvera Cloud c помощью простого push в выделенный Git-репозиторий. Для этого нужно выполнить несколько простых шагов, описанных в инструкциях для PostgreSQL и MySQL соответственно. Стоимость хостинга баз данных начинается от 170 руб. в месяц.
Реляционные базы закрывают широкий спектр задач, начиная от транзакционных баз и заканчивая аналитическими, но не являются “серебряной пулей” для всех задач. Рассмотрим другие виды базы данных.
Key-value (ключ значение) базы данных
Тип баз данных Key-value предназначен для осуществления быстрых, почти мгновенных запросов для таких задач как кэш, отображение баланса и т.д.. Высокая скорость осуществляется за счет хранения данных по принципу ключ-значение, и в большинстве случаев благодаря работе в оперативной памяти.
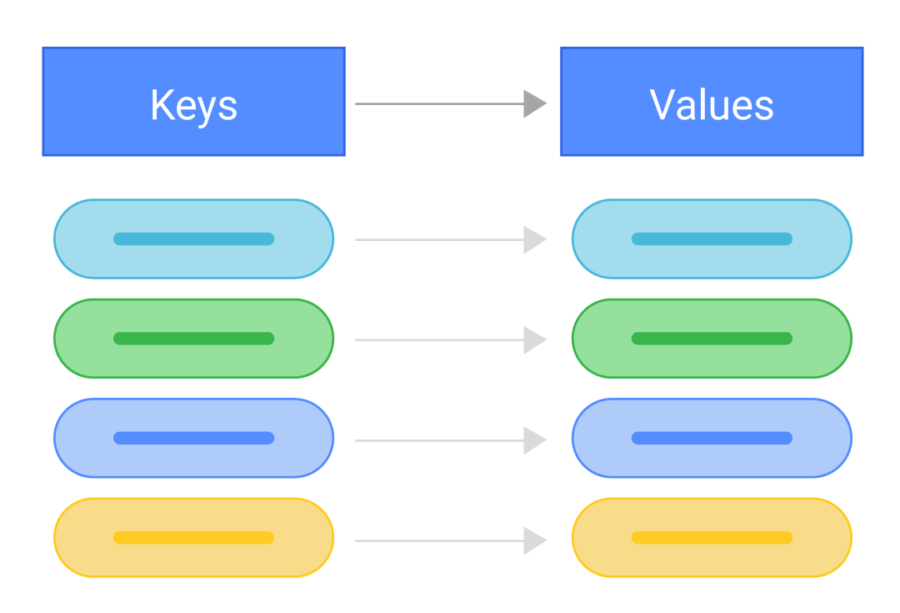
Словари содержат коллекцию объектов или записей, а объекты содержат множество различных полей, каждое из которых содержит данные. Записи хранятся и извлекаются с использованием ключа, который однозначно идентифицирует запись и используется для быстрого поиска данных.
Основным применением является ускорение отображения данных для конечных пользователей и снижение нагрузок, в том числе I/O на инфраструктуру организаций.
Наиболее известными и широко используемыми Key-Value решениями являются Redis и Memcached.
Полный список из 72 Key-Value СУБД под катом
- Redis — Key-value, мультимодальная
- Amazon DynamoDB — мультимодальная
- Microsoft Azure Cosmos DB — мультимодальная
- Memcached — Key-value
- etcd — Key-value
- Hazelcast — Key-value, мультимодальная
- Aerospike — мультимодальная
- Ehcache — Key-value
- Riak KV — Key-value
- Ignite — мультимодальная
- OrientDB — мультимодальная
- Google Cloud Bigtable — мультимодальная
- GemFire — Key-value, мультимодальная
- ArangoDB — мультимодальная
- Infinispan — Key-value
- Oracle NoSQL — мультимодальная
- RocksDB Key-value
- Oracle Berkeley DB — мультимодальная
- InterSystems Caché — мультимодальная
- InterSystems IRIS — мультимодальная
- LevelDB — Key-value
- LMDB — Key-value
- Geode — Key-value
- Amazon SimpleDB — Key-value
- Geode — Key-value
- Amazon SimpleDB — Key-value
- Oracle Coherence — Key-value
- GridGain — мультимодальная
- Tarantool — Key-value, мультимодальная
- GT.M — Key-value
- ZODB — Key-value
- FoudationDB — мультимодальная
- NCache — Key-value
- WebSphere eXtreme Scale — Key-value
- Hibari — Key-value
- MapDB — Key-value
- BoltDB — Key-value
- Graph Engine — мультимодальная
- Scalaris — Key-value
- KeyDB — Key-value
- Project Voldemort — Key-value
- Upscaledb — Key-value
- Cloudflare Workers KV — Key-value
- Elliptics — Key-value
- Tokyo — Tyrant — Key-value
- LeanXcale — мультимодальная
- Immudb — Key-value, мультимодальная
- STSdb — Key-value
- TomP2P — Key-value
- ArcadeDB — мультимодальная
- Speedb Key-value
- Faircom DB — мультимодальная
- Kyoto Tycoon — Key-value
- Skytable — Key-value
- HyperLevelDB — Key-value
- YTsaurus — мультимодальная
- InfinityDB — Key-value
- Tigris — мультимодальная
- Badger — Key — value
- Dragonfly — Key — value
- LedisDB — Key-value
- TerarkDB — Key-value
- Cachelot.io — Key-value
- ScaleOut StateServer — Key-value
- JaguarDB — Key-value
- Resin Cache — Key-value
- Faircom EDGE — мультимодальная
- SwayDB — Key-value
- BergDB — Key-value
- CortexDB — мультимодальная
- Helium — Key-value
- Tkrzw — Key-value
Из отечественных СУБД здесь следует отдельно выделить Tarantool, распространяемый под лицензией Упрощенная BSD и имеющий отдельную версию для крупных корпоративных клиентов. В Tarantool реализована гибридная схема данных: key-value, документно-ориентированная, реляционная и пространственная.
Вы можете развернуть Key-value базу данных Redis в облаке Amvera Cloud c помощью простого push в выделенный Git-репозиторий. Для этого нужно выполнить несколько простых шагов, описанных в инструкции по развертыванию Redis. Стоимость хостинга Redis начинается от 170 руб. в месяц.
Документо-ориентированные базы данных
Если вам нужно хранить много файлов/документов и вы не хотите задумываться (до разумных пределов, разумеется) о структуре хранения, иерархии, связях, вам может подойти одна из документо-ориентированных баз данных. Дополнительным преимуществом являются широкие возможности для масштабирования.
Документо-ориентированные базы данных созданы для хранения иерархических структур данных (документов). Основой документоориентированных СУБД являются документные хранилища, имеющие структуру дерева или леса. Деревья начинаются с корневого узла и может содержать несколько внутренних и листовых узлов. Листовые узлы содержат данные, которые при добавлении документа заносятся в индексы, это дает возможность даже при достаточно сложной структуре находить путь к искомых данных. В отличие от хранилищ типа ключ-значение, выборка по запросу к документному хранилищу может содержать части большого количества документов без полной загрузки этих документов в оперативную память.
Наиболее популярной документо-ориентированной базой данных на текущий момент является MongoDB.

Полный список из 56 решений документо-ориентированных баз данных подкатом
1. MongoDB — Документо-ориентированная, мультимодальная
2. Amazon DynamoDB — мультимодальная
3. Databricks — мультимодальная
4. Microsoft Azure Cosmos DB — мультимодальная
5. Couchbase — Документо-ориентированная, мультимодальная
6. Firebase Realtime Database — Документо-ориентированная
7. CouchDB — Документо-ориентированная, мультимодальная
8. Google Cloud Firestore — Документо-ориентированная
9. MarkLogic — мультимодальная
10. Realm — Документо-ориентированная
11. Aerospike — мультимодальная
12. Google Cloud Datastore — Документо-ориентированная
13. Virtuoso — мультимодальная
14. OrientDB — мультимодальная
15. ArangoDB — мультимодальная
16. RavenDB — Документо-ориентированная, мультимодальная
17. Oracle NoSQL — мультимодальная
18. IBM Cloudant — Документо-ориентированная
19. RethinkDB — Документо-ориентированная, мультимодальная
20. InterSystems IRIS — мультимодальная
21. PouchDB — Документо-ориентированная
22. CloudKit — Документо-ориентированная
23. Apache Drill — мультимодальная
24. Amazon DocumentDB — Документо-ориентированная
25. Mnesia — Документо-ориентированная
26. LiteDB — Документо-ориентированная
27. Fauna — мультимодальная
28. Datameer — Документо-ориентированная
29. GigaSpaces — мультимодальная
30. FoundationDB — мультимодальная
31. AllegroGraph — мультимодальная
32. HPE Ezmeral Data Fabric — мультимодальная
33. CrateDB — мультимодальная
34. LokiJS — Документо-ориентированная
35. BigchainDB — Документо-ориентированная
36. AlaSQL — мультимодальная
37. SurrealDB — мультимодальная
38. Sequoiadb — мультимодальная
39. Percona Server for MongoDB — Документо-ориентированная
40. HarperDB — Документо-ориентированная
41. EJDB — Документо-ориентированная
42. YDB — мультимодальная
43. ArcadeDB — мультимодальная
44. Bangdb — мультимодальная
45. XTDB — Документо-ориентированная
46. YTsaurus — мультимодальная
47. OrigoDB — мультимодальная
48. WhiteDB — Документо-ориентированная
49. ToroDB — Документо-ориентированная
50. SenseiDB — Документо-ориентированная
51. Acebase — Документо-ориентированная
52. iBoxDB — Документо-ориентированная
53. RaptorDB — Документо-ориентированная
54. NosDB — Документо-ориентированная
55. CortexDB — мультимодальная
56. JasDB — Документо-ориентированная
Из отечественных решений, к документо-ориентированным базам данных можно отнести СУБД Енисей.
И в рамках одной из модальностей к таким базам можно отнести YDB и YTsaurus.
Вы можете развернуть документо-ориентированную базу данных MongoDB в облаке Amvera Cloud c помощью простого push в выделенный Git-репозиторий. Для этого нужно выполнить несколько простых шагов, описанных в инструкции по развертыванию MongoDB. Стоимость хостинга MongoDB начинается от 170 руб. в месяц.
Базы данных временных рядов
Если у вас есть упорядоченные по времени данные с временными метками, такие как метрики от инфраструктуры или данные датчиков, может быть полезно использовать одну из баз данных временных рядов.

Общие характеристики баз данных временных рядов:
- Данные временных рядов всегда собираются на протяжении определенного периода времени.
- Данные из рабочих нагрузок являются новыми и записываются как вставки. Уже существующие данные не обновляются путем замены.
- Когда данные записываются, они автоматически назначаются последнему интервалу времени.
Базы даных временных рядов часто используются для осуществления мониторинга различных метрик (будь то загрузка CPU, или показатели работы какого-либо датчика).
Наиболее популярными и базами временных рядов являются Prometheus, InflubDB, Graphite.
Полный список из 43 СУБД для хранения временных рядов
Time Series, мультимодальная
Выбор СУБД: шпаргалка, чтобы не запутаться
Вопрос выбора СУБД для российской компании или госоргана — вопрос не праздный, тем более сейчас — когда с момента ухода с рынка западных вендоров прошло уже полтора года и пора что‑то решать. Но как не запутаться в номенклатуре СУБД и выбрать ту, которая лучше всего подходит? Без ложной скромности скажу: мы в «Кругах Громова» уже немного поднаторели в систематизации, поэтому надеемся, что наша шпаргалка для тех, кто хочет выбрать СУБД, окажется полезной.
Начнем с классики. СУБД делятся на несколько типов. Не будем описывать их подробно, остановимся только на их основном предназначении.
Реляционные СУБД — чаще всего используется для OLTP‑решений (обработка транзакций онлайн). Подходят для систем, предназначенных для хранения большого записей с различными типами отношений между ними. Самые известные — Oracle Database, Microsoft SQL Server, PostgreSQL, MySQL, IBM DB2, из российских — Postgres Pro, ЛИНТЕР и Ред База Данных. Плохо подходят они для неструктурированных данных, простых структур и случаев с частым обновлением строк.
Столбцовые (колонковые) СУБД — похожи на реляционные, но хранят данные по столбцам. Столбец предстает в виде отдельной таблицы, а считывание выполняется прямо из конкретного столбца. Т.о. они эффективно выполняют сложные аналитические запросы для большого объема данных, быстро реструктурируют таблицы с данными. Самые‑ Sybase IQ (SAP IQ), Vertica, ClickHouse, Google BigQuery, InfoBright, Apache Druid.
Применяют при сложной аналитике и объемах запрашиваемых строк более нескольких сотен миллионов.
Графовые СУБД — подходят для решения специфических задач.Самые известные графовые СУБД — Neo4j, Amazon Neptune, InfiniteGraph, InfoGrid.
Документные СУБД — в качестве базовой единицы логической модели применяется структурированный текст (документ). Самые известные — CouchDB, MongoDB, Amazon DocumentDB. Могут применяться как для одного микросервиса так и для хранения структур, включая объекты, списки и словари. Не годятся для реализации модели транзакций, и, конечно, это не лучшее решение для формирования отчетов.
СУБД типа «ключ — значение» — простейшая СУБД, используют для кэширования. Самые известные — Redis, Memcached. Применяют, когда необходимо кэширование данных, для хранения и доступа к простым структурам.
СУБД временных рядов. Сфера их применения — мониторинг, обработка телеметрии и финансовые системы. Но не стоит их использовать в задачах, не связанных с временными рядами и метками времени. Самые известные — InfluxDB, Kdb+, Prometheus, TimescaleDB, QuestDB, AWS Timestream, OpenTSDB, GridDB.
Объектно‑ориентированные СУБД — распространены в системах реального времени, архитектуре и инженерии для 3D‑моделирования, телекоммуникациях и научных продуктах, молекулярной науке и астрономии. Самые‑ MongoDB Realm, InterSystems Caché, ObjectStore, Actian NoSQL DB, Objectivity/DB. Не подходят, когда используется классический язык SQL или когда не применяется ООП.
Поисковые СУБД — используются для осуществления поиска. Самые известные — Apache Solr, Elasticsearch, Splunk. Неэффективны при поиске по ограниченному числу полей структурированных данных.
Теорема САР
Одним из способов, позволяющих на верхнем уровне определить, какие реалистичные требования можно устанавливать к СУБД, может стать теорема САР (известная также как теорема Брюера). Она гласит, что в любой реализации распределённых вычислений возможно обеспечить не более двух из трёх следующих свойств:
- согласованность данных (англ. consistency) — во всех вычислительных узлах в один момент времени данные не противоречат друг другу;
- доступность (англ. availability) — любой запрос к распределённой системе завершается корректным откликом, однако без гарантии, что ответы всех узлов системы совпадают;
- устойчивость к разделению (англ. partition tolerance) — расщепление распределённой системы на несколько изолированных секций не приводит к некорректности отклика от каждой из секций.
То есть при выборе системы из трех факторов: согласованность (consistency), доступность (availability) и устойчивость к распределению (partition tolerance) достижимыми являются только два.
В нашем случае согласованность — это точность, полнота и корректность данных, находящихся в БД. Доступность — мера того, как часто информация из вашей БД доступна и насколько быстро можно получить/внести информацию в базу данных. Устойчивость к распределению — возможность двух сегментов системы работать даже в случае временного сбоя коммуникации в их сети (а также возможность работы при нарушении сетевой связности).
И вот как это выглядит в применении к имеющимся на рынке СУБД:

УБД также различаются по ряду технических параметров. Поговорим о них.
1. Структура данных
а) Простая структура: база данных, которая использует простой способ организации данных, например, списки, массивы или хеш‑таблицы. Она может быть недостаточно гибкой для хранения и извлечения сложных данных, но может быть эффективной в простых сценариях.
б) Сложная иерархическая структура: данные организованы в виде иерархии, где каждый элемент имеет родителя и может иметь одного или несколько детей. Примером такой структуры может служить древовидная база данных, где элементы представляются в виде узлов дерева.
в) Реляционная структура: основана на концепции таблиц, где данные организованы в виде отношений. Реляционные базы данных используют SQL (Structured Query Language) для организации, хранения и извлечения данных. Таблицы связаны между собой ключами, что позволяет выполнять сложные запросы и анализировать данные.
г) Большой объем неструктурированных данных: БД содержит большое количество данных, которые не имеют четкой структуры или формата: текстовые документы, изображения, аудио‑ и видеофайлы. Обработка таких данных может быть сложной, требовать специальных методов и инструментов, например, алгоритмов машинного обучения или анализа естественного языка.
2. Схема лицензирования
а) Проприетарная лицензия: СУБД является собственностью компании‑разработчика, и доступ к ее исходному коду ограничен или отсутствует. Примеры проприетарных СУБД: Oracle Database, Microsoft SQL Server и IBM DB2.
б) Открытая лицензия (Open Source): код СУБД доступен общественности, его можно менять и распространять. Примеры: MySQL, PostgreSQL и SQLite.
в) Бесплатная лицензия (Freeware): можно пользоваться без ограничений, но с ограниченной или отсутствующей поддержкой и обновлениями. Бесплатные лицензии могут быть как проприетарными, так и открытыми.
г) Коммерческая лицензия: СУБД для коммерческого использования, с возможностью получения полной поддержки, обновлений и дополнительных функций. Плата зависит от потребностей организации и условий лицензионного соглашения.
3. Характер обращений
а) OLTP (Online Transaction Processing): большое количество несвязанных или слабо связанных между собой запросов, изменяющих значения в разных строках. Обработка каждого отдельного запроса должна происходить быстро, обычно в течение долей секунды.
б) OLAP (Online Analytical Processing): одновременный запрос гигантского количество однородных данных, которые потом агрегируются (чаще всего суммируются). Суммарное время обработки таких запросов должно составлять не более нескольких секунд.
в) Журналирование: огромное количество запросов на добавление новых записей при отсутствии изменения существующих.
4. Масштаб данных
а) малый объем – до 1 Гб, до 10 000 строк;
б) средний объем – 1 Гб – 1 Тб, 10 000 – 1 000 000 строк;
в) большой объем – от 1 Тб, более 1 000 000 строк.
Объем данных в БД может сильно варьироваться в зависимости от типа данных.
5. Параметры отказоустойчивости
б) возможность автоматической репликации данных для обеспечения отказоустойчивости;
в) восстановление после сбоев: возможность быстрого восстановления после сбоев и сбойных ситуаций.
6. Сертификация
а) соответствие международным стандартам безопасности;
б) сертификация соответствия: наличие сертификатов, подтверждающих соответствие определенным нормам и требованиям;
в) защита данных: уровень защиты данных, включая шифрование, механизмы аутентификации и авторизации.
Конечно, классификация СУБД в разрезе указанных параметров может зависеть от конкретной реализации и конфигурации. Мы предлагаем лишь общие ориентиры для каждой СУБД из предложенного списка.
И вот как все эти факторы выглядят сведёнными на диаграмме Вена:

Как определить, какая СУБД нужна?
Итак, чтобы определить, какую СУБД выбрать, следует задать себе следующие вопросы — и ответить на них:
- Какого назначение вашей базы данных: OLAP, OLTP или оба?
- Какой объем данных вы планируете хранить?
- Как много пользователей будет обращаться к БД при пиковой нагрузке?
- Какой уровень доступности, масштабируемости данных вам нужен?
- Как часто будут меняться схемы БД?
И конечно больше деталей в «СУБД‑круге Громова» и в нашей шпаргалке DB Cheat Sheet:
Какую СУБД выбрать и почему? (Статья 1)
Это первый выпуск в серии статей про СУБД , в рамках которых буду достаточно простыми словами давать информацию про то, что сейчас есть на рынке баз данных, и что выбрать для решения своих задач.
Заметил, что когда спрашиваешь кого-нибудь, особенно на собеседовании, какие типы СУБД существуют, то первое что вспоминают многие – это реляционные базы данных, и NoSQL, а вот про разновидности часто забывают или не могут сформулировать их отличие. Поэтому начнем с простого перечисления наиболее используемых.
- Реляционные
- Ключ-значение
- Документные
- Графовые
- Колоночные
Тем, кому не хочется долго читать, может сразу перейти на итоговую таблицу .
Нужно обязательно сделать ремарку, что некоторые крупные производители, имеют в своем арсенале несколько типов СУБД, как в виде отдельных продуктов, так и в виде внутренней реализации. Например, у Oracle на самом деле чего только нет, начиная с классической реляционной СУБД, продолжая с отдельным продуктом Oracle NoSQL Database, который может использоваться и как документная, и как колоночная, и как ключ-значение. Отдельное решение от того же Oracle, Autonomous Data Warehouse – это уже специализированное решение для хранилищ данных. Еще один отдельный продукт от Oracle – Oracle Graph Server для работы с графами, и еще много другого. Этому можно посвятить отдельную серию статей.
Реляционные СУБД
Начнем по порядку, классические, реляционные СУБД чаще всего используются для построения решений OLTP (Online Transaction Processing). В таких решениях СУБД работает с небольшими по размерам транзакциями, но идущими большим потоком, и при этом от системы требуется минимальное время отклика, а так же возможность, при определенных условиях, отменить любые изменения выполняемых в рамках транзакции. Если вы строите систему, в рамках которой требуется хранить значительное количество сущностей (таблиц), с различными типами связей между ними (один-к-одному, один-к-многим, многие-ко-многим), то это скорее всего про реляционные СУБД.
Наиболее известные СУБД такого типа — Oracle, Microsoft SQL, PostgreSQL, MySQL.
Когда выбирать реляционную СУБД
Один из основных признаков, который говорит о том что нужно выбирать реляционную СУБД – это высокая нормализация данных. Дополнительными признаками будет необходимость обработки большого кол-ва коротких транзакций, с большей долей операций на вставку
Когда не выбирать реляционную СУБД
Если предполагается хранить не структурируемые данные, или наоборот очень простые структуры типа ключ-значение, то лучше посмотреть в сторону документных СУБД и специализированных СУБД типа ключ-значение соответственно.
Так же один из признаков, что имеет смысл подумать не о реляционных СУБД, это такой факт как необходимость часто обновлять значения в одних и тех же строках. Обычно это обходится «дорого» в реляционных СУБД, и нужно применять «продвинутую магию» что бы делать это корректно.
Конечно, тут есть много «но», или «а если очень хочется», и других ситуаций, когда данные рекомендации можно игнорировать. Это нормально, особенно когда за дело берется эксперт, который знает как это сделать.
СУБД типа ключ-значение
Наверное один из самых простых типов СУБД. В упрощенном виде, это некая таблица с уникальным ключом и собственно связанным с ним значением, в котором может быть что угодно. Чаще всего такие СУБД используют для кэширования, т.к. они очень быстро работают, а это и не сложно, когда есть уникальный ключ, и запрос возвращает только одно значение. У некоторых представителей данных СУБД есть возможность работать полностью в памяти, а так же есть возможность задавать срок жизни записи, после истечения которого, записи будут автоматически удаляться.
Наиболее известные СУБД такого типа — Redis и Memcached.
Когда выбирать СУБД ключ-значение
Если СУБД будет использоваться для кэширования данных или для брокеров сообщений, то это очень подходящий тип. Так же, такая СУБД хорошо подходит для баз где нужно хранить достаточно простые структуры, и иметь к ним очень быстрый доступ.
Когда не выбирать СУБД ключ-значение
Если вы предполагаете хранить в базе данных много сущностей (таблиц), а у сущностей будут сложные структуры с разными типами данных. Так же, если вы предполагаете делать из этой таблицы сложные запросы которые возвращают множества строк.
Документные СУБД
Документные или документно-ориентированные СУБД — это одна из наиболее популярных разновидностей NoSQL СУБД, где основной единицей логической модели данных является документ — структурированный текст, с определенным синтаксисом.
Иногда встречаются мнения что модель данных в документных БД похожа на модель данных в объектно-ориентированных базах данных. В этом есть доля правды, единственная реальная разница между ними заключается в том, что базы данных документов только сохраняют состояние, но не поведение.
Так же, само название «документо-ориентированная» подчас вводит в заблуждение, и мне встречались коллеги, которые считали, что это база для систем документооборота. Нет, это не так.
Интересно, что документные СУБД развиваются достаточно активно, и сейчас некоторые из них, в том числе, поддерживают проверку схемы.
Известными представителями таких СУБД являются CouchDB, MongoDB, Amazon DocumentDB.
Когда выбирать документную СУБД
Если нужно хранить объекты в одной сущности, но с разной структурой. Если нужно хранит структуры, включая объекты, списки и словари, особенно в формате близкому к JSON.
На самом деле область применения документных СУБД очень широкая. Их можно использовать как компактную базу данных для отдельно взятого микро-сервиса, так и для вполне масштабных решений, в качестве хранилища состояний чего-либо.
Когда не выбирать документную СУБД
Не самое лучшее решение для реализации транзакционная модели, и точно не лучший вариант для формирования отчетности.
Графовые СУБД
Графовые СУБД — специфичный тип, предназначены для работы с графами, с их узлами, свойствами, и произвольными отношениями между узлами.
Очень простой пример, это организация связей в различного типа социальных сетях, где нужно хранить связи между пользователями (узлами) по разным критериям (родственные связи, коллеги, общие интересы).
Известные представители этого типа субд — Neo4j, Amazon Neptune, InfiniteGraph, InfoGrid.
Когда выбирать графовые СУБД
Точно стоит обратить внимание на графовые СУБД, если строите какое-то подобие социальной сети, или реализуете систему оценок и рекомендаций. Ну и во всех случаях когда вы хорошо понимаете что такое графы, и для чего это нужно.
Когда не выбирать графовые СУБД
Практически во всех остальных случаях, кроме указанных выше, лучше воздержаться от использования графовых СУБД.
Колоночные СУБД
Колоночные СУБД очень похожи на реляционные. Они так же состоят из строк, которые имеют атрибуты, а строки группируются в таблицах. Различия в логических моделях несущественные, а вот на уровне физического хранения данных различия значительные.
В реляционных СУБД данные хранятся «построчно», это означает что для считывания значения определенной колонки, придется прочитать практически всю строку, как минимум от первой до нужной колонки. В колоночной СУБД данные хранятся «поколоночно», т.е. колонка — это как отдельная таблица. Соответственно чтение будет происходить из конкретного столбца сразу. На практике это реально работает очень быстро (проверено мной на нескольких реализованных хранилищах данных).
Основные преимущества колоночных СУБД – эффективное выполнения сложных аналитических запросов на больших объемах, и легкое, практически мгновенное, изменение структуры таблиц с данными, плюс существенная компрессия и сжатие, которое позволяет значительно экономить место.
Яркие представители колоночных СУБД — Sybase IQ (ныне SAP IQ), Vertica, ClickHouse, Google BigTable, InfoBright, Cassandra.
Когда выбирать колоночные СУБД
Один из весомых аргументов за использование именно колоночной СУБД — это если вы хотите построить хранилище данных, и планируете делать выборки со сложными аналитическими вычислениями. Косвенный признак, который так же может сигнализировать о том, что имеет смысл, хотя бы посмотреть в сторону колоночных СУБД — это если количество строк, из которых делаются выборки, превышает сотни миллионов.
Когда не выбирать колоночные СУБД
Учитывая специфику колоночных СУБД, будет не эффективно ее использовать, если выборки достаточно простые, параметры выборки статичны, и если преобладают выборки по ключевым значениям. Так же, если количество строк в таблице, из которой делается выборка, меньше сотен миллионов строк, то скорее всего не будет большого преимущества, по сравнению с реляционной СУБД.
Нужно так же иметь ввиду, что в колоночных СУБД могут быть и другие ограничения. Например, может отсутствовать поддержка транзакций, а язык запросов может отличаться от классического SQL, и прочее.
Итоги
Важное замечание – не пытайтесь сразу все задачи решить в рамках одной СУБД. Это более чем нормально иметь несколько разных типов СУБД. Так же, не пытайтесь сразу определиться с производителем СУБД, или связать свою жизнь с одним конкретным брендом.
При выборе типа СУБД следует, прежде всего, исходить из типа решаемых задач, типов обрабатываемых данных, перспектив роста и масштабирования.
Обращайте так же внимание на популярность и наличие широкого круга разработчиков и средств разработки – это даст вам возможность, при необходимости, найти ответ на возникший вопрос быстро.
В данной статье я намеренно не делаю акцент на выбор между облачными и on-premise решениями — эта тема одной из следующих статей.
Итак, в таблице представленной ниже, кратко собрано то, что описано выше в статье.
Тип СУБД
Когда выбирать
Примеры популярных СУБД
Нужна транзакционность; высокая нормализация; большая доля операций на вставку
Oracle, MySQL, Microsoft SQL Server, PostgreSQL
Задачи кэширования и брокеры сообщений
Для хранения объектов в одной сущности, но с разной структурой; хранение структур на основе JSON
CouchDB, MongoDB, Amazon DocumentDB
Задачи подобные социальным сетям; системы оценок и рекомендаций
Neo4j, Amazon Neptune, InfiniteGraph, InfoGrid
Хранилища данных; выборки со сложными аналитическими вычислениями; количество строк в таблице превышает сотни миллионов
Vertica, ClickHouse, Google BigTable, Sybase \ SAP IQ, InfoBright, Cassandra
Надеюсь данная статья оказалась полезной.
В следующих статьях посмотрим на выбор между облачными и on-premise СУБД, платными и бесплатными, и многое другое.