
Начало работы с MS SQL Server
Базу данных часто отождествляют с набором таблиц, которые хранят данные. Но это не совсем так. Лучше сказать, что база данных представляет хранилище объектов. Основные из них:
- Таблицы : хранят собственно данные
- Представления (Views): выражения языка SQL, которые возвращают набор данных в виде таблицы
- Хранимые процедуры : выполняют код на языке SQL по отношению к данным к БД (например, получает данные или изменяет их)
- Функции : также код SQL, который выполняет определенную задачу
В SQL Server используется два типа баз данных: системные и пользовательские. Системные базы данных необходимы серверу SQL для корректной работы. А пользовательские базы данных создаются пользователями сервера и могут хранить любую произвольную информацию. Их можно изменять и удалять, создавать заново. Собственно это те базы данных, которые мы будем создавать и с которыми мы будем работать.
Системные базы данных
В MS SQL Server по умолчанию создается четыре системных баз данных:
- master : эта главная база данных сервера, в случае ее отсутствия или повреждения сервер не сможет работать. Она хранит все используемые логины пользователей сервера, их роли, различные конфигурационные настройки, имена и информацию о базах данных, которые хранятся на сервере, а также ряд другой информации.
- model : эта база данных представляет шаблон, на основе которого создаются другие базы данных. То есть когда мы создаем через SSMS свою бд, она создается как копия базы model.
- msdb : хранит информацию о работе, выполняемой таким компонентом как планировщик SQL. Также она хранит информацию о бекапах баз данных.
- tempdb : эта база данных используется как хранилище для временных объектов. Она заново пересоздается при каждом запуске сервера.
Все эти базы можно увидеть через SQL Server Management Studio в узле Databases -> System Databases :
Эти базы данных не следует изменять, за исключением бд model.
Если на этапе установки сервера был выбран и установлен компонент PolyBase, то также на сервере по умолчанию будут расположены еще три базы данных, которые используется этим компонентом: DWConfiguration, DWDiagnostics, DWQueue.
Создание базы данных в SQL Management Studio
Теперь создадим свою базу данных. Для этого мы можем использовать скрипт на языке SQL, либо все сделать с помощью графических средств в SQL Management Studio. В данном случае мы выберем второй способ. Для этого откроем SQL Server Management Studio и нажмем правой кнопкой мыши на узел Databases . Затем в появившемся контекстном меню выберем пункт New Database :
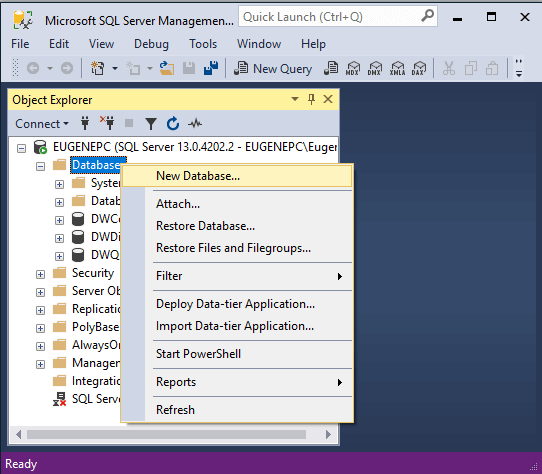
После этого нам открывается окно для создания базы данных:
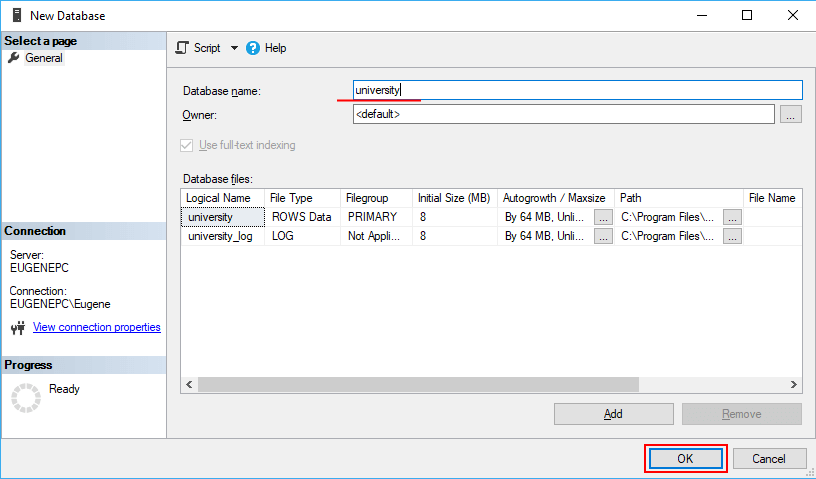
В поле Database необходимо ввести название новой бд. Пусть у нас база данных называется university .
Следующее поле Owner задает владельца базы данных. По умолчанию оно имеет значение , то есть владельцем будет тот, кто создает эту базу данных. Оставим это поле без изменений.
Далее идет таблица для установки общих настроек базы данных. Она содержит две строки — первая для установки настроек для главного файла, где будут храниться данные, и вторая строка для конфигурации файла логгирования. В частности, мы можем установить следующие настройки:
- Logical Name : логическое имя, которое присваивается файлу базы данных.
- File Type : есть несколько типов файлов, но, как правило, основная работа ведется с файлами данных (ROWS Data) и файлом лога (LOG)
- Filegroup : обозначет группу файлов. Группа файлов может хранить множество файлов и может использоваться для разбиения базы данных на части для размещения в разных местах.
- Initial Size (MB) : устанавливает начальный размер файлов при создании (фактический размер может отличаться от этого значения).
- Autogrowth/Maxsize : при достижении базой данных начального размера SQL Server использует это значение для увеличения файла.
- Path : каталог, где будут храниться базы данных.
- File Name : непосредственное имя физического файла. Если оно не указано, то применяется логическое имя.
После ввода названия базы данных нажмем на кнопку ОК, и бд будет создана.
После этого она появится среди баз данных сервера. Если эта бд впоследствии не потребуется, то ее можно удалить, нажав на нее правой кнопкой мыши и выбрав в контекстном меню пункт Delete:
Базы данных и начало работы с SQL

Эта статья имеет широкий спектр применения и будет актуальна для тех, кто хочет больше узнать о том, как управляются и обрабатываются данные в современном информационном мире, и особенно для людей, которые интересуются программированием и планируют строить карьеру в IT.
Статья предоставит читателю обзор основ баз данных и систем управления базами данных, а также поможет начать начать работу с языком структурированных запросов SQL.
В современном информационном обществе данные играют ключевую роль в различных аспектах жизни. От бизнеса и науки до повседневных дел, они стали неотъемлемой частью нашего существования. Однако с возрастающим объёмом информации важно находить и использовать новые эффективные и надежные методы хранения, обработки и управления информацией. В этом контексте большую значимость представляют базы данных и системы управления базами данных (СУБД).
Обычные файлы и папки могут быть удобны для хранения информации небольших проектов, но при росте объёма информации они становятся неэффективны и сложны в управлении, поэтому большинство проектов используют Базы данных (БД).
Базы данных являются структурированными сборниками информации, организованные таким образом, чтобы обеспечить эффективное хранение, управление и доступ к информации. Они играют важную роль в различных аспектах нашей современной информационной жизни. Вот некоторые из основных причин, для которых они необходимы.

- Предоставляют механизм для долгосрочного хранения больших объёмов информации. БД могут содержать данные о клиентах, продуктах, заказах, финансах, организационной структуре и многом другом.
- Позволяют систематизировать информацию с определенными правилами, что облегчает их управление. Это включает добавление, обновление, удаление и поиск данных.
- Ориентированы на максимальную производительность доступа к информации, что обеспечивает быструю обработку запросов и минимизирует время ответа.
- Возможность обслуживать одновременно множество пользователей, обеспечивая доступ к данным с различными уровнями разрешений.
- Предоставляют инструменты, обеспечивающие безопасность данных через реализацию прав доступа, применение шифрования и проведение аудита операций.
- В БД можно устанавливать правила целостности данных. Эти правила гарантируют, что информация остается согласованной и непротиворечивой.
- БД позволяют создавать резервные копии данных, что обеспечивает возможность восстановления данных после сбоев или потери информации.
- Современные БД поддерживают опцию проведения анализа информации с последующим созданием отчетов. Это помогает выявлять тенденции, принимать решения и планировать деятельность.
- Базы данных применяются в разнообразных приложениях, включая веб-сайты, мобильные приложения и корпоративные системы, чтобы обеспечить хранение и обработку данных.
- Позволяют расширяться и добавлять новые данные и функции по мере необходимости.
Виды баз данных
В области информационных технологий существует несколько различных категорий баз данных, каждая из которых предназначена под определенные задачи и сценарии. Вот несколько из наиболее распространенных типов баз данных.
- Реляционные базы данных (RDBMS) — это самый распространенный тип баз данных. Они основаны на табличной структуре, где данные организованы в виде таблиц с рядами и столбцами.
- NoSQL (Not Only SQL) — это семейство баз данных, разработанных для работы с разнородными и неструктурированными данными. К этой категории относятся:
- Документоориентированные БД. В них информация хранится в виде документов, обычно в формате JSON или BSON (бинарный формат JSON).
- Ключ-значение БД. Записи хранятся в виде пар ключ-значение.
- Колоночные. В этом типе данные организованы по столбцам, что облегчает работу с большими объемами данных при чтении и записи.
- Графовые. Ориентированы на работу с графовыми структурами данных, состоящими из узлов и связей.
- Временные ряды (Time-Series). Оптимизированы для хранения и обработки временных рядов данных, обычно с хронологическими метками.
- Object-Oriented Database Management System (OODBMS) — эти БД позволяют хранить объекты и классы из языков программирования, что упрощает хранение и доступ к сложным структурам данных, включая наследование и полиморфизм.
- OLAP (Online Analytical Processing) базы данных. Они предназначены для аналитической обработки и агрегации данных и облегчают сложные многомерные запросы и анализ данных.
- Интернет вещей (IoT) БД. Оптимизированы для работы с огромным объемом данных, сгенерированных устройствами интернета вещей. Примеры: ThingSpeak, CrateDB.
- Иерархические базы данных. Этот тип баз данных организован в виде иерархических структур с вложенными уровнями. Одна запись может иметь несколько дочерних записей. Такие базы данных часто используются в старых системах управления базами данных, например в In-Memory Database.
Это лишь некоторые из множества типов БД, доступных в сфере информационных технологий. Каждый тип баз данных имеет свои преимущества и сферу применения. Выбор определенного типа зависит от требований и характеристик проекта или приложения.
Что такое СУБД и SQL? Разбираемся с понятиями
Система управления базами данных (СУБД) — это программное обеспечение, предназначенное для создания, управления, обновления и анализа баз данных. Она обеспечивает интерфейс для взаимодействия пользователя или приложения с данными, хранящимися в базе данных. СУБД позволяют структурировать данные таким образом, чтобы обеспечить их легкий доступ, безопасность и эффективное использование.

СУБД предоставляют различные функции.

- Позволяют определить структуру БД, включая таблицы, поля, связи и ограничения.
- Обеспечивает добавление, изменение и удаление записей в БД с помощью стандартных команд.
- Поддерживают правила, гарантирующие, что данные остаются согласованными и целостными.
- Позволяют группировать операции в транзакции для обеспечения атомарности, согласованности, изолированности и долговечности (ACID-свойства).
- Управляет доступом к информации и защищает их от несанкционированного доступа.
- Оптимизирует запросы и структуру информации, чтобы обеспечить быстрое выполнение запросов.
SQL (Structured Query Language) — это специализированный язык программирования, предназначенный для взаимодействия с реляционными базами данных. С помощью SQL можно осуществлять различные операции с информацией с помощью запросов, включая добавление, изменение и удаление записей, а также создание и модификацию таблиц и прочие операции.

Подытожим, СУБД и SQL взаимодействуют между собой, обеспечивая эффективное управление и работу с информацией. СУБД предоставляют средства для создания и управления БД, а SQL позволяет выполнять различные операции с записями в этих базах, что делает их основой современных информационных систем.
Операторы SQL и как их использовать
Оператор CREATE TABLE применяется при создании новой таблицы в БД. Он определяет структуру таблицы, указывая имена столбцов и типы их данных. Вот синтаксис оператора CREATE TABLE:

table_name — имя таблицы, которую создаем.
column1, column2, . — имена столбцов таблицы.
datatype1, datatype2, . — типы данных для каждого столбца.
constraints — ограничения, которые можно применить к столбцам, такие как PRIMARY KEY, NOT NULL, UNIQUE, FOREIGN KEY и другие.
Пример создания таблицы «Employees» с семью столбцами:

EmployeeID — целочисленный тип данных (INT), который является PRIMARY KEY для уникальной идентификации каждого сотрудника.
FirstName и LastName — строки переменной длины (VARCHAR) с максимальной длиной 50 символов. Они также имеют ограничение NOT NULL, записи не могут быть пустыми.
Age — целочисленный тип данных (INT) для хранения возраста сотрудника.
Department — строка переменной длины (VARCHAR) с максимальной длиной 100 символов, в которой будет храниться название департамента.
Salary — числовой тип данных (DECIMAL) с общим размером 10 и 2 знаками после запятой, используемый для хранения заработной платы сотрудника.
HireDate — тип данных DATE для хранения даты найма сотрудника.
Обратите внимание, что каждый столбец в таблице должен иметь уникальное имя, а типы данных и ограничения должны соответствовать данным, которые вы хотите хранить в таблице. Оператор CREATE TABLE является мощным инструментом для определения структуры вашей БД и поддержки целостности информации.
INSERT применяется для вставки новых записей в таблицу БД. Он позволяет добавлять данные в таблицу, указывая значения для каждого столбца, или вставлять информацию из другой таблицы или результатов подзапроса.
Синтаксис оператора INSERT:

column1, column2, . — имена столбцов, в которые вставляем данные.
value1, value2, . — значения, которые вы хотите вставить в соответствующие столбцы. Значения нужно указывать в том же порядке, что и столбцы.
Пример вставки данных:

В этом примере мы вставляем информацию о сотруднике в таблицу «Employees». Мы указываем значения для каждого столбца в том же порядке, что и столбцы в определении таблицы. Здесь EmployeeID, FirstName, LastName, Age, Department, Salary и HireDate — это имена столбцов таблицы «Employees», а значения, которые мы указываем, соответствуют этим столбцам для новой записи о сотруднике.
Если вы не хотите указывать значения для всех столбцов, вы можете вставить данные только в определенные столбцы, указав их имена в операторе INSERT. Например, если у нас есть таблица с двумя столбцами «FirstName» и «LastName», и «LastName» допускает значение NULL, мы можем вставить только имя без фамилии:

Это создаст новую запись с именем «Alice» и фамилией, равной NULL.
Оператор SELECT применяется для выборки записей из таблицы или результатов подзапроса. Этот оператор позволяет получить информацию из БД в соответствии с определенными условиями и затем вернуть результат в виде набора строк.

condition — условие, которое определяет, какие строки будут выбраны. Это необязательное поле. Если оно не указано, будут выбраны все строки из таблицы.
Допустим, у нас есть таблица «Employees» со столбцами: EmployeeID, FirstName, LastName, Age, Department, Salary, и HireDate. И мы хотим выбрать имена и фамилии всех сотрудников, работающих в департаменте «IT» и зарабатывающих более 40000.00:

Результатом этого запроса будет набор строк, содержащий имена и фамилии всех сотрудников, которые удовлетворяют условиям (работающих в департаменте «IT» и зарабатывающих более 40000.00).
Можно также использовать функции агрегации, чтобы выполнять такие операции над данными, как COUNT, SUM, AVG, MIN и MAX. Например, чтобы подсчитать количество сотрудников в департаменте «IT»:

Это вернет число, равное количеству сотрудников в департаменте «IT».
Оператор SELECT предоставляет много возможностей для извлечения данных из базы данных. Вы можете выбрать определенные столбцы, установить условия, сортировать результаты и использовать агрегатные функции для получения нужной информации.
Условные операторы WHERE и HAVING используются для фильтрации записей в результате запроса. Они применяются для выставления условия, которое определяет, какие строки будут включены в результаты запроса. Однако они применяются в разных частях запроса и с разными функциями.
Оператор WHERE применяется в операторе SELECT, UPDATE и DELETE для фильтрации строк в результате запроса. Он позволяет выбрать только те строки, которые удовлетворяют определенному условию. В условии обычно вызываются операторы сравнения, логические операторы и другие условия.
Пример использования оператора WHERE
Допустим, у нас есть таблица «Employees» с полями EmployeeID, FirstName, LastName и Salary. Мы хотим выбрать всех сотрудников, чья зарплата больше 50000:

В этом примере оператор WHERE фильтрует строки и выбирает только те, где значение столбца Salary больше 50000.
Оператор HAVING применяется в операторе SELECT с использованием агрегатных функций (например, COUNT, SUM, AVG, MIN, MAX) и группировкой данных с помощью оператора GROUP BY. Он позволяет фильтровать результаты группировки на основе агрегатных функций.
Пример использования оператора HAVING
Допустим, у нас есть таблица «Orders» с полями OrderID, CustomerID и TotalAmount. Мы хотим получить общую сумму заказов для каждого клиента и выбрать только тех клиентов, у которых общая сумма заказов больше 1000:

В этом примере оператор HAVING применяется после оператора GROUP BY для фильтрации результатов группировки. Он выбирает только те группы клиентов, у которых общая сумма заказов (рассчитанная с помощью функции SUM) больше 1000.
Важно знать, что оператор WHERE применяется до группировки данных (если есть), тогда как оператор HAVING применяется после группировки данных. Поэтому, если вы хотите фильтровать строки до группировки, используйте WHERE, а если после группировки — используйте HAVING.
Операторы GROUP BY и ORDER BY используются для группировки данных и сортировки результатов запроса соответственно.
Оператор GROUP BY применяется в операторе SELECT совместно с агрегатными функциями (например, COUNT, SUM, AVG, MIN, MAX) для группировки данных по определенным столбцам. Это позволяет выполнить агрегатные операции на каждой группе данных отдельно.
Синтаксис оператора GROUP BY:

Пример использования оператора GROUP BY
Допустим, у нас есть таблица «Orders» с полями OrderID, CustomerID и TotalAmount. Мы хотим получить общую сумму заказов для каждого клиента:

В примере мы группируем записи по столбцу CustomerID, а затем для каждой группы (каждого клиента) вычисляем общую сумму заказов с помощью функции SUM.
Оператор ORDER BY используется в операторе SELECT для сортировки результатов запроса в определенном порядке (возрастающем или убывающем) на основе значений одного или нескольких столбцов.
Синтаксис оператора ORDER BY:

Пример использования оператора ORDER BY
Допустим, у нас есть таблица «Employees» с полями EmployeeID, FirstName, LastName и Salary. Мы хотим выбрать имена и фамилии всех сотрудников и отсортировать результаты по заработной плате (по убыванию):

В этом примере мы выбираем имена, фамилии и заработную плату всех сотрудников и сортируем результаты в порядке убывания по столбцу Salary.
Обратите внимание, что оператор GROUP BY и оператор ORDER BY могут использоваться вместе в одном запросе. Например, вы можете сначала сгруппировать данные по одному столбцу с помощью GROUP BY, а затем отсортировать результаты групп по другому столбцу с помощью ORDER BY.
Операторы JOIN (INNER JOIN, LEFT JOIN, RIGHT JOIN) используются для объединения записей из двух или более таблиц на основе условия соответствия между столбцами. Они позволяют объединять информацию из разных таблиц и получать более полную информацию, чем при работе с отдельными таблицами.
INNER JOIN (внутреннее объединение)
Оператор INNER JOIN используется для объединения только тех строк, которые удовлетворяют условию соответствия из обеих таблиц. Он возвращает только те строки, для которых есть соответствующие значения в обеих таблицах.
Синтаксис INNER JOIN:

Пример использования INNER JOIN
Например, у нас есть две таблицы «Customers» и «Orders», и мы хотим получить информацию о клиентах и их заказах, для которых есть соответствующие записи в обеих таблицах:

LEFT JOIN (левое объединение или LEFT OUTER JOIN)
Оператор LEFT JOIN применяется для объединения всех строк из таблицы слева (левая таблица) и только соответствующих строк из таблицы справа (правая таблица). Если в правой таблице нет совпадающих значений, то будут использоваться NULL значения.
Синтаксис LEFT JOIN:

Пример использования LEFT JOIN
Допустим, у нас есть таблицы «Customers» и «Orders», и мы хотим получить информацию о клиентах и их заказах, даже если для некоторых клиентов нет соответствующих заказов:

RIGHT JOIN (правое объединение или RIGHT OUTER JOIN):
Оператор RIGHT JOIN используется для объединения всех строк из таблицы справа (правая таблица), и только соответствующие строки из таблицы слева (левая таблица). Если в левой таблице нет соответствующих значений, то будут использоваться NULL значения.
Синтаксис RIGHT JOIN:

Пример использования RIGHT JOIN
Допустим, у нас есть таблицы «Customers» и «Orders», и мы хотим получить информацию о заказах и клиентах, даже если для некоторых заказов нет соответствующих клиентов:

Обратите внимание, что в большинстве СУБД также доступен оператор FULL JOIN (полное объединение или FULL OUTER JOIN), который возвращает все строки из обеих таблиц, независимо от того, есть ли у них соответствующие значения. Однако синтаксис может немного отличаться от приведенных выше примеров в зависимости от используемой СУБД.
Хоть начало работы с SQL может показаться не таким уж простым, со временем, чаще применяя знания на практике, вы сможете не только уверенно использовать эти запросы, но и писать более сложные. Базы данных и SQL — это не только инструменты для хранения данных, но и основа для анализа и принятия важных бизнес-решений. Поэтому, если вы интересуетесь разработкой программного обеспечения или планируете карьеру в IT-индустрии, изучение баз данных и SQL станет важной ступенькой вашего профессионального роста.
Автор статьи @Luckker
НЛО прилетело и оставило здесь промокод для читателей нашего блога:
-15% на заказ любого VDS (кроме тарифа Прогрев) — HABRFIRSTVDS.
Основы работы с MSSQL
Поговорим о том, как работает БД MSSQL, зачем она нужна и как настроить свой SQL-сервер Microsoft.
Что такое база данных
База данных – это система хранения информации. Она является постоянным онлайн-хранилищем, в котором можно держать любые данные, необходимые для корректной работы вашего приложения – комментарии, статьи, профили пользователей, списки избранных материалов, песни, видео в YouTube. Все это можно считать элементами БД.
Базы данных позволяют хранить, добавлять, модифицировать и находить информацию по запросу программиста.
Комьюнити теперь в Телеграм
Подпишитесь и будьте в курсе последних IT-новостей
Что такое SQL
SQL – это язык для «общения» с базами данных. Специальный синтаксис, позволяющий при помощи несложных команд запрашивать информацию из БД или, наоборот, добавлять в нее новый контент. SQL часто используется в реляционных базах данных, где соседние элементы тесно связаны друг с другом и организуются при помощи таблиц. Схожий синтаксис используется в БД MySQL, PostgresSQL и SQL Server от Microsoft (собственно, это и есть наша MSSQL).
SQL используется как в специальных приложениях для взаимодействия с базами данных, так и на программном уровне (непосредственно в коде ваших сайтов и других проектов).
MySQL и MSSQL – одно и то же?
Нет. Как уже было отмечено выше, существует множество баз данных. MySQL чаще остальных упоминается в сети, так как является наиболее популярным вариантом БД. Она имеет открытый исходный код и распространяется бесплатно, поэтому и сыскала любовь массовой аудитории.
MSSQL – это продукт Microsoft, существующий как в коммерческой, так и в бесплатной версии. И несмотря на то, что оба продукта используют схожий синтаксис, они отличаются друг от друга с точки зрения функциональности и в плане поддержки со стороны разработчиков.
Также существует PostgreSQL – еще одна популярная база данных с высоким уровнем отказоустойчивости и большой коллекцией расширений.
Какой вариант SQL выбрать?
Вариант Microsoft отличается от конкурентов заточенностью под корпоративные задачи. В частности, решение MSSQL может похвастать повышенной надежностью. Пользователь не вправе вносить изменения в базу данных, пока она функционирует и используется приложением. Добавлять данные на SQL-сервер необходимо в момент, когда БД выключена.
При этом MSSQL Server позволяет прерывать запросы, в то время как основной конкурент базы в лице MySQL такого не допускает.
Но зато решение Microsoft стоит денег, и бесплатно разместить у себя SQL-сервер не получится (есть пробная версия и специальный вариант MSSQL для разработчиков, но использовать их в коммерческих целях нельзя).
Как настроить MSSQL?
Чтобы начать работать с Microsoft SQL Server, надо раздобыть копию самого сервера, а также установить программу для управления базами данных Microsoft через графический интерфейс.
О том, как запустить SQL-сервер подробно рассказывается на официальном сайте Microsoft. Там же есть и бесплатный дистрибутив платформы под названием Developer. Для первого знакомства с Microsoft SQL Server, отладки и тестирования кода Developer-версии будет достаточно. Загружаем ее и запускаем.
Затем устанавливаем приложение SQL Server Management Studio. Это графическая оболочка для редактирования информации в SQL-таблицах базы данных Microsoft.
Подключение к SQL-серверу
Для начала откроем утилиту SQL Server Management Studio. Все манипуляции мы будем проделывать через нее. При первом же запуске эта программа попросит вас подключиться к SQL-серверу. В интерфейсе программы он называется Database Engine.
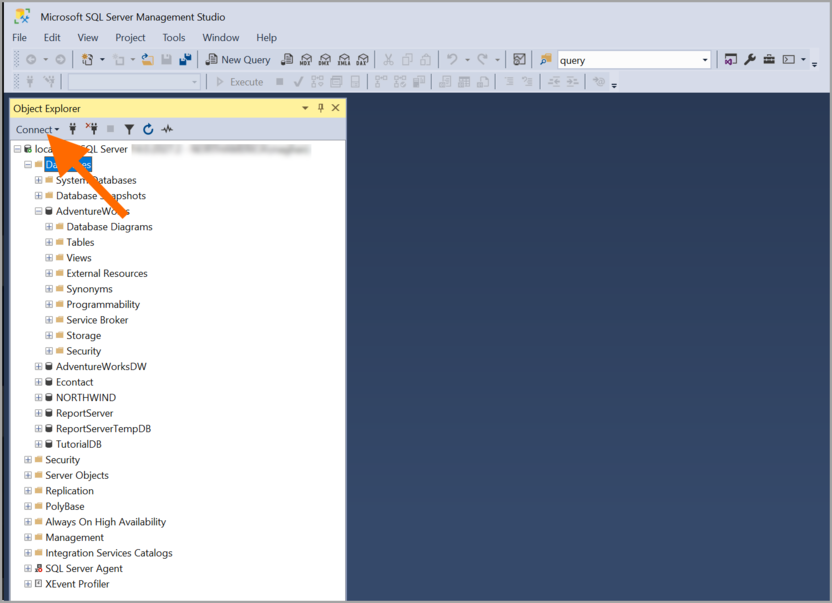
Приложение запросит ряд данных для подключения.
- Тип сервера (можно оставить по умолчанию, так как пока мы работаем с локальной копией MSSQL).
- Имя сервера. Нужно его заменить, если вы переименовывали сервер, когда запускали собственную копию базы данных на локальной машине.
- Способ аутентификации. Стоит оставить по умолчанию, если не хотите вводить пароль и логин от базы данных (или если вы вовсе их не устанавливали).
Указав необходимую информацию, нажимаем на кнопку Connect. Через несколько секунд соединение должно быть установлено, а в окне Object Explorer появится информация о SQL-сервере и его содержимом.
Создание базы
Важный момент заключается в том, что SQL-сервер и база данных – не одно и то же. Поэтому, запустив сервер и подключившись к нему, вам все еще необходимо создать базу самостоятельно.
Для этого в SQL Server Management Studio:
- Правой кнопкой мыши кликаем по названию сервера в окне Object Explorer.
- В списке опций находим пункт New Query.
- Появится окно для ввода запроса. Здесь как раз поддерживается SQL-синтаксис – с помощью него мы и создадим новую базу данных.
USE master GO IF NOT EXISTS ( SELECT name FROM sys.databases WHERE name = N'databaseName' ) CREATE DATABASE [databaseName] GO
Только вместо databaseName укажите название БД на свой вкус, не меняя соседних символов и других участков кода.
- После этого активируем запрос, нажав на кнопку Execute в левой части интерфейса программы или на клавишу F5.
Создание таблиц
Следующая по важности структура в БД – таблица. Это набор данных, связанных какой-то характеристикой. Например, в таблице могут храниться статьи из блога. Таблицей может быть плейлист в Spotify. Отдельной таблицей может быть ветка в Твиттере или список пользователей в Facebook. Способы применения таблиц ограничиваются только фантазией разработчика.
А еще таблицы визуально напоминают Excel, поэтому для многих будет привычным подобный интерфейс.
Чтобы создать новую таблицу:
- Кликаем по выпадающему меню со списком доступных баз данных (это поле под основным меню справа от значка в виде вилки).
- В появившемся списке выбираем свою базу.
- Снова делаем SQL-запрос к базе:
USE [myTable] IF OBJECT_ID('dbo.Posts', 'U') IS NOT NULL DROP TABLE dbo.Posts GO CREATE TABLE dbo.Posts ( postId INT NOT NULL PRIMARY KEY, -- primary key column Title [NVARCHAR](50) NOT NULL, Category [NVARCHAR](50) NOT NULL, Content [NVARCHAR](50) NOT NULL ); GO
- Активируем запрос, нажав на клавишу F5.
После этого в Object Explorer появится новое поле, отражающие вновь созданную таблицу со всеми необходимыми поддиректориями (колонками, строками и т.п.).
Встраивание строк в таблицу
Сами по себе таблицы не особо полезны, если в них нет какого-либо контента. Контент добавляется с помощью строк. Строка – это набор данных, включающий в себя информацию по пунктам, соответствующим колонкам в таблице. А колонки в таблице – это список параметров, что мы указали выше, когда создавали таблицу (в нашем случае это были пункты postId, Title, Category и Content).
Чтобы добавить строки в таблицу, снова воспользуемся SQL-выражением:
INSERT INTO dbo.Customers ([postId],[Title], [Category], [Content]) VALUES ( 1, N'About apes', N'Animals', N'Apes are cool'), ( 2, N'Story', N'Articles', N'The story about dead women killer'), ( 3, N'Very important article', N'News', N'Not so important information'), GO
В запросе мы указываем наименования колонок, которые будут заполнены данными из списка запросов. В поле VALUE как раз указываются нужные данные в заранее определенном порядке. То есть первый элемент в строке станет Id, второй элемент будет Title и т.п.
Создание запросов к базе данных MSSQL
До этого мы делали SQL-запросы, которые позволяют модифицировать базу. То есть добавлять в нее новую информацию, создавать таблицы, колонки и строки. Но немаловажным является умение добывать информацию из БД, чтобы отображать ее в интерфейсе приложения или веб-сайта.
Обычно такие запросы указываются в программном коде, но и в SQL Server Management Studio их можно протестировать. Например, чтобы отобразить все строки из таблицы Posts, мы используем запрос:
SELECT * FROM dbo.Posts
В блоке Results отобразятся все строки из таблицы. Здесь же можно их отредактировать, не покидая визуальный редактор.
Программное подключение
Чтобы подключиться к базе данных Microsoft из приложения, необходимо создать функцию соединения с сервером, создав строку, содержащую в себе информацию о сервере. Его название, расположение, а также данные для аутентификации (логин и пароль). Точная схема подключения зависит от выбранного языка программирования. В случае с C#, например, применяется команда SqlConnection и строка connectionString, как показано здесь.
Информацию для других языков можно найти в официальной документации и на Stack Overflow.
Вместо заключения
Теперь вы можете создать локальную копию базы данных Microsoft и добавить в нее всю необходимую информацию. Даже если вы никогда не работали с БД, вы быстро поймете, насколько это логичный и удобный интерфейс для манипуляции контентом. Главное – практиковаться.
Работа с базами данных SQL для новичков
Работу с базами данных SQL, как структурированный язык запросов, выполняет практически идеально. Более того, он считается основным инструментом для взаимодействия с реляционными БД, позволяющим проводить с ними самые разные манипуляции.
И пусть возраст SQL насчитывает уже несколько десятилетий, он до сих пор используется весьма широко. Создать без него нечто серьезное весьма затруднительно.
Особенности языка SQL
SQL является непроцедурным языком программирования, предназначенным в первую очередь для описания данных, их выборки из реляционных БД и последующей обработки. Таким образом, SQL оперирует исключительно базами данных, и использовать только его для создания полноценного приложения нельзя.
В этом случае потребуются инструменты других языков, поддерживающих встраивание SQL-команд. Именно по причине своей специфичности SQL считают вспомогательным средством, позволяющим обрабатывать данные. Этот язык на практике используется только совместно с другими языками.
В общем случае прикладные средства программирования подразумевают создание процедур. SQL такими возможностями не обладает. Здесь нельзя указать способы решения задач — задается лишь смысл каждой конкретной задачи. Иначе говоря, в работе с базами данных SQL важны результаты, а не процедуры, приводящие к этим результатам.
Этот специфический язык программирования обладает одним важным свойством — возможностью доступа к реляционным базам данных. Иногда все реляционные БД ошибочно приравниваются к СУБД с применением средств SQL. На самом деле эти понятия следует различать.
Понятие реляционной СУБД
Не углубляясь в детали, можно дать такое определение: реляционной называется СУБД, использующая реляционную модель управления.
Доктор Е. Ф. Кодд в 1970 году опубликовал свою работу, где впервые было дано понятие реляционной модели. В публикации описывался некий математический аппарат, структурирующий данные и оперирующий ими. Основная идея состояла в представлении любых данных в виде абстрактной модели.
В соответствии с предложенной концепцией отношение между объектами (relation) представляет собой некую таблицу с данными. При этом существуют атрибуты (или признаки) отношения, которые соответствуют столбцам рассматриваемой таблицы. Сами данные предстают в виде наборов этих признаков и формируют записи (кортежи). Последние в свою очередь соответствуют табличным строкам.
Значения атрибутов каждого кортежа входят в домены, представляющие собой определенные наборы данных и задающие пределы допустимых значений.
Разберем это на примере. Существует домен «Неделя», в котором содержатся значения всех дней недели («Понедельник», «Вторник», …, «Воскресенье»). Атрибут, имеющий эти значения, называется «ДеньНедели». Тогда соответствие этого атрибута домену автоматически означает, что в одноименном столбце должны содержаться только перечисленные значения. Любые другие символы и группы символов недопустимы.
Узнай, какие ИТ — профессии
входят в ТОП-30 с доходом
от 210 000 ₽/мес
Павел Симонов
Исполнительный директор Geekbrains
Команда GeekBrains совместно с международными специалистами по развитию карьеры подготовили материалы, которые помогут вам начать путь к профессии мечты.
Подборка содержит только самые востребованные и высокооплачиваемые специальности и направления в IT-сфере. 86% наших учеников с помощью данных материалов определились с карьерной целью на ближайшее будущее!
Скачивайте и используйте уже сегодня:
Павел Симонов
Исполнительный директор Geekbrains
Топ-30 самых востребованных и высокооплачиваемых профессий 2023
Поможет разобраться в актуальной ситуации на рынке труда
Подборка 50+ бесплатных нейросетей для упрощения работы и увеличения заработка
Только проверенные нейросети с доступом из России и свободным использованием
ТОП-100 площадок для поиска работы от GeekBrains
Список проверенных ресурсов реальных вакансий с доходом от 210 000 ₽
Получить подборку бесплатно
Уже скачали 24080
Также запрещается ввод сразу нескольких значений. Кроме того, требуется соблюдение условия атомарности. Иначе говоря, значения нельзя объединять друг с другом и разбивать их на более мелкие составляющие, сохранив при этом смысл. В случае присутствия в ячейке атрибута сразу двух значений и более (например, «Вторник» и «Среда») атомарность теряется. Тут можно выделить две части, сохранив смысл, но при дальнейшем разбитии слов на отдельные символы исходный смысл также утратится.
Другое важное свойство отношений в СУБД — замкнутость операций. Оно заключается в том, что любая операция над отношением порождает новое отношение. Благодаря этому свойству программисты SQL получают предсказуемые результаты математических действий. Также становится возможным представление операций в виде абстрактных выражений, обладающих разными уровнями вложенности.
Популярные сервисы для работы с SQL
Как язык работы с базами данных, SQL предполагает обязательное наличие установленной БД с доступом для подключения и выполнения запросов.
С помощью данного сервиса все SQL-операции можно выполнять в облаке. Это достаточно серьезное преимущество, ведь программистам здесь нет необходимости устанавливать и настраивать СУБД на локальную машину. Достаточно лишь зарегистрироваться.
В целом процесс работы весьма простой. После регистрации необходимо войти под созданной учетной записью и выбрать пункт «SQL WorkSheet» в боковом меню слева. Откроется рабочее окно, куда, собственно, и нужно вводить SQL-запросы. Для выполнения запросов следует нажать кнопку «Run» над полем ввода текста.
Это еще одна популярная программа для работы с SQL базами данных, работающая как сервис и поддерживающая множество форматов БД. Регистрация здесь не требуется.
При входе на SQL Fiddle в первую очередь нужно выбрать подходящую для работы БД (например, Oracle). Далее создается схема из таблиц путем ввода текста специального ddl-скрипта. После нажатия на кнопку «Build Schema» можно приступать к выполнению SQL-запросов. Для их ввода используется панель «Query Panel», расположенная справа. Выполнение запроса осуществляется нажатием на «Run Sql». Результаты работы будут видны под рабочими панелями.
Основные команды SQL
Помимо трех основных команд (CREATE, UPDATE и DELETE), используются и несколько других. Перечислим их ниже с примерами для MySQL (поэтому везде после операторов стоит точка с запятой).
Итак, прежде всего создаем базу данных с текстовым наполнением.
Далее необходимо скачать файлы DLL.sql и InsertStatements.sql, а затем установить на компьютер СУБД MySQL. После чего в командной строке нужно ввести mysql -u root -p для входа в консоль MySQL.