
Как посмотреть сохраненную копию страницы сайта
В данном видео, я хотел бы рассмотреть один интересный сервис, который представляет из себя архив сохраненных копий страниц интернета, благодаря которому можно получить доступ к удаленным или недоступным интернет страницам.
И так, что такое интернет архив, а это база сохраненных интернет страниц различных сайтов, благодаря которому, вы можете посмотреть определенную страницу в таком виде, как она выглядела в определенную дату.
Для чего это может понадобиться:
Доступ к удаленным страницам – допустим у вас осталась ссылка на какую-то интересную статью, но, на данный момент данной страницы уже не существует, а вам крайне важно посмотреть ту информацию. Так вот, можно с помощью этого архива получить доступ к сохраненной копии нужной вам страницы.
Просмотр истории изменений – тоже порой интересно посмотреть историю изменения сайта или какой-то конкретной страницы. Допустим я как-то увидел на сайте замануху в виде скидки и мне захотелось узнать, а действительно ли акция ограничена или у них постоянно на сайте висит этот баннер. И через историю сохраненных страниц можно было это проверить.
В любом случае, вы можете так же найти какие-то полезные моменты для применения, а я же покажу, как это сделать.
Наиболее известный сервис это arhive.org и к примеру, у меня есть необходимость посмотреть сайт, который уже давно был закрыт https://smartresponder.ru
Вы же указываете тот сайт, или ту страницу, которая вас интересует.
Допустим, мы можем посмотреть сохраненную версию сайта, на момент, когда проект только был создан, когда он активно работал и когда закрылся.
Не скажу что, данный архив сохраняет прям все содержимое сайта иначе это занимало много места, однако довольно многое в нем сохраняется.
Так же, пробовал походить по страницам какого-нибудь ДНС, чтобы помониторить цены в определенные даты, но ничего не получилось. Я так понимаю, что из-за того, что сайты интернет магазинов меняют свое содержимое практически каждый день, и хранить все эти копии было бы очень накладно.
Но, в любом случае для каких-то ваших задач он вполне подойдет.
Кому-то интересно посмотреть, как сайты выглядели в момент, когда только появились на свет. Допустим, как выглядел яндекс в первые дни своего существования.
Сохраненные копии страниц – это не то, что находится в индексе
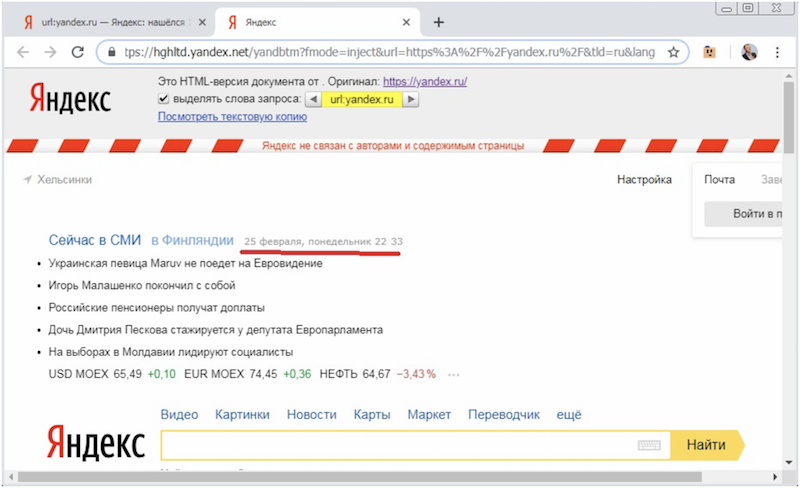
Издавна SEO-специалисты используют сохраненную копию страницы в поисковике для анализа индексации произведенных на странице изменений. Однако еще четыре года назад я заметил, что в Яндексе сохраненная копия может не совпадать с той версией страницы, которая реально находится на данный момент в поисковом индексе и используется в ранжировании. Сегодня мне хотелось бы проверить, можно сейчас ли доверять сохраненной копии Яндекса. Ну, и заодно посмотреть, как с этим обстоят дела у его основного конкурента на отечественном рынке поиска – Google. Для анализа мне понадобится страница, на которой публикуется текущая дата. Сопоставляя дату, которая находится в сохраненной копии с датой, по которой эта страница находится в поисковике, и которая может показываться при этом в ее сниппете, можно сделать вывод о соответствии версии страницы, демонстрируемой в сохраненной копии, и версии страницы, находящейся в поисковом индексе. Для нашей цели как нельзя лучше подойдет главная страница Яндекса. Итак, анализируем сначала ситуацию в самом Яндексе, найдя главную страницу Яндекса с помощью документированного оператора url: запросом url:yandex.ru и открыв ее сохраненную копию. Находим в ней дату (на момент анализа – это «25 февраля, понедельник, 22:23»):
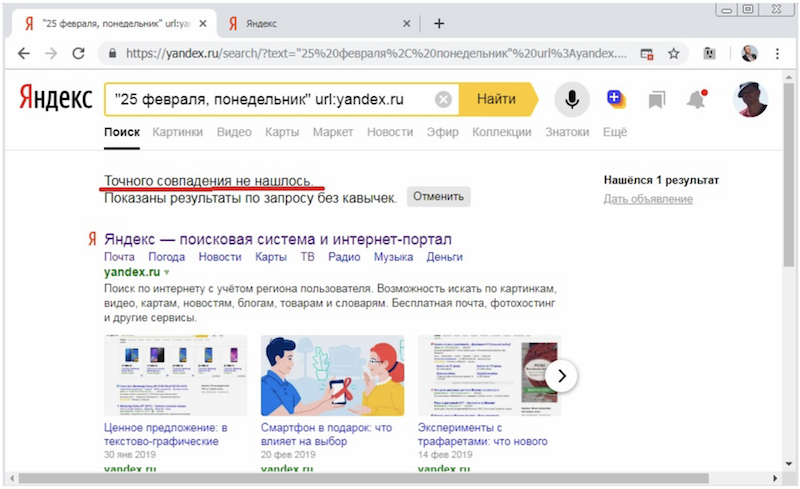
Итак, попробуем найти по точной текстовой фразе с этой датой в Яндексе его главную страницу. Увы, но сделать этого не удалось. Мы получаем сообщение, что точного совпадения не нашлось:
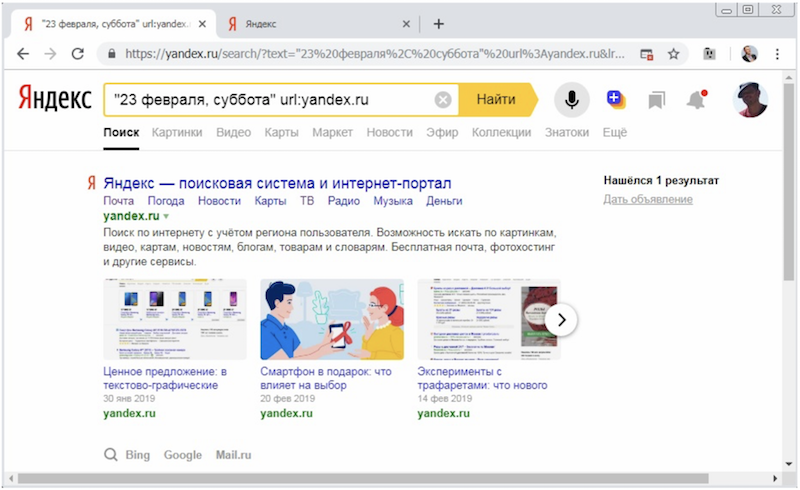
Получается, в поисковом индексе находится версия главной страницы Яндекса от другой даты. С помощью несложных манипуляций с изменением даты в поисковой фразе убеждаемся, что в индексе содержится более ранняя версия главной страницы Яндекса. К сожалению, Яндекс не соизволил нас порадовать показом текстового соответствия в сниппете (видимо, считая данный текст служебным и малозначимым), однако отсутствие фразы «Точного совпадения не нашлось» красноречиво свидетельствует о том, что именно данная фраза содержится в той версии страницы, что находится на данный момент в поисковом индексе:
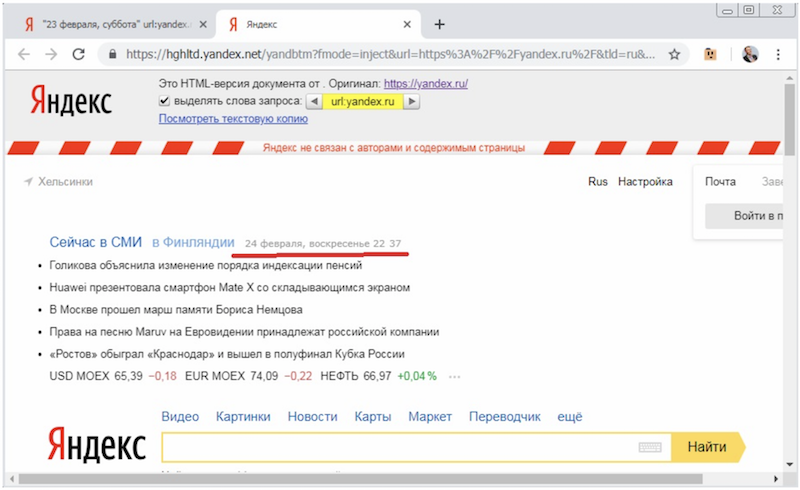
Более того, можно убедиться в том, что сохраненная копия в Яндексе может иметь несколько версий, показываемых попеременно. Так, обновляя страницу с сохраненной копией главной страницы в Яндексе, мы можем время от времени увидеть другую ее версию с другой датой (в моем случае – «24 февраля, воскресенье 22:37»), но все равно не совпадающей с той, по которой страница находится в индексе:
Итак, ситуация в Яндексе не изменилась. Сохраненная копия по-прежнему не совпадает с той, что находится в индексе и участвует в ранжировании. Ну, а что же по этому поводу думает Google? Сохраненную копию страницы можно посмотреть напрямую с помощью оператора cache. Делаем в Google запрос cache:yandex.ru, получаем сохраненку и находим в ней дату:
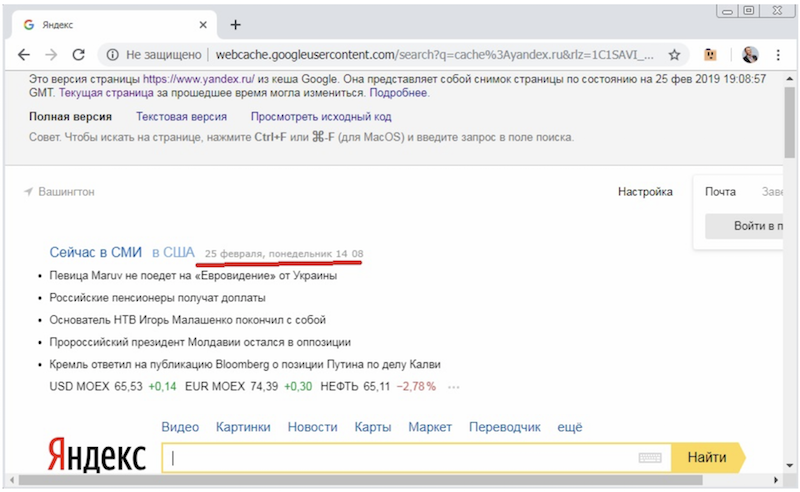
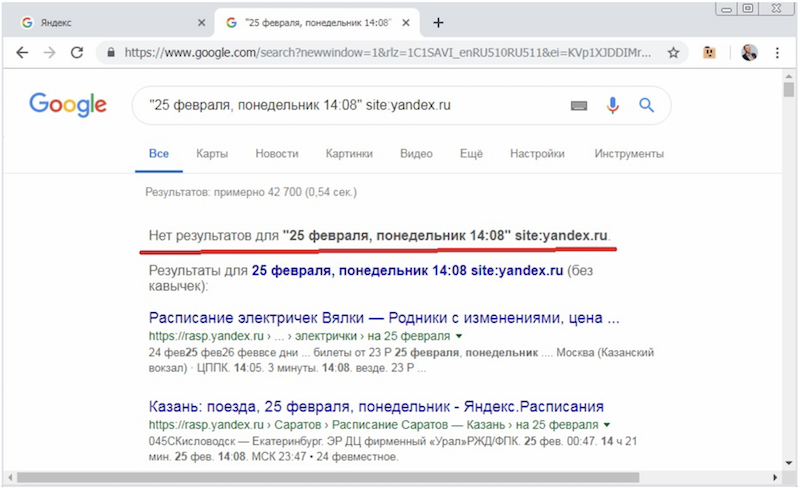
К сожалению, оператор site: в Google, в случае его применения к главной странице сайта, показывает выдачу по всему сайту, и по запросу по дате без времени мы получаем достаточно много страниц с сайта в выдаче (с сервиса Яндекс.Погода и т.п.), что затрудняет анализ. Но добавив в запрос время, убеждаемся, что по точной фразе выдача пуста:
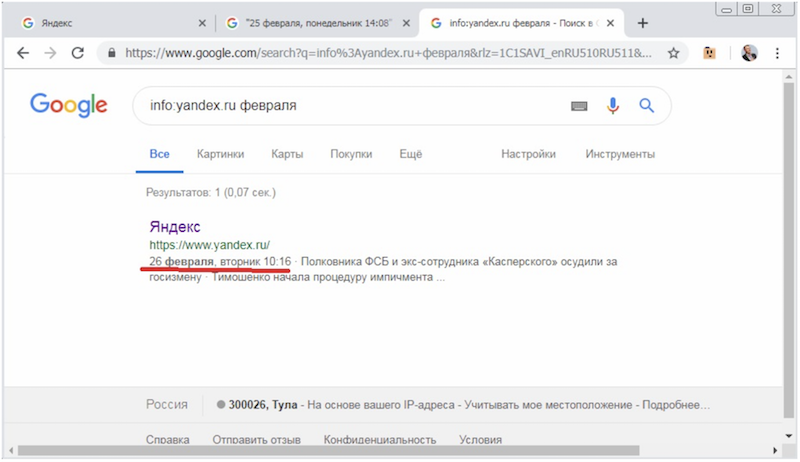
Для того, чтоб облегчить нахождение даты версии, находящейся в индексе, воспользуемся одним интересным приемом. Есть в Google оператор получения сведений о странице info:, который показывает сниппет указанной страницы в случае наличия ее в индексе. К сожалению, этот оператор не желает корректно работать в связке с поисковым запросом, т.е. не является аналогом оператора site:. Однако, если справа от этого оператора использовать какой-либо термин, то в случае наличия его точного вхождения в тексте страницы, мы можем увидеть сниппет с подсветкой этого термина. Используя в качестве такого термина название текущего месяца в соответствующем падеже, получаем отображение даты в сниппете, и убеждаемся в том, что она не совпадает с той, что содержится в сохраненке:
Проверим с помощью запроса по точной фразе, что в поисковом индексе действительно находится версия страницы с указанной датой:
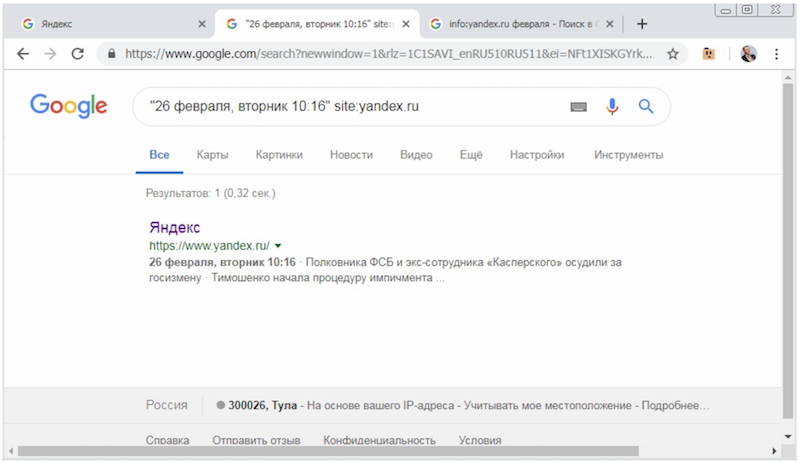
Любопытно, что в Яндексе версия анализируемой страницы в сохраненной копии свежее версии в индексе, а в Google – наоборот. Итого в результате несложного анализа убеждаемся в том, что ни в Яндексе, ни в Google нельзя быть уверенным в том, что версия страницы, показываемая в сохраненной копии, используется для ранжирования. И этот факт обязательно необходимо учитывать при анализе поисковой выдачи, дабы избежать ложных выводов.
Как открыть сохраненную копию сайта – несколько проверенных способов
Илья – главный редактор сайта softdroid.net. Является автором нескольких сотен руководств и статей по настройке Android. Около 15 лет занимается ремонтом техники и решением технических проблем iOS и Android. Имел дело практически со всеми более-менее популярными марками мобильных смартфонов и планшетов Samsung, HTC, Xiaomi и др. Для тестирования используется iPhone 12 и Samsung Galaxy S21 с последней версией прошивки.
В мире современных технологий мы привыкли, что у нас всегда под рукой Интернет, а вместе с ним и миллионы сайтов с различным контентом. Однако у пользователей нередко возникают ситуации, когда доступ к информации на сайте пропадает. Это происходит по нескольким причинам, при этом такая ситуация вовсе не означает, что данные утрачены безвозвратно. Найти удаленные статьи или страницы сайта помогает кеш Google.
Что такое кеш сайта и зачем он нужен
Поисковая система Google оснащена так называемыми ботами, которые регулярно посещают страницы сайтов и сохраняют их в памяти поисковика. Это и есть кеш, в котором сохраненная копия сайта остается даже в том случае, если сам ресурс был удален. Следует отметить, что боты «гуляют» по Интернету достаточно активно, поэтому информация в кеше, как правило, является актуальной. Однако есть два важных нюанса:
- Чем чаще на сайте появляются новые публикации, тем чаще его посещает бот, а значит, данные будут максимально свежими.
- Нередко случается так, что после удаления статьи с сайта по этой ссылке пользователь видит сообщение об ошибке. Однако бот успел посетить эту пустую страницу и сохранил ее в кеш, удалив прошлую актуальную версию.
Разобравшись с особенностями работы кеша Google, стоит понять, для чего поисковая система хранит в памяти старые версии сайтов. Эксперты приводят несколько серьезных аргументов:
- Страница с материалами была удалена с сайта, а вам срочно нужны именно эти данные.
- Часть информации в нужной публикации была изменена на другие материалы.
- Владелец сайта удалил его или закрыл доступ для пользователей.
- Сайт слишком перегружен, в результате чего страницы загружаются долго.
- На сайт обрушилась ддос-атака, поэтому данные оказались временно заблокированы.
- Программисты проводят технические работы, в результате чего открыть нужную страницу невозможно.
Очевидно, что главная причина поиска сохраненных страниц заключается в утерянной информации и попытке восстановить ее с помощью функционала Google. И если с причинами и особенностями кеширования все понятно, можно переходить к главному вопросу: как посмотреть старую версию сайта и сохранить нужные сведения.
Как посмотреть кеш в Google
Существует несколько способов найти удаленные страницы сайтов. Самый простой – воспользоваться стандартным поиском Google и придерживаться следующего алгоритма действий:
- В поисковой строке вводим адрес сайта, с которого нужно восстановить информацию.
- В выдаче находим нужную ссылку, а под ней – маленькую стрелку зеленого цвета.
- При нажатии на стрелку появляется меню, в котором нужно выбрать графу «Сохраненная копия».
- Система автоматически переходит в архив сайтов и открывает нужные страницы.
Если для работы в Интернете вы используете Google Chrome, вам подойдет еще один простой способ, как посмотреть удаленную страницу в кеше. Для этого достаточно перед адресом сайта ввести слово «cache» и поставить двоеточие. На примере сайта htmlbook.ru это будет выглядеть так: «cache:htmlbook.ru» и далее адрес конкретной страницы, которая вам нужна.
Если по каким-то причинам перечисленные методы не подошли, найти кеш страницы можно и таким способом:
- Открываем новую вкладку в браузере и в адресную строку вставляем текст «webcache.googleusercontent.com/search?q=cache:» (кавычки убираем).
- После двоеточия без пробела вставляем адрес сайта или страницы, которую хотим найти в памяти Google.
- Переходим по ссылке и получаем доступ к последней сохраненной версии.
Обратите внимание! Кеш сайта – это преимущественно текстовая информация. Если на странице были размещены изображения, которые владелец удалил, восстановить их может быть не так просто, как непосредственно статью.
Google Cache Browser
У всех перечисленных способов, как посмотреть кеш в Google, есть один существенный недостаток. С их помощью можно увидеть только одну страницу сайта, после чего придется скопировать ссылку на нужный раздел и проделать всю процедуру заново. Чтобы ускорить этот процесс и получить возможность «бродить» по всему сайту, предлагаем воспользоваться сервисом http://cache.nevkontakte.com/#! и изучить все сохраненные данные в один клик.
Чтобы воспользоваться сервисом, достаточно перейти по ссылке и на главной странице ввести адрес сайта, к которому нужен доступ. Система автоматически находит сохраненную информацию и предоставляет пользователю.
Выходим за рамки Google
Понятно, что сохранением страниц и сайтов в кеше занимается не только поисковая система Google. У пользователей есть еще несколько вариантов, как можно найти удаленную статью или другие данные с сайта:
- Кеш Яндекса. Система работает по такому же принципу, однако сохраненные версии могут отличаться от тех, которые хранит Google. Чтобы открыть кеш Яндекса, необходимо ввести в поиске адрес сайта и перейти к сохраненной копии с помощью зеленой стрелочки (точно так же, как и при работе с Google).
- Специализированный поисковик CachedView.com, который не ограничивается Google, а предлагает пользователям доступ к Всемирному архиву Интернета. Работает по принципу Nevkontakte.com.
- Еще один интересный сервис, на который стоит обратить внимание, находится по адресу archive.is. Его главная функция заключается в том, чтобы пользователь мог самостоятельно сохранять нужные страницы сайта. При этом сервис не требует регистрации и является бесплатным. Дополнительное преимущество архива – возможность искать данные среди страниц, которые сохранили другие пользователи.
Таким образом, даже удаленные из Интернета материалы можно найти и восстановить. Какой способ для этого выбрать? Рекомендуем не останавливаться на одном методе, а попробовать несколько, чтобы наверняка найти нужную страницу или сайт.
Сохраненная копия сайта или бесплатный бэкап от поисковиков
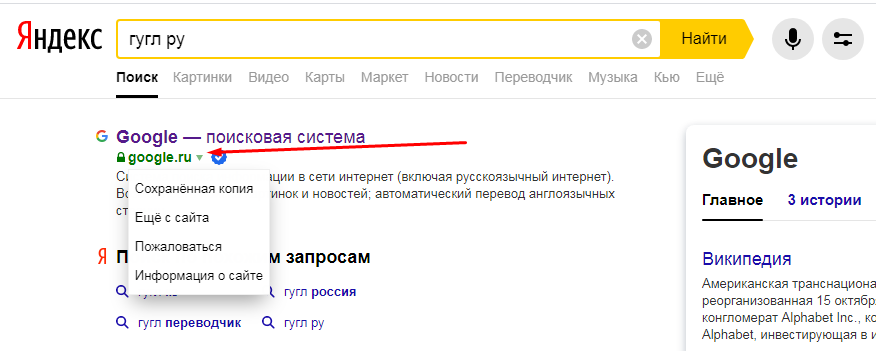
Сохраненная копия сайта (в Яндексе или другой поисковой системе) — это версия страницы, которая уже проиндексирована. Если при вводе поискового запроса посмотреть на сниппет нужного результата, там найдется блок с дополнительными данными. Там-то и лежит «Сохраненная копия». Что это такое, зачем она нужна, как просмотреть и каковы последствия отсутствия копии — вопросы, на которые несложно найти простые ответы. С помощью сохраненной копии можно просмотреть сайт, если к нему будет внезапно ограничен доступ по той или иной причине. В Google происходит то же самое — найдя в cash копию и перейдя по ссылке, можно просмотреть, как выглядела страница, когда Гугл в последний раз ее скопировал.
Для чего нужны сохраненные страницы?
Кэш-страницы сайта в поисковых системах позволяют увидеть, какую версию документа уже успели проиндексировать роботы поисковых систем и участвует ли страница в ранжировании. Грубо говоря, если страница начала сохраняться — это главный фактор пройденной индексации.
Бесплатный бэкап
В работе с сайтами, может возникнуть масса непредвиденных ситуаций. Особенно на стадии запуска проекта, на сайте частенько ведутся технические работы, предполагающие корректировку дизайна и текстовых блоков. В такие моменты не исключены ошибки, которые могут «положить» сайт или нарушить его работу, также могут пропасть тексты, изображения и так далее. Большинству разработчиков знакомы такие ситуации и если не был проведен бэкап, а дешевый хостинг не позволяет сделать «откат», то все печально. Вот тут-то и приходит на помощь кэш сайтов — копия позволяет сохраниться и проверить, какие ошибки нужно исправить.
Важно! Все же не стоит надеяться на Яндекс и Гугл, и хранить сайт только в копиях поисковиков. Если робот попал на нерабочую страницу или ее версию с ошибками, он будет копировать то, что «видел», и старая информация будет недоступна. Так что заранее продумывайте способы «отката» сайта.
SEO-продвижение
Еще один случай, когда кеш придет на помощь, связан с текстами. Например, вы откорректировали текст, чтобы повысить его релевантность. Чтобы проверить, обновилась и проиндексировалась ли нужная страница, достаточно взглянуть на копию.
Технические проблемы, просрочка оплаты и так далее
Часто интернет-ресурсы бывают недоступны из-за технических проблем на сервере, истечения срока оплаты хостинга и т.п. В этом случае попасть на сайт можно также через копию, которая хранится в кэше.
Как посмотреть кэшированную копию в Яндексе: основные способы
Перед тем как открыть сохраненную копию сайта в Яндексе, выберите удобный способ — с помощью сервисов (Page Promoter в Firefox или RDS bar в Google Chrome) или вручную. Плагины — это удобно, но они могут давать сбой, поэтому стоит освоить и ручной метод просмотра.
Способ № 1 — плагины
Расширения для браузеров, плагины и различные онлайн-сервисы позволяют быстро открывать кэш сайтов. Один из самых популярных на сегодня сервисов — это RDS bar. Плагин отличается интуитивным пользовательским интерфейсом и позволяет посмотреть последние изменения страницы, отсканированной роботами. Но если нужная страница еще не проиндексировалась, то и плагин ничего не покажет.
Способ № 2 — вручную
Самый простой и эффективный «механический» способ просмотра. Что нужно сделать:
- Найти в поисковике нужную страницу — по запросу или вбив в поисковую строку адрес сайта.
- В результате поиска в сниппете нажать на маленькую стрелочку.
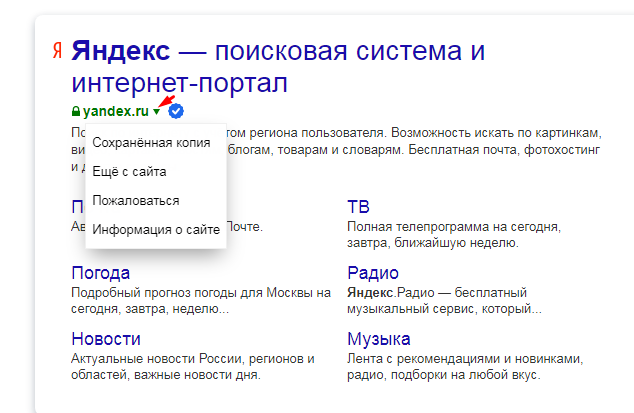
- В выпавшем окошке нажать «Сохраненная копия».
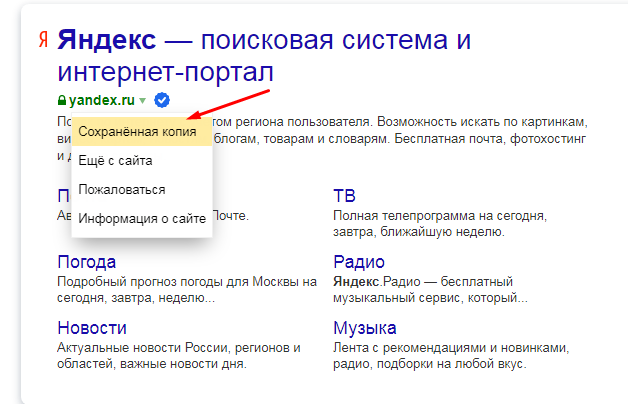
- Нажать и посетить сайт с данными, сохраненными с последнего визита робота на страницу.
Как посмотреть сохраненную копию страницы в Google
Алгоритм просмотра кэшированных страниц в системе Гугл не отличается от ручного способа для Яндекса. Все просто:
- В браузере вбейте в поисковую строку адрес или название нужного сайта (или поисковый запрос).
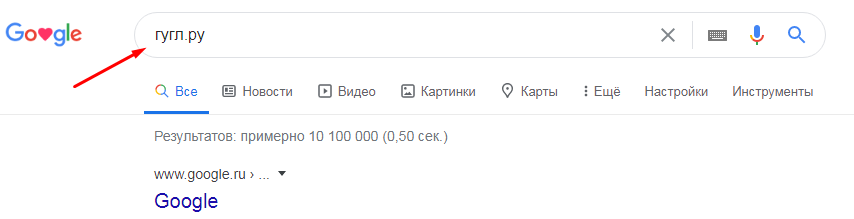
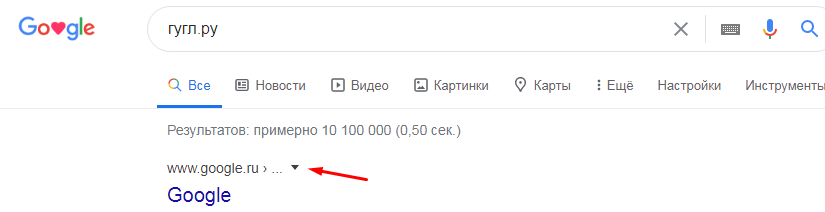
- В выдаче справа от URL нажмите на стрелку.
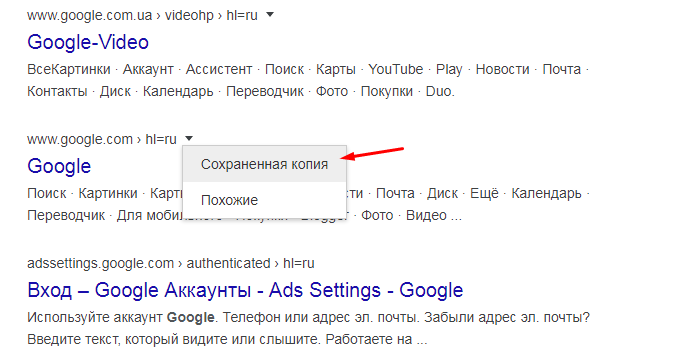
- В выпавшем окошке кликните по разделу «Сохраненная копия».
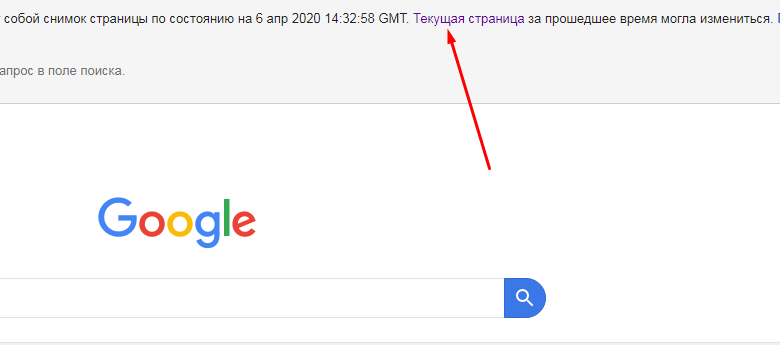
- Чтобы перейти к текущей версии, просто нажмите на кнопку «Текущая страница».
Почему страницы может не быть?
Иногда во время поиска при нажатии на стрелочку сниппета нужного пункта может и не быть. Это происходит по ряду причин:

- Сбой в работе поисковика. В Яндексе даже не скрывают, что нет никаких гарантий на наличие и показ копий — система может просто не сохранять страницы по какой-либо причине.
- Второй вариант: html-кодировка документа содержит мета-тег «robots» со значением «noarchive», что означает запрет на кэширование. Чтобы не рисковать из-за этого трафиком, стоит внимательно настроить соответствующие блоки и очистить ненужные значения.
Нет копии: чем это грозит?
С точки зрения продвижения — опасность нулевая. А вот сами причины, из-за которых невозможно сохранение, могут быть вредны, нужно разбираться именно в них.
Эксперты уверены, что проблема с копиями может обернуться трудностями при работе с биржами ссылок. Так, на некоторых известных биржах строго контролируют, есть ли в Яндексе копия, проверяя параметр No Index Cache (NIC).
Другие способы
- Наберите в адресной строке http://webcache.googleusercontent.com/search?q=cache:https://www.google.ru/ — где https://www.google.ru поменяйте на адрес нужного вам сайта.
- http://cachedview.com/ — этот сервис ищет копии не только в Google, но и во Всемирном архиве интернета.
- http://www.thesearchenginelist.com/ — а этот ресурс поможет найти копии, если Гугл и Яндекс не сохранили документ. Поочередно перебираем поисковики, рассчитывая на то, что кто-то заглянул на ваш сайт и «заскринил» данные.
Заключение
Всем мы хорошо помним и знаем, что всё нужно бэкапить — от семейных фото с отпуска до страниц сайтов. Но настолько же хорошо мы об этом еще и забываем. В этом случае приходит на помощь сохраненная версия сайта, которую можно найти в Яндексе, Гуле и других поисковых системах и даже вытянуть из Всемирных архивов.
Главное, чтобы поисковые системы успели кэшировать ваши страницы, а от вас дело за малым — просто выбрать удобный способ просмотра копии.