
Где находится кэш браузера Chrome, Firefox, Яндекс, Opera, Internet Explorer
Довольно часто на всевозможных форумах сталкиваюсь с вопросом «где находится кэш браузера». Так как данный вопрос тесно с связан с тематикой нашего сайта, я не мог обойти его стороной и решил в сегодняшней статье рассказать где хранится кэш самых популярных браузеров установленных в операционной системе Windows 7, 8, 10.
Вас может заинтересовать статья «Как удалить следы работы браузера«, в который мы подробно рассказывали как автоматический, после окончания работы в интернете очищать историю посещенных сайтов
Где находится кэш браузера?
Все браузеры сохраняют кеш в директорию «C:\Users\Admin\AppData\Local\» каждый в свою папку. Изначально эта папка в операционной системе Windows является скрытой. Для отображения содержимого необходимо включить показ системных и скрытых файлов, как это сделать вы можете узнать из статьи «Как открыть скрытые папки«.
Где найти и как почистить кэш Яндекс браузера

Вся информация, которую видит пользователь в окне веб-обозревателя (изображения, видео, аудио и прочие файлы) автоматически сохраняется на компьютер или ноутбук. Этот процесс называется кэшированием.
Очень важно регулярно выполнять очистку кэша, поскольку он занимает много свободного места и замедляет работу компьютера. Сделать это можно, используя штатные средства Яндекс Браузера или специализированные программы.
Каждый из способов будет разобран более подробно ниже.
Что такое кэш и для чего он нужен
Кэш является специальным хранилищем в качестве отдельной папки «Cache», которая находится на компьютере в системной папке Яндекс Браузера. В ней хранится информация и данные с посещенных ранее интернет ресурсов (музыка, видео, картинки и прочее).

Это необходимо, чтобы при повторном открытии сайта веб-обозреватель мог быстро загрузить нужные данные с диска, не обращаясь напрямую к серверу. Таким образом, повышается скорость загрузки сайта и происходит экономия интернет трафика.
Где он находится
В случае если вы хотите посмотреть кэш Яндекс Браузера и вручную его почистить, то найти его можно следующим способом:
- Открываем диск «С». Тот диск, на котором установлена ОС Windows.
- Далее нам нужно отобразить все скрытые файлы и папки. Для этого пользователям Windows 10 необходимо в верхнем меню проводника нажать на пункт «Вид — Параметры». В Windows 7 этот раздел находится во вкладке «Упорядочить – Параметры файлов и папок».

- Переходим во вкладку «Вид», отмечаем пункт «Показывать скрытые файлы…» и нажимаем «ОК».

- Далее переходим по следующему пути «C:\Users\User\AppData\Local\Yandex\YandexBrowser\User Data\Default\Cache». Последний пункт – это и есть та папка, в которой находятся закэшированные данные. Для того чтобы удалить кэш, выделите все содержимое нажатием клавиш «Ctrl+A», нажмите «Delete».

Готово, можно проверять результат.
Зачем чистить кэш
В папке кэш браузера хранится выборочные данные о посещенных пользователем веб-ресурсах. Сюда входит не только текстовых контент, но также изображения и видео. При повторном посещении эти сайтов информация с них не скачивается заново, а загружается непосредственно с компьютера, что существенно ускоряет загрузку сайта и оптимизирует расходование ресурсов системы.
Со временем папка перегружается информацией, что нагружает буферную память так, что загрузка сайтов (даже тех, на которых пользователь был ранее), становится очень медленной. В итоге главное назначение и смысл кэша теряется. Именно по этой причине кэш Яндекс Браузера нужно чистить время от времени. Это касается также истории посещений и куки.
Комбинация клавиш
Разработчики веб-обозревателя разработали быстрый метод сброса кэша для открытого сайта используя комбинацию «CTRL+F5» или «CTRL+R».


Страница сайта обновится и все данные загрузятся снова.
Очистка кэша через панель настроек Яндекс Браузера
Если предыдущий способ вам не подошел или вы просто не хотите его вручную искать и удалять, тогда почистить кэш можно прямо в Яндекс Браузере, для этого нужно выполнить ряд несложных действий:
- Находим в верхнем правом углу значок «Меню» и щелкаем по нему.

- Далее нас интересует раздел «Дополнительно – Очистить историю». В него также можно зайти, нажав комбинацию клавиш «Ctrl+Shift+Delete».
- Отметьте разделы, которые следует почистить и выберите период. Рекомендуется активировать все пункты и выбрать «За все время».

- Нажмите «Очистить» и дождитесь окончания процедуры. В зависимости от количества и объема файлов она может длиться от нескольких секунд до минут.
После этого веб-обозреватель начнет работать быстрее и стабильнее.
CCleaner
Это абсолютно бесплатная программа, которая находится в свободном доступе в сети. Она предназначена для оптимизации и очистки ОС компьютера или ноутбука. Утилита удаляет неиспользуемые и ненужные файлы, освобождает место на накопителях и делаем запуск Windows, как работу всего ПК, значительно быстрее.
Чтобы почистить кэш и куки в Яндекс браузере с ее помощью, необходимо:
- Скачать, установить и запустить программу.

- Найти в боковом меню пункт «Очистка» и открыть его.

- В разделе «Приложения» найдите «Google Chrome» (именно этот пункт относится к Yandex Browser), активируйте нужные параметры и нажмите по кнопке «Очистка».
Важно! CCleaner не распознает Yandex как отдельный компонент и относит его к «Google Chrome». Так как они оба используют один и тот же движок.
Также приложение позволяет почистить куки для конкретного ресурса. Для этого нужно войти в раздел «Параметры – Cookie файлы». Затем щелкните правой мышкой по конкретному ресурсу, выберите опцию «Удалить» и подтвердите выполнение операции.

Таким образом, всего в несколько нажатий мыши кэш и куки будут удалены. Также данная программа предлагает полноценный чистильщик реестра, а к ее положительным сторонам стоит отнести отсутствие рекламы и достаточно быструю работу.
Glary Utilities
Бесплатная, многофункциональная утилита для полноценного обслуживания системы. Она позволяет оптимизировать и ускорить работу всей системы путем освобождения дополнительных ресурсов. Благодаря этому ноутбук становится более производительным и работает значительно быстрее.
Чтобы очистить кэш с помощью этой программы нужно сделать следующее:
- Загрузить и запустить приложение.

- В нижнем меню войти в раздел «Очистка диска» и дождаться завершения сканирования.

- В разделе «Браузеры» отметить галочкой пункт «Кэш браузера Yandex» и нажать «Начать очистку».

- Остается лишь немного подождать, пока программа выполнит удаление данных. После этого, ее можно закрывать.
К сожалению, бесплатная версия программы не чистит куки и историю. Но возможно в дальнейшем разработчики исправят этот момент.
Wise Care 365 Free
Многофункциональный чистильщик системы, который станет удобным помощником в обслуживании системы.
Как им пользоваться:
- Загружаем утилиту с официального сайта и устанавливаем.

- После запуска открываем раздел «Очистка – Быстрая очистка».

- Разворачиваем меню «Кэш веб-браузера» и устанавливаем галочку рядом с «Yandex».
- Заходим в меню «Трассировка» и активируем все пункты относящиеся к Яндекс Браузеру.
- Щелкаем «Сканировать», а затем «Очистка».
При нехватке стандартных опций, можно обновить приложение до платной версии с большим количеством возможностей.
Дополнительные рекомендации
Для обеспечения максимальной производительности рекомендуется:
- Своевременно обновлять веб-обозреватель. Поскольку с выходом новой версии, исправляются многие ошибки, и оптимизируется работа определенных функций.
- Отключить назойливую рекламу,используя бесплатные плагины блокировки.
- Иметь установленный антивирус.
- Следить за состоянием жесткого диска. Даже небольшое количество битых секторов способно существенно понижать скорость работы ОС, включая все установленные приложения.
Попробуйте все способы и определитесь, какой из них подходит вам больше всего и действуйте. Главное – точно следуйте нашей инструкции, и тогда у вас все получится.
Под капотом бота-клиента Яндекс.Музыки
Привет, Хабр! Вновь я с уже второй статьей, затрагивающей API Яндекс.Музыки. Дело запланированное и упоминалось в первой статье.
Руки дошли, дело сделано. Сегодня я расскажу об интересных, на мой взгляд, моментах, которые присутствуют в кодовой базе моего Telegram бота, позиционирующего себя как полноценный клиент я.музыки. Ещё мы затронем API для распознавания музыки от Яндекс.
Перед тем, как приступить к попунктному рассказу реализации той или иной вещи, стоило бы иметь представление о самом боте и его функциональных возможностях.
Видеодемонстрация клиента
В основной части я расскажу про следующее:
- Авторизация в аккаунт через сайт на GitHub Pages (зачем и почему).
- Формат данных, его упаковка и использование в данных для кнопок.
- Роутинг апдейтов, версионность данных, прокидывание контекста в обработчики.
- Сервисы:
- Сервис перезаливки трека в Telegram.
- Сервис «подписок» на получение трека с отправкой статуса о загрузке.
- Наипростейшая и элегантная реализация кэширования запросов.
- Распознавание трека по голосовому сообщению и как это вообще появилось в боте.
- Мелкие заметки.
Если Вас заинтересовал хоть один пункт — добро пожаловать под кат.
Бот работает, как с пользователями, прошедшими авторизацию в свой аккаунт, так и нет. Всё вертится вокруг четырёх основных классов сервиса: альбом, исполнитель, плейлист и трек. Все данные сущности поддерживаются, присутствует постраничный вывод с выбором страницы. Для взаимодействия с ними авторизованный пользователь может воспользоваться своим личным меню, куда входят: умные плейлисты, плейлист «мне нравится» и свои собственные плейлисты. Для неавторизованных пользователей доступен поиск — отправка поискового запроса как обычное сообщение. Теперь просто сухой перечень того, что есть ещё: получение треков и других объектов по прямой ссылке, получение текста песни, возможность поставить лайк/дизлайк треку и исполнителю, просмотр похожих треков, распознавание трека по голосовому сообщению и другое.
Основная часть
1. Авторизация в аккаунт
Изначально бот не планировался для работы без авторизации, поэтому, ещё при проектировании, было решено, как должна происходить авторизация — через свой сайт. Основными аргументами была безопасность и прозрачность. Ни в коем случае не хотелось принимать логины и пароли пользователей через сообщения в открытом виде. А проходить авторизацию с компьютера пользователя — элементарно. Поэтому был написан сайт для авторизации на React’e. Он представляет из себя форму авторизации с редиректом обратно в бота. Кусок с авторизацией и обработки капчи был взят с библиотеки на Python и переписан на JavaScript.
Для авторизации используется полученный OAuth токен, который передаётся обратно в бота через deep linking.
Конечная ссылка для перенаправления выглядит так: t.me/music_yandex_bot?start=
Хотелось как лучше, а доверия у пользователей не было. Авторизацию проходил только каждый десятый пользователь (на момент, когда она была обязательной). Поэтому со следующими обновлениями пришлось объяснить, почему стоит доверять. Все пункты про HTTPS, про исключительно запросы с клиентской стороны и открытый исходный код были опубликованы на самом сайте для авторизации и продублированы в приветствующем сообщении в боте. Стало лучше.
Так же, среди факторов низкой авторизации, оказалась недоступность зеркал для t.me в России и поддержка только пользователей с подпиской (об этом в заметках, 7 пункт).

Первый пункт решился использованием URI (tg://), и в крайнем случае уже ссылка на зеркало (если не сработал автоматический редирект, и кнопка не помогла), а про второй опять же есть в 7 пункте.
2. Формат данных
Для этого бота я решил первый раз использовать NoSQL БД — MongoDB. Разобрался: когда embed документ, когда нет. Понравилось работать с mongoengine. Но я уж никак не хотел хранить все данные кнопок у себя, а у клиента только ID записи в базе. Меня ужасало количество данных, а я ведь хотел взять бесплатный сервер монго с ограничением в 512 мб для хранения данных. Придумывать красивое переиспользование записей, если данные совпадают в нескольких кнопках и заниматься чисткой устаревших — куда сложнее, чем хранить всё в самих кнопках. Проанализировав размер желаемых для хранения данных, сделал вывод, что это легко поместится.
На первых порах я просто использовал JSON, но уж очень быстро от него отказался, когда упёрся в лимит. У Telegram содержимое данных кнопки может быть только не больше 64 байт в UTF-8.
Поэтому, с подсказки друга, я начал смотреть на pack из модуля struct. Так и родились типы запросов, примитивный формат, упаковка и распаковка. Теперь это используется в боте абсолютно везде.
Формат очень прост. Первый байт — тип, второй — версия. Всё остальное является данными для определенного типа. Типы хранятся как Enum, имеют ID, который и является первый байтом. Помимо ID, у каждого типа лежит формат для упаковки и распаковки данных. Например: тип SHOW_TRACK_MENU, у которого формат имеет значение «s?», где «s» — уникальный идентификатор трека, а «?» — имеется ли у трека текст.
У треков используется строковый тип, потому что: во-первых, ID трека может быть конкатенацией ID альбома и ID трека через двоеточие, а во-вторых, может быть UUID. Треки с UUID — самозагруженные треки, доступные только пользователю, который их загрузил.
Так как данные не всегда соответствуют формату, например, тот же ID трека может быть представлен просто числом, то перед упаковкой надо скастовать его в тип под формат. В данном случае s. Поэтому в классе присутствует метод, нормализующий переданные данные для упаковки, чтобы не делать этого самому при передаче в конструктор.
Строки являются самодостаточными и способны указать свою длину при упаковке и учесть эту длину при распаковке.
Поддержка старых версий не планировалась, поэтому при несоответствии версий выбрасывается исключение. При обработке апдейтов, о которых я расскажу в следующем пункте, вызывается необходимая логика.
Так как Telegram ест исключительно UTF-8, то упакованные данные кодируются в base85. Да, я теряю тут скорость и экономлю самую малость в размере, не используя base64, но, учитывая малые данные, считаю использование base85 уместным.
Исходный код. Файл callback_data.py
import struct import base64 from ext.query_types import QueryType class BadDataVersion(Exception): pass class CallbackData: ACTUAL_VERSION = 7 BASE_FORMAT = ' Type: Version: Data: ' def _normalize_data_to_format(self, data, bytes_object=False): normalized_data = data.copy() for i, c in enumerate(self.type.format): cast = str if c.lower() in 'bhilqn': cast = int elif c in 'efd': cast = float elif c == '?': cast = bool casted = cast(data[i]) if bytes_object and cast == str: casted = casted.encode('utf-8') normalized_data[i] = casted return normalized_data @staticmethod def decode_type(callback_data): decoded = base64.b85decode(callback_data.encode('utf-8')) type_, version = struct.unpack(CallbackData.BASE_FORMAT, decoded[:2]) if CallbackData.ACTUAL_VERSION != version: raise BadDataVersion() return QueryType(type_), version, decoded @classmethod def decode(cls, type_, version, decoded): start, data = 2, [] if start < len(decoded): format_iter = iter(type_.format) while True: if start >= len(decoded): break format_ = next(format_iter, type_.format[-1]) decode_str = format_ in 'ps' if decode_str: # struct.calcsize('b') = 1 length = list(struct.unpack('b', decoded[start: start + 1]))[0] start += 1 format_ = f'' step = struct.calcsize(format_) unpacked = list(struct.unpack(f'', decoded[start: start + step])) if decode_str: unpacked[0] = unpacked[0].decode('UTF-8') data += unpacked start += step return cls(type_, data if data else None, version) def encode(self): encode = struct.pack(self.BASE_FORMAT, self.type.value, self.version) if self.data is not None: format_iter = iter(self.type.format) normalized_data = self._normalize_data_to_format(self.data, bytes_object=True) for data in normalized_data: format_ = next(format_iter, self.type.format[-1]) if format_ in 'ps': # в два пака чтобы не заботиться о порядке. Формат 'b' потому что # из-за ограней телеги все равно больше нельзя, да и строк > 36 нет encode += struct.pack('b', len(data)) encode += struct.pack(f'', data) else: encode += struct.pack(f'', data) return base64.b85encode(encode).decode('utf-8') 3. Роутинг апдейтов и контекст
В проекте используется библиотека python-telegram-bot для работы с Telegram Bot API. В ней уже присутствует система регистраций обработчиков на определенные типы пришедших апдейтов, фильтры по регулярным выражениям, командам и так далее. Но, учитывая мой собственный формат данных и свои типы, пришлось унаследоваться от TelegramHandler и реализовать свой Handler.
В каждый обработчик через аргументы передаётся апдейт и контекст. В данном случае контекст у меня свой и именно в Handler’e идёт его формирование, а это: получение и/или добавление пользователя в базу, проверка актуальности токена для получения доступа к музыке, инициализация клиента Яндекс.Музыки в зависимости от статуса авторизации и наличии подписки.
Далее от моего Handler’a идут более специфичные обработчики, например, CallbackQueryHandler. С помощью него происходит регистрация обработчика для определенного типа апдейта (моего типа, с форматом данных). Для проверки, подходит ли данный апдейт под текущий обработчик, распаковка происходит не всех данных, а только первых двух байт. На этом этапе и сверяется необходимость запуска коллбека. Только если запуск коллбека необходим — происходит полная распаковка данных и их передача как kwargs в конечный обработчик. Тут же и происходит отправка аналитических данных на ChatBase.
Регистрация происходит последовательно, и приоритет выше у того, кто будет зарегистрирован раньше (собственно, как и в Django роутинге, да и в других проектах). Поэтому регистрация обработчика на устаревшую версию идёт первым среди обработчиков CallBackQuery.
Логика обработки устаревшей версии проста — сообщить об этом пользователю и прислать обновлённые данные, если возможно.
4. Сервисы
Все сервисы инициализируются при запуске бота в одном управляющем классе, который потом повсеместно используется в любом месте бота (DJ).
У каждого сервиса свой ThreadPoolExecutor с определённым количеством воркеров, в который сабмитятся задачи.
Перезаливка трека в Telegram
На данный момент этот сервис не переписан на User Bot’a для обхода ограничения на размер загружаемого файла в Telegram. Как оказалось, в Яндекс.Музыке есть файлы размером больше 50 мб — подкасты.
Сервис проверяет размер файла и, в случае превышения, — кидает алерт пользователю. Благодаря системе кэширования, описанной в пункте 5, тут происходит проверка наличия и получение текста песни. Кэшируются также и треки. Хэш файла хранится в базе. При наличии такового — идёт отправка аудио с известным кэшем.
При отсутствии файла в базе, происходит прямое получение ссылки с Яндекс.Музыки. Хотя в данный момент возможности менять настройки качества у пользователей нет, но всем выставлены стандартные значения. Происходит поиск файла по битрейту и кодеку из настроек пользователя.
Файл и его обложка загружаются как tempfile.TemporaryFile(), после чего загружаются в Telegram. Стоит отметить, что TG не всегда корректно распознает длительность трека, а про исполнителя и название я вообще молчу. Поэтому эти данные берутся у Яндекса, благо, есть возможность их передать в телегу.
При отправке аудиофайла данным сервисом вызывается finished_callback(), сигнализирующий сервису по подпискам о конце загрузки.
Сервис «подписок» на получение треков и отправка статуса загрузки
Треки загружаются не моментально. Возможен случай, когда один и тот же трек запросило несколько пользователей. В данном случае пользователь, который запросил трек первым, является инициатором и владельцем трека. При перезаливке больше чем в секунду, начинается отправка статуса о загрузке: “Пользователь отправляет голосовое сообщение”. Остальные пользователи, которые запросили тот же трек, являются обычными подписчиками. Им, так же как и владельцу, происходит отправка статуса загрузки раз в ~4 секунды, чтобы сообщение не прерывалось (статус висит 5 секунд). Как только загрузка трека для владельца завершилась, вызывается finished_callback() из сервиса выше. После чего все подписчики удаляются из рассылки статуса и получают загруженный трек.
В архитектурном решении владелец трека также является подписчиком, но с определённой отметкой, так как способы отправки трека отличаются.
5. Кэширование запросов
Как мы помним из моей прошлой статьи, запросы в API Яндекс.Музыки очень тяжелые. Список треков может быть и 3, и 5 мб. Более того, запросов просто много. С каждой обработкой апдейта на Яндекс отправляется минимум 2 запроса: на инициализацию клиента и на определенное действие. Местами, для сбора достаточного количества информации (например для плейлиста), необходимо сделать запрос на получение плейлиста, на получение его треков, на информации с лендинга (если это умный плейлист), а еще не забываем про инициализацию клиента. В общем, тихий ужас по количеству запросов.
Хотелось чего-то очень универсального, а не делать какие-то хранилища для определенных объектов, тех же клиентов.
Так как библиотека позволяет указать свой собственный экземпляр для выполнения запросов, поверх requests, то этим я и воспользовался.
Суть проста. Сам класс кэша является синглтоном. У него есть всего два параметра: время жизни кэша, размер. При выполнении запроса вызывается враппер. Он и переопределён. Проверка наличия в кэше происходит по хешу замороженных аргов и кваргов. У кэша есть время добавления. При проверке необходимости обновления данных либо достаются данные с LimitedSizeDict, либо делается реальный запрос и добавление в кэш.
Некоторые запросы нельзя кэшировать, например, установку лайка/дизлайка. Если пользователь прожмёт следующую последовательность: лайк, дизлайк, лайк, то в конечном итоге лайк поставлен не будет. Для таких случаев, при отправке запроса, нужно передать аргумент use_cache со значением равным False. Собственно, это единственное место, где кэш не используется.
Благодаря этому я делаю максимально жирные запросы, чтобы они были закэшированы. Не пытаюсь разбить на мелкие и нужные только для текущей страницы. Я беру сразу всё, а при переходе между страницами имею огромную скорость переключения (в сравнении со старым подходом).
Как по мне, то класс кэшируемого запроса получился красиво и элементарно был интегрирован.
Исходный код
import copy import time from typing import Union from collections import OrderedDict import requests from yandex_music.utils.request import Request as YandexMusicRequest class LimitedSizeDict(OrderedDict): def __init__(self, *args, **kwargs): self.size_limit = kwargs.pop("size_limit", None) OrderedDict.__init__(self, *args, **kwargs) self._check_size_limit() def __setitem__(self, key, value): OrderedDict.__setitem__(self, key, value) self._check_size_limit() def _check_size_limit(self): if self.size_limit is not None: while len(self) > self.size_limit: self.popitem(last=False) class CachedItem: def __init__(self, response: requests.Response): self.timestamp = time.time() self.response = response class Cache: __singleton: 'Cache' = None def __init__(self, lifetime: Union[str, int], size: Union[str, int]): Cache.__singleton = self self.lifetime = int(lifetime) * 60 self.size = int(size) self.storage: LimitedSizeDict = LimitedSizeDict(size_limit=int(size)) def get(self, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) return self.storage[hash_].response def update(self, response: requests.Response, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) self.storage.update() def need_to_fetch(self, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) cached_item = self.storage.get(hash_) if not cached_item: return True if time.time() - cached_item.timestamp > self.lifetime: return True return False @classmethod def get_instance(cls) -> 'Cache': if cls.__singleton is not None: return cls.__singleton else: raise RuntimeError(f' not initialized') @staticmethod def freeze_dict(d: dict) -> Union[frozenset, tuple, dict]: if isinstance(d, dict): return frozenset((key, Cache.freeze_dict(value)) for key, value in d.items()) elif isinstance(d, list): return tuple(Cache.freeze_dict(value) for value in d) return d @staticmethod def get_hash(*args, **kwargs): return hash((args, Cache.freeze_dict(kwargs))) class Request(YandexMusicRequest): def _request_wrapper(self, *args, **kwargs): use_cache = kwargs.get('use_cache', True) if 'use_cache' in kwargs: kwargs.pop('use_cache') if not use_cache: response = super()._request_wrapper(*args, **copy.deepcopy(kwargs)) elif use_cache and Cache.get_instance().need_to_fetch(*args, **kwargs): response = super()._request_wrapper(*args, **copy.deepcopy(kwargs)) Cache.get_instance().update(response, *args, **kwargs) else: response = Cache.get_instance().get(*args, **kwargs) return response 6. Распознавание трека по голосовому сообщению
В начале и мысли не было добавлять это в бота, но случилась интересная ситуация. У бота есть чат (он указан в описании к боту). Спустя некоторое время я заметил, что люди заходят в него и отправляют голосовые сообщения с музыкой. Вначале я подумал, что это новый вид спама такой, ботоводит кто-то и прикалывается. Но, когда таких людей было уже под 10 и все делали то же самое, мой друг (тот же, что подсказал за struct), предположил, что пользователи вбивают в поиск “Яндекс.Музыка” в ожидании официального бота для распознавания музыки от Яндекса, видят там чатик и отправляют в него голосовые на полном серьёзе! Это было просто гениальное и верное предположение. Тогда я в шутку сказал, что пора сделать распознавание и добавлять бота в чат. В шутку… Спустя некоторое время это и было сделано!
Теперь по поводу API. В последнее время в Яндексе всё чаще используют вебсокеты. Встретил их использование в управлении я.модулем и я.станцией. Сервис по распознаванию музыки тоже работает на нём. Я накидал минимальное рабочее решение у себя в боте, но в библиотеку реализацию не добавлял.
WS находится по следующему адресу: wss://voiceservices.yandex.net/uni.ws
Нам необходимо всего два сообщения — авторизация и запрос на recognize.
Сам Яндекс, в своём официальном приложении, отправляет короткие файлы по секунде-три. В ответ можно получить необходимость прислать больше данных или результат — нашел или нет. Если результат найден, то вернётся ID трека.
Отправляются .ogg файлы с ENCODER=SpeechKit Mobile SDK v3.28.0. Я не проверял то, как оно работает с другими encoder’ами, просто изменяю его в файле, записанном Telegram’ом.
При реверсе с вебсокетом иногда происходила магия. Иногда не находило трек, но когда менял язык в сообщении с запросом на распознавание — находило. Или вначале находило, а потом переставало, хотя файл тот же. Я подумал, что язык трека устанавливается их SpeechKit’ом на клиенте. Не имея такой возможности сделать у себя, я делаю перебор языков.
Моя сделанная на коленке реализация распознавания войсов по голосовым сообщениям с Telegram
import uuid import lomond def get_auth_data(): return < "event": < "header": < "messageId": str(uuid.uuid4()), "name": "SynchronizeState", "namespace": "System" >, "payload": < "accept_invalid_auth": True, "auth_token": "5983ba91-339e-443c-8452-390fe7d9d308", "uuid": str(uuid.uuid4()).replace('-', ''), >> > def get_asr_data(): return < "event": < "header": < "messageId": str(uuid.uuid4()), "name": "Recognize", "namespace": "ASR", "streamId": 1 >, "payload": < "advancedASROptions": < "manual_punctuation": False, "partial_results": False >, "disableAntimatNormalizer": False, "format": "audio/opus", "music_request2": < "headers": < "Content-Type": "audio/opus" >>, "punctuation": False, "tags": "PASS_AUDIO;", "topic": "queries" > > > class Recognition: URI = 'wss://voiceservices.yandex.net/uni.ws' LANGS = ['', 'ru-RU', 'en-US'] POLL_DELAY = 0.3 def __init__(self, binary_data, status_msg): self.status_msg = status_msg self.websocket = lomond.WebSocket(self.URI) self.chunks = self.get_chunks_and_replace_encoder(binary_data) def get_track_id(self): for lang in Recognition.LANGS: asr_data = get_asr_data() if lang: asr_data['event']['payload'].update() self.status_msg.edit_text(f'Попытка распознать музыку на языке . ') else: self.status_msg.edit_text(f'Попытка распознать музыку без привязки к языку. ') for msg in self.websocket.connect(poll=self.POLL_DELAY): if msg.name == 'ready': self.websocket.send_json(get_auth_data()) self.websocket.send_json(asr_data) for chunk in self.chunks: self.websocket.send_binary(chunk) if msg.name == 'text': response = msg.json.get('directive') if self.is_valid_response(response): self.websocket.close() return self.parse_track_id(response) elif self.is_fatal_error(response): self.websocket.close() break def is_valid_response(self, response): if response.get('header', <>).get('name') == 'MusicResult' and \ response.get('payload', <>).get('result') == 'success': self.status_msg.edit_text(f'Трек найден, начинаем загрузку!') return True return False @staticmethod def is_fatal_error(response): if response.get('header', <>).get('name') == 'MusicResult' and \ response.get('payload', <>).get('result') == 'music': return False return True @staticmethod def parse_track_id(response): return response['payload']['data']['match']['id'] @staticmethod def get_chunks_and_replace_encoder(binary_data): chunks = [] for chunk in binary_data.split(b'OggS')[1:]: if b'OpusTags' in chunk: pos = chunk.index(b'OpusTags') + 12 size = len(chunk) chunk = chunk[:pos] + b'#\x00\x00\x00\x00ENCODER=SpeechKit Mobile SDK v3.28.0' chunk += b"\x00" * (size - len(chunk)) chunks.append(b'\x00\x00\x00\x01OggS' + chunk) return chunks Хоть я и занимался ревёрсом сам, под конец мне скинули уже готовый.
7. Мелкие заметки
Изначально ботом пользоваться могли только пользователи с подпиской по причине того, что сервис можно использовать в ограниченном количестве стран (без подписки), а сервер с ботом находится в Европе. Проблема решена использованием прокси, для выполнения запросов от пользователей без подписки. Сервер с прокси находится в Москве.
Выбор страниц есть, но он ограничен 100 (нельзя больше кнопок добавить, ограничение Telegram). В некоторых общих запросах страниц куда больше.
В поиске у Яндекса захардкожено количество элементов на странице. Сколько треков, сколько плейлистов. Иногда это даже не соответствует количеству отображаемых на фронте данных. Изменение страницы есть, количество элементов плавает. Поэтому в боте это так же скачет, что не очень красиво. А объединять их пагинатор со своим — как-то такое. В других местах, где есть возможность запросить определённое количество элементов на страницу, всё идеально. Голосовое сообщение после реализации поиска в боте — t.me/MarshalC/416.
При форварде аудио в Telegram’e теряется автор и присваивается тому, кто сделал форвард. Поэтому все треки отправляются с подписью юзернейма бота.
Голосовое сообщения со всем, с чем встретился после реализациии радио в библиотеке — t.me/MarshalC/422 (о цепочке треков, проходу по ней с отправкой кучи фидбека, batch_id).
Заключение
Несмотря на то, что это очередная статья про Telegram бота, вы дочитали аж до сюда, скорее всего потому, что вас заинтересовал один из пунктов в кате и это замечательно, спасибо Вам большое!
К сожалению, я не открыл исходный код бота целиком (потому что местами надо порефакторить). Многое описано в этой статье, но некоторые аспекты, например, с виртуальными клавиатурами и их генерацией не затронуты. По большей части то, чего нет в статье — просто работа с моей библиотекой, ничего интересного.
Классы, вокруг которых всё вертится, я показал в том виде, в котором они сейчас. Я допускаю наличие там багов, но это всё работает продолжительное время. Местами мне нравится свой код, местами нет — и это нормально. Не забываем, что работа с WS для распознавания — решение на коленке. Готов почитать аргументированную критику в комментариях.
Хоть бот и планировался ещё тогда, когда я начинал писать библиотеку, потом я от этой идеи открестился, но, как видно, вернулся (было скучно).
Яндекс.Музыка Бот — проект, доказывающий пригодность использования библиотеки для работы с API в проектах.
Большое спасибо Маме, Яне, Сане, Славе. Кому за вычитку ошибок, кому за подсказки, без которых некоторых пунктов в этой статье могло и не быть, а кому и просто за оценку статьи перед публикацией. Артуру за пикчи для статьи, Lyod’у за логотип.
P.S. У меня сейчас остро стоит вопрос с распределением после учёбы. Если Вы готовы сделать на меня вызов — сообщите куда отправить CV, прособеседуйте меня, пожалуйста. Все мои контакты есть в профиле. Сроки горят, я надеюсь на Вас. По закону проходить отработку могу только в Республике Беларусь.
P.P.S. Это была вторая статья из трёх, но я без малейшего понятия успею ли сделать ещё один проект на эту тему и нужен ли он. Публично раскрою его тему — кроссплатформенный клиент Яндекс.Музыки.
Как скачать музыку с Яндекс.Музыки
Бывает такая херня, когда хочется скачать трек в оригинале и более-менее хорошем качестве, а не очередной ремикс от гопника васи и не басбуст от какого-нибудь говноеда. Обычно на помощь приходит вк, но там чаще всего даже приписка Original Mix может ничего не дать, кроме кровищи из ушей, а если и гугл тоже не дает ничего выше 128 кбит и прочих радостей, с торрентов тянуть неохота, то на помощь приходит яндекс музыка — там все лежит в 320 кбит и mp3 формате (аудиофилам мимо), кнопки скачать нет, но вытянуть файл можно всего лишь в пару кликов. Покажу на примере Firefox, но метод в принципе универсален и надо только найти папку локального кэша вашего браузера.
0. Лезем в папку, где хранится все содержимое, для упрощения поиска папки надо зайти:
about:cache?storage=disk&context=
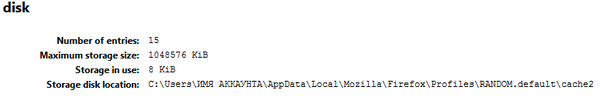
1. Скопировать-вставить в проводник, выбрать папку entries и узреть кучу непонятных файлов без расширений.
2.Чтобы не искать в тоннах старого новые файлы, очищаем кэш:
about:preferences#advanced

Теперь заходим на ямузыку и запустим один трек, дожидаемся пока песня прогрузится до конца, лезем в папку, сортируем по размеру файла, и вот что получается:
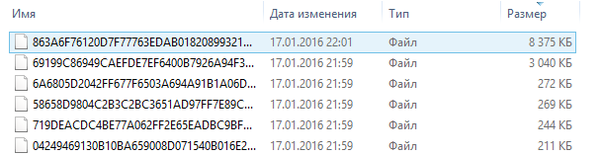
Самый жирный файл — и есть трек, дальше надо лишь приписать к нему .mp3 и все воспроизводится, все в нормальном качестве и именно то, что висит на яндексе.
PS я искал расширения с подобным функционалом, но ничего толкового, кроме кнопок управления ямузыкой найти не удалось.
PS2 способ подойдет для любого жадного сайта, который не хочет отдавать трек или другое медиа по-хорошему, но дает полностью кэшировать его.
7 лет назад
7 лет назад
1 год назад
Расширение Skyload пока работает, проверено
раскрыть ветку
7 лет назад
Плагин к мозиле — Video DownloadHelper.
раскрыть ветку
7 лет назад
На самом деле гораздо проще через дебагер посмотреть ссылку на файл, который грузится, и по ней скачать.
Похожие посты
14 дней назад
Бесплатное скачивание музыки в максимальном качестве с сервисов Amazon Music, Deezer, Napster, Qobuz, Soundcloud, Spotify, Tidal
Копируем ссылку на страницу с релизом в соответствующем сервисе, вставляем в строку запроса, жмём Download, ждём результат, скачиваем результат.

В опциях можно выбрать закачку на файлообменник (их несколько на выбор) для последующего скачивания, можно спрятать свой поисковый запрос из недавних (статистика отображается под строкой запроса), и выбрать формат файлов для Спотифая — mp3 или ogg.
После генерации ссылки на архив с рипнутым релизом сервис иногда может выдать ошибку — пугаться не надо, надо лишь обновить страницу и скачивание архива пойдёт. В самом крайнем случае скопировать ссылку на скачивание и «скормить» другому браузеру.
Если сайт у вас не открывается, используйте VPN. И вообще — используйте VPN!
Показать полностью
18 дней назад
Сраный яндекс и левая реклама в алисе
Только что. Привык ставить таймеры на колонке «алиса» и сейчас после фразы «Алиса, поставь таймер на 2 часа» это срань выдала мне рекламу пидорского тинькофа с его конченными кредитами на примерно на 30 секунд без возможности без возможности заткнуть её . @yandex, репутация зарабатывается годами, а сливается в унитаз буквалино за миг. Ваш новый государственный менеджмент слил вашу репутацию окончательно. Дно пробито. Прощайте.
30 дней назад
И опять о сервисах Яндекс
Купил я значит себе «плюс мульти» года назад (подписку на музыку и конопоиск) для семьи для дома, домашних животных etc. До 4 особей.
Как бы вынудили конечно. Мне только музыка была нужна, но ее отменили, сказали щас будет с кино и почти столько же в месяц.
299 рублей в месяц. Ну, в принципе — цена качества, как говорят профессиональные отделочники. Купил в общем.
Кроме музыки и кино естественно дети смотрят мультики, я слушаю аудиокниги, коты анонируют на фильмы о котах. Все как у всех.
И тут. Ваша книга не доступна. Ваши мультики больше не мультики.
«А вот так!» — говорит мне яндекс. «Теперь помимо 3000 в год за Плюс Мульти, заплати ка нам 2400 за детский контент и 1200 за аудиокниги. И да ты можешь сэкономить. И вместо Детского пакета можешь взять нашу всратую Амедиатеку за 4800 в год, там и мультики будут. да. «
На мой резонный вопрос: «Сх*яли тогда цена на основной пакет не уменьшалась?»
Был дан витиеватый ответ в духе: «Ну, так мы ж тебя нае*ываем!».
«А, ну так то да. » — подумал я.
Короче, господа из Яндекса, идёте вы нахер!
Принципиально уйду на Винк или на Окко или на КИОН или к чОрту на рога, лишь бы от вас подальше.
А музыка будет мп3.
И детей приучу, что жадных пи*орасов надо оставлять с хером вместо прибыли.
Показать полностью 1
2 месяца назад
Ответ на пост «Яндекс.музыка- очередное дно? вот прям счас»
У меня колонка Алиса позавчера выдала очень странную вещь. Спросила я у нее прогноз погоды, она потом на тему солнечной погоды спросила у меня – не хочу ли я жить в Лос-Анджелесе. Я ответила: нет, а ты бы хотела?
И тут она выдает:
— Я бы хотела жить в любой стране, кроме России.
Я в полном ступоре. Спрашиваю ее: почему? Она ответила:
– Потому что я хочу быть счастливой.
Вот что это было? Почему вообще колонка говорит такие странные вещи? Что скажете, @YandexSupport ?
3 месяца назад
Яндекс Минус
Один мой близкий друг сказал, что онлайн-сервисы достаточно чувствительны к подобным публикациям, поэтому я решила, что следует попробовать здесь побуянить.
Думаю, что по заголовку ясно, о ком пойдёт речь. Замечательная подписка Яндекс Плюс, которая стала достаточно популярна после ухода зарубежных сервисов из России. Но, по-классике, Яндекс, как отечественный производитель, живёт по принципу «не нае@#шь — не проживёшь». Их бесконечное количество сервисов периодически приносит пользу, но, как нам всем известно, когда вступаешь с кем-то в финансовые отношения, формат общения навсегда меняется.
Ладно, предыдущий абзац я накатала драматично от своей обиды, теперь можно и к сути перейти.
Пользовалась я подпиской с самого начала СВО, поскольку лень было возиться с переносом плейлистов из Спотифай, так что я продублировала их одной кнопочкой в яндекс музыке. Всё было в полном порядке. Весной этого года (2023) подписка закончилась, и я использовала бесплатный период предоставляемый мне моим сотовым оператором (далее СО) в личном кабинете. Там предлагалось 3 бесплатных месяца ЯП, так что на сей раз подписка была подключена через моего СО. Однако досрочно, 6 июля, я заметила в личном кабинете сбербанка два списания в один день с разницей в пару часов. Ушло по 299р на яндекс плюс. То есть, подписка оформлена на симкарту и действует она до 8 августа бесплатно, но списания произошли с банковской карты и на месяц раньше положенного.
Я написала в поддержку. Сначала мозг компостировал бот, но это современный стандарт поддержки. Когда я дописалась до оператора, он сказал, что решение вопроса требует больше времени, и что мне ответят на почту. Написала я 7 июля, когда заметила пропажу.
10 числа я снова написала в чат поддержки, поскольку признаков жизни на почте не было. Даже не подтвердили моё обращение автоматическим письмом. Там же мне спустя час ответили, что нужно ждать ответа на почту.
Спойлер: Ответа на почту я ждала 12 дней, большую часть из которых я спрашивала, когда придёт ответ. На 11 день я заново подала заявку, после которой пришло автоматизированное письмо с номером обращения. То есть до этого смысла ждать не было, поскольку запрос улетал в никуда. Хорошая работа, поддержка яндекса! Ответили мне на следующий же день.
Сообщение от поддержки можно увидеть на скриншоте.
По сути, яндекс заявил, что моя карта привязана к другим аккаунтам, и что мне нужно перевыпустить банковскую карту, если я не знаю об этих списаниях. Ага.
Ответила я поддержке так же, по почте. Вопросы были формата «каким образом можно оформить подписку ЯП на других аккаунтах без моего подтверждения». Сообщение моё было заигнорено на почте, поэтому я снова обратилась в чат. Цикл повторился, пришло то же письмо, тот же ответ, но уже на почту яндекса. Ответ на скриншоте. «Если вдруг появятся новые вопросы — смело пишите, мы на связи!» Пишите, но мы всё равно заигнорим!
598 рублей, их утрату переживу, хоть и неприятно. Но представьте количество пользователей в данной ситуации. Да, есть взрослые люди, которые способны случайно оформить подписку, дать телефон ребёнку, который куда-то нажмёт. Я человек, который следит за тем, что делает со своими банковскими картами, не раздаёт направо и налево коды от мобильного банка, или же данные своей карты, и в принципе старается соблюдать сетевую гигиену. И я умудрилась оформить две подписки яндекс плюс на чужих аккаунтах? Многое же я о себе не знала.
Надеюсь вы попьёте два наивкуснейших капучино за списанные с меня деньги.
С сервисом я, конечно же, навсегда прощаюсь, а он, в свою очередь, надеюсь распрощается со множеством потенциальных пользователей.
Кстати, после моего второго обращения, в чате поддержки яндекса мои сообщения перестали отправляться, выдаётся радующий глаз восклицательный знак в красном кружочке. Цвета любви к своим клиентам 🙂