
C#. Упаковка и распаковка. Необходимость (преимущества) применения обобщений
Упаковка и распаковка. Необходимость (преимущества) применения обобщений. Повышение типовой безопасности с помощью обобщений
Поиск на других ресурсах:
1. Понятие упаковки (boxing) и распаковки (unboxing)
Как известно, в .NET Framework все базовые типы ( int , double , char и т.д.) представлены соответствующим классом или структурой ( Integer , Double , Char и т.п.) в общей иерархической структуре классов. В вершине этой структуры лежит тип Object , к которому также можно обращаться по имени object . Это означает, что допускается объявлять переменную типа Object и использовать ее для работы с любым типом как показано ниже
. // Можно работать также через базовый класс Object Object a; object b; a = 25; // присваивание значения типа int b = "bestprog"; // присваивание значения типа string Console.WriteLine("a = ", a); // a = 25 Console.WriteLine("b = ", b); // b = bestprog // Переменной a опять присваивается значение другого типа double a = 2.88; Console.WriteLine("a = ", a); // a = 2.88 .
Допускается также использовать переменную типа object в правой части оператора присваивания:
. // Переменная типа object object c; c = 'A'; // присваивается значение char char cc; // Переменная типа char cc = (char)c; // здесь нужно явное приведение типов, иначе ошибка на этапе компиляции Console.WriteLine("cc = ", cc); // cc = A .
Но в этом случае нужно указывать явное приведение типов, как видно из строки
. cc = (char)c; .
иначе будет ошибка на этапе компиляции.
Если переменная типа object используется в левой части оператора присваивания, то компилятор выполняет так называемую упаковку. Если переменная или значение типа object используется в правой части оператора присваивания, то компилятор выполняет распаковку.
Таким образом можно дать следующие определения. Упаковка — это процесс сохранения значения простого типа ( int , char , double …) в экземпляре объекта (object). Распаковка — это процесс вытягивания упакованного значения ( int , double , char …) из объекта ( object ). Следующий пример демонстрирует различие между этими терминами:
. object a; // тип int упаковывается в тип object a = 300; // упаковка: object int b; b = (int)a; // распаковка: int .
2. Какая разница между использованием обобщений и приведением к типу object ? Демонстрация преимуществ применения обобщений. Пример
Как было сказано в п. 1 в программах на C# можно объявлять ссылки на тип Object , обращаясь к именам object или Object . Благодаря наследованию, переменным типа Object может быть присвоено значение любых унаследованных типов (смотрите п. 1).
Исходя из вышесказанного, можно сделать вывод, что использование типа Object может заменить обобщения. Тогда возникает резонный вопрос: зачем использовать обобщения, если они целиком могут быть заменены типом object ?
Использование обобщений вместо использования типа object дает следующие преимущества:
- отсутствие явного приведения типа в операторе присваивания при использовании обобщений;
- обеспечение типовой безопасности. Ошибка неправильного приведения типов генерируется уже на этапе компиляции а не на этапе выполнения программы;
- повышение производительности. Для типа object операция присваивания выполняется дольше, поскольку происходит упаковка, распаковка.
В следующих пунктах эти преимущества рассматриваются более подробно.
2.1. Преимущество 1. Отсутствие явного приведения типа
Если используется обобщение, то не нужно выполнять явное приведение типов в операции присваивания как показано на рисунке 1.
Рисунок 1. Отличие в явном приведении к типу int между обобщением и типом object
2.2. Преимущество 2. Обеспечение типовой безопасности в обобщениях
При использовании класса object в качестве типа можно допустить ошибку, которая на этапе компиляции не будет обнаружена. Эта ошибка окажется на этапе выполнения, что неприемлемо.
На рисунке 2 реализованы такие же классы как на рисунке 1. Однако, в функции main() , для обоих классов осуществляется попытка установить значение типа double .
В случае с классом ObjectClass ошибки на этапе компиляции не возникает. Эта ошибка вызовет исключительную ситуацию на этапе выполнения.
В случае с классом GenClass ошибка будет определена на этапе компиляции. Это связано с тем, что создается типизированный код с привязкой к типу int . В этом коде ошибки определяются на этапе компиляции. Это является основным преимуществом обобщений, которые повышают типовую безопасность.

Рисунок 2. Особенности выявления ошибки компилятором для обобщенного и необобщенных класса
2.3. Преимущество 3. Повышение производительности
Использование обобщенных классов дает большую производительность (быстродействие) по сравнению с необобщенными. При присвоении значения типа object другим типам и наоборот, компилятор выполняет упаковку и распаковку (смотрите п. 1). Этот процесс требует больше временных затрат чем использование обобщений. В случае с обобщениями формируется типизированный код с привязкой к конкретному типу, который выполняется быстрее.
Рисунок 3 отражает объявление двух классов ObjectClass и GenClass . В функции main() выделены фрагменты кода, в которых проявляется различие в производительности между объектами ( object ) и обобщениями.

Рисунок 3. Отличие в производительности выполнения кода между обобщенным классом и классом типа object . Операция присваивания для обобщенных классов выполняется быстрее
Связанные темы
- Обобщения. Основные понятия. Обобщенные классы и структуры
- Обобщенные интерфейсы. Синтаксис объявления. Реализация обобщенных интерфейсов в классах. Примеры
- Обобщенные методы в классах. Синтаксис объявления. Способы вызова
- Обобщенные делегаты
Упаковка-преобразование и распаковка-преобразование (Руководство по программированию на C#)
Упаковка представляет собой процесс преобразования типа значения в тип object или в любой другой тип интерфейса, реализуемый этим типом значения. Когда тип значения упаковывается общеязыковой средой выполнения (CLR), он инкапсулирует значение внутри экземпляра System.Object и сохраняет его в управляемой куче. Операция распаковки извлекает тип значения из объекта. Упаковка является неявной; распаковка является явной. Понятия упаковки и распаковки лежат в основе единой системы типов C#, в которой значение любого типа можно рассматривать как объект.
В следующем примере выполнена операция i упаковки целочисленной переменной, которая присвоена объекту o .
int i = 123; // The following line boxes i. object o = i; Затем можно выполнить операцию распаковки объекта o и присвоить его целочисленной переменной i :
o = 123; i = (int)o; // unboxing Следующий пример иллюстрирует использование упаковки в C#.
// String.Concat example. // String.Concat has many versions. Rest the mouse pointer on // Concat in the following statement to verify that the version // that is used here takes three object arguments. Both 42 and // true must be boxed. Console.WriteLine(String.Concat("Answer", 42, true)); // List example. // Create a list of objects to hold a heterogeneous collection // of elements. List mixedList = new List(); // Add a string element to the list. mixedList.Add("First Group:"); // Add some integers to the list. for (int j = 1; j < 5; j++) < // Rest the mouse pointer over j to verify that you are adding // an int to a list of objects. Each element j is boxed when // you add j to mixedList. mixedList.Add(j); >// Add another string and more integers. mixedList.Add("Second Group:"); for (int j = 5; j < 10; j++) < mixedList.Add(j); >// Display the elements in the list. Declare the loop variable by // using var, so that the compiler assigns its type. foreach (var item in mixedList) < // Rest the mouse pointer over item to verify that the elements // of mixedList are objects. Console.WriteLine(item); >// The following loop sums the squares of the first group of boxed // integers in mixedList. The list elements are objects, and cannot // be multiplied or added to the sum until they are unboxed. The // unboxing must be done explicitly. var sum = 0; for (var j = 1; j < 5; j++) < // The following statement causes a compiler error: Operator // '*' cannot be applied to operands of type 'object' and // 'object'. //sum += mixedList[j] * mixedList[j]; // After the list elements are unboxed, the computation does // not cause a compiler error. sum += (int)mixedList[j] * (int)mixedList[j]; >// The sum displayed is 30, the sum of 1 + 4 + 9 + 16. Console.WriteLine("Sum: " + sum); // Output: // Answer42True // First Group: // 1 // 2 // 3 // 4 // Second Group: // 5 // 6 // 7 // 8 // 9 // Sum: 30 Производительность
По сравнению с простыми операциями присваивания операции упаковки и распаковки являются весьма затратными процессами с точки зрения вычислений. При выполнении упаковки типа значения необходимо создать и разместить новый объект. Объем вычислений при выполнении операции распаковки, хотя и в меньшей степени, но тоже весьма значителен. Дополнительные сведения см. в разделе Производительность.
Упаковка
Упаковка используется для хранения типов значений в куче со сбором мусора. Упаковка представляет собой неявное преобразование типа значения в тип object или в любой другой тип интерфейса, реализуемый этим типом значения. При упаковке типа значения в куче выделяется экземпляр объекта и выполняется копирование значения в этот новый объект.
Рассмотрим следующее объявление переменной типа значения.
int i = 123; Следующий оператор неявно применяет операцию упаковки к переменной i .
// Boxing copies the value of i into object o. object o = i; Результат этого оператора создает ссылку на объект o в стеке, которая ссылается на значение типа int в куче. Это значение является копией значения типа значения, присвоенного переменной i . Разница между этими двумя переменными, i и o , показана на рисунке упаковки-преобразования ниже:
Можно также выполнять упаковку явным образом, как в следующем примере, однако явная упаковка не является обязательной.
int i = 123; object o = (object)i; // explicit boxing Пример
В этом примере целочисленная переменная i преобразуется в объект o при помощи упаковки. Затем значение, хранимое переменной i , меняется с 123 на 456 . В примере показано, что исходный тип значения и упакованный объект используют отдельные ячейки памяти, а значит могут хранить разные значения.
class TestBoxing < static void Main() < int i = 123; // Boxing copies the value of i into object o. object o = i; // Change the value of i. i = 456; // The change in i doesn't affect the value stored in o. System.Console.WriteLine("The value-type value = ", i); System.Console.WriteLine("The object-type value = ", o); > > /* Output: The value-type value = 456 The object-type value = 123 */ Распаковка-преобразование
Распаковка является явным преобразованием из типа object в тип значения или из типа интерфейса в тип значения, реализующего этот интерфейс. Операция распаковки состоит из следующих действий:
- проверка экземпляра объекта на то, что он является упакованным значением заданного типа значения;
- копирование значения из экземпляра в переменную типа значения.
В следующем коде показаны операции по упаковке и распаковке.
int i = 123; // a value type object o = i; // boxing int j = (int)o; // unboxing На рисунке ниже представлен результат выполнения этого кода.
Для успешной распаковки типов значений во время выполнения необходимо, чтобы экземпляр, который распаковывается, был ссылкой на объект, предварительно созданный с помощью упаковки экземпляра этого типа значения. Попытка распаковать null создает исключение NullReferenceException. Попытка распаковать ссылку на несовместимый тип значения создает исключение InvalidCastException.
Пример
В следующем примере показан случай недопустимой распаковки, в результате чего создается исключение InvalidCastException . В случае использования try и catch при возникновении ошибки выводится сообщение.
class TestUnboxing < static void Main() < int i = 123; object o = i; // implicit boxing try < int j = (short)o; // attempt to unbox System.Console.WriteLine("Unboxing OK."); >catch (System.InvalidCastException e) < System.Console.WriteLine("Error: Incorrect unboxing.", e.Message); > > > При выполнении этой программы выводится следующий результат:
Specified cast is not valid. Error: Incorrect unboxing.
При изменении оператора:
int j = (short)o; int j = (int)o; будет выполнено преобразование со следующим результатом:
Спецификация языка C#
Дополнительные сведения см. в спецификации языка C#. Спецификация языка является предписывающим источником информации о синтаксисе и использовании языка C#.
См. также
- Руководство по программированию на C#
- Ссылочные типы
- Типы значений
Совместная работа с нами на GitHub
Источник этого содержимого можно найти на GitHub, где также можно создавать и просматривать проблемы и запросы на вытягивание. Дополнительные сведения см. в нашем руководстве для участников.
The .NET documentation is open source. Provide feedback here.
Обратная связь
Отправить и просмотреть отзыв по
Зачем нужна упаковка в си шарп
Сегодня поговорим об Aйти и не только. Вас ждет разбор вопросов и ответов с собеседований. Обсудим такую область знаний из IT, как C# и .Net. Зачем разработчику ходить на собеседования? В чем разница между ссылочными и значимыми типами данных? Для чего нужна упаковка и распаковка C Sharp? В чем разница между интерфейсом и абстрактным классом? Где используются дженерики? Также больше про дженерики, абстрактный класс и абстрактный метод, конструкцию try/catch, команду throw, конструкцию using, тип коллекции dictionary, хэш код в Си шарп, асинхронность и многопоточность, тип string и многое другое — в новом видео. Поделится своим опытом работы и поможет во всем разобраться наш наставник и девелопер с большим опытом Паша Львов.
Как пройти СОБЕСЕДОВАНИЕ на С# & .Net РАЗРАБОТЧИКА? / НАТИВ / Павел Львов
21 февраля 2023

FullStack C# разработчик
Программа курса составлена практикующими .NET разработчиками для новичков в .NET разработке на основе требований IT компаний
Смотрите также

Что такое Python и чем он хорош?

Собеседование Python разработчика

Кто такой геймдизайнер?

Как пройти СОБЕСЕДОВАНИЕ на C# & .Net РАЗРАБОТЧИКА? (2)
Как стать iOS-разработчиком в 2023 году ?
Stack and heap. Структуры данных в .NET

10.09.2018

10756
Рейтинг: 5 . Проголосовало: 2
Вы проголосовали:
Для голосования нужно авторизироваться
В этой статье мы рассмотрим организацию работы с памятью в .NET. Здесь мы узнаем, что такое стек и куча, и для хранения каких типов данных они применяются.
Разделение памяти
По умолчанию, как только .NET приложение запускается и определяется виртуальный адрес текущего процесса, создаются следующие «кучи»:
Куча для кода — JIT-компилируемый нативный код
Малая объектная куча — объекты до 85 кб
Большая объектная куча — объекты свыше 85 кб*
Куча для обработки данных
*примечание: в случае массивов для данных типа double существует исключение, согласно которому они хранятся в большой объектной куче задолго до достижения размера в 85 кб (double[] считается системой «большим» объектом при достижении размера в 1000 элементов). По отношению к оптимизации 32-битного кода это, конечно, не очень хорошо.
Разбиение на большие и малые кучи достаточно целесообразно для улучшения производительности, но об этом позже, когда будем говорить о сборщике мусора.
Элементы, размещенные в кучи, обладают своими адресами, которые являются чем-то вроде указателей на ячейки памяти, где хранятся значения этих элементов.
Впрочем, куча — это не единственная структура данных, которой может похвалиться вселенная .NET. К примеру, есть еще и стек, который крайне полезен для хранения «специфических» типов данных. Сейчас мы рассмотрим в деталях, как устроены эти структуры данных в деталях.
Стек
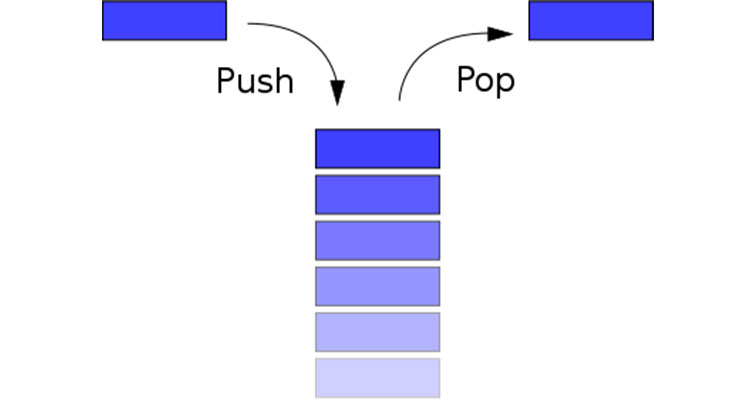
Стек — это структура данных, организованная по принципу LIFO (последний вошел — первый вышел). Если вдуматься, это идеальное решение для хранения данных, к которым вскоре предстоит обратиться (легко извлекаются с вершины стека). Де-факто природа области стека заключается в двух постулатах: «помнить» порядок выполнения и хранить значимые типы данных.
Тема связана со специальностями:
Запоминание порядка выполнения — обращение к стеку
Большая часть кода, который мы пишем, инкапсулирован в классы и методы, которые вызывают другие методы, и так далее. .NET Framework обязан всегда «помнить» порядок вызовов участков кода. Более того, так же нужно хранить данные о состоянии переменных и значениях параметров, передаваемых при вызове методов (дабы суметь восстановить состояние вызывающего метода после завершения работы вызываемого).
При каждом вызове метода .NET инициализирует стек-фрейм (что-то вроде контейнера), где и хранится вся необходимая информация для выполнения методов: параметры, локальные переменные, адреса вызываемых строчек кода. Стек-фреймы создаются в стеке друг на друге. Все это прекрасно проиллюстрировано ниже:
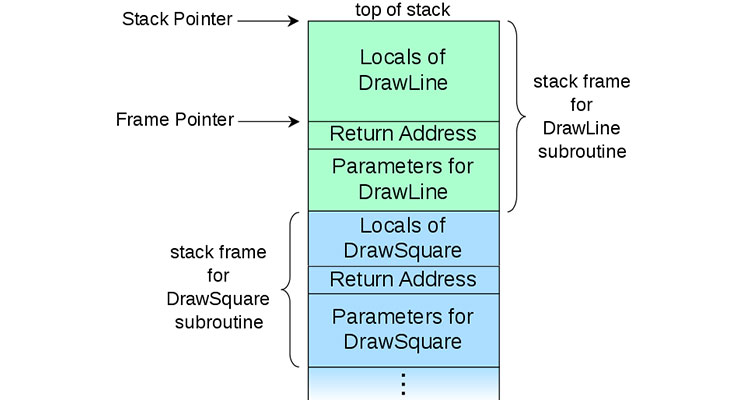
Стек используется для хранения порядка выполнения кода и часто называется стеком вызова, стеком выполнения или программным стеком.
Давайте взглянем на следующий участок кода:
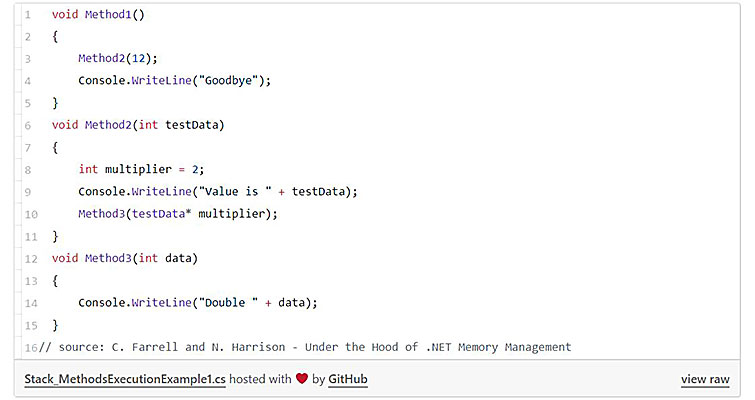
Дабы вызвать Method2, фреймворк должен сохранить адрес конца выполнения метода, которым будет следующая строчка кода (строчка 4 в примере ниже). Этот адрес вместе с параметрами и локальными переменными вызываемого и вызывающего метода хранятся в стеке вызова, как показано на схеме ниже.
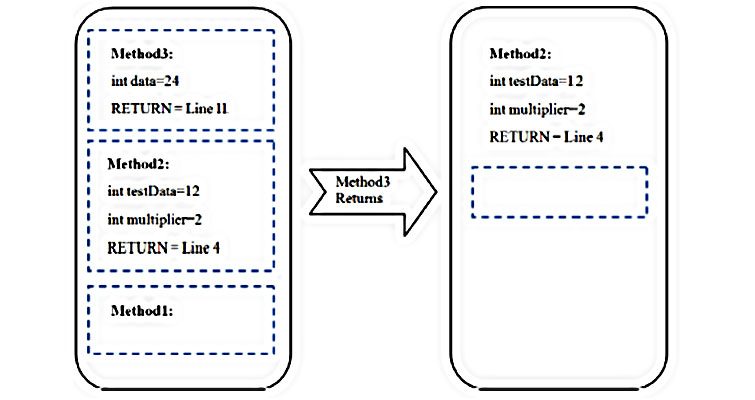
Также вы можете увидеть, что происходит, когда Method3 завершает свое выполнение (стек-фрейм покидает стек вызова).
Хранение значимых типов
Также стек используется для хранения переменных любых значимых типов .NET — включая: bool, decimal, int и так далее.
Ссылочные типы — это типы, которые хранят данные и ссылку на эти данные в рамках одной области памяти. Что так же интересно, так это то, что все локальные переменные значимых типов при завершении выполнения метода очищаются. Это происходит по той причине, что при завершении работы метода его стек-фрейм становится недоступным — стек имеет указатель на начало стек-фрейма на вершине стека вызова (текущий указатель стек-фрейма), который просто перемещается на следующий стек-фрейм после окончания работы текущего (физически данные все еще находятся в стеке вызова, но на практике получить доступ к ним через стандартный .NET-механизм невозможно).
Видео курсы по схожей тематике:
Платформа Managed Extensibility Framework (MEF)
C# 5.0 для профессионалов
Куча
Куча схож со стеком, но если стек представляется в виде последовательности коробок, складируемых друг на друге, в случае с кучей эти самые коробки аккуратно разложены и мы можем получить к ним доступ в любое время.
Хранение ссылочных типов
Все прочие переменные, которые не являются значимыми (производные от object), являются ссылочными типами данных. Все ссылочные типы данных хранятся в управляемой куче (малой или большой — в зависимости от размера). Впрочем, пусть даже и значение объекта хранится в куче, ссылка на него хранится в стеке.
Рассмотрим следующий код:
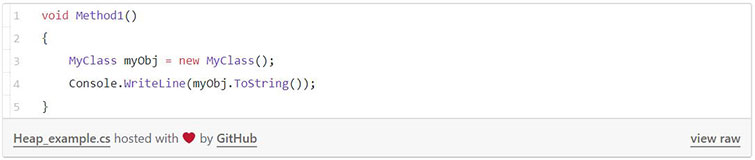
Фигура ниже иллюстрирует, как выглядит стек и куча в плане хранения данных:
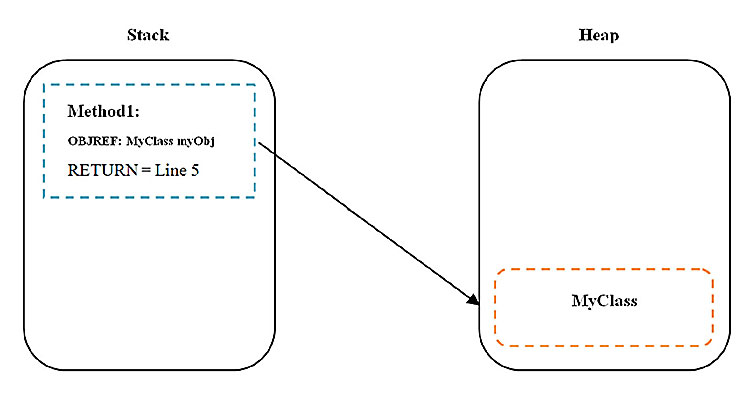
OBJREF, хранимый в стеке, на самом деле является ссылкой на объект MyClass, хранимый в куче.
Заметка: выражение MyClass myObj совершенно не занимает места в куче переменной myObj. Здесь всего лишь создается переменная OBJREF в стеке, после чего она инициализируется значением null. Как только выполняется команда new, куча получает действительное место памяти объекта, а сам ссылочный объект получает по адресу свое значение.
Значимые типы против ссылочных типов (стек против кучи)
Основное различие между ссылочными и значимыми типами данных заключается в том, что ссылочные типы данных передаются по адресу – то есть при передаче ссылочной переменной в виде параметра метода передается всего лишь общий адрес на ячейку памяти с данными объекта. В случае же со значимыми типами данных, между методами передается копия самого объекта. Вот как это выглядит схематически:
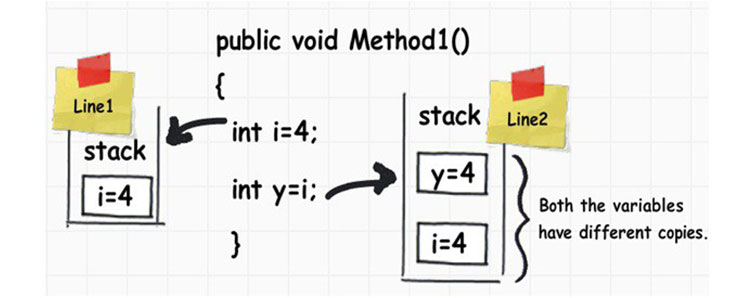
Как уже и было сказано, в случае со ссылочными типами данных, при присваивании ссылочному типу данных значения другого ссылочного типа данных, происходит присваивания адреса, тогда как ячейка памяти со значением остается прежней.
Бесплатные вебинары по схожей тематике:
Как стать программистом? Python, Java, FrontEnd или .NET – что выбрать?
Перспективы профессии .NET разработчик в 2024 году

Создание игры “Space Invaders” на C# с нуля.
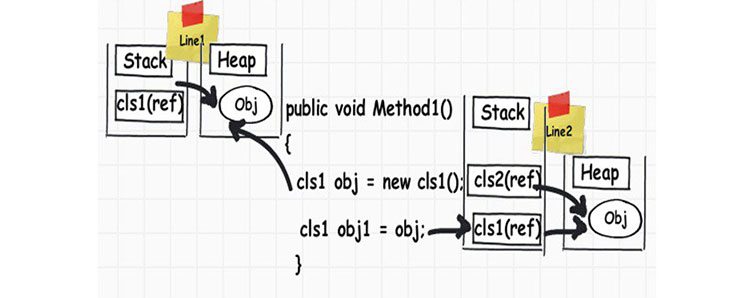
Конечно, хранение одного вида информации в стеке, другого в куче, имеет свои причины, которые мы рассмотрим в грядущих статьях. 🙂
Заключение
В сегодняшней статье мы рассмотрели область стека и кучи, два вида организации памяти для работы в рамках .NET-приложения. В следующей статье мы познакомимся с процессом упаковки и распаковки, а также узнаем, как это сказывается на производительности нашего приложения.
До новых встреч!
Автор перевода: Евгений Лукашук