
Запуск настраиваемых программ MapReduce
Системы для работы с большими данными Apache Hadoop, такие как HDInsight, позволяют обрабатывать данные с использованием разных инструментов и технологий. Преимущества и рекомендации каждого из них описаны в следующей таблице.
- Это идеальное решение для пакетной обработки и анализа больших объемов неизменяемых данных, для обобщения данных и отправки запросов данных по требованию. Использует знакомый синтаксис типа SQL.
- С его помощью можно создавать постоянные таблицы данных, которые легко секционируются и индексируются.
- Для одних и тех же данных можно создать несколько внешних таблиц и представлений.
- Поддерживает простую реализацию хранилища данных, которая обеспечивает широкие возможности горизонтального масштабирования и отказоустойчивости для хранения и обработки данных.
- Требует, чтобы исходные данные имели хотя бы какую-то идентифицируемую структуру.
- Не подходит для запросов в режиме реального времени и обновлений на уровне строк. Лучше всего подходит для выполнения пакетных заданий с большими наборами данных.
- Возможно, не сможет выполнять некоторые типы сложных задач обработки.
- Это идеальное решение для обработки данных в виде наборов, объединения и фильтрации наборов данных, применения функций к записям или группам записей, а также для реструктуризации данных путем определения столбцов, группировки значений или преобразования столбцов в строки.
- Для последовательности операций с данными может использовать подход на основе рабочих процессов.
- Для пользователей SQL Pig Latin может быть менее знакомым и более сложным в использовании, чем HiveQL.
- По умолчанию выходные данные обычно представляют собой текстовый файл, поэтому их сложнее использовать с инструментами визуализации, такими как Excel. Как правило, вам нужно будет накладывать таблицу Hive на выходные данные.
- Обеспечивает полный контроль над этапами сопоставления, сжатия и выполнения.
- Позволяет оптимизировать запросы, чтобы достичь максимальной производительности кластера или чтобы свести к минимуму нагрузку на серверах и в сети.
- Компоненты могут быть написаны на одном из общеизвестных языков из широкого диапазона.
- Более сложный в использовании, чем Pig или Hive, так как вам нужно будет создать собственные компоненты сопоставления и сжатия.
- Процессы, для которых нужно объединение наборов данных, сложнее реализовать.
- Несмотря на наличие доступных тестовых платформ, код отладки сложнее, чем в обычном приложении, так как он выполняется как пакетное задание под управлением планировщика заданий Hadoop.
- Абстрагирует сведения о пути хранилища, что упрощает администрирование. К тому же при его использовании пользователям не нужно знать, где хранятся данные.
- Предоставляет уведомления о событиях, таких как доступность данных, позволяя другим средствам, например Oozie, определять, когда выполнялись операции.
- Обеспечивает реляционное представление данных, включая секционирование по ключу, а также упрощает доступ к данным.
- Поддерживает RCFile, текст в формате CSV, текст в формате JSON, SequenceFile и форматы файла ORC по умолчанию, однако для него может потребоваться написание пользовательских SerDe для других форматов.
- HCatalog не является потокобезопасным.
- Существуют некоторые ограничения для типов данных столбцов при использовании загрузчика HCatalog в скриптах Pig. Дополнительные сведения см. в документации по Apache HCatalog в разделе о типах данных HCatLoader.
Как правило, из подходов, которые могут предоставить нужные результаты, используется самый простой. Например, таких результатов можно достичь с помощью Hive, однако для более сложных сценариев нужно использовать Pig или даже написать собственные компоненты сопоставления и сжатия. Поэкспериментировав с Hive или Pig, вы можете решить, что настраиваемые компоненты сопоставления и сжатия обеспечивают лучшую производительность, позволяя настроить и оптимизировать обработку.
Настраиваемые компоненты сопоставления и сжатия
Код сопоставления и сжатия состоит из двух отдельных функций, которые реализованы в виде компонентов map и reduce. Компонент map выполняется параллельно на нескольких узлах кластера, причем каждый узел применяет сопоставление к собственному подмножеству данных узла. Компонент reduce объединяет и суммирует результаты всех функций сопоставления. Дополнительные сведения об этих компонентах см. в статье Использование MapReduce в Hadoop в HDInsight.
В большинстве сценариев обработки HDInsight проще и эффективнее использовать абстракцию более высокого уровня, такую как Pig или Hive. Вы также можете создать компоненты настраиваемого сопоставления и сжатия для использования в скриптах Hive, чтобы выполнить более сложную обработку.
Обычно компоненты настраиваемого сопоставления и сжатия пишутся на языке Java. Hadoop предоставляет интерфейс потоковой передачи, который также позволяет использовать компоненты, разработанные на других языках, таких как C#, F#, Visual Basic, Python и JavaScript.
- Пошаговые инструкции по разработке настраиваемых программ MapReduce на Java см. в статье Разработка программ MapReduce на Java для Hadoop в HDInsight.
Рекомендуем создать собственные компоненты сопоставления и сжатия при следующих условиях:
- Для получения структурированных сведений из неструктурированных данных вам необходимо обработать эти данные путем анализа и использовать настраиваемую логику.
- Вам требуется выполнять сложные задачи, которые трудно (или невозможно) выразить в Pig или Hive, не создавая определяемые пользователем функции (UDF). Например, вам потребуется внешняя служба геокодирования, чтобы преобразовать широту и долготу координат или IP-адресов в исходных данных в названия географических расположений.
- Вам нужно повторно использовать имеющиеся коды .NET, Python или JavaScript в компонентах сопоставления и сжатия с помощью интерфейса потоковой передачи Hadoop.
Загрузка и запуск настраиваемой программы MapReduce
Самые распространенные программы MapReduce написаны на языке Java и скомпилированы в виде JAR-файла.
-
После разработки, компиляции и тестирования программы MapReduce отправьте JAR-файл на головной узел с помощью команды scp .
scp mycustomprogram.jar sshuser@CLUSTERNAME-ssh.azurehdinsight.net ssh sshuser@CLUSTERNAME-ssh.azurehdinsight.net yarn jar mycustomprogram.jar mynamespace.myclass /example/data/sample.log /example/data/logoutput Дальнейшие действия
- Использование C# для потоковой передачи MapReduce в Apache Hadoop в HDInsight
- Разработка программ MapReduce на Java для Apache Hadoop в HDInsight
- Создание приложений Apache Spark для кластера HDInsight с помощью Azure Toolkit for Eclipse
- Использование определяемых пользователем функций Python с Apache Hive и Apache Pig в HDInsight
Hadoop, часть 3: Pig, обработка данных
В предыдущей публикации мы подробно рассмотрели процесс сбора данных при помощи специализированного инструмента Flume. Но чтобы полноценно работать с информацией, мало ее просто собрать и сохранить: ее нужно обработать и извлечь из нее нечто нужное и полезное.
Для обработки данных в Hadoop используется технология MapReduce.
Технология MapReduce
История
Обработка данных в Hadoop осуществляется с помощью технологии MapReduce. Изначально эта технология была разработана компанией Google в 2004 году.
Разработчики Google Джеффри Дин и Санджай Гемават в 2004 году опубликовали статью, в которой предложили следующее решение для обработки больших объемов «сырых» данных (индексированных документов, логов запросов и т.п.): огромный массив информации делится на части, и обработка каждой из этих частей поручается отдельному серверу. Как правило, данные обрабатываются на тех же серверах, где они и хранятся, что позволяет ускорить процесс обработки и избежать лишних перемещений данных между серверами. После этого полученные результаты объединяются в единое целое.
Специалисты Google в упомянутой выше статье ограничились лишь описанием основных алгоритмов, не останавливаясь на подробностях реализации. Однако этой информации оказалось для разработчиков Hadoop вполне достаточно, чтобы создать собственный фреймворк MapReduce.
Сегодня он используется во многих известных веб-проектах — Yahoo!, Facebook, Last.Fm и других.
Рассмотрим архитектуру и принципы работы Hadoop MapReduсе более подробно.
Архитектура и принципы работы
Архитектура MapReduce построена по принципу «главный — подчиненные» (master — workers). В качестве главного выступает сервер JobTracker, раздающий задания подчиненным узлам кластера и контролирующий их выполнение.

- Запуск приложения: передача кода приложения на главный (master) и подчиненные узлы (workers);
- Мастер назначает конкретные задачи (Map или Reduce) и распределяет части входных данных по вычислительным узлам (workers);
- Map-узлы читают назначенные им входные данные и начинают их обработку;
- Map-узлы локально сохраняют промежуточные результаты: каждый узел сохраняет полученный результат на локальные диски;
- Reduce-узлы читают промежуточные данные с Map-узлов и выполняют Reduce обработку данных;
- Reduce-узлы сохраняют итоговые результаты в выходные файлы, обычно в HDFS.
Создание приложений для MapReduce — дело достаточно трудоемкое. Написание всех функций, компилирование и упаковка занимают много времени. Чтобы облегчить работу компания Yahoo! разработала специализированный инструмент под названием Pig, повышающий уровень абстракции при обработке данных.
Pig
- язык для описания потоков Pig Latin;
- исполнительная среда для запуска сценариев Pig Latin (доступны два варианта: запуск на локальной JVM или исполнение в кластере Hadoop).
Сценарий Pig включает серию операций (преобразований), которые необходимо применить к входным данным, чтобы получить выходные данные. Эти операции описывают поток данных, который затем преобразуется (компилируется) исполнительной средой Pig в исполняемое представление и запускается для выполнения. Во внутренней реализации Pig трансформирует преобразования в серию заданий MapReduce.
Изначально Pig был создан для работы из консоли (оболочка Grunt Shell). В реализации от Cloudera работа с Pig осуществляется через простой и удобный веб-интерфейс. Открыть его можно через уже знакомый нам интерфейс Hue http://[узел_на_котором_установлен_Hue]:8888/pig/

Веб-интерфейс включает полноценный редактор (есть даже автоподстановка операторов) и менеджер скриптов. С его помощью можно сохранять скрипты непосредственно в Hue, запускать их, просматривать список запущенных задач, результаты и логи запусков.
Тестовая задача
- общее количество запросов;
- количество запросов с каждого уникального IP;
- количество запросов на каждый уникальный URL;
- объем данных, переданных по каждому URL.
Полный листинг скрипта будет выглядеть так:
records = LOAD '/log/flume/events/14-02-20/' USING PigStorage('\t') AS ( date:chararray, clientip:chararray, clientport:chararray, proto:chararray, statuscode:int, bytes:int, sq:chararray, bq:chararray, request:chararray ); count_total = FOREACH (GROUP records ALL) GENERATE COUNT(records); count_ip = FOREACH (GROUP records BY clientip) GENERATE group AS ip, COUNT(records) AS cnt; top_ip = ORDER count_ip BY cnt DESC; filtered_req = FILTER records BY statuscode == 200 OR statuscode == 206; count_req = FOREACH (GROUP filtered_req BY request) GENERATE group AS req, COUNT(filtered_req) AS cnt, SUM(filtered_req.bytes) AS bytes; top_req = ORDER count_req BY bytes DESC; %declare DT `date +%y%m%dT%H%M` STORE count_total INTO '$DT/count_total'; STORE top_ip INTO '$DT/top_ip'; STORE top_req INTO '$DT/top_req';
Он состоит из трех частей: загрузка данных, обработка и сохранение. Такой порядок является общим для большинства задач. В некоторых случаях решение задач может включать и дополнительные этапы — например, генерацию данных (например, структурированных искусственных данных для проверки алгоритма) или сохранение промежуточных результатов вычислений. Подробное описание синтаксиса, типов данных и операторов вы можете найти в официальной документации.
Рассмотрим каждый этап более подробно.
Загрузка
records = LOAD '/log/flume/events/14-02-20/' USING PigStorage('\t') AS ( date:chararray, clientip:chararray, clientport:chararray, proto:chararray, statuscode:int, bytes:int, sq:chararray, bq:chararray, request:chararray );
В качестве входных данных мы используем логи веб-серверов. Для лучшего понимания дальнейшей обработки приведем пример входных данных:
07/Dec/2013:20:05:13 95.153.193.56 37877 http 200 1492030 0 0 GET /745dbda3-894e-43aa-9146-607f19fe4428.mp3 HTTP/1.1 08/Dec/2013:15:00:28 178.88.91.180 13600 http 200 4798 0 0 GET /public/cars/bmw7l/down.png HTTP/1.1 08/Dec/2013:15:00:29 193.110.115.45 64318 http 200 1594 0 0 GET /K1/img/top-nav-bg-default.jpg HTTP/1.1
Вначале рассмотрим модель данных и терминологию. Основной объект в Pig Latin- это «отношение». Именно с отношениями работают все операторы языка. В форме отношений представляются входные и выходные данные.
Каждое отношение представляет собой набор однотипных объектов — «кортежей» (tuples). Аналоги в БД: кортеж — это строка, отношение — это таблица.
Кортежи соответственно состоят из нумерованных или именованных объектов — «полей», произвольных базовых типов (число, строка, булева переменная и т.д.).
Итак, в Pig Latin результатом любого оператора является отношение, представляющее собой набор кортежей.
Оператор LOAD создает отношение records из файлов в HDFS из директории ’/log/flume/events/14-02-20/’, используя стандартный интерфейс PigStorage (также укажем, что разделителем в файлах является символ табуляции ‘\t’). Каждая строка из файлов предстанет кортежем в отношении. Секция AS присваивает полям в кортеже типы и имена, по которым нам будет удобнее к ним обращаться.
Обработка
Посчитаем общее количество записей в логах с помощью оператора COUNT. Перед этим необходимо объединить все строки в records в одну группу операторами FOREACH и GROUP.
count_total = FOREACH (GROUP records ALL) GENERATE COUNT(records); count_ip = FOREACH (GROUP records BY clientip) GENERATE group AS ip, COUNT(records) AS cnt; top_ip = ORDER count_ip BY cnt DESC;
В переводе с Pig Latin на естественный язык приведенный скрипт выглядит так: для каждой записи (FOREACH), из records, сгруппированных вместе (GROUP ALL), выполнить подсчет записей в records (GENERATE COUNT).
- поле ip, значение которого берется из названия группы в отношении records;
- количество записей в группе — cnt, посчитанное оператором COUNT, то есть количество записей, соответствующих определенному IP-адресу в поле IP.
Далее мы определяем еще одно отношение top_ip, состоящее из тех же данных, что и count_ip, но отсортированное по полю cnt оператором ORDER. Таким образом, в top_ip у нас будет список IP-адресов клиентов с которых чаще всего происходили запросы. В дальнейшем мы можем привязать эти данные к GEO-IP и посмотреть, в каких городах и странах наше хранилище пользуется наибольшей популярностью =)
filtered_req = FILTER records BY statuscode == 200 OR statuscode == 206; count_req = FOREACH (GROUP filtered_req BY request) GENERATE group AS req, COUNT(filtered_req) AS cnt, SUM(filtered_req.bytes) AS bytes; top_req = ORDER count_req BY bytes DESC;
После этого посчитаем количество успешных запросов на каждый URL, а также суммарный объем загруженных по каждому URL данных. Для этого сначала воспользуемся оператором фильтрации FILTER, отобрав только успешные запросы с HTTP кодами 200 OK и 206 Partial Content. Этот оператор определяет новое отношение filtered_req из отношения records, отфильтровав его по полю statuscode.
Далее аналогично подсчету IP-адресов посчитаем количество уникальных URL, группируя записи в отношении requests по полю request. Для нас также представляет интерес переданный объем данных по каждому URL: его можно рассчитать с помощью оператора SUM, складывающего поля bytes в сгруппированных записях отношения filtered_req.
Теперь осуществим сортировку по полю bytes, определяя новое отношение top_req.
Сохранение результатов
%declare DT `date +%y%m%dT%H%M` STORE count_total INTO '$DT/count_total'; STORE top_ip INTO '$DT/top_ip'; STORE top_req INTO '$DT/top_req';
Предпочтительно сохранять результаты каждого выполнения скрипта в отдельную директорию, имя которой включает дату и время исполнения. Для этого можно воспользоваться функцией вызова произвольной шелл-команды прямо из Pig-скрипта (ее нужно написать в обратных кавычках). В примере результат команды date заносится в переменную DT, которая затем подставляется в пути сохранения данных. Сохраняем результаты командой STORE: каждое отношение — в свой каталог.
Просмотреть выходные данные можно через файловый менеджер в Hue; по умолчанию путь в HDFS указывается относительно домашней директории пользователя, запустившего скрипт.

Информация о результатах выполнения задач будет отображена в логах Pig следующим образом:
http://cdh3:8888/pig/#logs/1100715 Input(s): Successfully read 184442722 records (32427523128 bytes) from: "/log/flume/events/14-02-20" Output(s): Successfully stored 1 records (10 bytes) in: "hdfs://cdh3:8020/user/admin/140225T1205/count_total" Successfully stored 8168550 records (1406880284 bytes) in: "hdfs://cdh3:8020/user/admin/140225T1205/top_req" Successfully stored 2944212 records (49039769 bytes) in: "hdfs://cdh3:8020/user/admin/140225T1205/top_ip" Counters: Total records written : 11112763 Total bytes written : 1455920063
Last Modified Tue, 25 Feb 2014 00:22:00 Start Time Tue, 25 Feb 2014 00:05:16 Created Time Tue, 25 Feb 2014 00:05:15 End Time Tue, 25 Feb 2014 00:22:00
Из приведенных логов видно, что при выполнении тестовой задачи было обработано более 180 миллионов записей общим объемом более 32 Гб. Вся процедура обработки заняла около 15 минут.
Во время активной фазы Map было задействовано 22 процессорных ядра и 91Гб оперативной памяти. Для небольшого кластера, состоящего из трех серверов пятилетней давности, такой результат можно считать вполне неплохим.
Выше уже было сказано, что Pig во время исполнения скрипта создает MapReduce задачи и отправляет их на выполнение в MR-кластер. Этот процесс наглядно показан на графиках статистики в панели управления Cloudera Manager:


- Этап Map: процессоры и диски на каждом узле заняты обработкой своих частей данных.
- Этап Reduce: результаты, полученные на первом этапе, передаются по сети и объединяются.
- На третьем этапе результаты сохраняются в файловой системе (на графике виден скачок записи в HDFS).
На графиках можно увидеть, что решение задачи включало два прохода MapReducе. Во время первого прохода был выполнен подсчет уникальных записей, а во время второго — сортировка. Эти процедуры не могут быть распараллелены и выполнены за один проход, так как вторая процедура работает с результатами первой.
Заключение
В этой статье мы рассказали об архитектуре MapReduce, а также рассмотрели особенности его работы с использованием инструмента Pig. Написание программ для MapReduce представляет собой весьма непростую задачу, требующую особого подхода. Все сложности, однако, компенсируются мощностью, возможностями масштабирования и высокой скоростью обработки огромных объемов произвольных данных.
В ближайшее время мы планируем продолжить цикл статей о Hadoop. Следующая публикация будет посвящена работе с базой данных Impala.
Читателей, не имеющих возможности комментировать посты на Хабре, приглашаем к нам в блог.
- Блог компании Selectel
- Big Data
- Hadoop
Какие виды заданий (jobs) поддерживает MapReduce Service?
Задания, предоставляемые сервисом MRS , являются платформой для выполнения программ. В настоящее время MRS поддерживает такие задания, как MapReduce, ClickHouse, Spark и Hive.
Модель программирования, предназначенная для параллельной обработки больших объемов данных (более одного Тб) с разделением работы на множество независимых задач. Map делит одну задачу на несколько задач, а Reduce суммирует результаты обработки этих задач и выдает конечный результат анализа. После завершения разработки кода упакуйте его в JAR-файл в IDEA или Eclipse, загрузите файл в кластер MRS для выполнения
Механизм пакетной обработки данных с высокой скоростью обработки. Вычисления на основе Spark требуют большого количества памяти. Spark-задание включает в себя: — Spark: заканчивается .jar , независимый от регистра.
- Spark Script: заканчивается на .sql , независимый от регистра.
- Spark SQL: задает стандартные операторы Spark SQL, например, show tables .
Система управления базами данных на основe платформы Hadoop. Hive предоставляет язык запросов Hive (HiveQL), аналогичный языку структурированных запросов (SQL) для обработки структурированных данных. Hive автоматически преобразует HiveQL в скрипте Hive в задачу MapReduce для запроса и анализа данных, хранящихся в кластере Hive. Например, стандартный оператор HiveQL выглядит следующим образом:
create table page_view (viewTime INT,userid BIGINT,page_url STRING,referrer_uel STRING,ip STRING COMMENT 'IP Address of the User')
Столбцовая СУБД для обработки аналитических запросов в реальном времени.
Что преобразует sql запросы в задания mapreduce
Сергей Кузнецов
4. Параллельная СУБД на основе MapReduce
Начну этот раздел с того, что в одной из первых серьезных статей, посвященных сравнению эффективности технологий MapReduce и массивно-параллельных СУБД при решении аналитических задач [27], утверждалось, что развитость и зрелость технологии параллельных СУБД категории sharing-nothing позволяет им обходиться стоузловыми кластерами для поддержки самых крупных сегодняшних аналитических баз данных петабайтного масштаба. Вместе с тем, особые качества масштабируемости и отказоустойчивости технологии MapReduce проявляются при использовании кластеров с тысячами узлов. Из этого делался вывод, что в обозримом будущем эти качества параллельным СУБД не то чтобы не требуются, но, во всяком случае, не являются для них настоятельно необходимыми.
- При возрастании числа узлов кластера возрастает вероятность отказов отдельных узлов, а массивно-параллельные СУБД проектировались в расчете на редкие отказы.
- Современные параллельные СУБД расчитаны на однородную аппаратную среду (все узлы кластера обладают одной и той же производительностью), а при значительном масштабировании полной однородности среды добиться почти невозможно.
- До последнего времени имелось очень небольшое число систем аналитических баз данных, для достижения требуемой производительности которых требовались кластеры с более чем несколькими десятками узлов. Поэтому существующие параллельные СУБД просто не тестировались в более масштабной среде, и при их дальнейшем масштабировании могут встретиться непредвиденные технические проблемы.
Однако объективно при обработке структурированных данных MapReduce не может конкурировать с параллельными СУБД по производительности, что объясняется отсутствием схемы у обрабатывемых данных, индексов, оптимизации запросов и т.д. В результате при выполнении многих типичных аналитических запросов MapReduce показывает производительность, более чем на порядок уступающую производительности параллельных СУБД [27, 31].
В проекте HadoopDB [48] специалисты из университетов Yale и Brown предпринимают попытку создать гибридную систему управления данными, сочетающую преимущества технологий и MapReduce, и параллельных СУБД. В их подходе MapReduce обеспечивает коммуникационную инфраструктуру, объединяющую произвольное число узлов, в которых выполняются экземпляры традиционной СУБД. Запросы формулируются на языке SQL, транслируются в среду MapReduce, и значительная часть работы передается в экземпляры СУБД. Наличие MapReduce обеспечивается масштабируемость и отказоустойчивость, а использование в узлах кластера СУБД позволяет добиться высокой производительности.
4.1. Общая организация HadoopDB
Архитектура HadoopDB показана на рис. 4, позаимствованном из [49]. Основой системы является реализация MapReduce, выполненная в проекте Hadoop [33]. К ней добавлены компоненты компиляции поступающих в систему SQL-запросов, загрузки и каталогизирования данных, связи с СУБД и самих СУБД. При реализации всех компонентов системы максимально использовались пригодные для этого программные средства с открытыми исходными текстами.
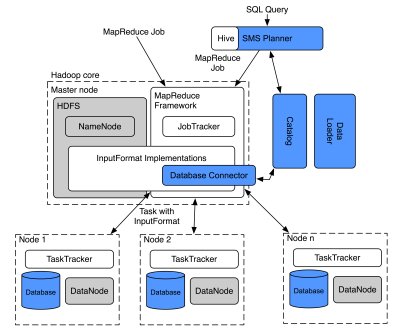
Рис. 4. Архитектура HadoopDB
4.1.1. Немного про Hadoop MapReduce
Как отмечалось в раз. 2, реализация Hadoop MapReduce основана на спецификациях Google, содержащихся в [24]. Однако в этом проекте используется собственная терминология, и для простоты описания особенностей HadoopDB в этом пункте кратко описывается организация Hadoop MapReduce в терминах Hadoop.
Hadoop MapReduce опирается на распределенную файловую систему HDFS (Hadoop Distributed File System) [36]. Файлы HDFS имеют блочную структуру, и блоки одного файла распределяются по узлам данных (DataNode). Файловая система работает под централизованным управлением выделенного узла имен (NameNode), в котором поддерживаются метаданные о файлах (в том числе, об их размерах, о размещении блоков и их реплик и т.д.).
В самой среде Hadoop MapReduce в соответствии с [24] поддерживаются один узел-распорядитель (в Hadoop он называется JobTracker) и много узлов-исполнителей (здесь TaskTracker). В узле JobTracker планируется выполнение MR-заданий, а также отслеживаются данные о загрузке узлов TaskTracker и доступных ресурсах. Каждое задание разбивается на задачи Map и Reduce, которые назначаются узлом JobTracker узлам TaskTracker с учетом требований локальности данных и балансировки нагрузки.
Требование локальности удовлетворяется за счет того, что JobTracker пытается назначать каждую задачу Map тому узлу TaskTracker, для которого данные, обрабатываемые этой задачей, являются локальными. Балансировка нагрузки достигается путем назначения задач всем доступным узлам TaskTracker. Узлы TaskTracker периодически посылают в узел JobTracker контрольные сообщения с информацией о своем состоянии.
Для обеспечения доступа к входным данным MR-задания поддерживается библиотека InputFormat. В Hadoop MapReduce имеется несколько реализаций этой библиотеки, одна из которых позволяет всем задачам одного MR-задания обращаться к JDBC-совместимой базе данных.
4.1.2. Собственные компоненты HadoopDB
Как показывает рис. 4, в архитектуре HadoopDB присутствует ряд компонентов, расширяющих среду Hadoop MapReduce.
Коннектор баз данных (Database Connector)
Коннектор баз данных обеспечивает интерфейс между TaskTracker и независимыми СУБД, располагаемыми в узлах кластера. Этот компонент расширяет класс InputFormat и является частью соответствующей библиотеки. От каждого MR-задания в коннектор поступает SQL-запрос, а также параметры поключения к системе баз данных (указание драйвера JDBC, размер структуры выборки данных и т.д.).
Теоретически коннектор обеспечивает подключение к любой JDBC-совместимой СУБД. Однако в других компонентах HadoopDB приходится учитывать специфику конкретных СУБД, поскольку для них требуется по-разному оптимизировать запросы. В экспериментах, описываемых в [30], использовалась реализация коннектора для PostgreSQL, а в [49] уже упоминается некоторая поколоночная система. В любом случае, для среды HadoopDB эта реализация обеспечивает естественное и прозрачное использование баз данных в качестве источника входных данных.
В каталоге поддерживаются метаданные двух сортов: параметры подключения к базе данных (ее месторасположение, класс JDBC-драйвера, учетные данные) и описание наборов данных, содержащихся в кластере, расположение реплик и т.д. Каталог сохраняется в формате XML в HDFS. К нему обращаются JobTracker и TaskTracker для выборки данных, требуемых для планирования задач и обработки данных.
Загрузчик данных (Data Loader)
- глобальное разделение данных по заданному ключу при их загрузке из HDFS;
- разбиение данных, хранимых в одном узле, на несколько более мелких разделов (чанков, chunk);
- массовая загрузка данных в базу данных каждого узла с использованием чанков.
В GlobalHasher и LocalHasher используются разные хэш-функции, обеспечивающие примерно одинаковые размеры всех чанков. Эти хэш-функции отличаются от хэш-функции, используемой в Hadoop MapReduce для разделения данных по умолчанию. Это способствует улучшению балансировки нагрузки.
Планирование SQL-запросов
Внешний интерфейс HadoopDB позволяет выполнять SQL-запросы. Компиляцию и подготовку планов выполнения SQL-запросов производит планировщик SMS (SMS Planner на рис. 4), являющийся расширением планировщика Hive [50].
Планировщик Hive преобразует запросы, представленные на языке HiveQL (вариант SQL) в задания MapReduce, которые выполняются над таблицами, хранимыми в виде файлов HDFS. Эти задания представляются в виде ориентированных ациклических графов (directed acyclic graph, DAG) реляционных операций фильтрации (ограничения), выборки (проекции), соединения, агрегации, каждая из которых выполняется в конвейере: после обработки каждого очередного кортежа результат каждой операции направляется на вход следующей операции.
Операции соединения, как правило, выполняются в задаче Reduce MR-задания, соответствующего SQL-запросу. Это связано с тем, что каждая обрабатываемая таблица сохраняется в отдельном файле HDFS, и невозможно предполагать совместного размещения соединяемых разделов таблиц в одном узле кластера. Для HadoopDB это не всегда так, поскольку соединяемые таблицы могут разделяться по атрибуту соединения, и тогда операцию соединения можно вытолкнуть на уровень СУБД.
Для пояснения того, как работает планировщик Hive, и каким образом его функциональность расширяется в SMS, невозможно обойтись без примера, и для простоты воспользуемся примером из [30]. Пусть задан следующий простой запрос с агрегацией, смысл которого состоит в получении ежегодных суммарных доходов от продаж товаров:
SELECT YEAR(saleDate), SUM(revenue) FROM sales GROUP BY YEAR(saleDate);
- Производится синтаксический разбор запроса, и образуется его абстрактное синтаксическое дерево.
- Далее работает семантический анализатор, который выбирает из внутреннего каталога Hive MetaStore информацию о схеме таблицы sales , а также инициализирует структуры данных, требуемые для сканирования этой таблицы и выборки нужных полей.
- Затем генератор логических планов запросов производит план запроса – DAG реляционных операций.
- Вслед за этим оптимизатор перестраивает этот план запроса, проталкивая, например, операции фильтрации ближе к операциям сканирования таблиц. Основной функцией оптимизатора является разбиение плана на фазы Map и Reduce. В частности, перед операциями соединения и группировки добавляется операция переразделения данных (Reduce Sink). Эти операции отделяют фазу Map от фазы Reduce. Оценочная (cost-based) оптимизация не используется, и поэтому получаемые планы не всегда эффективны.
- Генератор физических планов выполнения запросов преобразует логический план в физический, допускающий выполнение в виде одного или нескольких MR-заданий. Первая (и каждая аналогичная) операция Reduce Sink помечает переход от фазы Map к фазе Reduce некоторого задания MapReduce, а остальные операции Reduce Sink помечают начало следующего задания MapReduce. Физический план выполнения приведенного выше запроса, сгенерированный планировщиком Hive, показан на рис. 5.
- Полученный DAG сериализуется в формате XML. Задания инициируются драйвером Hive, который руководствуется планом в формате SQL и создает все необходимые объекты, сканирующие данные в таблицах HDFS и покортежно обрабатывающие данные.
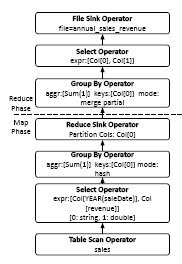
Рис. 5. Задание MapReduce, генерируемое Hive
В планировщике SMS функциональность планировщика Hive расширяется следующим образом. Во-первых, до обработки каждого запроса модифицируется MetaStore, куда помещается информация о таблицах базы данных. Для этого используется каталог HadoopDB (см. выше).
Далее, после генерации физического плана запроса и до выполнения MR-заданий выполняются два прохода по физическому плану. На первом проходе устанавливается, какие столбцы таблиц действительно обрабатываются запросом, и определяются ключи разделения, используемые в операциях Reduce Sink.
На втором проходе DAG запроса обходится снизу-вверх от операций сканирования таблиц до формирования результата или первой операции Reduce Sink. Все операции этой части DAG преобразуются в один или несколько SQL-запросов, которые проталкиваются на уровень СУБД. Для повторного создания кода SQL используется специальный основанный на правилах генератор.
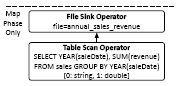
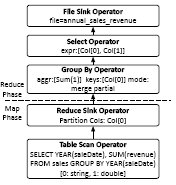
Рис. 6. Варианты MR-заданий, генерируемые SMS
На рис. 6 показаны два плана, которые производит SQL для приведенного выше запроса. План в левой части рисунка производится в том случае, если таблица sales является разделенной по YEAR(saleDate) . В этом случае вся логика выполнения запроса выталкивается в СУБД. Задача Map всего лишь записывает результаты запроса в файл HDFS.
В противном случае генерируется план, показанный в правой части рис. 6. При выполнении запроса по этому плану на уровне базы данных производится частичная агрегация данных, а для окончательной агрегации требуется выполнение задачи Reduce, производящей слияние частичных результатов группировки, которые получены в каждом узле на фазе задачи Map.
4.2. Производительность, масштабируемость и устойчивость к отказам и падению производительности узлов кластера
В [30] описан ряд экспериментов, показывающих, что гибридное использование технологий MapReduce и баз данных в реализации HadoopDB позволяет добиться от этой системы производительности, соизмеримой с производительностью параллельных СУБД, и устойчивости к отказам и падению производительности узлов, свойственной MapReduce. Я не буду в этой статье описывать детали этих экспериментов, а лишь кратко отмечу их основные результаты.
4.2.1. Производительность и маштабируемость
В большинстве экспериментов параллельные СУБД существенно превосходят HadoopDB по производительности, а HadoopDB оказывается значительно (иногда на порядок) производительнее связки Hive и Hadoop MapReduce. В экспериментах использовались поколоночная параллельная СУБД Vertica и некоторая коммерческая параллельная СУБД-X с хранением таблиц по строкам. Наибольшую производительность, естественно, демонстрировала Vertica, но в ряде случаев HadoopDB уступала ей значительно меньше, чем на десятичный порядок.
В [30] значительное отставание HadoopDB от параллельных СУБД объясняется тем, что в качестве базовой СУБД в HadoopDB использовалась PostgreSQL, в которой отсутствует возможность хранения таблиц по столбцам (как уже отмечалось, в [49] в HadoopDB уже используется поколоночная СУБД). Кроме того, в экспериментах с HadoopDB не использовалось сжатие данных. Наконец, в HadoopDB возникали значительные накладные расходы на взаимодействие Hadoop MapReduce и PostgreSQL, которые потенциально можно снизить. Так что в целом производительность HadoopDB не должна критически отставать от производительности параллельных СУБД.
Время загрузки данных в HadoopDB в десять раз больше соответствующего времени для Hadoop MapReduce. Однако это окупается десятикратным выигрышем в производительности при выполнении некоторых запросов.
Как и следовало ожидать, при возрастании числа узлов в кластере при одновременном увеличении объема данных HadoopDB (как и Hadoop) масштабируется почти линейно. Но следует заметить, что в этом диапазоне не хуже масштабируется и Vertica (с СУБД-X дела обстоят несколько хуже), а эксперименты на кластерах большего размера не производились. Так что объективных данных в этом отношении пока нет.
4.2.2. Устойчивость к отказам и неоднородности среды
В экспериментах с отказоустойчивостью и падением производительности некоторого узла сравнивались HadoopDB, Hadoop MapReduce c Hive и Vertica. В первом случае работа одного из узлов кластера искусственным образом прекращалась после выполнения 50% обработки запроса. Во втором случае работа одного узла замедлялась за счет выполнения фонового задания с большим объемом ввода-вывода с тем же диском, на котором сохранялись файлы соответствующей системы.
При продолжении работы после отказа узла СУБД Vertica приходилось выполнять запрос заново с использованием реплик данных, и время выполнения запроса возрастало почти вдвое. В HadoopDB и Hadoop MapReduce c Hive время выполнения увеличивалось примерно на 15-20% за счет того, что задачи, выполнявшиеся на отказавшем узле, перераспределялись между оставшимися узлами. При этом относительная производительность HadoopDB оказывается несколько выше, чем у Hadoop MapReduce c Hive, поскольку в первом случае обработка запроса проталкивалась на узлы, содержащие реплики баз данных, а во втором приходилось копировать данные, не являющиеся локальными для обрабатывающего узла.
При замедлении работы одного из узлов производительность Vertica определялась скоростью этого узла, и в экспериментах время выполнения запроса увеличивалось на 170%. При использовании HadoopDB и Hadoop MapReduce c Hive время выполнения запроса увеличивалось всего на 30% за счет образования резервных избыточных задач в недозагруженных узлах.
Проект HadoopDB представляется мне очень интересным и перспективным. В отличие от других систем, рассматриваемых в этой статье, HadoopDB – это проект с открытыми исходными текстами, так что потенциально участие в этой работе доступно для всех желающих. Помимо прочего, продукт HadoopDB открывает путь к созданию высокопроизводительных, масштабируемых и отказоустойчивых параллельных СУБД на основе имеющихся программных средств с открытыми кодами.
5. Использование MapReduce для подготовки данных параллельных СУБД
Я не могу считать себя специалистом в области различных средств ETL (Extract-Transform-Load), которых существует множество, и которые применяются во многих компаниях, использующих хранилища данных (я не буду даже пытаться как-то их классифицировать и/или сравнивать). Но, в любом случае, важность этих средств трудно переоценить, поскольку в хранилище данных по определению поступают данные из самых разнообразных источников: транзакционных баз данных, сообщений, участвующих в организации бизнес-процессов, электронной почты, журналов Web-серверов и т.д. Все эти данные нужно очистить, привести к единому формату, согласовать и загрузить в хранилище данных для последующего анализа.
Наверное, можно согласиться с идеологами MAD-аналитики из Greenplum (см. п. 3.1.1), что при использовании ортодоксального подхода к организации хранилищ данных подключение нового источника к хранилищу данных может занять недопустимо много времени во многом как раз из-за потребности в создании соответствующей процедуры ETL. Наверное, можно согласиться и с тем, что для аналитиков гораздо важнее получить новые данные, чем быть вынужденными ждать неопределенное время их в согласованной форме. Но совершенно очевидно, что если данные в хранилище данных не очищать никогда, то со временем в них не разберется никакой, даже самый передовой аналитик.
Итак, что мы имеем. Число источников данных, пригодных для анализа в составе хранилища данных, все время растет. Их разнородность тоже все время возрастает. Все меньший процент составляют структурированные базы данных, данные поступают из частично структурированных файлов и совсем неструктурированных текстовых документов. Для каждой разновидности источников данных нужна своя разновидность процедуры ETL, и по причине роста объемов исходных данных для обеспечения умеренного времени их загрузки в хранилище данных эти процедуры должны выполняться в массивно-параллельной среде. И в этом может помочь технология MapReduce.
5.1. MapReduce и ETL
- чтение журнальных данных из нескольких разных файлов-журналов;
- разбор и очистка журнальных данных;
- преобразования этих данных, в том числе их частичная агрегация;
- принятие решения о схеме результирующих данных;
- загрузка данных в хранилище данных или другую систему хранения.
Имелись попытки реализации процедур ETL внутри сервера баз данных средствами языка SQL. Разработчики параллельных СУБД с поддержкой MapReduce Greenplum Database и nCluster компании Aster Data тоже намекают, что их встроенный MapReduce можно использовать и для поддержки ETL. Но исторически системы ETL промышленного уровня существуют отдельно от СУБД. Обычно СУБД не пытаются выполнять ETL, а системы ETL не поддерживают функции СУБД.
5.2. Hadoop и Vertica
Эти рассуждения наводят на мысль, что если иметь в виду поддержку именно ETL, то наиболее грамотное (и самое простое) решение по интеграции технологий MapReduce и параллельных баз данных применяется в Vertica (см. рис. 7, позаимстованный из [51]).
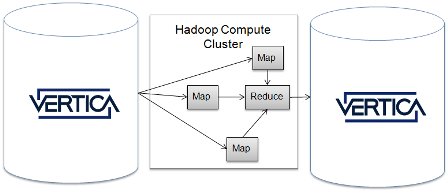
Рис. 7. MapReduce
В Vertica реализован свой вариант интерфейса DBInputFormat компании Cloudera [51] для Hadoop MapReduce, позволяющий разработчикам MapReduce выбирать данные из баз данных Vertica и направлять результирующие данные в эти базы данных. При этом подходе технологии MapReduce и параллельных баз данных тесно не интегрируются, но каждая из них может использовать возможности другой технологии.
Скорее всего, мы еще многое услышим о системах ETL, основанных на использовании технологии MapReduce, и, скорее всего, предводителем этого направления будет Vertica.
6. Заключение
Еще пару лет назад было непонятно, каким образом можно с пользой применять возникающие «облачные» среды для высокоуровневого управления данными. Многие люди считали, что в «облаках» системы управления базами данных будут просто вытеснены технологий MapReduce. Это вызывало естественное недовольство сообщества баз данных, авторитетные представители которого старались доказать, что пытаться заменить СУБД какой-либо реализацией MapReduce если не безнравственно, то, по крайней мере, неэффективно.
Однако вскоре стало понятно, что технология MapReduce может быть полезна для самих параллельных СУБД. Во многом становлению и реализации этой идеи способствовали компании-стартапы, выводящие на рынок новые аналитические массивно-параллельные СУБД и добивающиеся конкурентных преимуществ. Свою лепту вносили и продолжают вносить и университетские исследовательские коллективы, находящиеся в тесном сотрудничестве с этими начинающими компаниями.
На сегодняшний день уже понятно, что технология MapReduce может эффективно применяться внутри параллельной аналитической СУБД, служить инфраструктурой отказоустойчивой параллельной СУБД, а также сохранять свою автономность в симбиотическом союзе с параллельной СУБД. Все это не только мешает развитию технологии параллельных СУБД, а наоборот, способствует ее совершенствованию и распространению.
Интересные работы ведутся и в направлении использования «облачных» сред для создания нового поколения транзакционных средств управления данными. Но это уже, как говорили братья Стругацкие, совсем другая история.