
Как посмотреть таблицу в sql server
В дополнение к табличным переменным можно определять временные таблицы. Такие таблицы могут быть полезны для хранения табличных данных внутри сложного комплексного скрипта.
Временные таблицы существуют на протяжении сессии базы данных. Если такая таблица создается в редакторе запросов (Query Editor) в SQL Server Management Studio, то таблица будет существовать пока открыт редактор запросов. Таким образом, к временной таблице можно обращаться из разных скриптов внутри редактора запросов.
После создания все временные таблицы сохраняются в таблице tempdb , которая имеется по умолчанию в MS SQL Server.
Если необходимо удалить таблицу до завершения сессии базы данных, то для этой таблицы следует выполнить команду DROP TABLE .
Название временной таблицы начинается со знака решетки #. Если используется один знак #, то создается локальная таблица, которая доступна в течение текущей сессии. Ели используются два знака ##, то создается глобальная временная таблица. В отличие от локальной глобальная временная таблица доступна всем открытым сессиям базы данных.
Например, создадим локальную временную таблицу:
CREATE TABLE #ProductSummary (ProdId INT IDENTITY, ProdName NVARCHAR(20), Price MONEY) INSERT INTO #ProductSummary VALUES ('Nokia 8', 18000), ('iPhone 8', 56000) SELECT * FROM #ProductSummary
И с этой таблицей можно работать в большей степени как и с обычной таблицей — получать данные, добавлять, изменять и удалять их. Только после закрытия редактора запросов эта таблица перестанет существовать.
Подобные таблицы удобны для каких-то временных промежуточных данных. Например, пусть у нас есть три таблицы:
CREATE TABLE Products ( Id INT IDENTITY PRIMARY KEY, ProductName NVARCHAR(30) NOT NULL, Manufacturer NVARCHAR(20) NOT NULL, ProductCount INT DEFAULT 0, Price MONEY NOT NULL ); CREATE TABLE Customers ( Id INT IDENTITY PRIMARY KEY, FirstName NVARCHAR(30) NOT NULL ); CREATE TABLE Orders ( Id INT IDENTITY PRIMARY KEY, ProductId INT NOT NULL REFERENCES Products(Id) ON DELETE CASCADE, CustomerId INT NOT NULL REFERENCES Customers(Id) ON DELETE CASCADE, CreatedAt DATE NOT NULL, ProductCount INT DEFAULT 1, Price MONEY NOT NULL );
Выведем во временную таблицу промежуточные данные из таблицы Orders:
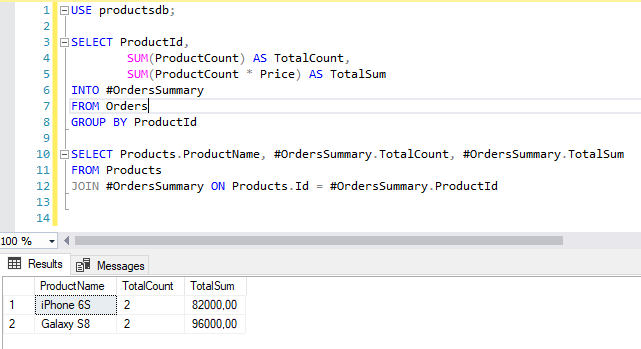
SELECT ProductId, SUM(ProductCount) AS TotalCount, SUM(ProductCount * Price) AS TotalSum INTO #OrdersSummary FROM Orders GROUP BY ProductId SELECT Products.ProductName, #OrdersSummary.TotalCount, #OrdersSummary.TotalSum FROM Products JOIN #OrdersSummary ON Products.Id = #OrdersSummary.ProductId
Здесь вначале извлекаются данные во временную таблицу #OrdersSummary. Причем так как данные в нее извлекаются с помощью выражения SELECT INTO, то предварительно таблицу не надо создавать. И эта таблица будет содержать id товара, общее количество проданного товара и на какую сумму был продан товар.
Затем эта таблица может использоваться в выражениях INNER JOIN.
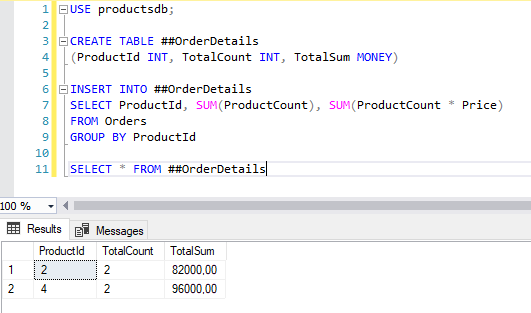
Подобным образом определяются глобальные временные таблицы, единственное, что их имя начинается с двух знаков ##:
CREATE TABLE ##OrderDetails (ProductId INT, TotalCount INT, TotalSum MONEY) INSERT INTO ##OrderDetails SELECT ProductId, SUM(ProductCount), SUM(ProductCount * Price) FROM Orders GROUP BY ProductId SELECT * FROM ##OrderDetails
Обобщенные табличные выражения
Кроме временных таблиц MS SQL Server позволяет создавать обобщенные табличные выражения (common table expression или CTE), которые являются производными от обычного запроса и в плане производительности являются более эффективным решением, чем временные. Обобщенное табличное выражение задается с помощью ключевого слова WITH :
WITH OrdersInfo AS ( SELECT ProductId, SUM(ProductCount) AS TotalCount, SUM(ProductCount * Price) AS TotalSum FROM Orders GROUP BY ProductId ) SELECT * FROM OrdersInfo -- здесь нормально SELECT * FROM OrdersInfo -- здесь ошибка SELECT * FROM OrdersInfo -- здесь ошибка
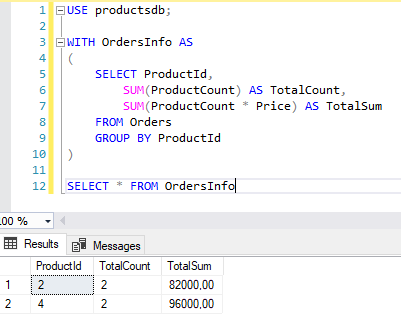
В отличие от временных таблиц табличные выполнения хранятся в оперативной памяти и существуют только во время первого выполнения запроса, который представляет это табличное выражение.
Как проверить существование временной таблицы

SQL Server умеет работать c временными таблицами. Названия у таких таблиц начинаются с одной или с двух решёток (#). Временные таблицы, очевидно, придуманы для того, чтобы хранить в них данные временно. Например, для сохранения промежуточных результатов каких-либо вычислений. Или для передачи каких-то данных от одного процесса другому.
Иногда требуется проверить, была ли уже создана определённая временная таблица или нет. Как это правильно сделать?
Если речь идёт о глобальной временной таблице, то проверить её наличие можно традиционным способом — заглянув в список таблиц. Только не забудьте сделать поправку на то, что все временные таблицы — и глобальные и локальные — создаются не в текущей пользовательской базе данных, а в системной базе TempDB.
Посмотрите на пример. Один процесс создал глобальную временную таблицу. Теперь этот и все другие процессы могут обращаться к ней, как к обыкновенной таблице. В том числе, они увидят её в системных каталогах sys.Tables и Information_Schema.Tables.

Годится. Однако, такой механизм проверки не сработает, если речь идёт о локальных временных таблицах. Ведь такие таблицы создаются индивидуально для каждого сеанса, и в разных сеансах могут оказаться таблицы с одинаковыми названиями. Чтобы не было конфликта имён, сервер переименовывает локальные таблицы, создавая их в TempDB.
Вот я создаю в двух сеансах локальные временные таблицы с одинаковыми названиями. В каждом сеансе сервер отличает свою таблицу от чужих, но в системных каталогах они видны все сразу:

Если посмотреть внимательнее, то можно заметить, что к названиям таблиц сервер дописывает уникальное окончание, по которому он и определяет чья это таблица:

Возиться с этими окончаниями в SQL-коде не хотелось бы. И не нужно. Потому что у нас есть функция Object_ID, которая автоматически выбирает нужную таблицу:

Если объект с заданным названиям существует, то функция Object_ID вернёт его идентификатор, а если нет — NULL. Таким образом мы сможем удобно и надёжно проверить наличие даже такого необычного объекта, как локальная временная таблица:

У этой функции есть необязательный второй параметр, который можно использовать для указания конкретного типа объекта. «U» означает, что мы ищем именно таблицу.
Подробнее об этом Вы сможете узнать на курсах SQL Server
Заказ добавлен в Корзину.
Для завершения оформления, пожалуйста, перейдите в Корзину!
Типы данных SQL Server, поддерживаемые в ArcGIS
ArcGIS работает с определенными типами данных. При осуществлении доступа к таблице базы данных через Подключения к базам данных , слой запроса или веб-сервис, ArcGIS отфильтровывает любые неподдерживаемые типы данных. ArcGIS не отображает неподдерживаемые типы данных, и вы не сможете редактировать их в ArcGIS. Аналогично, если при помощи ArcGIS копировать и вставлять таблицы, содержащие неподдерживаемые типы данных, из одной базы в другую, ArcGIS вставит только те столбцы, которые используют поддерживаемые типы данных.
В первом столбце в следующей таблице перечислены типы данных ArcGIS. Во втором столбце перечислены типы данных SQL Server , создаваемые ArcGIS. В третьем столбце показано, какие другие типы данных SQL Server (если они имеются) сопоставляются типам данных ArcGIS при просмотре таблицы, созданной вне ArcGIS (не зарегистрированной в базе геоданных). В последнем столбце при необходимости предоставляется дополнительная информация.
binary, image, timestamp, varbinary(n)
date, datetime2(n), datetime, smalldatetime, time
decimal, float, money, smallmoney
Точность и количество знаков, указанные в ArcGIS, могут повлиять на тип полученных данных, создаваемых в базе данных. Более подробно см. Типы данных полей ArcGIS.
Точность и количество знаков, указанные в ArcGIS, могут повлиять на тип полученных данных, создаваемых в базе данных. Более подробно см. Типы данных полей ArcGIS.
Укажите, что будет использоваться: GEOMETRY или GEOGRAPHY, – при создании класса пространственных объектов.
- CircularString
- CompoundCurve
- CurvePolygon
- GeometryCollection
Вы не можете создавать в ArcGIS Pro классы объектов, которые используют сжатый двоичный тип хранения геометрии, но вы можете просматривать такие классы в ArcGIS Pro . Сжатые двоичные данные хранятся в базе данных как тип данных INT.
Поддерживается только базами геоданных.
Растры поддерживаются только базами геоданных.
В многопользовательских базах геоданных тип создаваемых данных SQL Server зависит от ключевого слова конфигурации, использующегося при создании набора растровых данных или набора данных мозаики. Если параметр RASTER_STORAGE ключевого слова равен RASTERBLOB, создается столбец BLOB, а если он равен BINARY – создается столбец int.
int(4) when created in an enterprise geodatabase
integer with identity property when created in a database
В ArcGIS тип ObjectID соответствует столбцу с идентификаторами записей (ID) таблицы (или класса объектов). В таблице может быть только один такой тип.
varchar, nvarchar, varchar(max), nvarchar(max)
Текстовые типы данных
Если вы создаете поле varchar или varchar(max) в базе данных SQL Server , то оно будет сопоставлено с типом данных ArcGIS TEXT при просмотре в ArcGIS. Если вы создаете текстовое поле в базе данных SQL Server из ArcGIS, используется nvarchar или nvarchar(max).
В случае если параметр конфигурации UNICODE_STRING в многопользовательской базе геоданных равен FALSE, а длина текстового поля – 7999 символов и менее, используется VARCHAR.
Если параметр конфигурации UNICODE_STRING имеет значение FALSE, а длина текстового поля больше или равна 8000 символов, используется VARCHAR(MAX).
Если параметр конфигурации UNICODE_STRING имеет значение TRUE, а длина текстового поля меньше или равна 3 999 знаков, используется NVARCHAR.
Если параметр конфигурации UNICODE_STRING имеет значение TRUE, а длина текстового поля больше или равна 4 000 символов, используется NVARCHAR(MAX).
Геометрические типы данных
Как показано в таблице, ArcGIS Pro создает и может работать с двумя типами данных геометрии в SQL Server : SQL Server Geometry и SQL Server Geography.
SQL Server Geometry
Здесь представлено краткое описание типа Microsoft Geometry. Более подробные сведения о типе Geometry и его использовании можно найти в документации к Microsoft SQL Server .
- Тип Microsoft Geometry поддерживает любую систему координат X/Y.
- Для отображения и пространственных сравнений используются вычисления на плоскости (Евклидовы) и прямолинейная интерполяция между вершинами.
- Соответствует спецификации Open Geospatial Consortium (OGC) Simple Features for SQL версии 1.1.9 и совместимо с ISO-стандартом SQL MM.
SQL Server Geography
Здесь представлено краткое описание типа Microsoft Geography. Более подробные сведения о типе Geography и его использовании можно найти в документации к Microsoft SQL Server .
- Тип Geography поддерживает многие стандартные географические системы координат, например, широта-долгота GPS. Microsoft требует использования SRID и географических систем координат, заданных в словаре данных SQL Server .
- Для вычислений и пространственных сравнений используются модель эллипсоида (круглая Земля) и интерполяция отрезков линий между вершинами Great Elliptic.
- Тип Geography использует глобальный (на сфере) экстент слоя. Координаты данных не могут выходить за пределы глобального экстента.
Типы растровых данных
Тип растровых данных, используемый в базах геоданных в SQL Server , — это тип BLOB (rasterblob).
В этом разделе
- Текстовые типы данных
- Геометрические типы данных
- Типы растровых данных
Как посмотреть, какие данные заблокированы в СУБД MS SQL Server
Иногда требуется посмотреть, какие объекты и данные заблокированы и какие блокировки на этих объектах стоят (речь идет только о транзакционных блокировках). В SQL Server для этих целей существует динамическое представление sys.dm_tran_locks. Оно возвращает сведения об активных в данный момент в SQL Server ресурсах диспетчера блокировок.
Статья актуальна для MS SQL Server 2012.
Смотрим блокировки
Иногда требуется посмотреть, какие объекты и данные заблокированы и какие блокировки на этих объектах стоят (речь идет только о транзакционных блокировках). В SQL Server для этих целей существует динамическое представление sys.dm_tran_locks. Оно возвращает сведения об активных в данный момент в SQL Server ресурсах диспетчера блокировок. Следующий запрос
SELECT * FROM sys.dm_tran_locks
выведет таблицу: Нас интересуют следующие столбцы:
- resource_type — тип ресурса. Значение может быть одним из следующих: DATABASE, FILE, OBJECT, PAGE, KEY, EXTENT, RID, APPLICATION, METADATA, HOBT или ALLOCATION_UNIT. Основные из них это — DATABASE — сама база данных; OBJECT — таблица или любой другой объект; PAGE — страница файла БД; KEY — указатель на ключ индекса; EXTENT — экстент файла БД; RID — физическая строка в куче.
- resource_database_id — идентификатор базы данных.
- resource_description — описание ресурса. Для ресурса типа PAGE в этом поле хранится адрес страницы в формате : ; для KEY будет указан хэш ключевых столбцов; для RID адрес строки вида :: .
- resource_associated_entity_id — идентификатор сущности, с которой связан ресурс. Для OBJECT — это ИД объекта; для KEY, PAGE и RID — идентификатор HoBt.
- request_mode — тип блокировки. Как раз в этой колонке указано, какая блокировка наложена на ресурс — S, U, X и пр.
Смотрим какие объекты заблокированы
Представление sys.dm_tran_locks выдает результат в неудобном для чтения виде. Одни идентификаторы и ничего более. Чтобы получить более наглядное отображение, необходимо воспользоваться еще несколькими инструментами SQL Server.
Название базы данных из ее идентификатора можно получить через функцию DB_NAME(database_id). Для обратного преобразования — DB_ID(‘database_name’). Для объектов существуют аналогичные функции OBJECT_NAME(object_id) и OBJECT_ID( ‘database_name.object_name’).
Чтобы посмотреть, какие данные хранятся на странице, достаточно ИД файла и ИД страницы. При чтении будет указан и объект, к которому эта страница относится, и сами данные. Но для индексов необходимо узнать еще имя самого индекса, чтобы можно было выполнить запрос.
Узнать, к какому объекту относится элемент блокировки, у которого указан только HoBt, можно по представлению sys.partitions. Оно содержит нужные нам колонки:
- object_id — идентификатор объекта, к которому относится сущность.
- index_id — идентификатор индекса объекта. Нужен для получения названия индекса для типа ресурса KEY. 0 — означает кучу, 1 — кластерный индекс, все остальные значения относятся к некластерным индексам.
- hobt_id — идентификатор сущности.
По index_id и object_id уже можно узнать имя индекса, по ключу которого установлена блокировка. Для этого воспользуемся еще одним представлением — sys.indexes. От него нам нужны следующие колонки:
- object_id — идентификатор объекта, к которому относится индекс.
- index_id — идентификатор индекса. Его мы знаем из таблицы sys.partitions.
- name — имя индекса. Если тип индекса 0 (куча), то имя будет Null.
Итоговый запрос, который покажет заблокированные объекты, может выглядеть следующим образом:
SELECT CASE locks.resource_type WHEN N'OBJECT' THEN OBJECT_NAME(locks.resource_associated_entity_id) WHEN N'KEY'THEN (SELECT OBJECT_NAME(object_id) FROM sys.partitions WHERE hobt_id = locks.resource_associated_entity_id) WHEN N'PAGE' THEN (SELECT OBJECT_NAME(object_id) FROM sys.partitions WHERE hobt_id = locks.resource_associated_entity_id) WHEN N'HOBT' THEN (SELECT OBJECT_NAME(object_id) FROM sys.partitions WHERE hobt_id = locks.resource_associated_entity_id) WHEN N'RID' THEN (SELECT OBJECT_NAME(object_id) FROM sys.partitions WHERE hobt_id = locks.resource_associated_entity_id) ELSE N'Unknown' END AS objectName, CASE locks.resource_type WHEN N'KEY' THEN (SELECT indexes.name FROM sys.partitions JOIN sys.indexes ON partitions.object_id = indexes.object_id AND partitions.index_id = indexes.index_id WHERE partitions.hobt_id = locks.resource_associated_entity_id) ELSE N'Unknown' END AS IndexName, locks.resource_type, DB_NAME(locks.resource_database_id) AS database_name, locks.resource_description, locks.resource_associated_entity_id, locks.request_mode FROM sys.dm_tran_locks AS locks WHERE locks.resource_database_id = DB_ID(N'database_name')
Смотрим, какие данные заблокированы. Тип ресурса KEY, RID
Для типа ресурса KEY в поле resource_description в представлении sys.dm_tran_locks хранится хэш ключевых столбцов индекса. Для каждой записи индекса SQL Server вычисляет хэш. Он не повторяется, даже если все значения в колонках одинаковы, т.к. для каждой строки добавляется уникальный идентификатор, который участвует в формировании хэша. Посмотреть хэши строк таблицы (если есть кластерный индекс) или записей индекса можно с помощью виртуальной колонки %%lockres%%. Если кластерного индекса нет, то вместо хэша выведется адрес строки вида :: (который нам нужен для типа ресурса RID). Выводится в запросе как и обычная колонка:
SELECT %%lockres%% AS lockres, * FROM dbo.table_name (NOLOCK)Результат вывода для таблицы без кластерного индекса:

Для таблицы с кластерным индексом:

Чтобы посмотреть хэши по записям индекса, необходимо выполнить запрос:
SELECT %%lockres%% AS lockres, * FROM dbo.table_name WITH (INDEX (index_name) NOLOCK)Теперь, чтобы получить ключ индекса, достаточно выполнить запрос с условием по виртуальной колонке.
Например, для типа ресурса KEY:
SELECT %%lockres%% AS lockres, * FROM dbo._AccumRg7528 WITH (INDEX (_AccumR7528_ByProperty7546_RTRN) NOLOCK) WHERE %%lockres%% = '(143f95858242)'SELECT %%lockres%% AS lockres, * FROM dbo._InfoRg6407 (NOLOCK) WHERE %%lockres%% = '1:115919:16'Смотрим, какие данные заблокированы. Тип ресурса PAGE
Чтобы посмотреть, что хранится в странице файла базы данных, воспользуемся функцией DBCC PAGE (). Принимает параметры: DBCC PAGE(db_name|db_id, file_id, page_id, print_option). Последним параметром указывается формат вывода из следующих доступных значений:
- 0 — только заголовок;
- 1 — заголовок, дампы и индекс слотов;
- 2 — заголовок и полный дамп;
- 3 — заголовок и максимальная детализация для каждого слота.
Нам интересен формат вывода 3. Перед использованием функции необходимо включить флаг трассировки: DBCC TRACEON(3604), иначе вместо результата увидите только надпись, что команда выполнилась, и ничего более.
Если выполнить команду:
DBCC PAGE('database_name', 1, 423, 3)то мы скорее всего увидим результат в виде текста:

Это не очень удобно, поэтому команду DBCC PAGE удобнее всего выполнять с опцией WITH TABLE RESULT:
DBCC PAGE('database_name', 1, 423, 3) WITH TABLERESULTSТеперь та же информация представлена в виде таблицы:

Каждая страница (в общем виде) состоит из заголовка, раздела с данными и таблицы смещений. В заголовке стоит обратить внимание на поле m_type — тип страницы. 1 — означает страница с данными или кластерный индекс; 2 — страница с записями некластерного индекса; 10 — карта распределения индекса. После заголовка идут данные, распределенные по «слотам» (результат для страницы m_type = 1):

И вот здесь мы уже видим наши данные, которые хранятся в самой таблице. В моем случае это регистр сведений, у которого два измерения с типом Строка (поля _Fld11, _Fld12) и ресурс с типом Число (_Fld13).
Если на странице расположены записи индекса (m_type = 2), то в таблице ключей записи мы не увидим. Они выведутся в другой таблице уже без дополнительной информации (заголовков и пр.):

Получение структуры хранения базы данных
Чтобы получить размещение базы данных по страницам, можно воспользоваться функцией-представлением sys.dm_db_database_page_allocations. Принимает следующие аргументы: sys.dm_db_database_page_allocations(db_id , table_id , index_id , partidion_id , mode_option). В последнем аргументе передается формат вывода: ‘DETAILED’ или ‘LIMITED’.
Использовать в обычном SELECT-запросе:
SELECT OBJECT_NAME(pages.object_id) AS object, * FROM sys.dm_db_database_page_allocations(DB_ID('DBCC_PAGE'), NULL ,NULL,NULL,'DETAILED') AS pages
В колонке allocated_page_file_id будет указан адрес страницы.