
Паттерны CQRS и Event Sourcing
CQRS – Command and Query Responsibility Segregation паттерн
- Command ориентированы на задачи, а не на данные. («Забронировать номер в отеле», а не установить для ReservationStatus значение «зарезервировано» ).
- Command может помещаться в очередь для асинхронной обработки, а не обрабатываться синхронно.
- Query никогда не должен изменять базу данных. Query возвращает DTO, который не инкапсулирует знания предметной области.
Схематически работу клиента по CQRS модели можно отобразить следующим образом:
Наличие отдельных моделей запросов и команд упрощает проектирование таких систем как независимых друг от друга. Однако один из недостатков заключается в том, что код CQRS не может автоматически формироваться из схемы базы данных с помощью ORM или подобных механизмов. Для дополнительной изоляции часто физически разделяют данные для чтения и данные для записи. Как это описано на диаграмме выше. В этом случае в БД для чтения можно оптимизировать ее работу так, чтобы максимально эффективно выполнять запросы. К примеру заюзать materialized view, чтобы не использовать сложные операции join’ов или сложные связи. Вы можете использовать в том числе другой тип хранилища данных. Например, база данных для записи останется реляционной, а для чтения вы можете применять NoSQL или наоборот, в зависимости от бизнес задач.
Если вы пошли по пути отдельных БД для чтения и записи, они должны поддерживать синхронизацию. Обычно это реализуют с помощью событий при каждом обновлении базы данных. Обновление базы данных и публикации события должны выполняться в рамках одной транзакции.
�� Преимущества CQRS
- Независимое масштабирование. CQRS позволяет раздельно масштабировать рабочие нагрузки чтения и записи, снижая риск конфликтов блокировки.
- Оптимизированные схемы данных. Для query применить схему, оптимизированную для запросов, а commands — другую схему, оптимизированную для обновлений.
- Безопасность. Разделение операций позволит настроить более гибкую систему доступа.
- Разделение проблем. Разделение операций позволяет получить более гибкие и простые в обслуживании классы.
- Более простые запросы. Сохраняя в базе данных для чтения materialized view, вы предотвратите использование сложных запросов и join’ов.
- Не требует 2 хранилища данных. Отдельные хранилища для query и command это одна из реализаций, а не обязательное требование
�� Недостатки CQRS
- Сложность. Основная идея CQRS звучит просто. Но ее реализация может привести к усложнению проекта приложения, особенно если реализовывать его в связке с Event Sourcing.
- Обмен сообщениями. Сама по себе модель CQRS не требует месседжинга, но месседж брокеры часто применяются для обработки команд и публикации событий. Это означает, нужно будет реализовывать обработку сбоев и дубликатов при передаче сообщений.
- Eventual consistency. Если вы разделите базы данных для чтения и записи, в базе данных для чтения могут оставаться устаревшие данные. БД для чтения должна быть up to date, чтобы отражать изменения из БД для записи, и может быть трудно трекать, когда пользователь сделал запрос на основе устаревших данных с БД для чтения.
Event Sourcing
Event sourcing (источники событий, регистрация событий, генерация событий) — это архитектурный паттерн, в котором все изменения, вносимые в состояние приложения, сохраняются в той последовательности, в которой они были выполнены. Эти записи служат как источником для получения текущего состояния, так и audit-log’ом того, что происходило в системе. Event sourcing способствует децентрализованному изменению и чтению данных. Такая архитектура хорошо масштабируется и подходит для систем, которые уже работают с событиями или подходят для миграции на такую архитектуру.
Event sourcing идет в ногу с CQRS. «DELUXE» cхема связки CQRS + Event Sourcing выглядит следующим образом:
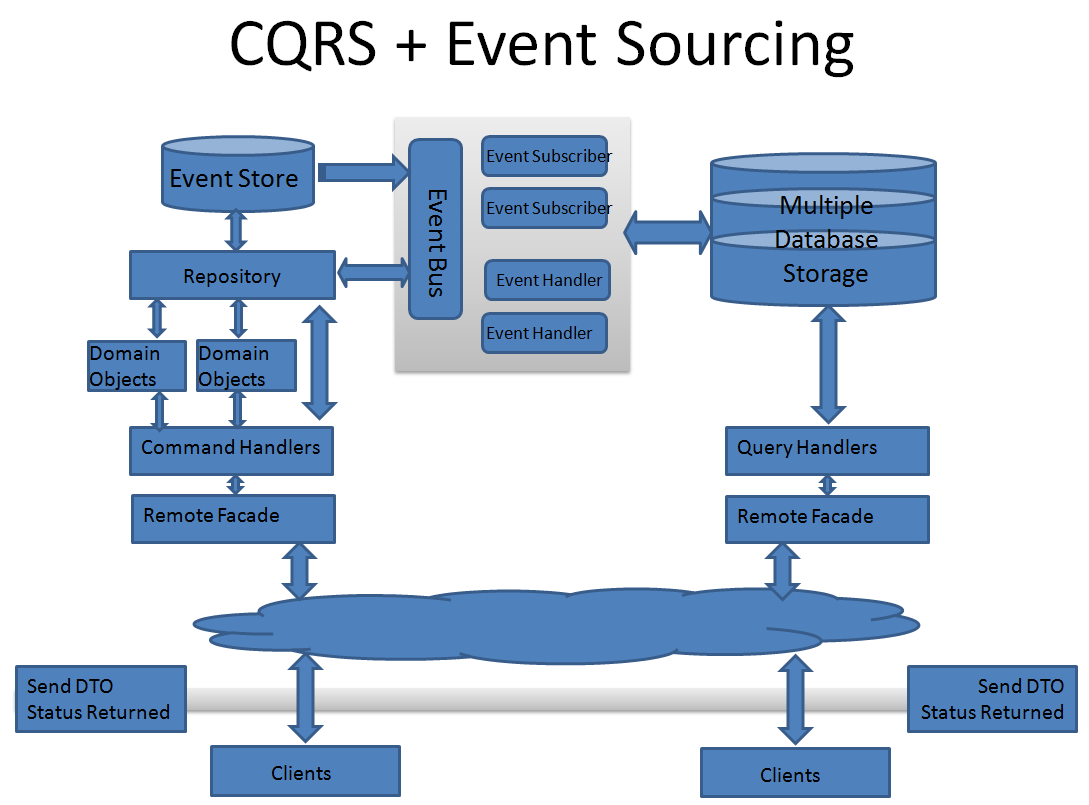
У Event sourcing есть следующие преимущества и недостатки:
�� Преимущества Event Sourcing
- События immutable, и их можно сохранить с помощью append-only операции.
- События могут раниться на фоне.
- Event sourcing может помочь в предотвращении конфликтов, вызванных параллельными апдейтами, тк исключает необходимость непосредственного обновления объектов в Data store. Однако доменная модель должна уметь себя защищать от запросов, которые могут вызвать несогласованное состояние.
- Append-only storage предоставляет audit log, который можно использовать для мониторинга событий, произошедших в Data store, повторного создания текущего состояния в виде materialized view или проекций путем воспроизведения событий в любое время, а также упрощения тестирования и отладки системы.
- Каждое событие могут обрабатывать несколько задач. Это обеспечивает простую интеграцию с другими службами и системами, которые только слушают новые события, вызванные data stor’ом. Однако event sourcing events зачастую являются низкоуровневыми, из-за чего может потребоваться создание определенных событий интеграции.
�� Недостатки CQRS
- Самые большие сложности обычно связаны с перестроением мышления разработчиков. Разработчики должны забыть про обычные CRUD-приложения и хранилища сущностей. Теперь основной концепцией становятся события.
- При Event Sourcing много сил тратится на моделирование событий. После сохранения событий в сторедж они должны быть immutable, иначе история и состояние могут быть повреждены или искажены. Event Log — это исходные данные, а это значит, что необходимо очень внимательно следить за тем, чтобы они содержали всю информацию, необходимую для получения полного состояния системы на определенный момент времени. Также необходимо учитывать, что события могут интерпретироваться повторно, поскольку система (и бизнес, который она представляет) со временем изменяются.
- Для простой бизнес логики переход на Event Sourcing может быть довольно легким, но для более сложных может стать проблемой (особенно с большим количеством зависимостей и отношений между сущностями). Так же могут возникнуть сложности интеграции с внешними системами, которые не предоставляют данные на определенный момент времени.
- Event Sourcing может работать хорошо в больших системах, так как паттерн «Event Log» естественным образом масштабируется горизонтально. Например, event log одной сущности необязательно должен физически находиться вместе с журналом событий другой сущности. Однако, такая легкость масштабирования приводит к дополнительным проблемам в виде решения проблем и реализацией eventual consistency.
- Важно учитывать структуру событий. Структура событий может измениться в какой-то момент, например набор полей. Могут возникнуть ситуации, когда исторические события должны быть обработаны текущей бизнес-логикой. И наличие расширяемой схемы событий поможет в будущем при необходимости отличать новые события от старых. Периодические снапшоты также помогают отделить серьезные изменения структуры событий.
Имплементация
Я не стану приводить примеры кода, их множество в интернете, мне кажется важнее показать схемы что б у вас как читателей этой статьи был helicopter-view и как строить такие системы в будущем.
Давайте начнем с такой диаграммы:

Это не то, как вы используете Event Sourcing.
Однако важная часть состоит в том, что события предметной области живут внутри контекста, потому что они являются неотъемлемой частью модели предметной области. Следовательно, события предметной области редко открываются внешнему миру как есть, поскольку они связывают модель предметной области с контрактом службы, поскольку они становятся контрактом. Это последнее, что мы хотим сделать. Разделение событий, отправляемых во внешний мир, публикация этих событий в виде контракта на обслуживание и поддержание их стабильности — это правильное решение.
Еще одна проблема заключается в том, что возможности Event Sourcing в устранении двухфазных коммитов здесь теряются. На диаграмме видно, что сохранение события и его публикация в шине — это две разные операции. Мы всегда сохраняем события в хранилище и используем хранилище как источник событий. Это возможно с продуктами, которые поддерживают потоки событий в реальном времени, например EventStoreDB. Это также лишает нас необходимости в каком-либо event bus внутри службы для построения модели чтения, которая отображена зеленым на диаграмме. Также важно, что чаще всего проекция на стороне чтения должна обрабатывать события по порядку, и ни один продукт, называемый шиной, не может этого сделать.
Вот исправленная, упрощенная схема того, как это должно быть:

Источники событий заботятся о логике записи, где события сохраняются в хранилище событий и транслируются с использованием подхода публикации/подписки, чтобы информировать микросервисы об изменении данных.
Когда следует использовать Event Sourcing
- Когда в данные необходимо записать намерение, цель или причину. Например, изменения в сущности клиента можно записать как ряд определенных типов событий, таких как Возвращение к исходному, Закрытая учетная запись или Недействительные.
- Когда очень важно свести к минимуму или полностью избежать конфликта операций обновления данных.
- Если требуется записывать происходящие события и иметь возможность воспроизвести их для восстановления определенного состояния системы, отката изменений или сохранения истории и audit-log. Например, если задача включает несколько шагов, необходимых для восстановления обновлений и последующего воспроизведения некоторых действий для восстановления согласованного состояния данных.
- Когда использование событий представляет собой стандартную возможность операции приложения и требует некоторой дополнительной разработки или усилий в отношении реализации.
- Если нужно разбить процесс ввода или обновления данных из задач, необходимых для применения этих действий. Это может быть в целях улучшения производительности пользовательского интерфейса или распределения событий в другие прослушиватели, выполняющие определенные действия при возникновении событий. Например, интеграция платежной системы с веб-сайтом о расходах требуется для того, чтобы события, вызванные с помощью хранилища событий в ответ на обновления данных, реализованные для веб-сайта, использовались как веб-сайтом, так и платежной системой.
- Если необходима гибкость для изменения формата материализованных моделей и данных сущности при изменении требований или —использовании в сочетании с CQRS, необходимо адаптировать модель чтения или представления с данными.
- Если используется в сочетании с CQRS, eventual consistency допустима при обновлении модели чтения или допустимо влияние на производительность при восстановленных сущностях и данных из потока события.
Когда не следуюет использовать Event Sourcing
- Для небольших или простых доменов, систем, которые обычно хорошо взаимодействуют со стандартными механизмами управления данных CRUD.
- Систем, где для представления данных требуются согласованность и обновления в режиме реального времени.
- Систем, где для действий отката и воспроизведения не требуются определенные функции, история и audit-log.
- Систем, где имеется незначительный конфликт обновлений в базовых данных. Например, это системы, которые преимущественно добавляют данные, а не обновляют их.
Выводы
CQRS и Event Sourcing — это интересный подход, имеющий свои преимущества. Одно из которых — упрощение расширения системы в будущем. Поскольку event log хранит все события, то их можно использовать во внешних системах. Довольно легко интегрироваться через добавление новых обработчиков событий.
Помните, что прежде чем интегрировать у себя CQRS и Event Sourcing нужно определить действительно ли вам это нужно, принцип KISS еще никто не отменял.
Однако, ограничения, связанные со сложностью предметной области, требованиями к согласованности и доступности данных, а также увеличение объема хранимых данных и масштабируемость в долгосрочной перспективе — все это необходимо учитывать при выборе этих паттернов. Так же важно уделять внимание разработчикам, которые будут разрабатывать и поддерживать такую систему на протяжении всего SDLC.
Как быстро попробовать CQRS/ES в Laravel или пишем банк на PHP
Недавно в подкасте «Цинковый прод» мы с товарищами обсуждали паттерн CQRS/ES и некоторые особенности её реализации в Elixir. Т.к. я в работе использую Laravel, грех было не покопаться в интернетах и не найти как же можно потягать этот подход в экосистеме данного фреймворка.
Всех приглашаю под кат, постарался максимально тезисно описать тему.
Немножко определений
CQRS (Command Query Responsibility Segregation) — выделение в отдельные сущности операции чтения и записи. Например пишем в мастер, читаем из реплики. CQRS. Факты и заблуждения — поможет досконально познать дзен CQRS.
ES (Event Sourcing) — хранение всех изменений состояния какой-либо сущности или набора сущностей.
CQRS/ES — это архитектурный подход при котором мы сохраняем все события изменения состояния какой либо сущности в таблице событий и добавляем к этому агрегат и проектор.
Агрегат — хранит в памяти свойства, необходимые для принятия решений бизнес логики (для ускорения записи), принимает решения (бизнес логика) и публикует события.
Проектор — слушает события и пишет в отдельные таблицы или базы (для ускорения чтения).
В бой
Laravel event projector — библиотека CQRS/ES для Laravel
Larabank — репозиторий с реализованным CQRS/ES подходом. Его и возьмем на пробу.
Конфигурация библиотеки подскажет куда смотреть и расскажет, что это такое. Смотрим файл event-projector.php. Из необходимого для описания работы:
- projectors — регистрируем проекторы;
- reactors — регистрируем реакторы. Реактор — в данной библиотеке добавляет сайд-эффекты в обработку событий, например в этом репозитории, если три раза попытаться превысить лимит снятия средств, то пишется событие MoreMoneyNeeded и отправляется письмо пользователю о его финансовых трудностях;
- replay_chunk_size — размер чанка повтора. Одна из фич ES — возможность восстановить историю по событиям. Laravel event projector подготовился к утечке памяти во время такой операции с помощью данной настройки.
Обращаем внимание на миграции. Кроме стандартных Laravel таблиц имеем
- stored_events — основная ES таблица с несколькими колонками неструктурированных данных под мета данные событий, строкой храним типы событий. Важная колонка aggregate_uuid — хранит uuid агрегата, для получения всех событий относящихся к нему;
- accounts — таблица проектора счетов пользователя, необходима для быстрой отдачи актуальных данных о состоянии баланса;
- transaction_counts — таблица проектора количества транзакций пользователя, необходима для быстрой отдачи количества совершенных транзакций.
А теперь предлагаю отправиться в путь вместе с запросом на создание нового счета.
Создание счета
Стандартный resource роутинг описывает AccountsController. Нас интересует метод store
public function store(Request $request) < $newUuid = Str::uuid(); // Обращаемся к агрегату, сообщаем ему uuid событий // которые в него должны входить AccountAggregateRoot::retrieve($newUuid) // Добавляем в массив событий на отправку событие создания нового счета ->createAccount($request->name, auth()->user()->id) // Отправляем массив событий на отправку в очередь на запись ->persist(); return back(); >AccountAggregateRoot наследует библиотечный AggregateRoot. Посмторим на методы, которые вызывал контроллер.
// Берем uuid и получаем все его события public static function retrieve(string $uuid): AggregateRoot < $aggregateRoot = (new static()); $aggregateRoot->aggregateUuid = $uuid; return $aggregateRoot->reconstituteFromEvents(); > public function createAccount(string $name, string $userId) < // Добавляем событие в массив событий на отправку // у событий, отправляемых в recordThat, есть хуки, но о них позже, // т.к. на создание счета их нет) $this->recordThat(new AccountCreated($name, $userId)); return $this; >Метод persist вызывает метод storeMany у модели указанной в конфигурации event-projector.php как stored_event_model в нашем случае StoredEvent
public static function storeMany(array $events, string $uuid = null): void < collect($events) ->map(function (ShouldBeStored $domainEvent) use ($uuid) < $storedEvent = static::createForEvent($domainEvent, $uuid); return [$domainEvent, $storedEvent]; >) ->eachSpread(function (ShouldBeStored $event, StoredEvent $storedEvent) < // Вызываем все проекторы, которые не реализуют интерфейс // QueuedProjector* Projectionist::handleWithSyncProjectors($storedEvent); if (method_exists($event, 'tags')) < $tags = $event->tags(); > // Отправляем в очередь джобу обработки и записи события $storedEventJob = call_user_func( [config('event-projector.stored_event_job'), 'createForEvent'], $storedEvent, $tags ?? [] ); dispatch($storedEventJob->onQueue(config('event-projector.queue'))); >); >Проекторы AccountProjector и TransactionCountProjector реализуют Projector поэтому реагировать на события будут синхронно вместе с их записью.
Ок, счет создали. Предлагаю рассмотреть как же клиент будет его читать.
Отображение счета
// Идем в таблицу `accounts` и берем счет по id public function index() < $accounts = Account::where('user_id', Auth::user()->id)->get(); return view('accounts.index', compact('accounts')); >Если проектор счетов реализует интерфейс QueuedProjector, то пользователь ничего не увидит пока событие не будет обработано по очереди.
Напоследок изучим, как работает пополнение и снятие денег со счета.
Пополнение и снятие
Снова смотрим в контроллер AccountsController:
// Получаем события с uuid агрегата // в зависимости от запроса вызываем пополнение // или снятие денег, затем отправляем на запись public function update(Account $account, UpdateAccountRequest $request) < $aggregateRoot = AccountAggregateRoot::retrieve($account->uuid); $request->adding() ? $aggregateRoot->addMoney($request->amount) : $aggregateRoot->subtractMoney($request->amount); $aggregateRoot->persist(); return back(); >при пополнении счета:
public function addMoney(int $amount) < $this->recordThat(new MoneyAdded($amount)); return $this; > // Помните говорил о "хуке" в recordThat // AggregateRoot*? // В нем вызывается метод apply(ShouldBeStored $event), // который в свою очередь вызывает метод 'apply' . EventClassName агрегата // Хук, который срабатывает при обработке `MoneyAdded` protected function applyMoneyAdded(MoneyAdded $event) < $this->accountLimitHitInARow = 0; $this->balance += $event->amount; >при снятии средств:
public function subtractMoney(int $amount) < if (!$this->hasSufficientFundsToSubtractAmount($amount)) < // Пишем событие о попытке снять больше лимита $this->recordThat(new AccountLimitHit()); // Если слишком много попыток шлем событие, что // нужно больше золота, на которое реагирует реактор // и отправляет сообщение пользователю if ($this->needsMoreMoney()) < $this->recordThat(new MoreMoneyNeeded()); > $this->persist(); throw CouldNotSubtractMoney::notEnoughFunds($amount); > $this->recordThat(new MoneySubtracted($amount)); > protected function applyMoneySubtracted(MoneySubtracted $event) < $this->balance -= $event->amount; $this->accountLimitHitInARow = 0; >
Заключение
Постарался максимально без воды описать процесс «онбординга» в CQRS/ES на Laravel. Концепция очень интересная, но не без особенностей. Прежде, чем внедрять помните о:
- eventual consistency;
- желательно использовать в отдельных доменах DDD, не стоит делать большую систему полностью на этом паттерне;
- изменения в схеме таблицы событий могут быть очень болезненны;
- ответственно стоит подойти к выбору гранулярности событий, чем больше будет конкретных событий, тем больше их будет в таблице и большее количество ресурсов будет необходимо на работу с ними.
Буду рад замеченным ошибкам.
CQRS. Факты и заблуждения
CQRS — это стиль архитектуры, в котором операции чтения отделены от операций записи. Подход сформулировал Грег Янг на основе принципа CQS, предложенного Бертраном Мейером. Чаще всего (но не всегда) CQRS реализуется в ограниченных контекстах (bounded context) приложений, проектируемых на основе DDD. Одна из естественных причин развития CQRS — не симметричное распределение нагрузки и сложности бизнес-логики на read и write — подсистемы Большинство бизнес-правил и сложных проверок находится во write — подсистеме. При этом читают данные зачастую в разы чаще, чем изменяют.
Не смотря на простоту концепции, детали реализации CQRS могут значительно отличаться. И это именно тот случай, когда дьявол кроется в деталях.
От ICommand к ICommandHandler
Многие начинают реализацию CQRS с применения паттерна «команда», совмещая данные и поведение в одном классе.
public class PayOrderCommand < public int OrderId < get; set; >public void Execute() < //. >>Это усложняет сериализацию / десериализацию команд и внедрение зависимостей.
public class PayOrderCommand < public int OrderId < get; set; >public PayOrderCommand(IUnitOfWork unitOfWork) < // WAT? >public void Execute() < //. >>Поэтому, оригинальную команду делят на «данные» — DTO и поведение «обработчик команды». Таким образом сама «команда» больше не содержит зависимостей и может быть использована как Parameter Object, в т.ч. в качестве аргумента контроллера.
public interface ICommandHandler < public void Handle(T command) < //. >> public class PayOrderCommand < public int OrderId < get; set; >> public class PayOrderCommandHandler: ICommandHandler < public void Handle(PayOrderCommand command) < //. >> Если вы хотите использовать сущности, а не их Id в командах, чтобы не заниматься валидацией внутри обработчиков, можно переопределить Model Binding, хотя этот подход сопряжен с недостатками. Чуть позже мы рассмотрим, как вынести валидацию, не меняя стандартный Model Binidng.
ICommandHandler должен всегда возвращать void?
Обработчики не занимаются чтением, для этого есть read — подсистема и часть Query, поэтому всегда должны возвращать void . Но как быть с Id, генерируемыми БД? Например, мы отправили команду «оформить заказ». Номеру заказа соответствует его Id из БД. Id нельзя получить, пока запрос INSERT не выполнен. Чего только не придумают люди, что обойти это выдуманное ограничение:
- Последовательный вызов CreateOrderCommandHandler , а затем IdentityQueryHandler
- Out — параметры
- Добавление в команду специального свойства для возвращаемого значения
- События
- Отказ от автоинкрементных Id в пользу Guid. Guid приходи в теле команды и записывается в БД
Грег Янг четко обозначает свою позицию по этому вопросу (25 минута): «Должен ли обработчик команды всегда возвращать void ? Нет, список ошибок или исключение может быть результатом выполнения». Обработчик может возвращать результат выполнения операции. Он не должен заниматься работой Query — поиском данных, что не значит, что он не может возвращать значение. Главным ограничением на этот счет являются ваши требования к системе и необходимость использования асинхронной модели взаимодействия. Если вы точно знаете, что команда не будет выполнена синхронно, а вместо этого попадет в очередь и будет обработана позже, не рассчитывайте получить Id в контексте HTTP-запроса. Вы можете получить Guid операции и опрашивать статус, предоставить callback или получить ответ по web sockets. В любом случае, void или не void в обработчике – меньшая из ваших проблем. Асинхронная модель заставит изменить весь пользовательский опыт, включая интерфейс (посмотрите, как выглядит поиск авиабилетов на Ozon или Aviasales).
Не стоит рассчитывать, что void в качестве возвращаемого значения позволит использовать одну кодовую базу для синхронной и асинхронной моделей. Отсутствие же значимого возвращаемого результата может вводить в заблуждение потребителей вашего API. Кстати, используя исключения для control flow вы все-равно возвращаете значение из обработчика, просто делаете это неявно, нарушая принцип структурного программирования.
На всякий случай, на одном из DotNext я спросил мнение Дино Эспозито по этому поводу. Он согласен с Янгом: обработчик может возвращать ответ. Это может быть не void , но это должен быть результат операции, а не данные из БД. CQRS – это высокоуровневый концепт, дающий выигрыш в некоторых ситуациях (разные требования к read и write подсистемам), а не догма.
Грань между void и не void еще менее заметна в F#. Значению void в F# соответствует тип Unit . Unit в функциональных языках программирования – своеобразный синглтон без значений. Таким образом разница между void и не void обусловлена технической реализацией, а не абстракцией. Подробнее о void и unit можно прочесть в блоге Марка Симана
А что с Query?
Query в CQRS чем-то может напомнить Query Object. Однако, на деле это разные абстракции. Query Object – специализированный паттерн для формирования SQL c помощью объектной модели. В .NET с появлением LINQ и Expression Trees паттерн утратил свою актуальность. Query в CQRS — это запрос на получение данных в удобном для клиента виде.
По аналогии с Command CommandHandler логично разделить Query и QueryHandler . И в данном случае QueryHandler уже действительно не может возвращать void . Если по запросу ничего не найдено, мы можем вернуть null или использовать Special Case.
Но в чем тогда принципиальная разница между CommandHandler и QueryHandler ? Их сигнатуры одинаковы. Ответ все тот же. Разница в семантике. QueryHandler возвращает данные и не меняет состояние системы. CommandHandler , наоборот меняет состояние и, возможно, возвращает статус операции.
Если одной семантики вам мало, можно внести такие изменения в интерфейс:
public interface IQuery < >public interface IQueryHandler where TQuery : IQuery
Тип TResult дополнительно подчеркивает, что у запроса есть возвращаемое значение и даже связывает его с ним. Эту реализацию я подсмотрел в блоге разработчика Simple Injector’а и соавтора книги Dependency Injection in .NET Стивена ван Дейрсена. В своей реализации мы ограничились заменой названия метода с Handle на Ask , чтобы сразу видеть на экране IDE, что выполняется запрос без необходимости уточнять тип объекта.
public interface IQueryHandler
А нужны ли другие интерфейсы?
В какой-то момент может показаться, что все остальные интерфейсы доступа к данным можно сдать в утиль. Берем несколько QueryHandler’ов , собираем из них хендлер по больше, из них еще больше и так далее. Компоновать QueryHandler’ы имеет смысл только если у вас существуют отдельно use case’ы A и B и вам нужен еще use case, который вернет данные A + B без дополнительных преобразований. По типу возвращаемого значения не всегда очевидно, что вернет QueryHandler . Поэтому легко запутаться в интерфейсах с разными generic-параметрами. Кроме того C# бывает многословным.
public class SomeComplexQueryHandler < IQueryHandler> findUsers; IQueryHandler> getUsers; IQueryHandler> getHighUsage; public SomeComplexQueryHandler( IQueryHandler> findUsers, IQueryHandler> getUsers, IQueryHandler> getHighUsage) < this.findUsers = findUsers; this.getUsers = getUsers; this.getHighUsage = getHighUsage; >>Удобнее использовать QueryHandler как точку входа для конкретного use case. А для получения данных внутри создавать специализированные интерфейсы. Так код будет более читаемым.
Если идея компоновки маленьких функций в большие не дает вам покоя, то рассмотрите вариант смены языка программирования. В F# эта идея воплощается гораздо лучше.
Можно ли write-подсистеме использовать read-подсистему и наоборот?
Еще один догмат – никогда нельзя перемешивать write и read – подсистемы. Строго говоря, здесь все верно. Если вам захотелось получить данные из QueryHandler внутри обработчика команды, скорее всего это значит, что CQRS в данной подсистеме не нужен. CQRS решает конкретную проблему: read — подсистема не справляется с нагрузками.
Одним из самых популярных вопросов в DDD-группе до недавнего времени был: «Мы используем DDD и у нас тут есть годовой отчет. Когда мы пытаемся его построить наш слой бизнес-логике поднимает в оперативную память агрегаты и оперативная память заканчивается. Как нам быть?». Ясно как: написать оптимизированный SQL-запрос вручную. Это же касается посещаемых веб-ресурсов. Нет нужды поднимать все ООП-великолепие, чтобы получить данные, закешировать и отобразить. CQRS – предлагает отличный водораздел: в обработчиках команд мы используем доменную логику, потому что команд не так много и потому что мы хотим, чтобы были выполнены все проверки бизнес-правил. В read — подсистеме, наоборот, желательно обойти слой бизнес-логики, потому что он тормозит.
Смешивая read и write подсистемы, мы теряем водораздел. Смысл семантической абстракции теряется даже на уровне одного хранилища. В случае, когда read — подсистема использует другое хранилище данных, вообще нет гарантии, что система находится в согласованном состоянии. Раз актуальность данных не гарантирована, теряется смысл проверок бизнес-слоя. Использование write — подсистемы в read — подсистеме вообще противоречит смыслу операции: команды по определению меняют состояние системы, а query – нет.
У каждого правила, впрочем, есть исключения. В том же видео минутой раньше Грег приводит пример: «вам требуется загрузить миллионы сущностей, чтобы сделать расчет. Вы будете грузить все эти данные в оперативную память или выполните оптимальный запрос?». Если в read — подсистеме уже есть подходящий query handler и вы используете один источник данных никто не посадит вас в тюрьму за вызов query из обработчика команды. Просто держите в голове аргументы против этого.
Возвращать из QueryHandler сущности или DTO?
DTO. Если клиенту требуется весь агрегат из БД что-то не так с клиентом. Более того, обычно требуются максимально плоские данные. Вы можете начать используя LINQ и Queryable Extensions или Mapster на этапе прототипирования. И по необходимости заменять реализации QueryHandler на Dapper и / или другое хранилище данных. В Simple Injector есть удобный механизм: можно зарегистрировать все объекты, реализующие интерфейсы открытых дженериков из сборки, а для остальных оставить fallback с LINQ. Один раз написав такую конфигурацию не придется ее редактировать. Достаточно добавить в сборку новую реализацию и контейнер автоматом подхватит. Для других дженериков будет продолжать работать фолбек на LINQ-реализацию. Mapster , кстати не требует создавать профайлы для маппинга. Если вы соблюдаете соглашения в названиях свойств между Entity и Dto проекции будут строиться автоматом.
С «автомаппером» у нас сложилось следующее правило: если нужно писать ручной мапиинг и встроенных соглашений не достаточно, лучше обойтись без автомапера. Таким образом, переезд на «мапстер» оказался довольно простым.
CommandHandler и QueryHandler — холистические абстракции
Т.е. действующие от начала до конца транзакции. Т.е. типовое использование — один хендлер на запрос. Для доступа к данным лучше использовать другие механизмы, например уже упомянутый QueryObject или UnitOfWork . Кстати, это решает проблему с использованием Query из Command и наоборот. Просто используйте QueryObject и там и там. Нарушение этого правила усложняет управление транзакциями и подключением к БД.
Cross Cutting Concerns и декораторы
У CQRS есть одно большое преимущество над стандартной сервисной архитектурой: у нас всего 2 generic-интерфейса. Это позволяет многократно повысить полезность шаблона «декоратор». Есть ряд функций, необходимых любому приложению, но не являющихся бизнес-логикой в прямом смысле: логирование, обработка ошибок, транзакционность и т.п. Традиционно варианта два:
- смириться и замусоривать бизнес-логику такими зависимостями и сопутствующим кодом
- посмотреть в сторону АОП: с помощью интерцепторов в runtime, например Castle.Dynamic Proxy или переписывая IL на этапе компиляции, например PostSharp
public class ValidationQueryHandlerDecorator : IQueryHandler where TQuery : IQuery < private readonly IQueryHandlerdecorated; public ValidationQueryHandlerDecorator(IQueryHandler decorated) < this.decorated = decorated; >public TResult Handle(TQuery query) < var validationContext = new ValidationContext(query, null, null); Validator.ValidateObject(query, validationContext, validateAllProperties: true); return this.decorated.Handle(query); >>Если нет, — можно сделать небольшую оберточку и использовать Result в качестве возвращаемого значения.
public class ResultQueryHandler : IQueryHandler> < private readonly IQueryHandler_queryHandler; public ResultQueryHandler(IQueryHandler queryHandler) < _queryHandler = queryHandler; >public Result Ask(TSource param) => Result.Succeed(_queryHandler.Ask(param)); >
SimpleInjector предлагает удобный способ для регистрации открытых generic’ов и декораторов. Всего одной строчкой кода можно вставить логирование перед выполнением, после выполнения, навесить глобальную транзакционность, обработку ошибок, автоматическую подписку на доменные события. Главное не слишком переусердствовать.
Есть определенное неудобство с двумя интерфейсами IQueryHandler и ICommandHandler . Если мы хотим включить логирование или валидацию в обеих подсистемах, то придется написать два декоратора, с одинаковым кодом. Что-ж, это не типичная ситуация. В read-подсистеме, вряд ли потребуется транзакционность. Тем не менее, примеры с валидацией и логированием вполне себе жизненные. Можно решить эту проблему перейдя от интерфейсов к делегатам.
public abstract class ResultCommandQueryHandlerDecorator : IQueryHandler> , ICommandHandler> < private readonly Func> _func; // Хендлеры превращаются в элегантные делегаты protected ResultCommandQueryCommandHandlerDecorator( Func> func) < _func = func; >// Для Query protected ResultCommandQueryCommandHandlerDecorator( IQueryHandler> query) : this(query.Ask) < >// Для Command protected ResultCommandQueryCommandHandlerDecorator( ICommandHandler> query) : this(query.Handle) < >protected abstract Result Decorate( Func> func, TSource value); public Result Ask(TSource param) => Decorate(_func, param); public Result Handle(TSource command) => Decorate(_func, command); >Да, в этом случае тоже есть небольшой оверхед: придется объявить два класса только для кастинга передаваемого в конструктор параметра. Это тоже можно решить путем усложнения конфигурации IOC-контейнера, но мне проще объявить два класса.
Альтернативный вариант — использовать интерфейс IRequestHandler для Command и Query , а чтобы не путаться использовать naming convention. Такой подход реализован в библиотеке MediatR.
- Веб-разработка
- Анализ и проектирование систем
- .NET
- Проектирование и рефакторинг
- C#