
Многопоточность в Python. Библиотеки threading и multiprocessing.
Процесс — исполняемый экземпляр какой-либо программы. Каждый процесс состоит из следующих элементов:
- образ машинного кода;
- область памяти, в которую включается исполняемый код, данные процесса (входные и выходные данные), стек вызовов и куча (для хранения динамически создаваемых данных);
- дескрипторы операционной системы (например, файловые дескрипторы);
- состояние процесса.
В целях стабильности и безопасности, в современных операционных системы каждый процесс имеет прямой доступ только с своим собственным ресурсам. Доступ к ресурсам другого процесса возможен через межпроцессное взаимодействие (например, посредством файлов, при помощи именованных и неименованных каналов и другие).
Сам процесс может быть разделен на так называемые потоки. Поток (поток выполнения, thread) — наименьшая единица обработки, исполнение которой может быть назначено ядром операционной системы. В отличии от нескольких процессов, потоки существуют внутри одного процесса и имеют доступ к ресурсам этого процесса. Каждый поток обладет собственным набором регистров и собственным стеком вызова, но доступ к ним имеют и другие потоки.
При работе с потоками стоит учесть несколько моментов:
- одно ядро процессора в один момент может исполнять только один поток;
- потоки одного процесса могут исполняться физически одновременно (на разных ядрах);
- бессмысленно порождать потоков больше, чем у вас есть ядер.
Потоки имеют несколько применений. Первое — ускорение работы программы. Ускорение достигается за счет параллельного выполнения независимых друг от друга вычислений. Например, при численном интегрировании область интегрирования может быть разбита на 3 участка. На каждый участок создается свой поток, в котором численно вычислется интеграл для конкретного участка. Второе — независимое исполнение операций. Отличие этого случая от первого хорошо видно на следующем примере. Пусть есть приложение с графическим интерфейсом, где весь код выполняется в одном потоке. При выполнении какой-нибудь долгой операции (например, копирование файла) интерфейс приложения просто перестанет отвечать до тех пор, пока долгий процесс не завершится. В таком случае в один поток помещается работа графического интерфейса, в другой — остальные вычисления. В таком случае интерфейс позволит проводить другие операции даже во время выполнения долгой операции в другом потоке (например, заполнение прогресс бара в процессе копирования файла).
threading
В Python работа с потоками осуществляется при помощи стандартной библиотеки threading. В библиотеке представлен класс Thread для создания потока выполнения. Задание исполняемого кода в отдельном потоке возможно двумя способами:
- передача исполняемого объекта (функции) в конструктор класса;
- переопределение функции run() в классе-наследнике.
После того, как объект создан, поток запускается путем вызова метода start(). Рассмотрим простой пример:
import threading import sys def thread_job(number): print('Hello <>'.format(number)) sys.stdout.flush() def run_threads(count): threads = [ threading.Thread(target=thread_job, args=(i,)) for i in range(0, count) ] for thread in threads: thread.start() # каждый поток должен быть запущен for thread in threads: thread.join() # дожидаемся исполнения всех потоков run_threads(4) print(finish)
Конструктор класса Thread имеет следующие аргументы:
- group должно быть None; зарезервировано для будующих реализаций Python 3;
- target является исполняемым объектом (по умолчанию равен None, ничего не исполняется);
- name обозначет имя потока (по умолчанию имя генерируется автоматически);
- args — кортеж аргументов для исполняемого объекта;
- kwargs — словарь именованных аргументов для исполняемого объекта;
- daemon равное True обозначет служебный поток (служебные потоки завершаются принудительно при завершении процесса); по умолчанию False.
В Python выполнение программы заканчивается, когда все неслужебные потоки завершены. Модифицировав программу выше, мы все еще получим корректно работающий код:
import threading import sys import time def thread_job(number): time.sleep(2) # "усыпляем" поток на 2 сек print('Hello <>'.format(number)) sys.stdout.flush() def run_threads(count): threads = [ threading.Thread(target=thread_job, args=(i,)) for i in range(1, count) ] for thread in threads: thread.start() # каждый поток должен быть запущен run_threads(1) print(finish)
Как можно увидеть, программа завершается без ошибок (с кодом 0), но теперь строка «finish» печатается раньше строки «Hello 0», т.к. главный поток теперь не ждет завершения работы других потоков. Метод join() используется для блокирования исполнения родительского потока до тех пор, пока созданный поток не завершится. Это нужно в случаях, когда для работы потока-родителя необходим результат работы потока-потомка. Вспомним пример с численным интегрированием. Вычисление итогового значения интеграла выполняется в главном потоке, но это возможно только после завершения вычислений в побочных потоках. В таком случае главный поток нужно просто приостановить до тех пор, пока не завершатся все побочные потоки. Метод join() может принимать один аргумент — таймаут в секундах. Если таймаут задан, join() бликирует работу на указанное время. Если по истечении времени ожидаемый поток не будет завершен, join() все равно разблокирует работу потока, вызвашего его. Проверить, исполняется ли поток можно методом is_alive(). Подробнее ознакомиться с функционалом библиотеки можно в официальной документации по threading.
Упражнение №1
Запустите следующий код. В чем проблема данного кода? Всегда ли counter = 10 после исполнения кода программы?
import threading import sys def thread_job(): global counter old_counter = counter counter = old_counter + 1 print('<> '.format(counter), end='') sys.stdout.flush() counter = 0 threads = [threading.Thread(target=thread_job) for _ in range(10)] for thread in threads: thread.start() for thread in threads: thread.join() print(counter)
Демонстрация «проблемности» кода:
import threading import random import time import sys def thread_job(): global counter old_counter = counter time.sleep(random.randint(0, 1)) counter = old_counter + 1 print('<> '.format(counter), end='') sys.stdout.flush() counter = 0 threads = [threading.Thread(target=thread_job) for _ in range(10)] for thread in threads: thread.start() for thread in threads: thread.join() print(counter)
Почему так происходит? Есть несколько возможных решений этой проблемы.
import threading import random import time import sys def thread_job(): lock.acquire() # mutex global counter old_counter = counter time.sleep(random.randint(0, 1)) counter = old_counter + 1 print('<> '.format(counter), end='') sys.stdout.flush() lock.release() lock = threading.Lock() counter = 0 threads = [threading.Thread(target=thread_job) for _ in range(10)] for thread in threads: thread.start() for thread in threads: thread.join() print(counter)
import threading import random import time import sys def thread_job(): with lock: global counter old_counter = counter time.sleep(random.randint(0, 1)) counter = old_counter + 1 print('<> '.format(counter), end='') sys.stdout.flush() lock = threading.Lock() counter = 0 threads = [threading.Thread(target=thread_job) for _ in range(10)] for thread in threads: thread.start() for thread in threads: thread.join() print(counter)
Вариант с контекстным менеджером более предпочтителен. Вспомните работу с файлами при помощи with. По завершении with файл автоматически закрывался. В данном случае похожая ситуация. Для того, чтобы запретить нескольким потокам параллельно выполнять некоторые участки кода, мы используем Lock (в UNIX системах более известен как мьютекс (mutex)). Мьютекс может быть в двух состояниях: свободен и заблокирован. Если какой-либо поток пытается заблокировать уже заблокированный мьютекс, то поток блокируется до тех пор, пока мьютекс не освободится. Причем если несколько потоков претендует на блокирование мьютекса, то потоки просто выстраиваются в очередь. Главная проблема — не освобожденный мьютекс. Отсутствие строчки lock.release() может повесить остальные потоки в бесконечное ожидание. Контекстный менеджер позволит избежать этой проблемы. Как только он закончится, все захваченные им ресурсы будут освобождены, в том числе мьютекс.
Упражнение №2
Иногда бывает нужно узнать доступность набора ip адресов. Неэффективный вариант представлен ниже.
Реализуйте то же самое, но используя threading.
import os, re received_packages = re.compile(r"(\d) received") status = ("no response", "alive but losses", "alive") for suffix in range(20, 30): ip = "192.168.178." + str(suffix) ping_out = os.popen("ping -q -c2 " + ip, "r") # получение вердикта print(". pinging ", ip) while True: line = ping_out.readline() if not line: break n_received = received_packages.findall(line) if n_received: print(ip + ": " + status[int(n_received[0])])
Global Interpreter Lock (GIL)
CPython — популярная реализация интерпретатора — имеет встроенный механизм, который обеспечивает выполнение ровно одного потока в любой момент времени. GIL облегчает реализацию интерпретатора, защищая объекты от одновременного доступа из нескольких потоков. По этой причине, создание несколько потоков не приведет к их одновременному исполнению на разных ядрах процессора.
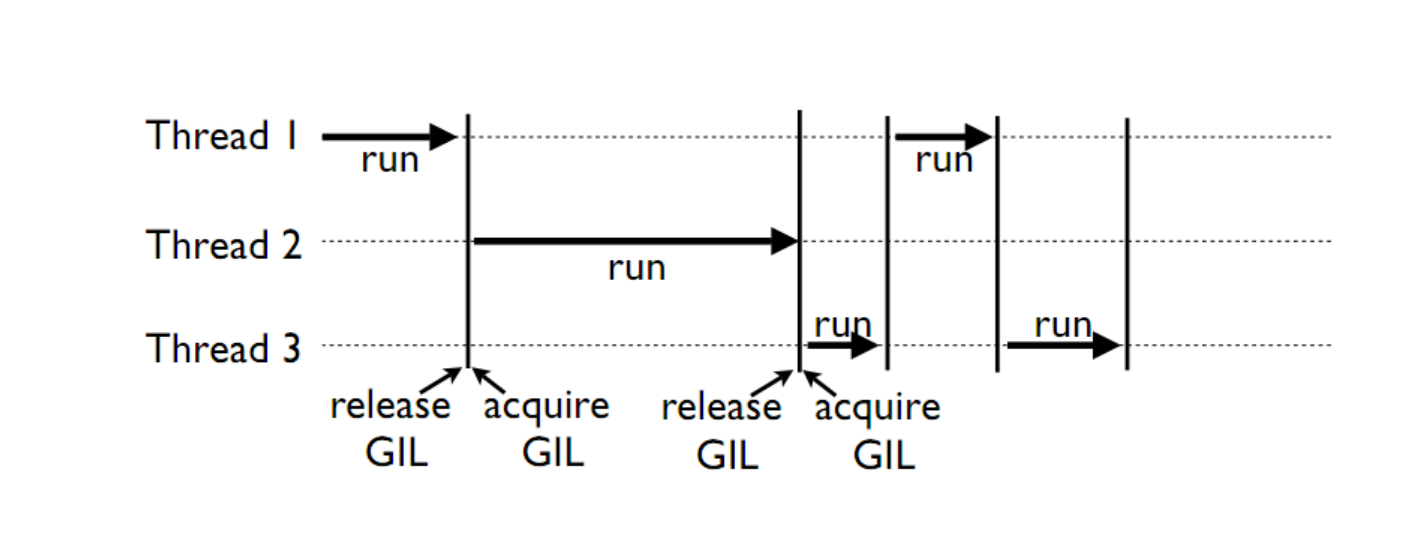
Однако, некоторые модули, как стандартные, так и сторонние, созданы для освобождения GIL при выполнении тяжелых вычислительных операций (например, сжатие или хеширование). К тому же, GIL всегда свободен при выполнении операций ввода-вывода.
Упражнение №3
Написать программу, которая будет находить сумму чисел массива с использованием N потоков. Запустить с разным параметром N. Убедиться, что несмотря на увеличение N, ускорения подсчета не происходит. Причина этому — GIL. В Python вычисления распараллеливать бессмысленно. Замерить время работы можно с помощью библиотеки time (ответ в секундах):
start = time.time() # код, время работы которого надо замерить print(time.time() - start)
Упражнение №4
Запустите на исполнение, замерив время работы. Перепишите с помощью потоков и опять замерьте время.
import urllib.request import time urls = [ 'https://www.yandex.ru', 'https://www.google.com', 'https://habrahabr.ru', 'https://www.python.org', 'https://isocpp.org', ] def read_url(url): with urllib.request.urlopen(url) as u: return u.read() start = time.time() for url in urls: read_url(url) print(time.time() - start)
Потоки очень уместны, если в коде есть блокирующие операции (ввод-вывод, сетевые взаимодействия). Также, удобно разбивать логические процессы по потокам (анимация, графический интерфейс, и тд).
multiprocessing
Библиотека multiprocessing позволяет организовать параллелизм вычислений за счет создания подпроцессов. Т.к. каждый процесс выполняется независимо от других, этот метод параллелизма позволяет избежать проблем с GIL. Предоставляемый библиотекой API схож с тем, что есть в threading, хотя есть уникальные вещи. Создание процесса происходит поутем создания объекта класса Process. Аргументы конструктора аналогичны тем, что есть в конструкторе Thread. В том числе аргумент daemon позволяет создавать служебные процессы. Служебные процессы завершаются вместе с родительским процессом и не могут порождать свои подпроцессы.
Простой пример работы с библиотекой:
from multiprocessing import Process def f(name): print('hello', name) if __name__ == '__main__': p = Process(target=f, args=('bob',)) p.start() p.join()
Чтобы убедить, что каждый процесс имеет свой ID, запустите пример:
from multiprocessing import Process import os def info(title): print(title) print('module name:', __name__) print('parent process:', os.getppid()) print('process id:', os.getpid()) def f(name): info('function f') print('hello', name) if __name__ == '__main__': info('main line') p = Process(target=f, args=('bob',)) p.start() p.join()
Старайтесь не забывать про конструкцию __name__ == ‘__main__’ . Это надо для того, чтобы ваш модуль можно было безопасно подключать в другие модули и при этом не создавались новые процессы без вашего ведома.
Упражнение №5
Запустите код. Попробуйте объяснить, почему LIST — пуст.
import multiprocessing def worker(): LIST.append('item') LIST = [] if __name__ == "__main__": processes = [ multiprocessing.Process(target=worker) for _ in range(5) ] for p in processes: p.start() for p in processes: p.join() print(LIST)
Общение между процессами
multiprocessing предоставляет два вида межпроцессного обмена данными: очереди и каналы данных (pipe).
Очереди (класс Queue) аналогичны структуре данных «очередь», рассмотренной вами в курсе алгоритмов.
from multiprocessing import Process, Queue def f(q): q.put([42, None, 'hello']) if __name__ == '__main__': q = Queue() p = Process(target=f, args=(q,)) p.start() print(q.get()) # выводит "[42, None, 'hello']" p.join()
Класс Pipe отвечает за канал обмена данными (по умолчанию, двунаправленный), представленный двумя концами, объектами класса Connection. С одним концом канала работает родительский процесс, а с другим концом — подпроцесс.
from multiprocessing import Process, Pipe def f(conn): conn.send([42, None, 'hello']) conn.close() if __name__ == '__main__': parent_conn, child_conn = Pipe() p = Process(target=f, args=(child_conn,)) p.start() print(parent_conn.recv()) # выводит "[42, None, 'hello']" p.join()
Еще один вид обмена данными может быть достигнут путем записи/чтения обычных файлов. Чтобы исключить одновременную работу двух процессов с одним файлом, в библиотеке есть классы аналогичные threading.
from multiprocessing import Process, Lock def f(l, i): l.acquire() try: print('hello world', i) finally: l.release() if __name__ == '__main__': lock = Lock() for num in range(10): Process(target=f, args=(lock, num)).start()
Подробнее ознакомиться с функционалом библиотеки можно в официальной документации по multiprocessing.
Класс Pool в multiprocessing
Класс Pool — удобный механизм распараллеливания выполнения функций, распределения входных данных по процессам и т.д.
Наиболее интересные функции: Pool.apply, Pool.map, Pool.apply_async, Pool.map_async.
apply, map работают аналогично питоновским built-in apply, map.
Как работает Pool можно понять на примере:
from multiprocessing import Pool def cube(x): return x**3 if __name__ == "__main__": pool = Pool(processes=4) # создаем пул из 4 процессов # в apply можно передать несколько аргументов results = [pool.apply(cube, args=(x,)) for x in range(1,7)] # раскидываем числа от 1 до 7 по 4 процессам print(results) pool = Pool(processes=4) # то же самое, но с map. разбивает итерируемый объект (range(1,7)) на chunks и раскидывает аргументы по процессам results = pool.map(cube, range(1,7)) print(results)
map, apply — блокирующие вызовы. Главная программа будет заблокирована, пока процесс не выполнит работу.
map_async, apply_async — неблокирующие. При их вызове, они сразу возвращают управление в главную программу (возвращают ApplyResult как результат). Метод get() объекта ApplyResult блокирует основной поток, пока функция не будет выполнена.
pool = mp.Pool(processes=4) results = [pool.apply_async(cube, args=(x,)) for x in range(1,7)] output = [p.get() for p in results] print(output)
Упражение №6*
Для этого упражнения скачайте архив viterbi_mp.zip с кодом и необходимыми данными.
Рассмотрим следующую задачу. Положение мобильного робота на двумерной карте может быть представлено тремя числами: x, y и направлением θ. Точное положение робота нам не известно. В связи с этим мы строим N гипотез о его пложении, сумма их вероятностей равна 1. В процессе движения робота некоторые гипотезы исчезали, а некоторые порождали новые. Однако в каждый момент времени количество гипотез — константа. Известно, какая гипотеза из какой была порождена.
Представленный (и слегка упрощенный) выше метод оценки положения робота множеством гипотез называется фильтром частиц, а сами гипотезы называются частицами. Фильтр частиц используется для оценки положения робота в процессе его движения. Вспомним, что в процессе работы некоторые частицы погибают, а некоторые порождают другие. Переходы между частицами образуют граф перехода. Используя этот граф, можно оценить траекторию робота с некоторой точностью.
Задача: необходимо восстановить траекторию движения робота. Есть несколько способов приближенно решить данную задачу. Один из способов — восстановить наиболее вероятную траекторию. Для этого воспользуемся алгоритмом Витерби, одним из алгоритмов динамического программирования.
Пусть у нас было T моментов времени. На каждом моменте времени t мы для каждой частицы, существующей в момент времени t, выбираем наиболее вероятный переход из какой-нибудь частицы с момента времени t-1. Тогда ответом будет — argmax по вероятности среди всех частиц в последний момент времени. Однако, сам алгоритм довольно медленный. Его асимптотика O(T * N^2) .
В архиве вам предоставлен код в файле generate_viterbi_trajectory.py . Однако, он написан без распараллеливания. Ваша задача — распараллелить код, используя multiprocessing. Файл graph.ldj представляет собой текстовый файл, где каждая строка в формате JSON. Каждая строка представляет собой один момент времени. В этом задании вам предлагаются первые 10 моментов времени движения робота. В каждый момент времени количество частиц N = 2000 . Файл localization_config.json — файл конфигурации, содержащий параметры с которыми происходила генерация графа. Файл true_trajectory.json содержит массив троек чисел (x, y, θ), построенный нераспараллеленым алгоритмом. Вам надо будет сравнить полученную вами траекторию с данной при помощи скрипта correspond_trajectories.py . Для тех, кто хочет попробовать свой код на больших данных, используйте файл full_graph.ldj , который содержит порядка 1700 строк. Архив с файлом.
Не забудьте замерить время работы. Примерное время работы на моем компьютере для 10 строк в 1 процесс — 300 сек.
Сайт построен с использованием Pelican. За основу оформления взята тема от Smashing Magazine. Исходные тексты программ, приведённые на этом сайте, распространяются под лицензией GPLv3, все остальные материалы сайта распространяются под лицензией CC-BY.
Что такое GIL в Python и как с ним работать
GIL (Global Interpreter Lock) – это механизм, используемый в CPython для синхронизации доступа к объектам Python. Он предотвращает одновременное выполнение нескольких нитей интерпретатора, что может привести к проблемам с производительностью в многопоточных приложениях. В этой статье мы поговорим о том, что такое GIL, его влиянии на производительность и как с ним работать. ��
Влияние GIL на производительность
GIL ограничивает выполнение кода в одну нить, что может замедлить работу многопоточных приложений. Например, если у вас есть программа с двумя потоками, которые выполняют вычисления, они не смогут использовать полностью ресурсы многоядерного процессора, так как только одна нить сможет выполняться в одно и то же время.
Python-разработчик: новая работа через 9 месяцев
Получится, даже если у вас нет опыта в IT
Как справиться с GIL
Использование многопроцессорности
Один из способов обойти ограничения GIL – использовать многопроцессорность вместо многопоточности. В Python для этого есть модуль multiprocessing . Пример создания двух процессов, выполняющих задачу параллельно:
from multiprocessing import Process def task(name): print(f'Выполнение задачи ') if __name__ == '__main__': p1 = Process(target=task, args=('Process 1',)) p2 = Process(target=task, args=('Process 2',)) p1.start() p2.start() p1.join() p2.join() print('Завершение работы')
Использование других реализаций Python
Еще один способ избавиться от проблем с GIL – использовать другие реализации Python, такие как PyPy, Jython или IronPython. Они не имеют GIL или используют другие механизмы для синхронизации доступа к объектам.
Заключение
GIL является важным механизмом синхронизации в CPython, который обеспечивает безопасность данных и предотвращает одновременное выполнение нескольких потоков. Однако, это может привести к проблемам с производительностью в многопоточных приложениях. Чтобы обойти ограничения GIL, можно использовать многопроцессорность или другие реализации Python. ��
Удаление GIL из Python: заметки со встречи Python Core и Сэма Гросса

Во время ежегодного спринта разработчиков ядра Python мы встретились с Сэмом Гроссом, автором nogil — fork в Python 3.9, который удаляет GIL. Ниже — итоги встречи.
tl;dr
Работа Сэма демонстрирует возможность удалить GIL таким образом, чтобы полученный интерпретатор Python был производительным и хорошо масштабировался на все ядра CPU. Чтобы получить прирост производительности, требуются, на первый взгляд, несвязанные по изменению работы интерпретатора задачи.
В настоящее время добавить изменения Сэма в CPython невозможно, потому что они сделаны в легаси-ветке 3.9. Это сделано, чтобы пользователи могли протестировать итоговый nogil -интерпретатор в версии 3.9 с помощью доступных pip-пакетов и С-расширений. Чтобы смёржить nogil , необходимо внести изменения в main -ветку, которая скоро должна стать 3.11.
Не ожидайте, что Python 3.11 уже откажется от GIL. Даже само добавление работы Сэма в CPython будет трудоемким процессом, а ведь это только часть того, что нужно. Прежде, чем CPython удалит GIL, потребуется очень хорошая обратная совместимость и план миграции для сообщества. Пока что ничего из этого не запланировано. Мы все еще можем отказаться от этого решения в теории.
Когда говорят об изменениях такого масштаба, некоторые люди думают про Python 4. Но разработчики ядра пока не очень-то планируют выход Python 4. По правде говоря, все наоборот: мы очень стараемся не выпускать Python 4 — с тех пор, как переход со 2-й версии на 3-ю оказался сложным для сообщества. Определенно, еще слишком рано строить предположения и беспокоиться о 4-й версии.
Введение в nogil
Сэм опубликовал свой код вместе с детальным описанием, где объясняет необходимость и основные мысли своего форка.
Главные пункты всей идеи можно объяснить так:
- замена встроенного в Python аллокатора pymalloc на mimalloc для:
- обеспечения потокобезопасности, включая взаимодействие, необходимое для неблокирующего доступа на чтение словарей и других коллекций
- эффективности — конструкция heap-памяти позволяет находить отслеживаемые GC-объекты без необходимости поддерживать их явный список
- связывает каждый объект с потоком-владельцем, который его создал — owner thread
- обеспечивает эффективный неатомарный подсчет локальных ссылок в owner thread
- разрешает более медленный, но атомарный подсчет общих ссылок в других потоках
- некоторые особые объекты сделаны бессмертными: количество их ссылок никогда не будет вычислено, и они никогда не будут деаллоцированы: это относится к таким синглтонам, как None, True, False, другим небольшим целым числам и интернированным строкам, а также статично аллоцированым PyTypeObjects для встроенных типов
- отложенный подсчет ссылок используется для других глобально доступных объектов, вроде функций верхнего уровня, объектов кода и модулей. Они не сделаны бессмертными, потому что не всегда сохраняются на всем сроке жизни программы
- ожидает остановки всех потоков на безопасной точке, на любой границе байт-кода
- не ожидает потоков, заблокированных на вводе-выводе, и использующих PyEval_ReleaseThread , аналог отпускания GIL в текущей версии Python
- эффективно создает список объектов для just-in-time деаллокации. Благодаря использованию mimalloc , GC-отслеживаемые объекты все хранятся в отдельной легковесной куче
Полная документация концепции Сэма включает детальное описание работы этих элементов, а также информацию по состоянию потоков и GIL API, другие модификации интерпретатора и байт-кода: замена стековой виртуальной машины на регистровую виртуальную машину с накопителем; оптимизирование вызовов функций без создания С стек-фреймов; другие изменения в ceval.c ; использование указателей с тегами; потокобезопасные метаданные для опкодов LOAD_ATTR, LOAD_METHOD, LOAD_GLOBAL. Это не полный список, поэтому я советую прочесть документацию целиком.
Ранние бенчмарки
В наборе тестов pyperformance Proof-of-concept no-GIL версия оказалась на 10% быстрее, чем 3.9. По оценкам, удаление GIL в комбинации с изменениями в интерпретаторе, большая часть которых связана со смещенным и отложенным подсчетами ссылок, снизит скорость примерно на 9%. Другими словами, Python 3.9 со всеми другими изменениями, но без удаления GIL, будет быстрее на 19%. Однако это не решит проблему многоядерной масштабируемости.
Кстати, некоторые из этих изменений, например отделение стека вызовов С от стека вызовов Python, уже добавлены в Python 3.11. У нас уже есть предварительные тесты для текущей main -ветки, которые показывают, что изменения в Python 3.11, которые касаются производительности, делают его на 16% быстрее, чем nogil в однопоточном режиме.
Необходимо больше тестов, особенно с использованием того, что Ларри Гастингс использовал при тестировании Gilectomy — сначала на основе Python 3.5, позже портированное на версию 3.6 alpha 1.
Сэм напоминает нам, что масштабируемость конечного приложения на Python без GIL сильно зависит от собственно кода. Без тестирования в реальных условиях невозможно предсказать, как поведет себя ваш код без GIL. Следовательно, невозможно ответственно заявлять, во сколько раз быстрее будет Python без GIL.
Вопросы к Сэму на встрече
Для лучшего понимания вопросы ниже изложены в другом порядке по сравнению с реальной встречей. Ответы отредактированы и согласованы с Сэмом перед финальной публикацией. Обратите внимание, что мнение команды разработки ядра не всегда полностью совпадает.
Какова вероятность того, что nogil в итоге окажется нежизнеспособным для включения в CPython?
Кодовая база в сегодняшнем виде уже доказывает, что это технически возможно. Проект работает, и он более производительный и масштабируемый, чем исходный CPython и проект Gilectomy. На текущий момент внедрение можно оценить по времени примерно в 2 года фуллтайм-работы.
Все зависит от того, насколько хорошо сообщество адаптирует С-расширения, чтобы они не вызывали сбоев в интерпретаторе. Еще важно, чтобы люди использовали потоки в приложениях одновременно правильным и хорошо масштабируемым образом. Это главные проблемы, но следует быть оптимистами.
Как вы планируете синхронизировать свою работу с main? Есть ли какие-то советы по порядку коммитов?
Сейчас Сэм работает над обновлением своей версии, первоначально созданной под версию 3.9.0а3. Новая версия должна совпадать с финально выпущенной 3.9.7. Часть этой работы — рефакторинг коммитов в логические юниты, которые могут лучше объяснить, что нужно заменить и зачем.
В настоящее время нет плана по переносу всей работы в main , будущую версию 3.11. Причина в том, что эта ветка слишком быстро меняется. К версии 3.9, напротив, существует много выпущенных pip-библиотек и C-расширений для тестирования. Это позволяет Сэму оценить, как проект ведет себя в реальной жизни со сторонним кодом. Rebase до main отнимет время, которое можно потратить на улучшение интерпретатора без GIL. Так что сейчас, возможно, слишком рано фокусироваться на синхронизации форка с апстримом.
Разделение работы, чтобы ее можно было смёржить, выполнимо, но вы должны помнить, что многие изменения положительно влияют на производительность в совокупности. По отдельности они — возможно, временно — только снижают производительность.
Примечание команды разработчиков ядра: сейчас мы не можем интегрировать изменения, внесенные в версию 3.9. На этом этапе может иметь смысл использовать 3.9, но критически важно разбить ее на составные части, которые можно интегрировать в main одну за другой. Такое внедрение шаг за шагом может повредить производительности, но это единственный возможный путь к интеграции.
Можем ли мы просто извлечь регистровую виртуальную машину и компилятор без изменений? Предвидите ли вы какие-то специфические сложности, связанные с использованием регистровой виртуальной машины без подсчета ссылок или изменений в GIL?
Виртуальная машина использует deferred/immortal подсчет ссылок. Теоретически его можно просто конвертировать в классический подсчет, но неясно, насколько эффективным будет результат. Например, все объекты в стеке используют отложенный подсчет ссылок из-за соображений производительности.
И обратный вопрос: насколько сложно будет внедрить nogil без новой виртуальной машины на основе регистров?
Хотя новая виртуальная машина на основе регистров улучшит только производительность, но не корректность, она также улучшит масштабируемость, что позволит Python использовать доступные ядра без конфликтов. Возможно также использовать версию 3.11, но с некоторыми дополнениями из ВМ на основе регистров, которые важны для масштабируемости и потокобезопасности. Это довольно значительный объем работы. Но обновление ВМ на основе регистров для согласования с main-веткой — плюс исправление оставшихся ошибок — тоже потребует большого труда. Оба варианта возможны.
Каковы ваши рекомендации для С-расширений, чей код не предполагает параллельного запуска с основными потоками? Потребуется ли дополнительная поддержка API от CPython для восполнения пробелов, пока они не будут адаптированы для работы в новой среде со свободными потоками?
На это потребуется время. Конечная цель — постепенное внедрение большинством С-расширений. GIL по-прежнему будет доступен как опция при запуске интерпретатора. Если он не включен, и С-расширение не знает об этом режиме, оно может выдать предупреждение или не выполнить импорт. Сообществу понадобится адаптировать расширения и включить их в режим без GIL.
PoC уже сейчас запускается без GIL и принимает любые С-расширения, потому что это то, чего ожидают пользователи, скачивая nogil . Если это общепринято, имеет смысл начать с противоположного: требовать от Python запуска с флагом -X nogil , чтобы дать время сторонним библиотеками адаптироваться. Затем, после нескольких релизов, значение по умолчанию может быть изменено на обратное.
Хотя перенести все будет непросто (параллельность — это сложно), во многих случаях это не должно быть большой проблемой, особенно для С-расширений, оборачивающих внешние библиотеки.
Примечание команды разработчиков ядра: существует большое количество не open-source кода Python и С-расширений в формате «темной материи». Нам необходимо быть осторожными, чтобы не сломать его, потому что для пользователей этих продуктов может быть невозможно внести требуемые изменения, или послать нам отчет об ошибке. В частности, некоторые С-расширения защищают собственное внутреннее состояние с помощью GIL. Это — причина серьезного беспокойства, и может стать крупным препятствием для принятия Python без GIL.
Добавите ли вы «слот» PEP 489, который расширения смогут использовать для индикации поддержки nogil, и фейлиться при импорте в nogil, если не поддерживают?
Об этом много говорили, но все же не совсем понятно, что это значит. Включение режима без GIL не гарантирует отсутствие ошибок. Вместо этого мы можем разрешить запуск всех расширений по умолчанию — именно это сейчас происходит с nogil . Несовместимое расширение может вместо этого использовать код модуля PyInit для упреждающего запроса интерпретатора, включен ли GIL, и вызова предупреждения или даже исключения во время импорта, если нет.
Включение nogil во время запуска — это долгосрочная опция, или только на переходное время?
В идеале конечным результатом должен стать CPython без GIL, точка. Однако ожидается также длинный период адаптации сообщества. Мы хотим избежать раскола, как во время перехода с Python 2 на Python 3. Мы хотим облегчить переход, даже если его придется растянуть по времени.
Уточните, в финале предполагается исключительно nogil, без вариантов вернуть GIL обратно?
Мы пока не знаем. Лучшим вариантом будет только Python без GIL, но неясно, возможно ли это вообще.
Если эти фича-флаги продолжат существовать долгое время, потребуется ли сильное увеличение матрицы тестирования?
Да, вам потребуется дублирование матрицы тестирования. Однако тестирование версии без GIL может быть хорошим индикатором того, работает ли классическая версия GIL. Возможно, имеет смысл запускать тесты с включенным GIL только периодически, например в нерабочее время.
Примечание команды разработчиков ядра: код сильно регрессирует, если его не тестировать. В CPython мы не запускаем тесты на всё необходимое им время для каждого изменения — вроде эталонных тестов на утечку. Но если для изменений проваливаются тесты в нерабочее время, мы немедленно их отменяем, потому что часто регрессии подкрадываются к уже падающим сборкам.
Что вы думаете о параллельном запуске нескольких интерпретаторов Python с одним GIL для каждого?
В каком-то смысле это дополняет мое предложение без GIL, в каком-то — конкурирует с ним. В интерпретаторе без GIL должна быть возможность запуска субинтерпретаторов.
Непонятно, получит ли работа с субинтерпретаторами завершение. Без GIL меньше беспокойства насчет передачи объектов между потоками и совместимости С-расширений. С субинтерпретаторами нет по-настоящему глобального состояния, следовательно, их нужно специально изолировать. Передача объектов через субинтерпретаторы требует некоторой формы сериализации/десериализации для мутабельных объектов. Для неизменяемых в интерпретатор может быть добавлена специальная поддержка, но код пользователя должен сообщить о таких объектах, если они не встроены. Об этом говорится в работе на схожую тему от PyTorch, в которой используется этот вид субинтерпретаторов.
Те сценарии использования, которые больше всего интересовали Сэма, были по своей природе научными данными — обучение моделей PyTorch. Поэтому возможность прямого эффективного обмена данными имела решающее значение для многопоточной производительности. С субинтерпретаторами такое совместное использование можно было включить только на уровне C-расширений, вместо Python без GIL.
Вы очень подробно описали словари и списки. А что насчет других изменяемых типов, таких как очереди, множества, массивы?
Форк nogil находится в стадии разработки. Реализация словарей и списков потребовала большого количества работы, потому что именно они преобладают во внутренней работе интерпретатора. Похожая работа проделана в отношении очередей, но на этом пока все. Следующий большой шаг — множества.
Очередь очень важна, потому что используется для связи между потоками с concurrent.futures и asyncio . Очереди проще словарей и списков, они используют обычные локи вместо lock-free чтений. Некоторые другие объекты, возможно, потребуют комбинации подходов.
Это хитрая работа, поскольку вам нужно быть осторожными, когда захватываете и снимаете блокировки. Например, в Py_DECREF можно войти несколько раз. Для подобных вариантов можно рассмотреть варианты более «грубых» блокировок, хотя они, конечно, подвержены риску дэдлоков.
Как nogil зависит от mimalloc? Если он нужен нам в качестве необязательной опции компиляции, есть ли возможность менее производительной сборки, которая вместо mimalloc использует платформу malloc без C-preprocessor-hell?
mimalloc используется больше, чем просто для безопасности потоков. Его поддержка необходима для возможности чтения словарей без блокировки и эффективного отслеживания GC-объектов.
Мейнтейнер mimalloc заинтересован в поддержке CPython и открыт к необходимым изменениям, которые позволят это осуществить.
Остальные реализации malloc считаются стабильными при работе с Cpython: jemalloc , используемый в Facebook, tcmalloc , используемый в Google, хотя и с меньшей интеграцией, которая больше похожа на простую замену встроенного аллокатора.
Примечание разработчиков ядра: Кристиан Хеймс и Пабло Галиндо Сальгадо проводят оценку использования mimalloc для CPython. Ранние тесты не показывают спада производительности в среднем (по среднему геометрическому). Большинство тестов работает лучше, небольшое количество тестов работает немного хуже. Некоторые возможные проблемы при оценке:
— API mimalloc и стабильность ABI
— лицензирование
— переносимость на CPython-поддерживаемые платформы — например, stdatomic.h доступен только на С11
— интеграция с профилировщиками и санитайзерами: Valgrind, asan, ubsan
— и т.д.Что общего у вашего проекта с проектом Ларри Гастингса Gilectomy? Удалось ли вам применить какие-то из его работ?
Верхнеуровнево наши проекты похожи: отложенный подсчет ссылок, блокировки, борьба с проблемами возврата заимствованных ссылок. В этом проекте нет переиспользования кода Gilectomy.
Вы сказали, что верхнеуровнево ваши работы с Gilectomy похожи. Работа Ларри также основана на отложенном подсчете ссылок. Хотя в Gilectomy он наблюдал исключительно спад производительности, а ваш nogil, наоборот, обещает рост. Как вы думаете, откуда такая разница?
В росте производительности и масштабируемости nogil сыграли критическую роль переключение на компилятор на основе регистров и другие оптимизации. Например, чтение словарей без блокировки, основанное на mimalloc , и отсутствие конфликтов с отложенным подсчетом ссылок. Также в некоторых случаях Python и сам хорошо вырос в этом плане. Например, вызов функций в Python 3.9 требует гораздо меньше ресурсов, чем в Python 3.5.
Определенно, чтобы его масштабировать, потребовалось значительно больше усилий, чем ожидалось.
Возможно ли включение С-расширения в режим без GIL и отключение обратно?
Как и говорится в заголовке, GIL — просто глобальная блокировка. Чтобы он защищал все части общих данных, он должен быть включен на всех потоках, а не только на одном с несовместимым расширением.
В уже запущенных процессах довольно сложно переключить интерпретатор с режима без GIL на запуск с GIL и наоборот. Скорее, нужен переключатель при запуске, который разрешает или не разрешает GIL внутри процесса. С-расширения, не помеченные как совместимые, вызовут предупреждение или ошибку импорта.
Другой вариант — всегда делать stop the world при доступе С-расширения, но это не решает задачу удаления GIL с точки зрения производительности.
Примечание команды разработчиков ядра: есть несколько других вариантов, которые пока не до конца изучены. Один — конвертировать GIL в блокировку «много читателей — один писатель». При таком сценарии режим без GIL получает блокировку на чтение, без блокирования другого нового кода от того, чтобы сделать то же самое. Легаси-код получает блокировку на запись, блокируя все выполняющиеся остальные потоки до их освобождения. Эта схема потребовала бы сохранения API получения/отпускания GIL (что уже делает nogil ), чтобы сказать GC о том, что поток заблокирован при вводе-выводе.
Возможно ли пометить функции как небезопасные для потоков (например, используя декоратор), чтобы nogil принял это и учел во время запуска кода, чтобы не мешать другим потокам? Что-то вроде временного GIL?
Если речь о состоянии, доступ к которому получают извне, каждый доступ должен быть заблокирован. Это не особенно важно на уровне декораторов. Как я уже говорил, было бы сложно реализовать условное включение GIL для частей, включающих небезопасный код.
Самостоятельная работа с блокировками вместо того, чтобы положиться на GIL, может быть трудоемкой. Ожидаете ли вы вспышки проблем с nogil?
Сложно сказать. Для API C-расширений существует по меньшей мере один хороший паттерн проектирования: они часто имеют схожую структуру и сохраняют общее состояние в единой структуре. Pybind11 выглядит на данный момент совершенно непохожим на этот паттерн, так что большинство изменений могут потребоваться в С-расширениях, написанных с ним.
Много сложных С-расширений уже должны работать с блокировками и многопоточностью, потому что их цель — отпускать GIL как можно чаще. Например, numpy . Это неожиданно, но перенести их будет проще.
Следующие шаги
В продолжение этой встречи разработчики ядра обсудили возможность включения nogil в текущую разработку и значение этого шага для сообщества. Определенно, перемены такого масштаба требуют большой осторожности.
Прежде чем мы решимся на это, кажется правильным сначала представить часть кода. В частности, mimalloc выглядит интересным, и на его включение уже есть открытые пулл-реквесты . По этой ссылке можно найти бенчмарки.
На личном уровне мы впечатлены работой Сэма и пригласили его присоединиться к проекту CPython. С удовольствием сообщаю, что он заинтересован. Чтобы помочь ему стать core-разработчиком, я буду его наставником. Гвидо и Нил Шеменауэр помогут мне ревьюить код для тех частей интерпретатора, с которыми я не знаком.
- Блог компании KTS
- Python
Новости

Книга предназначена для опытных программистов, которые хотят больше узнать о продвинутых концепциях и новейших возможностях Python.
Она написана для тех, кому интересно оттачивать мастерство владения Python, и прежде всего для профессиональных разработчиков, которые зарабатывают на жизнь программированием на Python. Из этих соображений книга ориентирована прежде всего на инструменты и приемы, необходимые для создания производительного, надежного и простого в сопровождении кода на Python.
Однако это не значит, что для программистов-любителей здесь нет ничего интересного. Книга прекрасно подойдет всем, кто хочет изучить продвинутые концепции языка Python. Чтобы освоить материал книги, достаточно владеть базовыми навыками Python, хотя менее опытным программистам, возможно, понадобится приложить дополнительные усилия. Книга также послужит неплохим введением в новейшие возможности Python для тех, кто немного отстал и пока еще использует старые версии языка.
Разработка расширений на Cython
Именем Cython обозначается как оптимизирующий статический компилятор, так и язык программирования, являющийся надмножеством Python. Он помогает ускорять приложения на Python, компилируя их в машинный код, а также служит «языком-оберткой» для кода, написанного на C и C++.
Как компилятор, Cython транспилирует «родной» код на Python и Cython в расширения на C для Python, которые используют Python/C API. Это позволяет объединить мощь Python и C без необходимости вручную работать с Python/C API.
Как надмножество Python, Cython позволяет использовать статическую типизацию и статическую компоновку библиотек C (в отличие от динамической компоновки общих библиотек), взаимодействовать с заголовочными файлами C и напрямую управлять блокировкой GIL в CPython.
Для начала обсудим Cython как транспилятор.
Cython как транспилятор
Главное преимущество расширений, созданных с помощью Cython, — это использование соответствующего надмножества языка. Впрочем, можно создавать расширения и из обычного кода Python, применяя транспиляцию (компиляцию «исходный код — исходный код»). Это простейший вариант использования Cython, потому что он почти не требует изменений в коде и может заметно улучшить быстродействие с минимальными затратами.
Чтобы создавать расширения на Cython, вам прежде всего понадобится пакет Cython. Его можно установить из PyPI с помощью pip:
$ python3 -m pip install CythonВ Cython есть простая вспомогательная функция cythonize, которая позволяет легко интегрировать процесс компиляции с пакетом setuptools. Допустим, вы хотите откомпилировать реализацию функции fibonacci(), написанную на чистом Python, в расширение на C. Если она находится в модуле fibonacci.py, то минимальный сценарий setup.py может выглядеть так:
from setuptools import setup from Cython.Build import cythonize setup( name='fibonacci', ext_modules=cythonize(['fibonacci.py']) )Такой модуль можно установить через pip так же, как обычное расширение на C:
$ python3 -m pip install -e . Installing collected packages: fibonacci Running setup.py develop for fibonacci Successfully installed fibonacciЭта команда устанавливает пакет в режиме редактирования, благодаря чему можно просмотреть файлы, сгенерированные в процессе установки. Выполнив ее в своей командной оболочке, вы увидите, что она также создает дополнительные артефакты сборки:
$ ls -1ap ./ ../ build/ fibonacci.c fibonacci.cpython-39-darwin.so fibonacci.egg-info/ fibonacci.py setup.pyФайл fibonacci.c в этом выводе — это автоматически сгенерированный код расширения на C. Cython преобразовывает (транспилирует) обычный код на Python в код на C. В процессе установки этот код на C будет использоваться, чтобы сформировать библиотеку модуля расширения; в нашем случае это файл fibonacci.cpython-39-darwin.so.
Чтобы понять, какой объем работы Cython выполняет «под капотом», просмотрите файл fibonacci.c. Он получается довольно длинным. Даже для нашего простого модуля fibonacci.py его длина может превышать 4000 строк.
Если использовать Cython для того, чтобы компилировать исходный код на Python, это дает еще одно преимущество. В процессе установки пакета не всегда обязательно транспилировать его в расширение. Если в среде, где его надо установить, нет Cython или других предусловий сборки, возможна установка в виде обычного пакета Python. При такой модели распространения пользователь, как правило, не заметит никаких функциональных различий в поведении кода. Стандартная практика распространения расширений на Cython состоит в том, чтобы включать в дистрибутив как исходные файлы на Python/Cython, так и код C, сгенерированный из этих исходных файлов.
- Если в среде установки доступен Cython, код расширения на C генерируется на основе предоставленного исходного кода на Python/Cython.
- Если Cython недоступен, но доступны предусловия сборки (компилятор C, заголовки Python/C API), расширение собирается на основе предварительно сгенерированных файлов C, которые входят в дистрибутив.
- Если ни один из этих вариантов не доступен, а расширение состоит из исходного кода на чистом Python, то модули устанавливаются как обычный код Python, а этап компиляции пропускается.
С официальными рекомендациями по распространению кода на Cython можно ознакомиться по адресу cython.readthedocs.io/src/userguide/source_files_and_compilation.html.
Как бы то ни было, с появлением изолированных сред эта проблема, похоже, стала намного менее актуальной. Кроме того, Cython доступен в PyPI как полноценный пакет Python, поэтому можно легко определить его конкретную версию как требование проекта. Конечно, решение о таком предусловии влечет серьезные последствия и должно быть тщательно продумано.
Другой, более безопасный вариант — использовать функциональность extras_require из пакета setuptools, чтобы пользователь мог сам решить, хочет ли он использовать Cython с конкретной переменной среды:
import os from setuptools import setup, Extension try: # транспиляция Cython возможна, # только если Cython доступен # и специальная переменная среды явно сообщает, # что нужно использовать Cython, # чтобы генерировать исходный код на C USE_CYTHON = bool(os.environ.get("USE_CYTHON")) import Cython except ImportError: USE_CYTHON = False ext = '.pyx' if USE_CYTHON else '.c' extensions = [Extension("fibonacci", ["fibonacci"+ext])] if USE_CYTHON: from Cython.Build import cythonize extensions = cythonize(extensions) setup( name='fibonacci', ext_modules=extensions, extras_require=< # Эта конкретная версия Cython будет указана # в числе требований, если устанавливать пакет # с дополнительным ключом '[with-cython]' 'with-cython': ['cython==0.29.22'] > )pip поддерживает установку пакетов с дополнениями (extras), для чего к имени пакета добавляется суффикс [имя_дополнения]. Для приведенного примера можно запустить следующую команду, чтобы активировать необязательные требования к версии Cython и компиляцию из локальных источников во время установки:
$ USE_CYTHON=1 pip install .[with-cython]Переменная окружения USE_CYTHON гарантирует, что pip будет использовать Cython, чтобы компилировать исходные коды .pyx в C, а ключ [with-cython] — что компилятор Cython будет загружен перед установкой.
Хотя с помощью Cython можно компилировать код на обычном Python, гораздо эффективнее будет использовать диалект Cython. Он поддерживает ряд дополнительных возможностей, которые недоступны в обычном коде на Python. Специфические средства Cython рассматриваются в следующем разделе.
Cython как язык
Cython — не только компилятор, но и надмножество языка Python. Термин «надмножество» означает, что Суthon не только поддерживает любой действительный код Python, но и способен расширять его новыми возможностями, такими как вызов функций C или объявление типов C для переменных и атрибутов классов. Таким образом, любой код на Python также является кодом на Cython, но обратное не всегда верно. Это объясняет, почему обычные модули Python так легко компилируются в C с помощью компилятора Cython.
Но мы не остановимся на этом простом факте. Вместо того чтобы просто сказать, что наша эталонная функция fibonacci() также является кодом на Cython, мы попытаемся ее немного усовершенствовать. Это не приведет к реальной оптимизации, потому что мы по-прежнему реализуем вычисление чисел Фибоначчи в рекурсивном виде. Но мы внесем небольшие изменения, чтобы извлечь больше пользы от того, что код написан на Cython.
Для исходного кода Cython используется другое расширение файла — .pyx вместо .py. Содержимое файла fibonacci.pyx может выглядеть так:
"""Модуль Cython, реализующий числа Фибоначчи.""" def fibonacci(unsigned int n): """Возвращает n-е число Фибоначчи, вычисленное рекурсивно.""" if n == 0: return 0 if n == 1: return 1 else: return fibonacci(n - 1) + fibonacci(n - 2)По сути, изменилась только сигнатура функции fibonacci(). Благодаря необязательной статической типизации в Cython можно объявить аргумент n c типом unsigned int, и от этого функция будет работать немного эффективнее. Есть и дополнительный эффект: если аргумент функции Cython объявлен со статическим типом, то расширение будет автоматически обрабатывать ошибки преобразования и переполнения, порождая соответствующие исключения. Следующий фрагмент интерактивного сеанса показывает, как это происходит с функцией fibonacci(), написанной на Cython:
>>> from fibonacci import fibonacci >>> fibonacci(5) 5 >>> fibonacci(0) 0 >>> fibonacci(-1) Traceback (most recent call last): File "", line 1, in File "fibonacci.pyx", line 4, in fibonacci.fibonacci def fibonacci(unsigned int n): OverflowError: can't convert negative value to unsigned int >>> fibonacci(10 ** 10) Traceback (most recent call last): File "", line 1, in File "fibonacci.pyx", line 4, in fibonacci.fibonacci def fibonacci(unsigned int n): OverflowError: value too large to convert to unsigned intМы уже знаем, что Cython выполняет только транспиляцию (преобразование исходного кода в исходный код), а генерируемый код использует тот же Python/C API, с которым мы бы работали, если бы вручную писали расширения на C. Учтите, что функция fibonacci() является рекурсивной и поэтому очень часто вызывает саму себя. А значит, несмотря на то что мы объявили статический тип для входного аргумента, во время рекурсивного вызова функция будет рассматривать себя как любую другую функцию Python. Таким образом, n-1 и n-2 будут упаковываться обратно в объект Python, а затем передаваться скрытому уровню-обертке внутренней реализации fibonacci(), которая вернет их к типу unsigned int. Это будет повторяться снова и снова, пока программа не достигнет максимальной глубины рекурсии. Такая схема не обязательно является проблемой, но требует значительно большей обработки аргументов, чем действительно необходимо.
Чтобы сократить лишние затраты на вызовы функций Python и обработку аргументов, можно делегировать больше работы функции на чистом C, которая ничего не знает о структурах Python. Мы занимались этим раньше, когда создавали расширения на чистом C, и то же самое можно сделать в Cython. С помощью ключевого слова cdef объявляются функции в стиле C, которые принимают и возвращают только типы C:
cdef long long fibonacci_cc(unsigned int n): if n == 0: return 0 if n == 1: return 1 else: return fibonacci_cc(n - 1) + fibonacci_cc(n - 2) def fibonacci(unsigned int n): """ Возвращает n-е число Фибоначчи, вычисленное рекурсивно. """ return fibonacci_cc(n)Функция fibonacci_cc() не будет доступна для импортирования в итоговом скомпилированном модуле fibonacci. Вместо этого функция fibonacci() формирует фасад к низкоуровневой реализации fibonacci_cc().
Можно пойти еще дальше. В примере с обычным C мы показали, как снимать GIL на время вызова функции на чистом C, чтобы расширение лучше вело себя в многопоточных приложениях. В предыдущих примерах использовались макросы препроцессора Py_BEGIN_ALLOW_THREADS и Py_END _ALLOW_THREADS из заголовков Python/C API, чтобы пометить участки кода, в которых нет вызовов Python. Соответствующий синтаксис Cython немного компактнее и проще запоминается. Чтобы снять блокировку GIL вокруг участка кода, достаточно выполнить команду nogil:
def fibonacci(unsigned int n): """ Возвращает n-е число Фибоначчи, вычисленное рекурсивно. """ with nogil: return fibonacci_cc(n)Также можно пометить всю функцию в стиле C как безопасную для вызова без GIL:
cdef long long fibonacci_cc(unsigned int n) nogil: if n < 2: return n else: return fibonacci_cc(n - 1) + fibonacci_cc(n - 2)Важно знать, что объекты Python не могут быть ни аргументами, ни возвращаемыми типами таких функций. Каждый раз, когда функции с пометкой nogil нужно выполнить какой-нибудь вызов Python/C API, она должна установить GIL инструкцией gil.
Вы уже умеете создавать расширения Python двумя способами: в виде кода на обычном C с использованием Python/C API и с помощью Cython. Первый вариант предоставляет больше мощи и гибкости ценой более сложного и подробного кода, а во втором случае писать расширения проще, но Cython выполняет большую часть «черной магии» незаметно для вас. Мы также рассмотрели некоторые потенциальные достоинства расширений, поэтому пришло время поближе познакомиться с их потенциальными недостатками.
Недостатки расширений
Откровенно говоря, я перешел на Python только потому, что мне надоели сложности написания программ на C и C++. На самом деле многие программисты берутся за изучение Python, когда понимают, что другие языки не позволяют осуществить то, что нужно их пользователям.
По сравнению с C, C++ или Java программирование на Python выглядит легкой прогулкой. Вроде бы все здесь устроено просто и хорошо спроектировано. Начинает казаться, что тут вообще негде споткнуться, а другие языки программирования больше не нужны.
И конечно, это абсолютно не соответствует действительности. Безусловно, Python — замечательный язык со множеством интересных возможностей, и он востребован во многих областях. Но это не означает, что он идеален и у него нет недостатков. Код на Python легко писать и понимать, но за эту легкость приходится платить. Он выполняется не настолько медленно, как многие считают, однако никогда не догонит C. Python отличается высокой переносимостью, но его интерпретаторы доступны для меньшего количества архитектур, чем компиляторы некоторых других языков. И этот список можно было бы продолжить.
Чтобы преодолеть многие недостатки, можно разрабатывать расширения, которые позволяют задействовать в Python некоторые сильные стороны старого доброго C. В большинстве случаев этот подход неплохо работает. Вопрос в другом: разве мы пишем код на Python именно для того, чтобы расширять его с помощью C? Нет конечно. Это всего лишь неизбежное зло в ситуациях, где не удается придумать ничего лучше.
За расширения всегда приходится расплачиваться, и один из самых больших недостатков их использования — рост сложности.
Дополнительная сложность
Не секрет, что разрабатывать приложения на нескольких языках — непростая задача. Python и C — совершенно разные технологии, и между ними трудно найти что-то общее. Правда и в том, что не существует приложений, в которых вообще нет ошибок. Если активно использовать расширения в кодовой базе, отладка может стать весьма неприятной — не только из-за того, что отладка кода на C требует совершенно иных рабочих процессов и инструментов, но и потому, что вам придется слишком часто переключать мышление между двумя языками.
Все мы люди, и наши когнитивные способности ограниченны. Конечно, некоторые представители человеческого рода способны эффективно работать с несколькими уровнями абстракции одновременно, но похоже, такие люди встречаются очень редко. Каким бы опытным разработчиком вы ни были, за сопровождение таких гибридных решений всегда приходится платить повышенную цену. Это могут быть дополнительные усилия и время, необходимые для переключения между C и Python, или же лишний стресс, от которого ваша работа со временем может стать менее эффективной.
По статистике TIOBE, C до сих пор остается одним из самых популярных языков программирования. Однако, несмотря на это, программисты на Python очень часто знают его на минимальном уровне или не знают вообще. Лично я считаю, что C должен быть универсальным языком общения в мире программирования, но мое мнение вряд ли что-нибудь изменит.
Python также настолько соблазнителен и прост в изучении, что многие программисты забывают весь предыдущий опыт и полностью переключаются на новую технологию. Но не стоит думать, будто программирование — это что-то вроде умения ездить на велосипеде. Этот навык очень легко теряется, если не пользоваться им и не поддерживать квалификацию. Даже программисты с серьезной подготовкой в области C рискуют постепенно утратить свое мастерство, если погрузятся в Python слишком надолго.
Все сказанное приводит к простому выводу: вам будет труднее найти людей, которые способны понять и расширить ваш код. Для пакетов с открытым кодом это означает меньшее количество добровольных участников. Для закрытого кода это означает, что не все ваши коллеги смогут разрабатывать и сопровождать расширения, ничего не сломав при этом. А отлаживать сломанные расширения определенно сложнее, чем код на обычном Python.
Более сложная отладка
Дефектные расширения способны создать кучу проблем. Казалось бы, у статической типизации есть множество преимуществ перед обычным кодом на Python, и она позволяет выявить на стадии компиляции многие проблемы, которые было бы трудно обнаружить в Python, причем это даже не потребует скрупулезного тестирования и полного тестового покрытия. Однако это лишь одна сторона монеты.
Другая сторона заключается в том, что памятью приходится управлять вручную. А некорректное управление памятью — главная причина большинства ошибок в программах на C. В лучшем случае такие ошибки приведут к утечкам памяти, которые постепенно исчерпают ресурсы вашей среды. Впрочем, хотя это и лучший случай, это не означает, что с ним легко справиться. Утечки памяти очень трудно обнаружить без таких внешних инструментов, как Valgrind. Как правило, проблемы с управлением памятью в коде расширения приводят к ошибкам сегментации, с которыми невозможно бороться на уровне Python, а интерпретатор аварийно завершается, не порождая исключение, которое объясняло бы причину сбоя. Следовательно, в конце концов вам придется вооружиться дополнительными инструментами, которыми большинство программистов Python обычно не пользуются. От этого и среда разработки, и рабочие процессы становятся сложнее.
Недостатки расширений позволяют сделать вывод, что они не всегда оказываются оптимальным средством для интеграции Python с другими языками. Если вам нужно только взаимодействовать с уже готовыми общими библиотеками, иногда лучше помогает совершенно иной подход. В следующем разделе идет речь о том, как взаимодействовать с динамическими библиотеками, не используя расширения.
Об авторах
Михал Яворски (Michał Jaworski) более 10 лет профессионально разрабатывает программное обеспечение на разных языках. Большую часть этого времени Михал занимался высокопроизводительными распределенными бэкенд-сервисами для веб-приложений. Он работал на разных должностях в нескольких компаниях: от рядового разработчика до ведущего специалиста по архитектуре. Python всегда был и остается его любимым языком.
Тарек Зиаде (Tarek Ziadé) — программист из Бургундии (Франция). Он трудится в Elastic и создает инструменты для разработчиков. До Elastic 10 лет проработал в Mozilla и основал AFPy — французскую группу пользователей Python. Тарек также написал ряд статей о Python для разных журналов и несколько книг на французском и английском языках.
О научном редакторе
Тал Эйнат (Tal Einat) занимается разработкой программного обеспечения более 20 лет, и Python всегда был его основным языком. Тал входит в группу главных разработчиков языка Python с 2010 года. Он получил диплом бакалавра по математике и физике в Тель-Авивском университете. Тал увлекается пешим туризмом, компьютерными играми и философской научной фантастикой, а также любит проводить время с семьей.
В последние 8 лет Тал занимался образовательными технологиями: сначала в Compedia, где создал группу разработки обучающих приложений с использованием виртуальной и дополненной реальности, а потом в стартапе FullProof, где он является одним из основателей.
Сейчас Тал работает в стартапе Rhino Health, который разрабатывает и внедряет модели искусственного интеллекта в области медицины. Эти модели используют данные пациентов со всего мира, обеспечивая их конфиденциальность.