
SQL-запросы по-быстрому: краткий и понятный гайд
SQL (Structured Query Language) — это язык структурированных запросов. Он позволяет читать, записывать, удалять, сортировать и фильтровать информацию в базе данных.
Курс Project Manager.
Впроваджуйте покроковий алгоритм управління проєктами вже зараз. У цьому вам допоможе Павло Харіков — Head of IoT у Veon Group (Kyivstar).
В SQL используется немного слов. Он напоминает человеческий язык и поэтому его легко изучить. С его помощью можно работать с реляционными базами данных: пользователь отправляет SQL-запрос к базе данных через систему управления базами данных (СУБД). Последняя обрабатывает запрос и отправляет полученные данные пользователю.
Структура SQL-запроса
Запрос на выборку данных выглядит вот так:
SELECT ('столбцы через запятую или символ * для выбора всех столбцов') FROM ('таблицы через запятую') WHERE ('условие или фильтр') GROUP BY ('столбцы через запятую, по которым нужно сгруппировать данные') HAVING ('условие в уже сгрупированных данных') ORDER BY ('столбцы через запятую, по которым нужно отсортировать вывод')
Рассмотрим подробнее, как производится выборка.
SELECT и FROM
SELECT и FROM — обязательные ключевые слова в этом запросе. С их помощью можно указать, откуда и какие данные можно выбрать:
Курс Project Manager.
Впроваджуйте покроковий алгоритм управління проєктами вже зараз. У цьому вам допоможе Павло Харіков — Head of IoT у Veon Group (Kyivstar).
- К примеру, выбрать фамилии сотрудников из таблицы Employees:
SELECT last_name FROM Employees
- Получить только фамилию и размер зарплаты из этой же таблицы:
SELECT last_name, salary FROM Employees
Обратите внимание: имена столбцов указываются через запятую.
-
Выбрать все столбцы из таблицы Employees:
SELECT * FROM Employees
Для выборки всех столбцов применяется групповой символ «*». При его использовании столбцы будут возвращены, но иногда порядок может не соблюдаться.
Групповой символ упрощает запрос, но при этом снижает производительность. Поэтому лучше использовать его в редких случаях.
WHERE
Обычно нам нужна определенная информация из таблицы. Но как ее быстро найти? WHERE помогает извлечь информацию, отфильтровав ее по одному или нескольким условиям. Это очень удобно!
С WHERE применяются такие операции:
Курс QA Manual.
Успішна кар’єра в IT-сфері без необхідності глибоких знань програмування. Очікуйте заробітню плату в розмірі 600$ після завершення навчання.
Некоторые из операций приведены в нескольких вариантах, потому что в разных СУБД они указываются по-разному. Чтобы узнать, какие операции используются в вашей СУБД — смотрите ее документацию.
Теперь вернемся к практике. Например, вам нужно выбрать фамилии сотрудников с зарплатой свыше 1000. Применим WHERE:
SELECT last_name FROM Employees WHERE salary > 1000
Если требуется указать значение строки , заключите его в апострофы:
Курс Англійської.
Навчання для різних цілей та рівнів: робоча англійська, початковий рівень, курси для дітей та підлітків.
SELECT * FROM Employees WHERE department = 'Sales'
Фильтр по нескольким условиям
Данные можно фильтровать не только по одному, а и по нескольким условиям и значениям. Для этого используются операторы IN, NOT IN, AND, OR.
- Отфильтровать по нескольким значениям с дополнительными условиями:
SELECT * FROM Employees WHERE department IN ('IT', 'Marketing')
В результате этого запроса будут выбраны все сотрудники из подразделений ИТ и маркетинга.
- Отфильтровать по нескольким значениям с исключением:
SELECT * FROM Employees WHERE department NOT IN ('IT', 'Marketing')
Будут выбраны все сотрудники, кроме тех, кто работает в подразделениях ИТ и маркетинга.
- Выбрать сотрудников из ИТ-подразделения с зарплатой свыше 1000:
SELECT * FROM Employees WHERE department = 'IT' AND salary > 1000
- Выбрать сотрудников из ИТ-подразделения или с зарплатой свыше 1000:
SELECT * FROM Employees WHERE department = 'IT' OR salary > 1000
GROUP BY
С помощью необязательного предложения GROUP BY создаются группы данных. Это удобно для получения итоговых значений. Например, нужно узнать, сколько человек работает в отделе продаж. Инструкция может выглядеть так:
SELECT department, COUNT (*) AS cnt FROM Employees GROUP BY department
Этот код возвращает названия подразделений и количество работников в каждом из них. Количество сотрудников помещается в столбец с псевдонимом cnt, который мы задали с помощью ключевого слова AS.
Предложение GROUP BY указывается после WHERE и перед ORDER BY.
В GROUP BY можно указать столько столбцов, сколько нужно. В результате группы вкладываются друг в друга.
При вложении данные будут суммироваться для последней заданной группы, а не для отдельно для каждого столбца.
В предложении GROUP BY можно указать только столбцы выборки или выражения. В нем не указывается функция группирования и не применяются псевдонимы.
Если в столбце, по которому производится группирование, встречается одна или несколько строк со значением NULL, они выделяются в отдельную группу.
HAVING
С помощью предложения GROUP BY можно также указывать, какие группы включить в результат, а какие — исключить из него. Для этого используется предложение HAVING. Оно очень напоминает WHERE, но фильтрует не строки, а группы.
HAVING можно использовать с любыми операторами. В этом предложении используется тот же синтаксис, что и в предложении WHERE:
SELECT department, COUNT (*) AS cnt FROM Employees GROUP BY department HAVING COUNT(*) >= 3
Этот код похож на предыдущий, но возвращает только те группы, в которых найдены три или больше сотрудников. Фильтрация выполняется по итоговому значению группы. Этим HAVING отличается от WHERE, которое фильтрует по значениям строк.
Эти предложения можно использовать вместе. Например, можно узнать, сколько сотрудников в подразделениях со штатом более трех человек, получают более 1000:
SELECT department, COUNT (*) AS cnt FROM Employees WHERE salary > 1000 GROUP BY department HAVING COUNT(*) >= 3
Сначала выбираются все строки, где в столбце salary содержатся значения больше 1000. А затем выбираются только те группы, в которых не меньше трех записей.
ORDER BY
Предложение ORDER BY используется для сортировки результатов запроса. В нем указываются имена столбцов, по которым нужна сортировка.
Давайте отсортируем список фамилий сотрудников:
SELECT last_name FROM Employees ORDER BY last_name
В предложении ORDER BY можно указывать и те столбцы, которые не выбраны в операторе SELECT:
SELECT last_name FROM Employees ORDER BY salary
Так список фамилий сотрудников будет отсортирован по размеру зарплаты.
Сортировку можно выполнять и по нескольким столбцам. Для этого имена столбцов указывают через запятую:
SELECT first_name, last_name FROM Employees ORDER BY last_name, first_name
Так мы увидим список сотрудников, который сначала отсортирован по фамилии, а затем — по имени.
Вместо имен столбцов можно указать их порядковые номера в операторе SELECT:
SELECT first_name, last_name FROM Employees ORDER BY 2, 1
Этот код также возвращает список сотрудников с сортировкой по фамилии, а затем — по имени.
Сортировка по убыванию
В предыдущих примерах мы сортировали по возрастанию (это делается по умолчанию). Но можно сортировать и по убыванию. Для этого укажем слово DESC:
SELECT first_name, last_name FROM Employees ORDER BY last_name DESC
Так мы отсортируем список с именами и фамилиями в обратном алфавитном порядке.
Если обратная сортировка выполняется по нескольким столбцам, укажите ключевое слово DESC после каждого из них.
Слово DESC — это сокращение от слова DESCENDING. В запросах можно использовать как полную, так и сокращенную форму. Для сортировки в порядке возрастания тоже существует ключевое слово. Его полная форма — ASCENDING, а сокращенная — ASC. Поскольку по умолчанию выполняется сортировка по возрастанию, то это слово не указывают.
Объединение таблиц
Иногда нам нужны данные из нескольких таблиц. Рассмотрим пример:
SELECT first_name, last_name, order_id FROM Employees, Orders WHERE Employees. employee_id = Orders.employee_id
Этот код возвратит имена и фамилии сотрудников из таблицы Employees и номера заказов из таблицы Orders, которые выполнены соответствующими сотрудниками. В предложении WHERE имена столбцов указаны с именами соответствующих таблиц. Это необходимо, чтобы СУБД могла различать столбцы employee_id из разных таблиц.
Такое объединение называется внутренним. Для него можно использовать специальный синтаксис с ключевым словом INNER JOIN. Приведенный ниже код выдаст те же результаты, что и предыдущий фрагмент:
SELECT first_name, last_name, order_id FROM Employees INNER JOIN Orders ON Employees.employee_id = Orders.employee_id
Вместо предложения WHERE используется предложение ON, синтаксис которого совпадает с синтаксисом WHERE.
Число объединяемых таблиц в SQL не ограничено, но может ограничиваться в разных СУБД. Обратите внимание: чем больше таблиц объединяется, тем ниже производительность. Поэтому не рекомендуем объединять таблицы без особой необходимости.
Вместо заключения
SQL — простой для освоения и при этом мощный язык. Он появился в 1970-х и до сих пор используется, хотя наряду с ним появляются новые похожие языки. Этот язык используется различными СУБД: MySQL, SQLite, Oracle Database, Microsoft Access, Microsoft SQL Server, dBASE, IBM DB2.
Сегодня SQL — не просто язык формирования запросов. С его помощью можно упорядочивать и изменять данные, делать выборки, управлять доступом к ним, совместно использовать информацию и обеспечивать ее целостность. Пользуйтесь!
Це хороший спосіб розвитку вашої кар’єри в IT-індустрії. Після проходження курсу Mate гарантує вам офер мрії.
SQL-запросы: базовые команды и примеры

Чтобы создать таблицу, используют команду CREATE TABLE, новую запись — INSERT.
Анастасия Хамидулина
Автор статьи
14 июня 2022 в 15:01
SQL — язык структурированных запросов. Его создали в 1974 году, чтобы хранить и обрабатывать данные. Все реляционные СУБД — системы управления базами данных — используют его в качестве препроцессора для обработки команд. Сами же базы данных представляют наборы таблиц, где запись — это строка.
SQL в работе используют разработчики и тестировщики, чтобы улучшать сайт или приложение через грамотную работу с базами данных. Тестировщики таким образом помогают бизнесу принимать эффективные решения на основе данных. Маркетологи — глубже анализировать поведение пользователей.
Инженер-тестировщик: новая работа через 9 месяцев
Получится, даже если у вас нет опыта в IT
Виды SQL-запросов
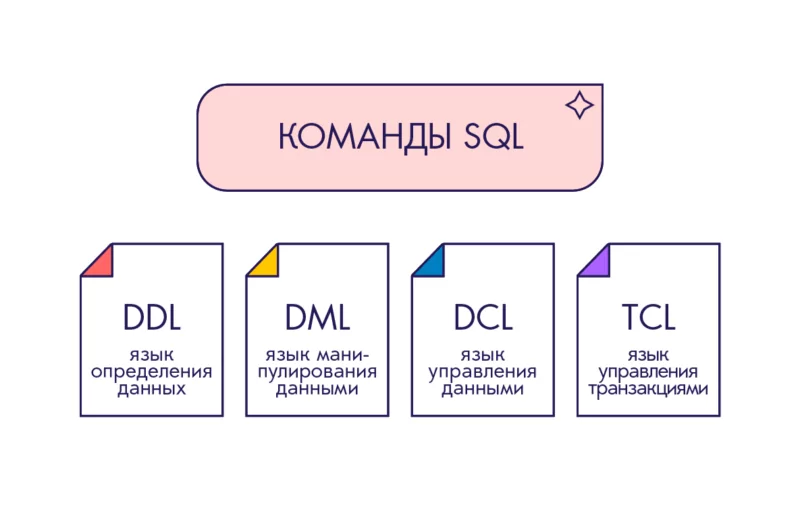
Ключевые слова этого языка делят на четыре логические группы.
1️⃣ DDL
Data Definition Language — язык определения данных. В него входят ключевые слова CREATE, DROP, RENAME и другие, которые относят к определению и манипулированию структурой базы данных. Их используют, чтобы создавать базы данных и описывать структуру, устанавливать, как размещать данные.
2️⃣ DML
Data Manipulation Language — язык манипулирования данными. В этой группе — запросы SELECT, INSERT, UPDATE, DELETE и другие. Их используют, чтобы изменять, получать, обновлять и удалять данные из базы.
3️⃣ DCL
Data Control Language — язык управления данными. К этой группе относят запросы разрешений, прав и различных ограничивающих доступ настроек. Например, GRANT или DENY.
4️⃣ TCL
Transaction Control Language — язык управления транзакциями. В эту группу входят все запросы, которые относят к управлению транзакциями и их жизненными циклами. Например, BEGIN TRANSACTION, ROLLBACK TRANSACTION, COMMIT TRANSACTION.
Особенности языка изучите на курсе «Аналитик данных». Под руководством наставников научитесь делать таблицы и составлять запросы для анализа. Сможете соединять и обрабатывать несколько таблиц, использовать оконные функции.
Структура SQL-запросов
https://sky.pro/media/sql-podzaprosy-rukovodstvo-po-ispolzovaniyu/
Запросы на языке SQL последовательны: логика их составления почти не отличается от обычного предложения. Например, вы хотите отфильтровать записи, чтобы получить только те, где в первом столбце значение равно единице. А после получить значения второго и третьего столбцов в выборке. Предложение на такую команду будет следующее:
Выбрать Столбец2, Столбец3 из Таблица1, где Столбец1 равен одному
На SQL это выглядит похоже:
SELECT (Column2, Column3) FROM Table1 WHERE Column1 = 1
Простые запросы SQL
Ключевые слова
Их используют, чтобы составить запросы:
Это ключевое слово отфильтровывает записи. Мы использовали его в абстрактном примере:
SELECT (Column2, Column3) FROM Table1 WHERE Column1 = 1
Группирует записи выборки по значениям указанных столбцов. Это ключевое слово должно следовать после WHERE.
✔️ AND, OR и BETWEEN
AND или OR расширяют выборку, создаваемую с помощью WHERE. Либо сужают ее, если указать дополнительные значения. Ключевое слово BETWEEN позволяет указать диапазон значений, чтобы создать выборку.
Лимитирует количество значений выборки. Например, по указанным фильтрам получено 100 значений, а нужны только первые 10. Тогда применяют синтаксис LIMIT 10.
На курсе «Анализ данных» несколько уроков посвящены тому, чтобы делать простые запросы на выборку, фильтрацию и сортировку данных, очищать и подготавливать их для анализа. На практике научитесь составлять разные комбинации, чтобы решать реальные задачи. Создадите проекты для портфолио, а если успешно окончите курс, получите диплом установленного образца.
Команды
С них начинаются запросы.
Предположим, нам необходимо создать базу данных, чтобы хранить информацию о прочитанных книгах, извлекать и изменять данные. В примерах мы будем использовать самую простую СУБД — sqlite3 в среде Linux. Создайте базу данных командой sqlite3 demo.db — и сразу попадете в командную строку программы:
sqlite3 demo.db SQLite version 3.27.2 2019-02-25 16:06:06 Enter ".help" for usage hints. sqlite>
�� CREATE TABLE
Чтобы создать таблицу, используют команду CREATE TABLE. Если создаете таблицу с прочитанными книгами, вероятно, понадобятся три столбца: id, название и автор.
sqlite> CREATE TABLE Books (id INTEGER PRIMARY KEY, title CHAR(255), author CHAR(255)); sqlite> .tables Books
Команда .tables отображает список таблиц.
�� INSERT
Команда создает новые записи. Добавим три книги в нашу таблицу:
sqlite> INSERT INTO Books(title, author) VALUES . > ("Язык SQL", "Неизвестный автор"), . > ("SQL. Сборник рецептов", "Энтони Молинаро"), . > ("Книга №3", "Без автора");
Указываем, в какие столбцы нужно вставить данные, игнорируя столбец id: он помечен как первичный ключ. Будет автоматически инкрементироваться, генерируя уникальные значения. В примере вставляем несколько записей за один запрос.
�� SELECT
Извлекает записи из таблицы:
sqlite> SELECT * FROM Books; 1|Язык SQL|Неизвестный автор 2|SQL. Сборник рецептов|Энтони Молинаро 3|Книга №3|Без автора
Каждая запись будет на новой строке, а значения столбцов — разделены вертикальной линией. Если, например, нужны не все, а определенные столбцы, то звездочку замените на названия столбцов через запятую:
sqlite> SELECT title, author FROM Books; Язык SQL|Неизвестный автор SQL. Сборник рецептов|Энтони Молинаро Книга №3|Без автора
�� UPDATE
Изменяет существующие записи. Чтобы использовать эту команду, укажите уникальный идентификатор изменяемой записи. Либо характеристику, по которой можно получить одну запись или группу из нескольких записей. Обновим авторов у первой и последней записи:
sqlite> UPDATE Books . > SET author = "Unknown" . > WHERE OR sqlite> SELECT title, author FROM Books; Язык SQL|Unknown SQL. Сборник рецептов|Энтони Молинаро Книга №3|Unknown
�� DELETE
Удаляет записи из таблицы по поисковому запросу. Удалим книгу с id, равным двум:
sqlite> DELETE FROM Books WHERE sqlite> SELECT * FROM Books; 1|Язык SQL|Unknown 3|Книга №3|Unknown
�� DROP TABLE
Удаляет таблицы из базы данных. Создадим и удалим демонстрационную таблицу:
sqlite> CREATE TABLE Demo (id INTEGER PRIMARY KEY, text TEXT); sqlite> sqlite> .tables Books Demo sqlite> sqlite> DROP TABLE Demo; sqlite> sqlite> .tables Books
�� ALTER TABLE
Команда в сочетании с другими ключевыми словами изменяет названия таблиц или добавляет новые столбцы. Изменим название нашей таблицы Books:
sqlite> ALTER TABLE Books RENAME TO MyBooks; sqlite> sqlite> .tables MyBooks
Добавим в нее новый столбец is_finished с булевым значением:
sqlite> ALTER TABLE MyBooks ADD COLUMN is_finished BOOLEAN; sqlite> UPDATE MyBooks . > SET is_finished = True; sqlite> sqlite> SELECT * FROM MyBooks; 1|Язык SQL|Unknown|1 3|Книга №3|Unknown|1
Агрегатные функции
Их используют, чтобы проводить дополнительные вычисления внутри полученной выборки:
✔️ COUNT(название_столбца) — возвращает количество строк выборки, где значение столбца не NULL.
✔️ SUM(название_столбца) — вычисляет и возвращает сумму значений в указанном столбце.
✔️ AVG(название_столбца) — вычисляет и возвращает среднее значение по столбцу.
✔️ MIN(название_столбца) — возвращает наименьшее значение для указанного столбца.
✔️ MAX(название_столбца) — возвращает наибольшее значение указанного столбца.
Научиться работе со всеми видами агрегатных функций можно на курсе «Анализ данных». Сможете взаимодействовать с синтаксисом и операторами для создания, модификации и удаления таблиц в SQL. В конце обучения у вас будет резюме, портфолио и диплом о профессиональной переподготовке. Это поможет устроиться на хорошую работу.
Вложенные подзапросы
Это SQL-запрос внутри другого SQL-запроса. Подзапросы помогают, если выборку фильтруют по значениям, которые тоже можно отфильтровать. Например, получим названия футбольных команд — участников соревнований с 2010 по 2020 годы:
SELECT DISTINCT club_name FROM clubs WHERE game_year = 2010 AND club_id IN (SELECT club_id FROM clubs WHERE game_year = 2020 );
Ключевое слово DISTINCT убирает из выборки дублирующиеся результаты.
Как писать запрос в sql

2. Для выбора всех столбцов из таблицы используем символ * .
SELECT * FROM Clients; 3. Команда SELECT может иметь необязательный оператор WHERE , позволяющий извлекать записи, соответствующие определенным условиям. Здесь мы выбираем из таблицы всех клиентов по фамилии Рабинович :
SELECT * FROM Clients; WHERE last_name = 'Рабинович'; 4. Здесь с помощью Select мы хотим получить всех клиентов из России :
SELECT age FROM Clients; WHERE country = 'Россия'; Примечание
В SQL мы должны заключать текстовые данные в одинарные или двойные кавычки.
5. Также для поиска достаточно часто используются условные операторы. В следующем примере мы извлекаем из таблицы всех клиентов, возраст которых превышает 25 лет:
SELECT * FROM Clients; WHERE age > 25; 6. А тут мы выбираем всех клиентов, по фамилии Рабинович проживающих в России .
SELECT * FROM Clients; WHERE last_name = 'Рабинович' AND country = 'Россия'; 7. Здесь SELECT выведет результат, если все условия, разделенные оператором AND , будут истинны. В данном случае команда выберет имена всех клиентов по фамилии Петров из России :
SELECT first_name FROM Clients; WHERE country = 'Россия' AND last_name = 'Петров'; По такому же принципу работает оператор OR (или), c той лишь разницей, что в этом случае система будет искать элементы таблицы, совпадающие хотя бы с одной частью условия.
8. Оператор SQL NOT выбирает строку, если заданное условие равно FALSE . Здесь мы выбираем имена и фамилии клиентов, проживающих во всех странах, кроме Латвии .
SELECT first_name, last_name FROM Clients; WHERE NOT country = 'Латвия 9. Также можно комбинировать несколько операторов AND , OR и NOT в одном запросе. В этом примере мы хотим выбрать клиентов из России или Беларуси , возраст которых меньше 26 .
SELECT * FROM Clients; WHERE (country = 'Россия' OR country = 'Беларусь') AND age < 26; 10. Оператор SQL SELECT DISTINCT выбирает уникальные, отличные от других, строки из таблицы. Здесь мы выводим неодинаковые страны проживания клиентов.
SELECT DISTINCT country FROM Clients; 11. А здесь мы выбираем неодинаковые комбинации параметров страна + имя .
SELECT DISTINCT country, first_name FROM Clients; 12. Если нам нужно подсчитать количество уникальных строк, мы можем использовать функцию COUNT() в совокупности с оператором DISTINCT . Здесь команда SELECT возвращает количество уникальных стран:
SELECT COUNT(DISTINCT country) FROM Clients; 13. Ключевое слово AS используется для присвоения столбцам или всей таблице временного имени, которое позже можно использовать для его или ее идентификации соответственно. Здесь переименовываем столбец first_name на name .
SELECT first_name AS name FROM Clients; 14. Оператор TOP используется для выбора фиксированного количества строк из базы данных. В примере ниже мы выбираем первые 2 строки из таблицы.
SELECT TOP 2 * FROM Clients; 15. Ключевое слово LIMIT используется со следующими системами баз данных: MySQL, PostgreSQL, SQLite. Здесь мы ограничиваем вывод имени и возраста клиента двумя первыми строками таблицы.
SELECT first_name, age FROM Clients; LIMIT 2; 16. Оператор IN используется с предложением WHERE для сопоставления значений в списке. Здесь мы выбираем имена клиентов, проживающих либо в России , либо в Латвии .
SELECT first_name, country FROM Clients; WHERE country IN ('Россия', 'Латвия'); 17. Оператор IN также можно использовать для выбора строк с определенным значением. Здесь выбираются строки со значением Россия в поле country .
SELECT first_name, country FROM Clients; WHERE 'Россия' in (country); 18. Ключевое выражение ORDER BY используется для сортировки результирующего набора выводимых данных в порядке возрастания или убывания. В этом примере мы выбираем всех клиентов, а затем сортируем их в порядке возрастания по имени (т. е. по алфавиту).
SELECT * FROM Clients; ORDER BY first_name; 19. Чтобы явно отсортировать выбранные записи в порядке возрастания, используем ключевое слово ASC . В примере мы выбираем всех клиентов, а затем сортируем их в порядке возрастания по возрасту.
SELECT * FROM Clients; ORDER BY age ASC; Ключевое слово DESC применяется для аналогичной сортировки, только в порядке убывания.
20. Также мы можем использовать ORDER BY при работе с несколькими столбцами. В конструкции ниже мы выбираем все записи, а затем сортируем их по имени. Если имя повторяется более одного раза, SQL сортирует данные по возрасту.
SELECT * FROM Clients; ORDER BY first_name, age; 21. Можем использовать ORDER BY вместе с ключевым словом WHERE . В примере мы сначала выбираем данные о фамилии и возрасте клиентов не из России . Затем выбранные записи сортируем в порядке убывания по фамилии:
SELECT last_name, age FROM Clients; WHERE NOT country = 'UK' ORDER BY last_name DESC; 22. Здесь мы группируем строки по параметру country и подсчитываем количество повторяющихся стран с помощью функции COUNT() .
SELECT country, COUNT(*) AS number FROM Clients; GROUP BY country; Это далеко не полный список вариантов использования команды SELECT при работе с базами данных. Комбинаций довольно много. Однако, важно понять базовый принцип написания таких запросов. По большому счету, язык запросов не так сложен и основные команды при должной усидчивости можно освоить за неделю. Ну а дальше – практика, а практический опыт накапливается долго. Удачи в обучении.
Материалы по теме
- �� Руководство по SQL для начинающих. Часть 1: создание базы данных, таблиц и установка связей между таблицами
- �� Руководство по SQL для начинающих. Часть 2: фильтрация данных, запрос внутри запроса, работа с массивами
- �� Руководство по SQL для начинающих. Часть 3: усложняем запросы, именуем вложенные запросы, анализируем скорость запроса
- SQL за 20 минут
Руководство по SQL: Как лучше писать запросы Часть 2 Хабр
Нет никаких препятствий для использования в качестве СУБД MS Access, но для задач веб-программирования гораздо лучше подходит альтернативная программа — MySQL. Кроме того, SQL очень простой язык по своей структуре, поэтому его освоение не составит большого труда. Другой подход, называющийся мемоизацией, заключается в построении дерева, узлами которого являются группы операций, и построение с их помощью итогового результата. Для этого каждому оператору в группе присваивается оценка стоимости и на каждом уровне выбирается один «победитель» — наиболее оптимальный оператор из своей группы.
Первое, что делает при таком подходе оптимизатор – строит дерево запроса. Перейдем к более интересному, на мой взгляд, подходу — стоимостному. Его идея заключается в оценке эффективности плана выполнения на основании некоторого параметра. Этим параметром может быть время выполнения, количество https://deveducation.com/ физических обращений к диску, размеры промежуточных выборок из БД и т.д. Внедрение в запрос ключевого слова DISTINCT способствует извлечению из выборки повторяющихся результатов. Прежде всего, давайте рассмотрим, что представляет собой база данных и каковы особенности ее иерархии.
Целостность данных
Однако, не забывайте, что практика – ключ к успеху, поэтому не забывайте регулярно выполнять практические задания и проекты для закрепления изученного материала. В 2023 году SQL (Structured Query Language) остается одним из самых популярных языков программирования, используемых в области баз данных и аналитики данных. Изучение SQL может быть полезным как для тех, кто только начинает свой путь в IT, так и для опытных профессионалов, которые хотят расширить свои знания и навыки. В этой статье мы рассмотрим несколько советов и ресурсов, которые помогут вам изучать SQL в 2023 году, и оставаться в курсе последних тенденций и изменений в этой области. Этот лучший онлайн-курс по SQL полон упражнений, задач, проектов и возможностей применить на практике то, что вы изучаете. Вы можете применить полученные знания для решения реальных задач, таких как поиск опытных пользователей веб-сайта, подсчет лучших учеников, выявление ботов на сайте.
VIEW — это виртуальная таблица SQL, созданная в результате выполнения выражения. Она содержит строки и столбцы и очень похожа на обычную SQL-таблицу. VIEW всегда показывает самую свежую информацию из базы данных. Создание таблицы предполагает указание названия таблицы и определение колонок таблицы и их типов данных. Огромное количество программ позволяют выбирать данные для финансовых и других отчетов в считанные минуты. Безусловно, в сочетании SQL SELECT позволяют проводить все необходимые действия, изложенные на примерах данной страницы.
Data Definition Language
В примере с созданием новой таблицы при перечислении необходимых полей первым полем идёт id INT AUTO_INCREMENT PRIMARY KEY. Язык SQL — это в первую очередь язык запросов, а кроме того он очень похож на естественный язык. Каждый раз, когда требуется прочитать или записать любую информацию в БД, требуется составить корректный запрос. Следуя этому roadmap, вы сможете изучить пройтись по SQL за 2 месяца и получить достаточно знаний для работы с базами данных и анализа данных.
Возможность редактирования отдельных данных допускается не для всех. Вот здесь то и пригодятся привилегии, которые допускает язык запросов sql. Вы сможете создать систему паролей и отсечь часть пользователей от активных действий. Раздел индексы, языка запроса sql, объясняет, как добиться максимальной производительности системы. Использование индексации позволит серверу легко и быстро находить данные.
Индексы
Предположим, вам необходимо понять, какие кафе и рестораны готовят роллы «Филадельфия» и доставляют круглосуточно. Прежде чем углубляться в терминологию SQL, приведём один пример. Представьте большую таблицу, в которой есть информация обо всех ресторанах и кафе в городе, готовящих суши и роллы. Из неё можно узнать адреса заведений, ассортимент, прайс на конкретную продукцию, наличие и стоимость доставки, состав блюд и др. В данном SQL примере мы выбираем все столбцы поля, у которого столбец status равен ‘Важные новости’.
Рассмотрены такие общие типы как команды определения данных, команды языка управления, управление транзакциями и манипулирование данными. Детально описан синтаксис команды, назначение, и конечный результат ее действия. Еще один серьезный раздел сайта посвящен условиям языка запроса sql. Здесь подробно описано как организовать обработку данных определенным образом.
Выполнение запросов
Представления могут содержать все или только некоторые строки таблицы. Представление может быть создано на основе одной или нескольких таблиц (это зависит от запроса для создания представления). Индексы — это специальные поисковые таблицы (lookup tables), которые используются движком БД в целях более быстрого извлечения данных.
- Но отличие от массивов всё-таки есть, и при этом достаточно важное — объекты могут иметь внутреннее состояние.
- Представление может быть создано на основе одной или нескольких таблиц (это зависит от запроса для создания представления).
- Примером таких сайтов являются форумы или корпоративные сайты.
- В свою очередь стоимостью плана называется сумма стоимостей всех входящих в него операторов.
Ее отличие от DROP TABLE состоит в том, что сохраняется структура таблицы (DROP TABLE полностью удаляет таблицу и все ее данные). Если в данном случае опустить WHERE, то из таблицы users будут удалены все записи. Эта инструкция, обычно, используется в сочетании с предложением WHERE. Существует несколько встроенных функций, таких как count(), sum(), avg(), min(), max() и др.
Как устроена база данных
Ограничения могут устанавливаться как на уровне колонки, так и на уровне таблицы. Изучение настоящей шпаргалки не сделает вас мастером SQL, но позволит получить общее представление об этом языке программирования и возможностях, которые он предоставляет. Рассматриваемые в шпаргалке возможности являются общими для всех или большинства диалектов SQL.
insert into
Здесь для вычисления оптимального плана на i-м уровне дерева вычисляются все планы на i-1-м уровне дерева, и из них выбирается наилучший. Очевидно, что при таком подходе выбор оптимального плана выродится в полный перебор всех вариантов, поэтому для использования на практике его нужно модифицировать. Так П.Г.Сэлинджер предложила рассматривать запросы sql только левосторонние деревья, у которых при этом элементы на левой ветви имеют минимальную оценку кардинальности. Перечислением планов называется выбор наиболее оптимальной последовательности выполнения соединений. Важно помнить про время построения плана при использовании слишком большого числа соединений таблиц в одном запросе.