
Я хочу стянуть информацию с сайта. Как это сделать?
Допустим, нам нужно получить данные с сайта, сбор которых вручную нецелесообразен или невозможен из-за объёма. В таком случае мы можем автоматизировать процесс, используя инструменты, описанные далее.
Библиотека requests
Python-библиотека для выполнения запросов к серверу и обработки ответов. Фундамент скрипта для парсинга и наше основное оружие. Пользуясь данной библиотекой мы получаем содержимое страницы в виде html для дальнейшего парсинга.
import requests response = requests.get('https://ya.ru') # get-запрос print(response.text) # вывод содержимого страницы payload = 'key1': 'value1', 'key2': 'value2'> response = requests.get('http://httpbin.org/get', params=payload) # запрос с параметрами headers = 'user-agent': 'my-app/0.0.1'> response = requests.get(url, headers=headers) # запрос с определенными html заголовками API
Application programming interface — программный интерфейс приложения, предоставляемый владельцем веб-приложения для других разработчиков. Отсутствие API, способного удовлетворить наши нужды — первое в чем стоит убедиться прежде чем бросаться анализировать исходный код страницы и писать для нее парсер. Множество популярных сайтов имеет собственное api и документацию, которая объясняет как им пользоваться. Мы можем использовать api таким образом — формируем http-запрос согласно документации, и получаем ответ при помощи requests.
BS4
Beautifulsoup4 — это библиотека для парсинга html и xml документов. Позволяет получить доступ напрямую к содержимому любых тегов в html.
from bs4 import BeautifulSoup soup = BeautifulSoup(raw_html, 'html.parser') print(soup.find("p", class_="some-class").text) # вывод содержимого тэга 'p' классом 'some-class' Selenium Web Driver
Данные на сайте могут генерироваться динамически при помощи javascript. В таком случае спарсить эти данные силами requests+bs4 не удастся. Дело в том, что bs4 парсит исходный код страницы, не исполняя js. Для исполнения js кода и получения страницы, идентичной той, которую мы видим в браузере, можно использовать selenium web driver — это набор драйверов для различных браузеров, снабжающийся библиотеками для работы с этими драйверами.
А что делать, если там авторизация?
Предварительно авторизоваться, отправив post-запрос и инициировать сессию:
session = requests.Session() data = "login_username":"login", "login_password":"password"> url = "http://site.com/login.php" response = session.post(url, data=data) А что, если сайт банит за много запросов?
- Установить задержку между запросами:
response = requests.get(url, timeout=(10, 0.01)) # таймаут на соединения, таймаут на чтение (в секундах) - Притвориться браузером, используя selenium web driver или передав содержимое заголовка user-agent, формируя запрос:
user_agent = ('Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:50.0) ' 'Gecko/20100101 Firefox/50.0') request = requests.get(url, headers='User-Agent':user_agent>) - Использовать прокси:
request = requests.get(url, proxies="http":"http://10.10.1.10:3128">) Попробуйте бесплатные уроки по Python
Получите крутое код-ревью от практикующих программистов с разбором ошибок и рекомендациями, на что обратить внимание — бесплатно.
Переходите на страницу учебных модулей «Девмана» и выбирайте тему.
Web Parsing. Основы на Python
Рассмотрим еще один практический кейс парсинга сайтов с помощью библиотеки BeautifulSoup: что делать, если на сайте нет готовой выгрузки с данными и нет API для удобной работы, а страниц для ручного копирования очень много?
111K открытий
Недавно мне понадобилось получить данные с одного сайта. Готовой выгрузки с информацией на сайте нет. Данные я вижу, вот они передо мной, но не могу их выгрузить и обработать. Возник вопрос: как их получить? Немного «погуглив», я понял, что придется засучить рукава и самостоятельно парсить страницу (HTML). Какой тогда инструмент выбрать? На каком языке писать, чтобы с ним не возникло проблем? Языков программирования для данной задачи большой набор, выбор пал на Python за его большое разнообразие готовых библиотек.
Примером для разбора основ возьмем сайт с отзывами banki_ru и получим отзывы по какому-нибудь банку.
Задачу можно разбить на три этапа:
- Загружаем страницу в память компьютера или в текстовый файл.
- Разбираем содержимое (HTML), получаем необходимые данные (сущности).
- Сохраняем в необходимый формат, например, Excel.
Инструменты
Для начала нам необходимо отправлять HTTP-запросы на выбранный сайт. У Python для отправки запросов библиотек большое количество, но самые распространённые urllib/urllib2 и Requests. На мой взгляд, Requests — удобнее, примеры буду показывать на ней.
А теперь сам процесс. Были мысли пойти по тяжелому пути и анализировать страницу на предмет объектов, содержащих нужную информацию, проводить ручной поиск и разбирать каждый объект по частям для получения необходимого результата. Но немного походив по просторам интернета, я получил ответ: BeautifulSoup – одна из наиболее популярных библиотек для парсинга. Библиотеки найдены, приступаем к самому интересному: к получению данных.
Загрузка и обработка данных
Попробуем отправить запрос HTTP на сайт, чтобы получить первую страницу с отзывами по какому-нибудь банку и сохранить в файл, для того, чтобы убедиться, получаем ли мы нужную нам информацию.
import requests from bs4 import BeautifulSoup bank_id = 1771062 #ID банка на сайте banki.ru url = ‘https://www.banki.ru/services/questions-answers/?id=%d&p=1’ % (bank_id) # url страницы r = requests.get(url) with open(‘test.html’, ‘w’) as output_file: output_file.write(r.text)
После исполнения данного скрипта получится файл text.html.
Открываем данный файл и видим, что необходимые данные получили без проблем.
Теперь очередь для разбора страницы на нужные фрагменты. Обрабатывать будем последние 10 страниц плюс добавим модуль Pandas для сохранения результата в Excel.
Подгружаем необходимые библиотеки и задаем первоначальные настройки.
import requests from bs4 import BeautifulSoup import pandas as pd bank_id = 1771062 #ID банка на сайте banki.ru page=1 max_page=10 url = ‘https://www.banki.ru/services/questions-answers/?id=%d&p=%d’ % (bank_id, page) # url страницы
На данном этапе необходимо понять, где находятся необходимые фрагменты. Изучаем разметку страницы с отзывами и определяем, какие объекты будем вытаскивать из страницы.
Подробно покопавшись во внутренностях страницы, мы увидим, что необходимые данные «вопросы-ответы» находятся в блоках , соответственно, сколько этих блоков на странице, столько и вопросов.
result = pd.DataFrame() r = requests.get(url) #отправляем HTTP запрос и получаем результат soup = BeautifulSoup(r.text) #Отправляем полученную страницу в библиотеку для парсинга tables=soup.find_all(‘table’, <'class': 'qaBlock'>) #Получаем все таблицы с вопросами for item in tables: res=parse_table(item)
Приступая к получению самих данных, я кратко расскажу о двух функциях, которые будут использованы:
- Find(‘table’) – проводит поиск по странице и возвращает первый найденный объект типа ‘table’. Вы можете искать и ссылки find(‘table’) и рисунки find(‘img’). В общем, все элементы, которые изображены на странице;
- find_all(‘table’) – проводит поиск по странице и возвращает все найденные объекты в виде списка
У каждой из этих функций есть методы. Я расскажу от тех, которые использовал:
- find(‘table’).text – этот метод вернет текст, находящийся в объекте;
- find(‘a’).get(‘href’) – этот метод вернет значение ссылки
Теперь, уже обладая этими знаниями и навыками программирования на Python, написал функцию, которая разбирает таблицу с отзывом на нужные данные. Каждые стадии кода дополнил комментариями.
def parse_table(table):#Функция разбора таблицы с вопросом res = pd.DataFrame() id_question=0 link_question=» date_question=» question=» who_asked=» who_asked_id=» who_asked_link=» who_asked_city=» answer=» question_tr=table.find(‘tr’,<'class': 'question'>) #Получаем сам вопрос question=question_tr.find_all(‘td’)[1].find(‘div’).text.replace(‘
‘,’\n’).strip() widget_info=question_tr.find_all(‘div’, ) #Получаем ссылку на сам вопрос link_question=’https://www.banki.ru’+widget_info[0].find(‘a’).get(‘href’).strip() #Получаем уникальным номер вопроса id_question=link_question.split(‘=’)[1] #Получаем того кто задал вопрос who_asked=widget_info[1].find(‘a’).text.strip() #Получаем ссылку на профиль who_asked_link=’https://www.banki.ru’+widget_info[1].find(‘a’).get(‘href’).strip() #Получаем уникальный номер профиля who_asked_id=widget_info[1].find(‘a’).get(‘href’).strip().split(‘=’)[1] #Получаем из какого города вопрос who_asked_city=widget_info[1].text.split(‘(‘)[1].split(‘)’)[0].strip() #Получаем дату вопроса date_question=widget_info[1].text.split(‘(‘)[1].split(‘)’)[1].strip() #Получаем ответ если он есть сохраняем answer_tr=table.find(‘tr’,<'class': 'answer'>) if(answer_tr!=None): answer=answer_tr.find_all(‘td’)[1].find(‘div’).text.replace(‘
‘,’\n’).strip() #Пишем в таблицу и возвращаем res=res.append(pd.DataFrame([[id_question,link_question,question,date_question,who_asked,who_asked_id,who_asked_link,who_asked_city,answer]], columns = [‘id_question’,’link_question’,’question’,’date_question’,’who_asked’,’who_asked_id’,’who_asked_city’,’who_asked_link’,’answer’]), ignore_index=True) #print(res) return(res)
Функция возвращает DataFrame, который можно накапливать и экспортировать в EXCEL.
result = pd.DataFrame() r = requests.get(url) #отправляем HTTP запрос и получаем результат soup = BeautifulSoup(r.text) #Отправляем полученную страницу в библиотеку для парсинга tables=soup.find_all(‘table’, <'class': 'qaBlock'>) #Получаем все таблицы с вопросами for item in tables: res=parse_table(item) result=result.append(res, ignore_index=True) result.to_excel(‘result.xlsx’)
В результате мы научились парсить web-сайты, познакомились с библиотеками Requests, BeautifulSoup, а также получили пригодные для дальнейшего анализа данные об отзывах с сайта banki.ru. А вот и сама результирующая таблица.
Приобретенные навыки можно использовать для получения данных с других сайтов и получать обобщенную и структурированную информацию с бескрайних просторов Интернета.
Я надеюсь, моя статья была полезна. Спасибо за внимание.
Web Scraping с помощью python
Недавно заглянув на КиноПоиск, я обнаружила, что за долгие годы успела оставить более 1000 оценок и подумала, что было бы интересно поисследовать эти данные подробнее: менялись ли мои вкусы в кино с течением времени? есть ли годовая/недельная сезонность в активности? коррелируют ли мои оценки с рейтингом КиноПоиска, IMDb или кинокритиков?
Но прежде чем анализировать и строить красивые графики, нужно получить данные. К сожалению, многие сервисы (и КиноПоиск не исключение) не имеют публичного API, так что, приходится засучить рукава и парсить html-страницы. Именно о том, как скачать и распарсить web-cайт, я и хочу рассказать в этой статье.
В первую очередь статья предназначена для тех, кто всегда хотел разобраться с Web Scrapping, но не доходили руки или не знал с чего начать.
Off-topic: к слову, Новый Кинопоиск под капотом использует запросы, которые возвращают данные об оценках в виде JSON, так что, задача могла быть решена и другим путем.
Задача
- Этап 1: выгрузить и сохранить html-страницы
- Этап 2: распарсить html в удобный для дальнейшего анализа формат (csv, json, pandas dataframe etc.)
Инструменты
- re
Регулярные выражения, конечно, нам пригодятся, но использовать только их, на мой взгляд, слишком хардкорный путь, и они немного не для этого. Были придуманы более удобные инструменты для разбора html, так что перейдем к ним. - BeatifulSoup, lxml
Это две наиболее популярные библиотеки для парсинга html и выбор одной из них, скорее, обусловлен личными предпочтениями. Более того, эти библиотеки тесно переплелись: BeautifulSoup стал использовать lxml в качестве внутреннего парсера для ускорения, а в lxml был добавлен модуль soupparser. Подробнее про плюсы и минусы этих библиотек можно почитать в обсуждении. Для сравнения подходов я буду парсить данные с помощью BeautifulSoup и используя XPath селекторы в модуле lxml.html. - scrapy
Это уже не просто библиотека, а целый open-source framework для получения данных с веб-страниц. В нем есть множество полезных функций: асинхронные запросы, возможность использовать XPath и CSS селекторы для обработки данных, удобная работа с кодировками и многое другое (подробнее можно почитать тут). Если бы моя задача была не разовой выгрузкой, а production процессом, то я бы выбрала его. В текущей постановке это overkill.
Загрузка данных
Первая попытка
Приступим к выгрузке данных. Для начала, попробуем просто получить страницу по url и сохранить в локальный файл.
import requests user_id = 12345 url = 'http://www.kinopoisk.ru/user/%d/votes/list/ord/date/page/2/#list' % (user_id) # url для второй страницы r = requests.get(url) with open('test.html', 'w') as output_file: output_file.write(r.text.encode('cp1251'))Открываем полученный файл и видим, что все не так просто: сайт распознал в нас робота и не спешит показывать данные.
Разберемся, как работает браузер
Однако, у браузера отлично получается получать информацию с сайта. Посмотрим, как именно он отправляет запрос. Для этого воспользуемся панелью «Сеть» в «Инструментах разработчика» в браузере (я использую для этого Firebug), обычно нужный нам запрос — самый продолжительный.
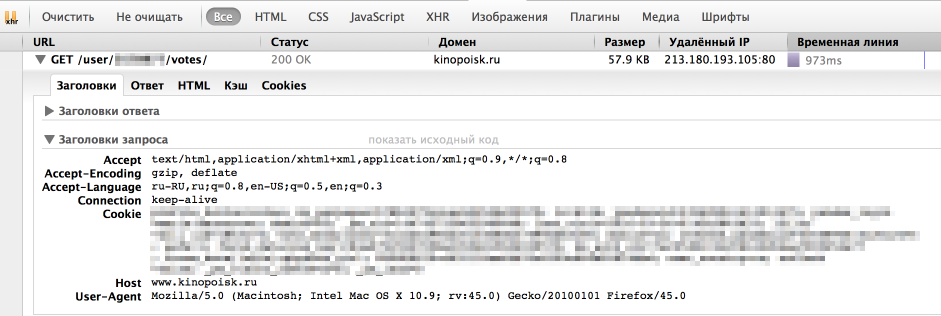
Как мы видим, браузер также передает в headers UserAgent, cookie и еще ряд параметров. Для начала попробуем просто передать в header корректный UserAgent.
headers = < 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.9; rv:45.0) Gecko/20100101 Firefox/45.0' >r = requests.get(url, headers = headers)На этот раз все получилось, теперь нам отдаются нужные данные. Стоит отметить, что иногда сайт также проверяет корректность cookie, в таком случае помогут sessions в библиотеке Requests.
Скачаем все оценки
Теперь мы умеем сохранять одну страницу с оценками. Но обычно у пользователя достаточно много оценок и нужно проитерироваться по всем страницам. Интересующий нас номер страницы легко передать непосредственно в url. Остается только вопрос: «Как понять сколько всего страниц с оценками?» Я решила эту проблему следующим образом: если указать слишком большой номер страницы, то нам вернется вот такая страница без таблицы с фильмами. Таким образом мы можем итерироваться по страницам до тех, пор пока находится блок с оценками фильмов ( ).

Полный код для загрузки данных
import requests # establishing session s = requests.Session() s.headers.update(< 'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10.9; rv:45.0) Gecko/20100101 Firefox/45.0' >) def load_user_data(user_id, page, session): url = 'http://www.kinopoisk.ru/user/%d/votes/list/ord/date/page/%d/#list' % (user_id, page) request = session.get(url) return request.text def contain_movies_data(text): soup = BeautifulSoup(text) film_list = soup.find('div', ) return film_list is not None # loading files page = 1 while True: data = load_user_data(user_id, page, s) if contain_movies_data(data): with open('./page_%d.html' % (page), 'w') as output_file: output_file.write(data.encode('cp1251')) page += 1 else: breakПарсинг
Немного про XPath
XPath — это язык запросов к xml и xhtml документов. Мы будем использовать XPath селекторы при работе с библиотекой lxml (документация). Рассмотрим небольшой пример работы с XPath
from lxml import html test = ''' one two
another tag
''' tree = html.fromstring(test) tree.xpath('//h2') # все h2 теги tree.xpath('//h2[@align]') # h2 теги с атрибутом align tree.xpath('//h2[@align="center"]') # h2 теги с атрибутом align равным "center" div_node = tree.xpath('//div')[0] # div тег div_node.xpath('.//h2') # все h2 теги, которые являются дочерними div ноде Подробнее про синтаксис XPath также можно почитать на W3Schools.
Вернемся к нашей задаче
Теперь перейдем непосредственно к получению данных из html. Проще всего понять как устроена html-страница используя функцию «Инспектировать элемент» в браузере. В данном случае все довольно просто: вся таблица с оценками заключена в теге . Выделим эту ноду:
from bs4 import BeautifulSoup from lxml import html # Beautiful Soup soup = BeautifulSoup(text) film_list = soup.find('div', ) # lxml tree = html.fromstring(text) film_list_lxml = tree.xpath('//div[@class = "profileFilmsList"]')[0]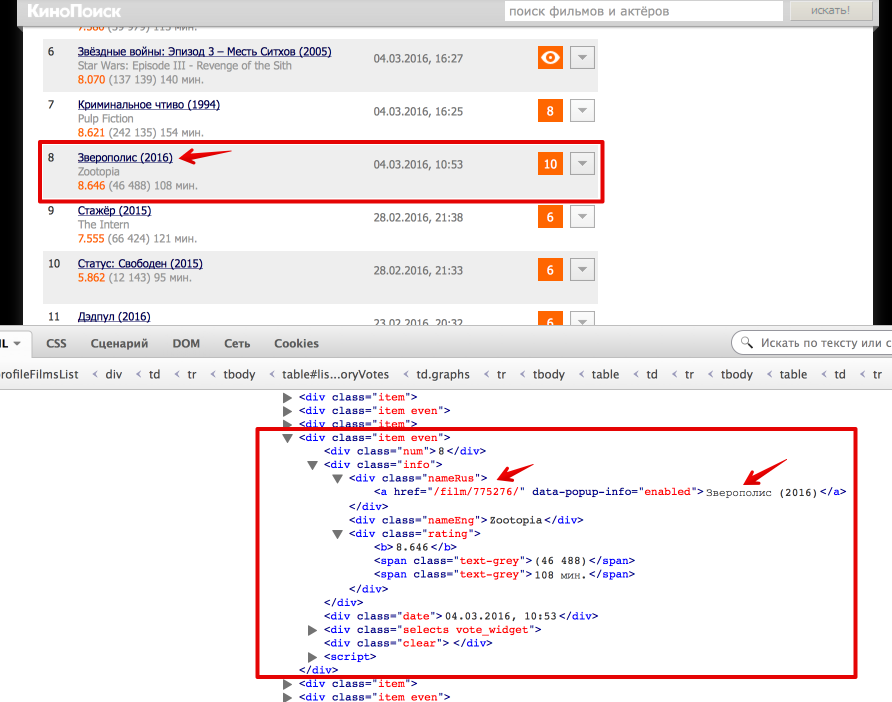
Каждый фильм представлен как или . Рассмотрим, как вытащить русское название фильма и ссылку на страницу фильма (также узнаем, как получить текст и значение атрибута).
# Beatiful Soup movie_link = item.find('div', ).find('a').get('href') movie_desc = item.find('div', ).find('a').text # lxml movie_link = item_lxml.xpath('.//div[@class = "nameRus"]/a/@href')[0] movie_desc = item_lxml.xpath('.//div[@class = "nameRus"]/a/text()')[0]Еще небольшой хинт для debug’a: для того, чтобы посмотреть, что внутри выбранной ноды в BeautifulSoup можно просто распечатать ее, а в lxml воспользоваться функцией tostring() модуля etree.
# BeatifulSoup print item #lxml from lxml import etree print etree.tostring(item_lxml)Полный код для парсинга html-файлов под катом
def read_file(filename): with open(filename) as input_file: text = input_file.read() return text def parse_user_datafile_bs(filename): results = [] text = read_file(filename) soup = BeautifulSoup(text) film_list = film_list = soup.find('div', ) items = film_list.find_all('div', ) for item in items: # getting movie_id movie_link = item.find('div', ).find('a').get('href') movie_desc = item.find('div', ).find('a').text movie_id = re.findall('\d+', movie_link)[0] # getting english name name_eng = item.find('div', ).text #getting watch time watch_datetime = item.find('div', ).text date_watched, time_watched = re.match('(\d\.\d\.\d), (\d:\d)', watch_datetime).groups() # getting user rating user_rating = item.find('div', ).text if user_rating: user_rating = int(user_rating) results.append(< 'movie_id': movie_id, 'name_eng': name_eng, 'date_watched': date_watched, 'time_watched': time_watched, 'user_rating': user_rating, 'movie_desc': movie_desc >) return results def parse_user_datafile_lxml(filename): results = [] text = read_file(filename) tree = html.fromstring(text) film_list_lxml = tree.xpath('//div[@class = "profileFilmsList"]')[0] items_lxml = film_list_lxml.xpath('//div[@class = "item even" or @class = "item"]') for item_lxml in items_lxml: # getting movie id movie_link = item_lxml.xpath('.//div[@class = "nameRus"]/a/@href')[0] movie_desc = item_lxml.xpath('.//div[@class = "nameRus"]/a/text()')[0] movie_id = re.findall('\d+', movie_link)[0] # getting english name name_eng = item_lxml.xpath('.//div[@class = "nameEng"]/text()')[0] # getting watch time watch_datetime = item_lxml.xpath('.//div[@class = "date"]/text()')[0] date_watched, time_watched = re.match('(\d\.\d\.\d), (\d:\d)', watch_datetime).groups() # getting user rating user_rating = item_lxml.xpath('.//div[@class = "vote"]/text()') if user_rating: user_rating = int(user_rating[0]) results.append(< 'movie_id': movie_id, 'name_eng': name_eng, 'date_watched': date_watched, 'time_watched': time_watched, 'user_rating': user_rating, 'movie_desc': movie_desc >) return resultsРезюме

В результате, мы научились парсить web-сайты, познакомились с библиотеками Requests, BeautifulSoup и lxml, а также получили пригодные для дальнейшего анализа данные о просмотренных фильмах на КиноПоиске.
Полный код проекта можно найти на github’e.
UPD
- Аутентификация: зачастую для того, чтобы получить данные с сайта нужно пройти аутентификацию, в простейшем случае это просто HTTP Basic Auth: логин и пароль. Тут нам снова поможет библиотека Requests. Кроме того, широко распространена oauth2: как использовать oauth2 в python можно почитать на stackoverflow. Также в комментариях есть пример от Terras того, как пройти аутентификацию в web-форме.
- Контролы: На сайте также могут быть дополнительные web-формы (выпадающие списки, check box’ы итд). Алгоритм работы с ними примерно тот же: смотрим, что посылает браузер и отправляем эти же параметры как data в POST-запрос (Requests, stackoverflow). Также могу порекомендовать посмотреть 2й урок курса «Data Wrangling» на Udacity, где подробно рассмотрен пример scrapping сайта US Department of Transportation и посылка данных web-форм.
Парсинг сайта с помощью PYTHON + SELENIUM
В этой статье, на примере моей задачи, рассмотрим, как можно извлечь большой объем данных с сайта ГИББД и с помощью какого инструмента. Это может быть полезно для финансовых компаний, которые принимают автомобили в качестве залога. Итак, мне необходимо было получить информацию о владельцах и периодах владения автомобилями, чтобы определить были ли изменения в конкретном периоде. Данная информация есть на официальном сайте ГИБДД.рф. На входе было дано 70 тысяч VIN номеров автомобилей, по которым и возможно было сделать эту выгрузку.

Поскольку я ранее не занимался парсингом, то решил проанализировать различные Интернет-ресурсы для поиска необходимого алгоритма, однако, для поставленной мне задачи отсутствовало готовое решение, в связи с чем мне пришлось делать всё самому. В ходе анализа я обнаружил библиотеку «requests» для передачи POST запросов, но понял, что она не подходит, поскольку на сайте «ГИБДД.РФ» есть элементы JS, а значит, что VIN номер не передать через адресную строку.
В ходе дальнейшего поиска решения для поставленной задачи я обнаружил библиотеку «Selenium», которая позволяет имитировать действия пользователя на сайте, в том числе с элементами JS.
Для ее установки используется команда: -pip install selenium .
При использовании браузера «Google Сhrome» для работы с вышеуказанной библиотекой необходима имеющаяся в свободном доступе программа «Webdriver Сhrome».
Проблемы:
На мой взгляд, особую сложность при парсинге подобных сайтов вызывает изучение вариантов различного поведения самого сайта при отправке запросов. В моём случае – это появление видеорекламы (которое можно закрыть спустя определенное время), либо фоторекламы (которое проходит само), то есть своеобразный аналог капчи. Проблематика заключалась в необходимости анализа периодичности появления рекламы, ее разновидности и способах обхода вышеуказанной рекламы.
Алгоритм действий:
Импортируем все необходимые библиотеки:
from selenium import webdriver from selenium.webdriver.common.by import By from selenium.webdriver.common.keys import Keys import pandas as pd import time from bs4 import BeautifulSoup from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as ECЗадаём опции для webdriver, запускаем его и переходим на нужную нам страницу проверки авто:
option = Options() option.add_argument("--disable-infobars") browser = webdriver.Chrome('C:\webdr\chromedriver.exe',chrome_options=option) # 'https://xn--90adear.xn--p1ai/check/auto' – ГИБДД.РФ browser.get('https://xn--90adear.xn--p1ai/check/auto')Открывается новое окно webdriver, после чего запускается сайт со следующим содержанием:

Затем осуществляем поиск нужных нам элементов через код страницы (правой кнопкой мыши – посмотреть код). В нашем случае это элемент с вводом VIN номера и кнопка с запросом.
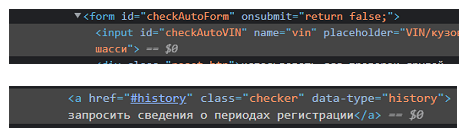
Находим идентификатор элемента id=”checkAutoVIN” и имя class =”checker”. Осуществляем поиск данных элементов, затем вставляем нужный VIN в соответствующую строку:
elem = browser.find_element(By.ID, 'checkAutoVIN' ) elem.send_keys('5GRGXXXXXXX129289' + Keys.RETURN)и нажимаем на кнопку:
share = browser.find_element(By.CLASS_NAME, 'checker' ) share.click()Первая проблема – появляется видеореклама, при просмотре которой через 4 секунды появляется крестик справа.

Находим код этого крестика на странице:
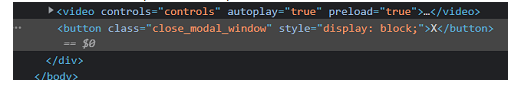
С помощью функции “WebDriverWait” ждём появления этого крестика и нажимаем на него, если это видеореклама.
WebDriverWait(browser, 10).until(EC.element_to_be_clickable((By.CLASS_NAME, "close_modal_window"))).click()В случае появления фоторекламы вышеуказанный код выдаст ошибку, которую я решил с помощью конструкции try – except (она пригодится ещё много раз).В случае появления фоторекламы необходимо дождаться ее самопроизвольного закрытия:
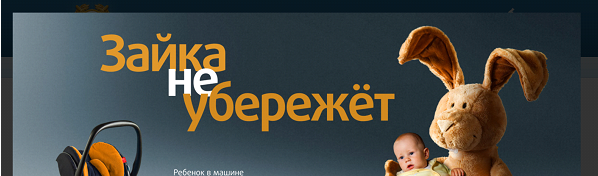
time.sleep(4) В дальнейшем для парсинга страницы необходимо воспользоваться библиотекой “ BeautifulSoup”.

elements = soup.find_all(attrs=>) elements1=soup.find_all(attrs=>) elements2=soup.find_all(attrs=>) elements3=soup.find_all(attrs=>) elements4=soup.find_all(attrs=>) elements5=soup.find_all(attrs=>) Для заполнения полученной информацией создадим пустую таблицу:
df = pd.DataFrame()Учитываем, что периодов владений автомобилем может быть несколько. В таком случае в каждом из найденных элементов будет несколько записей (элементы сохраняются в виде списка). Каждый новый период добавим с тем же VIN номером в новую строку:
for j in range(len(elements1)): df1 = df1.append(, ignore_index=True)На первый взгляд кажется, что для решения поставленной задачи необходимо только запустить цикл по всем VIN номерам, однако обнаружились следующие проблемы. После проверки 5 VIN номеров сайт начинает сильно затормаживаться. Чтобы это избежать, я установил счетчик и когда он достигает значение 5 – обнуляем его и инициализируем webdriver заново. В ходе данной работы я установил, что для корректной работы цикла важно не закрывать предыдущий webdriver ( browser.quit() ), поскольку при его закрытии в следующем проходе цикла возникает ошибка.
Также счётчик помог мне понять, что реклама появляется при первом запросе, при условии, что VIN номер есть в базе ГИБДД.
Учитываем указанную информацию и вводим новую переменную ermes , и при парсинге добавляем условие, что, если эта переменная равна ‘По указанному VIN не найдена информация о регистрации транспортного средства.’, то проделываем операцию с пережиданием или закрытием рекламы.
elementserr=soup.find_all(attrs=>) if elementserr[0].text=='По указанному VIN не найдена информация о регистрации транспортного средства.': ermes=elementserr[0].textСледующая проблема – иногда запрос выполняется с ошибкой. В таком случае необходимо нажимать кнопку запроса информации до тех пор, пока запрос выполнится без ошибки:
while elementserr[0].text=='При получении ответа сервера произошла ошибка.': share.click() time.sleep(4)Для успешного завершения поставленной задачи остается лишь взять все VIN номера и сделать по ним цикл:
vin=pd.read_excel(r'C:\Users\grvla\Desktop\Парс.xlsx')Таким образом, разработанный мной парсер работает стабильно, прерывания возможны, но крайне редко (оставлял на пару дней). В случае прерывания, будем запускать цикл заново, пропуская те значения, которые есть в итоговой таблице:
sh=0 ermes='' for i in vin.vins: if i in df.VIN.unique(): continueВ качестве ключевых выводов хочу отметить:
- Разработанный парсинг не могут забанить по ip, поскольку демонстрируется реклама. Мы же просто имитируем деятельность человека на сайте. Его можно запустить сразу на многих компьютерах, что ускорит результат работы. Количество полученных VIN-номеров в день – 7-8 тысяч. То есть на 10 компьютерах 70 тысяч VIN -номеров можно пропарсить за один день.
- Библиотека Selenium позволяет имитировать действия пользователя в браузере. Это помогает автоматизировать сбор данных практически с любого сайта, в котором нет капчи. С её помощью возможна работа с сайтами, в которых есть элементы javascript, с чем не справляются другие библиотеки для парсинга. Достаточно простой для написания код.
- Python
- Программирование