
Как хранить веса связей многослойной нейронной сети после обучения?
Подскажите пожалуйста как лучше хранить веса связей многослойной нейронной сети после обучения?
Я только пытаюсь «въехать» в данное направление. В моём дилетантском представлении их нужно записывать в таблицу БД и для каждого слоя должна быть своя таблица БД. А может всё в одну таблицу запихнуть? Не знаю.
У кого есть опыт или кто сталкивался с данным вопросом посоветуйте пожалуйста.
Лучшие ответы ( 1 )
94731 / 64177 / 26122
Регистрация: 12.04.2006
Сообщений: 116,782
Ответы с готовыми решениями:
Обучение многослойной нейронной сети
Начал изучать нейронные сети, и хотел сделать что нибудь по легче. И вот хочу сделать многослойную.
Функция обучения нейронной сети
добрый день. «TRAIN вызывает функцию, которая задается NET.trainFcn, использующую параметры.
Проблемы обучения нейронной сети
Доброго времени суток. Использую рекуррентную нейронную сеть для разделения двух классов, возникла.
Не работает процедура обучения нейронной сети
Здравствуйте! Я написал свой класс нейронной сети, но обучение по алгоритму обратного.
621 / 501 / 68
Регистрация: 20.09.2014
Сообщений: 3,248
Ответ короткий: засуньте в GPU, там обменные скорости на шесть порядков выше. )))
Регистрация: 20.02.2018
Сообщений: 446
Сообщение от Mikhaylo 
Ответ короткий: засуньте в GPU, там обменные скорости на шесть порядков выше. )))
Не понял ответа.
После обучения, т.е после того как мы уже вычислили нужные нам веса, нам же нужно где-то их хранить, чтобы каждый раз не пересчитывать. Вот что я имею ввиду.
1445 / 1364 / 234
Регистрация: 19.02.2010
Сообщений: 3,824
 Сообщение от Volodya_
как лучше хранить веса связей многослойной нейронной сети после обучения?
В двоичном файле Вашего собственного формата. Формат делаете таким, чтобы он удобно лёг на процедурную или объектную логику Вашей программы.
Т.е. если ООПа нет — то можно в начало файла положить все счётчики (число слоёв, число нейронов в каждом слое), а затем все веса (а при чтении их читать тогда, когда прочитали предыдущие счётчики и в соответствии с их значениями выделили нужные куски памяти). Если же ООП есть — сначала идёт счётчик числа слоёв, затем то, что будет читаться классом слоя (число нейронов в нём и их веса) — т.е. веса в файле будут чередоваться послойно с другими данными (счётчиками).
А тазы банных тут идут лесом.
Регистрация: 20.02.2018
Сообщений: 446
VTsaregorodtsev, у меня ООП.
Если можно ещё пара уточняющих вопросов.
Сообщение от VTsaregorodtsev
Если же ООП есть — сначала идёт счётчик числа слоёв
1. Счётчик для определения к какому слою относятся веса и др. инф-я?
Сообщение от VTsaregorodtsev
затем то, что будет читаться классом слоя (число нейронов в нём и их веса) — т.е. веса в файле будут чередоваться послойно с другими данными (счётчиками).
2. Число нейронов нужно чтобы автоматически инициализировать объекты слоя?
1445 / 1364 / 234
Регистрация: 19.02.2010
Сообщений: 3,824

Сообщение было отмечено Volodya_ как решение
Решение
Под «счётчиком» я имел в виду значение целочисленной переменной, в которой лежит общее количество чего-то
Т.е. «счётчик»<>«индекс».
У каждого слоя сохранять его индекс совсем не нужно.
Иными словами. Я (для ООП) предлагал структуру вида:
1) Число входов сети
2) Число слоёв
3а) Число нейронов в слое1
3б) Веса слоя1 (а число их при чтении рассчитаем как произведение числа входов слоя на число нейронов в нём, плюс бивисы)
4а) Число нейронов в слое2
4б) Веса слоя2
.
Естественно, если есть другие переменные или флаги (например, те, которые будут задавать нелинейности у нейронов в том или ином слое) — они будут сохраняться или где-то в начальном=общем «заголовке» файла, или внутри «послойного» блока информации.
Использование обученной модели нейронной сети
Вопросы такие:
Как использовать обученную Tensorflow RNN в GoogleCoLab на локальной машине?
Нужно скачать с CoLab файл с весами или какой-то другой, или их все?
И потом как использовать?
Разместить в корне, и можно ли импортить необходимые методы?
Или нужно сохранить модель в формат .h5 и после использовать?
Например создать простой prosto.py в котором:
И как в таком случае подать t в обученную модель?
Нужен ли для этого исходник модели?
Знающие, помогите пожалуйста!
Отслеживать
Galo Gramma
задан 7 ноя 2019 в 17:23
Galo Gramma Galo Gramma
135 1 1 серебряный знак 9 9 бронзовых знаков
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Существуют методы save() и load() для сохранения модели и последующей загрузки где хотите. Для использования существует метод predict()
Отслеживать
ответ дан 8 ноя 2019 в 18:03
376 2 2 серебряных знака 13 13 бронзовых знаков
При применении метода save() сохраняются чекпоинты в виде 4 файлов — модель, веса и указания что где. Вопрос в том.. Как использовать эти файлы на локальной машине?
9 ноя 2019 в 16:13
Архитектура модели — состоит из двух рекуррентных нейронных сетей: кодер RNN просто потребляет входные слова источника без каких-либо предсказаний; Декодер, с другой стороны, обрабатывает целевое предложение, предсказывая следующие слова.
9 ноя 2019 в 16:50
@GaloGramma метод load() запускаешь из того же репозитория, где сохранил. Тоесть он загружает сразу весь репозиторий с твоей моделью. Далее с помощью метода predict() используешь модель для предсказания/генерации. Я так полагаю, у вас что-то вроде GAN. Тогда после обучения стоит сохранять именно генератор, т.к. дискриминатор нужен лишь на период обучения)
11 ноя 2019 в 19:16
Большое спасибо за ответ, но пока что не до конца понятен принцип. Очень прошу Вас разъяснить более подробно! Я пока не сохранял модель в репозиторий. На данном этапе я лишь обучил модель на ноутбуке Google CoLab используя простой дата сет и получил сохраненные файлы чекпоинтов. Скачал их с CoLab на лок маш и не понимаю, что с ними дальше делать. Нужно ли восстанавливать исходную модель на лок маш? Нужен ли .HDF5 для использования модели на лок маш? Модель состоит из двух рекурентных сеток — (1)Encoder, (2)Decoder.
Настройка нейронной сети для детекции необходимых объектов
Нейронные сети – сложные математические алгоритмы, которые помогают решать большой круг задач. Перед использованием их необходимо настроить и обучить. Обучение нейронной сети достаточно долгий по времени и затратный по вычислительным ресурсам процесс. Однако существуют инструменты, благодаря которым мы можем упростить эти проблемы. Сегодня мы рассмотрим процесс переобучения нейронной сети по детекции определенного объекта на изображении.
В качестве примера для детекции объектов будем использовать алгоритм YOLOv3. Дополнительные материалы по статье вы сможете найти на github странице. Пример установки и настройки осуществляется на ОС Windows 10.
В первую очередь нам необходимо скачать или клонировать необходимые материалы для переобучения нейронной сети под определенный тип объекта с данной github страницы. Для того чтобы не возникало проблем с доступом или разрешениями, материалы лучше разместить в директории своей учетной записи, например: C:\Users\user_name\Documents\NN\.
1. Переходим в папку yolov3-master, вызываем терминал (командную строку) и выполняем команду pip install -U -r requirements.txt. При запуске команды некоторые из пакетов не установились, т.к в репозитории pip для windows, пакетов с таким названием не существует. Чтобы установка прошла успешно, в requirements.txt мы должны закомментировать несколько пакетов («torch >= 1.5» и «pycocotools»). Затем установить pytorch с помощью следующей команды:
pip install torch==1.5.0 torchvision==0.6.0 -f https://download.pytorch.org/whl/torch_stable.htmlПакет pycocotools в нашем случае не понадобится. Также необходимо скачать и установить CUDA tools, для того чтобы ваши вычисления проходили на видеокарте, что в разы увеличивает скорость переобучения.
2. После успешного завершения установки можем приступать к подготовке данных. Для лучшей работы алгоритма фотографии для обучения необходимо брать с материалов, на которых будет производится обработка. Например, необходимо обработать видеоматериалы с камер видеонаблюдения, которые установлены в помещении, где объекты располагаются под большим углом. В такой ситуации будет очень сложно обучить алгоритм для детекции объектов, которые сильно отличаются от картинок в интернете, на которых была обучена нейронная сеть. Таким образом, обучающая выборка составляется либо из скрин-снимков по видеоматериалам, либо с помощью ручной съемки фотоаппаратом. Размер обучающей выборки может сильно варьироваться, все зависит от характера задачи. В данном примере набор данных состоит из 46 картинок, на которых изображены три типа объектов (ручка, карандаш, маркер). Фотосъемка производилась на фоне стола и листа А4.
3. Следующий этап состоит в разметке объектов на изображении. Однако, перед тем как приступить к разметке, необходимо увеличить обучающую выборку с помощью нескольких методов аугментации. Это важно для улучшения способностей нейронной сети к распознаванию объектов в различных вариациях. Несколько примеров аугментации можно найти в данной тетрадке. По завершении аугментации объединяем оригинальные изображения с результатом аугментации в одну папку (важно, изображения должны располагаться в корне папки yolov3_master, например: C:\Users\user_name\Documents\NN\ yolov3_master\images\). Далее с помощью программы labelImg проводим разметку объектов, последовательно выполняя следующие шаги:

- выбираем папку с изображениями (…\yolov3_master\images\);
- выбираем папку для сохранения меток. Необходимо создать новую папку с названием labels, в той же директории где изображения (….\yolov3_master\labels\);
- меняем тип меток c PascalVOC на YOLO;
- нажимаем на инструмент выделения объектов;
- полностью выделяем все объекты, для которых хотим обучить алгоритм;
- задаем название для каждого из типов объектов (Pen, Pencil, Marker), после первого ввода эти названия буду доступны в списке для следующих изображений;
- подтверждаем;
- сохраняем метку;
- переходим к следующему изображению и повторяем пункты 4 – 8.

4. Далее нам необходимо разделить подготовленную выборку на обучающую и тестовую. В данном случае необходимо создать 2 текстовых документа (train_112.txt и test_24.txt), в которых будут указаны полный путь расположения для каждого изображения. Пример создания документов можно найти в тетрадке.
5. Для того чтобы искомые объекты были именованными необходимо создать файл с расширением .names, например objects.names, в котором указаны имена в том же порядке, как указано в classes.txt в папке labels. Выглядит примерно так:

Далее необходимо создать файл с расширением .data, например conf.data, в котором указано количество классов (в данном примере 3), файлы с именами объектов, а также файлы с расположением изображений для обучающей и тестовой выборки:
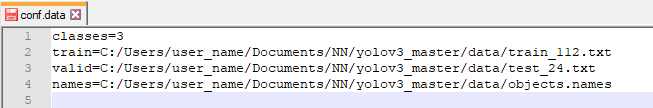
Файлы objects.names, conf.data и последующие файлы необходимо поместить в следующую директорию: yolov3_master\data\, заранее удалив с неё все файлы.
6. Для переобучения необходимо настроить конфигурационный файл, для этого с папки (…\yolov3_master\cfg) копируем файл yolov3-spp.cfg в папку (…\yolov3_master\data). Далее необходимо отредактировать строки (636,643 — 722,729 — 809,816) для каждого из трех слоев:
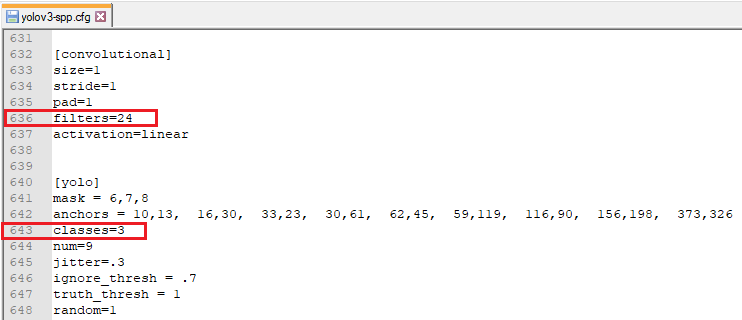
Где, filters = (5 + n) * 3 и classes = n. n – количество классов (в данном примере 3).
7. Далее необходимо скачать веса для настроенного конфигурационного файла. Для этого со страницы скачиваем файл yolov3-spp.pt и помещаем его в (…\yolov3_master\data). Для примера используется алгоритм yolov3-spp. Однако существует еще несколько вариаций алгоритма, например, yolov3-tiny, что является облегченной версией yolov3-spp. Облегченная версия менее точна, но при это скорость обработки материалов значительно выше.
8. Переходим непосредственно к переобучению алгоритма под свой тип объекта. Для этого в папке …\yolov3_master\ запускаем командную строку и вводим следующую команду:
python train.py --cfg data/yolov3-spp.cfg --data data/conf.data --weights data/yolov3-spp.pt --nosaveПосле запуска команды может возникнуть ошибка следующего характера:

Для решения данной проблемы необходимо закомментировать строки в файле utils.py в папке utils:

В теле функции check_git_status закомментируем все строки кроме print, в который передадим любую строку, например, «ss».
Также может появиться ошибка следующего вида:
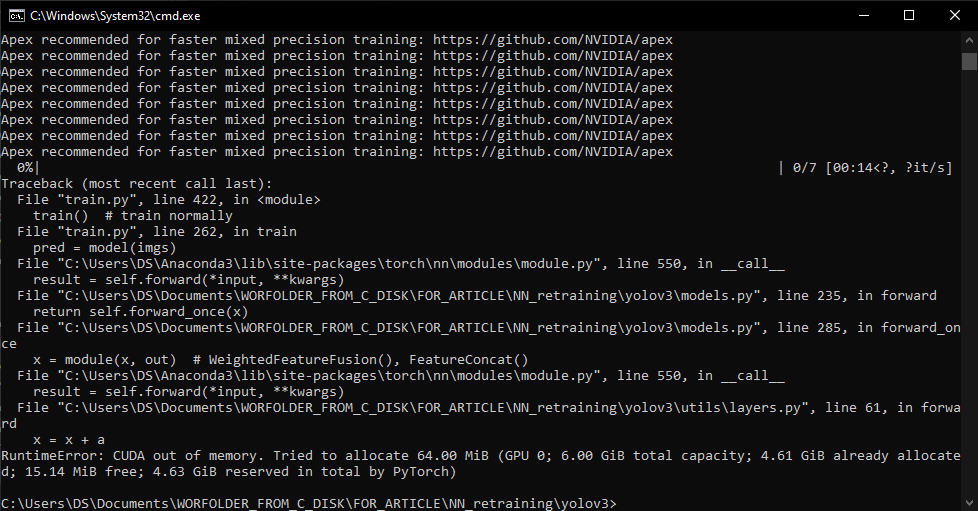
Данная ошибка говорит о том, что не хватает памяти видеокарты для построения вычислительного графа. Одним из способов решения данной проблемы является уменьшение размера батча при обучении. Для этого в файле (…\yolov3_master\train.py) необходимо изменить параметр batch_size, по умолчанию установлено 16, изменим на меньшее значение (8 или 4) кратное 4:
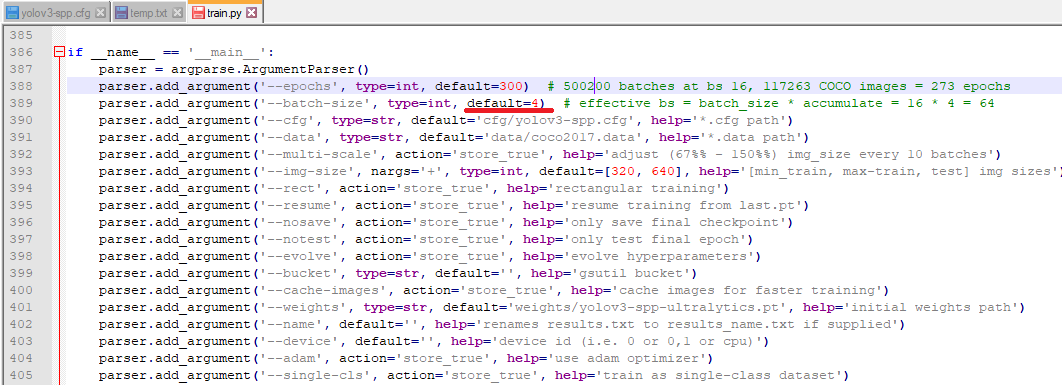
Также данное значение можно передать явно, используя значение параметра при инициализации:
python train.py --cfg data/yolov3-spp.cfg --data data/conf.data --weights data/yolov3-spp.pt --batch-size 4 --nosaveВ примере выше мы указали конфигурационный файл, файл с информацией об обучающей выборке, веса и параметр сохранения.
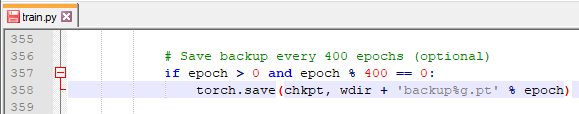
Параметр —nosave указывает на то что будет сохранен только финальный файл с весами. Также можно настроить в файле train.py режим сохранения, например, если вы хотите сохранять веса каждые 400 epoch:
Также важно указать параметр —epochs, количество эпох зависит от типа объектов, объема обучающей выборки и других факторов. В данном примере изначально было 46 изображений, с помощью методов аугментации набор данных увеличился до 136, из них 112 – обучающая выборка, 24 – тестовая выборка. Вычисления проводились на видеокарте GTX 1060 6 GB. Первая попытка проводилась для 300 эпох, обучение заняло порядка 2.5 часов. Выявилась очень плохая точность алгоритма. Вторая попытка проводилась для 1200 эпох, обучение заняло ~ 12 часов. По окончании обучения в папку (…\yolov3_master\weights\) сохранятся веса — файл last.pt. Для того чтобы проверить работоспособность алгоритма необходимо запустить следующую команду:
python detect.py --weights weights/last.pt --cfg data/yolov3-spp.cfg --names data/objects.namesПеред запуском команды необходимо поместить изображения для обработки алгоритмом в папку (…\yolov3_master\data\samples\). Результат появится в папке (…\yolov3_master\output\).
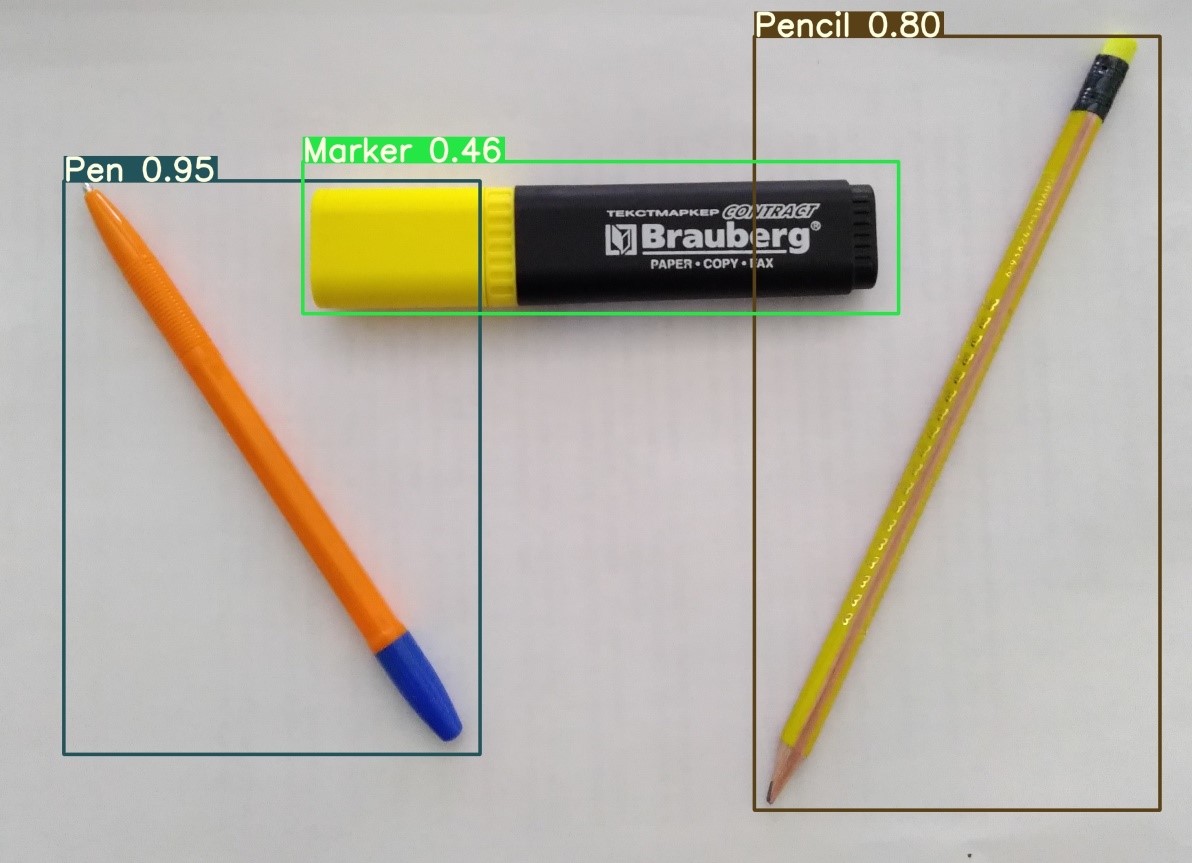
Таким образом, проведено переобучение готовой нейронной сети, которая была способна определять 80 классов объектов, под новые 3 типа объекта, не вошедших в этот список. Для объекта «маркер» алгоритм не совсем точен, уверенность составляет меньше 0.5. Одной из причин может быть малый размер обучающей выборки, т.к. в данном примере изображений с маркерами было 26 %, остальное ручки и карандаши.
- нейронные сети
- машинное обучение
NeuralBase — нейросеть за 5 минут
Библиотека компонентов, предназначена для программной реализации нейронных сетей. В качестве примера, созданы компоненты реализующие две нейросетевые парадигмы: рекуррентную нейронную сеть, в нашем случае – это сеть Хопфилда и многослойную нейронную сеть обучаемую по алгоритму обратного распространения ошибки (back propagation).
Основным назначением библиотеки является интеграция нейронных сетей в информационные системы, для расширения аналитических возможностей систем. Реализация нейронных сетей в виде компонентов, наличие открытого кода позволяет легко встраивать в другие программы. Объектно-ориентированное исполнение придает особую гибкость, достаточно переписать пару методов и вы можете получить компонент, оптимизированный под ваши задачи.
Иерархия классов
Существует три базовых класса TNeuron, TLayer, TNeuralNet. Все остальные являются производными от них. На рис.1 приведена иерархия классов, сплошными линиями показано наследование (стрелкой указан потомок), пунктирными в каких классах они используются.
TNeuron является базовым классом для нейронов, несет всю основную функциональность, имеет индексированное свойство Weights, представляющее собой весовые коэффициенты (синапсы), свойство Output, которое является выходом нейрона (результатом вычислений) и сумматор, роль которого, выполняет метод ComputeOut.
TNeuronHopf, потомок TNeuron, реализует нейрон используемый в нейронной сети Хопфилда, единственным отличием от базового класса, является использования активационной функции в перекрытом методе ComputeOut.
Следующим порожденным классом, является TNeuronBP служащий для программной реализации многослойных нейронных сетей. Аббревиатура BP в имени класса не должна вводить вас в заблуждение, что нейрон этого типа используется исключительно в сетях обучаемых по алгоритму обратного распространения, этим, мы лишний раз хотели подчеркнуть, что в нашем случае нейронная сеть обучается по этому алгоритму.
Переписан метод ComputeOut, использующий теперь нелинейную активационную функцию, которая реализована в виде индексированного свойства процедурного типа OnActivationF. Кроме того, добавлены два важных свойства, Delta – содержащая локальную ошибку и индексированное свойство PrevUpdate – содержащее величину коррекции весовых коэффициентов на предыдущем шаге обучения сети.
Основным назначением базового класса TLayer и его потомков TLayerHopf и TLayerBP является объединение нейронов в слой, для упрощения работы с нейронами.
Компонент TNeuralNet базовый компонент для всех видов нейронных сетей. TNeuralNet обеспечивает необходимую функциональность производных компонентов. Этот компонент поддерживает методы для работы со слоями сети (AddLayer, DeleteLayer) и методы для манипуляций с исходными данными (AddPattern, DeletePattern, ResetPatterns). Метод Init служит для построения нейронной сети. Большинство методов объявленных в разделе public в базовом компоненте и его потомках – виртуальные, что позволяет легко перекрывать их.
Компонент TNeuralNetHopf реализует нейронную сеть Хопфилда.
Дополнительно включены следующие методы: InitWeights – запоминает предъявленные образцы в матрице образов и метод Calc – вычисляет выход сети Хопфилда.
Компонент TNeuralNetBP реализует многослойную нейронную сеть обучаемую по алгоритму обратного распространения ошибки.
Дополнительно включены следующие методы: Compute – вычисляет выход нейронной сети, используется после обучения сети; TeachOffLine – обучает нейронную сеть. Компонент позволяет в режиме design-time, в окне Object Inspector, конструировать нейронную сеть добавляя или удаляя слои и нейроны в сети. Для этого используется редактор свойств NeuronsInLayer, имеющий следующий вид:
Совместимость с Neural Network Wizard
Следующим компонентом является TNeuralNetExtented порожденный от TNeuralNetBP, который обеспечивает полную совместимость с Neural Network Wizard. Дополнительно включены следующие методы: для записи (LoadPhase1, LoadPhase2, LoadPhase4, LoadNetwork) и чтения (SavePhase1, SavePhase2, SavePhase4, SaveNetwork) обученной нейронной сети в формате *.nnw; LoadDataFrom – загружает данные из текстового файла, а также метод NormalizeData нормализации входных и выходных данных; Train – для обучения нейронной сети; ComputeUnPrepData – для вычисления выхода сети, используется в том случае, если у вас входные значения ненормализованы.
Компонент позволяет в режиме design-time, в окне Object Inspector, выбирать нужные поля, а также задавать тип нормализации полей. Для этих целей используется редактор свойств, имеющий следующий вид:
Компонент TNeuralNetExtented один из самых мощных в библиотеке NeuralBase. Используя этот компонент, практически за считанные минуты можете получить готовое полнофункциональное приложение.
Демонстрационные программы
В качестве демонстрационных примеров приведены три программы, показывающие возможности предложенных компонентов.
Программа Recognition используя компонент TNeuralNetHopf , реализует нейронную сеть Хопфилда. Программа решает задачу распознавания образов. На вход сети подается некий образ, возможно искаженный или неполный и нейронная сеть восстанавливает образ, т.е. относит предъявляемый образ к одному из хранимых сетью образов, либо в случае неудачи, выдает новый образ, иногда называемый «химерой».
Программа XOR_Problem, реализует функцию «исключающее или», которая является стандартным тестом, после знаменитой работы Минского и Пейперта «Перцептроны». В основе программы лежит компонент TNeuralNetBP.
Программа EasyNNW, использующая компонент TNeuralNetExtented представляет собой аналог программы Neural Network Wizard, единственным отличием от NNW является несколько «облегченный» интерфейс. Данный пример показывает, насколько легко и быстро, создаются программы реализующие нейронные сети с достаточно хорошей функциональностью на основе библиотеки компонентов NeuralBase.
Вам может быть интересно:
- Быстродействие Deductor: файлы данных (до 10 млн. строк)
- Быстродействие Deductor: файлы данных (до 1 млн. строк)
- Быстродействие Deductor: файлы данных (до 100 тыс. строк)
- Быстродействие Deductor: файлы данных (параметры тестирования)
- Метод касательных в ABC-анализе