
Как посчитать количество записей sql
Размещение сквозной ссылки
Способы подсчета количества записей в каждой из таблиц базы данных
В этой стате рассматриваются несколько способов, с помощью которых можно подсчитать количество записей в таблицах базы данных MS SQL Server
Способ 1: Поскольку приведенный ниже sql-код для подсчета количества записей использует таблицу sysindexes, его результат зависит от того, была ли обновлена статистика.
select substring(o.name, 1, 30) Table_Name ,i.rows Number_of_Rows
from sysobjects o
inner join sysindexes i
on (o.id = i.id)
where o.xtype = ‘u’
and i.indid < 2
order by o.name
В приведенном примере xtype = ‘u’ используется для выбора объектов типа «таблица», а использование indid < 2 гарантирует выборку всех таблиц (как имеющих, так и не имеющих индексы).
Способ 2: Следующий sql-код также может быть использован для определения количества записей в таблицах базы данных. Для подсчета числа строк этот sql-код использует функцию агрегации. Обрамление кавычками выбранного названия таблицы необходимо для обработки пробелов в названии (если такие названия существуют).
SET NOCOUNT ON
DECLARE tables_cursor CURSOR
FOR
SELECT name FROM sysobjects WHERE type = ‘U’ order by 1
OPEN tables_cursor
DECLARE @tablename varchar(50)
FETCH NEXT FROM tables_cursor INTO @tablename
WHILE (@@fetch_status <> -1)
BEGIN
select @tablename = quotename(@tablename, ‘[]’)
DECLARE @CMD VARCHAR(100)
PRINT @TABLENAME
SELECT @CMD = ‘ select count(*) from ‘+@tablename+’ ‘
EXEC (@CMD)
FETCH NEXT FROM tables_cursor INTO @tablename
END
DEALLOCATE tables_cursor
SET NOCOUNT OFF
Способ 3: Для решения поставленной задачи можно также использовать недокументированную хранимую процедуру sp_Msforeachtable. Sp_Msforeachtable сканирует все таблицы в определенной базе данных и выполняет указанную sql-команду (ы) для каждой из таблиц. Для подстановки имени таблицы используется символ «?».
sp_msforeachtable @command1= ‘print »?»’, @command2 = «select count(*) from ?»
Финансы: форекс для тебя
Сколько записей в базе данных данной структуры. Как узнать
Представим, что наша база данных содержит некую таблицу, где мы ведем учет своих клиентов. Итак, наша таблица «customers» выглядит следующим образом:
|
Идентификатор, ID |
Customers_name |
Customers_age |
Customers_purchase |
|
1 |
Дмитрий Федорович |
24 |
4000 |
|
2 |
Петр Алексеевич |
26 |
5000 |
|
3 |
Василий Алибабаевич |
24 |
5000 |
|
4 |
Николай Павлович |
31 |
10000 |
|
5 |
Иван Николаевич |
28 |
5000 |
|
6 |
Кирилл Мефодиевич |
29 |
10000 |
Естественно, строк и столбцов в таблице с клиентами может быть очень много. Давайте посмотрим, как можно считать записи в таблице, используя разные вариации функции COUNT и ее условий.
К примеру, мы можем посчитать всех покупателей, у которых возраст будет 24 года. В этом случай SQL-запрос будет таким:
SELECT COUNT(*) as count FROM customers WHERE customers_age=24
В ответ на данный запрос мы получим результат — «2», потому что в нашей таблице есть всего 2 покупателя с таким возрастом.
Мы можем посчитать количество разных чеков наших покупателей. То ест ь мы будем считать количество разных сумм, которые оставили наши клиенты. Код SQL-запроса будет следующий:
SELECT COUNT(DISTINCT customers_purchase) as count FROM customers
В ответе на данный запрос мы получим ответ 3, потому что в нашей таблице всего 3 разных объема покупок: 4000, 5000 и 10000.
С помощью COUNT можно составлять и более сложные SQL-запросы. Например , в одном запросе мы можем посчитать сколько у нас разных возрастов в таблице и сколько у нас разных чеков покупки. В этом случае SQL-запрос будет выглядеть следующим образом:
SELECT
COUNT(DISTINCT costumers_age) as count_first,
COUNT(DISTINCT costumers_purchase) as count_second
FROM costumers
В результате такого запроса мы получим два столбца с названиями «count_first» с количеством возрастов «5» и «count_second» с количеством разных чеков «3».
Мы можем подсчитать общее количество записей в базе данных без особых условий. В этом случае SQL-запрос будет выглядеть следующим образом:
SELECT COUNT(*) as count FROM costumers
В ответ на этот запрос мы получим цифру «6», так как в нашей таблице всего 6 записей. Но тут есть одна хитрость. Когда мы указываем символ «*»(звездочка), тогда мы активируем подсчет абсолютно всех записей, даже тех, которые содержат в своих аргументах «NULL». Но вам не всегда нужно подсчитывать строки с «нулевым» значением. В этом случае в качестве аргумента функции COUNT нужно указать идентификатор какого-то столбца, тогда в результате будут отражаться только строки, которые содержат какие-то данные в указанном столбце. Например:
SELECT COUNT(customers_purchase) as count FROM costumers
В этом случае в результате мы получим сколько записей в базе данных имеют заполненные ячейки в столбце «customers_purchase». Важно помнить об этом. Потому что подсчеты строк в обоих случаях могут отличаться. К примеру, пользователь не совершил покупку, поэтому в столбце «customers_purchase» не заполнена ячейка. В этом случае при подсчете с COUNT(*) она попадет в результат, а при подсчете COUNT(customers_purchase) — нет.
Заключение
Как посчитать, сколько записей в базе данных? Самый верный способ — это использовать функцию COUNT. С помощью этой функции можно посчитать абсолютно все записи в базе данных: со значениями «NULL» и «NOT NULL». Помимо этого, совместно с функцией COUNT можно использовать команду WHERE и задавать условия подсчета записей, что делает работу функции COUNT очень гибкой.
Мы будем очень благодарны
если под понравившемся материалом Вы нажмёте одну из кнопок социальных сетей и поделитесь с друзьями.
COUNT(*)
У меня есть подборка простеньких вопросов, которые я люблю задавать при собеседовании. Например, как посчитать общее число записей к таблице? Вроде бы ничего сложного, но если копнуть глубже, то можно много интересных нюансов рассказать собеседнику.
Давайте начнем с простого… Эти запросы отличаются чем-то друг от друга с точки зрения конечного результата?
SELECT COUNT(*) FROM Sales.SalesOrderDetail SELECT COUNT_BIG(*) FROM Sales.SalesOrderDetail Большинство отвечали: «Нет».
Реже старались долее детально формировать ответ: «Запросы вернут идентичный результат, но COUNT вернет значение типа INT, а COUNT_BIG – тип BIGINT».
Если проанализировать план выполнения, то можно заметить различия, которые многие упускают из вида. При использовании COUNT на плане будет операция Compute Scalar:

Если посмотреть в свойства оператора, то мы увидим там:
[Expr1003] = Scalar Operator(CONVERT_IMPLICIT(int,[Expr1004],0)) Это происходит потому, что при вызове COUNT неявно используется COUNT_BIG после чего результат преобразуется в INT.
Не сказал бы, что существенно, но преобразования типов увеличивает нагрузку на процессор. Многие, конечно, могут сказать, что этот оператор ничего не стоит при выполнении, но нужно отметить простой факт – SQL Server очень часто недооценивает Compute Scalar операторы.
Еще я знаю людей, которые любят использовать SUM вместо COUNT:
SELECT SUM(1) FROM Sales.SalesOrderDetail Такой вариант примерно равнозначен COUNT. Мы также получим лишний Compute Scalar на плане выполнения:
[Expr1003] = Scalar Operator(CASE WHEN [Expr1004]=(0) THEN NULL ELSE [Expr1005] END) Теперь более детально затронем вопросы производительности.…
Если использовать запросы выше, то чтобы посчитать количество записей SQL Server необходимо выполнить Full Index Scan (или Full Table Scan если таблица является кучей). В любом случае, эти операции далеко не самые быстрые. Лучше всего для получения количества записей использовать системные представления: sys.dm_db_partition_stats или sys.partitions (есть еще sysindexes, но оставлен для обратной совместимости с SQL Server 2000).
USE AdventureWorks2012 GO SET STATISTICS IO ON SET STATISTICS TIME ON GO SELECT COUNT_BIG(*) FROM Sales.SalesOrderDetail SELECT SUM(p.[rows]) FROM sys.partitions p WHERE p.[object_id] = OBJECT_ID('Sales.SalesOrderDetail') AND p.index_id < 2 SELECT SUM(s.row_count) FROM sys.dm_db_partition_stats s WHERE s.[object_id] = OBJECT_ID('Sales.SalesOrderDetail') AND s.index_id < 2 Если сравнить планы выполнения, то доступ к системным представлениям менее затратный:

На AdventureWorks преимущество от применения системных представлений явно не проявляется:
Table 'SalesOrderDetail'. Scan count 1, logical reads 276, . SQL Server Execution Times: CPU time = 12 ms, elapsed time = 26 ms. Table 'sysrowsets'. Scan count 1, logical reads 5, . SQL Server Execution Times: CPU time = 4 ms, elapsed time = 4 ms. Table 'sysidxstats'. Scan count 1, logical reads 2, . SQL Server Execution Times: CPU time = 2 ms, elapsed time = 1 ms. Время выполнения на секционированной таблице с 30 миллионами записей:
Table 'big_test'. Scan count 6, logical reads 114911, . SQL Server Execution Times: CPU time = 4859 ms, elapsed time = 5079 ms. Table 'sysrowsets'. Scan count 1, logical reads 25, . SQL Server Execution Times: CPU time = 0 ms, elapsed time = 2 ms. Table 'sysidxstats'. Scan count 1, logical reads 2, . SQL Server Execution Times: CPU time = 0 ms, elapsed time = 2 ms. В случае если нужно проверить наличие записей в таблице, то использование метаданных как было показано выше не даст особых преимуществ…
IF EXISTS(SELECT * FROM Sales.SalesOrderDetail) PRINT 1 IF EXISTS( SELECT * FROM sys.dm_db_partition_stats WHERE [object_id] = OBJECT_ID('Sales.SalesOrderDetail') AND row_count > 0 ) PRINT 1 Table 'SalesOrderDetail'. Scan count 1, logical reads 2. SQL Server Execution Times: CPU time = 1 ms, elapsed time = 3 ms. Table 'sysidxstats'. Scan count 1, logical reads 2. SQL Server Execution Times: CPU time = 4 ms, elapsed time = 5 ms. И на практике будет даже капельку медленнее, поскольку SQL Server генерирует более сложный план выполнения для выборки из метаданных.

Еще интереснее становиться, когда нужно посчитать количество записей по всем таблицам сразу. На практике встречал несколько вариантов, которые можно обобщить.
Вариант #1 с применением недокументированной процедуры, которая курсором обходит все пользовательские таблицы:
IF OBJECT_ID('tempdb.dbo.#temp') IS NOT NULL DROP TABLE #temp GO CREATE TABLE #temp (obj SYSNAME, row_count BIGINT) GO EXEC sys.sp_MSForEachTable @command1 = 'INSERT #temp SELECT ''?'', COUNT_BIG(*) FROM ?' SELECT * FROM #temp ORDER BY row_count DESC Вариант #2 – динамический SQL которые генерирует запросы SELECT COUNT(*):
DECLARE @SQL NVARCHAR(MAX) SELECT @SQL = STUFF(( SELECT 'UNION ALL SELECT ''' + SCHEMA_NAME(o.[schema_id]) + '.' + o.name + ''', COUNT_BIG(*) FROM [' + SCHEMA_NAME(o.[schema_id]) + '].[' + o.name + ']' FROM sys.objects o WHERE o.[type] = 'U' AND o.is_ms_shipped = 0 FOR XML PATH(''), TYPE).value('.', 'NVARCHAR(MAX)'), 1, 10, '') + ' ORDER BY 2 DESC' PRINT @SQL EXEC sys.sp_executesql @SQL Вариант #3 – быстрый вариант на каждый день:
SELECT SCHEMA_NAME(o.[schema_id]), o.name, t.row_count FROM sys.objects o JOIN ( SELECT p.[object_id], row_count = SUM(p.row_count) FROM sys.dm_db_partition_stats p WHERE p.index_id < 2 GROUP BY p.[object_id] ) t ON t.[object_id] = o.[object_id] WHERE o.[type] = 'U' AND o.is_ms_shipped = 0 ORDER BY t.row_count DESC Уж очень много я выдал дифирамбов, что системные представления такие хорошие. Однако, при работе с ними нас могут подстерегать «приятные» неожиданности.
Помнится, был такой веселый баг, когда при миграции с SQL Server 2000 на 2005 некоторые системные представления некорректно обновлялись. Особо везучим людям, в таком случае, из метаданных возвращались неверные значения о количестве записей в таблицах. Лечилось это все командой DBCC UPDATEUSAGE.
Вместе с SQL Server 2005 SP1 этот баг исправили и все бы ничего… Но подобную ситуацию я наблюдал еще один раз, когда восстановил бекап с SQL Server 2005 SP4 на SQL Server 2012 SP2. Воспроизвести проблему на реальном окружении увы не смогу, поэтому немного обманув оптимизатор:
UPDATE STATISTICS Person.Person WITH ROWCOUNT = 1000000000000000000 расскажу на простом примере.
Самый безобидный запрос начал выполняться дольше чем обычно:
SELECT FirstName, COUNT(*) FROM Person.Person GROUP BY FirstName Посмотрел на план запроса и увидел там явно неадекватное значение Estimated number of rows:
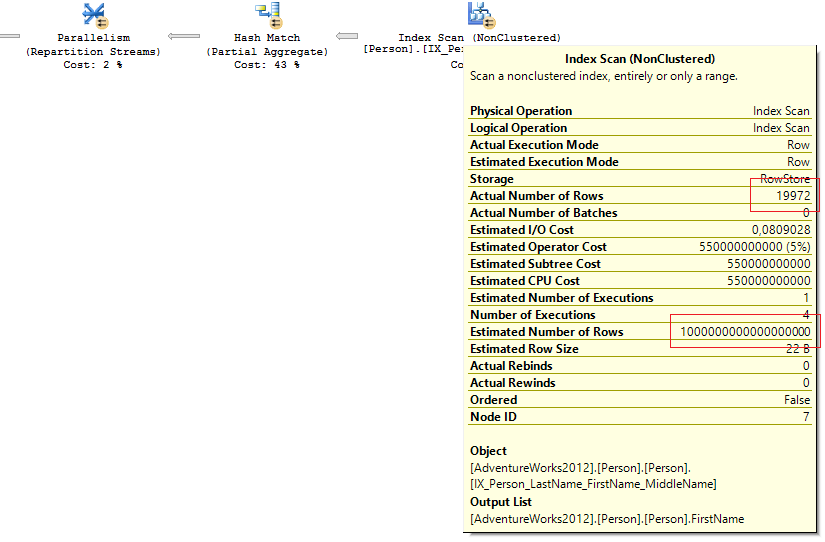
Заглянул в статистику по кластерному индексу:
DECLARE @SQL NVARCHAR(MAX) DECLARE @obj SYSNAME = 'Person.Person' SELECT @SQL = 'DBCC SHOW_STATISTICS(''' + @obj + ''', ' + name + ') WITH STAT_HEADER' FROM sys.stats WHERE [object_id] = OBJECT_ID(@obj) AND stats_id < 2 EXEC sys.sp_executesql @SQL Все было в норме:
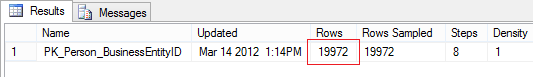
Но в системных представления о которых мы говорили ранее:
SELECT rowcnt FROM sys.sysindexes WHERE AND indid < 2 SELECT SUM([rows]) FROM sys.partitions p WHERE p.[object_id] = OBJECT_ID('Person.Person') AND p.index_id < 2 
В запросе не было предикатов для фильтрации и оптимизатор выбрал Full Index Scan. При Full Index/Table Scan ожидаемое количество строк оптимизатор не берет из статистики, а обращается к метаданным (точно не уверен всегда ли это происходит).
Не секрет, что на основе Estimated number of rows SQL Server генерирует план выполнения и вычисляет сколько нужно памяти чтобы его выполнить. Если оценка будет неверной, то может быть выделено больше памяти на выполнение запроса, чем нужно на самом деле.
SELECT session_id, query_cost, requested_memory_kb, granted_memory_kb, required_memory_kb, used_memory_kb FROM sys.dm_exec_query_memory_grants Вот к чему приводит неверная оценка количества строк:
query_cost requested_memory_kb granted_memory_kb required_memory_kb used_memory_kb ----------- -------------------- -------------------- -------------------- -------------- 1133156839 769552 769552 6504 6026 Проблема решилась достаточно просто:
DBCC UPDATEUSAGE(AdventureWorks2012, 'Person.Person') WITH COUNT_ROWS DBCC FREEPROCCACHE После рекомпиляции запроса все пришло в норму:
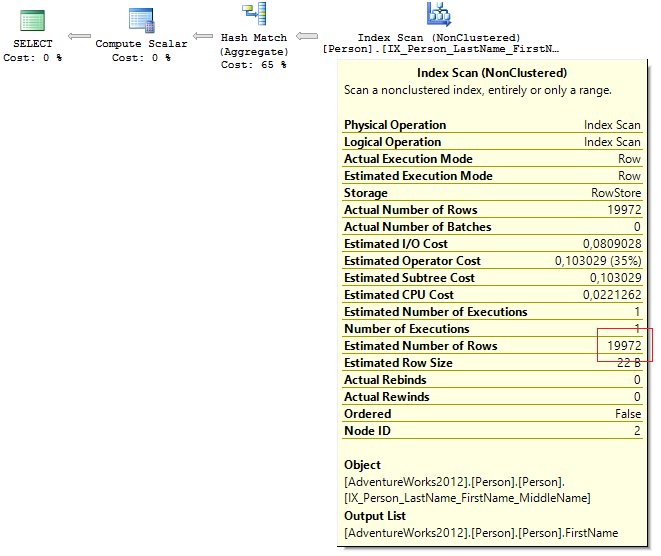
query_cost requested_memory_kb granted_memory_kb required_memory_kb used_memory_kb ----------- -------------------- -------------------- -------------------- -------------- 0,2919 1168 1168 1024 952 Если системные представления уже не кажутся «спасительной палочкой», то какие варианты у нас остаются? Можно делать все по-старинке:
SELECT COUNT_BIG(*) FROM . Но при интенсивной вставке в таблицу я бы не доверял результатам. «Волшебный» хинт NOLOCK тем более не гарантирует правильного значения:
SELECT COUNT_BIG(*) FROM . WITH(NOLOCK) По сути, чтобы получить правильное значение количества строк в таблице, нужно выполнять запрос под уровнем изоляции SERIALIZABLE либо используя хинт TABLOCKX:
SELECT COUNT_BIG(*) FROM . WITH(TABLOCKX) И что мы получаем в итоге… монопольную блокировку таблицы на период выполнении запроса. И тут каждый должен решать сам, что ему лучше использовать. Мой выбор — метаданные.
Еще интереснее, когда нужно быстро подсчитать число строк по условию:
SELECT City, COUNT_BIG(*) FROM Person.[Address] --WHERE City = N'London' GROUP BY City Если в таблице не происходят частые операции вставки-удаления, то можно создать индексированное представление:
IF OBJECT_ID('dbo.CityAddress', 'V') IS NOT NULL DROP VIEW dbo.CityAddress GO CREATE VIEW dbo.CityAddress WITH SCHEMABINDING AS SELECT City, [Rows] = COUNT_BIG(*) FROM Person.[Address] GROUP BY City GO CREATE UNIQUE CLUSTERED INDEX IX ON dbo.CityAddress (City) Для этих запросов оптимизатор будет генерировать идентичный план на основе кластерного индекса вьюхи:
SELECT City, COUNT_BIG(*) FROM Person.[Address] WHERE City = N'London' GROUP BY City SELECT * FROM dbo.CityAddress WHERE City = N'London' План выполнения с индексным представлением и без:
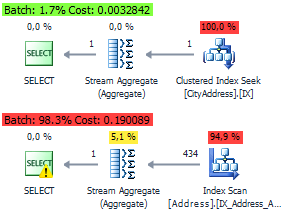
Этим постом я хотел показать, что идеальных решений на все случаи жизни не бывает. И в каждом конкретной ситуации нужно действовать с индивидуальным подходом.
Все тестировалось на SQL Server 2012 SP3 (11.00.6020).
В качестве выводов… Когда нужно подсчитать общее число строк по таблице, то я использую метаданные — это самый быстрый способ. И пусть Вас не пугает ситуация с старым багом, который я привел выше.
Если нужно быстро подсчитать количество строк в разрезе какого-то поля или по условию — то я стараюсь использовать индексированные представления либо фильтрованные индексы. Все зависит от ситуации.
Когда таблица маленькая или вопросы с производительностью не стоят так остро, то проще уж действительно по-старинке написать SELECT COUNT(*)…
Если хотите поделиться этой статьей с англоязычной аудиторией:
What is the fastest way to calculate the record COUNT?
- sql server
- sql
- optimization
- execution plan
- sys.dm_db_partition_stats
- sys.partitions
- perfomance
- SQL
- Microsoft SQL Server
Форум пользователей MySQL
Таблица с двумя столбцами: id и время в datetime
Нужно получить количество строк в интервале 24 часа, с шагом в 20 минут.
#2 13.12.2011 13:28:33
deadka Администратор Зарегистрирован: 14.11.2007 Сообщений: 2417
Re: Посчитать количество строк в интервале
Вообще-то его и так можно посчитать- 24 * 3 .
Или у Вас есть пропуски в шагах?
Зеленый свет для слабаков, долги отдают только трусы, тру гики работают только в консоли.
#3 13.12.2011 13:55:25
iAmUser Участник Зарегистрирован: 13.12.2011 Сообщений: 3
Re: Посчитать количество строк в интервале
Нужно посчитать сколько записей было добавлено за каждые 20 минут, в течении 24 часов.
Т.е. :
с 00:00 часов по 00:20,
с 00:20 по 00:40,
с 00:40 по 1:00
#4 13.12.2011 14:01:21
deadka Администратор Зарегистрирован: 14.11.2007 Сообщений: 2417
Re: Посчитать количество строк в интервале
Зеленый свет для слабаков, долги отдают только трусы, тру гики работают только в консоли.
#5 13.12.2011 14:37:04
iAmUser Участник Зарегистрирован: 13.12.2011 Сообщений: 3
Re: Посчитать количество строк в интервале
deadka написал:
Спасибо, то что надо.
Буду признателен если расскажите про "starttime - interval( UNIX_TIMESTAMP( starttime ) %300) second"
Что делает символ %
#6 13.12.2011 14:40:05
deadka Администратор Зарегистрирован: 14.11.2007 Сообщений: 2417
Re: Посчитать количество строк в интервале
% - это остаток от деления.
приведенная конструкция отсекает "лишнее" от начала очередного пятиминутного интервала.