
Сохранить промежуточные результаты обучения (checkpoints)
Промежуточные результаты, или контрольные точки обучения (checkpoints), содержат информацию о конфигурации модели, ее переменных, градиентах и весах.
Сохранение промежуточных результатов позволяет:
- Не потерять результаты обучения, если задача по какой-то причине остановилась, например из-за выхода за денежный лимит или ошибок обучения. Пользователь сможет возобновить обучение модели из последнего сохраненного состояния.
- Делиться обученными моделями с коллегами, чтобы те могли восстановить объект с моделью без повторного обучения.
Рекомендуется сохранять промежуточные результаты с некоторой периодичностью, например, в конце каждой эпохи или после того, как закончится итерация по небольшим блокам обучения (batches).
В процессе обучения модели промежуточные результаты сохраняются в рабочем каталоге пользователя /home/jovyan/ . Их можно скачать через веб-интерфейс Jupyter Notebook/JupyterLab или скопировать в хранилище S3 из локально доступной файловой системы. Подробнее о выгрузке промежуточных результатов обучения на S3 — в примере.
Рассмотрим, как сохранять промежуточные результаты обучения для наиболее распространенных фреймворков.
Keras
Чтобы сохранить промежуточные результаты и зафиксировать состояние модели в определенный момент, используется механизм обратных вызовов (callbacks) как экземпляр класса ModelCheckpoint.
# Horovod: save checkpoints only on worker 0 to prevent other workers from corrupting them if hvd.rank() == 0: callbacks.append(tf.keras.callbacks.ModelCheckpoint(os.path.join('checkpoints','checkpoint- .h5')) # Train the model # Horovod: adjust number of steps based on number of GPUs mnist_model.fit(dataset, steps_per_epoch=500 // hvd.size(), callbacks=callbacks, epochs=24, verbose=verbose)
TensorFlow
Восстановить сеанс Tensorflow можно, использовав конструктор MonitoredTrainingSession() с аргументом checkpoint_dir .
# Horovod: Save checkpoints only on worker 0 to prevent other workers from corrupting them checkpoint_dir = '/tmp/train_logs' if hvd.rank() == 0 else None # The MonitoredTrainingSession takes care of session initialization, # restoring from a checkpoint, saving to a checkpoint, and closing when done # or an error occurs with tf.train.MonitoredTrainingSession(checkpoint_dir=checkpoint_dir, some_other_variables>) as sess:
PyTorch
Сохранение параметров модели с помощью torch.save() .
# Save checkpoints only on worker 0 to prevent other workers from corrupting them if hvd.rank() == 0 torch.save(the_model.state_dict(), PATH)
Ниже показано, как возобновить обучение модели из последнего сохраненного состояния. За основу взят следующий пример.
num_epochs = 3 print(f'Start train num_epochs> epochs total') # Loading from checkpoint # https://pytorch.org/tutorials/beginner/saving_loading_models.html last_epoch = 0 import os for root, dirs, files in os.walk(BASE_DIR.joinpath('logs')): saved_models = [model_filename for model_filename in files if ".bin" in model_filename] if saved_models: checkpoint = torch.load(os.path.join(root, saved_models[-1])) clf.load_state_dict(checkpoint['model_state_dict']) # Loading model weights and other training parameters optimizer.load_state_dict(checkpoint['optimizer_state_dict']) last_epoch = checkpoint['epoch'] print(f"Continue training from last_epoch> epoch") # Start training mlflow.set_tracking_uri('file:/home/jovyan/mlruns') mlflow.set_experiment("pytorch_tensorboard_mlflow.ipynb") with mlflow.start_run(nested=True) as run: for epoch in range(num_epochs): if last_epoch: epoch += last_epoch + 1 print("Epoch %d" % epoch) train(epoch, clf, optimizer, writer) test(epoch, clf, writer) # Save checkpoint every epoch torch.save( 'epoch': epoch, 'model_state_dict': clf.state_dict(), 'optimizer_state_dict': optimizer.state_dict(), >, BASE_DIR.joinpath('logs/log_' + current_time + f"/model_epoch_epoch>.bin")) writer.close()
Python. Урок 21. Работа с контекстным менеджером

Контекстные менеджеры позволяют задать поведение при работе с конструкцией with: при входе и выходе из блока. Это упрощает работу с ресурсами в части их захвата и освобождения; транзакциями, когда нужно либо полностью закончить транзакцию, либо откатить ее целиком. Этой теме будет посвящен данный урок.
- Работа с контекстным менеджером
- Создание своего контекстного менеджера
- Работа с contextlib
Работа с контекстным менеджером
Рассмотрим пример, на котором будут показаны преимущества работы с контекстным менеджером. Задача состоит в следующем: записать в файл file.txt строку hello .
Самый простой способ ее решить – это воспользоваться функцией open() для открытия файла и записать в него данные через функцию write() . При этом нужно не забыть освободить ресурс, вызвав функцию close() .
f = open(‘file.txt’, ‘w’) f.write(‘hello’) f.close()
Но это не очень хорошее решение, если в процессе работы с файлом (запись, чтение), произошло исключение, то функция close() не будет вызвана, что влечет за собой возможную потерю данных. Для решения этого вопроса воспользуемся обработкой исключения:
f = open('file.txt', 'w') try: f.write('hello') except: print('Some error!') finally: f.close()
Для того, чтобы не писать дополнительный код, связанный с обработкой исключений (это неудобно и об этом можно забыть), можно воспользоваться конструкцией with… as :
with open('file.txt', 'w') as f: f.write('hello')
Такая конструкция позволяет захватить ресурс (в данном случае файл), выполнить нужный набор операций (запись данных), а перед выходом – освободить ресурс.
Создание своего контекстного менеджера
Если сущность, которую вы создаете, по стилю работы с ней похожа на файл, т.е. предполагает захват ресурса и освобождение, либо требует выполнения определенных действий перед началом работы и при завершении, то хорошим решением будет создать свой контекстный менеджер, с которым можно будет работать с помощью конструкции with..as. Для этого, в класс необходимо добавить два метода: __enter__ и __exit__ .
Перед тем как перейти к примеру, демонстрирующему работу с этими функциями, рассмотрим, что происходит (какие методы и в каком порядке вызываются) в конструкции:
with open('file.txt', 'w') as file_data: file_data.write('hello')
- Оператор with сохраняет метод __exit__ класса File .
- Вызывается метод __enter__ класса File .
- __enter__ открывает файл и возвращает его.
- Дескриптор открытого класса передается в file_data .
- В файл записываются данные через метод write.
- Вызывается сохраненный метод __exit__ , который закрывает файл.
Если внутри конструкции with происходит исключение, то оно передается в метод __exit__ , в котором производится его обработка и освобождение ресурсов (закрытие файла).
Пример реализации контекстного менеджера
Создадим класс, у объекта которого необходимо вызывать метод post_work() перед прекращением работы с ним:
class Resource: def __init__(self, name): print('Resource: create <>'.format(name)) self.__name = name def get_name(self): return self.__name def post_work(self): print('Resource: close')
Теперь создадим контекстный менеджер для работы с Resource , который можно будет использовать с оператором with:
class ResourceForWith: def __init__(self, name): self.__resource = Resource(name) def __enter__(self): return self.__resource def __exit__(self, type, value, traceback): self.__resource.post_work()
Пример работы с ResourceForWith и конструкцией with :
with ResourceForWith('Worker') as r: print(r.get_name())
Если выполнить этот код, то получим следующий вывод на консоль
>python test.py Resource: create Worker Worker Resource: close
Работа с contextlib
В стандартную библиотеку Python входит модуль contextlib , который содержит утилиты для построения и работы с контекстными менеджерами.
Рассмотрим только один инструмент из всего набора – contextmanager . contextmanager используется как декоратор для функции, превращая ее в контекстный менеджер. При этом схема конструирования такая: все, что написано до оператора yield вызывается в рамках функции __enter__ , а все что после – в рамках __exit__ .
Рассмотрим несколько примеров:
from contextlib import contextmanager @contextmanager def processor(): print('--> start processing') yield print('
В contextmanager можно завернуть работу с файлом :
from contextlib import contextmanager @contextmanager def open_file(path, mode): f = open(path, mode) yield f f.close() with open_file('test.txt', 'w') as fw: fw.write('hello')
P.S.
Вводные уроки по “Линейной алгебре на Python” вы можете найти соответствующей странице нашего сайта . Все уроки по этой теме собраны в книге “Линейная алгебра на Python”.
Если вам интересна тема анализа данных, то мы рекомендуем ознакомиться с библиотекой Pandas. Для начала вы можете познакомиться с вводными уроками. Все уроки по библиотеке Pandas собраны в книге “Pandas. Работа с данными”.
Раздел: Python Уроки по Python Метки: Python, Уроки Python
Python. Урок 21. Работа с контекстным менеджером : 4 комментария
- Олег 02.04.2020 Добрый день! Подскажите, как можно реализовать менеджер контекста для измерения времени выполнения какого-либо кода с помощью with и показывать результат измерения после завершения исполнения этого кода.
по типу: >>> with Timer ():
do_some_long_stuff () Time: 10.004614966004738
- yossik 11.04.2020 Например вот так: from contextlib import contextmanager
import time @contextmanager
def timer():
start_time = time.time()
yield
print(“— %s seconds —” % (time.time() – start_time)) with timer():
for i in range(1000):
junk = list(range(i**2))
print(“–DONE–“)
Многопоточность в Python - шпаргалка для начинающих
Модуль threading Python 3 построен на низкоуровневых функциях thread, что делает работу с потоками проще. Потоки в Python позволяет программе запускать одновременно несколько операций в одном пространстве процесса.
Объекты потоков
Самый простой способ использовать поток - создать его с помощью целевой функции и запустить с помощью метода start() .
import threading def worker(): """thread worker function""" print 'Worker' return threads = [] for i in range(5): t = threading.Thread(target=worker) threads.append(t) t.start()
Результат работы программы – пять строк со строкой "Worker":
$ python threading_simple.py Worker Worker Worker Worker Worker
В приведенном ниже примере в качестве аргумента потоку передается число для вывода.
import threading def worker(num): """thread worker function""" print 'Worker: %s' % num return threads = [] for i in range(5): t = threading.Thread(target=worker, args=(i,)) threads.append(t) t.start()
Целочисленный аргумент теперь включен в сообщение, выводимое каждым потоком:
$ python -u threading_simpleargs.py Worker: 0 Worker: 1 Worker: 2 Worker: 3 Worker: 4
Определение текущего потока
Использование аргументов для идентификации потока является трудоемким процессом. Каждый экземпляр Thread имеет имя со значением, присваиваемым по умолчанию. Оно может быть изменено, когда создается поток.
Именование потоков полезно в серверных процессах с несколькими служебными потоками, обрабатывающими различные операции.
import threading import time def worker(): print threading.currentThread().getName(), 'Starting' time.sleep(2) print threading.currentThread().getName(), 'Exiting' def my_service(): print threading.currentThread().getName(), 'Starting' time.sleep(3) print threading.currentThread().getName(), 'Exiting' t = threading.Thread(name='my_service', target=my_service) w = threading.Thread(name='worker', target=worker) w2 = threading.Thread(target=worker) # используем имя по умолчанию w.start() w2.start() t.start()
Программа выводит имя текущего потока в каждой строке. «Thread-1» - это безымянный поток w2 .
$ python -u threading_names.py worker Thread-1 Starting my_service Starting Starting Thread-1worker Exiting Exiting my_service Exiting
Большинство программ не используют print для отладки. Модуль logging поддерживает добавление имени потока в каждое сообщение журнала с помощью % (threadName)s. Включение имен потоков в журнал облегчает отслеживание этих сообщений.
import logging import threading import time logging.basicConfig(level=logging.DEBUG, format='[%(levelname)s] (%(threadName)-10s) %(message)s', ) def worker(): logging.debug('Starting') time.sleep(2) logging.debug('Exiting') def my_service(): logging.debug('Starting') time.sleep(3) logging.debug('Exiting') t = threading.Thread(name='my_service', target=my_service) w = threading.Thread(name='worker', target=worker) w2 = threading.Thread(target=worker) # use default name w.start() w2.start() t.start()
Модуль logging также является поточно-ориентированным, поэтому сообщения из разных потоков сохранятся в выводимых данных.
$ python threading_names_log.py [DEBUG] (worker ) Starting [DEBUG] (Thread-1 ) Starting [DEBUG] (my_service) Starting [DEBUG] (worker ) Exiting [DEBUG] (Thread-1 ) Exiting [DEBUG] (my_service) Exiting
Daemon потоки non-daemon
До этого момента примеры программ ожидали, пока все потоки не завершат свою работу. Иногда программы порождают такой поток, как демон. Он работает, не блокируя завершение основной программы.
Использование демона полезно, если не удается прервать поток или завершить его в середине работы, не потеряв и не повредив при этом данные.
Чтобы пометить поток как demon, вызовите метод setDaemon() с логическим аргументом. По умолчанию потоки не являются «демонами», поэтому передача в качестве аргумента значения True включает режим demon.
import threading import time import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def daemon(): logging.debug('Starting') time.sleep(2) logging.debug('Exiting') d = threading.Thread(name='daemon', target=daemon) d.setDaemon(True) def non_daemon(): logging.debug('Starting') logging.debug('Exiting') t = threading.Thread(name='non-daemon', target=non_daemon) d.start() t.start()
Обратите внимание, что в выводимых данных отсутствует сообщение «Exiting» от потока-демона. Все потоки, не являющиеся «демонами» (включая основной поток), завершают работу до того, как поток-демон выйдет из двухсекундного сна.
$ python threading_daemon.py (daemon ) Starting (non-daemon) Starting (non-daemon) Exiting
Чтобы дождаться завершения работы потока-демона, используйте метод join() .
import threading import time import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def daemon(): logging.debug('Starting') time.sleep(2) logging.debug('Exiting') d = threading.Thread(name='daemon', target=daemon) d.setDaemon(True) def non_daemon(): logging.debug('Starting') logging.debug('Exiting') t = threading.Thread(name='non-daemon', target=non_daemon) d.start() t.start() d.join() t.join()
Метод join() позволяет demon вывести сообщение «Exiting».
$ python threading_daemon_join.py (daemon ) Starting (non-daemon) Starting (non-daemon) Exiting (daemon ) Exiting
Также можно передать аргумент задержки (количество секунд, в течение которых поток будет неактивным).
import threading import time import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def daemon(): logging.debug('Starting') time.sleep(2) logging.debug('Exiting') d = threading.Thread(name='daemon', target=daemon) d.setDaemon(True) def non_daemon(): logging.debug('Starting') logging.debug('Exiting') t = threading.Thread(name='non-daemon', target=non_daemon) d.start() t.start() d.join(1) print 'd.isAlive()', d.isAlive() t.join()
Истекшее время ожидания меньше, чем время, в течение которого поток-демон спит. Поэтому поток все еще «жив» после того, как метод join() продолжит свою работу.
$ python threading_daemon_join_timeout.py (daemon ) Starting (non-daemon) Starting (non-daemon) Exiting d.isAlive() True
Нумерация потоков
Можно не сохранять дескрипторы всех потоков-демонов, чтобы убедиться в их завершении до выхода из основного процесса. enumerate() возвращает список активных экземпляров Thread . Список включает в себя текущий поток. Но присоединение к текущему потоку не разрешено (это приводит к ситуации взаимной блокировки), его необходимо пропустить.
import random import threading import time import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def worker(): """thread worker function""" t = threading.currentThread() pause = random.randint(1,5) logging.debug('sleeping %s', pause) time.sleep(pause) logging.debug('ending') return for i in range(3): t = threading.Thread(target=worker) t.setDaemon(True) t.start() main_thread = threading.currentThread() for t in threading.enumerate(): if t is main_thread: continue logging.debug('joining %s', t.getName()) t.join()
Поскольку worker спит в течение случайного отрезка времени, выходные данные программы могут отличаться. Это должно выглядеть примерно так:
$ python threading_enumerate.py (Thread-1 ) sleeping 3 (Thread-2 ) sleeping 2 (Thread-3 ) sleeping 5 (MainThread) joining Thread-1 (Thread-2 ) ending (Thread-1 ) ending (MainThread) joining Thread-3 (Thread-3 ) ending (MainThread) joining Thread-2
Подклассы потоков
При запуске Thread выполняет базовую инициализацию и затем вызывает свой метод run() . Он в свою очередь вызывает целевую функцию, переданную конструктору. Чтобы создать подкласс Thread , переопределите run() .
import threading import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) class MyThread(threading.Thread): def run(self): logging.debug('running') return for i in range(5): t = MyThread() t.start()
Возвращаемое значение метода run() игнорируется.
$ python threading_subclass.py (Thread-1 ) running (Thread-2 ) running (Thread-3 ) running (Thread-4 ) running (Thread-5 ) running
Значения args и kwargs, передаваемые в конструктор Thread , сохраняются в private переменных. Поэтому к ним трудно получить доступ из подкласса.
Для передачи аргументов пользовательскому потоку, переопределите конструктор, чтобы сохранить значения в атрибуте экземпляра.
import threading import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) class MyThreadWithArgs(threading.Thread): def __init__(self, group=None, target=None, name=None, args=(), kwargs=None, verbose=None): threading.Thread.__init__(self, group=group, target=target, name=name, verbose=verbose) self.args = args self.kwargs = kwargs return def run(self): logging.debug('running with %s and %s', self.args, self.kwargs) return for i in range(5): t = MyThreadWithArgs(args=(i,), kwargs=) t.start()
MyThreadWithArgs использует тот же API, что и Thread . Но другой класс может легко изменить метод конструктора, чтобы принимать другие аргументы, связанные с назначением потока.
$ python threading_subclass_args.py (Thread-1 ) running with (0,) and (Thread-2 ) running with (1,) and (Thread-3 ) running with (2,) and (Thread-4 ) running with (3,) and (Thread-5 ) running with (4,) and
Таймеры потока
Timer начинает свою работу после задержки и может быть отменен в любой момент этой задержки.
import threading import time import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def delayed(): logging.debug('worker running') return t1 = threading.Timer(3, delayed) t1.setName('t1') t2 = threading.Timer(3, delayed) t2.setName('t2') logging.debug('starting timers') t1.start() t2.start() logging.debug('waiting before canceling %s', t2.getName()) time.sleep(2) logging.debug('canceling %s', t2.getName()) t2.cancel() logging.debug('done')
Второй таймер никогда не запускается, а первый запускается после завершения работы основной программы. Поскольку это не поток-демона, он присоединяется неявно, когда основной поток завершен.
$ python threading_timer.py (MainThread) starting timers (MainThread) waiting before canceling t2 (MainThread) canceling t2 (MainThread) done (t1 ) worker running
Сигналы между потоками
Бывают случаи, когда нужно синхронизировать операции в двух или более потоках. Простой способ реализации – использование объектов Event .
Event управляет внутренним флагом, который вызывающий объект может либо устанавливать ( set()) либо сбрасывать ( clear()) . Другие потоки могут ждать ( wait()) , пока флаг не будет установлен ( set()) ,блокируя процесс, пока не будет разрешено продолжить выполнение.
import logging import threading import time logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def wait_for_event(e): """Wait for the event to be set before doing anything""" logging.debug('wait_for_event starting') event_is_set = e.wait() logging.debug('event set: %s', event_is_set) def wait_for_event_timeout(e, t): """Wait t seconds and then timeout""" while not e.isSet(): logging.debug('wait_for_event_timeout starting') event_is_set = e.wait(t) logging.debug('event set: %s', event_is_set) if event_is_set: logging.debug('processing event') else: logging.debug('doing other work') e = threading.Event() t1 = threading.Thread(name='block', target=wait_for_event, args=(e,)) t1.start() t2 = threading.Thread(name='non-block', target=wait_for_event_timeout, args=(e, 2)) t2.start() logging.debug('Waiting before calling Event.set()') time.sleep(3) e.set() logging.debug('Event is set')
Метод wait() принимает время задержки. Он возвращает логическое значение, указывающее, установлено событие или нет. Поэтому вызывающий объект знает, почему был возвращен wait() . Метод isSet() можно использовать для события отдельно, не опасаясь блокировки.
В этом примере wait_for_event_timeout() проверяет состояние события без бесконечной блокировки. wait_for_event() блокирует вызов wait() , который не возобновляет свою работу до изменения статуса события.
$ python threading_event.py (block ) wait_for_event starting (non-block ) wait_for_event_timeout starting (MainThread) Waiting before calling Event.set() (non-block ) event set: False (non-block ) doing other work (non-block ) wait_for_event_timeout starting (MainThread) Event is set (block ) event set: True (non-block ) event set: True (non-block ) processing event
Контроль доступа к ресурсам
Помимо синхронизации операций с потоками, также важно иметь возможность контролировать доступ к общим ресурсам, чтобы предотвратить повреждение данных.
Встроенные в Python структуры данных (списки, словари и т. д.) являются поточно-ориентированными. Другие структуры данных, реализованные в Python, и более простые типы (целые числа и числа с плавающей запятой) имеют такой защиты. Для защиты от одновременного доступа к объекту используйте объект Lock .
import logging import random import threading import time logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) class Counter(object): def __init__(self, start=0): self.lock = threading.Lock() self.value = start def increment(self): logging.debug('Waiting for lock') self.lock.acquire() try: logging.debug('Acquired lock') self.value = self.value + 1 finally: self.lock.release() def worker(c): for i in range(2): pause = random.random() logging.debug('Sleeping %0.02f', pause) time.sleep(pause) c.increment() logging.debug('Done') counter = Counter() for i in range(2): t = threading.Thread(target=worker, args=(counter,)) t.start() logging.debug('Waiting for worker threads') main_thread = threading.currentThread() for t in threading.enumerate(): if t is not main_thread: t.join() logging.debug('Counter: %d', counter.value)
В этом примере функция worker() увеличивает экземпляр Counter , который управляет Lock, чтобы два потока не могли одновременно изменить свое внутреннее состояние. Если Lock не использовался, можно пропустить изменение значения атрибута.
$ python threading_lock.py (Thread-1 ) Sleeping 0.47 (Thread-2 ) Sleeping 0.65 (MainThread) Waiting for worker threads (Thread-1 ) Waiting for lock (Thread-1 ) Acquired lock (Thread-1 ) Sleeping 0.90 (Thread-2 ) Waiting for lock (Thread-2 ) Acquired lock (Thread-2 ) Sleeping 0.11 (Thread-2 ) Waiting for lock (Thread-2 ) Acquired lock (Thread-2 ) Done (Thread-1 ) Waiting for lock (Thread-1 ) Acquired lock (Thread-1 ) Done (MainThread) Counter: 4
Чтобы выяснить, применил ли другой поток блокировку, не задерживая текущий поток, передайте значение False аргументу blocking функции acquire() .
В следующем примере worker() пытается применить блокировку три раза и подсчитывает, сколько попыток нужно сделать. А lock_holder() выполняет циклическое переключение между снятием и запуском блокировки с короткими паузами в каждом состоянии, используемом для имитации загрузки.
import logging import threading import time logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def lock_holder(lock): logging.debug('Starting') while True: lock.acquire() try: logging.debug('Holding') time.sleep(0.5) finally: logging.debug('Not holding') lock.release() time.sleep(0.5) return def worker(lock): logging.debug('Starting') num_tries = 0 num_acquires = 0 while num_acquires < 3: time.sleep(0.5) logging.debug('Trying to acquire') have_it = lock.acquire(0) try: num_tries += 1 if have_it: logging.debug('Iteration %d: Acquired', num_tries) num_acquires += 1 else: logging.debug('Iteration %d: Not acquired', num_tries) finally: if have_it: lock.release() logging.debug('Done after %d iterations', num_tries) lock = threading.Lock() holder = threading.Thread(target=lock_holder, args=(lock,), name='LockHolder') holder.setDaemon(True) holder.start() worker = threading.Thread(target=worker, args=(lock,), name='Worker') worker.start()
worker() требуется более трех итераций, чтобы применить блокировку три раза.
$ python threading_lock_noblock.py (LockHolder) Starting (LockHolder) Holding (Worker ) Starting (LockHolder) Not holding (Worker ) Trying to acquire (Worker ) Iteration 1: Acquired (Worker ) Trying to acquire (LockHolder) Holding (Worker ) Iteration 2: Not acquired (LockHolder) Not holding (Worker ) Trying to acquire (Worker ) Iteration 3: Acquired (LockHolder) Holding (Worker ) Trying to acquire (Worker ) Iteration 4: Not acquired (LockHolder) Not holding (Worker ) Trying to acquire (Worker ) Iteration 5: Acquired (Worker ) Done after 5 iterations
Повторные блокировки
Обычные объекты Lock не могут быть получены более одного раза даже одним и тем же потоком. Это может привести к нежелательным эффектам, если доступ к блокировке осуществляется несколькими функциями в одной цепочке вызовов.
import threading lock = threading.Lock() print 'First try :', lock.acquire() print 'Second try:', lock.acquire(0)
Обе функции используют одну и ту же глобальную блокировку, а одна вызывает другую. Поэтому второй вызов завершится неудачно и будет заблокирован с использованием аргументов по умолчанию для acquire() .
$ python threading_lock_reacquire.py First try : True Second try: False
В ситуации, когда отдельный код из одного и того же потока должен «повторно применить» блокировку, используйте RLock .
import threading lock = threading.RLock() print 'First try :', lock.acquire() print 'Second try:', lock.acquire(0)
Единственным изменением в коде предыдущего примера является замена RLock на Lock .
$ python threading_rlock.py First try : True Second try: 1
Блокировки как менеджеры контекста
Блокировки реализуют API context manager и совместимы с оператором with . Использование оператора with позволяет обойтись без блокировки.
import threading import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def worker_with(lock): with lock: logging.debug('Lock acquired via with') def worker_no_with(lock): lock.acquire() try: logging.debug('Lock acquired directly') finally: lock.release() lock = threading.Lock() w = threading.Thread(target=worker_with, args=(lock,)) nw = threading.Thread(target=worker_no_with, args=(lock,)) w.start() nw.start()
Функции worker_with() и worker_no_with() управляют блокировкой эквивалентными способами.
$ python threading_lock_with.py (Thread-1 ) Lock acquired via with (Thread-2 ) Lock acquired directly
Синхронизация потоков
Другой способ синхронизации потоков – объект Condition . Поскольку Condition использует Lock , его можно привязать к общему ресурсу. Это позволяет потокам ожидать обновления ресурса.
В приведенном ниже примере поток consumer() будет ждать , пока не будет установлено Condition , прежде чем продолжить. Поток producer() отвечает за установку Condition и уведомление других потоков о том, что они могут продолжить выполнение.
import logging import threading import time logging.basicConfig(level=logging.DEBUG, format='%(asctime)s (%(threadName)-2s) %(message)s', ) def consumer(cond): """wait for the condition and use the resource""" logging.debug('Starting consumer thread') t = threading.currentThread() with cond: cond.wait() logging.debug('Resource is available to consumer') def producer(cond): """set up the resource to be used by the consumer""" logging.debug('Starting producer thread') with cond: logging.debug('Making resource available') cond.notifyAll() condition = threading.Condition() c1 = threading.Thread(name='c1', target=consumer, args=(condition,)) c2 = threading.Thread(name='c2', target=consumer, args=(condition,)) p = threading.Thread(name='p', target=producer, args=(condition,)) c1.start() time.sleep(2) c2.start() time.sleep(2) p.start()
Потоки используют with для блокировки, связанной с Condition . Использование методов acquire() и release() в явном виде также работает.
$ python threading_condition.py 2013-02-21 06:37:49,549 (c1) Starting consumer thread 2013-02-21 06:37:51,550 (c2) Starting consumer thread 2013-02-21 06:37:53,551 (p ) Starting producer thread 2013-02-21 06:37:53,552 (p ) Making resource available 2013-02-21 06:37:53,552 (c2) Resource is available to consumer 2013-02-21 06:37:53,553 (c1) Resource is available to consumer
Ограничение одновременного доступа к ресурсам
Как разрешить доступ к ресурсу нескольким worker одновременно, но при этом ограничить их количество. Например, пул соединений может поддерживать фиксированное число одновременных подключений, или сетевое приложение может поддерживать фиксированное количество одновременных загрузок. Semaphore является одним из способов управления соединениями.
import logging import random import threading import time logging.basicConfig(level=logging.DEBUG, format='%(asctime)s (%(threadName)-2s) %(message)s', ) class ActivePool(object): def __init__(self): super(ActivePool, self).__init__() self.active = [] self.lock = threading.Lock() def makeActive(self, name): with self.lock: self.active.append(name) logging.debug('Running: %s', self.active) def makeInactive(self, name): with self.lock: self.active.remove(name) logging.debug('Running: %s', self.active) def worker(s, pool): logging.debug('Waiting to join the pool') with s: name = threading.currentThread().getName() pool.makeActive(name) time.sleep(0.1) pool.makeInactive(name) pool = ActivePool() s = threading.Semaphore(2) for i in range(4): t = threading.Thread(target=worker, name=str(i), args=(s, pool)) t.start()
В этом примере класс ActivePool является удобным способом отслеживания того, какие потоки могут запускаться в данный момент. Реальный пул ресурсов будет выделять соединение для нового потока и восстанавливать значение, когда поток завершен. В данном случае он используется для хранения имен активных потоков, чтобы показать, что только пять из них работают одновременно.
$ python threading_semaphore.py 2013-02-21 06:37:53,629 (0 ) Waiting to join the pool 2013-02-21 06:37:53,629 (1 ) Waiting to join the pool 2013-02-21 06:37:53,629 (0 ) Running: ['0'] 2013-02-21 06:37:53,629 (2 ) Waiting to join the pool 2013-02-21 06:37:53,630 (3 ) Waiting to join the pool 2013-02-21 06:37:53,630 (1 ) Running: ['0', '1'] 2013-02-21 06:37:53,730 (0 ) Running: ['1'] 2013-02-21 06:37:53,731 (2 ) Running: ['1', '2'] 2013-02-21 06:37:53,731 (1 ) Running: ['2'] 2013-02-21 06:37:53,732 (3 ) Running: ['2', '3'] 2013-02-21 06:37:53,831 (2 ) Running: ['3'] 2013-02-21 06:37:53,833 (3 ) Running: []
Специфичные для потока данные
Некоторые ресурсы должны быть заблокированы, чтобы их могли использовать сразу несколько потоков. А другие должны быть защищены от просмотра в потоках, которые не «владеют» ими. Функция local() создает объект, способный скрывать значения для отдельных потоков.
import random import threading import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def show_value(data): try: val = data.value except AttributeError: logging.debug('No value yet') else: logging.debug('value=%s', val) def worker(data): show_value(data) data.value = random.randint(1, 100) show_value(data) local_data = threading.local() show_value(local_data) local_data.value = 1000 show_value(local_data) for i in range(2): t = threading.Thread(target=worker, args=(local_data,)) t.start()
Обратите внимание, что значение local_data.value не доступно ни для одного потока, пока не будет установлено.
$ python threading_local.py (MainThread) No value yet (MainThread) value=1000 (Thread-1 ) No value yet (Thread-1 ) value=34 (Thread-2 ) No value yet (Thread-2 ) value=7
Чтобы все потоки начинались с одного и того же значения, используйте подкласс и установите атрибуты с помощью метода __init __() .
import random import threading import logging logging.basicConfig(level=logging.DEBUG, format='(%(threadName)-10s) %(message)s', ) def show_value(data): try: val = data.value except AttributeError: logging.debug('No value yet') else: logging.debug('value=%s', val) def worker(data): show_value(data) data.value = random.randint(1, 100) show_value(data) class MyLocal(threading.local): def __init__(self, value): logging.debug('Initializing %r', self) self.value = value local_data = MyLocal(1000) show_value(local_data) for i in range(2): t = threading.Thread(target=worker, args=(local_data,)) t.start()
__init __() вызывается для каждого объекта (обратите внимание на значение id() ) один раз в каждом потоке.
$ python threading_local_defaults.py (MainThread) Initializing (MainThread) value=1000 (Thread-1 ) Initializing (Thread-1 ) value=1000 (Thread-2 ) Initializing (Thread-1 ) value=81 (Thread-2 ) value=1000 (Thread-2 ) value=54
Знакомство с Apache Airflow: установка и запуск первого DAGа

Привет! Меня зовут Алексей Карпов, я прикладной администратор (MLOps) отдела сопровождения моделей машинного обучения в Альфа-Банке. Хочу поделиться опытом в работе с Apache Airflow. Расскажу, как установить интерпретатор Python и сам Airflow, а также как отладить его работу. Всё это — на примере запуска простейшего DAGа.
Моя статья будет полезна дата-инженерам и разработчикам, которым необходимо автоматизировать запуск скриптов и установить возможность автоматического выполнения по расписанию.
вы познакомитесь с основными понятиями Airflow;
научитесь собирать интерпретатор Python из исходного кода;
установите базу данных PostgreSQL;
создадите сервисы для Airflow;
запустите первый DAG.
Что такое Apache Airflow
Apache Airflow — это решение с открытым исходным кодом. Это оркестратор, который позволяет наладить разработку, планирование и мониторинг сложных рабочих процессов. Также он работает как планировщик ETL/ELT-процессов и использует язык программирования Python.
В основе концепции Airflow лежит DAG — направленный ациклический граф. Он описывает процессы обработки данных и позволяет объединять задачи, определяя правила их совместной работы.
Вот базовый пример DAG:
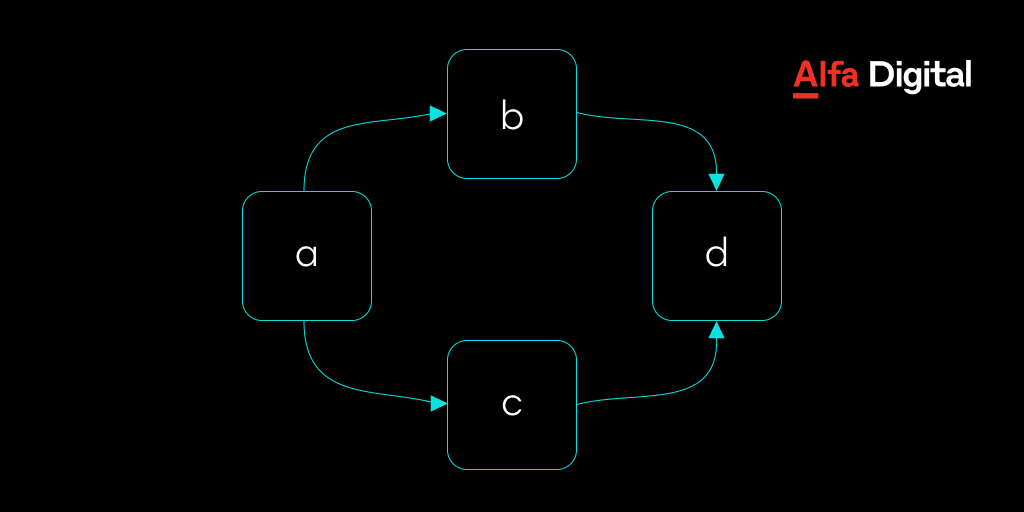
Он описывает четыре задачи — A, B, C и D и определяет порядок, в котором они должны выполняться, а также настраивает взаимосвязи между задачами. Можно указать, как часто требуется запускать DAG: например, «каждые 5 минут, начиная с завтрашнего дня» или «каждый день с 1 января 2023 года». Почитать об этом подробнее можно в документации.
Airflow состоит из нескольких компонентов, но главные из них — scheduler и webserver. Без них ничего не запустится.
Scheduler (планировщик) отслеживает все задачи и DAGs, а затем запускает экземпляры задач после установки их зависимостей. В фоновом режиме планировщик запускает подпроцесс, который отслеживает и синхронизирует все DAGs в указанном каталоге. По умолчанию он раз в минуту собирает результаты синтаксического анализа DAGs и проверяет, необходимо ли запустить какие-либо активные задачи. Почитать об этом подробнее можно в документации.
WebServer (веб-сервер) отвечает за отображение веб-интерфейса и аутентификацию пользователей, а также решает, к какой группе должен относиться тот или иной пользователь в соответствии с конфигурационным файлом. И снова ссылка на документацию.
Установка и запуск
Рассмотрим процесс установки и отладки этого чудесного инструмента, существенно облегчающего жизнь разработчика.
Допустим, вам необходимо выполнять определённые шаги с каким-то интервалом. Для автоматизации этой рутинной работы прекрасно подходит Airflow (но на самом деле его функциональность намного шире). Работа проводится на CentOS Stream 8 с правами суперпользователя. Также есть настроенный внешний firewall, поэтому использовать тот, который предлагает операционная система, нет смысла. Его можно отключить вместе с SELinux:
sudo su systemctl disable firewalld && systemctl stop firewalld setenforce 0 && sed -i 's/^SELINUX=.*/SELINUX=disabled/g' /etc/selinux/config
Для дальнейшей работы понадобится установленный интерпретатор python последней версии. В репозиториях его нет, но исходный код наиболее свежей версии доступен на официальном сайте языка. На момент написания статьи наиболее свежая стабильная версия — 3.10.10.
Перед началом нужно установить пакеты, необходимые для сборки python из исходного кода:
dnf -y install gcc \ make \ openssl-devel \ bzip2-devel \ libffi-devel \ wget \ sqlite-devel \ zlib-devel \ ncurses-devel \ gdbm-devel \ readline-devel\ tar
Скачиваем исходный код python и распаковываем архив:
PYTHON_VERSION="3.10.10" wget https://www.python.org/ftp/python/$PYTHON_VERSION/Python-$PYTHON_VERSION.tgz tar xf Python-$PYTHON_VERSION.tgz
Переходим в директорию с исходным кодом и проводим конфигурирование файлов:
cd Python-$PYTHON_VERSION ./configure --enable-optimizations
make -j $(nproc)
make altinstall
Правилом хорошего тона будет оставить исходный код собранный из исходных файлов утилит: в случае, если будет необходимо удалить утилиты, понадобится директория, откуда всё собиралось.
Запретим изменение и удаление файлов. Для этого выполним команду:
chattr +i ../Python-$PYTHON_VERSION
Проверяем версию python:
python3.10 --version
Теперь у вас на сервере установлен интерпретатор Python актуальной на данный момент версии.
Установка базы данных PostgreSQL-15
По умолчанию Airflow работает с базой данных SQLite. Её функциональности вполне достаточно для пробного запуска и демонстрации процесса работы, но не хватит для использования в Production-среде, поскольку с этой базой данных невозможно распараллеливание задач. Один из способов решения данной проблемы — использование базы данных PostgreSQL.
В стандартных репозиториях уже содержится встроенный модуль PostgreSQL, но более старой версии. Отключим его для избежания конфликтов версий:
dnf -qy module disable postgresql
Установим последнюю версию репозитория PostgreSQL:
dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-8-x86_64/pgdg-redhat-repo-latest.noarch.rpm
Установим сами пакеты PostgreSQL:
dnf install -y postgresql15-server postgresql15-contrib
После установки пакетов для экономии места на сервере необходимо очистить кэш пакетов DNF:
dnf clean all
Инициализируем базу данных PostgreSQL и добавим её в автозагрузку:
/usr/pgsql-15/bin/postgresql-15-setup initdb systemctl enable --now postgresql-15
Создадим базу данных Airflow и пользователя к ней. Предоставим пользователю права на БД:
sudo -iu postgres psql -c "CREATE DATABASE airflow;" sudo -iu postgres psql -c "CREATE USER airflow WITH PASSWORD 'alfa-digital';" sudo -iu postgres psql -c "GRANT ALL PRIVILEGES ON DATABASE airflow TO airflow;"
Для обеспечения безопасности создадим непривилегированного системного пользователя airflow, под которым будут работать непосредственно сами сервисы:
useradd airflow
Получим права пользователя airflow:
su - airflow
В Python есть правило: для каждого приложения используется своё виртуальное окружение. Это позволит избежать проблем с зависимостями в дальнейшей работе.
Создадим виртуальное окружение и активируем его:
python3.10 -m venv .venv source .venv/bin/activate
Установим необходимые библиотеки. Для экономии места на сервере используем ключ --no-cache-dir :
pip3.10 install --no-cache-dir apache-airflow psycopg2-binary virtualenv kubernetes
Чтобы не прописывать переменные каждый раз, добавим их в файл .bashrc . Это позволит не прописывать переменные при каждом входе в систему.
cat >> /home/airflow/.bashrc
Проведём миграции базы данных Airflow. Также будут созданы все необходимые конфигурационные файлы для работы:
airflow db init
Создадим пользователя для работы с UI Apache Airflow:
airflow users create --username admin \ --firstname Aleksey\ --lastname Karpov \ --role Admin \ --email akarpov5@alfabank.ru \ --password alfa-digital
Поправим конфигурационный файл airflow.cfg :
sed -i '/executor/s/SequentialExecutor/LocalExecutor/' /home/airflow/airflow.cfg
Список пользователей Apache Airflow можно посмотреть командой:
airflow users list
Выйдем из пользователя Airflow:
exit
Теперь создадим хук, который позволяет сохранять права на pid-файл Airflow, а также сервисы для scheduler и webserver. Воспользуемся официальным репозиторием:
curl https://raw.githubusercontent.com/apache/airflow/main/scripts/systemd/airflow.conf -o /etc/tmpfiles.d/airflow.conf curl https://raw.githubusercontent.com/apache/airflow/main/scripts/systemd/airflow-webserver.service -o /etc/systemd/system/airflow-webserver.service curl https://raw.githubusercontent.com/apache/airflow/main/scripts/systemd/airflow-scheduler.service -o /etc/systemd/system/airflow-scheduler.service
Учитывая то, что Airflow работает в виртуальном окружении, поправим файлы сервисов:
sed -i 's/\/bin/\/home\/airflow\/.venv\/bin/g' /etc/systemd/system/airflow-scheduler.service /etc/systemd/system/airflow-webserver.service
Создадим файл для переменных среды, чтобы они автоматически подключались во время работы сервисов:
cat > /etc/sysconfig/airflow
Дадим права на данный файл пользователю airflow, иначе сервисы не смогут его прочитать:
chown airflow:airflow /etc/sysconfig/airflow
Перезагрузим демон systemctl , чтобы изменения подтянулись системой:
systemctl daemon-reload
Запустим сервисы Apache Airflow и добавим их в автозагрузку:
systemctl enable --now airflow-scheduler systemctl enable --now airflow-webserver
Теперь у вас на сервере есть полноценный Airflow, который будет автоматически включаться при старте системы.
Дебаг
Что-то не работает? Занимаемся дебагом!
Посмотрим состояние WebServer:
systemctl status airflow-webserver -l
airflow-webserver.service - Airflow webserver daemon Loaded: loaded (/etc/systemd/system/airflow-webserver.service; enabled; vendor preset: disabled) Active: active (running) since Sat 2022-07-09 17:01:02 MSK; 2h 38min ago Main PID: 6542 (airflow) Tasks: 6 (limit: 23630) Memory: 592.1M CGroup: /system.slice/airflow-webserver.service ├─ 6542 /home/airflow/.venv/bin/python3.10 /home/airflow/.venv/bin/airflow webserver --pid /run/airflow/webserver.pid ├─ 6594 gunicorn: master [airflow-webserver] ├─ 6603 [ready] gunicorn: worker [airflow-webserver] ├─ 6604 [ready] gunicorn: worker [airflow-webserver] ├─ 6605 [ready] gunicorn: worker [airflow-webserver] └─47985 [ready] gunicorn: worker [airflow-webserver]
Посмотрим состояние Scheduler:
systemctl status airflow-scheduler -l
airflow-scheduler.service - Airflow scheduler daemon Loaded: loaded (/etc/systemd/system/airflow-scheduler.service; enabled; vendor preset: disabled) Active: active (running) since Sat 2022-07-09 17:00:56 MSK; 2h 39min ago Main PID: 6286 (/home/airflow/.) Tasks: 72 (limit: 23630) Memory: 1.7G CGroup: /system.slice/airflow-scheduler.service ├─6286 /home/airflow/.venv/bin/python3.10 /home/airflow/.venv/bin/airflow scheduler ├─6288 gunicorn: master [gunicorn] ├─6289 gunicorn: worker [gunicorn] ├─6290 airflow executor -- LocalExecutor ├─6293 gunicorn: worker [gunicorn] ├─6299 airflow worker -- LocalExecutor ├─6301 airflow worker -- LocalExecutor ├─6303 airflow worker -- LocalExecutor ├─6305 airflow worker -- LocalExecutor ├─6308 airflow worker -- LocalExecutor ├─6310 airflow worker -- LocalExecutor ├─6313 airflow worker -- LocalExecutor ├─6314 airflow worker -- LocalExecutor ├─6318 airflow worker -- LocalExecutor ├─6319 airflow worker -- LocalExecutor ├─6322 airflow worker -- LocalExecutor ├─6325 airflow worker -- LocalExecutor ├─6326 airflow worker -- LocalExecutor ├─6329 airflow worker -- LocalExecutor ├─6331 airflow worker -- LocalExecutor ├─6334 airflow worker -- LocalExecutor ├─6338 airflow worker -- LocalExecutor ├─6339 airflow worker -- LocalExecutor ├─6342 airflow worker -- LocalExecutor ├─6343 airflow worker -- LocalExecutor ├─6346 airflow worker -- LocalExecutor ├─6347 airflow worker -- LocalExecutor ├─6349 airflow worker -- LocalExecutor ├─6350 airflow worker -- LocalExecutor ├─6353 airflow worker -- LocalExecutor ├─6354 airflow worker -- LocalExecutor ├─6355 airflow worker -- LocalExecutor ├─6359 airflow worker -- LocalExecutor ├─6361 airflow worker -- LocalExecutor ├─6366 airflow worker -- LocalExecutor ├─6372 airflow worker -- LocalExecutor ├─6373 airflow worker -- LocalExecutor └─6375 airflow scheduler -- DagFileProcessorManager
Посмотрим последние логи:
journalctl -eu airflow-webserver journalctl -eu airflow-scheduler
Запуск DAG
Веб-сервер можно открыть напрямую в браузере. Он будет доступен по порту 8080, например:
http://192.168.232.32:8080
Введём данные пользователя, который был создан выше, и нажмём кнопку Sign In.
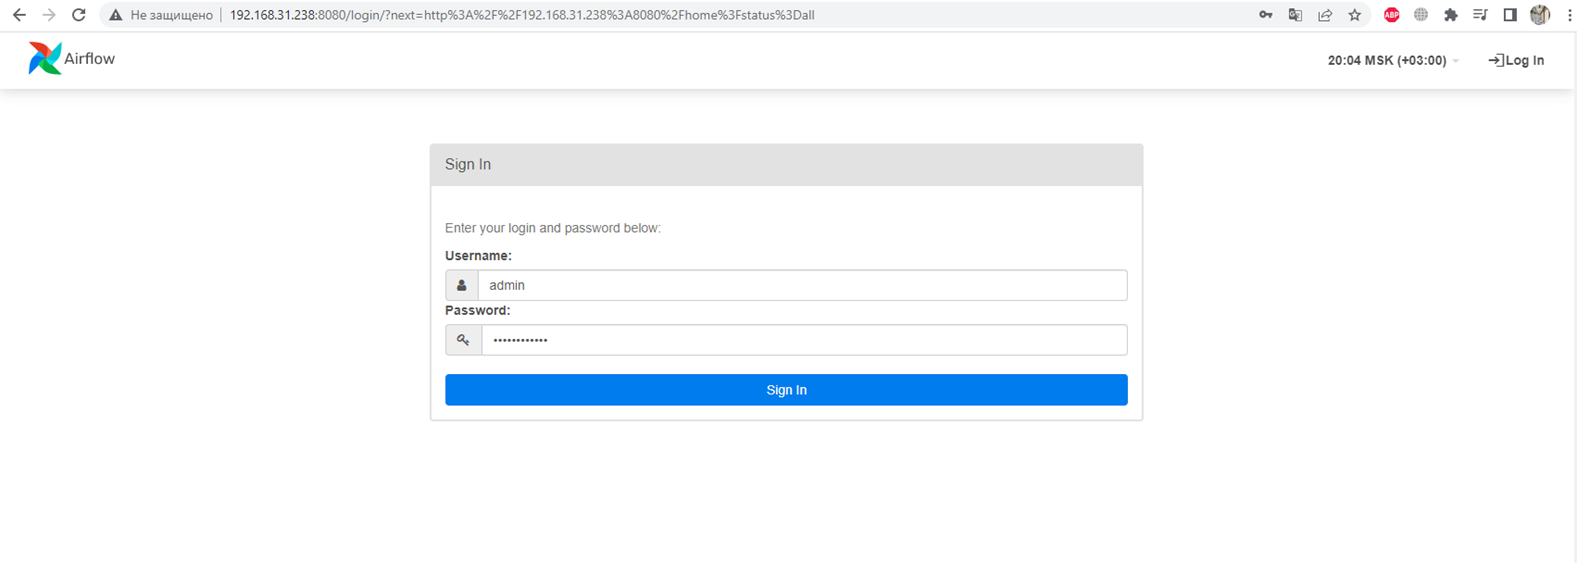
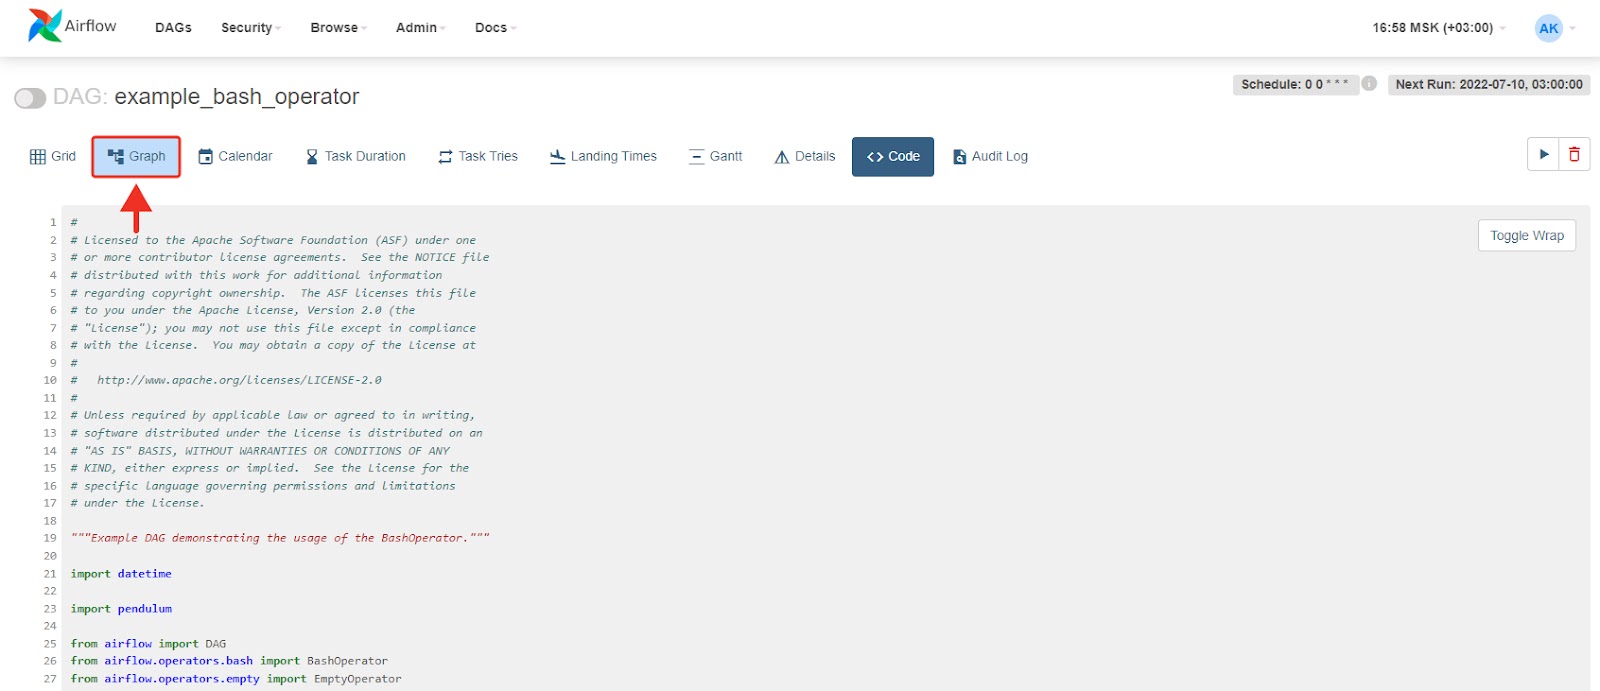
После входа вам будет представлен набор DAGs, предназначенных для демонстрации функциональности Airflow. Зайдём в DAG example_bash_operator :
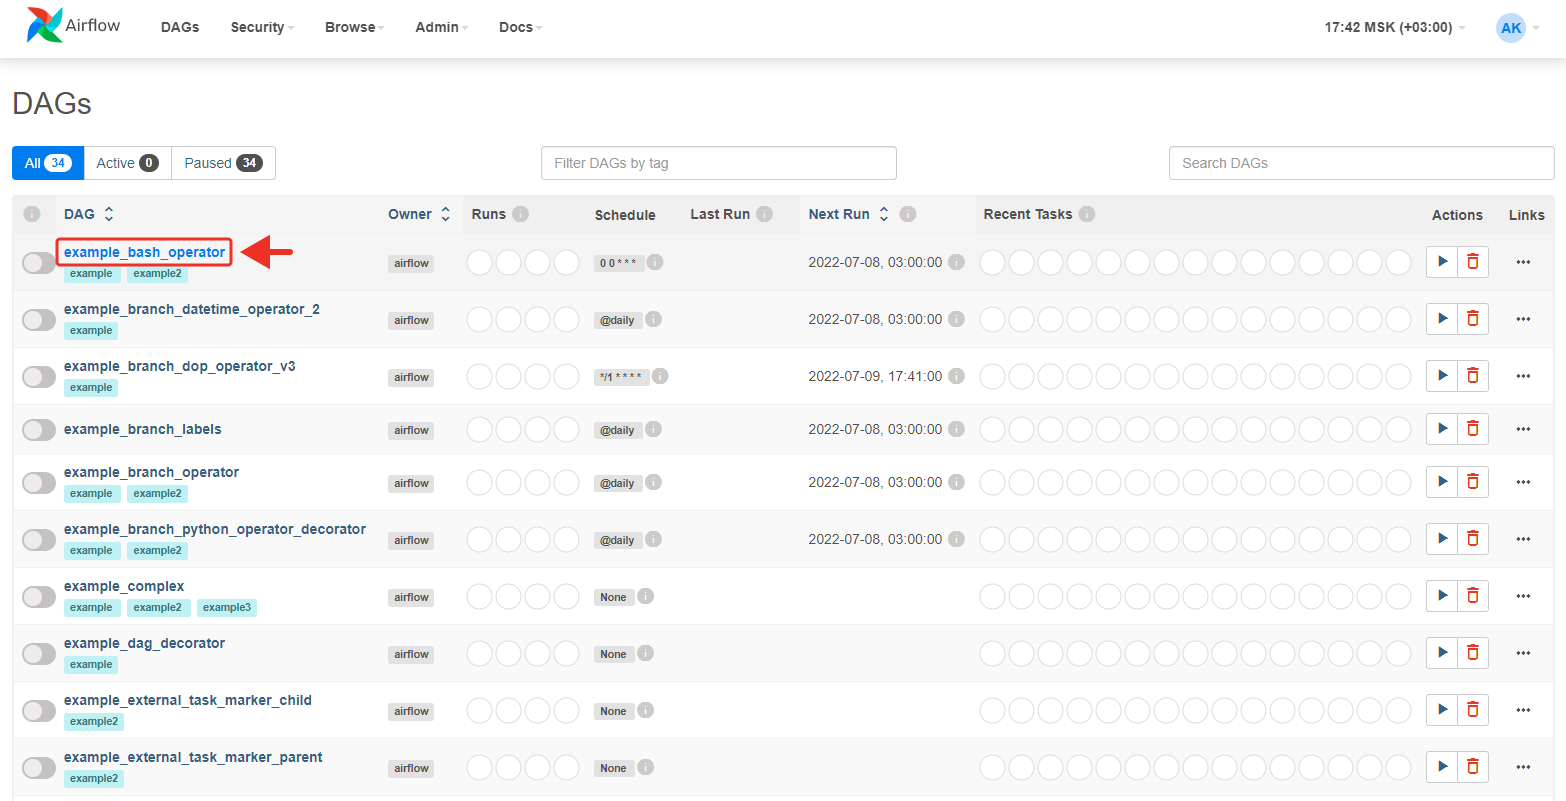

На рисунке представлен непосредственно код самого DAG. Теперь запустим его:
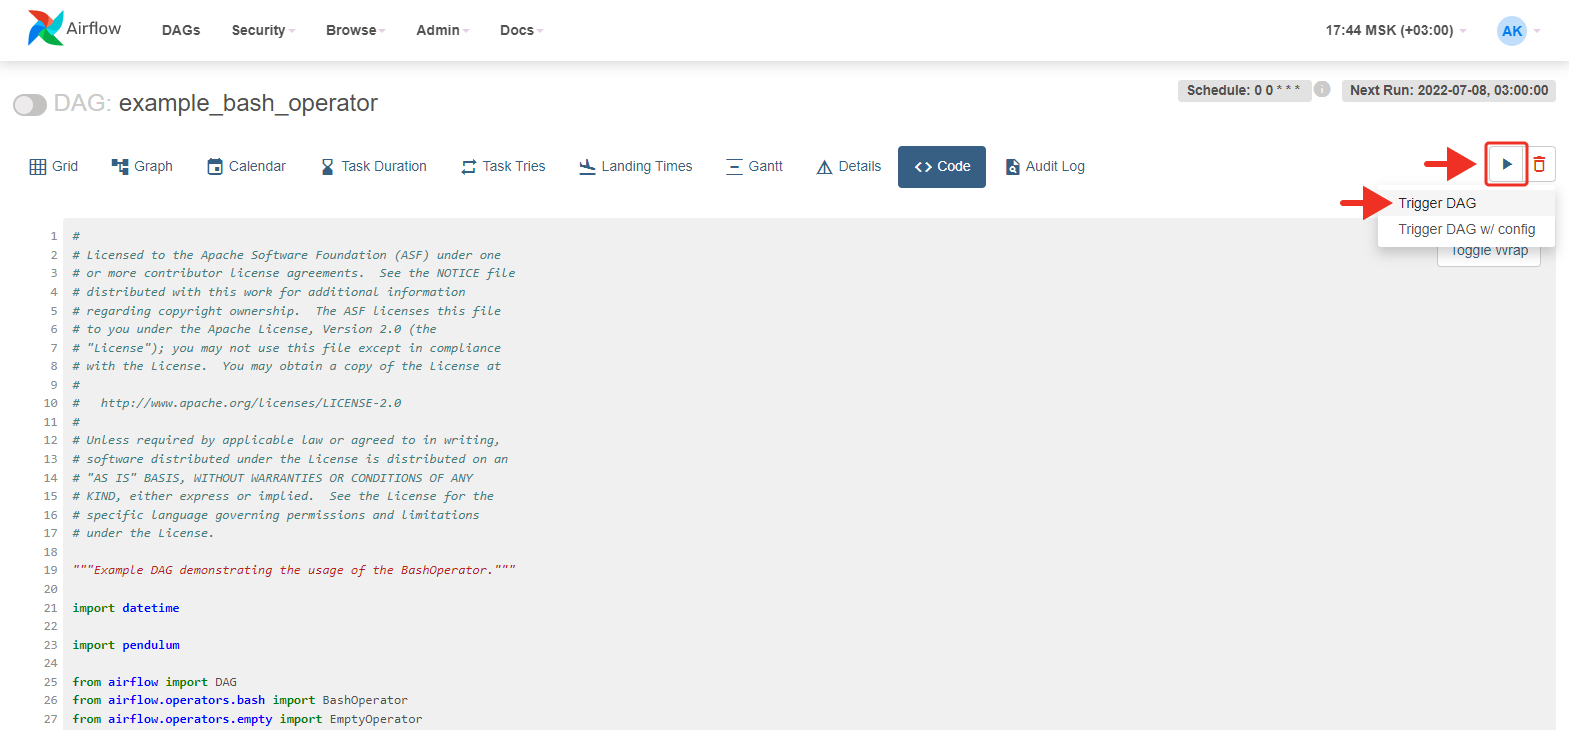
Посмотрим на граф DAGа. Жмём на Graph:
Посмотрим, как отработал DAG. Для этого нажмём Grid:

Увидим, что DAG выполнился успешно. Зелёным цветом обозначено то, что должно было быть исполнено, а розовым — то, что не должно:

10Итак, вы узнали, что такое Apache Airflow: познакомились с его основными понятиями, научились собирать интерпретатор Python из исходного кода, установили базу данных PostgreSQL, создали сервисы для Airflow, а также запустили первый DAG.
В следующей статье я расскажу о видах Airflow Operators, чем они отличаются, для чего они нужны и как ими пользоваться.
- Блог компании Альфа-Банк
- Python
- Программирование
- Data Engineering