
SQL-Ex blog
Что такое фрагментация индекса и коэффциент заполнения индекса в SQL Server?
Добавил Sergey Moiseenko on Среда, 1 марта. 2023
Что такое фрагментация индекса и как она происходит?
Важно знать, что данные SQL Server хранятся на страницах данных, каждая из которых имеет размер 8Кб. Имеется два типа фрагментации, оба являются результатом того, что эти страницы используются не так эффективно, как могло бы быть.
Когда вы вставляете или обновляете данные на странице, которая уже заполнена, SQL Server создает новую страницу. Информация из исходной страницы будет разбиваться 50/50, при этом половина данных вместе с новой записью будет добавляться на новую страницу. Таким образом в конце страницы (страниц) появляется пустое пространство. Это пустое пространство, которое называется внутренней фрагментацией, также возникает при удалении данных со страницы. На диаграмме показано, как это происходит:

Эта вновь созданная страница не будет находиться в последовательности исходных страниц, т.е. связанные данные теперь хранятся в разных областях диска. Таким образом разделенные данные называются внешней фрагментацией.
Почему фрагментация это плохо?
Фрагментированные индексы могут вызвать проблемы с производительностью. Скажем, у вас есть 1Мб данных, они теоретически занимают 128 страниц данных (1024Кб / 8Кб = 128 страниц), однако из-за внутренней фрагментации эти 1Мб данных могут находиться на множестве частично заполненных страниц. Когда SQL Server выполняет запрос к таблице, который включает сканирование индекса, это сканирование должно исполняться на каждой странице. Сканирование 128 полных страниц было бы значительно быстрей, чем сканирование 200+ фрагментированных страниц. Теперь еще вспомним, что разыскиваемые данные могут находиться в различных местах диска из-за внешней фрагментации. Дополнительное сканирование в сочетании с ростом операций ввода/вывода могут вызвать большие проблемы производительности.
Числа в примере ниже помогают представить себе математику процесса, но вообразите таблицу с миллиардами строк, и вы начинаете понимать масштаб потенциальных проблем производительности.
Как устранить фрагментацию?
Имеется табличнозначная функция с именем sys.dm_db_index_physical_stats, которая позволит вам проанализировать степень фрагментации индексов. После ее использования для идентификации проблематичных индексов вы сможете решить, что применить к ним — реорганизацию (reorganise) или перестройку (rebuild).
reorganise — название не вполне отражает действие, оно переупорядочивает страницы. Это помогает решить проблему внешней фрагментации, но содержимое страниц при этом не меняется.
rebuild удаляет индекс и заново строит его с нуля. Это более долгий и более трудоемкий процесс, но он решает проблемы как с внутренней, так и с внешней фрагментацией.
Что такое коэффициент заполнения (Fill-Factor)?

Для борьбы с фрагментацией многие администраторы баз данных применяют пользовательский коэффициент заполнения. Коэффициент заполнения — это значение, которое определяет процент заполнения страницы и сколько пространства будет намеренно оставлено свободным. Например, установка значения 80 оставит 20% страницы пустым, но разве мы сознательно не вводим внутреннюю фрагментацию? Ну, да, но теперь, когда вы вставляете данные, на странице есть место для них, что позволяет избежать расщепления с появлением новой страницы где-нибудь на диске. Другими словами, вы приносите в жертву более высокий уровень внутренней фрагментации, чтобы ограничить величину внешней фрагментации.
Тут нет одного значения при установке коэффициента заполнения на все случаи жизни, поэтому он должен устанавливаться на уровне индекса, а не на уровне сервера, в зависимости от того, как используется индекс. Статичная таблица, которая используется только для чтения, больше выиграет от значения, близкого к 0 (100% использование страницы), чем таблица, в которую регулярно вставляются и из которой удаляются данные. Вот где неоценимы навыки администратора баз данных.
Как узнать фрагментацию индекса sql
Развернул базу из бекапа, к кластеру еще не подключал.
Формирую стандартный отчет mssql «Физическое состояние индексов». Получаю, к примеру, по таблице «_Acc28» некластеризованный индекс «_Acc28_ByCode_SR», фрагментация 50%, рекомендация — перестроить.
Выбираю в дереве этот индекс — перестроить. Операция выполнена успешна. Формирую отчет, изменений нет! Те же 50% фрагментации. Такая же ситуация через план обслуживания.
Что не так-то? Как правильно перестраивать/дефрагментировать индексы? Или отчет кривой?
хм, сделал dbcc freeproccache, сейчас отчет формирую заново. Ну хз, может что изменится.
Такс, команда
ALTER INDEX _Acc28_ByCode_SR ON [имябазы].[dbo].[_Acc28] REBUILT ничего не дала. ФРагментация осталась, хотя при перестроении должна быть равна 0.
ALTER INDEX _Acc28_ByCode_SR ON [имябазы].[dbo].[_Acc28] REORGANIZE — фрагментацию убрала.
Что-то я не догоняю
UPDATE STATISTICS делал?
Если не ошибаюсь, делал. С вероятностью в 80%)
Судя по всему тут вырисовывается вопрос, а rebuilt вообще отрабатывает?
на всякий случай, вдруг еще не читал
В общем, либо я не умею смотреть, либо руки не из плеч, но план обслуживания как с реорганизацией, так и перестроением судя по отчету «Физическое состояние индексов» ничего толком не делают. Фрагментация остается.
Отрабатывает ПКМ на индексе, далее реорганизовать или перестроить. Посмотрел, что там за скрипт.
«USE [имя базы]
GO
ALTER INDEX [имя индекса] ON [dbo].[имя таблицы] REORGANIZE WITH ( LOB_COMPACTION = ON )
GO»
Нашел такой скрипт, к умному(с анализом процента фрагментации) он не относится, но хоть что-то. Выполняется схожий скрипт, который по ПКМ, но для всех индексов всех таблиц БД.
Declare @TBname nvarchar(255),
@SQL nvarchar(max)
select @TBname = min(TABLE_NAME) from INFORMATION_SCHEMA.TABLES WHERE TABLE_TYPE=’BASE TABLE’
while @TBname is not null
BEGIN
set @SQL=’ALTER INDEX ALL ON [‘ + @TBname + ‘] REORGANIZE;’
—print @SQL
EXEC SP_EXECUTESQL @SQL
select @TBname = min(TABLE_NAME) from INFORMATION_SCHEMA.TABLES WHERE TABLE_TYPE=’BASE TABLE’ and TABLE_NAME > @TBname
END»
Фрагментация исчезла.
Теперь надо над перестроением думать. Как там 1С рекомендует? Более 30% фрагментации — перестроить, что ли.
SQL: Получить список всех индексов БД и процент фрагментации
Во время анализа состояния базы данных, и возможного анализа ее производительности, стоит обратить внимание на состояние ее индексов и их количества.
Получить список индексов базы данных MS SQL
Для получения полного списка индексов базы данных, можно использовать System View sys.indexes, которое — покажет список всех индексов в выбранной базе данных. Результат запроса вида: select * from sys.indexes выглядит не очень читаемо, но если добавить информацию из других предствлений (View), то можно получить список с наглядной информацией. Например, запрос:
USE select i.[name] as index_name, substring(column_names, 1, len(column_names)-1) as [columns], case when i.[type] = 1 then 'Clustered index' when i.[type] = 2 then 'Nonclustered unique index' when i.[type] = 3 then 'XML index' when i.[type] = 4 then 'Spatial index' when i.[type] = 5 then 'Clustered columnstore index' when i.[type] = 6 then 'Nonclustered columnstore index' when i.[type] = 7 then 'Nonclustered hash index' end as index_type, case when i.is_unique = 1 then 'Unique' else 'Not unique' end as [unique], schema_name(t.schema_id) + '.' + t.[name] as table_view, case when t.[type] = 'U' then 'Table' when t.[type] = 'V' then 'View' end as [object_type] from sys.objects t inner join sys.indexes i on t.object_id = i.object_id cross apply (select col.[name] + ', ' from sys.index_columns ic inner join sys.columns col on ic.object_id = col.object_id and ic.column_id = col.column_id where ic.object_id = t.object_id and ic.index_id = i.index_id order by key_ordinal for xml path ('') ) D (column_names) where t.is_ms_shipped <> 1 and index_id > 0 order by i.[name]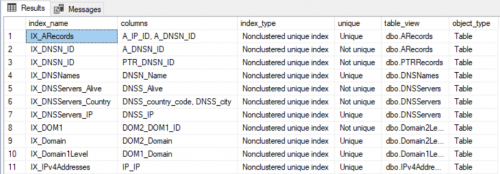
Вернет результат подобный тому что показан ниже:
а при необходимости этот запрос успешно редактируется, добавлением необходимых полей.
Получить состояние фрагментации индексов базы данных MS SQL
При работе с данными (при вставке, обновлении или удалении), также происходит изменение информации хранящейся в индексах. С точки зрения SQL, фрагментация выглядит как несоответствие логического порядка индекса, физическому порядку размещения данных, и чем больший процент фрагментации в индексе, тем существеннее это отражается на производительности. В целом, это нормальный рабочий момент, за которым надо следить, настраивая планы обслуживания. Но иногда бывает полезно в целом узнать «среднюю темпиратуру по больнице», чтобы создать новые или отредактировать старые планы обслуживания.
Если выполнялось сжатие (shrink) базы данных или отдельных файлов БД, то после этого, с высокой долей вероятности, потребуется выполнение операции перестроения индексов. Иначе, можно получить существенную деградацию производительности базы данных.
Ниже, приведен пример скрипта, которые отображает список всех индексов БД в порядке по убыванию уровня фрагментации:
declare @DB sysname = ; select s.name schema_name, t.name TableName, i.name IndexName, d.avg_fragmentation_in_percent Fragmentation from sys.dm_db_index_physical_stats( DB_ID(@DB), null, null, null, null) d inner join sys.tables t on d.object_id = t.object_id inner join sys.schemas s on t.schema_id = s.schema_id inner join sys.indexes i on d.object_id = i.object_id AND d.index_id = i.index_id where d.index_id > 0 and d.page_count > 8 order by fragmentation desc
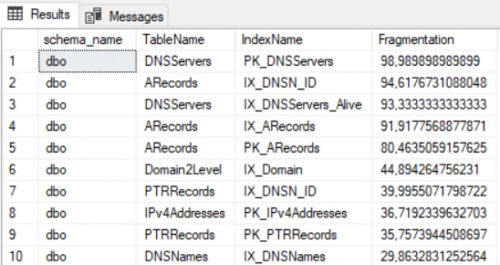
Результат:
Перестроить (Rebuild) все индексы в базе данных
Для перестроения всех индексов базы данных, можно использовать чуть более сложный скрипт, ниже
begin declare @databaseName sysname = N'IPScan'; declare @rebuildFloor float = 40; declare @schemaName sysname; declare @tableName sysname; declare @indexName sysname; declare @fragmentation float; declare @command nvarchar(500); print N'Начало перестроения индекса: ' + convert( nvarchar(100), SYSDATETIME(), 20 ); print N'-------------------------------------------------------------------------'; declare indexCursor cursor fast_forward local for select s.name schema_name, t.name table_name, i.name index_name, d.avg_fragmentation_in_percent fragmentation from sys.dm_db_index_physical_stats( DB_ID(@databaseName), null, null, null, null) d inner join sys.tables t on d.object_id = t.object_id inner join sys.schemas s on t.schema_id = s.schema_id inner join sys.indexes i on d.object_id = i.object_id AND d.index_id = i.index_id where d.index_id > 0 and d.avg_fragmentation_in_percent > 10 and d.page_count > 8 open indexCursor; while( 1=1 ) begin fetch next from indexCursor into @schemaName, @tableName, @indexName, @fragmentation; if @@FETCH_STATUS <> 0 break; begin try set @command = N'ALTER INDEX ' + @indexName + N' ON ' + @databaseName + N'.' + @schemaName + N'.' + @tableName; if @fragmentation < @rebuildFloor begin set @command = @command + N' REORGANIZE;'; set @command = @command + N' UPDATE STATISTICS ' + @databaseName + N'.' + @schemaName + N'.' + @tableName + N' ' + @indexName + N';'; end else begin set @command = @command + N' REBUILD WITH (ONLINE = ON); '; end; --print @command; exec (@command); print N'INDEX ' + @indexName + N'ON ' + @databaseName + N'.' + @schemaName + N'.' + @tableName + N' Обработан'; end try begin catch print N'ERROR REBUILD INDEX ' + @indexName; print N'ERROR MESSAGE: ' + ERROR_MESSAGE(); end catch end; print N'-------------------------------------------------------------------------'; print N'Перестроение индексов завершено: ' + convert( nvarchar(100), SYSDATETIME(), 20 ); close indexCursor; deallocate indexCursor; end; 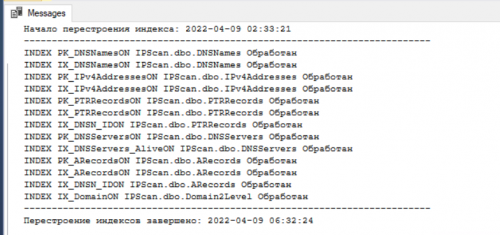
Результат выполнения скрипта:
Скрипт можно скопивать из текста выше или скачать файлом по ссылке:
Дефрагментация и статистика индексов SQL Server

Продолжим знакомится с производительностью базы данных MS SQL Server и как ее улучшить и сегодня я решил рассказать про две примерно смежные темы - фрагментация индексов и статистика. Обе темы объединяют как раз индексы и они влияют на их производительность, поэтому я решил рассмотреть их одновременно.
Фрагментация индексов и некорректная статистика может повлиять на производительность базы данных и как SQL Server выполняет запросы. Сервер по умолчанию собирает статистику сам и нам не нужно заботиться о ней. При создании индексов можно указать – обновлять статистику автоматически или нет и по умолчанию как раз все обновляется.
Начнем со статистики, которая показывает, как много данных определенного типа и это может сильно повлиять на выполнение запроса. Например, есть запрос:
Select * From Member m Join Address a on m.MemberID = a.MemberID Where m.LastName = 'Иванов'
Статистика скорей всего покажет, что после фильтрации по фамилии в результате получиться всего несколько записей и проще будет для каждой из них найти адрес в таблице адресов – то есть выполнить loop join.
Select * From Address a Join City c on a.CityID = c.CityID Where a.CountryName = 'Лапландия'
Здесь уже поиск по первой таблице может вернуть множество строк и для каждой из них искать город во второй будет невыгодно. В зависимости от ситуации, сервер может выбрать hash или merge join.
Сколько строк может вернуться говорит нам статистика и чем лучше статистика, тем точнее результат.
Если честно, я никогда не отключал обновление статистики и не знаю, в каких случаях это может пригодиться, поэтому из личного опыта нечего рассказать. Но что я могу сказать, так это мне приходилось встречаться с случаями, когда статистика была неверна и это значительно влияло на производительность, в негативную сторону. Средние по размеру запросы с большим количеством логики и Join начинали сильно тормозить.
Чаще всего с потерей корректности статистики мне приходилось сталкиваться сразу после восстановления большой базы данных. Сразу после этого очень даже рекомендую обновить статистику на базу данных и это легко делается выполнением команды:
sp_updatestats
В зависимости от размера базы данных эта команда может выполняться достаточно долго, но это очень важно. Если необходимо работать над оптимизацией запроса и вы делаете это при не оптимальных индексах – это трата времени, потому что в реальности вы будете оптимизировать запросы под не оптимальную систему, а после обновления статистики может произойти как улучшение производительности, так и падение.
Чтобы обновить статистику только для определенной таблицы, можно выполнить следующий запрос:
UPDATE STATISTICS ИмяТаблицы
Этот запрос уже более безопасный и достаточно быстрый и я его без проблем выполнял на огромных таблицах на рабочем сервере, правда под минимальной нагрузке. При сильной нагрузке я бы не выполнял этот запрос, потому что он приводит к перекомпиляции запросов и это реально имеет смысл – ведь если статистика изменилась, то и план выполнения может измениться на более оптимальный. А если вы выполните обновление, но реально ничего не изменилось, перекомпиляция будет бессмысленной.
В принципе, выполнять обновление статистики можно, но не слишком часто. Работая над Sony сайтами, я никогда не выполнял полное обновление sp_updatestats, но регулярно выполнял UPDATE STATISTICS на отдельных таблицах.
У меня на канале есть видео, в котором я рассказываю, как я находил медленные запросы. На моем сайте есть и текстовая версия этого видео (Поиск медленных запросов). Если появлялись медленный запрос, который раньше выполнялся быстро, то первым делом я обновлял статистику всех таблиц, которые вовлечены в запрос и если не помогало, тогда уже переходил к исследованию, что произошло и как улучшить производительность.
Второй вопрос, который я хотел бы сегодня обсудить – это дефрагментация и перестроение индексов.
Когда вы только создали индекс, то его данные последовательны и все счастливы. Со временем и после большого количества вставки записей может случиться так, что данные будут разбросаны по базе данных и их нужно будет реорганизовать.
Чтобы определить фрагментацию индекса кликаем правой кнопкой по индексу и выбираем пункт Свойства. В появившемся окне выбираем слева Fragmentation и здесь можно увидеть наверху заполненность страниц и фрагментацию:
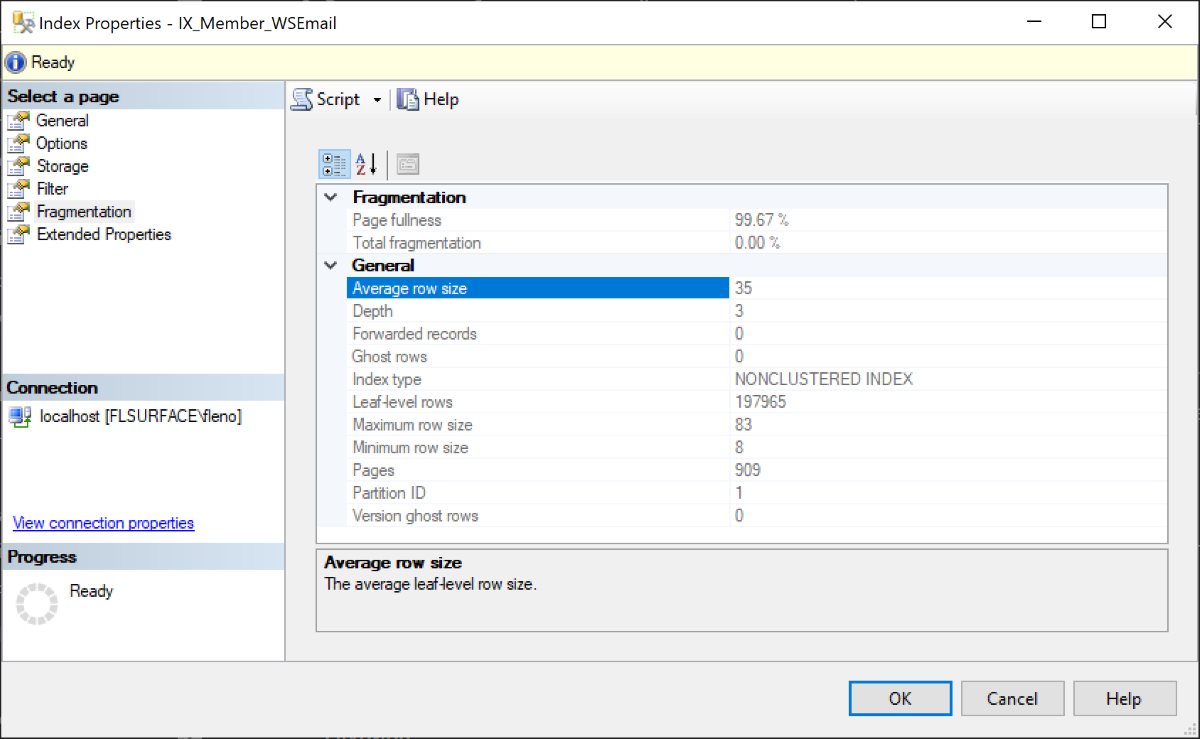
В моем случае заполненность почти 100 процентов, но фрагментации нет, потому что это такая база, куда не вставляется большого количества записей, это локальный тест.
Такая высокая заполненность получилась за счет того, что у меня Fill Factor установлен в 0. Фактор заполненности можно увидеть в разделе Options. Попробую его установить в 50 и если нажать OK, то индекс будет пересоздан и заполненность сократиться до 50.
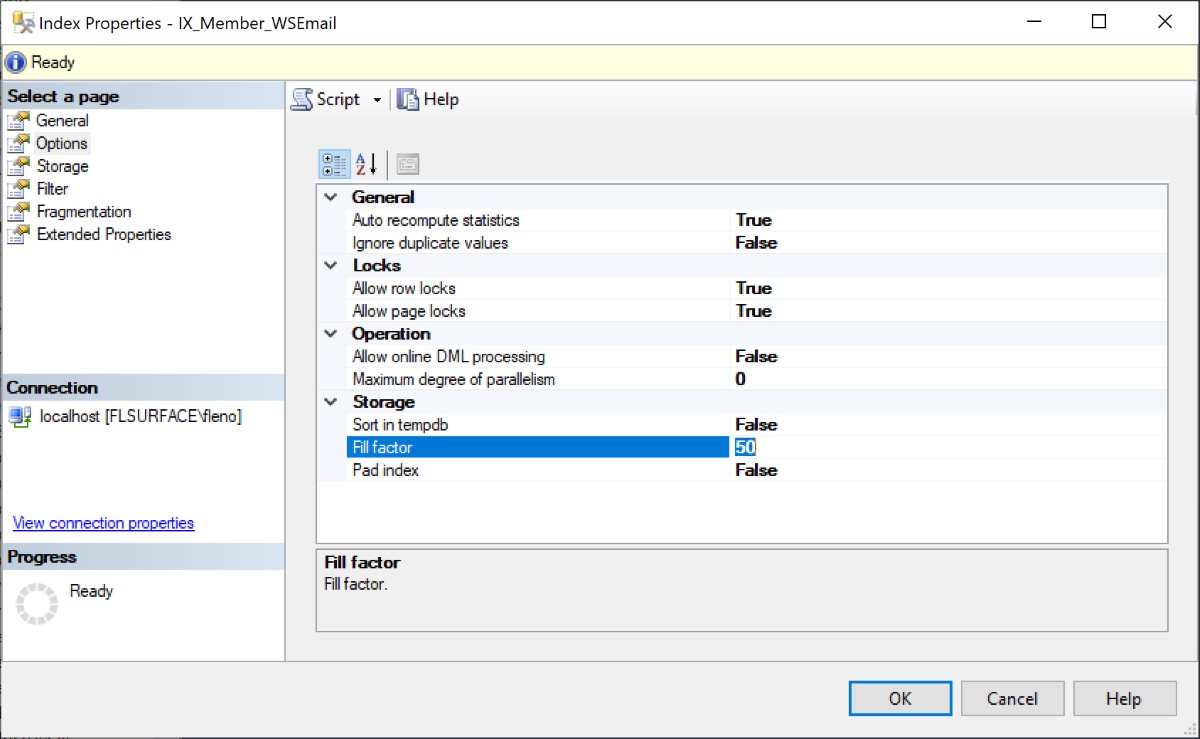
Теперь в каждой странице индекса данные заполнены только на 50% и там достаточно пространства для вставки новых данных, и эта операция будет происходить очень быстро. В чем прикол? Почему не сделать 50% по умолчанию? Дело в том, это нужно далеко не всегда. Если это первичный ключ с авто увеличивающейся колонкой, в который данные всегда добавляются в конец, нет смысла выделять пустое пространство в каждой странице. Если это данные, где новая строка может вставляться в любое место, можно оставить 80 или даже 60 процентов пустого пространства. Все зависит от того, как часто вставляются данные и как часто читаются.
Если страницы индекса заполнять только на 50%, понадобиться больше страниц и серверу во время поиска придется читать больше данных с диска, что сократит немного производительность. Заполненность индекса может сократить скорость вставки, но замедлить чтение.
Чтобы определить текущую фрагментацию на базе данных с именем DevDB можно выполнить следующий запрос:
SELECT a.index_id, name, avg_fragmentation_in_percent FROM sys.dm_db_index_physical_stats (DB_ID(N'DevDB'), NULL, NULL, NULL, NULL) AS a JOIN sys.indexes AS b ON a.object_id = b.object_id AND a.index_id = b.index_id;
Теперь зная убитые индексы можно в SQL Server Management кликнуть на каждом из них и выбрать Reorganize или выполнить следующий запрос:
ALTER INDEX Имя_Индекса ON Имя_Таблицы REORGANIZE;
Можно реорганизовать индекс и сразу же поменять заполненность:
ALTER INDEX Имя_Индекса ON Имя_Таблицы REBUILD WITH (FILLFACTOR = 80, SORT_IN_TEMPDB = ON, STATISTICS_NORECOMPUTE = ON);
Вместо имени индекса можно указать ALL, если вы хотите реорганизовать все индексы на таблице.
Для дефрагментации последнее время я использую скрипт https://github.com/MichelleUfford/sql-scripts/blob/master/indexes/dba_indexDefrag_sp.sql. Я создаю эту хранимую процедуру у себя в базе данных и потом ставлю следующий скрипт на выполнение каждый месяц в определенный день. Когда я отвечал за базу данных, то этот скрипт у меня бегал каждый понедельник в 3 часа ночи, когда самая минимальная нагрузка на базу данных:
EXECUTE dbo.dba_indexDefrag_sp @executeSQL = 1 , @printCommands = 1 , @debugMode = 1 , @printFragmentation = 1 , @forceRescan = 1 , @maxDopRestriction = 1 , @minPageCount = 8 , @maxPageCount = NULL , @minFragmentation = 5 , @rebuildThreshold = 30 , @defragDelay = '00:00:05' , @defragOrderColumn = 'page_count' , @defragSortOrder = 'DESC' , @excludeMaxPartition = 1 , @timeLimit = NULL , @database = 'mamberdatabase,pointsystem';
01 Июня 2019 | Базы данных
Поделитесь с друзьями
Внимание. Если ты копируешь эту статью себе на сайт, то оставляй ссылку непосредственно на эту страницу. Спасибо за понимание