
JSON
JSON (JavaScript Object Notation) это текстовый формат обмена данными, широко используемый в веб-приложениях. По сравнению с XML он является более лаконичным и занимает меньше места. Кроме этого все браузеры имеют встроенные средства для работы с JSON.
Необходимость работы с этим форматом на уровне платформы обусловлена не только тем, что это современный формат, который прикладные решения 1С:Предприятия сами по себе могут использовать для интеграции со сторонними приложениями. Другая причина заключается ещё и в том, что JSON активно используется в HTTP интерфейсах, для работы с которыми в 1С:Предприятии есть REST интерфейс приложения, автоматически генерируемый платформой, и HTTP-сервисы, которые можно создавать самостоятельно.
Существует несколько основных сценариев использования JSON.
- Интеграция с внешними системами через их HTTP интерфейсы: Google Calendar, Salesforce.com, REST интерфейс 1С:Предприятия, SharePoint и т. д.;
- Организация собственного HTTP интерфейса прикладного решения;
- Обмен файлами JSON с внешними системами. Формирование конфигурационных, настроечных файлов. Использование их в процедурах обмена данными, например, с интернет-магазинами;
- Использование файлов JSON для обмена данными между разными приложениями 1С:Предприятия.
В платформе реализовано несколько слоёв работы с JSON. Самые простые и гибкие — это низкоуровневые средства потоковой записи и чтения. Более высокоуровневые и не такие универсальные — средства сериализации в JSON примитивных типов и коллекций 1С:Предприятия. И, наконец, третий слой это средства, позволяющие сериализовать/десериализовать прикладные типы 1С:Предприятия: ссылки, объекты, наборы записей и вообще любые типы, для которых поддерживается XDTO сериализация.
Потоковое чтение и запись JSON
Объекты потоковой работы последовательно читают данные в формате JSON из файла или строки, или последовательно записывают их в файл или строку. Таким образом, чтение и запись данных происходят без формирования всего документа в памяти.
Потоковая запись JSON может выглядеть следующим образом. Записывается массив из четырёх элементов. Три из них примитивного типа, а четвёртый элемент — это объект с двумя свойствами:
Результат такой записи:
Сериализация примитивных типов и коллекций
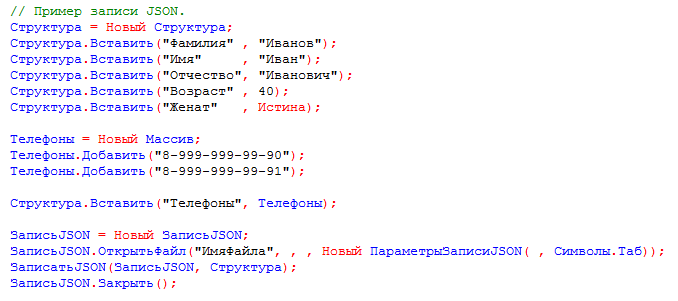
Вторая группа средств работы с JSON хороша тем, что избавляет от рутинной работы по чтению/записи каждого отдельного значения или свойства. При чтении документы JSON отображаются в фиксированный набор типов платформы: Строка, Число, Булево, Неопределено, Массив, ФиксированныйМассив, Структура, ФиксированнаяСтруктура, Соответствие, Дата. Соответственно, в обратную сторону, композиция объектов этих типов позволяет сформировать в памяти и быстро записать в файл структуру JSON. Таким образом, чтение и запись небольшого объема JSON заранее известной структуры можно производить немногими строчками кода.
Основное назначение этих средств в обмене информацией с внешними системами, чтении конфигурационных файлов в формате JSON.
Пример сериализации (записи) в JSON может выглядеть так:
Сериализация прикладных типов 1С:Предприятия
Прежде всего, и в основном, XDTO сериализацию в JSON рекомендуется использовать при обмене данными между двумя прикладными решениями 1С:Предприятия. Также этот механизм можно использовать и для обмена с внешними системами, готовыми принимать типы данных 1С:Предприятия.
Простейший код, выполняющий сериализацию элемента справочника, может выглядеть так:
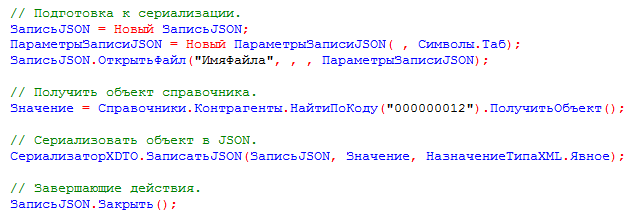
В результате будет получен файл JSON следующего содержания:
Функции преобразования и восстановления при сериализации
Не всегда сериализация может быть выполнена полностью автоматически. В жизни встречаются самые разные ситуации. Поэтому существует возможность использовать «самописную» функцию обработки значений при записи в JSON и при чтении из JSON.
При записи в JSON эта функция полезна потому, что позволяет самостоятельно преобразовать в JSON те типы, которые не подлежат автоматическому преобразованию. Или даже совсем отказаться от их сериализации.
При чтении из JSON функция восстановления может использоваться для того, чтобы преобразовать данные JSON в типы 1С, которые не могут являться результатом автоматического преобразования, или для того, чтобы самостоятельно (не автоматически) преобразовать даты JSON в даты 1С:Предприятия.
Во процессе десереализации прикладных типов 1С:Предприятия функция восстановления может потребоваться, например, для того, чтобы при переносе данных из одного прикладного решения в другое, заменить в них ссылки на связанные объекты. Так, чтобы после переноса эти данные ссылались уже на объекты новой базы. Или, например, для того, чтобы удалить из данных информацию, имеющую смысл только в исходной базе.
Использование JSON в HTTP интерфейсах приложений
Автоматически генерируемый REST интерфейс прикладных решений
При обращении к REST интерфейсу прикладного решения можно получать ответ в формате JSON. Есть возможность управлять объёмом передаваемой информации за счёт изменения детальности представления метаданных в выгрузке. Существуют три уровня: минимальный, средний и максимальный. Однако при этом нужно учитывать, что сокращение объёма передаваемой информации приводит к более интенсивным вычислениям на клиенте. И наоборот, когда вся информация включается в выгрузку, объём вычислений на клиенте будет минимальным.
HTTP-сервисы прикладного решения
HTTP-сервисы, реализованные в прикладном решении, также могут возвращать ответ в формате JSON. При этом, при формировании тела ответа, есть возможность указать, следует ли использовать BOM (Byte Order Mark, метка порядка байтов).
Взаимодействие со сторонними HTTP сервисами
При взаимодействии со сторонними HTTP интерфейсами также существует возможность сформировать тело запроса в JSON, а затем установить его в HTTP запрос.
Авторы: Е.Ю. Хрусталева
ТОП-50 вопросов системному аналитику на собеседовании
Всем привет! Я проходил собеседования на системного аналитика в разных компаниях с декабря 2021 до сентября 2022 каждую неделю по одному разу и каждый раз записывал все вопросы. Компании были не только российские, но и расположенные в самых разных регионах Европы, Азии и запада. Я собрал ТОП-50 вопросов технического собеседования. Вероятность что вам на всех собеседованиях попадутся именно эти вопросы очень сильна и я уверен что подготовившись на эти вопросы вам точно дадут оффер большинство, если не все компании.
P.S — Вопросы телефонного и первых этапов собеседования тут не включены, только вопросы технического собеседования
Требования
- Какие виды требований вы знаете?
- Что входит в функциональные требования?
- Что входит в нефункциональные требования?
- ГОСТ 19 и 34 для чего нужны и в чем разница между ними?
- Критерии требований
- Use cases — это что и как пишутся?
- User stories — это что и как пишутся?
- Заинтересованные лица (стейкхолдеры) — кто это и как с ними взаимодействовать?
- Что содержится в вашей типовой постановке задач для разработчика
Процесс разработки
- Расскажите про процесс разработки, который был принят на вашем прошлом месте работы
- Чем Kanban отличается от Scrum?
- Где можно применять Scrum и где нельзя?
Интеграции и проектирование
- Что такое XSD?
- Чем SOAP отличается от REST?
- Что такое XML и что в нем содержится?
- Какие методы есть в REST
- Напишите пример rest-API для книжной библиотеки на JSON
- Что содержит URL в REST запросе?
- Что такое WSDL?
- Понимание работы основных протоколов и способов взаимодействия систем (REST, GRPC, брокеры сообщений);
- Чем POST отличается от GET?
- Что такое идемпотентность?
- Что такое брокеры сообщений?
- Проектировали взаимодействие информационных систем?
- Какие виды и способы интеграций вы знаете?
- Чем Kafka отличается от RabbitMQ?
- Чем отличается ошибка 200 от 201?
- Что такое корпоративная шина?
- К корпоративной шине подключены веб-сервисы. В одном веб-сервисе появились два новых обязательных поля. Что изменится в интеграции?
- Чем брокер сообщений отличается от корпоративной шины?
- Назовите все способы снизить нагрузку на веб-сервис.
- Приходилось ли вам проектировать API в нотации OpenAPI/Swagger?
- Что такое клиент-сервер и микросервисы?
- Какими UML диаграммами вы пользуетесь?
- Что такое диаграмма последовательности?
- Какие элементы BPMN вы знаете?
- Опишите работу банкомата в BPMN
- Что такое Хореография и Оркестрация?
SQL и Базы данных
- Как привести данные в форму: что такое нормализация и зачем она нужна?
- Писали ли вы SQL запросы и для чего?
- Можете ли писать сложные запросы?
- Зачем нужны индексы в таблицах БД?
- JOIN запросы, что это и какими бывают?
- Что такое первичный ключ и какими свойствами обладает?
- Поисковые пути в БД это?
Другие вопросы
- Как работает https?
- Что такое FTP?
- Что такое SFTP
- Чем отличаются синхронное и асинхронное взаимодействия?
- Чем авторизация отличается от аутентификации?
- Что такое СЭД и как они работают?
- Что такое синхронное и асинхронное шифрование?
- Какие уровни протоколов знаете?
- Какие UX принципы вы знаете?
Чаще всего требования к кандидатам следующие (помимо опыта работы в определенном домене):
- Основная деятельность: сбор, анализ и документирование требований к ПО на техническом языке. Сопутствующее общение с заказчиками и проектной командой, изучение предметной области, участие в проектировании решений, проверка реализованного функционала на соответствие требованиям, участие в показах.
- Требуемые hard skills: навыки разработки технической документации (BRD, SRS), опыт работы с различными СУБД, уверенные знания SQL, проектирование модели данных, знание нотаций UML, BPMN, знание различных методов интеграции систем, понимание принципов проектирования REST API, опыт работы с SOAP, понимание особенностей форматов обмена данными JSON/XML.
- Требуемые soft skills: коммуникабельность, способность находить общий язык и с разработкой, и с бизнесом, аналитическое мышление, умение работать в условиях недостатка информации, адаптивность к изменениям, проактивность и ответственность за конечный результат.
Что такое ETL: полное руководство

Чем больше данных из различных источников собирает компания, тем больше у нее возможностей в аналитике. Но вместе с возможностями появляются и задачи, связанные с обработкой данных. Ведь перед тем, как начать строить отчеты и искать инсайты, все эти сырые и разрозненные данные необходимо обработать, привести к единому формату и объединить. Для этих задач используются процессы и инструменты извлечения, преобразования и загрузки (ETL). В этой статье мы подробно разбираем, что такое ETL и зачем инструменты ETL нужны аналитикам и маркетологам.
Что такое ETL и почему это важно?
Извлечение, преобразование, загрузка данных — это процесс интеграции данных, который лежит в основе анализа данных и состоит из трех этапов:
1) Данные взяты из первоисточника
2) Данные конвертируются в формат, пригодный для анализа
3) Данные загружаются в хранилище, озеро данных или систему бизнес-аналитики.
Инструменты ETL позволяют компаниям собирать данные различных типов из нескольких источников и объединять эти данные для работы с ними в централизованном хранилище данных.
Процессы извлечения, преобразования и загрузки данных обеспечивают основу для успешного анализа данных и создают единый источник надежных данных, обеспечивая согласованность и актуальность всех данных вашей компании.
Чтобы быть максимально полезной для лиц, принимающих решения, система бизнес-аналитики должна меняться по мере изменения бизнеса. ETL — это непрерывно изменяющийся процесс, и ваша система аналитики должна быть гибкой, автоматизированной и хорошо документированной.
Краткая история возникновения ETL
ETL стал популярным в 1970-х годах, когда компании начали работать с несколькими репозиториями или базами данных. В результате возникла необходимость эффективно интегрировать все эти данные.
В конце 1980-х годов появились технологии хранения данных, которые предлагали интегрированный доступ к данным из нескольких разнородных систем. Но проблема заключалась в том, что многим базам данных требовались ETL-инструменты конкретного поставщика. Поэтому разные отделы часто выбирали разные инструменты ETL для использования с разными решениями для хранения данных. Это привело к необходимости постоянно писать и настраивать скрипты под разные источники данных. Увеличение объема и сложности данных привело к автоматизированному процессу ETL, который позволяет избежать ручного кодирования.
Как работает процесс ETL
Процесс ETL состоит из трех этапов: извлечение, преобразование и загрузка. Давайте внимательно рассмотрим каждый из них.
Шаг 1. Извлеките данные
На этом этапе необработанные (структурированные и частично структурированные) данные из разных источников извлекаются и помещаются в промежуточную область (временную базу данных или сервер) для последующей обработки.
Источниками таких данных могут быть:
- Веб-сайты
- Мобильные устройства и приложения
- CRM/ERP-системы
- API-интерфейсы
- Маркетинговые услуги
- Инструменты аналитики
- Базы данных
- Облачные, гибридные и локальные среды
- Различные файлы
- Таблицы
- SQL- или NoSQL-серверы
- Эл. адрес
- Инструменты передачи данных Интернета вещей (IoT), такие как торговые автоматы, банкоматы и товарные датчики.
Данные, собранные из разных источников, обычно разнородны и представлены в разных форматах: XML, JSON, CSV и других. Поэтому перед его извлечением необходимо создать логическую карту данных, описывающую взаимосвязь между источниками данных и целевыми данными.
На этом шаге необходимо проверить:
- Соответствуют ли извлеченные записи исходным данным
- Спам / нежелательные данные
- Соответствуют ли данные требованиям к целевому хранилищу
- Есть ли дубликаты и фрагментированные данные
- Все ли ключи на месте
Данные могут быть извлечены тремя способами:
Частичное извлечение данных — источник уведомляет вас о последних изменениях данных.
Частичное извлечение без уведомления — не все источники данных предоставляют уведомление об обновлении, однако они могут указать на записи, которые изменились, и предоставить выдержку из таких записей.
Полное извлечение. Некоторые системы вообще не могут определить, какие данные были изменены; в этом случае возможна только полная выгрузка. Для этого вам понадобится копия последней загрузки в том же формате, чтобы вы могли найти и внести изменения.
Этот шаг может быть выполнен либо вручную аналитиками, либо автоматически. Однако извлечение данных вручную занимает много времени и может привести к ошибкам.
Шаг 2. Преобразование данных
На этом этапе необработанные данные, собранные в промежуточной области (временное хранилище), преобразуются в единый формат, отвечающий потребностям бизнеса и требованиям целевого хранилища данных. Такой подход — использование промежуточного хранилища вместо прямой загрузки данных в конечный пункт — позволяет быстро откатить данные, если вдруг что-то пойдет не так.
Преобразование данных может включать следующие операции:
- Очистка — устранение несоответствий и неточностей в данных
- Стандартизация — преобразование всех типов данных в один формат: даты, валюты и так далее
- Дедупликация — исключение лишних данных
- Проверка — удаление неиспользуемых данных и отметка аномалий
- Повторная сортировка строк или столбцов данных
- Объединение данных из двух значений в одно или, наоборот, разделить данные из одного значения на два
- Дополнение — добавление данных из других источников
- Форматирование данных в таблицы согласно схеме целевого хранилища данных
- Аудит качества данных и проверка соответствия
- Прочие задачи — применить любые дополнительные/необязательные правила для улучшения качества данных; например, если имя и фамилия в таблице находятся в разных столбцах, их можно объединить
- Трансформация, пожалуй, самая важная часть процесса ETL. Она помогает повысить качество данных и обеспечивает доставку обработанных данных в хранилище с полной совместимостью и готовностью к использованию в отчетах и других бизнес-задачах
По нашему опыту, некоторые компании до сих пор не подготавливают готовые для бизнеса данные и не строят отчеты на необработанных данных. Основная проблема такого подхода — бесконечная отладка и переписывание SQL-запросов. Поэтому мы настоятельно рекомендуем не игнорировать этот этап.
Шаг 3. Загрузите данные
На этом этапе обработанные данные из промежуточной области загружаются в целевую базу данных, хранилище либо локально, либо в облаке.
Это обеспечивает удобный доступ к бизнес-данным для различных групп внутри компании.
Есть несколько вариантов загрузки:
- Первичная загрузка — заполнение всех таблиц в хранилище данных в первый раз
- Инкрементная загрузка — периодически записывайте новые данные по мере необходимости. В этом случае система сравнивает поступающие данные с уже имеющимися и создает дополнительные записи только в случае обнаружения новых данных. Такой подход удешевляет обработку данных за счет уменьшения их объема
- Полное обновление — удаление содержимого таблицы и перезагрузка таблицы с последними данными
- Вы можете выполнить каждый из этих шагов с помощью инструментов ETL или вручную, используя собственный код и SQL-запросы
Преимущества ETL
- ETL экономит ваше время и помогает избежать ручной обработки данных.
Самым большим преимуществом процесса ETL является то, что он помогает автоматически собирать, преобразовывать и консолидировать данные. Вы можете сэкономить время и силы и избавиться от необходимости вручную импортировать огромное количество строк.
- ETL упрощает работу со сложными данными.
Со временем вашему бизнесу приходится иметь дело с большим объемом сложных и разнообразных данных: часовые пояса, имена клиентов, идентификаторы устройств, местоположения и так далее. Добавьте еще несколько атрибутов, и вам придется форматировать данные круглосуточно. Кроме того, входящие данные могут быть в разных форматах и разных типов. ETL делает вашу жизнь намного проще.
- ETL снижает риски, связанные с человеческим фактором.
Как бы аккуратно вы ни обращались со своими данными, вы не застрахованы от ошибок. Например, данные могут быть случайно продублированы в целевой системе или ручной ввод может содержать ошибку. Исключая влияние человека, инструмент ETL помогает избежать таких проблем.
- ETL помогает улучшить процесс принятия решений.
Автоматизируя рабочие процессы с критически важными данными и снижая вероятность ошибок, ETL гарантирует, что данные, которые вы получаете для анализа, имеют высокое качество и им можно доверять. А качественные данные имеют основополагающее значение для принятия более эффективных корпоративных решений.
- ETL увеличивает рентабельность инвестиций.
Поскольку процесс ETL экономит ваше время, усилия и ресурсы, процесс ETL в конечном итоге помогает вам повысить рентабельность инвестиций. Кроме того, улучшая бизнес-аналитику, вы увеличиваете свою прибыль. Это связано с тем, что компании полагаются на процесс ETL для получения консолидированных данных и принятия более эффективных бизнес-решений.
Проблемы ETL
При выборе инструмента ETL стоит полагаться на требования вашего бизнеса, объем собираемых данных и то, как вы их используете. С какими проблемами вы можете столкнуться при настройке процесса ETL?
- Выбор формата обработки данных.
Одна компания может работать с сотнями источников с разными форматами данных. Это могут быть структурированные и частично структурированные данные, потоковые данные в реальном времени, плоские файлы, файлы CSV, S3, источники потоковой передачи и многое другое. Некоторые из этих данных лучше конвертировать batch режиме, тогда как для других лучше работает потоковое преобразование данных. Обработка каждого типа данных наиболее эффективным и практичным способом может оказаться сложной задачей.
- Качество данных имеет первостепенное значение.
Чтобы аналитика работала эффективно, необходимо обеспечить точную и полную трансформацию данных. Ручная обработка, регулярное обнаружение ошибок и перезапись SQL-запросов могут привести к ошибкам, дублированию или потере данных. Инструменты ETL избавляют аналитиков от рутины и помогают уменьшить количество ошибок. Аудит качества данных выявляет несоответствия и дубликаты, а функции мониторинга предупреждают, если вы имеете дело с несовместимыми типами данных и другими проблемами.
- Ваша система аналитики должна быть масштабируемой.
Объем данных, которые собирают компании, с годами будет только расти. На данный момент вы можете довольствоваться локальной базой данных и пакетной загрузкой, но всегда ли этого будет достаточно для вашего бизнеса? Здорово иметь возможность масштабировать процессы и емкость ETL до бесконечности. Когда дело доходит до принятия решений на основе данных, мыслите масштабно и быстро: воспользуйтесь преимуществами облачного хранилища, которое позволяет быстро и дешево обрабатывать большие объемы данных.
ETL или ELT — в чем разница?
ELT (Extract, Load, Transform) — это, по сути, современный взгляд на знакомый процесс ETL, в котором данные преобразуются после их загрузки в хранилище.
Традиционные инструменты ETL извлекают и преобразовывают данные из разных источников перед их загрузкой в хранилище. С появлением облачных хранилищ больше нет необходимости очищать данные на промежуточном этапе между исходным и целевым хранилищами данных.
ELT особенно актуален для расширенной аналитики. Например, вы можете загружать необработанные данные в озеро данных, а затем объединять их с данными из других источников или использовать для обучения моделей прогнозирования. Хранение необработанных данных позволяет аналитикам расширить свои возможности. Этот подход быстр, потому что он использует мощь современных механизмов обработки данных и уменьшает ненужное перемещение данных.
Что выбрать? ETL или ELT? Если вы работаете локально, а ваши данные предсказуемы и поступают только из нескольких источников, то традиционного ETL будет достаточно. Однако это становится все менее и менее актуальным, поскольку все больше компаний переходят на облачные или гибридные архитектуры данных.
5 советов для успешного внедрения ETL
Если вы хотите реализовать успешный процесс ETL, выполните следующие действия:
Шаг 1. Четко определите источники данных, которые вы хотите собирать и хранить. Этими источниками могут быть реляционные базы данных SQL, нереляционные базы данных NoSQL, платформы программного обеспечения как услуги (SaaS) или другие приложения. После подключения источников данных определите конкретные поля данных, которые вы хотите извлечь. Затем примите или получите эти данные из различных источников в необработанном виде.
Шаг 2. Унифицируйте эти данные с помощью набора бизнес-правил (таких как агрегация, вложение, сортировка, функции слияния и так далее).
Шаг 3. После преобразования данные необходимо загрузить в хранилище. На этом шаге необходимо определиться с периодичностью загрузки данных. Укажите, хотите ли вы записать новые данные или обновить существующие данные.
Шаг 4. Важно проверить количество записей до и после передачи данных в хранилище. Это необходимо сделать, чтобы исключить неверные и избыточные данные.
Шаг 5. Последний шаг — автоматизировать процесс ETL с помощью специальных инструментов. Это поможет вам сэкономить время, повысить точность и уменьшить усилия, связанные с перезапуском процесса ETL вручную. С помощью инструментов автоматизации ETL вы можете проектировать рабочий процесс и управлять им через простой интерфейс. Кроме того, эти инструменты имеют такие возможности, как профилирование и очистка данных.
Основные выводы
Объемы данных, собираемых компаниями, с каждым днем становятся все больше и будут продолжать расти. Пока достаточно работы с локальными базами данных и пакетной загрузкой, однако очень скоро это перестанет удовлетворять потребности бизнеса. Таким образом, возможность масштабирования процессов ETL очень удобна и особенно актуальна для расширенной аналитики.
Основные преимущества инструментов ETL:
- Экономия вашего времени
- Нет ручной обработки данных
- Упрощает работу со сложными данными
- Снижение рисков, связанных с человеческим фактором
- Помогает улучшить принятие решений
REST, что же ты такое? Понятное введение в технологию для ИТ-аналитиков
Проектирование и работа с REST-сервисами стали повседневными задачами для многих аналитиков. Однако мы часто встречаемся на работе с различными или даже противоречащими друг другу трактовками таких понятий, как REST, RESTful-сервис, RESTAPI.
Сегодня мы разберём, какие принципы вложил в парадигму REST её автор и как они могут помочь нам при проектировании систем.
Выясним, почему существует терминологическая путаница вокруг REST и как нам научиться лучше понимать коллег.
Поговорим о том, как связаны HTTP и REST. А также почему REST противопоставляют SOAP.
Терминология
Формат представления данных
Давайте представим, что я живу в девятнадцатом веке и хочу отправить письмо своему клиенту, который заинтересован в покраске своего автомобиля. Разумеется, я должен написать в письме про то, какие цвета для покраски автомобиля имеются в автосалоне.
Перед тем, как отправить письмо, я беру лист бумаги и пишу клиенту, что в автосалоне сейчас доступны цвета: синий, зелёный, красный, белый, чёрный.
Но я мог бы написать это и на английском: blue, green, red, white, black.
Выходит, что одна и та же информация может быть представлена разными способами. И такой способ представления одной и той же информации разными способами будем называть форматом представления данных.
- Plain text — это обычный текст, который я использовал при написании письма;
- XML — язык разметки информации;
- JSON — текстовый формат обмена данными;
- Binary — бинарный формат.
Давайте запомним из этой части статьи что XML и JSON — это форматы представления данных.
Протокол передачи данных
Я написал письмо и теперь хочу его отправить. Что мне нужно для этого сделать? Как правило, я кладу письмо в конверт. В нашем случае таким конвертом будет такое понятие, как протокол передачи данных.
Протокол передачи данных — это набор соглашений, которые определяют обмен данными между различными программами. Эти соглашения задают единообразный способ передачи сообщений и обработки ошибок.

Если продолжать рассматривать аналогию с письмом, то стоит обратить, что:
1. конверт имеет структуру;
2. я наклеиваю на конверт марки, указываю определённую информацию: от кого письмо, куда я его отправляю, адрес и т.д.
Транспорт
Получил письмо в конверте, всё здорово! Но нужно его как-то отправить. Как мне его отправить? Я воспользуюсь услугами почты. Что для этого нужно сделать? Прийти на почту, отдать письмо. Затем его кто-то должен доставить, используя некоторый транспорт.
Транспорт — это подмножество сетевых протоколов, с помощью которых мы можем передавать данные по сети.
Такими протоколами могут быть, например: HTTP, AMQP, FTP.
Если продолжать аналогию с письмом, то почтовая служба может отправить это письмо с помощью голубя или, например, с помощью совы. Вроде бы, письмо одно и то же. Конверт (протокол) один и тот же, формат данных один и тот же, но, обратите внимание — транспорт разный.
Чтобы указать, что данные в определенном формате передаются с помощью некоторого транспорта, часто используют запись вида over .
- JSON over HTTP
- XML over HTTP
- XML over MQ
Протокол HTTP
HyperText Transfer Protocol (HTTP) — это протокол передачи данных. Изначально для передачи данных в виде гипертекстовых документов в формате HTML, сегодня — для передачи произвольных данных.
Этот протокол имеет две особенности, которые должны учитывать все, кто работает с этим протоколом: ресурсы и HTTP-глаголы.
Ресурсы
Чтобы разобраться с понятием ресурса, давайте представим, что у нас имеется некоторая ссылка: http://webinar.ru/schedule/speech.
Это как раз и есть тот самый URL, который мы используем поверх HTTP. Рассмотрим, из чего состоит эта ссылка:
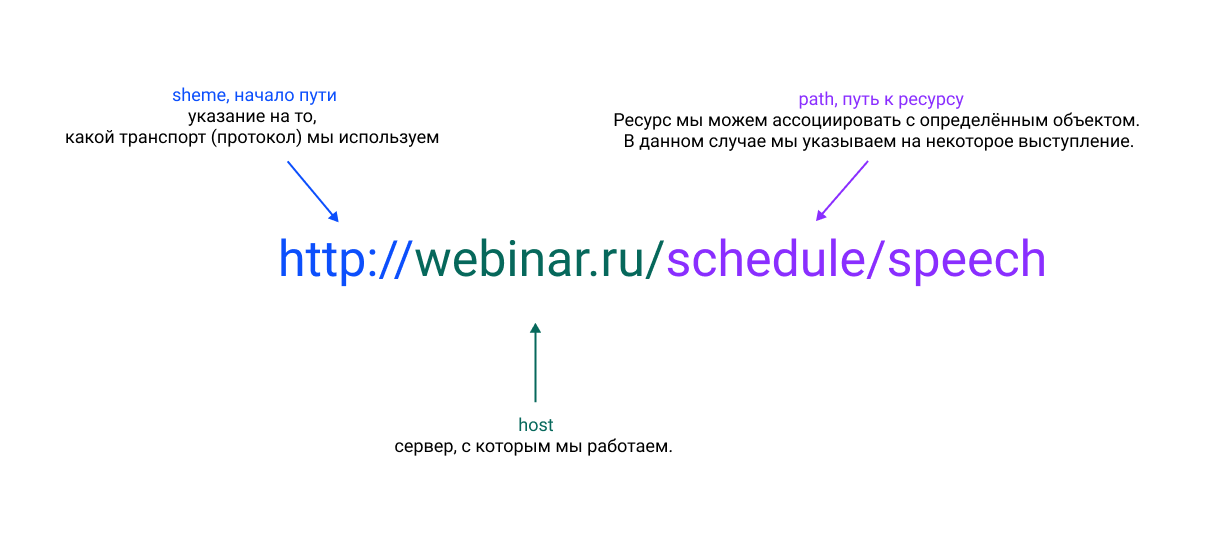
А вот как нам работать с этими объектами, нам говорят HTTP-глаголы (методы).
HTTP-глаголы
HTTP-глаголы — это элемент протокола HTTP, который используется в каждом запросе, чтобы указать, какое действие нужно выполнить над данным ресурсом.
- GET/schedule/speech/id413 — получить информацию об объекте
Здесь мы видим некоторый объект (ресурс) с конкретным идентификатором с номером 413. Я могу использовать HTTP-глагол GET для, того чтобы получить информацию о выступлении 413.
Я могу воспользоваться каким-либо другим HTTP-глаголом, если мне необходимо выполнить какие-либо другие действия.
- PUT/schedule/speech/id413 — создать или перезаписать объект
Или удалить объект:
- DELETE/schedule/speech/id413
Главное здесь то, что мы рассматриваем некоторые объекты (ресурсы) и совершаем над ними некоторые действия, которые определены в протоколе списком HTTP-методов: GET, PUT, POST, DELETE и т.д.
Что такое REST?
Какое же определение в понятие REST заложил его основатель Рой Филдинг?
Representational State Transfer — это архитектурный стиль взаимодействия компонентов распределённого приложения в сети. Архитектурный стиль – это набор согласованных ограничений и принципов проектирования, позволяющий добиться определённых свойств системы.
Но зачем нам REST? Зачем нам этот стиль? Что нам даст применение принципов REST?
Если мы обратимся опять же к первоисточнику — к работе Филдинга, то мы выясним, что назначение REST в том, чтобы придать проектируемой системе такие свойства как:
- Производительность,
- Масштабируемость,
- Гибкость к изменениям,
- Отказоустойчивость,
- Простота поддержки.
Это наиболее ценные свойства, с которыми встречается, например, аналитик при проектировании систем. В действительности их намного больше. Если внимательно посмотреть на эти свойства, то мы увидим ни что иное, как нефункциональные требования к системе, которых мы на своих проектах стремимся достичь.
Принципы REST
Каким образом REST может помочь нам достичь этих свойств и реализовать эти нефункциональные требования?
Чтобы это понять, давайте рассмотри 6 принципов REST — ограничений, которые и помогают нам добиться этих нефункциональных требований.
6 принципов REST:
- Клиент-серверная архитектура
- Stateless
- Кэширование
- Единообразие интерфейса
- Layered system
- Code on demand
Далее мы рассмотрим эти шесть принципов поподробнее.
Принцип 1. Клиент-серверная архитектура
Сама концепция клиент-серверной архитектуры заключается в разделении некоторых зон ответственности: в разделении функций клиента и сервера. Что это означает?
Например, мы разделяем нашу систему так, что клиент (допустим, это мобильное приложение) реализует только функциональное взаимодействие с сервером. При этом сервер реализует в себе логику хранения данных, сложные взаимодействия со смежными системами и т.д.
Что мы этим добиваемся и как могло бы быть иначе? Давайте представим, что клиент и сервер у нас объединены. Тогда, если мы говорим о мобильном приложении, каждое мобильное приложение каждого клиента должно было бы быть абсолютно самодостаточной единицей. И тогда, поскольку у нас единого сервера нет для получения/отправки информации, у нас получилась бы какая-то сеть единообразных компонентов – например, мобильные приложения общались бы друг с другом – такая распределённая сеть равноценных узлов.
Такие системы в реальной жизни есть и можно найти их примеры. Например, в блокчейне. Тем не менее, в случае с REST мы говорим о том, что разделяем ответственность. Например, отображение информации, её обработку и хранение.

Также сервер может иметь базу данных (см. рисунок ниже). В данном случае надо понимать, что пара «сервер и БД» тоже будет парой «клиент-сервер». Только в данном случае сервером будет БД, а сам сервер — клиентом.

Что дает клиент-серверная архитектура и зачем она нужна?
Во-первых, клиент-серверная архитектура дает нам определённую масштабируемость: есть сервер, есть единая точка обработки запросов. При необходимости выдерживать большую нагрузку мы можем поставить несколько серверов. Также к нему можно подключать достаточно большое количество клиентов (сколько сможет выдержать). Таким образом, клиент-серверная архитектура позволяет добиться масштабируемости.
Во-вторых, REST даёт определённую простоту поддержки. Если мы хотим изменить логику обработки информации на сервере, то выполним эти изменения на сервере. В данном случае мы можем и не менять каждого клиента, как если бы они были абсолютно равноценной сетью.
Конечно, есть и минусы. В случае с клиент-серверной архитектурой мы понимаем, что у нас есть единая точка отказа в виде сервера. Если отказал сервер и у нас нет дополнительных инстансов, то для нас это будет означать неработоспособность системы.
Также потенциально может увеличиться нагрузка, поскольку часть логики мы вынесли с клиента на сервер. Клиент будет совершать меньше каких-либо действий самостоятельно, соответственно, у нас возрастёт количество запросов между клиентом и сервером.
Принцип 2. Stateless
Принцип заключается в том, что сервер не должен хранить у себя информацию о сессии с клиентом. Он должен в каждом запросе получать всю информацию для обработки.

Представим, что у нас есть некоторый сервис прогноза погоды, в котором уже реализована клиент-серверная архитектура, и мы хотим получить сообщение о прогнозе погоды на завтра.
Что мы делаем в случае, если мы работаем с Stateless? Мы отправляем запрос «Какая погода?», отправляем место, где хотим погоду узнать, и дату. Соответственно, прогноз погоды отвечает нам — «Будет жарко».
Если я захочу узнать, какая будет погода через день, то опять укажу место, где хочу узнать погоду, укажу другую дату. Сервер получит этот запрос, обработает и сообщит мне, что там уже будет очень жарко.

Рассмотрим ситуацию: что было бы, если бы у нас не было Stateless? В таком случае у нас бы был Stateful. В этом случае сервер хранит информацию о предыдущих обращениях клиента, хранит информацию о сессии, какую-то часть контекста взаимодействия с клиентом. А затем может использовать эту информацию при обработке следующих запросов.
Приведём пример на рисунке:

Я всё так же хочу узнать, какая погода будет завтра: отправляю запрос, сервер его обрабатывает, формирует ответ и, помимо того, что он возвращает ответ клиентам, он еще сохраняет какую-то информацию (часть или всю) о том, какой запрос он получил. В случае, если я захочу узнать, какая погода будет через день, я могу сделать такой вызов: «А завтра?». Не сообщая ничего о месте и о дате.
В этом случае у сервера хранится некоторый контекст. Он понимает, что я у него спрашиваю про 21-е число и могу дать ответ на основе информации, хранимой у него в БД или в кэше. Один из примеров, где можно встретить подход Stateful в жизни — это работа с FTP-сервером.
Вернёмся к Statless-подходу. Почему в REST-архитектуре мы должны использовать именно Statless-подход?
Какие он даёт плюсы?
- Масштабируемость сервера,
- Уменьшение времени обработки запроса,
- Простота поддержки,
- Возможность использовать кэширование.
В первую очередь, это масштабирование сервера. Если каждый запрос содержит в себе абсолютно весь контекст, необходимый для обработки, то можно, например, клонировать сервер-обработчик: вместо одного поставить десять таких. Мне будет абсолютно неважно, в какой из этих клонов придёт запрос. Если бы они хранили состояние, то либо должны были синхронизироваться, либо мне нужно было бы умело направлять запрос в нужное место.
Помимо этого, появляется простота поддержки. Каждый раз я вижу в логах, какое сообщение приходило от клиента, какой ответ он получал. Мне не нужно дополнительно узнавать о том, какое состояние хранил сервер.
Также подход Stateless позволяет использовать кэширование.
Какие проблемы может создать Stateless-подход?
- Усложнение логики клиента (именно на стороне клиента нам нужно хранить всю информацию о состоянии, о допустимых действиях, о недопустимых действиях и подобных вещах).
- Увеличение нагрузки на сеть (каждый раз мы передаём всю информацию, весь контекст. Таким образом, больше информации гоняем по сети).
Принцип 3. Кэширование
В оригинале этот принцип говорит нам о том, что каждый ответ сервера должен иметь пометку, можно ли его кэшировать.
Что такое кэширование?
Представим, что у нас всё так же есть сервис по прогнозу погоды, есть клиент, с которым взаимодействуют. Сам по себе этот сервис погоду не определяет. Погоду определяет метеостанция, с которой он связывается с помощью специальных удалённых вызовов. Что происходит, когда мы используем кэширование?
Например, клиент обратился к серверу с запросом «Хочу узнать погоду». Что делает сервер?
Если мы его только запустили и используем кэширование или если мы не используем кэширование вообще — сервер обратится к метеостанции, а она вернёт ему ответ. Перед тем, как сервер ответит клиенту, он должен сохранить эту информацию в кэше. И только потом вернуть ответ. Для чего?
Когда клиент в следующий раз отправит ровно такой же запрос, сервер сможет не обращаться к метеостанции. Он сможет извлечь прогноз из кэша и вернуть ответ клиенту.

Чего мы добились? Мы убрали одну часть взаимодействия между сервером и метеостанцией. Зачем нам это нужно? Это нужно и полезно, если у сервера часто запрашивают одинаковую информацию. Например, кэширование активно используется на новостных сайтах или в соцсетях (на веб-ресурсах, к которым происходит много обращений).
Какие у кэширования плюсы?
- Уменьшение количества сетевых взаимодействий.
- Уменьшение нагрузки на системы (не грузим их дополнительными запросами).
В каких-то случаях одинаковых обращений будет не так много. Тогда кэширование использовать нет смысла.
При этом важно понимать, что кэширование — это совсем не простая штука. Она бывает достаточно сложна и нетривиальна в реализации.
Также мы должны учитывать, что если отдаём какие-то данные, которые сохранили раньше, то важно помнить, что эти данные могли уже устареть.
В каких-то случаях это может быть приемлемо, но в каких-то случаях — абсолютно недопустимо. Соответственно, стоит ли использовать кэширование — всегда нужно обдумывать на конкретном примере.
Принцип 4. Единообразие интерфейса. HATEOAS
Hypermedia as the Engine of Application State (HATEOAS) — одно из ограничений REST, согласно которому сервер возвращает не только ресурс, но и его связи с другими ресурсами и действия, которые можно с ним совершить.
Рассмотрим пример. Возьмём HTTP-запрос, в котором я хочу получить определенный ресурс:

Здесь мы используем HTTP-глагол GET, то есть хотим получить ресурс. Обращаемся к некоторому счёту с номером 12345.
Если бы мы не использовали подход HATEOAS, то получили бы примерно такой XML-ответ:

Здесь указан номер счёта, баланс и валюта.
Что же предлагает HATEOAS? Если бы мы с учётом этого ограничения выполняли бы этот запрос, то в ответе получим не только информацию об этом объекте, но и все те действия, которые мы можем с ним совершить. И, если бы у него были бы какие-то важные связанные объекты, мы получили бы ещё и ссылки на них.

Получая такие ответы, клиент самостоятельно понимает, какие конкретные действия он может совершать над этим объектом и какую ещё информацию о связанных объектах он может получить. Мы даём клиентскому приложению намного больше информации и свободы действий. Логика клиента становится более гибкой, но при этом и более сложной.
Главный плюс этого подхода — клиент становится очень гибким в плане изменений на сервере с точки зрения изменения допустимых действий, изменения модели данных и т.д.
В качестве обратной стороны медали мы получаем сильное усложнение логики, в первую очередь, клиента. Это может потянуть за собой и усложнение логики на сервере, потому что такие ответы нужно правильно формировать. Фактически ответственность за действия, которые совершает клиент, мы передаём на его же сторону. Мы ослабляем контроль валидности совершаемых операций на стороне сервера.
Принцип 5. Layered system (слоистая архитектура)
В предыдущих схемах мы рассматривали сторону клиента и сторону сервера, но не думали, что между ними могут быть посредники.
В реальной жизни между ними могут быть, к примеру, proxy-сервера, роутеры, балансировщики — все, что угодно. И то, по какому пути запрос проходит от клиента до сервера, мы часто не можем знать.
Концепция слоистой архитектуры заключается в том, что ни клиент, ни сервер не должны знать о том, как происходит цепочка вызовов дальше своих прямых соседей.

Знания балансировщика в этой схеме об участниках конкретно этой цепочки вызовов должны заканчиваться proxy-сервером слева и сервером справа. О клиенте он уже ничего не знает.
Если изменяется поведение proxy-сервера (балансировщика, роутера или чего-то ещё), это не должно повлечь изменения для клиентского приложения или для сервера. Помещая их в эту цепочку вызовов, мы не должны замечать никакой разницы. Это позволяет нам изменять общую архитектуру без доработок на стороне клиента или сервера.
- Увеличение нагрузки на сеть (больше участников и больше вызовов, чем если бы мы шли один раз от клиента до сервера напрямую).
- Увеличение времени получения ответа (из-за появления дополнительных участников).
Принцип 6. Code on done (код по требованию)
Идея передачи некоторого исполняемого кода (по сути какой-то программы) от сервера клиенту.

Представьте, что клиент — это, например, обычный браузер. Клиент отправляет некоторый запрос и ждёт ответа — страницу с определённым интерактивом (например, должен появляться фейерверк в том месте, где пользователь кликает кнопкой мышки). Это всё может быть реализовано на стороне клиента.
Либо клиент, запрашивая данную страницу приветствия, получит в ответ от сервера не просто HTML-код для отображения, а ещё программу, которую он сам и исполнит. Получается, что сервер передаёт исходный код клиенту, а тот его выполняет.
Что мы за счёт этого получаем? Отчасти, это схоже с принципом HATEOAS. Мы позволяем клиенту стать гибче. Если мы захотим изменить цвет фейерверка, то нам не нужно вносить изменений на клиенте — мы можем сделать это на сервере, а затем передавать клиенту. Пример такого языка — javascript.
Насколько же сходятся идеи, которые вложил Рэй Филдинг в концепцию REST, с восприятием REST аналитиками?
Давайте рассмотрим наиболее частые заблуждения, которые вы можете встретить относительно концепции REST.
1. Ограничения REST опциональны (необязательны)
С точки зрения создателя этой концепции существует ровно одно необязательное ограничение — код по требованию. Все остальные ограничения должны выполняться. Если одно из них не выполняется — это уже не REST-подход.
2. REST — протокол передачи данных
REST — это не протокол передачи данных. Он не определяет правила о том, как мы должны передавать запросы, какая у них должна быть структура, что мы должны возвращать в ошибках. Единственное, что косвенно можно было бы приписать — это указание на то, что каждый ответ сервера должен содержать информацию о том, можно ли его кэшировать.
Но, в целом, REST — это концепция, парадигма, но не протокол. В отличие от HTTP, который действительно является протоколом.
3. REST — это всегда HTTP
С одной стороны, ни один из архитектурных принципов REST не говорит нам о том, какой транспорт мы должны использовать — HTTP или очереди.
Но при этом в жизни очень часто встречаются люди, для которых REST и HTTP — это аксиома.
Поэтому, если сказать человеку, что REST — это необязательно HTTP, то вас могут посчитать сумасшедшими.
Почему же все считают, что REST — это HTTP? Здесь нужно сделать ремарку, что одним из главных авторов протокола HTTP — это Рэй Филдинг, автор концепции REST. Рэй Филдинг стремился спроектировать HTTP так, чтобы с помощью него концепцию REST было максимально удобно реализовывать.
4. REST — это обязательно JSON
Почему так сложилось? Главная причина в том, что какое-то время назад сервисы вида JSON over HTTP стали противопоставлять SOAP. JSON одновременно стал популярным и стал антагонистом XML, как SOAP подходу. JSON использовался, потому что это не SOAP.
Модель зрелости REST-сервисов

Ричардсон выделил уровни зрелости REST-сервисов. Выделение происходило исходя из подхода, что REST — это, с точки зрения протокола, всё-таки HTTP. Соответственно, он спроектировал модель, по которой можно понять: насколько сервис REST или не REST.
Уровень 0
В первую очередь, он выделил нулевой уровень. К нему относятся любые сервисы, которые в качестве транспорта используют HTTP и какой-то формат представления данных. Например, когда мы говорим про JSON over HTTP – мы говорим про нулевой уровень.
Если более наглядно «пощупать ручками» с точки зрения использования протокола HTTP, то можно представить, что мы выставляем некоторый API. Мы начинаем с того, что объявляем единый путь для отправки команд и всегда используем один и тот же HTTP-глагол для совершения абсолютно любых действий с любыми объектами. Например: создай вебинар, запиши вебинар, удали вебинар и т.д. То есть мы всегда используем один и тот же URL и всегда используем один и тот же HTTP-метод, обычно POST.
Как один из примеров:

Уровень 1
Следующий уровень — первый. Мы уже научились использовать разные ресурсы и делаем это не по одному URL. Но при этом всё ещё игнорируем HTTP-глаголы.
Мы просто разделяем явно наши объекты, как некоторые ресурсы. Например: спикер, курс, вебинар. Но, независимо от того, что мы хотим сделать — удалить, создать, редактировать, мы всё равно используем один и тот же HTTP-глагол POST.

Уровень 2
Второй уровень — это когда мы начинаем правильно с точки зрения спецификации HTTP-протокола использовать HTTP-глаголы.
Например, если есть спикер, то, чтобы создать спикера и получить информацию о нём, я использую соответствующий глагол: GET, POST. Когда хочу создать или удалить спикера — я использую глаголы: PUT, DELETE.
По сути, второй уровень зрелости — это то, что чаще всего называют REST.
Надо понимать, что, с точки зрения изначальной концепции, если мы дошли до второго уровня зрелости, то это еще не означает, что мы спроектировали REST-систему/ REST-сервис. Но в очень распространённом понимании соответствие 2-ому уровню часто называют RESTfull сервисом.
RESTfull-сервис — это такой сервис, который спроектирован с учётом REST-ограничений. Хотя, в целом, правильнее сервис такого уровня зрелости называть HTTP-сервисом или HTTP-API, нежели REST-API.

Уровень 3
Третий уровень зрелости — это уровень, в котором мы начинаем использовать концепцию HATEOAS. Когда мы передаём информацию, ресурсы, мы сообщаем потребителям (клиентам) о том, какие ещё действия необходимо совершить ресурсу, а также связи с другими ресурсами.

Выводы, которые мы можем сделать из модели зрелости
Итак, как нам эта модель может помочь понять то, что наши коллеги называют RESTом в каждой отдельно взятой компании? REST у вас или не REST?
Первая распространенная трактовка термина REST — всё, что передаётся в виде JSON поверх HTTP.
Вторая, не менее популярная версия, REST — это сервис второго уровня зрелости, то есть HTTP-API, составленное в соответствии со спецификацией HTTP-протокола. Если мы правильно выделяем ресурсы, правильно используем HTTP-глаголы, а также выполняем некоторые требования HTTP-протокола, то у нас REST.

Подведём итоги
Во-первых, у каждого свой REST. Мнения о том, что такое REST, часто разнятся. Когда мы работаем с новыми проектами, новыми коллегами или специалистами, очень важно понять, что именно ваш коллега называет RESTом. Это полезно для того, чтобы на одном из этапов проектирования или разработки не оказалось, что мы половину проекта говорили о разных вещах.
Во-вторых, принципы REST мы часто применяем в жизни. Они очень полезны для осмысления. Кэширование, STATELESS и STATEFUL, клиент-серверная модель или код по требованию — это те вещи, которые аналитику полезно знать для понимания.
Третье — это то, что парадигма REST помогает нам выявить и определить важнейшие свойства архитектуры — масштабируемость, производительность и т.д.
1. Способы описания API
- https://swagger.io/specification/
- https://raml.org
2. Инструменты для тестирования API
- https://www.postman.com
- https://www.soapui.org
3. Большой список открытых API
4. Ещё открытые API
- https://jsonplaceholder.typicode.com
- https://dadata.ru/api/
- https://coda.io/developers/apis/v1
- https://developer.kontur.ru/doc/focus?about=2
Вопросы участников вебинара и ответы на них Андрея
Что входит в задачи системного аналитика при проектировании REST-сервиса?
Предположу, что в вопросе говорится про REST-сервисы второго уровня зрелости, когда мы говорим про HTTP API. Здесь системный аналитик может, в зависимости от компании, от проекта и от договоренности с руководителем, делать многое.
Кто-то проектирует архитектуру сервиса, кто-то только формирует API. Наиболее часто аналитик готовит описание REST-сервиса с помощью каких-нибудь формализованных языков (например, Swagger или JSON-схемы).
Если не рассматривать описание формализованных языков, то остается описание структуры запросов/ответов, описание возможных ошибок, проектирование внутренней логики сервиса и того, что он делает.
В каких программах можно потренироваться новичкам и разобраться в командах, взаимодействиях REST (возможно, SOAP)?
Первое, о чём хочется рассказать сказать, это об инструменте Postman. Его можно как скачать и установить на ПК, так и работать онлайн. Postman — это некоторая утилита, которая позволяет вызывать внешние сервисы, внешние API, реальные REST-сервисы (которые работают поверх протокола HTTP) и используется для тестирования.
Также можно упомянуть SOAP UI и Swagger UI. Кстати, Swagger — это не только некоторый язык формального описания API, но ещё и редактор, с помощью которого можно вызывать реальные сервисы.
Какую последовательность действий можно посоветовать?
- Найти общедоступное API;
- Выбрать одну из утилит (я бы рекомендовал начать с Postman);
- Тренироваться.
Как определить необходимую детализацию описания требований REST API в конкретном проекте? Есть ли хорошие шаблоны описания?
К сожалению, это очень сложный и абстрактный вопрос, на который трудно ответить. Хочется сказать, что при определении детализации описания требований очень важно договариваться с командой.
На одном из проектов мы действовали оперативно: начинали с самого минималистичного варианта, говорили команде, что будем экспериментировать. И затем с фидбеком от команды оперативно перейдём к тому формату требований, который всех устраивает.
Какую документацию по интеграции должен уметь делать аналитик?
Ответ такой же, как и в предыдущем вопросе. Всё зависит от проекта и от того, как вы договоритесь с командой.
Если говорить про описание API, то это могут быть разные формальные языки. Описание REST API с помощью Swagger, описание транспортов/протоколов с помощью JSON-схемы, с помощью XSD + WSDL, если это SOAP-сервисы.
Ещё аналитик проектирует взаимодействие между системами или сервисами. Очень часто это визуализируют с помощью диаграммы последовательности (sequence diagram). Также можно использовать use case для описания взаимодействий не только пользователь-система, но и для описания интеграций. Также используют диаграмму потоков данных и компонентные схемы.
Об авторе
Андрей Бураков
Разработчик, аналитик и product owner в кровавом энтерпрайзе и продуктовой разработке
- Создал отдел системного и бизнес анализа VK Pay;
- Автор телеграм-канала об анализе и архитектуре Yet another SA channel;
- Автор и ведущий курсов по системной интеграции.