
Скачивание большого двоичного объекта с помощью Python
В этой статье показано, как скачать большой двоичный объект с помощью клиентской библиотеки службы хранилища Azure для Python. Данные больших двоичных объектов можно скачивать в различные места назначения, включая локальный путь к файлу, поток или текстовую строку. Вы также можете открыть поток больших двоичных объектов и считывать из него.
Предварительные требования
- В этой статье предполагается, что у вас уже есть проект, настроенный для работы с клиентской библиотекой Хранилище BLOB-объектов Azure для Python. Дополнительные сведения о настройке проекта, включая установку пакета, добавление import инструкций и создание авторизованного клиентского объекта, см. в статье Начало работы с Хранилище BLOB-объектов Azure и Python.
- Механизм авторизации должен иметь разрешения на выполнение операции скачивания. Дополнительные сведения см. в руководстве по авторизации для следующей операции REST API:
- Get BLOB (Получение BLOB-объекта)
Загрузка BLOB-объектов
Для скачивания большого двоичного объекта можно использовать следующий метод:
Метод download_blob возвращает объект StorageStreamDownloader . Во время скачивания клиентские библиотеки разделяют запрос на скачивание на блоки, где каждый блок загружается с отдельным запросом получить диапазон BLOB-объектов . Это поведение зависит от общего размера большого двоичного объекта и настройки параметров передачи данных .
Загрузка по пути к файлу
В следующем примере большой двоичный объект скачивается в путь к файлу:
def download_blob_to_file(self, blob_service_client: BlobServiceClient, container_name): blob_client = blob_service_client.get_blob_client(container=container_name, blob="sample-blob.txt") with open(file=os.path.join(r'filepath', 'filename'), mode="wb") as sample_blob: download_stream = blob_client.download_blob() sample_blob.write(download_stream.readall())Скачивание в поток
В следующем примере большой двоичный объект загружается в поток. В этом примере StorageStreamDownloader.read_into загружает содержимое большого двоичного объекта в поток и возвращает число прочитанных байтов:
def download_blob_to_stream(self, blob_service_client: BlobServiceClient, container_name): blob_client = blob_service_client.get_blob_client(container=container_name, blob="sample-blob.txt") # readinto() downloads the blob contents to a stream and returns the number of bytes read stream = io.BytesIO() num_bytes = blob_client.download_blob().readinto(stream) print(f"Number of bytes: ")Скачивание BLOB-объекта фрагментами
В следующем примере выполняется скачивание большого двоичного объекта и итерация по фрагментам в потоке загрузки. В этом примере StorageStreamDownloader.chunks возвращает итератор, который позволяет считывать содержимое большого двоичного объекта блоками:
def download_blob_chunks(self, blob_service_client: BlobServiceClient, container_name): blob_client = blob_service_client.get_blob_client(container=container_name, blob="sample-blob.txt") # This returns a StorageStreamDownloader stream = blob_client.download_blob() chunk_list = [] # Read data in chunks to avoid loading all into memory at once for chunk in stream.chunks(): # Process your data (anything can be done here - 'chunk' is a byte array) chunk_list.append(chunk)Скачивание в строку
В следующем примере содержимое BLOB-объекта скачивается в виде текста. В этом примере encoding параметр необходим для readall() возврата строки, в противном случае он возвращает байты:
def download_blob_to_string(self, blob_service_client: BlobServiceClient, container_name): blob_client = blob_service_client.get_blob_client(container=container_name, blob="sample-blob.txt") # encoding param is necessary for readall() to return str, otherwise it returns bytes downloader = blob_client.download_blob(max_concurrency=1, encoding='UTF-8') blob_text = downloader.readall() print(f"Blob contents: ")Скачивание блочного BLOB-объекта с параметрами конфигурации
Параметры конфигурации клиентской библиотеки можно определить при скачивании большого двоичного объекта. Эти параметры можно настроить для повышения производительности и надежности. В следующих примерах кода показано, как определить параметры конфигурации для скачивания как на уровне метода, так и на уровне клиента при создании экземпляра BlobClient. Эти параметры также можно настроить для экземпляра ContainerClient или blobServiceClient .
Указание параметров передачи данных при скачивании
Вы можете задать параметры конфигурации при создании экземпляра клиента, чтобы оптимизировать производительность операций передачи данных. При создании клиентского объекта в Python можно передать следующие аргументы ключевое слово:
- max_chunk_get_size — максимальный размер блока, используемый для скачивания большого двоичного объекта. Значение по умолчанию — 4 МиБ.
- max_single_get_size — максимальный размер большого двоичного объекта, который будет скачан за один вызов. Если общий размер большого двоичного объекта превышает max_single_get_size , остальная часть данных большого двоичного объекта загружается блоками. Значение по умолчанию — 32 МиБ.
Для операций скачивания можно также передать аргумент при вызове max_concurrency download_blob. Этот аргумент определяет максимальное число параллельных подключений для операции скачивания.
В следующем примере кода показано, как указать параметры передачи данных при создании BlobClient объекта и как скачать данные с помощью этого клиентского объекта. Значения, приведенные в этом примере, не предназначены для рекомендации. Чтобы правильно настроить эти значения, необходимо учитывать конкретные потребности приложения.
def download_blob_transfer_options(self, account_url: str, container_name: str, blob_name: str): # Create a BlobClient object with data transfer options for download blob_client = BlobClient( account_url=account_url, container_name=container_name, blob_name=blob_name, credential=DefaultAzureCredential(), max_single_get_size=1024*1024*32, # 32 MiB max_chunk_get_size=1024*1024*4 # 4 MiB ) with open(file=os.path.join(r'file_path', 'file_name'), mode="wb") as sample_blob: download_stream = blob_client.download_blob(max_concurrency=2) sample_blob.write(download_stream.readall())Ресурсы
Дополнительные сведения о скачивании BLOB-объектов с помощью клиентской библиотеки Хранилище BLOB-объектов Azure для Python см. в следующих ресурсах.
Операции REST API
Пакет Azure SDK для Python содержит библиотеки, которые создаются на основе REST API Azure, что позволяет взаимодействовать с операциями REST API через знакомые парадигмы Python. Методы клиентской библиотеки для скачивания больших двоичных объектов используют следующую операцию REST API:
- Получение BLOB-объекта (REST API)
Примеры кода
Ресурсы клиентской библиотеки
- Справочная документация по клиентской библиотеке
- Исходный код клиентской библиотеки
- Пакет (PyPi)
Python-блог
Скачивание файлов из интернета — это, наверно, та задача, с которой рано или поздно сталкивается любой программист. Самый популярный способ сделать это — использовать модули urllib или urllib2 для работы через http. Кроме этого у Вас есть модуль для работы с ftp. Наконец, у Вас есть сторонний модуль под названием request. В этой статье мы посмотрим как работать с модулями для http.
Так как это достаточно простая задача, то мы лишь сделаем маленький скрипт который загружает один и тот же zip файл тремя разными способами. Давайте посмотрим:
import urllib
import urllib2
import requestsprint «downloading with urllib»
urllib.urlretrieve(url, «code.zip»)print «downloading with urllib2»
f = urllib2.urlopen(url)
data = f.read()
with open(«code2.zip», «wb») as code:
code.write(data)print «downloading with requests»
r = requests.get(url)
with open(«code3.zip», «wb») as code:
code.write(r.content)Как Вы можете видеть, urllib требует всего одной строки, его достаточно легко использовать. С другой стороны и два других способа не сильно сложнее. Для urllib2 Вам надо открыть url, затем прочитать его и записать данные в файл. На самом деле, Вы можете сократить количество кода на одну строку:
f = urllib2.urlopen(url)
with open(«code2.zip», «wb») as code:
code.write(f.read())В любом случае это работает. Метод для чтения называется get, что соответствует HTTP GET. Мы получаем данные и затем записываем их при помощи менеджера контекста (выражения with), что позволяет нам автоматически закрыт файл и опять же сократить код.
Я думаю, что код можно сделать ещё короче, если уж извращаться (хотя сам не проверял):
with open(«code2.zip», «wb») as code:
code.write(urllib2.urlopen(url).read())Вот так всё просто. Теперь Вы можете легко скачивать файлы при помощи Python.
Что почитать по теме:
- StackOverFlow: Как можно скачать файл по HTTP с помощью Python?
- Скачивание файла из сети — recipe
Как скачать файл с помощью python
Для этого понадобится всего две строчки кода. Это, конечно, можно сделать разными способами… но мы сейчас будем использовать модуль urllib.
Итак, наш код выглядит следующим образом:import urllib urllib.urlretrieve('https://domain.com/files/file1.txt', 'out.txt')Здесь все предельно просто. Мы скачиваем файл по ссылке https://domain.com/files/file1.txt и сохраняем в файл с именем out.txt
Работа с файлами в Google Colab
Для построения модели нам нужны данные. И очень часто эти данные содержатся во внешних файлах. Мы уже столкнулись с этим, когда работали с рекомендательными системами и временными рядами. Предлагаю сегодня рассмотреть этот вопрос более детально.
Содержание занятия
- Общее описание процесса
- Датасет «Титаник»
- Способ 1. Вручную через вкладку «Файлы»
- Способ 2. Через объект files библиотеки google.colab
- Просмотр содержимого в папке /content/
- Модуль os и метод .walk()
- Команда !ls
- Шаг 1. Обработка и анализ данных
- Исследовательский анализ данных (EDA)
- Пропущенные значения
- Категориальные переменные
- Отбор признаков
- Нормализация данных
- Соревнование «Титаник»
- Вопросы для закрепления
Общее описание процесса

В целом работа с файлами в Google Colab состоит из следующих этапов.
- Этап 1. Подгрузка файлов с локального компьютера на сервер Google
- Этап 2. Чтение файла
- Этап 3. Построение модели и прогноз
- Этап 4. Сохранение результата в новом файле на сервере Google
- Этап 5. Скачивание обратно на жесткий диск
Пройдемся по каждому из них. Но прежде поговорим про данные.
Датасет «Титаник»
На этом занятии предлагаю взять датасет о пассажирах корабля «Титаник», который, как известно, затонул в 1912 году при столкновении с айсбергом. Часть пассажиров выжила, но многие, к сожалению, погибли. В предложенном датасете собрана информация о самих пассажирах (признаки), а также о том, выжили они или нет (целевая переменная).
Данные уже разделены на обучающую и тестовую выборки. Скачаем их.
Этап 1. Подгрузка файлов в Google Colab
Если внешние файлы хранятся на локальном компьютере, то нам нужно подгрузить их в так называемое «Сессионное хранилище» (session storage, по сути, сервер Google).
Слово «сессионное» указывает на то, что данные, как я уже говорил, хранятся временно и после завершения очередной сессии стираются.
Подгрузить данные с локального компьютера можно двумя способами.
Способ 1. Вручную через вкладку «Файлы»
Этот способ мы использовали до сих пор. В качестве напоминания приведу скриншоты подгрузки файла train.csv.


Способ 2. Через объект files библиотеки google.colab
К объекту files мы применяем метод .upload(), который передает нам словарь. Ключами этого словаря будут названия файлов, а значениями — сами подгруженные данные. Приведем пример с файлом test.csv.
# из библиотеки google.colab импортируем класс files
from google . colab import files
# создаем объект этого класса, применяем метод .upload()
uploaded = files . upload ( )Нам будет предложено выбрать файл на жестком диске.


# посмотрим на содержимое переменной uploaded
Все что идет после двоеточия ( : ) и есть наш файл. Он содержится в формате bytes, о чем свидетельствует буква b перед строкой файла (подробнее об этом ниже).
Этап 2. Чтение файлов
После загрузки оба файла (train.csv и test.csv) оказываются в сессионном хранилище в папке под названием /content/.

Просмотр содержимого в папке /content/
Модуль os и метод .walk()
Для того чтобы просмотреть ее содержимое внутри ноутбука, мы можем воспользоваться модулем os (отвечает за взаимодействие Питона с операционной системой) и, в частности, методом .walk() (позволяет «пройтись» по содержимому конкретной папки).
# импортируем модуль os
# выводим пути к папкам (dirpath) и наименования файлов (filenames) и после этого
for dirpath , _ , filenames in os . walk ( ‘/content/’ ) :
# во вложенном цикле проходимся по названиям файлов
for filename in filenames :
# и соединяем путь до папок и входящие в эти папки файлы
# с помощью метода path.join()
print ( os.path . join ( dirpath , filename ) )
/content/test.csv
/content/train.csv
/content/.config/gce
/content/.config/.last_update_check.json
/content/.config/config_sentinel
/content/.config/.last_opt_in_prompt.yaml
/content/.config/active_config
/content/.config/.last_survey_prompt.yaml
/content/.config/logs/2021.11.01/13.34.55.836922.log
/content/.config/logs/2021.11.01/13.34.28.082269.log
/content/.config/logs/2021.11.01/13.34.08.637862.log
/content/.config/logs/2021.11.01/13.34.55.017895.log
/content/.config/logs/2021.11.01/13.33.47.856572.log
/content/.config/logs/2021.11.01/13.34.35.080342.log
/content/.config/configurations/config_default
/content/sample_data/anscombe.json
/content/sample_data/README.md
/content/sample_data/california_housing_test.csv
/content/sample_data/mnist_train_small.csv
/content/sample_data/california_housing_train.csv
/content/sample_data/mnist_test.csvПервые два файла и есть наши данные. В скрытой подпапке /.config/ содержатся служебные файлы, а в подпапке /sample_data/ — примеры датасетов, хранящиеся в Google Colab по умолчанию.
Команда !ls
Кроме того, если нас интересуют только видимые файлы и папки, мы можем воспользоваться командой !ls (ls означает to list, т.е. «перечислить»).
sample_data test.csv train.csv
Подобным образом мы можем заглянуть внутрь папки sample_data.
! ls / content / sample_data /
anscombe.json mnist_test.csv
california_housing_test.csv mnist_train_small.csv
california_housing_train.csv README.mdТеперь прочитаем файл сначала из переменной uploaded, а затем напрямую из папки /content/.
Чтение из переменной uploaded
Как мы уже сказали выше, в словаре uploaded файл содержится в формате bytes.
# посмотрим на тип значений словаря uploaded
type ( uploaded [ ‘test.csv’ ] )Основная особенность: информация в объекте bytes представляет собой последовательность байтов (byte string), в то время как обычная строка — это последовательность символов (character string). Компьютер понимает первый тип, мы (люди) — второй.
Для того чтобы прочитать информацию из объекта bytes, ее нужно декодировать (decode). Если мы захотим вернуть ее обратно в объект bytes, соответственно, закодировать (encode).

Таким образом, чтобы прочитать данные напрямую из словаря uploaded, вначале нам нужно преобразовать эти данные в обычную строку.
# обратимся к ключу словаря uploaded и применим метод .decode()
uploaded_str = uploaded [ ‘test.csv’ ] . decode ( )
# на выходе получаем обычную строку
print ( type ( uploaded_str ) )Выведем первые 35 значений.
print ( uploaded_str [ : 35 ] )
PassengerId,Pclass,Name,Sex,Age,SibЕсли разбить строку методом .split() по символам \r (возврат к началу строки) и \n (новая строка), то на выходе мы получим список.
uploaded_list = uploaded_str . split ( ‘\r\n’ )
type ( uploaded_list )Пройдемся по этому списку и выведем первые четыре значения.
# не забудем создать индекс с помощью функции enumerate()
for i , line in enumerate ( uploaded_list ) :
# начнем выводить записи
print ( line )
# когда дойдем до четвертой строки
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
892,3,»Kelly, Mr. James»,male,34.5,0,0,330911,7.8292,,Q
893,3,»Wilkes, Mrs. James (Ellen Needs)»,female,47,1,0,363272,7,,S
894,2,»Myles, Mr. Thomas Francis»,male,62,0,0,240276,9.6875,,QВот нам и пригодился оператор break. Как мы видим, первая строка — это заголовок (header), остальные — информация по каждому из пассажиров.
Использование функции open() и конструкции with open()
Такого же результата можно добиться с помощью базовой функции open().
Обратите внимание, здесь мы читаем файл непосредственно из папки /content/. Декодировать файл уже не нужно.
Функция open() возвращает объект, который используется для чтения и изменения файла. Откроем файл train.csv.
# передадим функции open() адрес файла
# параметр ‘r’ означает, что мы хотим прочитать (read) файл
f1 = open ( ‘/content/train.csv’ , ‘r’ )Вначале попробуем применить метод .read().
# метод .read() помещает весь файл в одну строку
# выведем первые 142 символа (если параметр не указывать, выведется все содержимое)
print ( f1 . read ( 142 ) )
# в конце файл необходимо закрыть
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,»Braund, Mr. Owen Harris»,male,22,1,0,A/5 21171,7.25,,SДля наших целей метод .read() не очень удобен. Будет лучше пройтись по файлу в цикле for.
# снова откроем файл
f2 = open ( ‘/content/train.csv’ , ‘r’ )
# пройдемся по нашему объекту в цикле for и параллельно создадим индекс
for i , line in enumerate ( f2 ) :
# выведем строки без служебных символов по краям
print ( line . strip ( ) )
# дойдя до четвертой строки, прервемся
# не забудем закрыть файл
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,»Braund, Mr. Owen Harris»,male,22,1,0,A/5 21171,7.25,,S
2,1,1,»Cumings, Mrs. John Bradley (Florence Briggs Thayer)»,female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,»Heikkinen, Miss. Laina»,female,26,0,0,STON/O2. 3101282,7.925,,SЕще один способ — использовать конструкцию with open(). В этом случае специально закрывать файл не нужно.
# скажем Питону: «открой файл и назови его f3»
with open ( ‘/content/test.csv’ , ‘r’ ) as f3 :
# «пройдись по строкам без служебных символов»
for i , line in enumerate ( f3 ) :
print ( line . strip ( ) )
# и «прервись на четвертой строке»
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
892,3,»Kelly, Mr. James»,male,34.5,0,0,330911,7.8292,,Q
893,3,»Wilkes, Mrs. James (Ellen Needs)»,female,47,1,0,363272,7,,S
894,2,»Myles, Mr. Thomas Francis»,male,62,0,0,240276,9.6875,,QЧтение через библиотеку Pandas
Вероятно наиболее удобный и подходящий для наших целей способ чтения файлов — это преобразование напрямую в датафрейм библиотеки Pandas. С этим методом в целом мы уже знакомы.
# импортируем библиотеку
import pandas as pd
# применим функцию read_csv() и посмотрим на первые три записи файла train.csv
train = pd . read_csv ( ‘/content/train.csv’ )
train . head ( 3 )
# сделаем то же самое с файлом test.csv
test = pd . read_csv ( ‘/content/test.csv’ )
test . head ( 3 )
Примечание. На скриншотах приведена лишь часть датафреймов, полностью их можно посмотреть в ноутбуке⧉.
Этап 3. Построение модели и прогноз
Давайте ненедолго отвлечемся от работы с файлами и построим несложную модель, которая предскажет погиб пассажир (обозначим этот факт через 0) или выжил (1). Прежде всего, концептуально обсудим, что нам нужно сделать.
Для понимания дальнейшей работы очень советую пройти или повторить первые три раздела вводного курса. На этом занятии я предполагаю, что вы с ними уже знакомы.
- Шаг 1. Обработать и проанализировать данные
- Шаг 2. Разделить обучающую выборку (train) на признаки (X_train) и целевую переменную (y_train)
- Шаг 3. Обучить модель логистической регрессии
- Шаг 4. Подготовить тестовые данные (X_test) и построить прогноз
А теперь обо всем по порядку.
Шаг 1. Обработка и анализ данных
Исследовательский анализ данных (EDA)
Напомню, что основная задача EDA — выявить взаимосвязь между признаками и целевой переменной. Воспользуемся методом .info(), чтобы обобщенно посмотреть на наши данные.
train . info ( )
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
# Column Non-Null Count Dtype
0 PassengerId 891 non-null int64
1 Survived 891 non-null int64
2 Pclass 891 non-null int64
3 Name 891 non-null object
4 Sex 891 non-null object
5 Age 714 non-null float64
6 SibSp 891 non-null int64
7 Parch 891 non-null int64
8 Ticket 891 non-null object
9 Fare 891 non-null float64
10 Cabin 204 non-null object
11 Embarked 889 non-null object
dtypes: float64(2), int64(5), object(5)
memory usage: 83.7+ KBКак мы видим, у нас 12 переменных. Одна из них (Survived) — зависимая (целевая), остальные — независимые (признаки). Всего в датасете 891 запись, при этом в нескольких переменных есть пропуски.
Ниже приведено короткое описание каждой из переменных:
- PassengerId — id пассажира
- Survived — погиб (0) или выжил (1)
- Pclass — класс билета (первый (1), второй (2) или третий (3))
- Name — имя пассажира
- Sex — пол
- Age — возраст
- SibSp — количество братьев и сестер или супругов на борту
- Parch — количество родителей и детей на борту
- Ticket — номер билета
- Fare — стоимость билета
- Cabin — номер каюты
- Embarked — порт посадки (C — Шербур; Q — Квинстаун; S — Саутгемптон)
Проведем несложный визуальный анализ данных.
# для построения графиков воспользуемся новой для нас библиотекой seaborn
import seaborn as snsУ нас есть несколько потенциально значимых категориальных переменных, целевая переменная — тоже категориальная. В этом случае удобно использовать столбчатую диаграмму (bar chart), где каждый столбец также разбит на категории. В библиотеке seaborn такую диаграмму можно построить с помощью функции countplot().
# посмотрим насколько значим класс билета для выживания пассажира
# с помощью x и hue мы можем уместить две категориальные переменные на одном графике
sns . countplot ( x = ‘Pclass’ , hue = ‘Survived’ , data = train )
Мы видим, что погибших пассажиров в третьем классе гораздо больше, чем выживших. При этом в первом классе больше выживших, чем погибших. Очевидно класс билета имеет значение.
# кто выживал чаще, мужчины или женщины?
sns . countplot ( x = ‘Sex’ , hue = ‘Survived’ , data = train )
Большинство мужчик погибло. Большая часть женщин выжила. Пол также значим для построения прогноза.
Пропущенные значения
Посмотрим, что можно сделать с пропущенными значениями (missing values).
# выявим пропущенные значения с помощью .isnull() и посчитаем их количество sum()
train . isnull ( ) . sum ( )
PassengerId 0
Survived 0
Embarked 2
dtype: int64Больше всего пропущенных значений в переменной Cabin. Они также есть в переменных Age и Embarked.
# переменная Cabin (номер каюты), скорее всего, не является самой важной
# избавимся от нее с помощью метода .drop()
# (параметр axis отвечает за столбцы, inplace = True сохраняет изменения)
train . drop ( columns = ‘Cabin’ , axis = 1 , inplace = True )
# а вот Age (возраст) точно важен, заменим пустые значения средним арифметическим
train [ ‘Age’ ] . fillna ( train [ ‘Age’ ] . mean ( ) , inplace = True )В данном случае мы применили метод .fillna(), то есть «заполнить пропуски», к столбцу Age (через train [ ‘Age’ ] ) и заполнили пропуски средним значением этого же столбца через train [ ‘Age’ ] . mean ( ) .
Более подробно с преобразованием датафреймов мы познакомимся на курсе анализа и обработки данных. На данном этапе важно просто понимать логику нашей работы.
# у нас остаются две пустые строки в Embarked, удалим их
train . dropna ( inplace = True )Посмотрим на результат.
train . isnull ( ) . sum ( )
PassengerId 0
Survived 0
Embarked 0
dtype: int64Категориальные переменные
Теперь нужно поработать с категориальными переменными (categorical variable). Как мы помним, модель не сможет подобрать веса, если значения выражены словами (например, male и female в переменной Sex или C, Q, S в переменной Embarked).
Кроме того, когда категория выражена не 0 и 1, мы все равно не можем оставить ее без изменения. Например, если не трогать переменную Pclass, то модель воспримет классы 1, 2 и 3 как количественную переменную (проще говоря, число), а не как категорию.
И в первом, и во втором случае к переменным нужно применить one-hot encoding. Мы уже познакомились с этим методом, когда разбирали нейронные сети. В библиотеке Pandas есть метод .get_dummies(), который как раз и выполнит необходимые преобразования.
В статистике, dummy variable или вспомогательная переменная — это переменная, которая принимает значения 0 или 1 в зависимости от наличия определенного признака.
Применим этот метод на практике.
# применим one-hot encoding к переменной Sex (пол) с помощью метода .get_dummies()
pd . get_dummies ( train [ ‘Sex’ ] ) . head ( 3 )Первый пассажир — мужчина (в колонке male стоит 1), второй и третий — женщина. Помимо этого, если присмотреться, то станет очевидно, что мы можем обойтись только одним столбцом. В частности, в столбце male уже содержится достаточно информации о поле (если 1 — мужчина, если 0 — женщина). Это значит, что первый столбец можно удалить.
# удалим первый столбец, он избыточен
sex = pd . get_dummies ( train [ ‘Sex’ ] , drop_first = True )
sex . head ( 3 )Сделаем то же самое для переменных Pclass и Embarked.
embarked = pd . get_dummies ( train [ ‘Embarked’ ] , drop_first = True )
pclass = pd . get_dummies ( train [ ‘Pclass’ ] , drop_first = True )Еще раз замечу, что переменную Survived трогать не надо. Она уже выражена через 0 и 1.
Присоединим новые (закодированные) переменные к исходному датафрейму train. Для этого используем функцию .concat().
train = pd . concat ( [ train , pclass , sex , embarked ] , axis = 1 )
Отбор признаков
Теперь давайте отберем те переменные (feature selection), которые мы будем использовать в модели.
- В первую очередь, удалим исходные (до применения one-hot encoding) переменные Sex, Pclass и Embarked
- Кроме того, переменные PassengerId, Name и Ticket вряд ли скажут что-то определенное о шансах на выживание пассажира, удалим и их
# применим функцию drop() к соответствующим столбцам
train . drop ( [ ‘PassengerId’ , ‘Pclass’ , ‘Name’ , ‘Sex’ , ‘Ticket’ , ‘Embarked’ ] , axis = 1 , inplace = True )
train . head ( 3 )

Как вы видите, теперь все переменные либо количественные (Age, SibSp, Parch, Fare), либо категориальные и выражены через 0 и 1.
Нормализация данных
На занятиях по классификации и кластеризации мы уже говорили о важности приведения количественных переменных к одному масштабу. В противном случае модель может неоправданно придать большее значение признаку с большим масштабом.
# импортируем класс StandardScaler
from sklearn . preprocessing import StandardScaler
# создадим объект этого класса
scaler = StandardScaler ( )
# выберем те столбцы, которые мы хотим масштабировать
cols_to_scale = [ ‘Age’ , ‘Fare’ ]
# рассчитаем среднее арифметическое и СКО для масштабирования данных
scaler . fit ( train [ cols_to_scale ] )
# применим их
train [ cols_to_scale ] = scaler . transform ( train [ cols_to_scale ] )
# посмотрим на результат
train . head ( 3 )
Остается небольшой технический момент. Переменные 2 и 3 (второй и третий класс) выражены числами, а не строками (их выдает отсутствие кавычек в коде ниже). Так быть не должно.
train . columns
Index([‘Survived’, ‘Age’, ‘SibSp’, ‘Parch’, ‘Fare’, 2, 3, ‘male’, ‘Q’, ‘S’], dtype=’object’)Преобразуем эти переменные в тип str через функцию map().
train . columns = train . columns . map ( str )
Шаг 2. Разделение обучающей выборки на признаки и целевую переменную
# поместим в X_train все кроме столбца Survived
X_train = train . drop ( ‘Survived’ , axis = 1 )
# столбец ‘Survived’ станет нашей целевой переменной (y_train)
y_train = train [ ‘Survived’ ]
X_train . head ( 3 )
Шаг 3. Обучение модели логистической регрессии
Воспользуемся моделью логистической регрессии из библиотеки sklearn и передадим ей обучающую выборку.
# импортируем логистическую регрессию из модуля linear_model библиотеки sklearn
from sklearn . linear_model import LogisticRegression
# создадим объект этого класса и запишем его в переменную model
model = LogisticRegression ( )
# обучим нашу модель
model . fit ( X_train , y_train )
LogisticRegression()Остается сделать прогноз и оценить качество модели. При этом обратите внимание, что в тестовых данных отсутствует целевая переменная (почему это так, расскажу ниже), поэтому чтобы иметь хоть какое-то представление о качестве модели, нам необходимо вначале использовать обучающую выборку для построения прогноза.
# сделаем предсказание класса на обучающей выборке
y_pred_train = model . predict ( X_train )Теперь мы можем сравнить прогнозные значения с фактическими. Построим матрицу ошибок (confusion matrix).
# построим матрицу ошибок
from sklearn . metrics import confusion _ matrix
# передадим ей фактические и прогнозные значения
conf_matrix = confusion_matrix ( y_train , y_pred_train )
# преобразуем в датафрейм
conf_matrix_df = pd . DataFrame ( conf_matrix )
conf_matrix_dfДля удобства интерпретации добавим подписи.
conf_matrix_labels = pd . DataFrame ( conf_matrix , columns = [ ‘Прогноз погиб’ , ‘Прогноз выжил’ ] , index = [ ‘Факт погиб’ , ‘Факт выжил’ ] )
conf_matrix_labels

Также давайте посмотрим на метрику accuracy. Она показывает долю правильно предсказанных значений. То есть мы берем тех, кого верно предсказали как погибших (true negative, TN, таких было 478), и тех, кого верно предсказали как выживших (true positive, TP, 237), и делим на общее число прогнозов.
# рассчитаем метрику accuracy вручную
round ( ( 478 + 237 ) / ( 478 + 237 + 71 + 103 ) , 3 )
# импортируем метрику accuracy из sklearn
from sklearn . metrics import accuracy _ score
# так же передадим ей фактические и прогнозные значения
model_accuracy = accuracy_score ( y_train , y_pred_train )
# округлим до трех знаков после запятой
round ( model_accuracy , 3 )На обучающей выборке наша модель показала результат в 80,4%. При этом только на тестовой выборке мы можем объективно оценить качество нашего алгоритма.
Шаг 4. Построение прогноза на тестовых данных
Посмотрим на тестовые данные.
test . info ( )
RangeIndex: 418 entries, 0 to 417
Data columns (total 11 columns):
# Column Non-Null Count Dtype
0 PassengerId 418 non-null int64
1 Pclass 418 non-null int64
2 Name 418 non-null object
3 Sex 418 non-null object
4 Age 332 non-null float64
5 SibSp 418 non-null int64
6 Parch 418 non-null int64
7 Ticket 418 non-null object
8 Fare 417 non-null float64
9 Cabin 91 non-null object
10 Embarked 418 non-null object
dtypes: float64(2), int64(4), object(5)
memory usage: 36.0+ KBВзглянув на сводку по тестовым данным, становится заметна одна сложность. Мы обучили модель на обработанных данных. В частности, мы заполнили пропуски, закодировали категориальные переменные и убрали лишние признаки. Кроме того, мы масштабировали количественные переменные и превратили названия столбцов в строки.
Для того чтобы наша модель смогла работать с тестовой выборкой нам нужно таким же образом обработать и эти данные.
При этом обратите внимание, мы не нарушаем принципа разделения данных, поскольку меняем тестовую выборку так же, как мы меняли обучающую.
# для начала дадим датасету привычное название X_test
X_test = test
# заполним пропуски в переменных Age и Fare средним арифметическим
X_test [ ‘Age’ ] . fillna ( test [ ‘Age’ ] . mean ( ) , inplace = True )
X_test [ ‘Fare’ ] . fillna ( test [ ‘Fare’ ] . mean ( ) , inplace = True )
# выполним one-hot encoding категориальных переменных
sex = pd . get_dummies ( X_test [ ‘Sex’ ] , drop_first = True )
embarked = pd . get_dummies ( X_test [ ‘Embarked’ ] , drop_first = True )
pclass = pd . get_dummies ( X_test [ ‘Pclass’ ] , drop_first = True )
# присоединим новые столбцы к исходному датафрейму
X_test = pd . concat ( [ test , pclass , sex , embarked ] , axis = 1 )
# и удалим данные, которые теперь не нужныX_test . drop ( [ ‘PassengerId’ , ‘Pclass’ , ‘Name’ , ‘Sex’ , ‘Cabin’ , ‘Ticket’ , ‘Embarked’ ] , axis = 1 , inplace = True )
# посмотрим на результат
X_test . head ( 3 )
Теперь нужно масштабировать количественные переменные. Для этого мы будем использовать те параметры (среднее арифметическое и СКО), которые мы получили при обработке обучающей выборки. Так мы сохраним единообразие изменений и избежим утечки данных (data leakage).
# применим среднее арифметическое и СКО обучающей выборки для масштабирования тестовых данных
X_test [ cols_to_scale ] = scaler . transform ( X_test [ cols_to_scale ] )
X_test . head ( 3 )
Остается превратить название столбцов в строки.
X_test . columns = X_test . columns . map ( str )
И сделать прогноз на тестовой выборке.
y_pred_test = model . predict ( X_test )
На выходе мы получаем массив с прогнозами.
# посмотрим на первые 10 прогнозных значений
y_pred_test [ : 10 ]
array([0, 0, 0, 0, 1, 0, 1, 0, 1, 0])Этап 4. Сохранение результата в новом файле на сервере
Теперь, когда прогноз готов, мы можем сформировать новый файл, назовем его result.csv, в котором будет содержаться id пассажира и результат, погиб или нет. Приведу пример того, что мы хотим получить.
# файл с примером можно загрузить не с локального компьютера, а из Интернета
url = ‘https://www.dmitrymakarov.ru/wp-content/uploads/2021/11/titanic_example.csv’
# просто поместим его url в функцию read_csv()
example = pd . read_csv ( url )
example . head ( 3 )
Перед созданием нужного нам файла (1) соберем данные в новый датафрейм.
# возьмем индекс пассажиров из столбца PassengerId тестовой выборки
ids = test [ ‘PassengerId’ ]
# создадим датафрейм из словаря, в котором
# первая пара ключа и значения — это id пассажира, вторая — прогноз «на тесте»
result = pd . DataFrame ( < 'PassengerId' : ids , 'Survived' : y_pred_test >)
# посмотрим, что получилось
result . head ( )
И (2) создадим новый файл.
# создадим новый файл result.csv с помощью функции to_csv(), удалив при этом индекс
result . to_csv ( ‘result.csv’ , index = False )
# файл будет сохранен в ‘Сессионном хранилище’ и, если все пройдет успешно, выведем следующий текст:
print ( ‘Файл успешно сохранился в сессионное хранилище!’ )
Файл успешно сохранился в сессионное хранилище!Новый файл появится в «Сессионном хранилище».

Этап 5. Скачивание обратно на жесткий диск
После этого мы можем скачать файл на жесткий диск.
# применим метод .download() объекта files
files . download ( ‘/content/result.csv’ )Вот что у нас получилось.

Про соревнования на Kaggle
Вы вероятно заметили, что мы так и не узнали насколько хорош наш алгоритм на тестовой выборке. У нас просто нет тестовой целевой переменной (y_test).
Дело в том, что эти данные взяты с платформы, которая называется Kaggle⧉.

На этой платформе проводятся соревнования по машинному обучению. Участники получают данные, строят модели и затем подгружают свой результат. Kaggle его оценивает и тот или те, чья модель наиболее точна — выигрывают.
Соревнование «Титаник»
«Титаник» — одно из стартовых соревнований Kaggle для новичков. Предлагаю прямо сейчас в нем поучавствовать. На странице соревнования⧉, после того как вы зарегистрировались на сайте и присоединились к самому соревнованию, у вас появится возможность подгрузить файл с результатом.
Для этого зайдите на вкладку Submit Predictions⧉, (1) подгрузите файл result.csv с локального компьютера и (2) нажмите кнопку Make Submission.
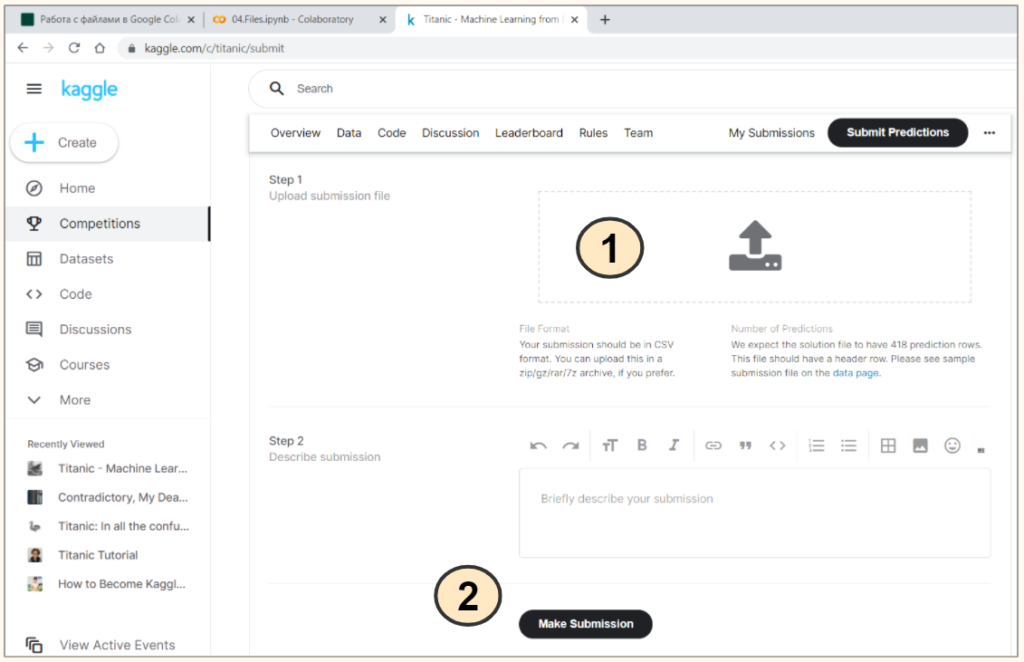
Платформа сама рассчитает accuracy вашего прогноза «на тесте» (Score). В нашем случае accuracy составляет 0,77033 или 77,03%. Чуть хуже, чем показатель «на трейне» (напомню, там было 80,4%).

Нажав на Jump to your position on the leaderboard, система сообщит вам ваше место в рейтинге участников (лидерборде).

Мы с вами оказались на 9512 месте из примерно 14500 участников. Для первого раза это хороший результат.
Подведем итог
Первая часть занятия была посвящена работе с внешними файлами. Мы научились:
- Подгружать внешний файл в сессионное хранилище
- Читать этот файл внутри ноутбука
- Обучать модель «на трейне» и делать прогноз на тестовых данных
- Подгружать прогноз в сессионное хранилище
- Скачивать его на жесткий диск
Во второй части мы приняли участие в соревновании «Титаник» на платформе Kaggle. Подгрузив прогноз, платформа сообщила нам accuracy нашей модели «на тесте» и наше место в лидерборде.
Вопросы для закрепления
Как вы считаете, что предпочтительнее использовать, функцию open() или конструкцию with open()?
Посмотреть правильный ответ
Ответ: конструкция with open() является более предпочтительной, в частности, потому что после отработки блока with Питон сам закрывает файл.
Какие данные мы подгрузили на платформу Kaggle?
Посмотреть правильный ответ
Ответ: мы подгрузили прогноз на тестовой выборке (y_pred_test). Платформа сравнила прогноз с фактическими данными y_test (то есть целевой переменной), которых у нас изначально не было, и рассчитала accuracy. На основе этой метрики нам было присвоено место в рейтинге участников.
В следующий раз мы подробнее изучим возможности Питона по работе с датой и временем.