
Как скачать контент с сайта, не засоряя браузер плагинами.
Порой возникает ситуация, когда нужно скачать музыку/видео/картинку с сайта, а заветной кнопки «Скачать» на странице нет.
Для популярных сайтов, вроде ВК и ютуба, эта проблема остро не стоит, для них имеется куча разных программ, плагинов или сайтов, дающих вам возможность скачать нужный контент. Но как быть с не столь популярными сайтами, для которых найти плагины почти нереально??
Способ есть! И что самое главное, ничего скачивать и устанавливать не надо, все делается стандартными средствами браузера.
Я не мастер словоблудия, поэтому учиться будем на примерах.
(формат поста: сначала описание картинки, потом — сама картинка)
1. Заходим на страницу с видео, кликаем правой кнопкой мыши, в появившемся меню выбираем пункт «Просмотреть код элемента».
2. В появившемся окне выбираем вкладку «Network».
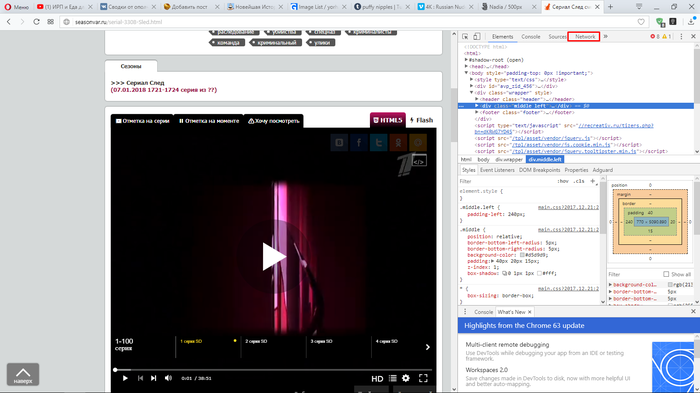
3. Затем выбираем вкладку «Media».
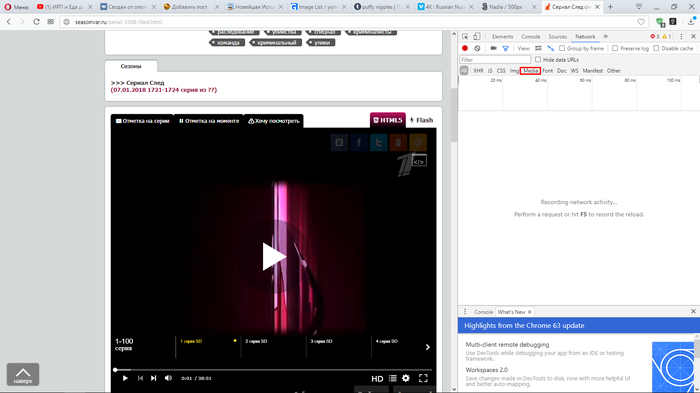
4. Перезагружаем страницу и запускаем видео.
5. Выбираем в таблице нужный нам файл (у меня он один, но бывает и несколько, тогда следует немного подождать, и выбрать файл с наибольшим объемом (объем файла указан в пункте «Size»)) и делаем двойной клик по нему.
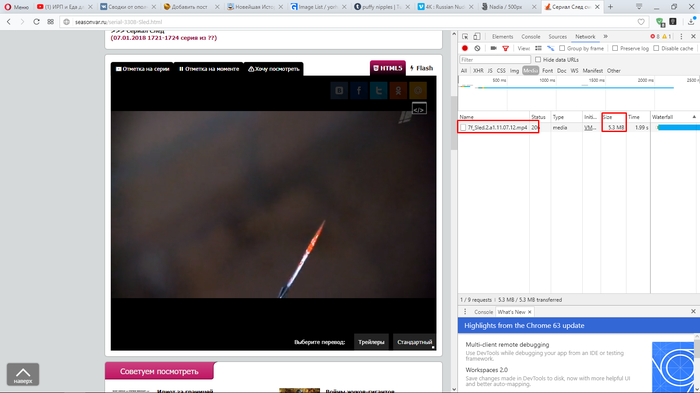
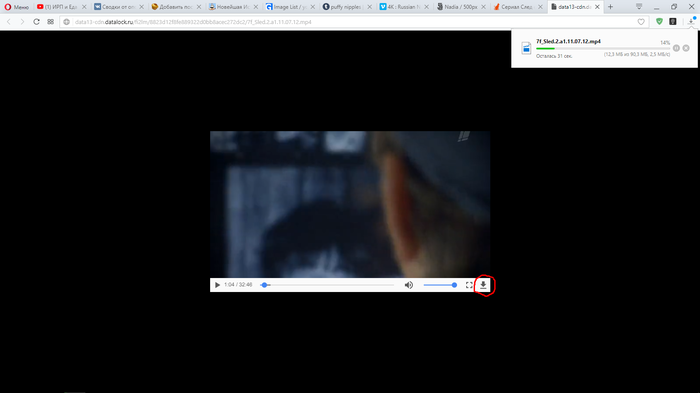
6. Откроется новая вкладка с плеером, нажимаем кнопку «Скачать» и наслаждаемся видом загрузки))
Пример 2. Музыка.
1. Повторяем пункты 1 — 4 из первого примера.
2. Запускаем воспроизведение нужного трека, и делаем двойной клик на файле с наибольшим объемом, затем повторяем пункт 6 из первого примера.
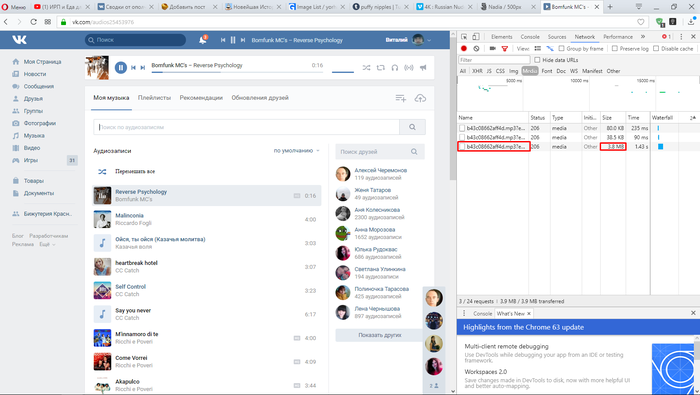
Пример 3. Картинка.
Чтобы не было глупых вопросов, поясню: не на всех сайтах можно сохранить картинку через контекстное меню, на некоторых оно либо урезано, либо заблокировано совсем.
1. Повторяем пункты 1 — 2 из первого примера.
2. Выбираем вкладку «Img».
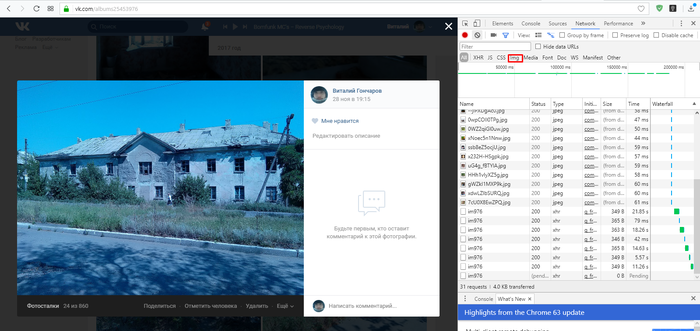
3. Перезагружаем страницу.
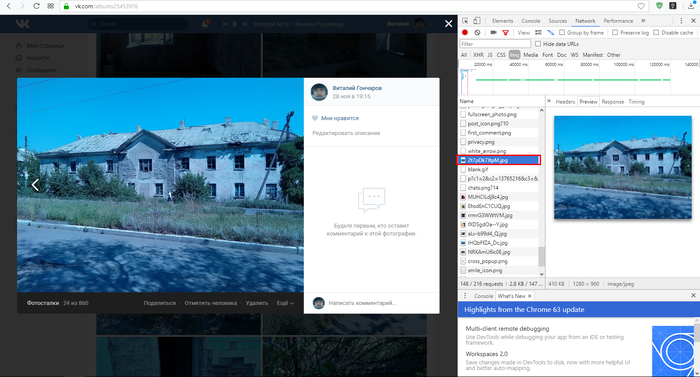
4. Ищем нужную картинку в списке (он может быть большим), используя предпросмотр (один клик по файлу) и найдя, делаем двойной клик по ней.
5. В открывшейся вкладке кликаем правой клавишей мыши по картинке, и выбираем в контекстном меню пункт «Сохранить изображение как. «.
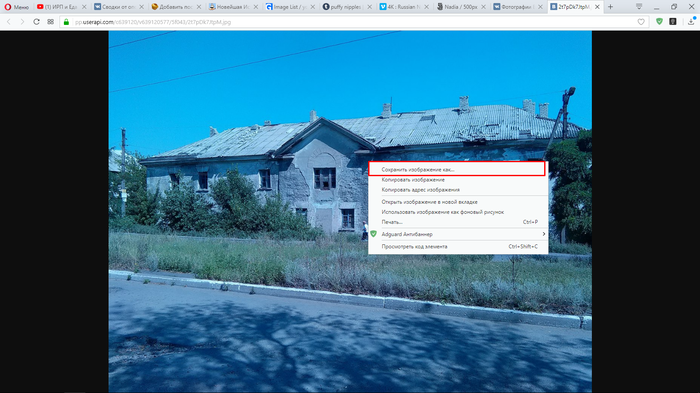
6. Сохраняем картинку.
P. S.: Все действия проводились на Опере v.50, за работоспособность этого способа на других браузерах я не ручаюсь.
5 лет назад
Ну удачи вам с потоковым контентом
раскрыть ветку
5 лет назад
уважаемый мамкин хакирь, специально от таких как вы видосы режут на кусочки и с ютуба ты так не скачаешь
пс: шучу, не специально а для оптимизации
раскрыть ветку
5 лет назад
Для Хрома — Flash Video Downloader
Для Мозилы — FlashGot
раскрыть ветку
5 лет назад
С потоковым видео такое не прокатит, плюс есть всякие защищенные плееры на подобии netu.tv, которые в плеер вставляют кучу всякого мусора, который затрудняет поиск потока.
Так, что НЕ с любого сайта.
5 лет назад
чет с ютобом у меня не прокатило
раскрыть ветку
Похожие посты
2 месяца назад
Девушка демонстрирует способы освободить связанные изолентой или зажимом руки
Мало ли пригодится в жизни.
Взято из сети.
Поддержать
9 месяцев назад
Ещё один вариант
Поддержать
1 год назад
Как купить билет на поезд, если билетов нет совсем. 3 проверенных способа
Бывают случаи, когда вам нужно ехать в другой город: по работе, на свадьбу, юбилей и т.д. Забегались, забыли, билеты не купили. Что делать, если билетов нет от слова Совсем. Да, на вашу дату осталось, пару билетов СВ по цене, как ваша месячная зарплата. Что делать? Вы не можете не ехать.
Сохраните в закладки, чтобы не потерять.
Отказные билеты.
Заходить на сайт РЖД каждые 10 минут. Во-первых есть много нюансов, когда снимается дополнительная бронь и появляются билеты, за 3 суток, за сутки, за 3 часа и т.д. Плюс кто-то может сдать билет.
Некоторые направления настолько популярны, например Минск-Москва, что уже в ноябре люди начинают покупать билеты на Новый год, причем в обе стороны. Тем более 10 дней праздничных дней в России сделают свое дело. Попробуйте найти билеты на 30 декабря, скорее всего их почти не осталось.
Второй способ- можно поделить ваш путь на части. Самый работающий метод.
Сейчас расскажу подробнее. Например, вы едете Москва-Минск. Билетов нет, совсем никаких. Вы смотрите маршрут поезда, который вам нужен. Какие крупные города проезжает поезд.
В нашем случае Вязьму, Смоленск. Начинаете смотреть билеты частями: Москва-Вязьма, Вязьма-Смоленск, Смоленск-Минск и т.д. Да это не очень удобно, старайтесь , чтобы места были в одном вагоне. То есть до Вязьмы вы едете на месте 21, дальше 45. Впринципе ничего страшного) Только у проводников иногда вызывает удивление.
Почему частями должны быть свободные места? Потому что человек, например, купил билет Москва-Вязьма, это всего 3 часа от Москвы, дальше это место до самого Минска будет свободно, а вы в итоге не можете уехать.
Допустим вы нашли билет Вязьма-Минск, теперь ваша задача добраться из Москвы до Вязьмы. Ищите билет в этом же вагоне или хотя бы поезде. Если вообще ничего нет, смотрите билет на другой поезд. Да, это не удобно! Пересаживаться, иногда ночью, на другой поезд! Но речь о ситуациях, когда вам надо быть завтра на свадьбе свидетельницей, и вы не можете сказать подруге:
-Извини, не было билетов, я не приеду!
К тому же до этого ближайшего города, например, Вязьмы, вы можете добраться на электричке, скоростной Ласточке за 2 часа, на автобусе, вас может довезти муж на машине.
Третий способ — смотреть билеты на начало следующего дня.
Допустим впереди 3-4 праздничных дня и вы упорно ищите билеты на пятницу вечер. Ничего нет. Всем надо ехать.
А теперь попробуйте посмотреть на субботу, после 0.00 часов. И там кстати довольно много поездов, на час ночи, на 3.00. Вот как раз на поезда глубокой ночью могут быть билеты, потому что не каждый сможет добраться. Плюс на утро скорее всего будут билеты, да, потом полдня ехать, может немного опоздаете на торжество. Но вы приедете!
Вывод- выход с покупкой билетов есть всегда! Да, способы не очень удобные, но не пешком же вам идти.
Забронировать билет на поезд онлайн:
Сервисы бронирования жилья:
Суточно (квартиры, комнаты, отели и апартаменты),
Как скачать файлы с сайта через код страницы.
Мне нужно скачать около трехсот png (единый pdf сайт не дает) и при этом не тыкать на каждый пкм -> открыть в новой вкладке и скачать. Они не выделяются.
Голосование за лучший ответ
Есть программы граббер сайта …используй их))
Ссылку на сайт с этими картинками можно?
Андрей КейльЗнаток (487) 2 года назад
Это сайт типографии учебника, злые люди не дают учебник (только купить доступ на год за 150 рублей онлайн, скачать его нельзя)
Lame Wolf Искусственный Интеллект (355440) Андрей Кейль, Мне насрать кто там не дает тебе книги! Тебя просили ссылку на сайт!
На странице с нужными картинками:
ПКМ — Сохранить как html
Затем посмотреть любым текстовым редактором (например Notepad++) на наличие ссылок на картинки.
Если таковые имеются, то попытаться найти все такие (см. скриншот 1)
Ещё немного терпения… Может быть какие-то дополнительные условия… Может быть с помощью макросов… Получим голый список (см. скриншот 2)
Сохранить его в файл и с помощью какой-нибудь утилитки типа WGET (https://eternallybored.org/misc/wget/) и скармливаем ему этот файлик…
Но это при условии, что нужные картинки именно в html присутствуют. Динамические сайты не всегда это дают.
Прячут картинки за своими движками… ;–)


11 фишек для извлечения и сохранения данных с сайтов

В закладки
БЕЗ скриптов, макросов, регулярных выражений и командной строки.
Эта статья пригодится студентам, которые хотят скачать все картинки с сайта разом, чтобы потом одним движением вставить их в Power Point и сразу получить готовую презентацию. Владельцам электронных библиотек, которые собирают новые книги по ресурсам конкурентов. Просто людям, которые хотят сохранить интересный сайт/страницу в соцсети, опасаясь, что те могут скоро исчезнуть, а также менеджерам, собирающим базы контактов для рассылок.
Есть три основные цели извлечения/сохранения данных с сайта на свой компьютер:
- Чтобы не пропали;
- Чтобы использовать чужие картинки, видео, музыку, книги в своих проектах (от школьной презентации до полноценного веб-сайта);
- Чтобы искать на сайте информацию средствами Spotlight, когда Google не справляется (к примеру поиск изображений по exif-данным или музыки по исполнителю).
Ситуации, когда неожиданно понадобится автоматизированно сохранить какую-ту информацию с сайта, могут случиться с каждым и надо быть к ним готовым. Если вы умеете писать скрипты для работы с утилитами wget/curl, то можете смело закрывать эту статью. А если нет, то сейчас вы узнаете о самых простых приемах сохранения/извлечения данных с сайтов.
1. Скачиваем сайт целиком для просмотра оффлайн
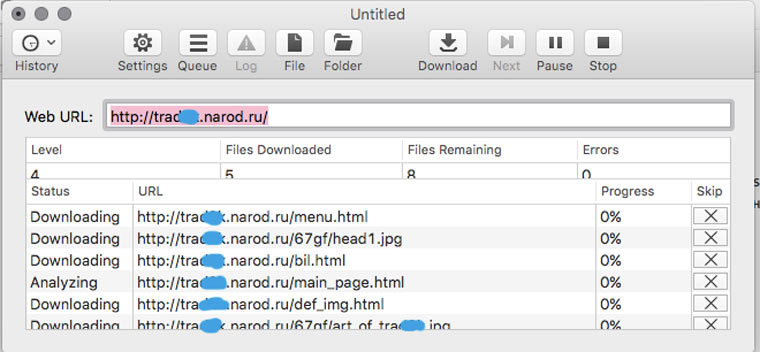
В OS X это можно сделать с помощью приложения HTTrack Website Copier, которая настраивается схожим образом.
Пользоваться Site Sucker очень просто. Открываем программу, выбираем пункт меню File -> New, указываем URL сайта, нажимаем кнопку Download и дожидаемся окончания скачивания.
Чтобы посмотреть сайт надо нажать на кнопку Folder, найти в ней файл index.html (главную страницу) и открыть его в браузере. SiteSucker скачивает только те данные, которые доступны по протоколу HTTP. Если вас интересуют исходники сайта (к примеру, PHP-скрипты), то для этого вам нужно в открытую попросить у его разработчика FTP-доступ.
2. Прикидываем сколько на сайте страниц
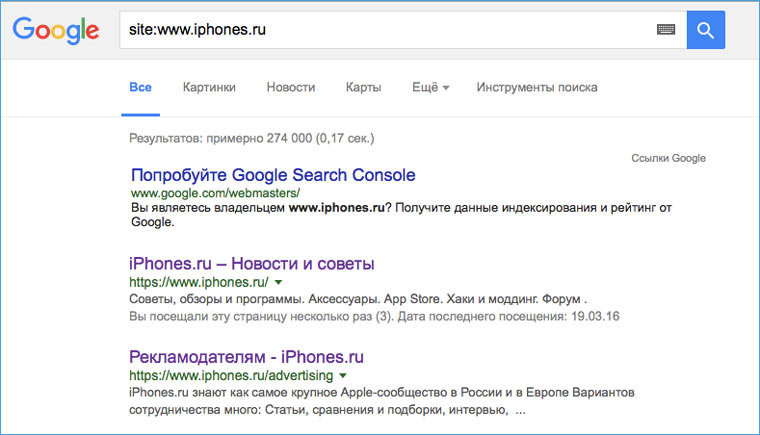
Перед тем как браться за скачивание сайта, необходимо приблизительно оценить его размер (не затянется ли процесс на долгие часы). Это можно сделать с помощью Google. Открываем поисковик и набираем команду site: адрес искомого сайта. После этого нам будет известно количество проиндексированных страниц. Эта цифра не соответствуют точному количеству страниц сайта, но она указывает на его порядок (сотни? тысячи? сотни тысяч?).
3. Устанавливаем ограничения на скачивание страниц сайта
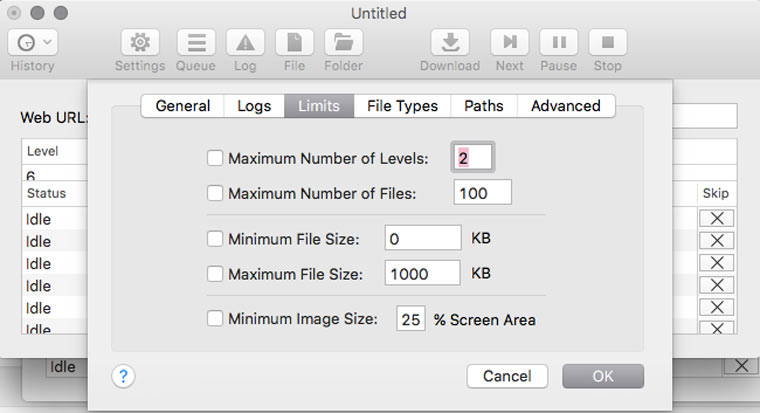
Если вы обнаружили, что на сайте тысячи страниц, то можно ограничить число уровней глубины скачивания. К примеру, скачивать только те страницы, на которые есть ссылка с главной (уровень 2). Также можно ограничить размер загружаемых файлов, на случай, если владелец хранит на своем ресурсе tiff-файлы по 200 Мб и дистрибутивы Linux (и такое случается).
Сделать это можно в Settings -> Limits.
4. Скачиваем с сайта файлы определенного типа
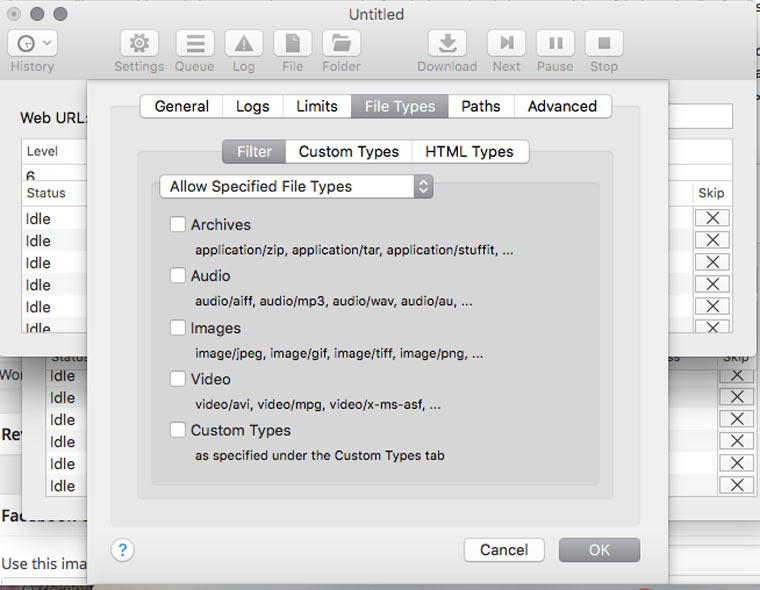
В Settings -> File Types -> Filters можно указать какие типы файлов разрешено скачивать, либо какие типы файлов запрещено скачивать (Allow Specified Filetypes/Disallow Specifies Filetypes). Таким образом можно извлечь все картинки с сайта (либо наоборот игнорировать их, чтобы места на диске не занимали), а также видео, аудио, архивы и десятки других типов файлов (они доступны в блоке Custom Types) от документов MS Word до скриптов на Perl.
5. Скачиваем только определенные папки
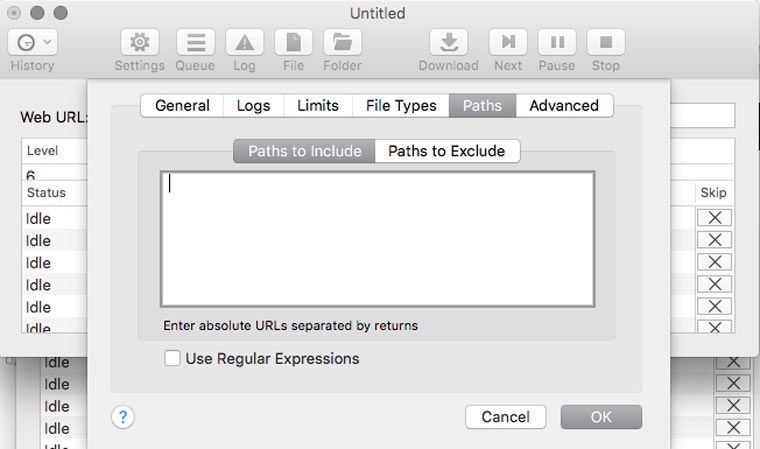
Если на сайте есть книги, чертежи, карты и прочие уникальные и полезные материалы, то они, как правило, лежат в отдельном каталоге (его можно отследить через адресную строку браузера) и можно настроить SiteSucker так, чтобы скачивать только его. Это делается в Settings -> Paths -> Paths to Include. А если вы хотите наоборот, запретить скачивание каких-то папок, то их адреса надо указать в блоке Paths to Exclude
6. Решаем вопрос с кодировкой
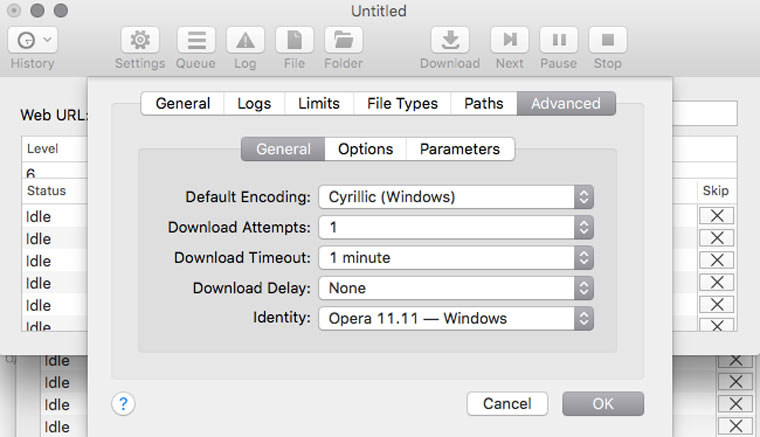
Если вы обнаружили, что скачанные страницы вместо текста содержат кракозябры, там можно попробовать решить эту проблему, поменяв кодировку в Settings -> Advanced -> General. Если неполадки возникли с русским сайтом, то скорее всего нужно указать кодировку Cyrillic Windows. Если это не сработает, то попробуйте найти искомую кодировку с помощью декодера Лебедева (в него надо вставлять текст с отображающихся криво веб-страниц).
7. Делаем снимок веб-страницы
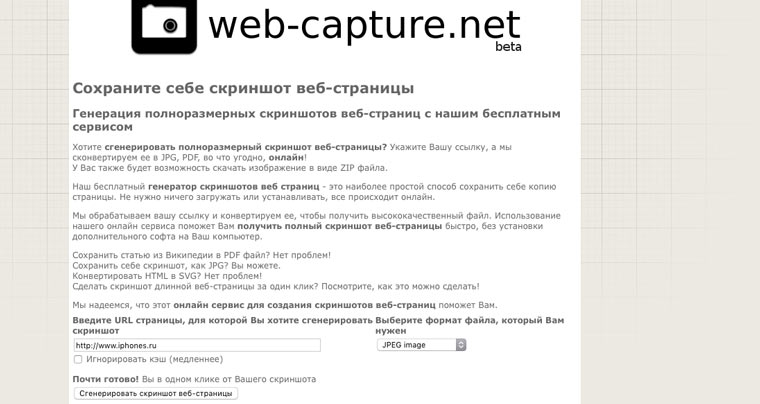
Сделать снимок экрана умеет каждый. А знаете ли как сделать снимок веб-страницы целиком? Один из способов — зайти на web-capture.net и ввести там ссылку на нужный сайт. Не торопитесь, для сложных страниц время создания снимка может занимать несколько десятков секунд. Еще это можно провернуть в Google Chrome, а также в других браузерах с помощью дополнения iMacros.
Это может пригодиться для сравнения разных версий дизайна сайта, запечатления на память длинных эпичных перепалок в комментариях или в качестве альтернативы способу сохранения сайтов, описанного в предыдущих шести пунктах.
8. Сохраняем картинки только с определенной страницы
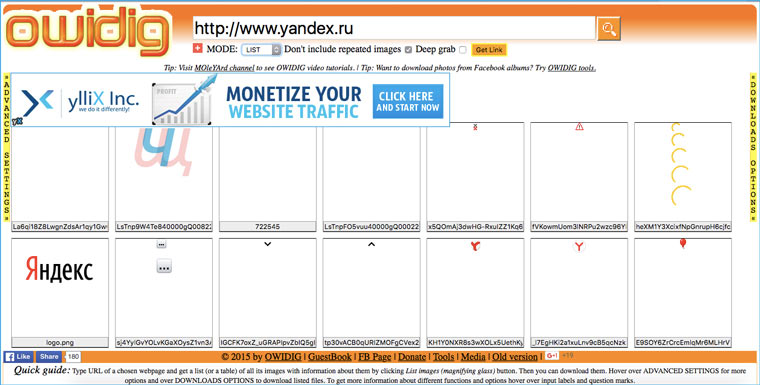
Идем на owdig.com, указываем нужную ссылку, ждем когда отобразятся все картинки и кликаем на оранжевую полоску справа, чтобы скачать их в архиве.
9. Извлекаем HEX-коды цветов с веб-сайта
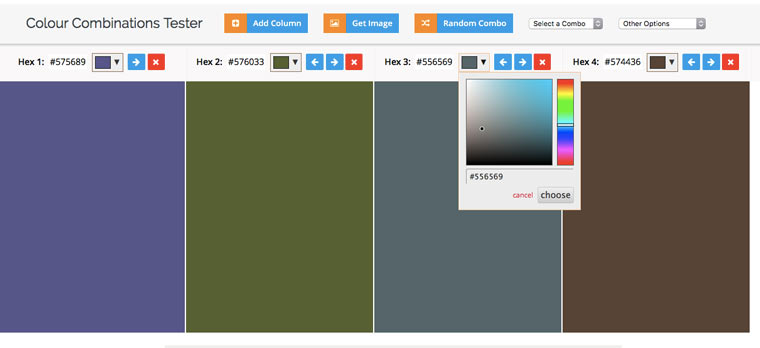
Идем на colorcombos.com и набираем адрес искомой страницы и получаем полный список цветов, которые использованы на ней.
10. Извлекаем из текста адреса электронной почты

Предположим, что вам надо сделать рассылку по сотрудникам компании, а их email-адреса есть только на странице корпоративного сайта и копировать их оттуда в ручную займет лишние 20-30 минут. В такой ситуации на помощь приходит сервис emailx.discoveryvip.com. Просто вставьте туда текст и через секунду вы получите список всех адресов электронной почты, которые в нем найдены.
11. Извлекаем из текста номера телефонов
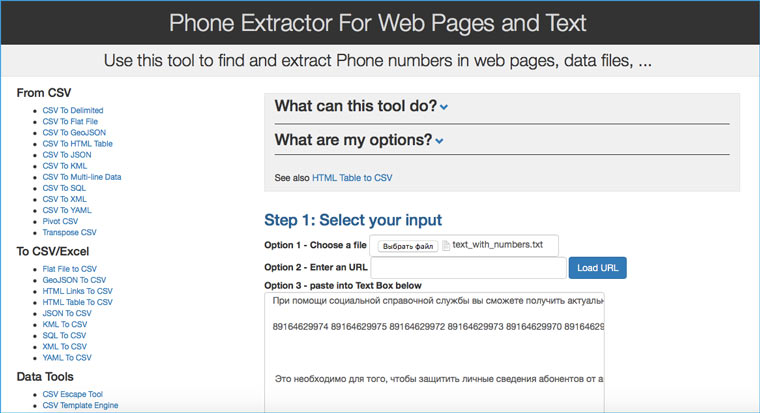
Идем на convertcsv.com/phone-extractor.htm, копируем в форму текст/html-код, содержащий номера телефонов и нажимаем на кнопку Extract.
А если надо отфильтровать в тексте заголовки, даты и прочую информацию, то к вам на помощь придут регулярные выражения и Sublime Text.
Есть и другие способы извлечения данных с сайтов. Можно попросить какую-ту информацию непосредственно у владельца ресурса, cохранять части веб-страниц с помощью iMacros и парсить сайты с помощью Google Apps Script. Еще можно пойти традиционным путем и написать для парсинга bash-скрипт, но статей об этом на iPhones.ru пока нет.
(4 голосов, общий рейтинг: 4.50 из 5)
�� Хочешь ещё? Читай больше в Telegram
�� Ищешь ответ на вопрос? Приходи на Форум
БЕЗ скриптов, макросов, регулярных выражений и командной строки. Эта статья пригодится студентам, которые хотят скачать все картинки с сайта разом, чтобы потом одним движением вставить их в Power Point и сразу получить готовую презентацию. Владельцам электронных библиотек, которые собирают новые книги по ресурсам конкурентов. Просто людям, которые хотят сохранить интересный сайт/страницу в соцсети, опасаясь, что.
Экспорт кода
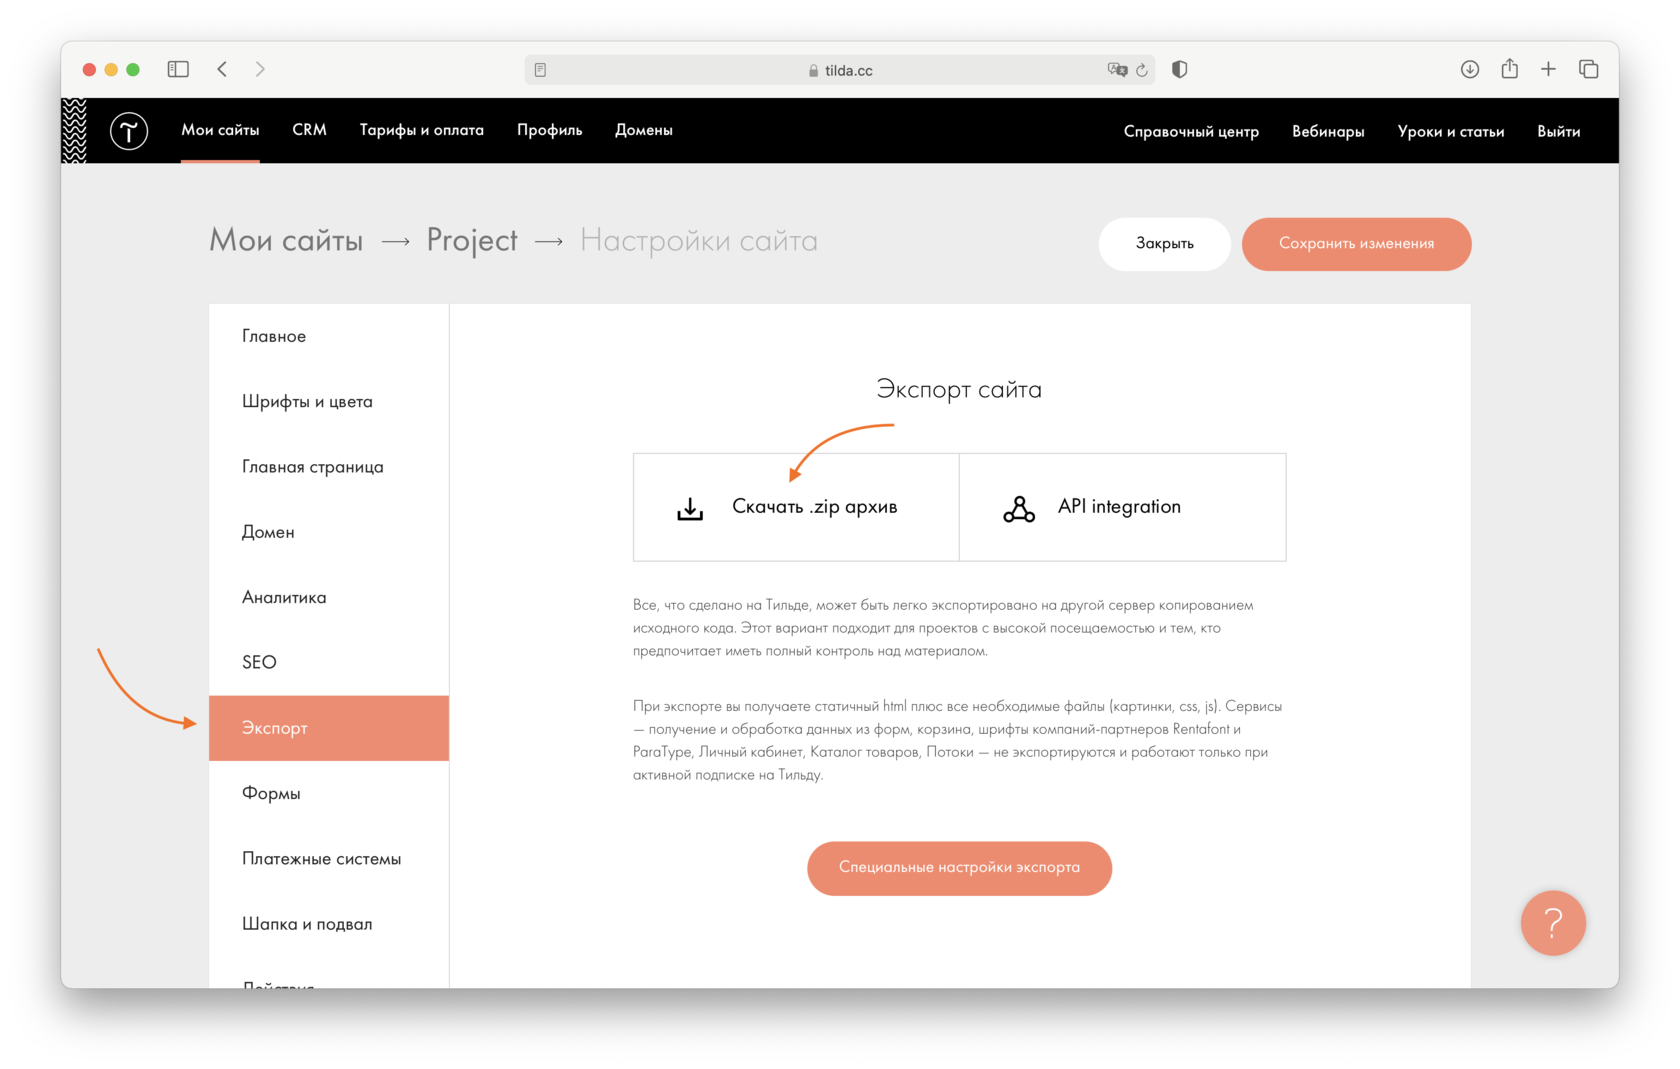
Нажмите «Скачать .zip архив» → «Начать экспорт», подождите несколько секунд, пока идет архивация страниц, затем нажмите на ссылку, которая появится после списка файлов. Сохраните zip-файл на компьютере.

Распакуйте файл, у вас появится папка, которая содержит все файлы вашего проекта.
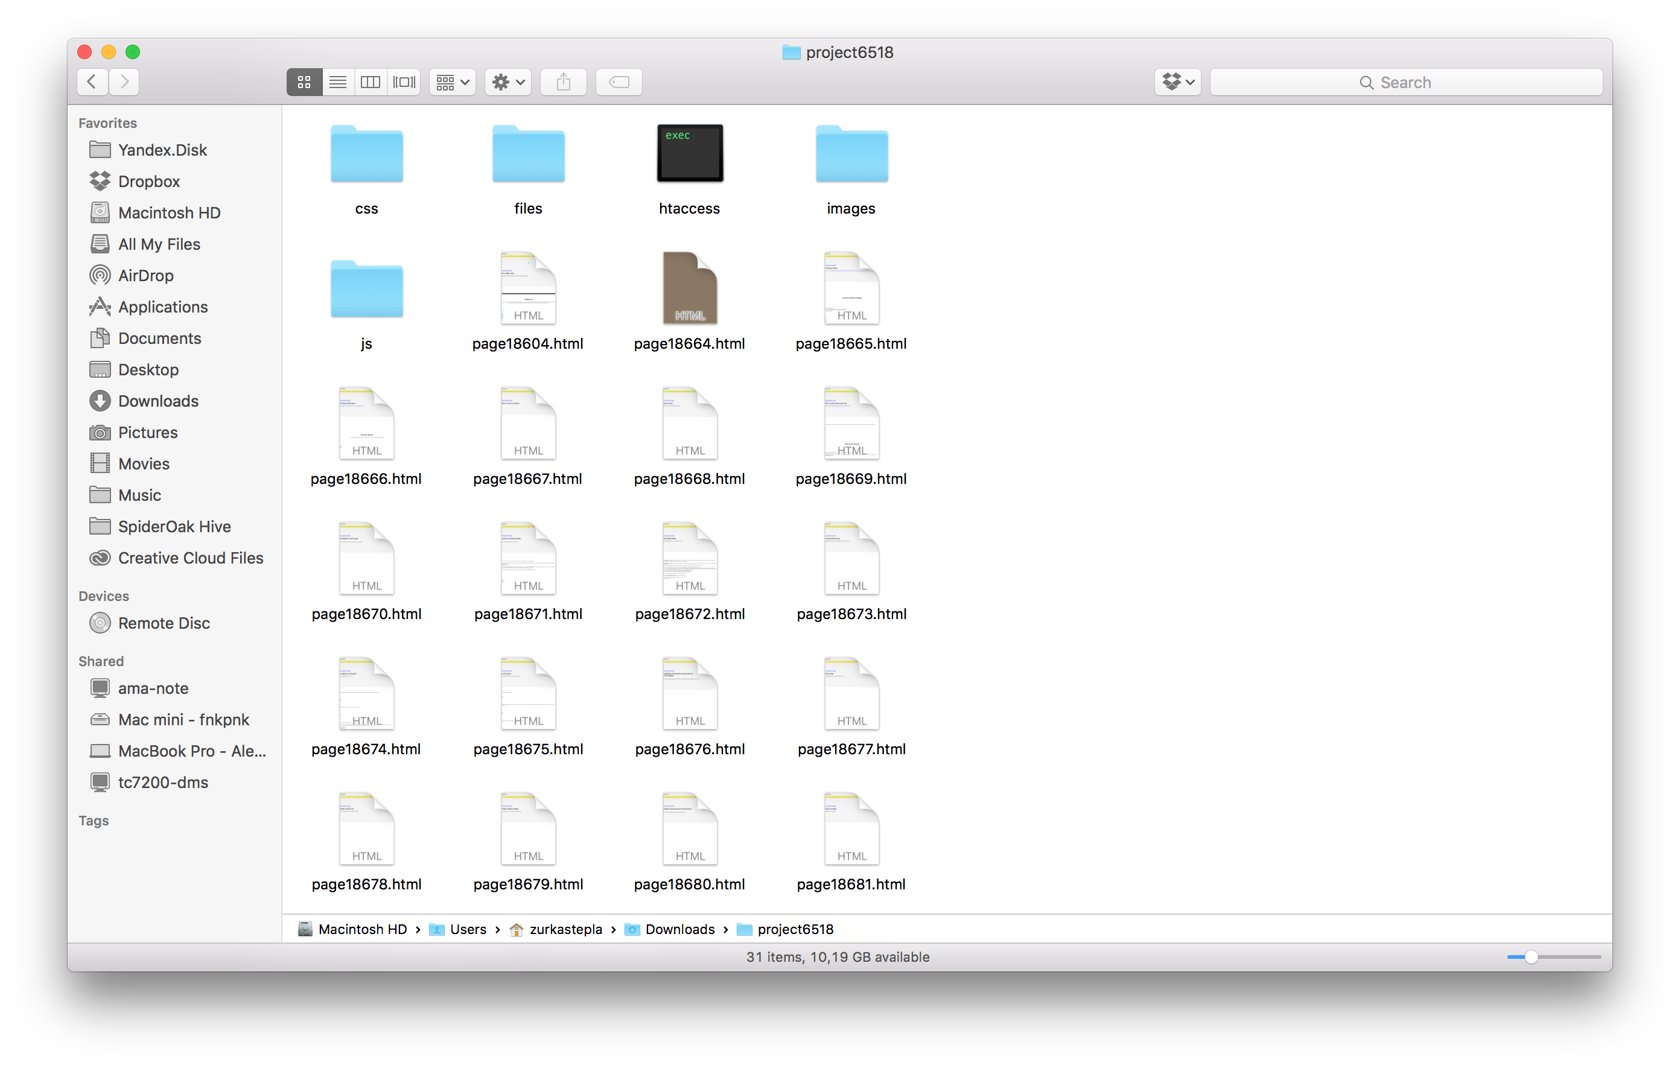
Подключитесь через FTP к вашему серверу, на котором будет размещен сайт и скопируйте на него файлы. Переименуйте файл htaccess в .htaccess (указанный файл работает только под веб-сервером Apache, если у Вас Nginx, то для него нужно писать правила связи самостоятельно и подключать их в настройках Nginx).
Дополнительные возможности: специальные пути для файлов
Вы можете указать свои пути для файлов, если вы используете свой CDN или вам не подходят относительные пути по умолчанию для изображений, css и js файлов.