
Нужна ли БД для Telegram бота? [закрыт]
Закрыт. На этот вопрос невозможно дать объективный ответ. Ответы на него в данный момент не принимаются.
Хотите улучшить этот вопрос? Переформулируйте вопрос так, чтобы на него можно было дать ответ, основанный на фактах и цитатах.
Закрыт 5 лет назад .
Нужно написать Telegram бота с личным кабинетом в котором будет баланс пользователя и специально сгенерированная строка для реферальной ссылки. Можно использовать словарь, где ключем будет ID пользователя Telegram, а значениями его баланс и код для реферальной ссылки. Подойдет ли такое решение или нужно использовать БД, в которой вся эта информация будет храниться? Если нужно использовать БД, то какую вы посоветуете для бота написанного на Python?
Telegram в качестве хранилища данных для IT проектов
Добрый день, сегодня я хотел бы поделится с Вами проблемами и их необычными решениями, которые встретились при написании небольших IT проектов. Сразу скажу, что статья для тех, кто хоть немного разбирается в разработке телеграмм ботов, баз данных, SQL и в языке программировании python.
Весь проект выложен на github, ссылка будет в конце статьи.
Основная проблема
Изначально я хотел для себя написать простенького телеграмм бота счетчика калорий, который получает число от пользователя и возвращает сколько калорий осталось до нормы на день. То есть нужно хранить грубо говоря пару переменных для каждого пользователя.
В итоге нужно было выбрать способ хранить эти данные.
- Вариант — глобальные переменные, оперативная память. Вариант сразу провальный, так как при падении программы мы теряем все
- Вариант — запись в файл на диске. Для такого проекта может и пойдет, но я планировал деплой бота на heroku, который каждый день стирает все данные с диска. Так что этот вариант не подошел
- Вариант — Google-таблицы. Изначально я хотел остановится на этом варианте, но начал разбираться и понял, что есть ограничение на количество запросов к таблице, и чтобы только начать использовать таблицу нужно написать кучу строк кода и разобраться в их не самом простом апи
- Вариант — база данных. Да, это наилучший вариант во всем. Но для такого проекта это даже смешно использовать. Также развертывание и поддержка базы данных на стороннем сервере обойдется в копеечку.
Решение
Идея очень простая, для хранения данных мы будем использовать in memory базу данных sqllite, так как она уже встроена в python 3 и будем делать бэкапы нашей таблицы на сервера Telegram с небольшим интервалом (примерно каждые 30 секунд) и бэкап при закрытие процесса программы.
Если сервер упал, то при первом запросе мы автоматически загрузим нашу таблицу с сервера Telegram и восстановим данные в sqllite.
Можно использовать и любую другую in memory бд, кому как нравится.
Плюсы
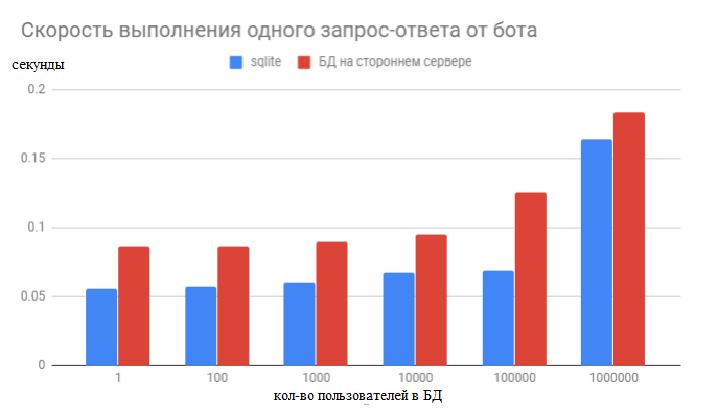
- Быстродействие — за счет работы с данными в оперативной памяти скорость выполнения программы даже быстрее, чем при использовании бд на стороннем сервере (графики скорости выполнения и тестирования будут в конце)
- Бесплатно — не нужно покупать сторонние сервера для баз данных и все данные хранятся в виде бэкапа бесплатно на серверах Telegramа
- Относительно надежно — если сервер падает по непонятным причинам, то мы максимум теряем данные за последние 30 секунд (время интервала бэкапов), для рабочего прототипа или небольшого проекта будет достаточно.
- Минимальные затраты при переходе на обычную бд — нужно заменить данные подключения, убрать код бекапов и перенести данные таблицы из бэкапа на новую бд.
Минусы
- Отсутствие горизонтального масштабирования
- Нужно два аккаунта в Telegramе (один для администратора, другой для тестирования пользователя)
- Сервер не будет работать в России из-за блокировок
- В комментариях я думаю Вы найдете еще десяток других нюансов.
Время говнокодить
Напишем простой кликер и проведем тесты на скорость выполнения.
Бот будет написан на языке программирования python с использованием асинхронной библиотеки взаимодействия с api телеграмма aiogram.
Первым делом нужно заполнить настройки бота, не буду рассказывать как получить токен от BotFather, уже сотни статей есть на эту тему.
Также нам нужен второй аккаунт в телеграмме для админа, в котором будут сохраняться наши бекапы.
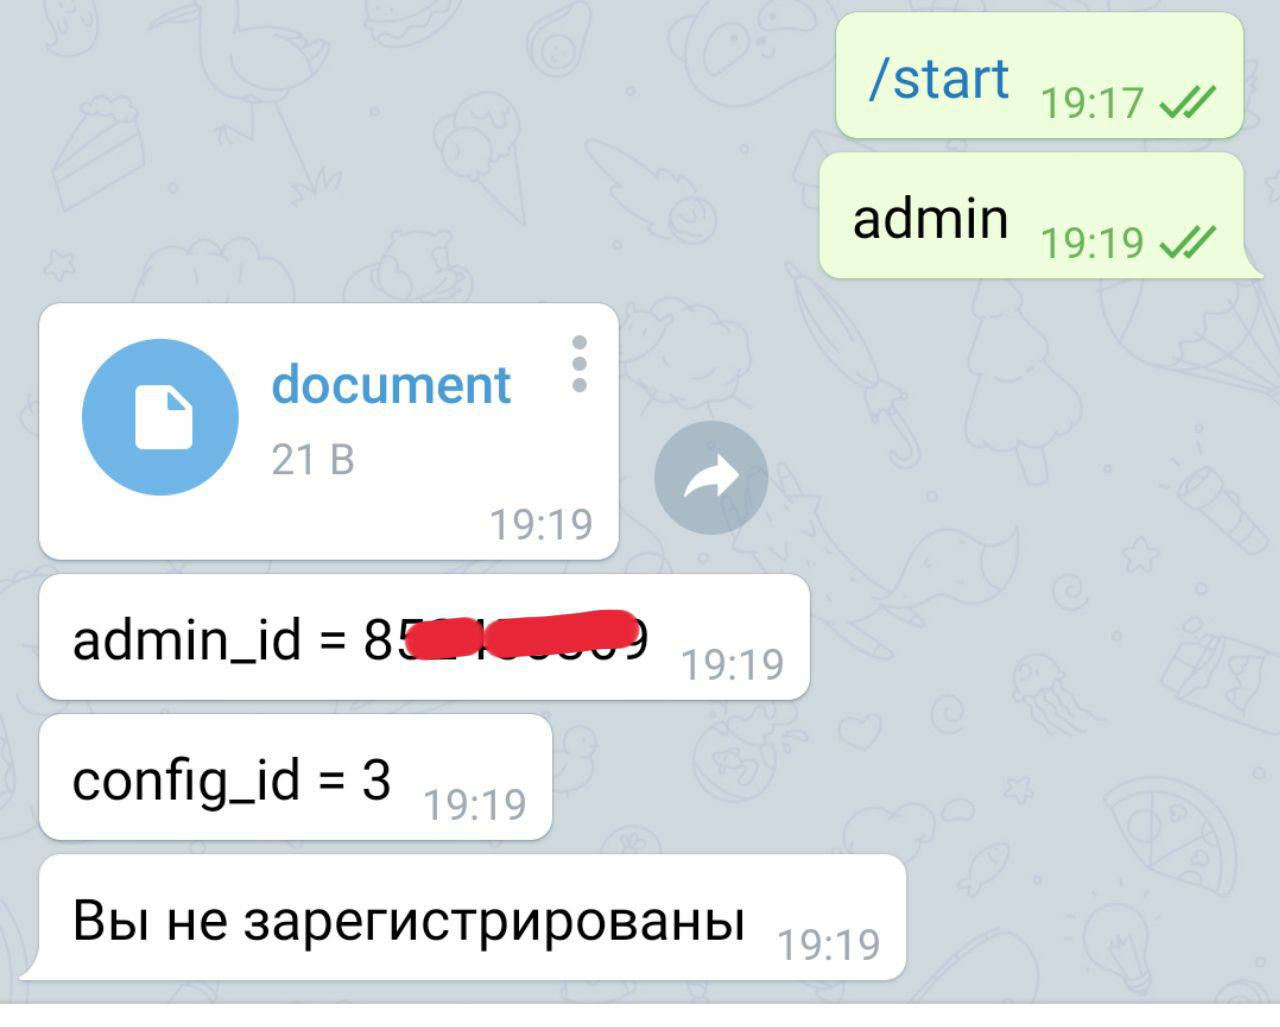
Для того, чтобы получить admin_id и config_id нам нужно запустить бота с аккаунта администратора и написать боту «admin», после чего он создаст первый бекап, и напишет ваш admin_id, config_id. Заменяем и запускаем бота заново.
#--------------------Настройки бота------------------------- # Ваш токен от BotFather TOKEN = '1234567:your_token' # Логирование logging.basicConfig(level=logging.INFO) bot = Bot(token=TOKEN) dp = Dispatcher(bot) # Ваш айди аккаунта администратора и айди сообщения где хранится файл с данными admin_id=12345678 config_id=12345 conn = sqlite3.connect(":memory:") # настройки in memory бд cursor = conn.cursor() Так теперь пройдемся по основной логике бота
Если боту приходит сообщение со словом «admin», то мы создаем таблицу пользователей с такой моделью данных:
- chatid — уникальный чат айди пользователя
- name — имя пользователя
- click — количество кликов
- state — значение для машины состояний, в данном проекте не используется, но в более сложных без него не обойтись
# Логика для администратора if message.text == 'admin': cursor.execute("CREATE TABLE users (chatid INTEGER , name TEXT, click INTEGER, state INTEGER)") cursor.execute("INSERT INTO users VALUES (1234, 'eee', 1,0)") conn.commit() sql = "SELECT * FROM users " cursor.execute(sql) data = cursor.fetchall() str_data = json.dumps(data) await bot.send_document(message.chat.id, io.StringIO(str_data)) await bot.send_message(message.chat.id, 'admin_id = <>'.format(message.chat.id)) await bot.send_message(message.chat.id, 'config_id = <>'.format(message.message_id+1))
Логика для пользователя
Первым делом пытаемся получить из in memory бд данные пользователя, который отправил сообщение. Если ловим ошибку, то загружаем данные с бекапа сервера Telergam, заполняем нашу бд данными с бекапа и повторно пытаемся найти пользователя.
# Логика для пользователя try: sql = "SELECT * FROM users where chatid=<>".format(message.chat.id) cursor.execute(sql) data = cursor.fetchone() # or use fetchone() except Exception: data = await get_data() cursor.execute("CREATE TABLE users (chatid INTEGER , name TEXT, click INTEGER, state INTEGER)") cursor.executemany("INSERT INTO users VALUES (. )", data) conn.commit() sql = "SELECT * FROM users where chatid=<>".format(message.chat.id) cursor.execute(sql) data = cursor.fetchone() # or use fetchone() Если мы нашли пользователя в бд, то обрабатываем кнопки:
- При нажатие «Клик» мы обновляем количество кликов у данного пользователя
- При нажатие «Рейтинг» мы выводим список пятнадцати человек у которых наибольшее количество кликов.
#При нажатии кнопки клик увеличиваем значение click на один и сохраняем if data is not None: if message.text == 'Клик': sql = "UPDATE users SET click = <> WHERE chatid = <>".format(data[2]+1,message.chat.id) cursor.execute(sql) conn.commit() await bot.send_message(message.chat.id, 'Кликов: <> '.format(data[2]+1)) # При нажатии кнопки Рейтинг выводим пользователю топ 10 if message.text == 'Рейтинг': sql = "SELECT * FROM users ORDER BY click DESC LIMIT 15" cursor.execute(sql) newlist = cursor.fetchall() # or use fetchone() sql_count = "SELECT COUNT(chatid) FROM users" cursor.execute(sql_count) count=cursor.fetchone() rating='Всего: <>\n'.format(count[0]) i=1 for user in newlist: rating=rating+str(i)+': '+user[1]+' - '+str(user[2])+'\n' i+=1 await bot.send_message(message.chat.id, rating) else: await bot.send_message(message.chat.id, 'Вы не зарегистрированы')
Напишем логику для регистрации пользователя
Пытаемся найти пользователя в бд, если его нет, то добавляем новую строку в таблицу и делаем бэкап.
Если ловим ошибку, то подгружаем последний бэкап, заполняем таблицу и повторяем попытку регистрации.
sql_select = "SELECT * FROM users where chatid=<>".format(message.chat.id) sql_insert = "INSERT INTO users VALUES (<>, '<>', <>,<>)".format(message.chat.id,message.chat.first_name, 0, 0) try: cursor.execute(sql_select) data = cursor.fetchone() if data is None: cursor.execute(sql_insert) conn.commit() await save_data() except Exception: data = await get_data() cursor.execute("CREATE TABLE users (chatid INTEGER , name TEXT, click INTEGER, state INTEGER)") cursor.executemany("INSERT INTO users VALUES (. )", data) conn.commit() cursor.execute(sql_select) data = cursor.fetchone() if data is None: cursor.execute(sql_insert) conn.commit() await save_data() # Создаем кнопки button = KeyboardButton('Клик') button2 = KeyboardButton('Рейтинг') # Добавляем kb = ReplyKeyboardMarkup(resize_keyboard=True).add(button).add(button2) # Отправляем сообщение с кнопкой await bot.send_message(message.chat.id,'Приветствую <>'.format(message.chat.first_name),reply_markup=kb)Так, ну и самое интересное.
Сохранение и получение данных с сервера Telergam
Мы выгружаем все данные с таблицы пользователей, переводим словарь в строку и изменяем наш файл, который хранится на серверах Telegram.
#--------------------Сохранение данных------------------------- async def save_data(): sql = "SELECT * FROM users " cursor.execute(sql) data = cursor.fetchall() # or use fetchone() try: # Переводим словарь в строку str_data=json.dumps(data) # Обновляем наш файл с данными await bot.edit_message_media(InputMediaDocument(io.StringIO(str_data)), admin_id, config_id) except Exception as ex: print(ex)
Для того, чтобы получить бэкап нам нужно переслать сообщение с файлом от админа к админу. Затем получить путь к файл, считать данные по url и вернуть весь бэкап.
# #--------------------Получение данных------------------------- async def get_data(): # Пересылаем сообщение в данными от админа к админу forward_data = await bot.forward_message(admin_id, admin_id, config_id) # Получаем путь к файлу, который переслали file_data = await bot.get_file(forward_data.document.file_id) # Получаем файл по url file_url_data = bot.get_file_url(file_data.file_path) # Считываем данные с файла json_file= urlopen(file_url_data).read() # Переводим данные из json в словарь и возвращаем return json.loads(json_file)Ну вот почти и все, осталось только написать таймер, чтобы делал бэкапы и протестировать бота.
Создаем поток, который каждые 30 секунд выполняет наш метод save_data()
def timer_start(): threading.Timer(30.0, timer_start).start() try: asyncio.run_coroutine_threadsafe(save_data(),bot.loop) except Exception as exc: passНу и в главной программе мы запускаем таймер и самого бота.
#--------------------Запуск бота------------------------- if __name__ == '__main__': timer_start() executor.start_polling(dp, skip_updates=True)Так с кодом вроде бы разобрались, вот ссылка рабочего проекта на github.
Как запустить
- Скачиваем проект с гитхаба. Запускаем проект в любой среде разработки для python (Например: PyCharm).
- Среда разработки автоматически подгрузит необходимые библиотеки с файла requirements.
- Заменяем Token от BotFather в файле main.py
Тестирование и графики
Тесты проводились на серверах heroku с минимальными характеристиками инстансов. Так, что можно считать, что все тесты были выполнены в более менее равных условиях.
Графики сделаны по выборкам из ~100 запрос-ответов. И представлены средние показатели выборки.
В качестве базы данных на стороннем сервере использовался PostgreSQL на Amazon RDS с минимальными характеристиками.
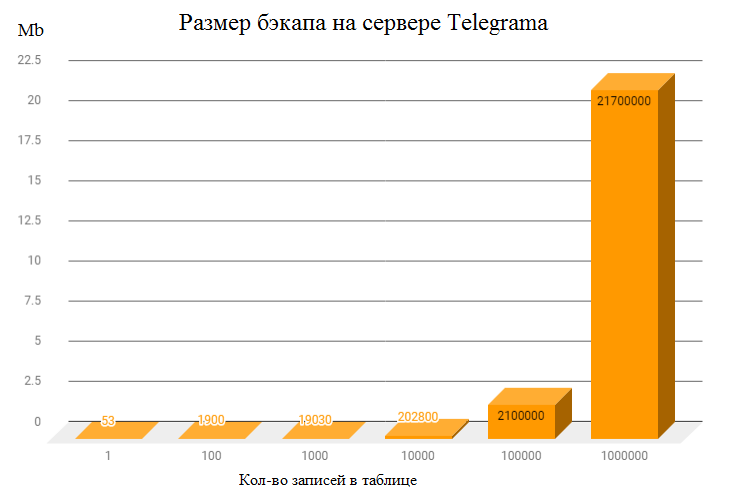
При одном миллионе пользователей время бэкапов становится проблемой.
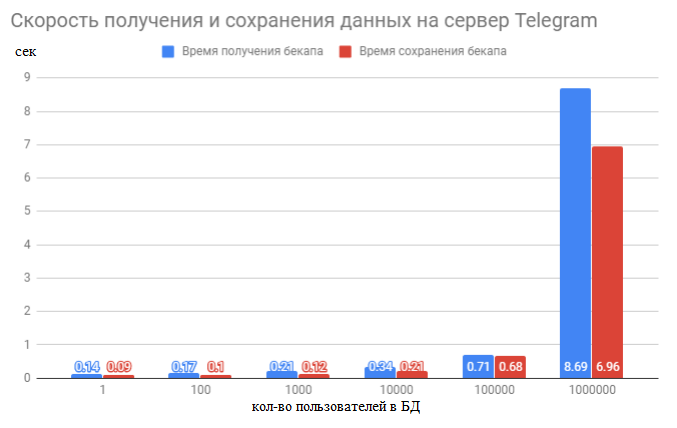
Размер бэкапа полностью зависит от вашей модели данных, в моем случае при одном миллионе пользователей получился файл с данными на 21 мегабайт.
Вывод
Данный метод хранения данных имеет смысл для проектов до миллиона пользователей. То есть для прототипа или личного стартапа данный способ имеет право на жизнь.
В итоге мы получили полностью автономного кликера, независящий от удаленных баз данных.
Вот выше описанный проект, развернутый на heroku: @Clicker_fast_bot
Так же я реализовал более сложный проект с данной идеологией: @Random_friend_bot
Подобие чатвдвоем и чатрулет, но только в телеграмме.
Он ищет в радиусе 100 км человека противоположного пола для общения и реализует закрытый чат с новым собеседником.
Если будет интересно могу скинуть исходный код проекта. Так же если данная тема будет актуальна, то в следующей статье могу описать создание Rest api без внешних БД. То есть такой стек django-sqllite-Telegram.
Буду рад любой критике, спасибо за внимание!
Какой объем базы данных telegram
Утечка данных «Глаз Бога»: что случилось, кому это нужно и что происходит с персональными данными россиян?
В сети оказалась база данных, содержащая информацию о нескольких сотнях тысяч пользователей Telegram-бота «Глаз Бога» – сервиса, позволяющий получить личные данные россиян, среди которых, естественно, были и персональные данные, охраняемые законом. База данных, «утёкшая» в сеть, содержит телефоны, ники и имена пользователей, которые когда-либо пользовались данным ботом. Всего файл насчитывает 774 тысячи записей, при этом, очевидно, это не полный список. В распространяемом документе можно найти контакты 27 Бочаровых, 55 человек указаны с фамилией Путин, еще 31 человек записаны как Кадыров. При этом, в телеграм-каналах, специализирующихся на утечках информации, пытаются опровергнуть данный факт. Пользователям рассказывают о том, что это – никакая не база клиентов «Глаза Бога».

«Эта база собрана парсингом из Telegram по тем пользователям, у которых в настройках не скрыт номер телефона. Как утверждает источник, распространивший базу, она была собрана через открытый (на момент сбора) API «Глаза Бога». Другими словами, сначала «Глаз Бога» собрал эти данные из Telegram, а затем кто-то собрал их из «Глаза Бога»
«Глаз Бога» – телеграм-бот, который при оформлении платной подписки позволял любому желающему получить данные практически о любом человеке. В частности, можно было получить как условно свободную информацию в виде архива объявлений на Avito, данные об аккаунтах в соцсетях, так и весьма специфические данные. Так, в несколько шагов пользователи могли получить доступ к паспортным данным россиян, адресах регистрации, данные о движимом и недвижимом имуществе.
1 июля 2021 года Таганский суд Москвы признал работу телеграм-бота незаконной. «Решением Таганского районного суда деятельность интернет-ресурса признана незаконной и нарушающей права граждан на неприкосновенность частной жизни, личную и семейную тайну», — отмечалось в пресс-релизе столичного суда. При этом, проблемы у владельца телеграм-бота Евгения Антипова начались еще раньше. Так, 12 марта администрация мессенджера удалила сам бот. Также в марте по требованию Роскомнадзора бот внес изменения в формат работы. В частности, проект начал выступать от другого юридического лица и ограничил доступ к персональным данным для неограниченного круга лиц. Однако данная мера не возымела должного эффекта, поскольку в кратчайшие сроки сервис был перезапущен под другим аккаунтом. В апреле по месту жительства создателя бота прошли обыски. Стоит отметить, что и в настоящий момент можно воспользоваться сервисом, но сначала нужно приложить немало усилий, чтобы разыскать актуальный никнейм бота.
Черный рынок персональных данных

Торговля персональными данными россиян – явление абсолютно не новое. Базы данных в том или ином виде оказывались доступны «неограниченному кругу лиц» практически одновременно с началом цифровизации. Как это не парадоксально, самыми распространенными базами, «свободно гуляющими по стране», были базы МВД. В них содержались паспортные данные, сведения о совершенных правонарушениях, телефонах, адресах. В общем, вся полнота картины по нужному лицу. Потребителями данного специфического продукта в основном являлись сотрудники служб безопасности коммерческих структур. Для них, к слову, не составляло особого труда работать с подобного рода базами, поскольку большинство из них пришло работать «безопасниками» как раз из силовых структур. Позднее доступ к таким «сервисам» начали получать частные детективы, журналисты, в общем, все, кто хоть как-то вынужден работать с информацией. Подобные базы спокойно распространялись на радиорынках крупных городов, затем на форумах в интернете. В особых, так скажем, деликатных случаях, базу данных на компакт-дисках, а позднее на флеш-накопителях действующие сотрудники МВД выносили адресно. Аналогичным образом распространялись базы приставов, налоговой, Пенсионного фонда и прочих структур. Отличительной особенностью каждого подобного «продукта» было неудобство в использовании. Цифровизация и унификация данных стала появляться в государственных органах с появлением сервиса «Госуслуги». До этого времени каждое ведомство собирало и теряло данные в собственных разрозненных программных продуктах. Самых больших успехов в обработке, глубоком анализе и защите данных добилась налоговая под руководством Мишустина. Похищенные данные попадали на рынок в разных форматах. В идеале это были файлы баз данных, украденные сотрудниками, имеющими доступ к серверу. В другом случае сотрудники, имеющие пользовательский доступ, делали массовые выгрузки в текстовый формат или exсel. При этом в исходниках содержалось огромное количество лишней и ненужной информации, подобная «зашлакованность» очень мешала в работе. Программисты, собирающие базы данных для продажи, имели слабое представление о потребности 99% пользователей. Зато прекрасно понимали, как продавать данные и как «безопаснику» объяснить руководителю необходимость затрат. Базы оценивались количеством самих баз и объектов в них. Попытки объединить несколько баз в одну и сделать удобную форму выдачи ответа не приносили коммерческого успеха. Как правило, покупатели были регулярные, постоянно платили за обновления, продавать ежеквартально 1 красивую базу вместо 20 «кривых» было не выгодно. С радостью «левые» базы покупали и сами правоохранители. Запрос информации через ответственных сотрудников мог привести к утечке предмета запроса и занимал много времени. Не очень продвинутые сотрудники пользовались услугами бывших коллег, сотрудников СБ и ЧОПов. И никого из правоохранителей, откровенно говоря, не интересовало то, что они пользуются украденными данными, несмотря на то что они прекрасно знали и понимали происхождение данной информации. Интересно, что при всех государственных миллиардных затратах на базы данных, общий объем оптимизированных сведений обо всех россиянах составляет всего пару терабайт. Первые отголоски хоть какой-то защиты персональных данных начали появляться в 2016 году, одновременно с тем, когда в России принимался пакет так называемых «законов Яровой». Напомним, согласно законодательным инициативам, операторов связи обязали хранить звонки и сообщения абонентов за период, определяемый Правительством Российской Федерации, но не более, чем за 6 месяцев. При этом, долгие годы естественным путём развивались цифровые сервисы, которым граждане сами несли свои персональные данные: сайты объявлений, сайты по поиску работы, социальные сети, в конце концов. Последние, к слову, представляют немалый интерес не только у журналистов, безопасников и иже с ними, но и у злоумышленников. Появление такой платформы, как Telegram, с возможностью создания ботов, действующих якобы анонимно, стало настоящим подарком как для покупателей, так и для продавцов подобного контента. Если допустить, что в Сеть действительно утекли данные пользователей бота «Глаз Бога», которые, напомним, содержат минимум 774 тысячи записей, можно предположить, что при платеже за доступ к данному сервису для пользователя в размере 2500 рублей и при условии оформления подписки как минимум половиной пользователей, можно говорить о выручке основателей сервиса в размере 1 миллиарда рублей. Программисты получили явный финансовый стимул развивать качественную обработку и удобную выдачу информации. Старый товар в виде баз данных для ограниченного круга специалистов получил новый рынок. Клиентами стали далекие от компьютеров домохозяйки, пробивающие телефоны из записной книжки мужа, любопытные студенты, возмущенные соседи. Все они легко смогли найти телефон негодяя, припарковавшего машину на газоне. Мало того, профессиональные пользователи баз данных тоже начали пользоваться различными анонимными ботами, с которыми не надо тратить время на составление справки из «мусорных данных». Изначально бот «Глаз Бога» предоставлял исключительно сервис по поиску аккаунта в соцсетях по фотографии. Однако в скором времени бот начал накачиваться различными базами данных, среди которых были данные МВД, ФНС, данные коммерческих площадок и прочие. Помимо «Глаза Бога» в последние годы в Telegram развивались такие боты для «пробива», как AVInfo, Smart Search Bot, «Архангел», Mail Search Bot и How To Find Bot. Несмотря на то что все сервисы предлагают своим пользователям схожие данные, претензии именно к «Глазу Бога» возникли в первую очередь из-за чрезмерной пиар-активности. Бот рекламировали блогеры, ряд сервисов так называемого даркнета. И в середине 2020 года, когда бот стремительно набирал пользователей, Антипов неоднократно высказывался о том, что его сервис уникальный, поскольку предоставляет исчерпывающее количество данных, которых нет ни у кого. Однако спусковым крючком по блокировке «Глаза Бога» и его аналогов стало, как ни странно, расследование Алексея Навального в отношении так называемых его отравителей. В своем видеоролике блогер привел данные якобы действующих сотрудников ФСБ, среди которых были данные о перелетах, образовании, местах работы, «паспортные» фотографии. При этом большую часть данных они получали явно не в ботах, а через конкретные запросы к актуальным данным различных ведомств. Кстати, данный сервис помог журналистам «СоцИнформБюро» подготовить расследование «Воронок для губернатора. Подлинная история 7-летия у власти Андрея Бочарова». Между тем, утечку данных пользователей бота можно отнести к безусловной победе Роскомнадзора, это можно трактовать как своего рода сигнал всем интересантам о том, что в распоряжении контролирующих структур могут легко оказаться данные не только о тех, кто пользовался услугами бота, но и о том, что и когда они запрашивали.
Как мы тестировали несколько баз данных временных рядов
Может показаться, что в 2019-м году статья про то, какую TSDB стоит использовать, будет состоять лишь из одного предложения: «просто используйте ClickHouse». Но… есть нюансы.
За последние несколько лет базы данных временных рядов (Time-series databases) превратились из диковинной штуки (узкоспециализированно применяющейся либо в открытых системах мониторинга (и привязанной к конкретным решениям), либо в Big Data проектах) в «товар народного потребления». На территории РФ отдельное спасибо за это надо сказать Яндексу и ClickHouse’у. До этого момента, если вам было необходимо сохранить большое количество time-series данных, приходилось либо смириться с необходимостью поднять монструозный Hadoop-стэк и сопровождать его, либо общаться с протоколами, индивидуальными для каждый системы.
Может показаться, что в 2019-м году статья про то, какую TSDB стоит использовать, будет состоять лишь из одного предложения: «просто используйте ClickHouse». Но… есть нюансы.
Действительно, ClickHouse активно развивается, пользовательская база растет, а поддержка ведется очень активно, но не стали ли мы заложниками публичной успешности ClickHouse’а, которая затмила другие, возможно, более эффективные/надежные решения?
В начале прошлого года мы занялись переработкой нашей собственной системы мониторинга, в процессе которой встал вопрос о выборе подходящей базы для хранения данных. Об истории этого выбора я и хочу здесь рассказать.
Прежде всего — необходимое предисловие. Зачем нам вообще собственная система мониторинга и как она была устроена?
Мы начали оказывать услуги поддержки в 2008 году, и к 2010-му стало понятно, что агрегировать данные о происходящих в клиентской инфраструктуре процессах решениями, существовавшими на тот момент, стало сложно (мы говорим о, прости господи, Cacti, Zabbix-е и зарождающемся Graphite).
Основными нашими требованиями были:
- сопровождение (на тот момент — десятков, а в перспективе — сотен) клиентов в пределах одной системы и при этом наличие централизованной системы управления оповещениями;
- гибкость в управлении системой оповещений (эскалация оповещений между дежурными, учет расписания, база знаний);
- возможность глубокой детализации графиков (Zabbix на тот момент отрисовывал графики в виде картинок);
- длительное хранение большого количества данных (год и более) и возможность их быстрой выборки.
В данной статье нас интересует последний пункт.
Говоря о хранилище, требования были следующие:
- система должна быстро работать;
- желательно, чтобы система имела SQL-интерфейс;
- система должна быть стабильной и иметь активную пользовательскую базу и поддержку (когда-то мы столкнулись с необходимостью поддерживать такие системы, как например MemcacheDB, которую перестали развивать, или распределенное хранилище MooseFS, багтрекер которого велся на китайском языке: повторения этой истории для своего проекта нам не хотелось);
- соответствие CAP-теореме: Consitency (необходимо) — данные должны быть актуальными, мы не хотим, чтобы система управления оповещениями не получила новых данных и плюнулась алертами о неприходе данных по всем проектам; Partition Tolerance (необходимо) — мы не хотим получить Split Brain системы; Availability (не критично, в случае существования активной реплики) — можем сами переключиться на резервную систему в случае аварии, кодом.
Как ни странно, на тот момент идеальным решением для нас оказался MySQL. Наша структура данных была предельно проста: id сервера, id счетчика, timestamp и значение; быстрая выборка горячих данных обеспечивалась большим размером buffer pool, а выборка исторических данных — SSD.
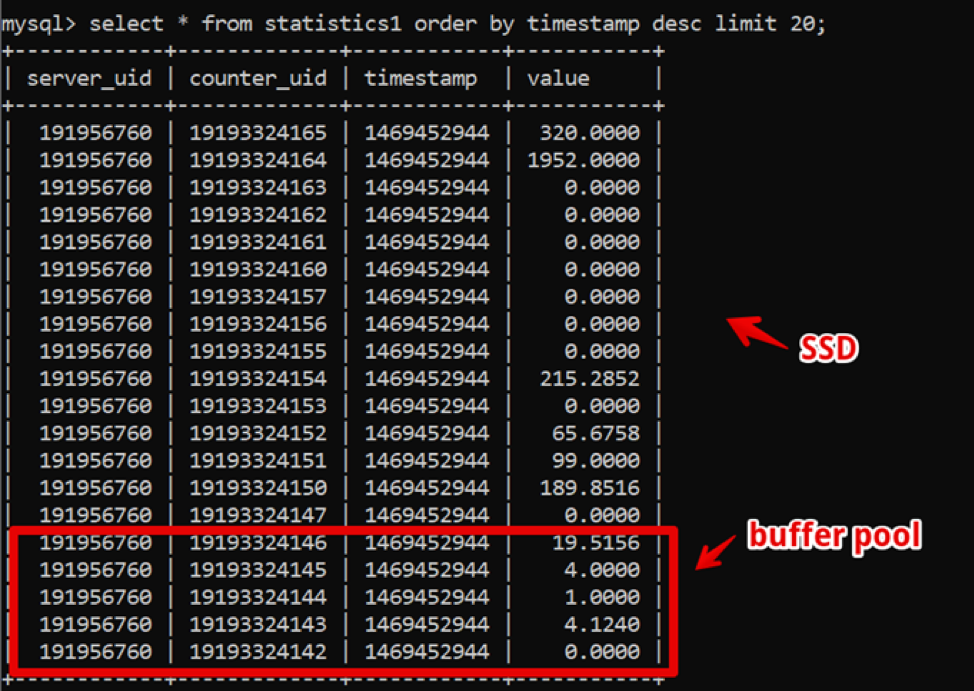
Таким образом, мы добились выборки свежих двухнедельных данных, с детализацией до секунды за 200 мс до момента полной отрисовки данных, и жили в этой системе довольно долго.
Между тем, время шло и количество данных росло. К 2016-му году объемы данных достигали десятков терабайт, что в условиях арендуемых SSD-хранилищ было существенным расходом.
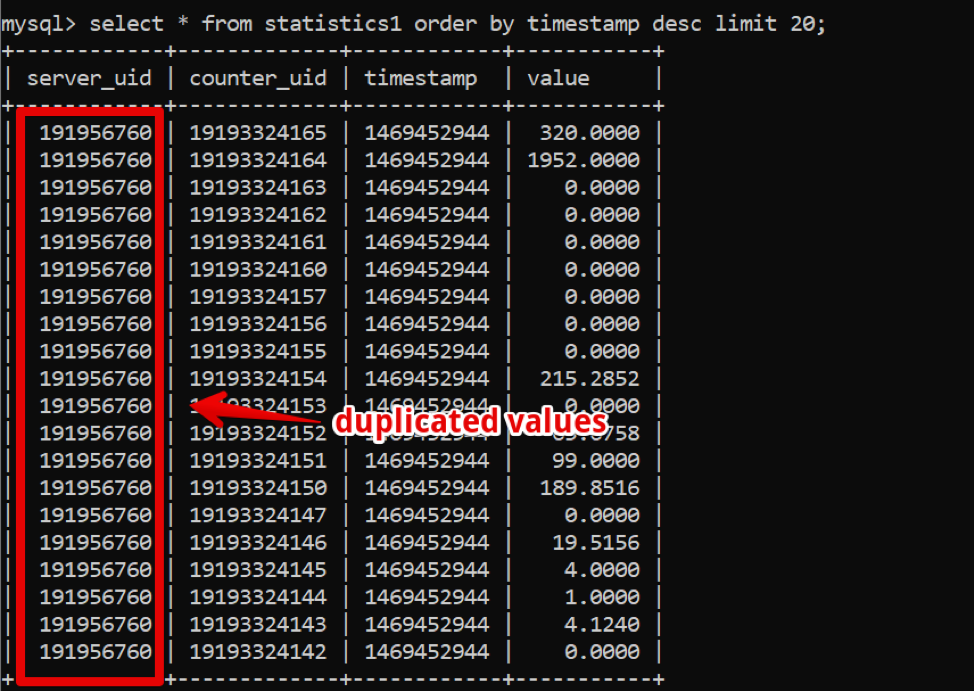
К этому моменту активное распространение получили колоночные базы данных, о которых мы стали активно думать: в колоночных БД данные хранятся, как это можно понять, колонками, и если посмотреть на наши данные, то легко увидеть большое количество дублей, которые можно было бы, в случае использовании колоночной БД, сжать компрессией.
Однако ключевая для работы компании система продолжала работать стабильно, и экспериментировать с переходом на что-то другое не хотелось.
В 2017-м году на конференции Percona Live в Сан-Хосе, наверное, впервые о себе заявили разработчики Clickhouse. На первый взгляд, система была production-ready (ну, Яндекс.Метрика — это суровый продакшн), поддержка была быстрой и простой, и, главное, эксплуатация была простой. С 2018-го года мы затеяли процесс перехода. Но к тому времени «взрослых» и проверенных временем систем TSDB стало много, и мы решили выделить значительное время и сравнить альтернативы, для того чтобы убедиться, что альтернативных Clickhouse-у решений, согласно нашим требованиям, нет.
В дополнении к уже указанным требованиям к хранилищу появились свежие:
- новая система должна обеспечивать, как минимум, такую же производительность, что и MySQL, на том же самом количестве железа;
- хранилище новой системы должно занимать значительно меньше места;
- СУБД по-прежнему должна быть проста в управлении;
- хотелось минимально менять приложение при смене СУБД.
Какие системы мы стали рассматривать
Apache Hive/Apache Impala
Старый проверенный боями Hadoop-стэк. По сути, это SQL-интерфейс, построенный поверх хранения данных в собственных форматах на HDFS.
- При стабильной эксплуатации очень просто масштабировать данные.
- Есть колоночные решения по хранению данных (меньше места).
- Очень быстрое выполнение распаралелленых задач при наличии ресурсов.
- Это Hadoop, и он сложен в эксплуатации. Если мы не готовы брать готовое решение в облаке (а мы не готовы по стоимости), весь стэк придется собирать и поддерживать руками админов, а этого очень не хочется.
- Данные агрегируются действительно быстро.
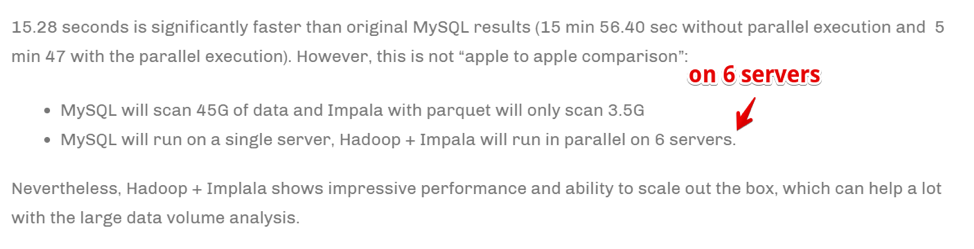
Скорость достигается масштабированием числа вычислительных серверов. Проще говоря, если мы большая компания, занимаемся аналитикой и бизнесу критически важно максимально быстро агрегировать информацию (пусть даже ценой использования большого количества вычислительных ресурсов), — это может быть нашим выбором. Но мы не были готовы кратно увеличивать парк железа для скорости выполнения задач.
Druid/Pinot
Если в нескольких словах: Druid/Pinot выглядят лучше Clickhouse’а в случаях, когда:
- У вас гетерогенный характер данных (в нашем случае мы записываем только таймсерии серверных метрик, и, по сути, это одна таблица. Но могут быть и другие кейсы: временные ряды оборудования, экономические временные ряды и т.д. — каждый со своей структурой, которые надо агрегировать и обрабатывать).
- При этом этих данных очень много.
- Таблицы и данные с временными рядами появляются и пропадают (то есть какой-то набор данных пришел, его проанализировали и удалили).
- Нет четкого критерия, по которому данные могут быть партиционированы.
В противоположных случаях лучше себя показывает ClickHouse, а это наш случай.
ClickHouse
- SQL-like.
- Прост в управлении.
- Люди говорят, что он работает.
Попадает в шорт-лист тестирования.
InfluxDB
Зарубежная альтернатива ClickHouse’у. Из минусов: High Availability присутствует только в коммерческой версии, но надо сравнить.
Попадает в шорт-лист тестирования.
Cassandra
С одной стороны, мы знаем, что ее используют для хранения метрических таймсерий такие системы мониторинга, как, например, SignalFX или OkMeter. Однако есть специфика.
Cassandra не является колоночной базой данных в привычном ее понимании. Выглядит она больше как строчная, но в каждой строке может быть разное количество столбцов, за счет чего легко организовать колоночное представление. В этом смысле понятно, что при ограничении в 2 миллиарда столбцов можно хранить какие-то данные именно в столбцах (да те же временные ряды). Например, в MySQL стоит ограничение на 4096 столбцов и там легко наткнуться на ошибку с кодом 1117, если попытаться сделать тоже самое.
Движок Cassandra ориентирован на хранение больших объемов данных в распределенной системе без мастера, и в вышеупомянутой CAP-теореме Cassandra больше про AP, то есть про доступность данных и устойчивость к разделению партиций. Таким образом, этот инструмент может замечательно подойти, если нужно только писать в эту базу и достаточно редко из нее читать. И тут логично использовать Cassandra в качестве “холодного” хранилища. То есть в качестве долговременного надежного места хранения больших массивов исторических данных, которые редко требуются, но при необходимости их можно достать. Тем не менее, ради полноты картины, протестируем и ее. Но, как я ранее говорил, нет желания активно переписывать код под выбранное БД-решение, поэтому тестировать мы её будем несколько ограничено — без адаптации структуры базы под специфику Cassandra.
Prometheus
Ну, и уже из интереса мы решили протестировать производительность стораджа Prometheus — просто для того, чтобы понять, быстрее мы текущих решений или медленнее и насколько.
Методика и результаты тестирования
Итак, мы протестировали 5 баз данных в следующих 6 конфигурациях: ClickHouse (1 нода), ClickHouse (распределенная таблица на 3 ноды), InfluxDB, Mysql 8, Cassandra (3 ноды) и Prometheus. План тестирования такой:
- заливаем исторические данные за неделю (840 млн значений в сутки; 208 тысяч метрик);
- генерируем нагрузку на запись (рассматривали 6 режимов нагрузки, см. ниже);
- параллельно с записью периодически делаем выборки, эмулируя запросы пользователя, работающего с графиками. Чтобы не слишком усложнять, выбирали данные по 10 метрикам (как раз столько их на графике CPU) за неделю.
Нагружаем, эмулируя поведение агента нашего мониторинга, который отправляет в каждую метрику значения раз в 15 секунд. При этом нам интересно варьировать:
- общее количество метрик, в которые пишутся данные;
- интервал отправки значений в одну метрику;
- размер батча.
Про размер батча. Поскольку почти все наши подопытные базы не рекомендуется нагружать единичными инсертами, нам нужен будет релей, который собирает приходящие метрики и группирует их по сколько-нибудь и пишет в базу пакетным инсертом.
Также, чтобы лучше понимать, как потом интерпретировать полученные данные, представим, что мы не просто шлём кучу метрик, а метрики организованы в серверы — по 125 метрик на сервер. Тут сервер просто виртуальная сущность — просто чтобы понимать, что, например, 10000 метрик соответствуют примерно 80 серверам.
И вот, с учетом этого всего, наши 6 режимов нагрузки базы на запись:
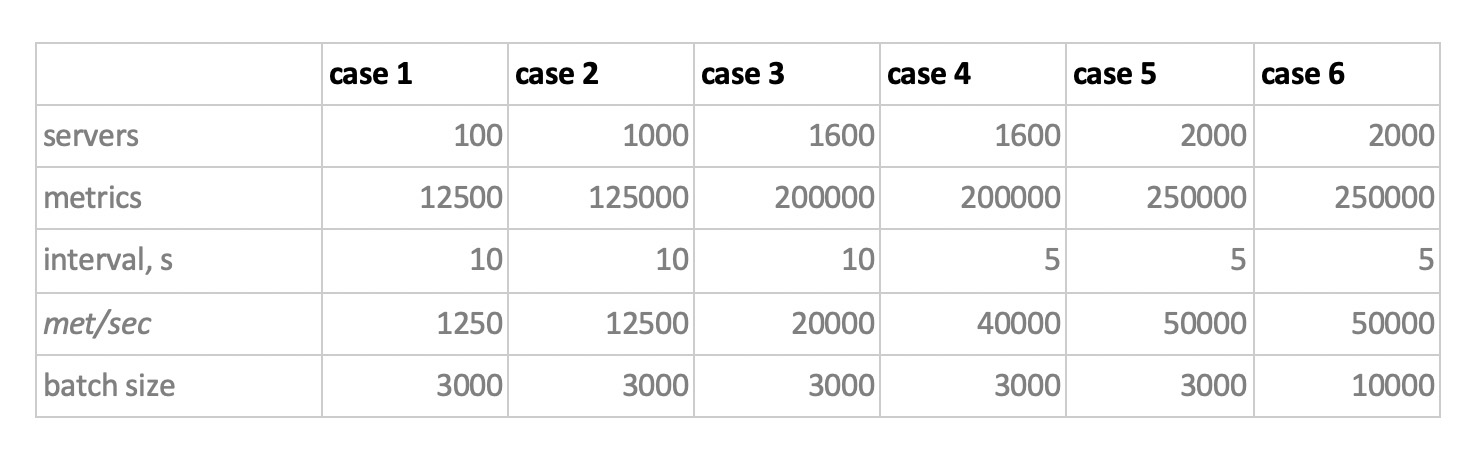
Тут есть два момента. Во-первых, для кассандры такие размеры батчей оказались слишком большими, там мы использовали значения 50 или 100. А во-вторых, поскольку прометеус работает строго в режиме pull, т.е. сам ходит и забирает данные с источников метрик (и даже pushgateway, несмотря на название, в корне ситуацию не меняет), соответствующие нагрузки были реализованы с помощью комбинации static configs.
Результаты тестирования такие:
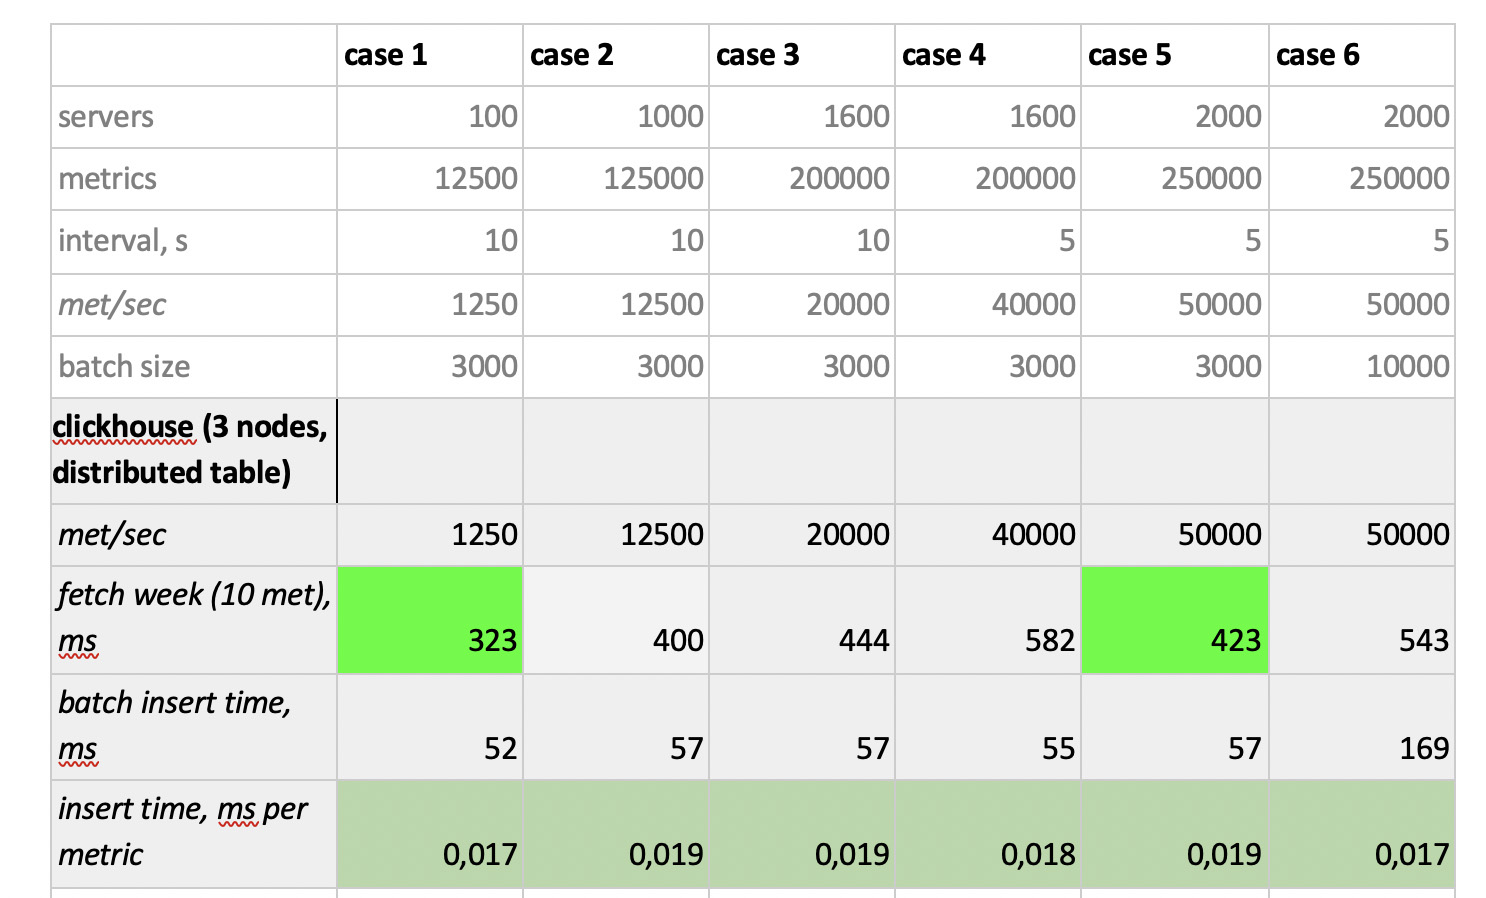
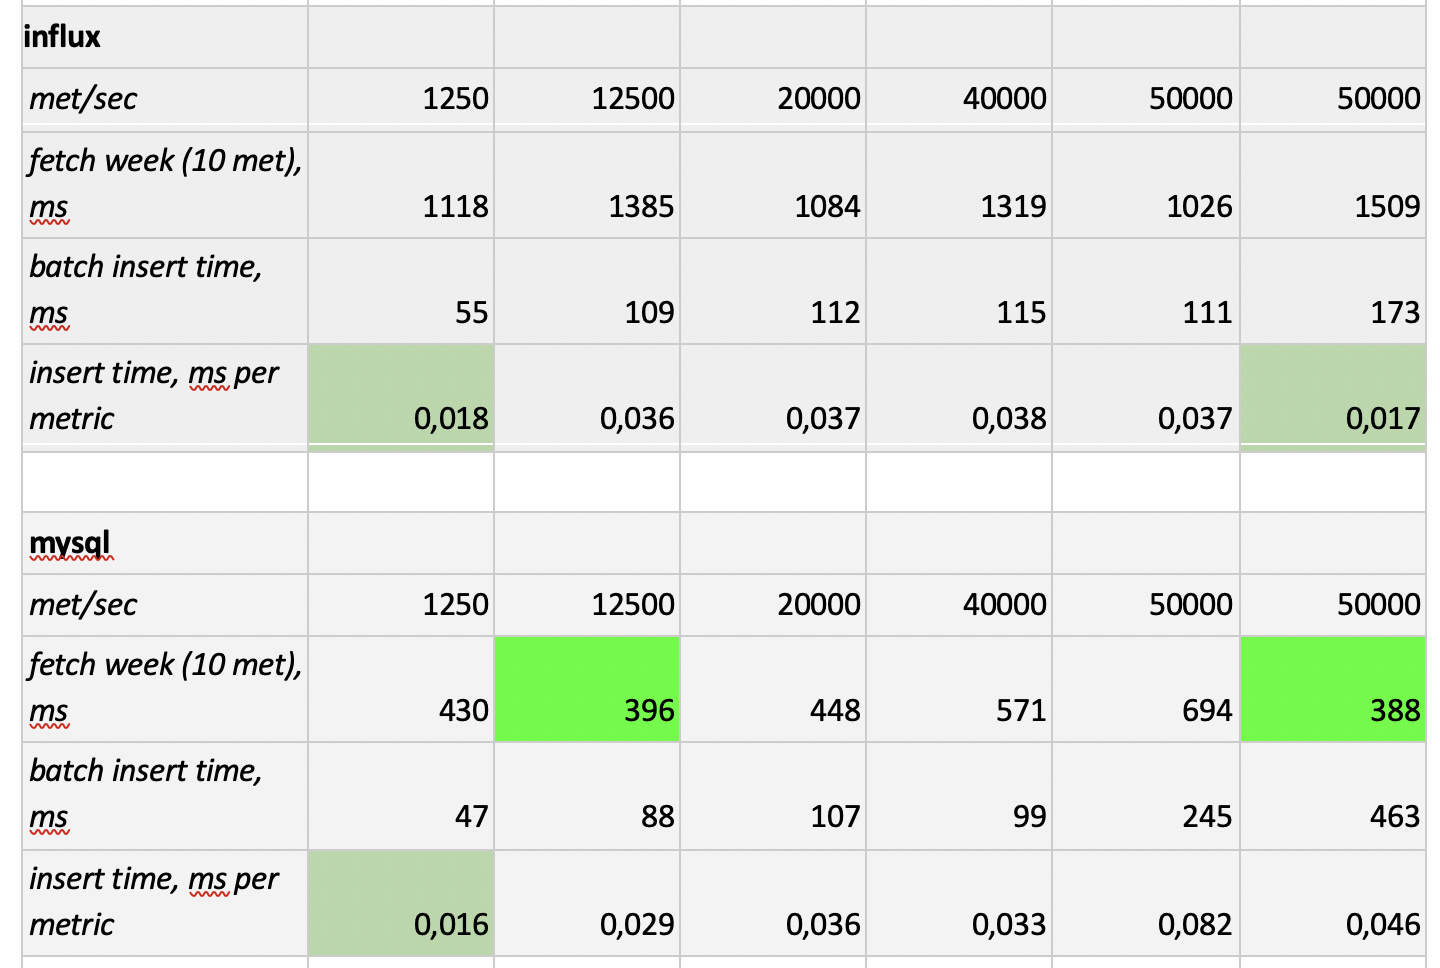
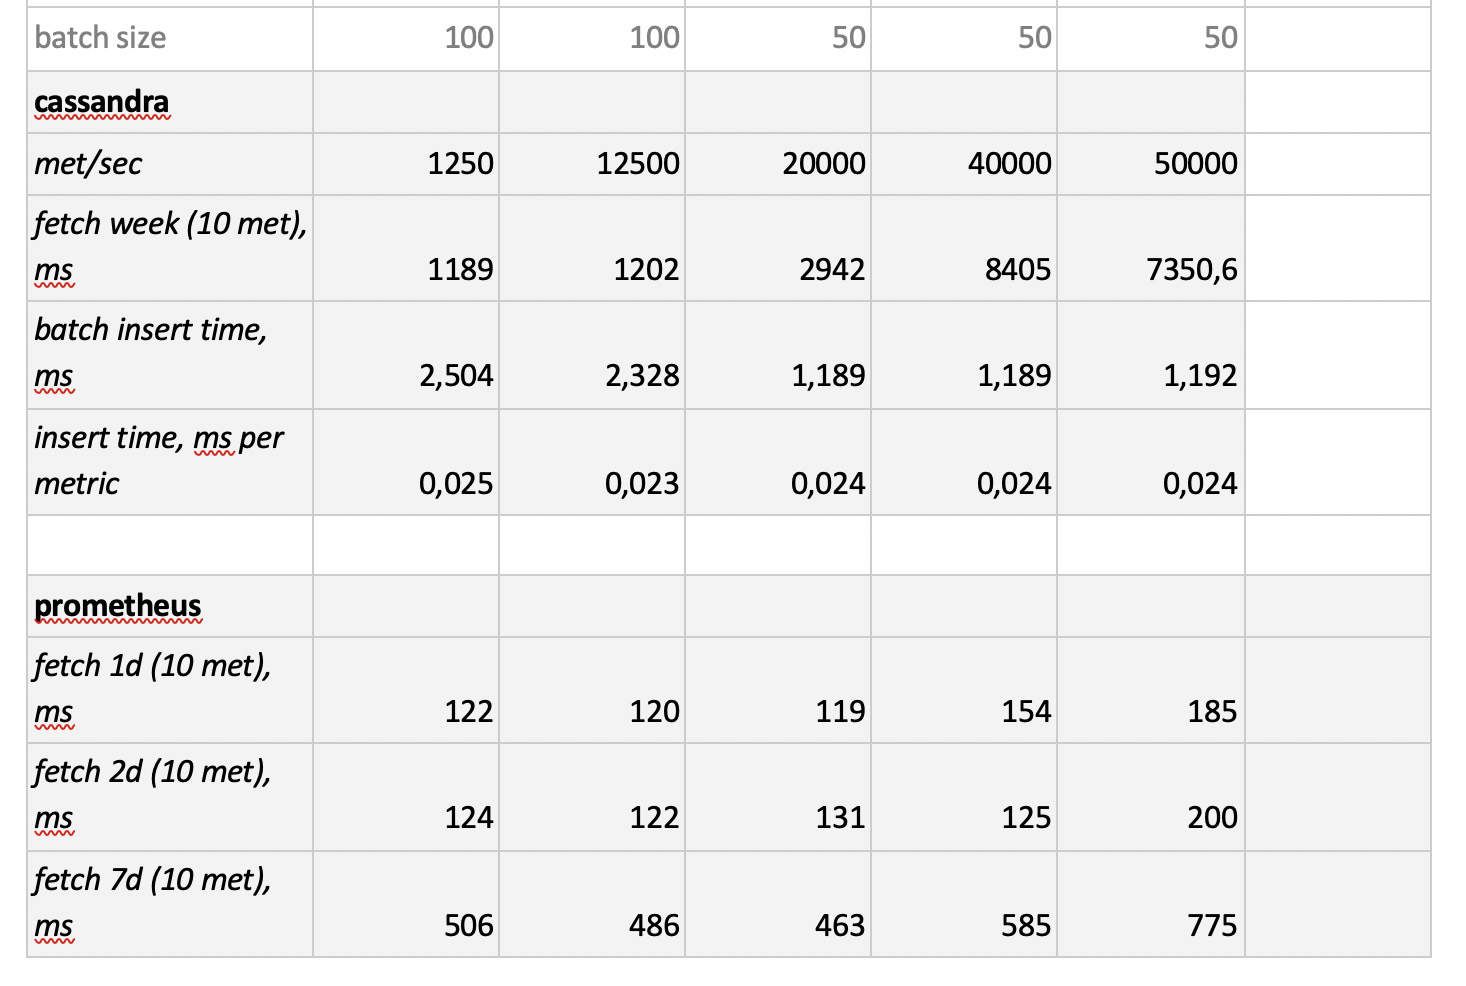
Что стоит отметить: фантастически быстрые выборки из Prometheus’a, ужасающе медленные выборки из Cassandra, неприемлемо медленные выборки из InfluxDB; по скорости записи всех победил ClickHouse, а Prometheus в конкурсе не участвует, потому что он делает инсерты сам внутри себя и мы ничего не замеряем.
В итоге: лучше всех себя показали ClickHouse и InfluxDB, но кластер из Influx’а можно построить только на основе Enterprise-версии, которая стоит денег, а ClickHouse ничего не стоит и сделан в России. Логично, что в США выбор, пожалуй, в пользу inInfluxDB, а у нас — в пользу ClickHouse’а.