
Просмотр определения таблицы
Свойства таблицы в SQL Server можно отобразить с помощью SQL Server Management Studio или Transact-SQL.
Разрешения
Просматривать свойства таблицы может только владелец таблицы или лицо, получившее разрешения на таблицу.
Использование среды SQL Server Management Studio
Отображение свойств таблицы в окне «Свойства»
- В обозревателе объектов выберите таблицу, для которой необходимо просмотреть свойства.
- Щелкните таблицу правой кнопкой мыши и выберите в контекстном меню пункт Свойства . Дополнительные сведения см. в разделе Свойства таблицы — SSMS.
Создание скрипта CREATE TABLE для существующей таблицы
Вы можете создать скрипты для существующих объектов из обозреватель объектов в SSMS. Дополнительные сведения см. в разделе Создание скриптов.
Использование Transact-SQL
Отображение свойств таблицы
- В обозревателе объектовподключитесь к экземпляру компонента Компонент Database Engine.
- На стандартной панели выберите пункт Создать запрос.
- Скопируйте приведенный ниже пример в окно запроса и нажмите кнопку Выполнить. В этом примере выполняется системная хранимая процедура sp_help для возврата всех сведений о столбцах для указанного объекта.
EXEC sp_help 'dbo.mytable'; Дополнительные сведения см. в разделе sp_help.
По умолчанию SSMS сопоставляет сочетание клавиш для sp_help с Alt-F1 . Выделите имя объекта в скрипте, который вы хотите увидеть, например dbo.mytable , и нажмите , Alt-F1 чтобы выполнить предыдущий пример скрипта. Дополнительные сведения см. в разделе Сочетания клавиш SSMS.
Как вариант, можно отправлять запросы к представлениям системного каталога напрямую для получения метаданных таких объектов, как таблицы, схемы и столбцы. Пример:
SELECT s.name as schema_name, t.name as table_name, c.* FROM sys.columns AS c INNER JOIN sys.tables AS t ON t.object_id = c.object_id INNER JOIN sys.schemas AS s ON s.schema_id = t.schema_id WHERE t.name = 'mytable' AND s.name = 'dbo'; Next Steps
- sys.columns (Transact-SQL)
- sys.tables (Transact-SQL)
- sys.schemas (Transact-SQL)
- Формирование скриптов (среда SQL Server Management Studio)
- Сочетания клавиш SSMS
Как получить список и описание всех колонок в таблице Microsoft SQL Server?
В данной заметке будет рассмотрено несколько способов получения информации о столбцах таблицы в базе данных Microsoft SQL Server, например, мы научимся получать список колонок таблицы, включая их тип данных, с помощью SQL запроса.
Начну с того, что если Вам нужно просто визуально посмотреть, какие колонки или какой тип данных у той или иной колонке в таблице, то Вы для этого можете использовать графический функционал SQL Server Management Studio, а именно «Обозреватель объектов». Например, для того чтобы посмотреть информацию о столбцах таблицы, необходимо плюсиком открыть соответствующий контейнер.
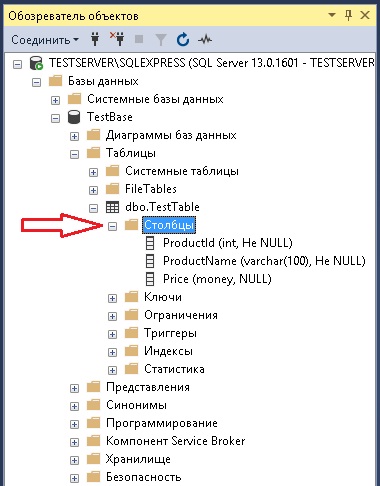
Но если Вам необходимо выгрузить эту информацию или обработать ее в SQL инструкции, то в этом случае необходимо обращаться к системным объектам SQL Server с помощью языка SQL, как и к каким именно объектам обращаться мы сейчас и рассмотрим.
Примечание! Все примеры ниже мы будем рассматривать в Microsoft SQL Server 2016 Express. В базе данных создана тестовая таблица TestTable, она имеет всего три столбца.
Получаем список колонок таблицы с помощью представления информационной схемы
В Microsoft SQL Server существует специальная схема — INFORMATION_SCHEMA, которая содержит метаданные для всех объектов базы данных. В данной схеме есть представление COLUMNS, с помощью которого и можно получить информацию о колонках таблицы. Также в ней есть и другие полезные представления, о которых мы разговаривали в статье — «Представления информационной схемы Microsoft SQL Server».
А теперь допустим, нам нужно получить информацию о столбцах в таблице, например, имя столбца, тип данных и возможность принятия значения NULL, для этого мы напишем следующий запрос, в котором обратимся к представлению COLUMNS информационной схемы.
SELECT TABLE_NAME AS [Имя таблицы], COLUMN_NAME AS [Имя столбца], DATA_TYPE AS [Тип данных столбца], IS_NULLABLE AS [Значения NULL] FROM INFORMATION_SCHEMA.COLUMNS WHERE table_name='TestTable'
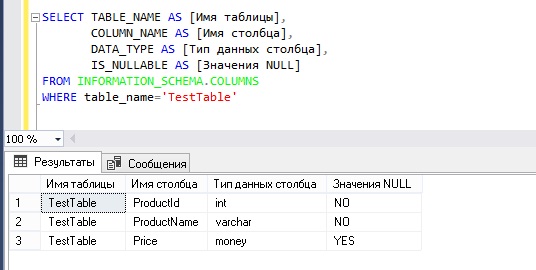
Получаем список столбцов таблицы с помощью системного представления sys.columns
Также информацию о колонках таблицы можно получить с помощью системного представления sys.columns, но только в этом случае для получения точно такого же результата, как был выше, необходимо будет объединять несколько системных представлений, а именно sys.tables, sys.columns и sys.types, так как в представлении sys.columns есть только идентификаторы нужных нам данных.
SELECT T.name AS [Имя таблицы], C.name AS [Имя столбца], DataType.name AS [Тип данных столбца], CASE WHEN C.is_nullable = 0 THEN 'NO' ELSE 'YES' END AS [Значения NULL] FROM sys.tables T LEFT JOIN sys.columns C ON T.object_id = C.object_id LEFT JOIN sys.types DataType ON C.user_type_id = DataType.user_type_id WHERE T.name='TestTable'
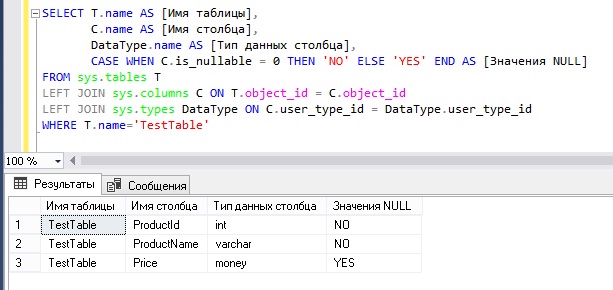
Получаем список колонок таблицы с помощью системной процедуры sp_columns
В SQL Server существует специальная системная процедура sp_columns, которая как раз и предназначена для получения информации о колонках таблицы.
EXEC sp_columns TestTable
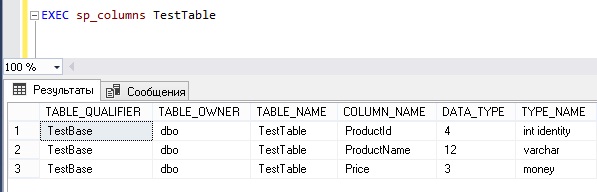
Какой из рассмотренных выше способов Вам подойдет и окажется удобней решать Вам, а у меня на этом все, удачи!
Заметка! Новичкам рекомендую посмотреть мой видеокурс по T-SQL для начинающих, с помощью него Вы «с нуля» научитесь работать с SQL и программировать на T-SQL.
DESCRIBE TABLE
Запрос DESCRIBE для каждого столбца таблицы возвращает строку со следующими значениями типа String:
- name — имя столбца;
- type — тип столбца;
- default_type — вид выражения для значения по умолчанию: DEFAULT , MATERIALIZED или ALIAS . Если значение по умолчанию не задано, то возвращается пустая строка;
- default_expression — значение, заданное в секции DEFAULT ;
- comment — комментарий;
- codec_expression — кодек, который применяется к столбцу;
- ttl_expression — выражение TTL;
- is_subcolumn — флаг, который равен 1 для внутренних подстолбцов. Он появляется в результате, только если описание подстолбцов разрешено настройкой describe_include_subcolumns.
Каждый столбец Nested структур описывается отдельно. Перед его именем ставится имя родительского столбца с точкой. Чтобы отобразить внутренние подстолбцы других типов данных, нужно включить настройку describe_include_subcolumns.
Пример
CREATE TABLE describe_example ( id UInt64, text String DEFAULT 'unknown' CODEC(ZSTD), user Tuple (name String, age UInt8) ) ENGINE = MergeTree() ORDER BY id; DESCRIBE TABLE describe_example; DESCRIBE TABLE describe_example SETTINGS describe_include_subcolumns=1; ┌─name─┬─type──────────────────────────┬─default_type─┬─default_expression─┬─comment─┬─codec_expression─┬─ttl_expression─┐ │ id │ UInt64 │ │ │ │ │ │ │ text │ String │ DEFAULT │ 'unknown' │ │ ZSTD(1) │ │ │ user │ Tuple(name String, age UInt8) │ │ │ │ │ │ └──────┴───────────────────────────────┴──────────────┴────────────────────┴─────────┴──────────────────┴────────────────┘ Второй запрос дополнительно выводит информацию о подстолбцах:
┌─name──────┬─type──────────────────────────┬─default_type─┬─default_expression─┬─comment─┬─codec_expression─┬─ttl_expression─┬─is_subcolumn─┐ │ id │ UInt64 │ │ │ │ │ │ 0 │ │ text │ String │ DEFAULT │ 'unknown' │ │ ZSTD(1) │ │ 0 │ │ user │ Tuple(name String, age UInt8) │ │ │ │ │ │ 0 │ │ user.name │ String │ │ │ │ │ │ 1 │ │ user.age │ UInt8 │ │ │ │ │ │ 1 │ └───────────┴───────────────────────────────┴──────────────┴────────────────────┴─────────┴──────────────────┴────────────────┴──────────────┘ См. также
- настройка describe_include_subcolumns.
Как получить информацию о структуре БД для документации
Из этой статьи вы узнаете, зачем нужно отслеживать метаданные в ИТ-проектах и какие существуют основные подходы к документированию баз данных, а также познакомитесь с примерами SQL запросов, которые помогут получить сведения о структуре и составе реляционной базы данных.
Это поможет любому участнику команды, а в первую очередь системному аналитику, решить такие задачи:
- Корректно сформулировать задачу на доработку системы в ситуации, когда её БД не описана
- Оценить актуальность имеющейся документации на БД
- Выполнить инвентаризацию информационных ресурсов
- Проводить мониторинг состояния БД на проекте
Время на чтение статьи: 14 минут
Оглавление
Какие метаданные полезно знать о своей БД?
При работе над любым ИТ-проектом полезно иметь возможность посмотреть на данные своих систем с высоты птичьего полёта.
Вот какая информация пригодится вам в первую очередь.
- Физическая структура данных: объекты БД (в первую очередь — таблицы и поля, их наименования, типы данных, допустимые диапазоны значений, ключи, а также — пользователи, индексы, представления и т. п.)
- Объём данных, частота их обновления, дата последнего обновления БД
- Модель данных (логическая, концептуальная) — ключевые атрибуты и сущности, связь между ними
- Смысл и значение данных, объяснение основных сущностей на языке бизнеса
- Распределение данных (количество пустых полей, кардинальность (количество уникальных и повторяющихся значений)
- Ответственный за данные — кто может пояснить смысл данных или помочь исправить найденные проблемы в них
Что такое словарь данных и зачем он нужен
Мы будем подразумевать под «словарем данных» (англ. — data dictionary) справочник или централизованное описание метаданных, дающее представление о структуре и содержании данных. У этого термина есть и другое значение, в рамках данной статьи не используемое: словарём данных называют технику моделирования, дополняющую требования при проектировании информационных систем, в культуре Systems Analysis and Design.
Мы все знаем, что в целостном и удобном для использования виде найти такую информацию по своему проекту аналитику бывает непросто. Структура таблиц базы данных попросту не описана в документации. Почему же так происходит?
Моделирование предметной области и проектирование баз данных
Воркшоп для системных аналитиков и не-разработчиков уровня джун или мидл, которые хотят спроектировать логическую модель базы данных и изучить основы нормализации баз данных. Особенно актуально для тех, кто еще не знаком с базами данных.
Традиционный подход для старта проектирования БД
Почему так редко задумываются о документировании БД?
- Это самая неинтересная для программистов часть
- На старте проекта БД создаётся по интуиции и видению разработчиков
- Для данных редко выделяется отдельный архитектор или просто ответственное лицо в команде
- По мере роста проекта требования к БД сложно выделить из множества требований на доработку
Вначале всё кажется очевидным, но по мере роста проекта оказывается, что единого описания данных и их структуры не существует, также как и носителя информации об этом среди участников команды. Иногда оказывается, что устройство БД уже усложнилось до такой степени, что приходится организовывать целую исследовательскую экспедицию для восстановления этой информации. В идеале нужно поддерживать актуальность информации о данных системы, и делать это можно разными способами.
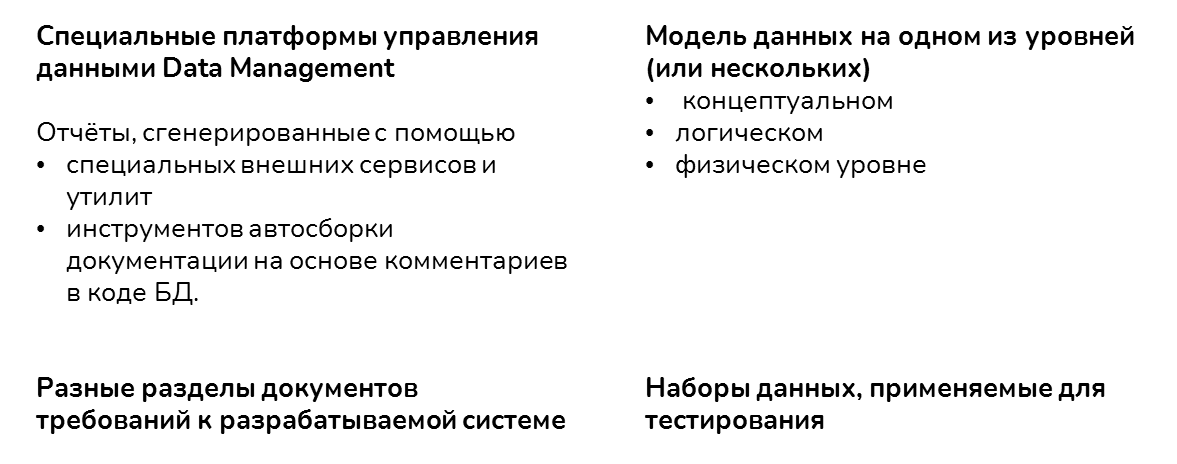
Какие средства документирования можно применять для описания БД?
| Инструмент, тип документации | Какую информацию можно найти | Примеры и комментарии | Что почитать |
| Специальные платформы управления данными Data Management. | • Каталог данных (Data Catalog) — единый источник сведений о всех информационных активах организации. • Список полей и атрибутов • Метаданные — например, информацию о размере таблиц, дате последнего обновления • Информацию об ответственных лицах • Бизнес-глоссарий |
Дороги в применении, используются в крупных только в больших компаниях, актуальны для проектов создания DWH (централизованное персистентное хранение данных всего предприятия для аналитики). | Что такое каталог данных? Видео от DIS Group |
Как вы уже поняли, если перед вами стоит задача понять смысл и структуру данных вашей системы, то придётся обращаться к нескольким источникам. Рыться в документации полезно, но утомительно. Наверно, вам уже пришла в голову мысль, что лучший способ понять вашу базу данных «as is» будет заключаться в том, чтобы подключиться к ней и «пощупать её руками».
Источники информации о БД
Как можно получить информацию о данных, используемых в системе?
| Способ | Описание | Пример |
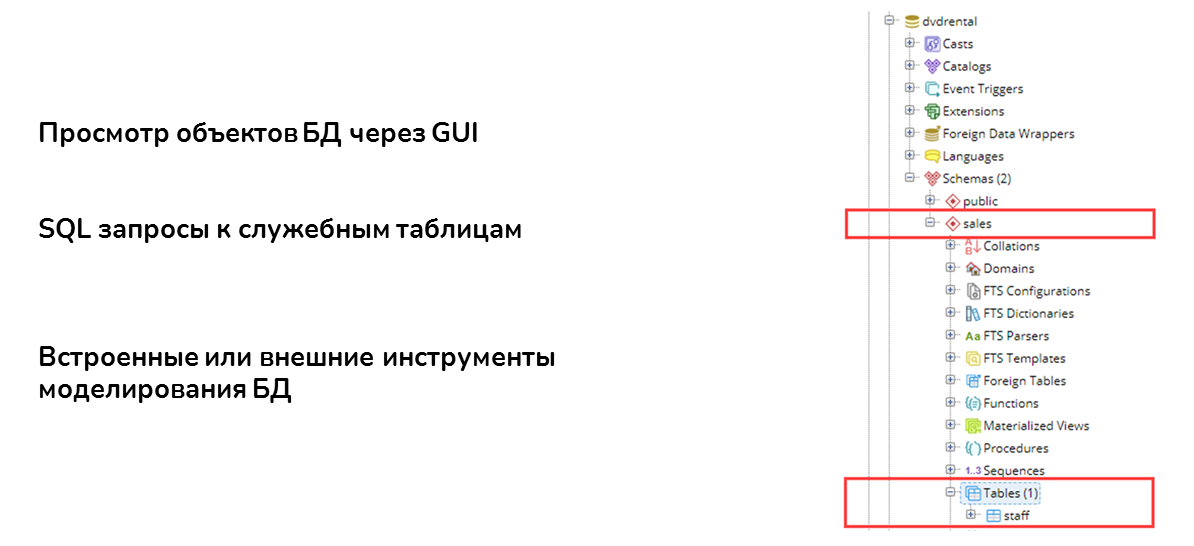
| Использовать специализированные инструменты, обеспечивающие возможность просмотра объектов БД. | Способ позволит визуально быстро понять, какие объекты есть в вашей базе данных. Можное осмотреть список таблиц и о каждой из них узнать что-то из контекстного меню или другой части внутри GUI используемого средства. Однако, получать, хранить и передавать информацию в такой форме неудобно. | Документация к редактору объектов DBeaver |
| Вывести информацию об объектах БД с помощью соответствующих SQL запросов к служебным таблицам. | В РСУБД существуют служебные таблицы, которые содержат интересующие нас сведения об объектах базы данных. Вы можете строить несложные SQL запросы к служебным таблицам и системным каталогам БД (помимо таблиц со схемой, среди служебных таблиц обычно есть много интересного). | Использование схемы данных в SQL Server |
Не все из перечисленных способов могут быть доступны аналитику. Например, возможность просмотра полной схемы БД бывает ограничена только для администраторов, а построение запросов к служебным таблицам требует знания особенностей конкретной СУБД. В следующих частях статьи вы найдёте примеры таких запросов и сможете начать использовать их прямо сейчас.
Как получить информацию о БД
Как быстро получить словарь данных для популярных БД?
Несколько слов по данному вопросу от Александра Кротова.
Полагаю, многие системные и бизнес-аналитики сталкивались с задачей инвентаризации информационных ресурсов организации, то есть с работой по описанию имеющихся в наличии автоматизированных систем, баз данных, локальных АРМ-ов и других ИТ-объектов, играющих определённую роль в бизнес-процессах. Как правило, такие работы проводятся в целях анализа состояния и эффективности ИТ-инфраструктуры внутри компании или на стороне заказчика, либо на фазе обследования в проектах, связанных с доработкой существующих систем. Зачастую работа по документированию текущего состояния дел возлагается на системного аналитика или бизнес-аналитика. В этой статье мы не будем обсуждать всё, что может быть связано с подобной инвентаризацией, а остановимся на подходах к обследованию одного типа ИТ-ресурсов компании — её баз данных.
В идеале, конечно, такое обследование должно начинаться с изучения документации на используемые базы данных, но проблема в том, что далеко не всегда (а по моему опыту, так и почти никогда) такая документация существует. А если документация на БД существует, то крайне редко бывает достаточно полной и актуальной.
Что делать в такой ситуации? Первое, что пришло бы мне в голову, это провести для всех баз данных так называемый «реверс-инжиниринг» (reverse engineering). Можно было бы изучить имеющиеся данные и их структуру, взять могучее универсальное средство моделирования, построить ER-модели, сформировать текстовое описание и приступить к более глубокому анализу полученных материалов. Но здесь мы можем натолкнуться на ряд проблем: универсальные средства моделирования, способные работать с разными СУБД, стоят, как правило, дорого, и далеко не каждый работодатель будет готов потратить деньги на приобретение подобного программного продукта. А вероятность того, что в процессе инвентаризации информационных ресурсов придётся столкнуться с так называемым «зоопарком», то есть разбродом и шатанием в платформах, СУБД и их версиях, достаточно высока. Иначе и задача наведения порядка в информационном хозяйстве вообще вряд ли бы возникла.
И вот, в ситуации, когда «зоопарк» есть, а актуальной документации и подходящего инструмента для её создания нет, можно пойти по другому пути и попробовать сформировать необходимую для анализа документацию на основе так называемых «словарей данных» — служебных таблиц, в которых реляционная (и не только) СУБД хранит описание своих объектов — таблиц, полей, представлений, ключей, индексов и многого другого. В том или ином виде такие словари должны быть в любой СУБД, хотя структура их может сильно различаться. В общем, я решил посмотреть, как подобные словари устроены, взяв для примера несколько популярных СУБД: MySQL, PostgreSQL, Oracle, SQLite, MS Access. А задачу я себе поставил простую: для каждой СУБД написать SQL-запрос, который сформирует описание таблиц и полей выбранных баз данных. Только хотел бы предупредить, что для разных версий одной и той же СУБД запросы могут немного отличаться, но, думаю, это и так очевидно.
Словарь данных для MySQL
Начал я с MySQL. Здесь всё оказалось достаточно просто. Можно использовать стандартную схему под названием INFORMATION_SCHEMA (говорят, даже ANSI на неё свой стандарт оформила для разных СУБД). Схема содержит таблицы, в которых можно легко найти все необходимые метаданные. В нашем случае достаточно соединить таблицы TABLES (таблицы) и COLUMNS (поля) по именам схемы и таблицы, выбрать нужные атрибуты, присвоить понятные псевдонимы, задать условия выборки (например, по имени схемы и типу объектов, как на примере ниже). Получится примерно такой запрос:
Получим результат вот такого вида
(показано на фрагменте отчёта для учебной БД «Студенты»):
| Таблица | Комментарий к таблице | № п.п | Поле | Комментарий к полю | Тип | Ключ | NULL |
| EMPLOYEE | Сотрудники | 1 | ID | Идентификатор | int(11) | PK | NO |
| EMPLOYEE | Сотрудники | 2 | LAST_NAME | Фамилия | varchar(45) | NO | |
| EMPLOYEE | Сотрудники | 3 | FIRST_NAME | Имя | varchar(45) | NO | |
| EMPLOYEE | Сотрудники | 4 | MIDDLE_NAME | Отчество | varchar(45) | YES | |
| EMPLOYEE | Сотрудники | 5 | BIRTHDAY | День рождения | date | YES | |
| GRADE | Оценки | 1 | ID | Идентификатор | int(11) | PK | NO |
| GRADE | Оценки | 2 | STUDENT_ID | ИД студента в группе | int(11) | YES | |
| GRADE | Оценки | 3 | MODULE_NUM | Номер модуля | int(11) | YES | |
| GRADE | Оценки | 4 | GRADE | Оценка | int(11) | YES | |
| GROUP_ST | Учебные группы | 1 | ID | Идентификатор | int(11) | PK | NO |
| GROUP_ST | Учебные группы | 2 | GROUP_CODE | Код группы | varchar(45) | YES | |
| GROUP_ST | Учебные группы | 3 | TEACHER_ID | ИД сотрудника-преподавателя | int(11) | YES | |
| GROUP_ST | Учебные группы | 4 | CURATOR_ID | ИД сотрудника-куратора | int(11) | YES | |
| STUDENT | Студенты | 1 | ID | Идентификатор | int(11) | PK | NO |
| STUDENT | Студенты | 2 | LAST_NAME | Фамилия | varchar(45) | NO | |
| STUDENT | Студенты | 3 | FIRST_NAME | Имя | varchar(45) | NO | |
| STUDENT | Студенты | 4 | MIDDLE_NAME | Отчество | varchar(45) | YES | |
| STUDENT | Студенты | 5 | BIRTHDAY | День рождения | date | YES |
Единственное, надо не забывать, что запрос вернёт только те объекты БД, на просмотр которых у текущего пользователя есть привилегии. И ещё я бы обратил внимание на атрибут ORDINAL_POSITION, который был использован в составе оператора ORDER BY после TABLE_NAME (имя таблицы). Атрибут предназначен для хранения порядка полей, заданного в DDL-скрипте при создании таблицы (оператор CREATE TABLE) или установленного разработчиком позже (кстати, возможность изменять порядок полей после создания таблицы реализована далеко не во всех СУБД, MySQL здесь обогнал многих). Но зачем хранить исходный порядок полей, если теория реляционных баз данных утверждает, что порядок полей в таблице не несёт никакой смысловой нагрузки? Полагаю, эта возможность реализована исключительно для удобства пользователя. Разработчик, создавая таблицу, задаёт порядок полей не просто так, а на основе определённой бизнес-логики, и вправе ожидать, что выполнив запрос типа SELECT * FROM … без явно указанного порядка полей, или создав отчёт на основе словаря данных, как мы это сделали выше, он получит поля в порядке, соответствующем заложенной логике, а не как попало. Аналогичные по сути атрибуты с порядковым номером поля в таблице, есть и в других СУБД, что мы увидим ниже.