
PIVOT — поворот таблицы в T-SQL
В этой статье: о применении инструкций PIVOT и UNPIVOT языка T-SQL для разворота табличных данных.
Лирическое вступление
Решив возобновить свои навыки владения SQL, продолжил начатое когда-то решение упражнений на замечательном сайте sql-ex.ru. В отличие от многих других ресурсов, где проводится тестирование путем выбора варианта среди ответов на вопрос, здесь решением является собственный SQL-запрос, который должен выдать верный набор данных на тестовой базе данных.
В одной из задач возникла необходимость отобразить результирующий набор данных зеркально относительно диагонали. На практике мне не довелось сталкиваться со случаями, когда подобный разворот необходимо делать именно средствами SQL. Обычно это решается несколько проще уже на наборе данных, который был возвращён средствами SQL. Хотя, слышал, что есть любители задавать подобную задачку на собеседованиях.
На sql-ex используется СУБД MS SQL Server, работающая с расширенным вариантом SQL — Transact-SQL (T-SQL). Гугль на запрос «T-SQL повернуть таблицу» сразу подсказал, что существует инструкция pivot, а последующее изучение этой темы — unpivot.
Ужас! Таково было моё впечатление после изучения документации и примеров использования. Синтаксис специфический и интуитивно непонятный, документация и имеющиеся примеры из одной колонки делают одну строку и наоборот. А как быть с несколькими сроками и столбцами? В редких случаях имеем примеры нескольких строк и колонок в результате, но полученных агрегатными функциями. А что делать, если меня в конкретном случае агрегирование не интересует? «Ну нипанятна!»
Скажу откровенно, как работает pivot, к моменту написания этих строк я так до конца и не разобрался. Тем не менее, попробую в процессе написания понять сам и как можно проще объяснить читателям.
Формулируем задачу
В общем случае задача достаточно проста для понимания. Из определенного исходного набора данных получить результирующий, зеркально отображенный относительно диагонали, например:
Исходный набор Результирующий набор ------------------------------ ------------------------ Фамилия Г.р. Пол Рост Чел.1 Чел.2 Чел.3 ------------------------------ ------------------------ Иванов 1972 м 176 Иванов Петров Сидорова Петров 1981 м 181 1972 1981 1990 Сидорова 1990 ж 168 м м ж 176 181 168
Мы видим, что есть набор данных, в котором число колонок не совпадает с числом строк (4×3), при этом колонки превращаются в строки и наоборот (3×4).
Надеюсь, что к концу статьи мы сможем проделать подобную операцию. К сожалению, одной простой командой такая транспозиция не произойдет.
Примеры будут приводится по структуре и данным из тестовой БД сайта sql-ex (другой возможности проверить запросы на СУБД MS SQL Server у меня просто нет).
Начнём с конца, с освоения unpivot, он мне показался проще.
UNPIVOT
UNPIVOT используется совместно с инструкцией SELECT и позволяет строку с данными развернуть в виде колонки.
Например, есть таблица Product, содержащая информацию о производителе, номере и типе продукции:
Product ------------------ maker varchar(10) model varchar(50) type varchar(50)
При выполнении следующего простейшего запроса:
select maker, model, type from product where model = '1276'
maker model type A 1276 Printer
Все же для начала начнём с одной строчки. Сразу можно догадаться, что развороту данных помешает различный тип данных полей. Поэтому предыдущий запрос слегка изменяется, поле maker приводится к типу остальных полей — cast(maker as varchar(50)) . Теперь ничто не мешает совершить разворот:
select aData from ( -- Это предыдущий запрос с приведенным типом поля maker select cast(maker as varchar(50)) maker, model, type from product where model = '1276' ) as t unpivot ( aData for fields in (maker, model, type) ) as unpvt
В результате выполнения этого, пока еще непонятного, запроса получим:
aData A 1276 Printer
Т. е. строка развернулась и стала вертикально. Имевшийся ранее селектовый запрос обёрнут новым, в котором присутствует блок unpivot. Синтаксис этого блока можно описать следующим образом:
unpivot( for in () )
- — имя поля внешнего запроса, в которое попадут «повёрнутые» данные. В примере было задано имя поля aData и выведены его значения ( select aData from . );
- — имя поля, содержащего имена полей вложенного запроса. Это поле может быть выведено отдельной колонкой;
- — перечень имён полей вложенного запроса, выводимых в результирующую колонку. Здесь могут быть перечислены все или часть полей вложенного запроса, которые необходимо вывести в результирующую колонку.
Как можно догадаться, изменение первой строчки запроса
select fields, aData from .
даст следующий результат:
fields aData maker A model 1276 type Printer
Тот же результат можно получить запросом select * from . , только первой будет выведена колонка aData.
Теперь рассмотрим работу с несколькими записями вложенного запроса. Для понимания вполне хватит двух. Изменим первичный запрос:
select cast(maker as varchar(50)) maker, model, type from product where model in ('1276', '2113')
maker model type A 1276 Printer E 2113 PC
В поворачивающем запросе изменился только вложенный подзапрос t:
select aData from ( select cast(maker as varchar(50)) maker, model, type from product where model in ('1276', '2113') ) as t unpivot ( aData for fields in (maker, model, type) ) as unpvt
В результате его выполнения получим:
aData A 1276 Printer E 2113 PC
Явная бессмыслица — данные в таком виде вряд ли применимы (что получится, если добавить в конце запроса сортировку? Например: order by fields ).
Чтобы данным придать осмысленность, попробуем их представить в таком виде:
model aData 1276 A 1276 Printer 2113 E 2113 PC
Здесь для каждой модели в отдельную колонку выведены характеристики «производитель» и «тип».
Если первую строку запроса изменить, добавив в нее поле model из вложенного запроса:
select model, aData from .
то при выполнении запроса возникнет ошибка — поле «модель» участвует в развороте данных и не может быть выведено в отдельную колонку. Что делать? Всего лишь исключить поле model из перечня в блоке unpivot. Получим следующий рабочий запрос:
select model, aData from ( select cast(maker as varchar(50)) maker, model, type from product where model in ('1276', '2113') ) as t unpivot ( aData for fields in (maker, type) ) as unpvt
Если в первую строку запроса добавить еще поле fields и изменить имена полей, получим:
select model, fields, aData from ( select cast(maker as varchar(50)) as [производитель], model, type as [тип] from product where model in ('1276', '2113') ) as t unpivot ( aData for fields in ([производитель], [тип]) ) as unpvt
и результат запроса:
model fields aData 1276 производитель A 1276 тип Printer 2113 производитель E 2113 тип PC
Таким образом, UNPIVOT позволяет:
- полностью или частично развернуть запись (строку) и представить её в вертикальном, колоночном виде;
- вывести в отдельной колонке имена полей или их синонимы, заданные в запросе;
- выводить поля из внутреннего запроса в виде отдельной колонки с тем ограничением, что эти поля не должны участвовать в развороте данных (отсутствовать в перечислении полей в блоке unpivot).
PIVOT
PIVOT является обратным по отношению к UNPIVOT, т. е. столбцы поворачивает в строки, но делает это несколько иначе, с использованием агрегатной функции.
pivot( aggregation() for in () )
- в отличие от unpivot, в котором было полем результирующего набора данных, здесь — имя поля, которое должно быть в исходном наборе;
- в обязательном порядке по полю должна выполняться агрегация (sum, count, avg и т. п.). Странная на первый взгляд особенность, её рассмотрим позднее;
- — имя поля исходного набора данных, значения которого будут выступать в роли колонок итогового набора данных — , в эти поля будет выводится результат выполнения агрегатной функции.
select * from product pivot ( count(model) for maker in ([A], [B], [D]) ) as pvt
Результат выполнения запроса:
type A B D Laptop 2 1 0 PC 2 1 0 Printer 3 0 2
Используемые в блоке pivot запроса поля model и maker, это поля, которые содержит исходный набор данных, таблица product. В перечислении maker in ([A], [B], [D]) значения «A», «B» и «D» — названия тех производителей из колонки maker, данные по которым необходимо вывести в виде отдельных колонок.
Здесь сразу заметно существенное ограничение в использовании pivot — с его помощью поворачивается не любой набор данных, а тот, из которого мы можем получить заранее оговорённый набор колонок (кварталы года, дни месяца, перечень конкретных компаний, сотрудников и т. п.).
При ближайшем рассмотрении тестового примера становится понятно, что в отличие от unpivot, осуществляющего «чистый» разворот, pivot в первую очередь предназначен для создания таких себе отчетов в более удобочитаемой форме, поэтому в нем и присутствует необходимость использования агрегатной функции.
В начале непонятно, откуда в примере взялась колонка type, если в запросе мы её нигде не использовали? Pivot делает отчет по тому набору данных, который ему передан. В примере он получил в качестве набора данных просто таблицу product, которая содержит три поля maker, model и type. Мы указали просчитать количество моделей по таким-то производителям, но поскольку в наборе данных есть еще поля, то pivot делает группировку и по всем остальным полям, оставляя их в итоговом наборе данных.
Т.е. с точки зрения полученных данных наш запрос полностью аналогичен такому:
select maker, type, count(model) models from product where maker in ('A', 'B', 'D') group by maker, type
отличается лишь представление данных:
maker type models A Laptop 2 B Laptop 1 A PC 2 B PC 1 A Printer 3 D Printer 2
Как быть, если мы хотим выбрать итог по производителям без учёта типа продукции? Ограничить набор данных требуемыми полями. Получим:
select 'Число моделей:' as [Производитель:], * from ( select maker, model from Product where maker in ('A', 'B', 'D') ) as pr pivot ( count(model) for maker in ([A], [B], [D]) ) as pvt
Мы ограничили набор исходных данных, с которыми мы работаем ( maker in (‘A’, ‘B’, ‘D’) ). Сразу уточню, что если команда pivot используется без параметра xml ( pivot xml ), то мы явно должны указать параметры IN. При выборке в формате xml, можем просто ввести any или выбрать значения обычным select. В результате получим:
Производитель: A B D Число моделей: 7 2 2
Для придания человекочитаемости результату запроса я нарушил принципы нормализации, в колонке «Производитель:» внесено значение «Число моделей:» 🙂
Если не удовлетворяют имена колонок, полученные по значениям из исходного набора данных, то их можно переименовать обычным способом:
select [A] as 'Произв. 1', [B] as 'Произв. 2', [D] as 'Произв. 3' from.
Таким образом, PIVOT позволяет:
- выполнить агрегатную функцию по полю исходного набора данных, при этом считается, что по остальным полям набора производится группировка;
- результаты выполнения агрегатной функции вывести в горизонтальном виде, при этом колонками для вывода служат заранее определенные (известные) значения одного из полей исходного набора данных. Остальные поля исходного набора данных могут быть выведены отдельными колонками, результаты агрегации выводятся не только в разных колонках, но и в разных строках (получается нечто похожее на сводный отчет, «шахматка»).
Полный разворот
Работу PIVOT и UNPIVOT рассмотрели, но первоначально задекларированную задачу зеркально отобразить таблицу ещё не решили. Этим и займёмся.
Допустим, что в интернет-магазине есть функционал, обеспечивающий возможность показывать сравнительную характеристику нескольких выбранных пользователем ПК, при этом, характеристики каждого ПК выводятся в виде отдельной колонки, а на каждый вид характеристики выделена отдельная строчка.
Например, пользователь выбрал для сравнения ПК с кодами товара 1, 2, 4 и 7.
select * from pc where code in (1,2,4,7)
выдаст следующий набор данных:
code model speed ram hd cd price 1 1232 500 64 5.0 12x 600.0000 2 1121 750 128 14.0 40x 850.0000 4 1121 600 128 14.0 40x 850.0000 7 1232 500 32 10.0 12x 400.0000
Как можно заметить, существуют одинаковые модели, имеющие различные характеристики, поэтому сразу понятно, что для сравнения группировать характеристики следует не по модели, а по коду продукта.
Шаг 1. Вертикальное представление характеристик
На первом шаге получим характеристики в вертикальном представлении с использованием UNPIVOT.
select code, prop, val from ( select code, model, cast(speed as varchar(50)) speed, cast(ram as varchar(50)) ram, cast(hd as varchar(50)) hd, cast(cd as varchar(50)) cd, cast(price as varchar(50)) price from pc where code in (1,2,4,7) ) x unpivot ( val for prop in (model, speed, ram, hd, cd, price) ) unpvt
Здесь все значения, попадающие в колонку характеристик, приведены к типу наибольшего из строковых полей model — varchar(50).
Чтобы значения можно было однозначно идентифицировать, выведены колонки с кодом продукта и названием характеристики.
При выполнении запроса получим следующие данные:
code prop val 1 model 1232 1 speed 500 1 ram 64 1 hd 5 1 cd 12x 1 price 600.00 2 model 1121 2 speed 750 2 ram 128 2 hd 14 2 cd 40x 2 price 850.00 4 model 1121 4 speed 600 4 ram 128 4 hd 14 4 cd 40x 4 price 850.00 7 model 1232 7 speed 500 7 ram 32 7 hd 10 7 cd 12x 7 price 400.00
Шаг 2. Сведение характеристик в строки
На предыдущем шаге характеристики ПК были представлены в вертикальном виде, но в одной колонке для всех ПК. Осталось характеристики каждого ПК вывести в отдельную колонку.
Это умеет делать PIVOT, но есть одна проблема: PIVOT — конструкция, использующая агрегацию. На sql-ex я подсмотрел достаточно простое решение: поскольку для пары code+prop в нашем наборе данных существует только одно значение val, то при группировке по этим полям выражение max(val) выдаст само это значение 🙂
select * from ( select code, prop, val from ( select code, model, cast(speed as varchar(50)) speed, cast(ram as varchar(50)) ram, cast(hd as varchar(50)) hd, cast(cd as varchar(50)) cd, cast(price as varchar(50)) price from pc where code in (1,2,4,7) ) x unpivot ( val for prop in (model, speed, ram, hd, cd, price) ) unpvt ) xx pivot ( max(val) for code in ([1],[2],[4],[7]) ) pvt
В результате получим:
prop 1 2 4 7 cd 12x 40x 40x 12x hd 5 14 14 10 model 1232 1121 1121 1232 price 600.00 850.00 850.00 400.00 ram 64 128 128 32 speed 500 750 600 500
Шаг 3. Улучшение визуального представления
Требуемые данные в нужной структуре представления получены. Что меня не устраивает — неинформативные заголовки колонок и неудобный для восприятия порядок сортировки характеристик. Сделаем незначительные доработки запроса:
select prop as 'Хар-ка', [1] as 'Код № 1', [2] as 'Код № 2', [4] as 'Код № 4', [7] as 'Код № 7' from ( select code, prop, val from ( select code, model [0.model], cast(speed as varchar(50)) [2.speed], cast(ram as varchar(50)) [3.ram], cast(hd as varchar(50)) [4.hd], cast(cd as varchar(50)) [5.cd], cast(price as varchar(50)) [1.price] from pc where code in (1,2,4,7) ) x unpivot ( val for prop in ([0.model], [2.speed], [3.ram], [4.hd], [5.cd], [1.price]) ) unpvt ) xx pivot ( max(val) for code in ([1],[2],[4],[7]) ) pvt order by prop
В результате его выполнения получим:
Хар-ка Код № 1 Код № 2 Код № 4 Код № 7 0.model 1232 1121 1121 1232 1.price 600.00 850.00 850.00 400.00 2.speed 500 750 600 500 3.ram 64 128 128 32 4.hd 5 14 14 10 5.cd 12x 40x 40x 12x
Заключение
Инструкции PIVOT и UNPIVOT — достаточно мощный и интересный инструмент, расширяющий возможности SQL. Инструмент неидеальный, т.к. у него имеются определённые ограничения. Например, не представляется возможным повернуть набор данных, для которого значения ключевого поля и число записей (строк) заранее неизвестны. Но в случаях, подобных примеру «сравнительной характеристики», эти инструкции позволяют ещё на стороне сервера баз данных выполнить достаточно лаконичный запрос без значительных последующих преобразований данных на сервере приложений или клиенте.
Ссылки
- Pages with syntax highlighting errors
- Личные заметки
- Программная инженерия
Построение сводных таблиц в SQL
Сводная таблица – один из самых популярных методов анализа табличных данных. Иногда мы анализируем большие таблицы — более 500 тыс. строк, но Excel обрабатывает такое количество данных достаточно долго, система постоянно зависает. Сегодня мы рассмотрим наиболее известные варианты построения сводной таблицы, доступные в SQL Server.
12K открытий
Предположим, у нас есть таблица с данными продаж нескольких видов продуктов (Product 1, 2, 3, 4) у разных операторов (A, B, C, D):
Из вышеуказанной таблицы мы хотим получить сводную таблицу вида:
Вариант 1: Использование оператора CASE
Для замены значения Null на обычный «0» достаточно добавить в конструкцию CASE WHEN оператор ELSE:
Не хватает итогов под таблицей. Для этого мы будем использовать оператор GROUP BY rollup:
А для того, чтобы под колонкой «product» вместо значения «NULL» вывести всем понятное «Total_sum» нам понадобится оператор coalesce.
Вариант 2: Использование оператора GROUP BY CUBE
Для быстрой группировки данных по операторам и вывода итоговых значений по каждому продукту без перечисления в коде всех операторов удобно использовать оператор GROUP BY CUBE:
Для отображения вместо NULL в колонке operator названия «Total_sum» воспользуемся оператором coalesce
Вариант 3: Использование оператора разворота таблиц PIVOT
Перед использованием этого оператора нам необходимо получить агрегированную таблицу. Для этого мы будем использовать ранее подготовленную с использованием оператора GROUP BY CUBE таблицу, используя предыдущий фрагмент кода как подзапрос (выделено цветом).
Здесь мы «поворачиваем» таблицу из прошлого запроса, используя агрегатную функцию суммы sum (Summa). При этом заголовки столбцов мы берём из поля operator, а с помощью in («A», «B», «C», «D», «total_sum») указываем какие конкретно операторы должны быть выведены (total_sum отвечает за столбец с итогами по строкам). При этом заголовки столбцов обязательно берем в двойные кавычки.
Для разворота таблицы в разрезе продуктов по каждому оператору меняем аргумент в операторе PIVOT.
Вариант 4: Динамический SQL
Запрос с PIVOT выглядит короче, чем изначальный с CASE, но названия поставщиков все ещё необходимо вносить вручную. Но что делать, если поставщиков много? Или если их список регулярно обновляется? Хотелось бы выбирать их автоматически. Здесь чистого SQL недостаточно. Он подразумевает статическую типизацию: для создания плана запроса СУБД нужно заранее указать число столбцов. Поэтому синтаксис PIVOT не позволяет использовать подзапрос. Но это ограничение легко обойти с помощью динамического SQL. Для этого названия столбцов необходимо преобразовать в строку формата «элемент_1», «элемент_2»,… , «элемент_n», и использовать их в запросе.
Для генерации строки, мы можем использовать оператор STUFF:
declare @colnames as nvarchar(max); select @colnames = stuff((select distinct ‘, ‘ + ‘»‘ + operator + ‘»‘ from [TB13_SANDBOX].[dbo].[Dr_operator] for xml path (») ), 1, 1, » ) + ‘, «total_sum»‘;
Полученную строку включаем в окончательный запрос:
Oracle Database Reflections
До версии 11 задача транспонирования решалась довольно сложно.
В версии 11 в синтаксисе оператора SELECTпоявились фразы PIVOT и UNPIVOT , которые выполняют такое транспонирование прозрачно и просто.
План запроса получается простой и эффективный — запрос будет хорошо выполняться даже на больших объёмах. Прежние варианты с самосоединением таблиц были бы менее эффективны
Приведу пример использования:
Имеем таблицу курсов валют к рублю:
| ISO_CODE | RATE_DATE | RATE_VALUE |
| EUR | 01.02.2012 | 39,9678 |
| EUR | 02.02.2012 | 39,6777 |
| EUR | 03.02.2012 | 39,7664 |
| UAH | 01.02.2012 | 3,7731 |
| UAH | 02.02.2012 | 3,7881 |
| UAH | 03.02.2012 | 3,7547 |
| USD | 01.02.2012 | 30,3131 |
| USD | 02.02.2012 | 30,4067 |
| USD | 03.02.2012 | 30,1855 |
Хотим получить такую таблицу
| RATE_DATE | RATE_EUR | RATE_UAH | RATE_USD |
| 01.02.2012 | 39,9678 | 3,7731 | 30,3131 |
| 02.02.2012 | 39,6777 | 3,7881 | 30,4067 |
| 03.02.2012 | 39,7664 | 3,7547 | 30,1855 |
В 11g это можно сделать таким запросом:
select * from (select ISO_CODE , RATE_DATE , RATE_VALUE from EXCH_RATES )
pivot (max ( RATE_VALUE )
for ISO_CODE in ( ‘EUR’ as RATE_EUR , ‘UAH’ as RATE_UAH , ‘USD’ as RATE_USD )
)
1. Первый select * from ( ) обязателен
2. Внутри фразы pivot ( ) сначала должна быть агрегатная функция, даже если фраза group by явно не указана. PIVOT выполнит неявный group by по всем полям, кроме поля в агрегатной функции и полей после FOR . Это необходимо, чтобы обработать ситуацию, когда там окажется несколько строк. Если строка одна — не важно, что писать, MIN, MAX, SUM, AVG .
UNPIVOT выполняет обратное преобрзование
UPDATE 15.06.2015
Как транспонировать несколько полей ?
В приведённом выше примере мы транспонировали только одно поле — RATE_VALUE превратилось в RATE_EUR, RATE_UAH, RATE_USD
Но бывают задачи, когда нужно транспонировать несколько полей, ниже я привожу пример, связанный тоже с курсами валют, но курсы взяты с рынка Форекс, и там строка курса содержит несколько значений OPEN (значение на момент начала интервала), MIN (минимальное, которое достигалось в интервале), MAX (максимальное, которое достигалось в интервале), CLOSE (каким значением курса интервал закончился), VOLUME (объём операций)
В этом случае, названия колонок нам нужно собрать перемножением множества значений (‘OPEN’, ‘MIN’, ‘MAX’, ‘CLOSE’, ‘VOLUME’) на множество значений названий пар валют
Этот запрос можно написать так, что в каждой колонке сначала будет название пары валют (поле из FOR) и через подчёркивание название поля, которое мы транспонируем
Сначала приведу запрос
select * from (select * from RATES)
pivot (avg (QOPEN) as QOPEN ,
avg (QMIN) as QMIN ,
avg (QMAX) as QMAX ,
avg (QCLOSE) as QCLOSE ,
avg (QVOLUME) as QVOLUME
for (CURPAIR) in (‘EURGBP’ as EURGBP
, ‘EURPLN’ as EURPLN
, ‘EURUSD’ as EURUSD)
)
order by 1
Алиасы полей, помеченные зелёным фоном — обязательны
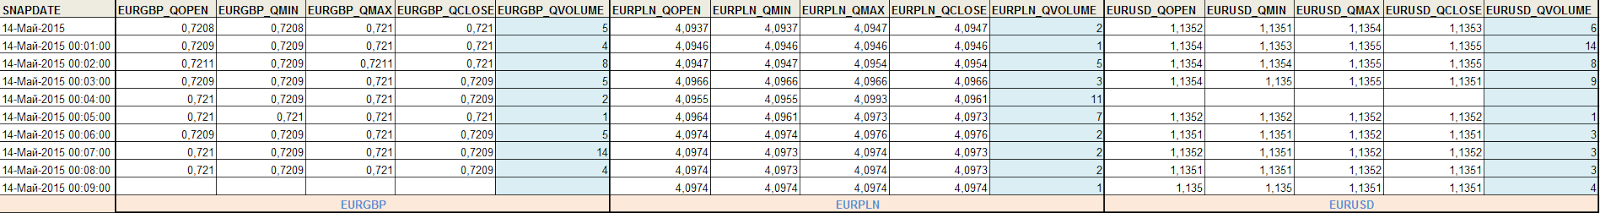
Вот таблица для тестирования
create table RATES (
CURPAIR varchar2(16) not null,
SNAPDATE date not null,
QOPEN number not null,
QMAX number not null,
QMIN number not null,
QCLOSE number not null,
QVOLUME number not null);
И её заполнение
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:00’, ‘YYYY.MM.DD HH24:MI’) ,0.7208,0.721,0.7208,0.721,5 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:01’, ‘YYYY.MM.DD HH24:MI’) ,0.7209,0.721,0.7209,0.721,4 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:02’, ‘YYYY.MM.DD HH24:MI’) ,0.7211,0.7211,0.7209,0.721,8 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:03’, ‘YYYY.MM.DD HH24:MI’) ,0.7209,0.721,0.7209,0.7209,5 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:04’, ‘YYYY.MM.DD HH24:MI’) ,0.721,0.721,0.7209,0.7209,2 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:05’, ‘YYYY.MM.DD HH24:MI’) ,0.721,0.721,0.721,0.721,1 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:06’, ‘YYYY.MM.DD HH24:MI’) ,0.7209,0.721,0.7209,0.7209,5 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:07’, ‘YYYY.MM.DD HH24:MI’) ,0.721,0.721,0.7209,0.7209,14 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURGBP’, to_date (‘2015.05.14 00:08’, ‘YYYY.MM.DD HH24:MI’) ,0.721,0.721,0.7209,0.7209,4 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:00’, ‘YYYY.MM.DD HH24:MI’) ,4.0937,4.0947,4.0937,4.0947,2 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:01’, ‘YYYY.MM.DD HH24:MI’) ,4.0946,4.0946,4.0946,4.0946,1 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:02’, ‘YYYY.MM.DD HH24:MI’) ,4.0947,4.0954,4.0947,4.0954,5 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:03’, ‘YYYY.MM.DD HH24:MI’) ,4.0966,4.0966,4.0966,4.0966,3 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:04’, ‘YYYY.MM.DD HH24:MI’) ,4.0955,4.0993,4.0955,4.0961,11 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:05’, ‘YYYY.MM.DD HH24:MI’) ,4.0964,4.0973,4.0961,4.0973,7 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:06’, ‘YYYY.MM.DD HH24:MI’) ,4.0974,4.0976,4.0974,4.0976,2 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:07’, ‘YYYY.MM.DD HH24:MI’) ,4.0974,4.0974,4.0973,4.0973,2 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:08’, ‘YYYY.MM.DD HH24:MI’) ,4.0974,4.0974,4.0973,4.0973,2 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURPLN’, to_date (‘2015.05.14 00:09’, ‘YYYY.MM.DD HH24:MI’) ,4.0974,4.0974,4.0974,4.0974,1 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:00’, ‘YYYY.MM.DD HH24:MI’) ,1.1352,1.1354,1.1351,1.1353,6 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:01’, ‘YYYY.MM.DD HH24:MI’) ,1.1354,1.1355,1.1353,1.1355,14 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:02’, ‘YYYY.MM.DD HH24:MI’) ,1.1354,1.1355,1.1354,1.1355,8 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:03’, ‘YYYY.MM.DD HH24:MI’) ,1.1354,1.1355,1.135,1.1351,9 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:05’, ‘YYYY.MM.DD HH24:MI’) ,1.1352,1.1352,1.1352,1.1352,1 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:06’, ‘YYYY.MM.DD HH24:MI’) ,1.1351,1.1352,1.1351,1.1351,3 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:07’, ‘YYYY.MM.DD HH24:MI’) ,1.1352,1.1352,1.1351,1.1352,3 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:08’, ‘YYYY.MM.DD HH24:MI’) ,1.1351,1.1352,1.1351,1.1351,3 );
insert into RATES (CURPAIR, SNAPDATE, QOPEN, QMAX, QMIN, QCLOSE, QVOLUME) values (‘EURUSD’, to_date (‘2015.05.14 00:09’, ‘YYYY.MM.DD HH24:MI’) ,1.135,1.1351,1.135,1.1351,4 );
Как в Oracle SQL развернуть строку в столбец
Давайте рассмотри пример преобразования данных SQL-запросом Oracle.
Создаем тестовую таблицу:
create table tTest ( id number, value varchar2(100) ); --Вставляем в нее строку insert into tTest(id,value) values(1,'value1;value2'); commit; --Смотрим, что получилось: select * from tTest; --запрос вернул: ID Value 1 value1;value2
Допустим, что для какой-то цели нам надо извлечь данные из этой таблицы, не немного не в том виде, как они хранятся.
На надо развернуть строку в столбец, т.е. SQL-запрос вместо одной строки
value1;value2
должен вернуть две строки:
value1 value2
Сделать это можно таким запросом:
select id, regexp_substr(t.value, '[^;]+', 1, level) vals from tTest t where t.id=1 connect by level Этот запрос вернет такой результат:Id vals 1 value1 1 value2Это нам и надо.
Дополнительно стоит отметить, что в этом запросе используется резулярное выражениет.е. все символы кроме ";" (используется как разделитель полей) и запрос генерации последовательности чисел.
Комментарии.
Внимание.
Комментировать могут только зарегистрированные пользователи.
Возможно использование следующих HTML тегов: , , ,
.
| Chalyshev | 14.07.2015 15:32:25 | |
| Серега , вроде я это где то уже читал ) или писал , не помню уже . | ||
| Chalyshev | 14.07.2015 15:35:49 | |
| в вобще есть отличная книга по SQL Энтони Моллиаро SQL Сборник рецептов | ||
| Chalyshev | 14.07.2015 16:05:20 | |
| считаю так же что в данном примере тема сисек раскрыта далеко не полностью . select distinct id,level, regexp_substr(value, '[^;]+', 1, level) vals from ttest connect by regexp_substr(value, '[^;]+', 1, level) is not null; вот так полностью. | ||