
История развития SQL
SQL (Structured Query Language) — Структурированный Язык Запросов — стандартный язык запросов по работе с реляционными БД. Язык SQL появился после реляционной алгебры, и его прототип был разработан в конце 70-х годов в компании IBM Research. Он был реализован в первом прототипе реляционной СУБД фирмы IBM System R. В дальнейшем этот язык применялся во многих коммерческих СУБД и в силу своего широкого распространения постепенно стал стандартом «де-факто» для языков манипулирования данными в реляционных СУБД.
Первый международный стандарт языка SQL был принят в 1989 г. (далее мы будем называть его SQL/89 или SQL1 ). Иногда стандарт SQL1 также называют стандартом ANSI/ISO, и подавляющее большинство доступных на рынке СУБД поддерживают этот стандарт полностью. Однако развитие информационных технологий, связанных с базами данных, и необходимость реализации переносимых приложений потребовали в скором времени доработки и расширения первого стандарта SQL.
В конце 1992 г. был принят новый международный стандарт языка SQL, который в дальнейшим будем называть SQL/92 или SQL2 . И он не лишен недостатков, но в то же время является существенно более точным и полным, чем SQL/89. В настоящий момент большинство производителей СУБД внесли изменения в свои продукты так, чтобы они в большей степени удовлетворяли стандарту SQL2.
В 1999 году появился новый стандарт , названный SQL3 . Если отличия между стандартами SQL1 и SQL2 во многом были количественными, то стандарт SQL3 соответствует качественным серьезным преобразованиям. В SQL3 введены новые типы данных, при этом предполагается возможность задания сложных структурированных типов данных, которые в большей степени соответствуют объектной ориентации. Наконец, добавлен раздел, который вводит стандарты на события и триггеры, которые ранее не затрагивались в стандартах, хотя давно уже широко использовались в коммерческих СУБД. В стандарте определены возможности четкой спецификации триггеров как совокупности события и действия. В качестве действия могут выступать не только последовательность операторов SQL, но и операторы управления ходом выполнения программы. В рамках управления транзакциями произошел возврат к старой модели транзакций, допускающей точки сохранения (savepoints). Возможность указания в операторе отката ROOLBACK точек возврата позволит откатывать транзакцию не в начало, а в промежуточную ранее сохраненную точку. Такое решение повышает гибкость реализации сложных алгоритмов обработки информации.
В настоящее время действует стандарт, принятый в 2003 году ( SQL:2003 ) с небольшими модификациями, внесёнными позже в 2008 г.
История версий SQL
Название
Иное название
Изменения
1986
SQL-86
SQL-87
Первый вариант стандарта, принятый институтом ANSI и одобренный ISO в 1987 году.
1989
SQL-89
FIPS 127-1
Немного доработанный вариант предыдущего стандарта.
1992
SQL-92
SQL2, FIPS 127-2
Значительные изменения (ISO 9075); уровень Entry Level стандарта SQL-92 был принят как стандарт FIPS 127-2.
1999
SQL:1999
SQL3
Добавлена поддержка регулярных выражений, рекурсивных запросов, поддержка триггеров, базовые процедурные расширения, нескалярные типы данных и некоторые объектно-ориентированные возможности.
2003
SQL:2003
Введены расширения для работы с XML-данными, оконные функции (применяемые для работы с OLAP-базами данных), генераторы последовательностей и основанные на них типы данных.
2006
SQL:2006
Функциональность работы с XML-данными значительно расширена. Появилась возможность совместно использовать в запросах SQL и XQuery.
2008
SQL:2008
Улучшены возможности оконных функций, устранены некоторые неоднозначности стандарта SQL:2003
А зачем вообще нужны эти стандарты? Зачем их изобретают и почему надо изучать их? Текст стандарта SQL2 занимает 600 станиц сухого формального текста, это очень много, и кажется, что это просто происки разработчиков стандартов, а не то, что необходимо рядовым разработчикам. Однако ни один серьезный разработчик, работающий с базами данных, не должен игнорировать стандарт, и для этого существуют весьма веские причины. Разработка любой информационной системы, ориентированной на технологию баз данных (а других информационных систем на настоящий момент практически нет), является трудоемким процессом, занимающим несколько десятков и даже сотен человеко-месяцев. Следует отдавать себе отчет, что нельзя разработать сколько-нибудь серьезную систему за несколько дней. Кроме того, развитие вычислительной техники, систем телекоммуникаций и программного обеспечения столь стремительно, что проект может устареть еще до момента внедрения. Но развивается не только вычислительная техника, изменяются и реальные объекты, поведение которых моделируется использованием как самой БД, так и процедур обработки информации в ней, то есть конкретных приложений, которые составляют реальное наполнение разрабатываемой информационной системы. Именно поэтому проект информационной системы должен быть рассчитан на расширяемость и переносимость на другие платформы. Большинство поставщиков аппаратуры и программного обеспечения следуют стратегии поддержки стандартов, в противном случае пользователи просто не будут их покупать. Однако каждый поставщик cтремится улучшить свой продут введением дополнительных возможностей, не входящих в стандарт. Выбор разработчиков, следовательно, таков: ориентироваться только на экзотические особенности данного продукта либо стараться в основном придерживаться стандарта. Во втором случае весь интеллектуальный труд, вкладываемый в разработку, становится более защищенным, так как система приобретает свойства переносимости. И в случае появления более перспективной платформы проект, ориентированный в большей степени на стандарты, может быть легче перенесен на нее, чем тот, который в основном ориентировался на особенности конкретной платформы. Кроме того, стандарты — это верный ориентир для разработчиков, так как все поставщики СУБД в своих перспективных разработках обязательно следуют стандарту, и можно быть уверенным, что в конце концов стандарт будет реализован практически во всех перспективных СУБД. Так произошло со стандартом SQL1, так происходит со стандартом SQL2 и так будет происходить со стандартом SQL3.
Для поставщиков СУБД стандарт — это путеводная звезда, которая гарантирует правильное направление работ. А вот эффективность реализации стандарта — это гарантия успеха.
SQL нельзя в полной мере отнести к традиционным языкам программирования, он не содержит традиционные операторы, управляющие ходом выполнения программы, операторы описания типов и многое другое, он содержит только набор стандартных операторов доступа к данным, хранящимся в базе данных. Операторы SQL встраиваются в базовый язык программирования, которым может быть любой стандартный язык типа C++, PL, COBOL и т. д. Кроме того, операторы SQL могут выполняться непосредственно в интерактивном режиме.
Знаете ли Вы, почему «черные дыры» — фикция?
Согласно релятивистской мифологии, «чёрная дыра — это область в пространстве-времени, гравитационное притяжение которой настолько велико, что покинуть её не могут даже объекты, движущиеся со скоростью света (в том числе и кванты самого света). Граница этой области называется горизонтом событий, а её характерный размер — гравитационным радиусом. В простейшем случае сферически симметричной чёрной дыры он равен радиусу Шварцшильда».
На самом деле миф о черных дырах есть порождение мифа о фотоне — пушечном ядре. Этот миф родился еще в античные времена. Математическое развитие он получил в трудах Исаака Ньютона в виде корпускулярной теории света. Корпускуле света приписывалась масса. Из этого следовало, что при высоких ускорениях свободного падения возможен поворот траектории луча света вспять, по параболе, как это происходит с пушечным ядром в гравитационном поле Земли.
Отсюда родились сказки о «радиусе Шварцшильда», «черных дырах Хокинга» и прочих безудержных фантазиях пропагандистов релятивизма.
Впрочем, эти сказки несколько древнее. В 1795 году математик Пьер Симон Лаплас писал:
«Если бы диаметр светящейся звезды с той же плотностью, что и Земля, в 250 раз превосходил бы диаметр Солнца, то вследствие притяжения звезды ни один из испущенных ею лучей не смог бы дойти до нас; следовательно, не исключено, что самые большие из светящихся тел по этой причине являются невидимыми.» [цитата по Брагинский В.Б., Полнарёв А. Г. Удивительная гравитация. — М., Наука, 1985]
Однако, как выяснилось в 20-м веке, фотон не обладает массой и не может взаимодействовать с гравитационным полем как весомое вещество. Фотон — это квантованная электромагнитная волна, то есть даже не объект, а процесс. А процессы не могут иметь веса, так как они не являются вещественными объектами. Это всего-лишь движение некоторой среды. (сравните с аналогами: движение воды, движение воздуха, колебания почвы). Подробнее читайте в FAQ по эфирной физике.
История языков программирования: SQL- стандартизация длиною в жизнь
По мнению аналитиков CodingDojo, SQL — самый важный и нужный язык запросов среди языков программирования, как бы странно это ни звучало. Рейтинг CodingDojo учитывает статистику востребованности языков программирования на рынке труда.
Ведь СУБД – MySQL, PostgreSQL и Microsoft SQL Server – распространены повсеместно: в крупном и малом бизнесе, в больницах, банках, университетах и так далее. В принципе, SQL не ограничивается только настольными девайсами: СУБД SQLite с успехом заняла свое место на Android-смартфонах и мобильных устройствах Apple. Соответственно, такие приложения, как Skype и Dropbox, постоянно к ней обращаются.
Однако были времена, когда не было смартфонов, а этот язык уже существовал. История SQL – это не годы, но десятилетия. Поверили в него не сразу.
System R и IBM
Первые упоминания об этом языке датируются 1974 годом. SQL создавался в рамках проекта экспериментальной реляционной СУБД System R. Занималась этим проектом компания IBM.
Первоначально язык назывался SEQUEL (Structured English Query Language), но потом слово «English» пропало из этого словосочетания, а аббревиатура приобрела тот вид, к которому мы давно уже привыкли. С одной стороны, SQL был ориентирован на удобную и понятную пользователям формулировку запросов к реляционным БД. С другой стороны, практически с самого начала он был так называемым «полным языком БД». Это означает, что SQL включал:
• средства определения и манипулирования схемой БД;
• средства определения ограничений целостности и триггеров;
• средства определения представлений БД;
• средства определения структур физического уровня, поддерживающих эффективное выполнение запросов;
• средства авторизации доступа к отношениям и их полям;
• средства определения точек сохранения транзакции и выполнения фиксации и откатов транзакций.
Правда, в нем не были реализованы средства синхронизации доступа к объектам БД со стороны параллельно выполняемых транзакций. Дело в том, что разработчики изначально рассчитывали, что необходимую синхронизацию неявно выполняет СУБД.
Язык реализован в подавляющем большинстве СУБД – как в реляционных, так и нереляционных. Целью разработки было создание простого непроцедурного языка, которым мог воспользоваться любой пользователь, даже не имеющий навыков программирования.
Разработкой языка запросов занимались Дональд Чэмбэрлин (Donald D. Chamberlin) и Рэй Бойс (Ray Boyce).

SEQUEL был не единственным языком подобного назначения. В Калифорнийском Университете Беркли была разработана некоммерческая СУБД Ingres, которая являлась реляционной СУБД, но использовала свой собственный язык QUEL, который, однако, не выдержал конкуренции по количеству поддерживающих его СУБД по сравнению с языком SQL.
В System R была реализована наиболее сложная и полная версия SQL. Чуть меньше функциональности было в SQL/DS и DB2 от той же IBM. Из SQL System R были удалены только те части, которые были недостаточно проработаны (например, точки сохранения) или реализация которых вызывала слишком большие технические трудности (например, ограничения целостности и триггеры).
Коммерческий успех
Поэтому путь к коммерческой реализации SQL, который прошла IBM, называют движением «сверху вниз».
Oracle, Informix и Sybase пошли по другому пути – «снизу вверх»: в первых версиях этих систем, выпущенных на рынок, использовалось существенно ограниченное подмножество SQL System R. А далее они начали постепенно расширяться. Однако в первой коммерческой реализации SQL в СУБД Oracle в операторах выборки не допускалось использование вложенных подзапросов и отсутствовала возможность формулировки запросов с соединениями нескольких отношений.

Распеределение рыночных долей по состоянию на 2011 год
Растущая заинтересованность рынка в скорейшем переходе к реляционным системам управления базами данных позволила разработчикам перечисленных выше компаний добиться коммерческого успеха. Это произошло, скорее, вопреки тому, что СУБД были тогда очень далеки от совершенства. Ну а теперь Oracle, Informix, Sybase и Microsoft SQL Server поддерживают достаточно мощные диалекты SQL.
Стандартизация
Появление многочисленных диалектов SQL и их разрастание должно было привести к проблемам совместимости и прочим противоречиям.
Однако деятельность по стандартизации языка SQL началась очень вовремя – практически одновременно с появлением его первых коммерческих реализаций. В 1982 году комитету по базам данных Американского национального института стандартов (ANSI) было поручено разработать спецификацию стандартного языка реляционных баз данных.
После отклонения ряда неудачных версий стандарта в 1986 году эксперты пришли к единому знаменателю. А в 1987 году стандарт SQL/86 был одобрен Международной организацией по стандартизации (ISO).
За основу стандарта нельзя было брать SQL System R. Во-первых, этот вариант языка был недостаточно проработан технически. Во-вторых, его слишком сложно было бы реализовать. Поэтому за основу был взят диалект языка SQL, сложившийся в IBM к началу 1980-х годов. В сущности, этот диалект представлял собой подмножество SQL System R.
Стандарт SQL1
К 1989 году стандарт SQL/86 был несколько расширен, после чего появился следующий стандарт, получивший название ANSI/ISO SQL/89.
SQL/89 стал первым всемирно принятым стандартом языка SQL. У этого языка имеется масса недостатков: многие важные понятия не определены, много отдано на откуп реализациям. В этом стандарте полностью отсутствуют такие важные разделы, как манипулирование схемой БД и динамический SQL.
Но тем не менее он сыграл свою роль в становлении действительно стандартизованных реляционных систем управления базами данных. Более того, с появлением стандарта SQL/89 стало возможно проектировать, разрабатывать и сопровождать информационные системы, не слишком привязанные к конкретному производителю СУБД. В некотором смысле появление SQL/89 явилось продвижением технологии баз данных в сторону открытых систем.
Возможно, наиболее важными достижениями стандарта SQL/89 являются четкая стандартизация синтаксиса, семантики операторов выборки данных и манипулирования данными, а также фиксация средств ограничения целостности БД.
В стандарте определяются два уровня языка и отдельное средство поддержания целостности. Уровень 2 — это полный язык баз данных SQL, не включающий средство поддержания целостности. Уровень 1 — это специфицированное подмножество уровня 2.
Средство поддержания целостности включает возможности определения:
• требуемых ограничений на ссылки между таблицами;
• проверочных ограничений на строки таблицы;
• значений столбца по умолчанию при занесении строки в таблицу.
Средства определения внешних ключей позволяют легко формулировать требования так называемой ссылочной целостности БД. Это распространенное в реляционных БД требование можно было сформулировать и на основе общего механизма ограничений целостности SQL System R, но формулировка на основе понятия внешнего ключа более проста и понятна.

Возможности операции Join в разных стандартах
Стандарт SQL2 и его дополнения
Осознавая неполноту стандарта SQL, специалисты различных компаний начали работу над очередным стандартом, который получил название SQL2. Эта работа также длилась несколько лет, было выпущено множество проектов стандарта, пока наконец в марте 1992 года не был принят окончательный проект стандарта (SQL/92). Этот стандарт существенно полнее стандарта SQL/89 и охватывает практически все аспекты, необходимые для реализации приложений: манипулирование схемой БД, управление транзакциями (появились точки сохранения) и сессиями (сессия – это последовательность транзакций, в пределах которой сохраняются временные отношения), подключения к БД, динамический SQL. Наконец, были стандартизованы отношения-каталоги БД, что вообще-то не связано непосредственно с языком, но очень сильно влияет на реализацию.
В 1995 году стандарт был дополнен спецификацией интерфейса уровня вызова (Call-Level Interface – SQL/CLI). SQL/CLI представляет собой набор спецификаций интерфейсов процедур, вызовы которых позволяют выполнять динамически задаваемые операторы SQL. По сути дела, SQL/CLI представляет собой альтернативу динамическому SQL.
Стандарт SQL/CLI послужил основой для создания повсеместно распространенных сегодня интерфейсов ODBC (Open Database Connectivity) и JDBC (Java Database Connectivity).
В 1996 году к стандарту SQL/92 был добавлен еще один компонент – SQL/PSM (Persistent Stored Modules). Основная цель этой спецификации – стандартизировать способы определения и использования хранимых процедур, то есть специальным образом оформленных программ, включающих операторы SQL, которые сохраняются в базе данных, могут вызываться приложениями и выполняются внутри СУБД.
Oracle является одной из наиболее популярных СУБД. Более того, именно там впервые была реализована совместимость со стандартом SQL/92.
А изначально первой СУБД, поддерживающей язык SQL, стала Oracle V2, разработанная для машин VAX. Это было еще в в 1979 году.
Oracle поддерживает ряд различных платформ, включая Windows, Linux, Max OS X и Sun Solaris.

Процедурное расширение SQL, разработанное Oracle, называется PL/SQL (Procedural Language/Structured Query Language) и основано на синтаксисе языков Ada и Pascal. Третьим ключевым языком, использующийся в СУБД Oracle наравне с SQL и PL/SQL, является Java.
PL/SQL поддерживает программные блоки, а также разнообразные типы данных для хранения чисел, строк и дат, операторы управления потоком вычислений (в том числе условные переходы и циклы) и три типа контейнеров (коллекций) — массивы переменной длины, ассоциативные массивы и вложенные таблицы.
Стандарт SQL3
Первоначально планировалось закончить работу над новым стандартом в 1995 году. Реально работу над новым стандартом удалось частично завершить только в 1999 году, и по этой причине стандарт получил название SQL:1999.
Каждый новый вариант стандарта языка SQL был существенно объемнее предыдущих версий. Так, если стандарт SQL/89 занимал около 600 страниц, то объем SQL/92 составлял на 300 с лишним страниц больше.
Самые первые проекты SQL3 занимали около 1500 страниц.
Однако разработчики SQL3 пришли к выводу, что при таких объемах стандарта вероятность его принятия и последующей успешной поддержки заметно уменьшается. Поэтому они решили разбить стандарт на относительно независимые части, которые можно было бы разрабатывать и поддерживать по отдельности.
В 1999 году были приняты пять частей стандарта SQL:1999.
Первая часть (SQL/Framework) посвящена описанию концептуальной структуры стандарта. В этой части приводится развернутая аннотация следующих четырех частей и формулируются требования к реализациям, претендующим на соответствие стандарту.
Вторая часть SQL:1999 (SQL/Foundation) образует базис стандарта. Вводится система типов языка, формулируются правила определения функциональных зависимостей и возможных ключей, определяются синтаксис и семантика основных операторов SQL:
• операторов определения и манипулирования схемой базы данных;
• операторов манипулирования данными;
• операторов управления транзакциями;
• операторов управления подключениями к базе данных и т. д.

Третью часть занимает уточненная по сравнению с SQL/92 спецификация SQL/CLI. В четвертой части специфицируется SQL/PSM – синтаксис и семантика языка определения хранимых процедур. Наконец, в пятой части – SQL/Bindings – определяются правила связывания SQL для стандартных версий языков программирования.
В стандарт SQL:1999 должны были войти еще несколько частей. Среди них спецификации следующих средств:
• управление распределенными транзакциями (SQL/Transaction);
• поддержка темпоральных свойств данных (SQL/Temporal);
• управление внешними данными (SQL/MED);
• связывание с объектно-ориентированными языками программирования (SQL/OLB);
• поддержка оперативной аналитической обработки (SQL/OLAP).
SQL в XXI веке
В конце 2003 года был принят и опубликован новый вариант международного стандарта SQL:2003. Многие специалисты считали, что в варианте стандарта, следующем за SQL:1999, будут всего лишь исправлены неточности SQL:1999. Но на самом деле, в SQL:2003 специфицирован ряд новых и важных свойств, с небольшими модификациями, внесёнными позже в 2008 году.
Наиболее серьезные изменения языка SQL, специфицированные в части 2 стандарта SQL:2003, касаются следующих аспектов:
• типы данных;
• подпрограммы, вызываемые из SQL;
• расширенные возможности оператора CREATE TABLE;
• новый объект схемы – генератор последовательностей;
• новые виды столбцов – идентифицирующие столбцы (identity column) и генерируемые столбцы (generated column);
• новый оператор MERGE;
Претерпела некоторые изменения общая организация стандарта. Стандарт SQL:2003 состоит из следующих частей:
• 9075-1, SQL/Framework;
• 9075-2, SQL/Foundation;
• 9075-3, SQL/CLI;
• 9075-4, SQL/PSM;
• 9075-9, SQL/MED;
• 9075-10, SQL/OLB;
• 9075-11, SQL/Schemata;
• 9075-13, SQL/JRT;
• 9075-14, SQL/XML.
Части 1-4 и 9-10 с необходимыми изменениями остались такими же, как и в SQL:1999. Часть 5 (SQL/Bindings) перестала существовать; соответствующие спецификации включены в часть 2.
Раздел части 2 SQL:1999, посвященный информационной схеме, выделен в отдельную часть 11. Появились две новые части – 13 и 14.
Часть 13 полностью называется «SQL Routines and Types Using the Java Programming Language» («Использование подпрограмм и типов SQL в языке программирования Java»). Появление такой части стандарта оправдано повышенным вниманием к языку Java со стороны ведущих производителей SQL-ориентированных СУБД.
Наконец, последняя часть SQL:2003 посвящена спецификациям языковых средств, позволяющих работать с XML-документами в среде SQL.
Несмотря на старания разработчиков, процесс стандартизации явно не поспевает за происходящими изменениями.

Основные моменты в истории SQL
Тем не менее, можно сказать, что базовый набор операторов SQL, включающий операторы определения схемы БД, выборки и манипулирования данными, авторизации доступа к данным, поддержки встраивания SQL в языки программирования и операторы динамического SQL, в коммерческих реализациях устоялся и более или менее соответствует стандарту.
P.S. SQL нельзя в полной мере отнести к традиционным языкам программирования, он не содержит традиционные операторы, управляющие ходом выполнения программы, операторы описания типов и многое другое, он содержит только набор стандартных операторов доступа к данным, хранящимся в базе данных. Однако эти «недостатки» ему прощают, учитывая его место в истории ИТ.
Когда была разработана первая версия языка sql
Всем добрый день! Сегодня мы начинаем цикл занятий по языку программирования SQL. Выясним, что такое базы и модели данных, как их создавать и, разумеется, как ими оперировать. На этом занятии мы с вами разберемся: откуда появились базы данных? И почему они появились такими, какими мы их видим и используем в настоящий момент?
Совокупность взаимосвязанных действий, преобразующих входящие данные в исходящие.
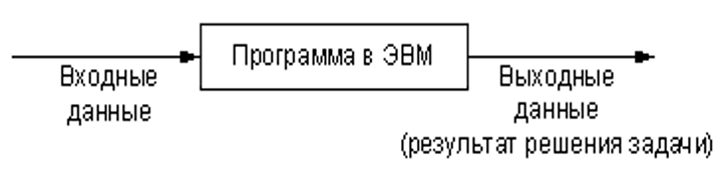
Соотношение сложности представления обрабатываемых данных и алгоритма вычислений определяет два класса задач:
- вычислительные задачи;
Y=X2+5X
X и Y — определенные числа, которые являются здесь элементарными единицами данных (элементами данных) - задачи обработки данных
Начисление заработной платы.
Начисленная сумма = (кол-во отработанных дней в месяц * Оклад) / кол-во рабочих дней в месяце
Развитие систем хранения данных
Этапы развития систем хранения данных
История развития баз данных насчитывает более 50 лет.
- 0-й этап.
Файловые системы.
1958 г. - 1-й этап.
Монолитная архитектура.
1960 — 1980 гг. - 2-й этап.
Архитектура «файл-сервер».
1975 — 1995 гг. - 3-й этап.
Трехуровневая архитектура (клиент-сервер).
1985 г. — н.в. - 4-й этап.
Облачные технологии.
2012 г. — н.в.
0-й этап . Файловые системы.
Фа́йловая систе́ма (file system) — порядок, определяющий способ организации, хранения и именования данных на носителях информации
Недостатки применения файловых систем:
- Избыточность данных.
- Несогласованность данных.
- Зависимость структур данных и прикладных программ.
Магнитные диски впервые были реализованы в 1956 году в исследовательской лаборатории корпорации IBM, расположенной в Сан-Хосе (Калифорния), где был выпущен серийный дисковый накопитель
IBM 350 — первое устройство с подвижной головкой для чтения и записи.
Первая развитая файловая система была разработана фирмой IBM для ее серии System/360 в 1964 году
В 60-х годах прошлого столетия появилась необходимость в надежной модели хранения и обработки данных. В первую очередь эти данные генерировались банками и финансовыми организациями. В то время не существовало единых стандартов работы с данными и моделями, да и работа как таковая заключалась в ручном упорядочении и организации хранящейся информации.
У банков худо-бедно получалось записывать информацию о транзакциях в виде файлов в заранее подготовленную структуру. У каждой организации было собственное понимание того, как все это должно выглядеть и работать. Не было таких понятий, как консистентность (англ. data consistency), целостности данных (англ. data integrity). В файлах часто встречались дубликаты данных клиентов и их транзакций, которые необходимо было каким-то образом уточнять и приводить в порядок, делалось это в основном вручную. В целом все проблемы того времени в отношении работы с данными можно разделить на несколько основных видов:
- представление структуры в каждом файле было различным;
- необходимо было согласовывать данные в разных файлах, чтобы обеспечить непротиворечивость информации;
- сложность разработки и поддержки приложений, работающих с конкретными данными, и их обновления при изменении структуры файла.
1-й этап. Монолитная архитектура
- В 1968 году компания IBM разработала первую промышленную СУБД: IBM IMS (Information Management System)
- В задачу IMS входила обработка спецификации изделия для ракеты Сатурн-5 и кораблей Аполлон.
- В качестве носителя информации использовалась магнитная лента, а в качестве структуры данных — иерархическая модель.
Получаемые в результате библиотеки, реализующие дополнительные индивидуальные средства управления данными, являлись существенной частью информационных систем и практически повторялись от одной системы к другой.
Стремление выделить и обобщить общую часть информационных систем, ответственную за управление сложно структурированными данными, вылилось в реализацию новых программных систем, названных впоследствии Системами Управления Базами Данных (СУБД), а сами хранилища информации, которые работали под управлением данных систем, назывались базами данных.
2-й этап. Архитектура «файл-сервер»
Файл-сервер только извлекает данные из файла (файлов) базы данных и передает их клиенту для дальнейшей обработки.
- Значительный сетевой трафик.
- Неважно, сколько записей из базы данных нужны клиенту — файлы базы данных передаются в самом общем случае целиком.
- Безопасность не может быть обеспечена на должном уровне.
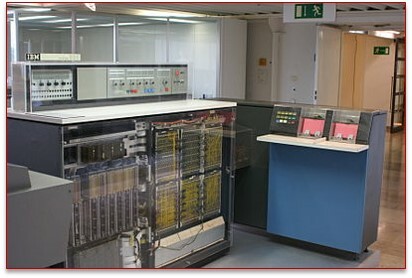
Первый персональный компьютер модели 5100 производства фирмы IBM выпущен в 1975 году. Он был более компактным, чем мэйнфреймы, имел встроенные монитор, клавиатуру и накопитель на магнитной ленте, и предназначался для решения научно-инженерных задач.
Первым массовым персональным компьютером производства фирмы IBM, выпущенным в 1981 году, стал IBM PC модели 5150, положивший начало семейству наиболее распространённых современных персональных компьютеров.
Спрос на развитые удобные программы обработки данных заставлял поставщиков программного обеспечения поставлять все новые системы, которые принято называть настольными (desktop) СУБД.
Наличие на рынке большого числа СУБД, выполняющих сходные функции, потребовало разработки методов экспорта, импорта и открытых форматов хранения данных. Так появились первые коммерческие СУБД с реляционной моделью данных.
Основанные на реляционном подходе СУБД для персональных компьютеров принято считать системами второго поколения.
В 80-х годах были созданы различные коммерческие реляционные СУБД — например, DB2 или SQL/DS корпорации IBM, Oracle и др. Большинство СУБД имели развитый и удобный пользовательский интерфейс, предлагающий интерактивный режим работы с БД, как в рамках описания БД, так и в рамках проектирования запросов.
3-й этап. Трехуровневая архитектура (клиент-сервер)
- Основной объем обработки данных сосредоточен на сервере.
- Клиент использует запросы SQL.
- SQL-89;
- SQL-92;
- SQL-99;
- SQL:2003;
- SQL:2006;
- SQL:2008.

Третий этап развития СУБД связывают с распространением локальных и глобальных компьютерных сетей. На сегодняшний день третий этап можно считать незавершённым.
SQL-89, SQL-92, SQL-99, SQL:2003, SQL:2006, SQL:2008
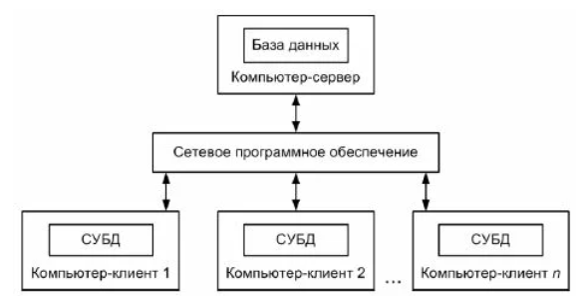
Информационные системы с клиент-серверной архитектурой позволяют избежать проблем файл-серверных приложений. При такой архитектуре сервер базы данных, расположенный на компьютере-сервере, обеспечивает выполнение основного объема обработки данных. Клиентское приложение формирует запросы к серверу базы данных, как правило, в виде инструкций языка SQL. Сервер извлекает из базы запрошенные данные и передает на компьютер клиента. Главное достоинство такого подхода — значительно меньший объем передаваемых данных.
Большинство конфигураций информационных систем типа «клиент-сервер» использует двухуровневую модель, в которой клиент обращается к серверу.
Безопасность же современных серверов баз данных, организованная в нескольких направлениях: с помощью самой операционной системы; с использованием схем, имен входов, ролей, шифрования базы данных и т. д.; путем ограничения доступа пользователей через представления, заслуживает похвалы. В настоящее время архитектура «клиент-сервер» широко признана и находит применение для организации работы приложений как для рабочих групп, так и для информационных систем масштаба предприятия.
4-й этап. Облачные технологии
Database as a Service (Daas) — концепция предоставления масштабируемой базы данных как сервиса.
Клиент приобретает возможность хранения/получения информации из данной БД без необходимости её настройки, администрирования и привлечения дополнительных ресурсов, требуемых для обеспечения возможности масштабируемости самой БД.
Эволюция моделей данных
Модель данных — это абстрактное, самодостаточное, логическое определение объектов, операторов и прочих элементов, в совокупности составляющих абстрактную машину доступа к данным, с которой взаимодействует пользователь.
Теория СУБД включает, по меньшей мере, три аспекта:
- аспект структуры: методы описания типов и логических структур данных в базе данных;
- аспект обработки: методы манипулирования данными;
- аспект целостности: методы описания и поддержки целостности базы данных.
- cтруктурный аспект — данные в базе воспринимаются пользователем как таблицы (и никак иначе);
- аспект целостности — таблицы отвечают определенным условиям целостности;
- аспект обработки — в распоряжении пользователя есть операторы манипулирования данными (сокращения, проекции, объединения), которые генерируют новые таблицы на основании уже имеющихся.
Иерархическая модель данных
Модель данных, где используется представление базы данных в виде древовидной (иерархической) структуры, состоящей из объектов (данных) различных уровней.
- запись может иметь только одного «предка»;
- возможны отношения только «один к одному» или «один ко многим»;
- невозможность реализации отношения «многие ко многим»;
- проблема дублирования;
- сложность в поддержке.
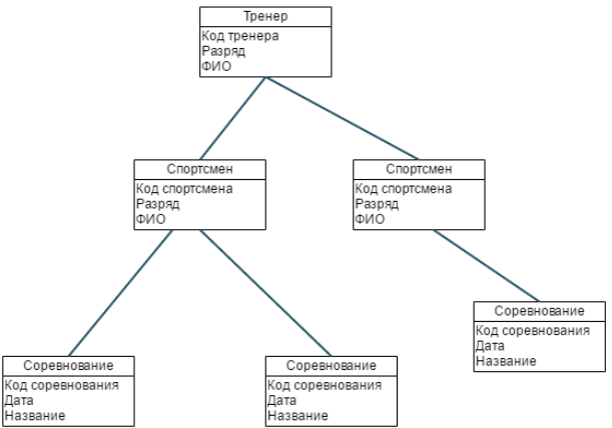
Иерархическая модель, в которой данные были организованы в виде древовидной структуры. Иерархическая модель была востребованной, но не гибкой. В ней каждая запись могла иметь только одного «предка», даже если отдельные записи могли иметь несколько «потомков». Из-за этого базы данных представляли только отношения «один к одному» или «один ко многим». Невозможность реализации отношения «многие ко многим» могла привести к проблемам при работе с данными и усложняла модель. Более того, вопросы консистентности данных и отсутствия дублирования информации здесь вообще не стояли. Первая иерархическая СУБД называлась IMS от IBM.
Сетевая модель данных
Модель данных, являющаяся расширением иерархического подхода, — у потомка может быть любое число предков.
- эффективность реализации по памяти.
- высокая сложность схемы БД;
- «жесткость» схемы БД;
- модель не является полностью независимой от приложения.

Реляционная модель данных
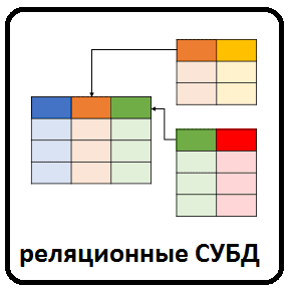
Реляционная модель использует таблицы и базируется на двух утверждениях:
- база данных должна состоять из таблиц и только из таблиц. Только содержимое таблиц определяет операции БД;
- описание данных и манипуляции над ними должны быть независимыми от способа хранения данных на нижнем уровне.
- отсутствие дублирования данных;
- исключение ряда ошибок и аномалий данных, которые есть в других моделях;
- все данные представлены как факты, хранящиеся в виде отношений со столбцами и строками.
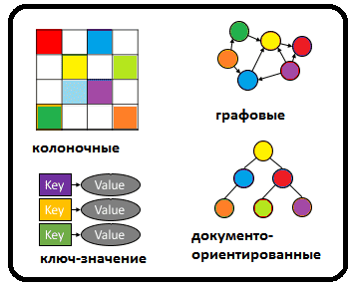
Not Only SQL (4 типа)
- Ключ-значение (Key-value) — наиболее простой вариант хранилища данных, использующий ключ для доступа к значению в рамках большой хэш-таблицы.
- Документно-ориентированное хранилище , в котором данные, представленные парами ключ-значение, сжимаются в виде полуструктурированного документа из тегированных элементов, подобно JSON, XML.
- Колоночное хранилище , которое хранит информацию в виде разреженной матрицы, строки и столбцы которой используются как ключи.
- Графовое хранилище представляют собой сетевую базу, которая использует узлы и рёбра для отображения и хранения данных.
Система управления базами данных (СУБД)
Понятие «База данных»
База данных — это совокупность связанных данных, организованных по определенным правилам, предусматривающим общие принципы описания, хранения и манипулирования, независимая от прикладных программ.
Отличительные признаки БД:
- база данных хранится и обрабатывается в вычислительной системе;
- данные в базе данных логически структурированы (систематизированы);
- база данных включает метаданные, описывающие логическую структуру БД.
Базой данных является представленная в объективной форме совокупность самостоятельных материалов, систематизированных таким образом, чтобы эти материалы могли быть найдены и обработаны с помощью электронной вычислительной машины.
База данных — организованная в соответствии с определенными правилами и поддерживаемая в памяти компьютера совокупность данных, характеризующая актуальное состояние некоторой предметной области и используемая для удовлетворения информационных потребностей пользователей.
База данных — совокупность данных, хранимых в соответствии со схемой данных, манипулирование которыми выполняют в соответствии с правилами средств моделирования данных.
База данных — некоторый набор перманентных (постоянно хранимых) данных, используемых прикладными программными системами какого-либо предприятия.
База данных — совокупность взаимосвязанных данных, совместно хранимых в одном или нескольких компьютерных файлах.
База данных — совместно используемый набор логически связанных данных (и описание этих данных), предназначенный для удовлетворения информационных потребностей организации.
База данных — это совокупность связанных данных, организованных по определенным правилам, предусматривающим общие принципы описания, хранения и манипулирования, независимая от прикладных программ.
Существует множество и других определений, отражающих скорее субъективное мнение тех или иных авторов о том, что означает этот термин в их понимании, однако общепризнанная единая формулировка отсутствует. Наиболее часто используются следующие отличительные признаки:
База данных хранится и обрабатывается в вычислительной системе. Таким образом, любые некомпьютерные хранилища информации (архивы, библиотеки, картотеки и т. п.) базами данных не являются.
Данные в базе данных логически структурированы (систематизированы) с целью обеспечения возможности их эффективного поиска и обработки в вычислительной системе. Структурированность подразумевает явное выделение составных частей (элементов), связей между ними, а также типизацию элементов и связей, при которой с типом элемента (связи) соотносится определенная семантика и допустимые операции.
База данных включает метаданные, описывающие логическую структуру БД в формальном виде (в соответствии с некоторой метамоделью). В соответствии с ГОСТ Р ИСО МЭК ТО 10 032−2007, «постоянные данные в среде базы данных включают в себя схему и базу данных. Схема включает в себя описания содержания, структуры и ограничений целостности, используемые для создания и поддержки базы данных. База данных включает в себя набор постоянных данных, определенных с помощью схемы. Система управления данными использует определения данных в схеме для обеспечения доступа и управления доступом к данным в базе данных».
Из перечисленных признаков только первый является строгим, а другие допускает различные трактовки и различные степени оценки. Можно лишь установить некоторую степень соответствия требованиям к БД.
Многие специалисты указывают на распространенную ошибку, состоящую в некорректном использовании термина база данных вместо термина система управления базами данных. Эти понятия, следовательно, необходимо различать.
СУБД и ее назначение
СУБД — программный комплекс поддержки интегрированной совокупности данных, предназначенный для создания, ведения и использования базы данных несколькими пользователями (прикладными программами).
Основная задача СУБД — дать пользователю базы данных возможность работать с ней не вникая во все подробности работы на уровне аппаратного обеспечения.
SQL — SQL
SQL (( слушайте ) SQL, «продолжение»; язык структурированных запросов ) — это предметно-ориентированный язык, используемый в программировании и предназначенный для управления данными, хранящимися в системе управления реляционными базами данных (RDBMS), или для потоковой обработка в системе управления реляционными потоками данных (RDSMS). Это особенно полезно при обработке структурированных данных, то есть данных, включающих отношения между сущностями и переменными.
SQL предлагает два основных преимущества по сравнению с более старыми API чтения-записи , такими как ISAM или VSAM. Во-первых, он представил концепцию доступа к множеству записей с помощью одной единственной команды. Во-вторых, это избавляет от необходимости указывать, как достичь записи, например с индексом или без него.
Первоначально основанный на реляционной алгебре и кортежном реляционном исчислении, SQL состоит из множества типов операторов, которые можно неофициально классифицировать как подъязыки, обычно: язык запросов данных (DQL), язык определения данных (DDL), язык управления данными (DCL) и язык управления данными (DML). Объем SQL включает запрос данных, манипулирование данными (вставка, обновление и удаление), определение данных (создание и изменение схемы ) и управление доступом к данным. Хотя SQL по сути является декларативным языком (4GL ), он также включает в себя процедурные элементы.
SQL был одним из первых коммерческих языков, в которых использовалась реляционная модель Эдгара Ф. Кодда . Модель была описана в его влиятельной статье 1970 года «Реляционная модель данных для больших общих банков данных». Несмотря на то, что он не полностью придерживался реляционной модели, описанной Коддом, он стал наиболее широко используемым языком баз данных.
SQL стал стандартом американской Национальный институт стандартов (ANSI) в 1986 году и Международной организации по стандартизации (ISO) в 1987 году. С тех пор стандарт был пересмотрен, чтобы включить более широкий набор функций. Несмотря на наличие стандартов, большая часть кода SQL требует по крайней мере некоторых изменений перед переносом в другие системы баз данных.
- 1 История
- 2 Синтаксис
- 3 Процедурные расширения
- 4 Взаимодействие и стандартизация
- 4.1 Обзор
- 4.2 Причины несовместимости
- 4.3 История стандартизации
- 4.4 Текущий стандарт
- 4.4.1 Анатомия стандарта SQL
- 4.4.2 Расширения стандарта ISO / IEC
- 7.1 Дизайн
- 7.2 Другие критические замечания
- 7.2.1 Ортогональность и полнота
- 7.2.2 Нулевой
- 7.2.3 Дубликаты
- 7.2.4 Несовпадение импеданса
- 8.1 Целостность объекта
- 8.2 Целостность домена
- 8.3 Ссылочная целостность
- 8.4 Целостность, определяемая пользователем
- 9.1 Предопределенные типы данных
- 9.2 Сконструированные типы
- 13.1 Документы стандартов SQL
- 13.1.1 Общедоступные стандарты ITTF и технические отчеты
- 13.1.2 Проекты документов
История
Изначально SQL был разработан в IBM от Дональда Д. Чемберлина и Рэймонда Ф. Бойса после изучения реляционной модели от Эдгара Ф. Кодда в начале 1970-х.. Эта версия, первоначально называвшаяся SEQUEL (Structured English Query Language), была разработана для манипулирования и извлечения данных, хранящихся в исходной квазиреляционной системе управления базами данных IBM, которая была создана IBM, группа в Исследовательской лаборатории IBM в Сан-Хосе была разработана в 1970-х годах.
Первой попыткой Чемберлина и Бойса создать язык реляционных баз данных был Square, но его было трудно использовать из-за обозначения индекса. После перехода в исследовательскую лабораторию Сан-Хосе в 1973 году они начали работу над SEQUEL. Акроним SEQUEL позже был изменен на SQL, потому что SEQUEL был товарным знаком компании Великобритании Hawker Siddeley Dynamics Engineering Limited.
После тестирования SQL на тестовых сайтах заказчиков для определения полезности и практичности системы IBM приступила к разработке коммерческих продуктов на основе своего прототипа System R, включая System / 38, SQL / DS, и DB2, которые были коммерчески доступны в 1979, 1981 и 1983 годах соответственно.
В конце 1970-х годов Relational Software, Inc. (сейчас Oracle Corporation ) увидели потенциал концепций, описанных Коддом, Чемберлином и Бойсом, и разработали свою собственную РСУБД на основе SQL и надеялись продать ее США. ВМС, Центральное разведывательное управление и другие США государственные агентства. В июне 1979 года компания Relational Software, Inc. представила первую коммерчески доступную реализацию SQL, Oracle V2 (Version2) для компьютеров VAX.
К 1986 году стандартные группы ANSI и ISO официально приняли стандартное определение языка «Database Language SQL». Новые версии стандарта были опубликованы в 1989, 1992, 1996, 1999, 2003, 2006, 2008, 2011 и, в последний раз, в 2016 году.
Синтаксис
Язык SQL подразделяется на несколько языковых элементов, включая:
- Разделы, которые являются составными компонентами операторов и запросы. (В некоторых случаях это необязательно.)
- Выражения, которые могут давать либо скалярные значения, либо таблицы, состоящие из столбцов и строк данных
- Предикаты, которые определяют условия, которые могут быть оценены с помощью SQL трехзначной логики (3VL) (истина / ложь / неизвестно) или логическогозначения истинности и используются для ограничения эффектов операторов и запросов или для изменения потока программы.
- Запросы, которые извлекают данные на основе определенных критериев. Это важный элемент SQL.
- Операторы, которые могут иметь постоянное влияние на схемы и данные или могут управлять транзакциями, потоком программы, соединениями, сеансами или диагностикой.
- SQL-операторы также содержат символ конца оператора точка с запятой («;»). Хотя он не требуется на каждой платформе, он определен как стандартная часть грамматики SQL.
Процедурные extension
SQL разработан для конкретной цели: запрашивать данные, содержащиеся в реляционной базе данных. SQL — это основанный на наборе, декларативный язык программирования, а не императивный язык программирования, такой как C или BASIC. Однако расширения к стандартному SQL добавляют функции процедурного языка программирования, такие как конструкции управления потоком. К ним относятся:
Источник Аббревиатура Полное имя Стандарт ANSI / ISO SQL / PSM Модули SQL / Persistent Stored Interbase / Firebird PSQL процедурный SQL IBM DB2 SQL PL процедурный язык SQL (реализует SQL / PSM) IBM Informix SPL Сохраненный процедурный язык IBM Netezza NZPLSQL (на основе Postgres PL / pgSQL) Invantive PSQL Invantive Procedural SQL (реализует SQL / PSM и PL / SQL ) MariaDB SQL / PSM, PL / SQL SQL / Persistent Stored Module (реализует SQL / PSM), процедурный язык / SQL (на основе Ada ) Microsoft / Sybase T-SQL Transact-SQL Mimer SQL SQL / PSM SQL / Persistent Stored Module (реализует SQL / PSM) MySQL SQL / PSM SQL / Persistent Stored Module (реализует SQL / PSM) MonetDB SQL / PSM SQL / Persistent Stored Module (реализует SQL / PSM) NuoDB SSP Starkey Stored Процедуры Oracle PL / SQL процедурный язык / SQL (на основе Ada ) PostgreSQL PL / pgSQL процедурный язык / язык структурированных запросов PostgreSQL (на основе сокращенного PL / SQL ) SAP R / 3 ABAP Расширенное программирование бизнес-приложений SAP HANA SQLScript SQLScript Sybase Watcom-SQL SQL Anywhere Watcom-SQL Dialect Teradata SPL Хранимый процедурный язык В дополнение к стандартным расширениям SQL / PSM и проприетарным расширениям SQL, процедурным и объектно-ориентированное программирование доступно на многих платформах SQL через интеграцию СУБД с другими языками. Стандарт SQL определяет расширения SQL / JRT (процедуры и типы SQL для языка программирования Java) для поддержки кода Java в базах данных SQL. Microsoft SQL Server 2005 использует SQLCLR (общеязыковая среда выполнения SQL Server) для размещения управляемых сборок .NET в базе данных, тогда как предыдущие версии SQL Server были ограничены в неуправляемые расширенные хранимые процедуры, в основном написанные на C. PostgreSQL позволяет пользователям писать функции на самых разных языках, включая Perl, Python, Tcl, JavaScript (PL / V8) и C.
Взаимодействие и стандартизация
Обзор
Реализации SQL несовместимы между поставщиками и не обязательно полностью следовать стандартам. В частности, синтаксис даты и времени, конкатенация строк, NULL s и сравнение чувствительность к регистру варьируются от поставщика к поставщику. Конкретными исключениями являются PostgreSQL и Mimer SQL, которые стремятся к соответствию стандартам, хотя PostgreSQL не придерживается стандарта в том, как выполняется сворачивание имен без кавычек. Сворачивание имен без кавычек в нижний регистр в PostgreSQL несовместимо со стандартом SQL, согласно которому имена без кавычек следует переводить в верхний регистр. Таким образом, Foo должен быть эквивалентен FOO , а не foo согласно стандарту.
Популярные реализации SQL обычно не поддерживают базовые функции стандартного SQL, такие как типы данных DATE или TIME . Наиболее очевидными из таких примеров и, кстати, наиболее популярными коммерческими и проприетарными СУБД SQL являются Oracle (чья DATE ведет себя как DATETIME и не имеет типа TIME ) и MS SQL Server (до версии 2008). В результате код SQL редко может быть перенесен между системами баз данных без изменений.
Причины несовместимости
Существует несколько причин отсутствия переносимости между системами баз данных:
- Сложность и размер стандарта SQL означает, что большинство разработчиков не поддерживают весь стандарт.
- Стандарт не определяет поведение базы данных в нескольких важных областях (например, индексы, файловое хранилище. ), оставляя реализациям решать, как себя вести.
- SQL Стандарт точно определяет синтаксис, который должна реализовать соответствующая система баз данных. Однако стандартная спецификация семантики языковых конструкций менее четко определена, что приводит к двусмысленности.
- Многие поставщики баз данных имеют большие существующие базы клиентов; там, где более новая версия стандарта SQL конфликтует с предыдущим поведением базы данных поставщика, поставщик может не желать нарушать обратную совместимость.
- У поставщиков мало коммерческих стимулов, чтобы облегчить пользователям смену поставщиков базы данных (см. привязка к поставщику ).
- Пользователи, оценивающие программное обеспечение баз данных, обычно ставят другие факторы, такие как производительность, выше в свои приоритеты, чем соответствие стандартам.
История стандартизации
До 1996 года программа стандартов управления данными Национального института стандартов и технологий (NIST) сертифицировала соответствие СУБД SQL стандарту SQL. Теперь поставщики самостоятельно -проверить соответствие t наследственные продукты.
Исходный стандарт объявил, что официальное произношение для «SQL» было инициализмом : («ess cue el»). Тем не менее, многие англоговорящие специалисты по базам данных (включая Дональда Чемберлина ) используют акроним -подобное произношение («продолжение»), отражая название предварительной версии языка, «SEQUEL».. Стандарт SQL претерпел ряд изменений:
Год Имя Псевдоним Комментарии 1986 SQL-86 SQL-87 Впервые формализована ANSI. 1989 SQL-89 FIPS 127-1 Незначительная редакция, добавляющая ограничения целостности, принятая как FIPS 127-1. 1992 SQL-92 SQL2, FIPS 127-2 Основная версия (ISO 9075), начальный уровень SQL-92 принят как FIPS 127-2. 1999 SQL: 1999 SQL3 Добавлено сопоставление регулярных выражений, рекурсивные запросы (например, транзитивное замыкание ), триггеры, поддержка процедурных операторов и операторов управления потоком, нескалярных типов (массивов) и некоторых объектно-ориентированных функций (например, структурированных типов ). Поддержка встраивания SQL в Java (SQL / OLB ) и наоборот (SQL / JRT ). 2003 SQL: 2003 Введены функции, связанные с XML (SQL / XML ), оконные функции, стандартизованные последовательности и столбцы с автоматически сгенерированными значениями (включая идентификационные столбцы). 2006 SQL: 2006 ISO / IEC 9075-14: 2006 определяет способы использования SQL с XML. Он определяет способы импорта и хранения данных XML в базе данных SQL, управления ими в базе данных и публикации как XML, так и обычных данных SQL в форме XML. Кроме того, он позволяет приложениям интегрировать запросы в свой код SQL с помощью XQuery, языка запросов XML, опубликованного Консорциумом World Wide Web (W3C ), для одновременного доступа к обычным данным SQL и XML-документы. 2008 SQL: 2008 Легализует определения ORDER BY за пределами курсора. Добавляет триггеры INSTEAD OF, оператор TRUNCATE, предложение FETCH. 2011 SQL: 2011 Добавляет временные данные (PERIOD FOR) (дополнительная информация: Temporal database # History ). Улучшения для оконных функций и предложения FETCH. 2016 SQL: 2016 Добавляет сопоставление шаблонов строк, полиморфные табличные функции, JSON. 2019 SQL: 2019 Добавляет Часть 15, многомерные массивы (тип и операторы MDarray). Текущий стандарт
Стандарт обычно обозначается шаблоном: ISO / IEC 9075-n: yyyy Part n: title, или, сокращенно, ISO / IEC 9075.
ISO / IEC 9075 дополняется ISO / IEC 13249: SQL Multimedia and Application Packages (SQL / MM), который определяет интерфейсы и пакеты на основе SQL для широко распространенных приложений, таких как видео, аудио и пространственные данные. Заинтересованные стороны могут приобрести документы стандартов SQL в ISO, IEC или ANSI. Черновик SQL: 2008 находится в свободном доступе в виде архива zip.
Анатомия стандарта SQL
Стандарт SQL разделен на десять частей. Имеются пробелы в нумерации из-за вывода устаревших деталей.
- ISO / IEC 9075-1: 2016, часть 1: Framework (SQL / Framework). Он предоставляет логические концепции.
- ISO / IEC 9075-2: 2016 Часть 2: Foundation (SQL / Foundation). Он содержит наиболее важные элементы языка и состоит как из обязательных, так и из дополнительных функций.
- ISO / IEC 9075-3: 2016 Часть 3: Интерфейс на уровне вызовов (SQL / CLI ). Он определяет сопрягающие компоненты (структуры, процедуры, привязки переменных), которые могут использоваться для выполнения операторов SQL из приложений, написанных на Ada, C соответственно C ++, COBOL, Fortran, MUMPS, Pascal или PL / I. (Для Java см. Часть 10.) SQL / CLI определен таким образом, что операторы SQL и вызовы процедур SQL / CLI обрабатываются отдельно от исходного кода вызывающего приложения. Открытые возможности подключения к базам данных — это хорошо известная расширенная версия SQL / CLI. Эта часть стандарта состоит исключительно из обязательных функций.
- ISO / IEC 9075-4: 2016 Часть 4: Постоянно хранимые модули (SQL / PSM ). Он стандартизирует процедурные расширения для SQL, включая поток управления, обработку условий, сигналы условий оператора и отмены, курсоры и локальные переменные, а также присвоение выражений переменным и параметрам. Кроме того, SQL / PSM формализует объявление и обслуживание постоянных подпрограмм языка базы данных (например, «хранимых процедур»). Эта часть стандарта состоит исключительно из дополнительных функций.
- ISO / IEC 9075-9: 2016 Часть 9: Управление внешними данными (SQL / MED ). Он предоставляет расширения для SQL, которые определяют оболочки сторонних данных и типы каналов данных, позволяющие SQL управлять внешними данными. Внешние данные — это данные, которые доступны СУБД на базе SQL, но не управляются ею. Эта часть стандарта состоит исключительно из дополнительных функций.
- ISO / IEC 9075-10: 2016 Часть 10: Привязки объектного языка (SQL / OLB ). Он определяет синтаксис и семантику SQLJ, который является SQL, встроенным в Java (см. Также часть 3). Стандарт также описывает механизмы, обеспечивающие двоичную переносимость приложений SQLJ, и определяет различные пакеты Java и содержащиеся в них классы. Эта часть стандарта состоит исключительно из дополнительных функций. В отличие от SQL / OLB JDBC определяет API и не является частью стандарта SQL.
- ISO / IEC 9075-11: 2016 Часть 11: Информация и схемы определения (SQL / схема ). Он определяет информационную схему и схему определения, предоставляя общий набор инструментов для самоописания баз данных и объектов SQL. Эти инструменты включают идентификатор объекта SQL, ограничения структуры и целостности, спецификации безопасности и авторизации, функции и пакеты стандарта ISO / IEC 9075, поддержку функций, предоставляемых реализациями СУБД на основе SQL, информацию о реализации СУБД на основе SQL и элементы определения размеров, а также значения, поддерживаемые реализациями СУБД. Эта часть стандарта содержит как обязательные, так и дополнительные функции.
- ISO / IEC 9075-13: 2016 Часть 13: Процедуры и типы SQL с использованием языка программирования Java TM (SQL / JRT ). Он определяет возможность вызова статических методов Java как подпрограмм из приложений SQL («Java-in-the-database»). Это также требует возможности использовать классы Java в качестве структурированных пользователем типов SQL. Эта часть стандарта состоит исключительно из дополнительных функций.
- ISO / IEC 9075-14: 2016 Часть 14: Спецификации, связанные с XML (SQL / XML ). Он определяет расширения на основе SQL для использования XML в сочетании с SQL. Представлен тип данных XML, а также несколько процедур, функций и сопоставлений типов данных XML-SQL для поддержки обработки и хранения XML в базе данных SQL. Эта часть стандарта состоит исключительно из дополнительных функций.
- ISO / IEC 9075-15: 2019 Часть 15: Многомерные массивы (SQL / MDA). Он определяет тип многомерного массива (MDarray) для SQL, а также операции с MDarrays, срезами MDarray, ячейками MDarray и связанными функциями. Эта часть стандарта состоит исключительно из дополнительных функций.
Расширения стандарта ISO / IEC
ISO / IEC 9075 дополняются мультимедийными и прикладными пакетами ISO / IEC 13249 SQL. Этот тесно связанный, но отдельный стандарт разработан тем же комитетом. Он определяет интерфейсы и пакеты на основе SQL. Целью является унифицированный доступ к типичным приложениям баз данных, таким как текст, изображения, интеллектуальный анализ данных или пространственные данные.
- ISO / IEC 13249-1: 2016 Часть 1: Framework
- ISO / IEC 13249-2 : 2003 Часть 2: Полнотекстовый
- ISO / IEC 13249-3: 2016 Часть 3: Пространственный
- ISO / IEC 13249-5: 2003 Часть 5: Неподвижное изображение
- ISO / IEC 13249-6: 2006 Часть 6: Интеллектуальный анализ данных
- ISO / IEC 13249-7: 2013 Часть 7: История
- ISO / IEC 13249-8: xxxx Часть 8: Метаданные Доступ к реестру MRA (в стадии разработки)
ISO / IEC 9075 также сопровождается серией технических отчетов, опубликованных как ISO / IEC TR 19075 в 8 частях. В этих технических отчетах объясняется обоснование и использование некоторых функций SQL, приводя примеры, где это необходимо. Технические отчеты не являются нормативными; если есть какие-либо расхождения с 9075, текст в 9075 остается в силе. В настоящее время доступны следующие технические отчеты 19075:
- ISO / IEC TR 19075-1: 2011 Часть 1: Поддержка регулярных выражений XQuery в SQL
- ISO / IEC TR 19075-2: 2015 Часть 2: Поддержка SQL для времени -Связанная информация
- ISO / IEC TR 19075-3: 2015 Часть 3: SQL, встроенный в программы с использованием языка программирования Java
- ISO / IEC TR 19075-4: 2015 Часть 4: SQL с Подпрограммы и типы с использованием языка программирования Java
- ISO / IEC TR 19075-5: 2016 Часть 5: Распознавание шаблонов строк в SQL
- ISO / IEC TR 19075-6: 2017 Часть 6: SQL поддержка нотации объектов JavaScript (JSON)
- ISO / IEC TR 19075-7: 2017 Часть 7: Полиморфные табличные функции в SQL
- ISO / IEC TR 19075-8: 2019 Часть 8: Multi -Массивы измерений (SQL / MDA)
Альтернативы
Следует проводить различие между альтернативами SQL как языку и альтернативами самой реляционной модели. Ниже предлагаются реляционные альтернативы языку SQL. См. навигационная база данных и NoSQL для получения информации об альтернативах реляционной модели.
- .QL : объектно-ориентированный журнал данных
- 4D Query Language (4D QL)
- Datalog : критики предполагают, что Datalog имеет два преимущества перед SQL: он имеет более чистую семантику, которая облегчает понимание и обслуживание программ, и является более выразительным, в частности, для рекурсивных запросов.
- HTSQL : метод запроса на основе URL
- IBM Business System 12 (IBM BS12) : одна из первых полностью реляционных систем управления базами данных, представленная в 1982 году.
- ISBL
- jOOQ : SQL, реализованный в Java как внутренний предметно-ориентированный язык
- Java Persistence Query Language (JPQL): язык запросов, используемый Java Persistence API и Hibernate библиотекой сохраняемости
- JavaScript : MongoDB реализует свой язык запросов в JavaScript API.
- LINQ : запускает операторы SQL, написанные как языковые конструкции, для запроса коллекций непосредственно из кода .Net.
- Язык объектных запросов
- Создан QBE (Query By Example ) автор: Moshè Z loof, IBM 1977
- Quel, представленный в 1974 году U.C. Проект Berkeley Ingres.
- Учебник D
- XQuery
Распределенная обработка SQL
Архитектура распределенной реляционной базы данных (DRDA) была разработана рабочей группой внутри IBM в период с 1988 по 1994 год. DRDA обеспечивает работу в сети подключенные реляционные базы данных для взаимодействия для выполнения запросов SQL.
Интерактивный пользователь или программа могут выдавать операторы SQL в локальную RDB и получать таблицы данных и индикаторы состояния в ответ от удаленных RDB. Операторы SQL также могут быть скомпилированы и сохранены в удаленных RDB как пакеты, а затем вызваны по имени пакета. Это важно для эффективной работы прикладных программ, которые выдают сложные высокочастотные запросы. Это особенно важно, когда таблицы, к которым нужно получить доступ, находятся в удаленных системах.
Сообщения, протоколы и структурные компоненты DRDA определены Архитектурой управления распределенными данными.
Критика
Дизайн
SQL по-разному отличается от его теоретическая основа, реляционная модель и ее кортежное исчисление. В этой модели таблица представляет собой набор кортежей, тогда как в SQL таблицы и результаты запросов представляют собой списки строк: одна и та же строка может встречаться несколько раз, и порядок строк могут использоваться в запросах (например, в разделе LIMIT).
Критики утверждают, что SQL следует заменить языком, который строго возвращается к исходной основе: например, см. Третий манифест. Однако не существует известных доказательств того, что такую уникальность нельзя добавить к самому SQL или, по крайней мере, к его разновидности. Другими словами, вполне возможно, что SQL можно «исправить» или, по крайней мере, улучшить в этом отношении, так что отрасли, возможно, не придется переключаться на совершенно другой язык запросов для получения уникальности. Дебаты по этому поводу остаются открытыми.
Другая критика
Чемберлин обсуждает четыре исторических критических замечания SQL в статье 2012 года:
Ортогональность и полнота
Ранние спецификации не поддерживали основные функции, такие как как первичные ключи. Наборы результатов не могут быть названы, а подзапросы не определены. Они были добавлены в 1992 году.
Нулевой
Концепция Нулевого является предметом некоторых споров. Маркер Null указывает на отсутствие значения, даже 0 для целочисленного столбца или строки длины 0 для текстового столбца. Концепция Nulls применяет 3-значную логику в SQL, которая является конкретной реализацией общей 3-значной логики.
Duplicates
Другой популярной критикой является то, что он позволяет дублировать строки, обеспечивая интеграцию с такими языками, как Python, типы данных которых могут затруднять точное представление данных, что затрудняет синтаксический анализ и отсутствие модульности.
Этого можно избежать, объявляя уникальное ограничение с одним или несколькими полями, которые однозначно идентифицируют строку в таблице. Это ограничение также может стать первичным ключом таблицы.
Несоответствие импеданса
В смысле, аналогичном Объектно-реляционное несоответствие импеданса, существует несоответствие между декларативным языком SQL и процедурными языками, в которые обычно встроен SQL..
Категории целостности данных
Основные категории целостности данных каждой СУБД.
Целостность сущности
Устанавливает, что в таблице первичный ключ имеет уникальное значение для каждой строки, проверяя уникальность значения первичного ключа, избегая дублирования строк в таблице.
Целостность домена
Ограничивает тип, формат и диапазон значений, которые применяются к допустимым записям для столбца в таблице
Ссылочная целостность
Создает строки в таблице, которые используются другими записями, невозможно удалить
Заданная пользователем целостность
Применяются другие особые правила, не указанные выше
Типы данных SQL
Стандарт SQL определяет три типа типов данных:
- предопределенные типы данных
- сконструированные типы
- определяемые пользователем типы.
предопределенные типы данных
- символьные типы
- Символ (CHAR)
- Изменение символа (VARCHAR)
- Большой объект символа (CLOB)
- Двоичные типы
- Двоичный (BINARY)
- Изменение двоичного значения (VARBINARY)
- Большой двоичный объект (BLOB)
- Числовые типы
- Точные числовые типы (NUMERIC, DECIMAL, SMALLINT, INTEGER, BIGINT)
- Приблизительные числовые типы (FLOAT, REAL, DOUBLE PRECISION)
- Типы даты и времени (DATE, TIME, TIMESTAMP)
- Тип интервала (INTER VAL)
- Boolean
- XML
- JSON
Сконструированные типы
Сконструированные типы — это один из ARRAY, MULTISET, REF (erence) или ROW. Типы, определяемые пользователем, сопоставимы с классами объектно-ориентированного языка со своими собственными конструкторами, наблюдателями, мутаторами, методами, наследованием, перегрузкой, перезаписью, интерфейсами и т. Д.
См. Также
- Реляционная база данных
- Объектная база данных
- Объектно-реляционная база данных
- Список систем управления реляционными базами данных
- Сравнение систем управления реляционными базами данных
- Сравнение объектных- системы управления реляционными базами данных
- D (спецификация языка данных)
- D4 (язык программирования)
- Пример запроса
- синтаксис SQL
- Oracle PL / SQL
- Microsoft Transact-SQL (T-SQL)
- Онлайн-обработка транзакций (OLTP)
- Онлайн-аналитическая обработка (OLAP)
- Хранилище данных
- Система управления реляционными потоками данных
- NoSQL
- MUMPS
- Иерархическая модель
- Схема звезды
- Схема снежинки
Примечания
Ссылки
Источники
документы стандартов SQL
общедоступные стандарты и технические отчеты ITTF
ISO /IEC Целевая группа по информационным технологиям публикует общедоступные стандарты, включая SQL. Здесь публикуются Технические исправления (исправления) и Технические отчеты (документы для обсуждения).
Черновики документов
Формальные стандарты SQL доступны в ISO и ANSI за плату.. Для информативного использования, в отличие от строгого соблюдения стандартов, часто бывает достаточно поздних черновиков.
Внешние ссылки
- Воссоединение SQL: люди, проекты и политика, 1995 г., Пол МакДжонс (ред.) : стенограмма встречи, посвященной воссоединению к личной истории реляционных баз данных и SQL.
- Американский национальный институт стандартов. X3H2 Records, 1978–1995Институт Чарльза Бэббиджа Коллекция документирует разработку комитетом H2 стандартов NDL и SQL.
- Устное интервью по истории с Дональдом Д. ЧемберлиномЧарльз Бэббидж Институт В этой устной истории Чемберлин рассказывает о своей молодости, своем образовании в Колледже Харви Мадда и Стэнфордском университете, а также о своей работе над технологией реляционных баз данных. Чемберлин был членом исследовательской группы System R и вместе с Рэймондом Ф. Бойсом разработал язык баз данных SQL. Чемберлин также кратко обсуждает свои недавние исследования языков запросов XML.
- Сравнение различных реализаций SQL Это сравнение различных реализаций SQL предназначено для того, чтобы служить руководством для тех, кто заинтересован в переносе кода SQL между различными продуктами СУБД, и включает сравнения между SQL: 2008, PostgreSQL, DB2, MS SQL Server, MySQL, Oracle и Informix.
- Обработка потока событий с помощью SQL — Введение в обработку потоковых данных в реальном времени с помощью непрерывных SQL-запросов
- Грамматика BNF для ISO / IEC 9075: 2003, часть 2 SQL / Framework