
Ошибки #ПЕРЕНОС! ошибка — выходит за границу листа
Формула с пролитой массивом, в который вы попытались ввести формулу, выходит за пределы диапазона. Попробуйте еще раз с небольшим диапазоном или массивом.
В следующем примере при перемещении формулы в ячейку F1 ошибка будет исправлена, и формула будет переносима правильно.
Распространенные причины: полные ссылки на столбцы
При создании формул в lookup_value в них часто неправильно засоряются. Перед динамическим массивом Приложение Excel учитывало только значение в той же строке, что и формулу, и игнорировало все остальные, так как при функции ВЛОП ожидалось только одно значение. При вводе динамических массивов Excel рассматривает все значения, предоставляемые lookup_value. Это означает, что если в качестве аргумента lookup_value столбец, Excel попытается найти все 1 048 576 значений в столбце. Когда все будет готово, он попытается пролить их на сетку и, скорее всего, зажмет #SPILL! ошибка «#ЗНАЧ!».
Например, при размещении в ячейке E2, как по примеру ниже, формула =ВЛОЖЕННАЯ(A:A;A:C;2;ЛОЖЬ) ранее только подыскала бы ИД в ячейке A2. Однако в динамическом массиве Excel формула приведет к #SPILL! из-за того, что Excel подытнет весь столбец, отвернет результат с результатом 1 048 576 и пожмет в конце сетки Excel.
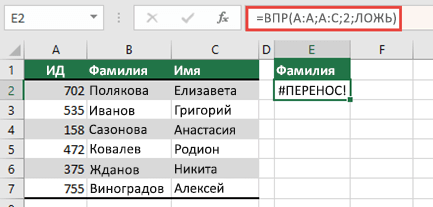
Существует три простых способа решения этой проблемы:
Ссылаясь только на значения подпапок, которые вас интересуют. Этот стиль формулы возвращает динамический массив, ноне работает с таблицами Excel.
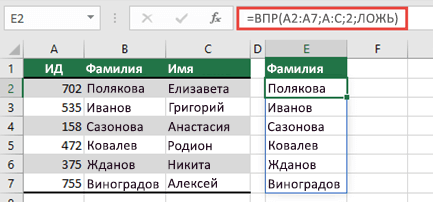
Ссылаясь только на значение в той же строке, скопируйте формулу вниз. Этот традиционный стиль формул работает в таблицах,но не возвращаетдинамический массив.
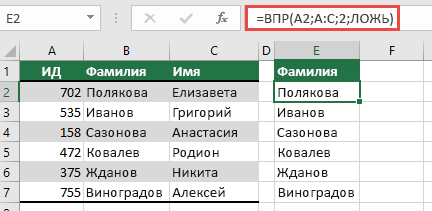
=В ПРОСМОТР(A2;A:C;2;ЛОЖЬ)
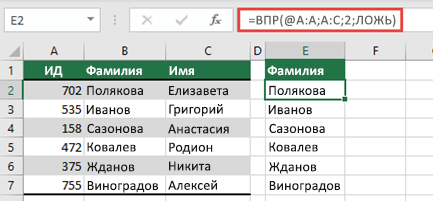
Запрос на выполнение неявного пересечения с помощью оператора @ и копирование формулы вниз. Этот стиль формулы работает в таблицах,но не возвращаетдинамический массив.
Дополнительные сведения
Вы всегда можете задать вопрос специалисту Excel Tech Community, попросить помощи в сообществе Answers community, а также предложить новую функцию или улучшение на веб-сайте Excel User Voice.
Spill-файлы в Greenplum

Если вы читаете эту статью, скорее всего, с некоторой периодичностью сталкиваетесь со spill-файлами, а может, и генерируете их. В сети мало статей и постов на эту тему, поэтому я решил написать здесь всё, что знаю о спиллах, о том, как понять, что они есть в запросе, и как их избежать.
Меня зовут Николай, я BI-аналитик. Одна из моих рабочих задач — написание запросов к GreenPlum, причем таких, которые не уронят базу и не навлекут админский гнев.
Мне нравится создавать хорошие процессы и совершенствовать существующие.
Не буду подробно останавливаться на каких-то базовых понятиях работы с GreenPlum, предполагаю, что вы знакомы с планом запроса и основными методами оптимизации запросов.
Все примеры буду показывать на двух таблицах.
Первая таблица — prod_wrk.applications. Содержит 1 831 606 562 строк. DDL:
CREATE TABLE prod_wrk.applications ( id bigint, first_name character varying(32), last_name character varying(32), patronymic character varying(60), birth_dt timestamp(0) without time zone, phone_mobile character varying(16), phone_work character varying(16), additional_work_phone character varying(16), phone_home character varying(16), additional_phone_home character varying(16), email character varying(50), region character varying(255), product_category character varying(50), dt_created timestamp(0) without time zone, some_foreign_key_1 character varying(255), some_foreign_key_2 character varying(255), some_foreign_key_3 character varying(255), some_foreign_key_4 character varying(255), some_foreign_key_5 character varying(255), some_foreign_key_6 character varying(255), some_foreign_key_7 character varying(255), some_foreign_key_8 character varying(255), some_foreign_key_9 character varying(255), some_foreign_key_10 character varying(255), some_foreign_key_11 character varying(255), some_foreign_key_12 character varying(255), some_foreign_key_13 character varying(255), some_foreign_key_14 character varying(255), some_foreign_key_15 character varying(255), some_foreign_key_16 character varying(255), some_foreign_key_17 character varying(255), ) WITH (APPENDONLY=true, ORIENTATION=column, COMPRESSTYPE=quicklz) DISTRIBUTED BY (id)Вторая таблица формата key-param-value — prod_wrk.applications_extra_fields. Содержит 4 328 017 строк. DDL:
CREATE TABLE prod_wrk.applications_extra_fields ( id bigint, name character varying(100), value character varying(255) ) WITH (APPENDONLY=true, ORIENTATION=column, COMPRESSTYPE=quicklz) DISTRIBUTED BY (id)Немного о spill-файлах
Spill-файлы, спиллы — это некоторый генерируемый дополнительный объем данных на жестком диске, который используется для выполнения запроса.
Спиллы появляются, когда для запроса нужно хранить данных больше, чем предоставлено оперативной памятью. Например, есть запрос, который для выполнения требует 650 Гб рабочей памяти, однако под запрос выделено 500 Гб оперативной памяти. В итоге 650 − 500 = 150 Гб — столько требуется сверх оперативной памяти. Именно этот объем сгенерируется в виде спиллов.
Почему плохо, когда спиллов становится много?
Страдаете вы. Спиллы хранятся на жестком диске, а скорость чтения и записи с жесткого диска в разы меньше, чем из оперативной памяти. Из-за этого увеличивается время выполнения вашего запроса.
Страдают другие пользователи. Пока выполняется ваш запрос, другие пользователи долго ждут своей очереди к ресурсам хранилища. Очередь к ресурсам растягивается, и пользователи с оптимизированными запросами получат результаты лишь к середине рабочего дня.
Страдают админы и хранилище в целом. Представьте, что в вашем GreenPlum 250 Тб данных. Если 20 пользователей запустят запросы, где каждый в среднем нагенерит 2,5 Тб спиллов, то в итоге около 1/6 (50 Тб) данных в хранилище занято временными файлами на один раз, а ведь это место в будущем будут занимать какие-то полезные для аналитики данные. И если такие запросы останутся, то начнутся проблемы с памятью.
В идеале запрос не должен содержать спиллов, но допускается их небольшой объем. Спиллы сами по себе не зло, а гибкий метод выполнения запроса несмотря на ограничение по объему оперативной памяти. Зло — когда их становится слишком много. Особенное зло — когда их слишком много на небольшом GreenPlum.
Отлов и подсчет спиллов
Узнать, сколько точно спиллов генерирует запрос, нельзя. Можно узнать лишь объем сгенерированных спиллов на текущий момент или примерно оценить через EXPLAIN ANALYZE.
Способ № 1. При помощи системной таблицы gp_toolkit.gp_workfile_usage_per_query
В системной таблице хранятся данные: кто, каким запросом и сколько сгенерировал спиллов в каждом сегменте.
Пользователям эта таблица будет интересна в целях самоконтроля и проверки собственных запросов. Администраторам она будет интересна для выявления запросов с большим объемом спиллов, ограничения количества таких запросов и наказания пользователей, которые генерируют чрезмерно много спиллов. Например, на основе этой таблицы можно написать скрипт, который с некоторой периодичностью будет проверять запросы, работающие на текущий момент, и убивать те запросы, объем спиллов в которых превышает штрафное значение.
Пример запроса с использованием gp_toolkit.gp_workfile_usage_per_query. Так можно узнать количество и объем в Гб спиллов, которые были сгенерированы вашими запросами на текущий момент.
select current_query ,sum(size) / 1024 / 1024 / 1024 :: float size_spill_files_gb ,sum(numfiles) count_spill_files from gp_toolkit.gp_workfile_usage_per_query where usename = current_user group by current_queryПлюсы
- Показывает точный объем спиллов.
Минусы
- Показывает объем лишь на текущий момент. Возможна ситуация, когда запрос генерирует спиллы в какой-то промежуток времени, а запрос с gp_toolkit.gp_workfile_usage_per_query запущен вне данного промежутка. Таким образом можно сделать ошибочный вывод, что запрос не генерирует спиллы.
- Нельзя узнать проблемное место в запросе.
Способ № 2. При помощи команды EXPLAIN ANALYZE
Работу с EXPLAIN ANALYZE я покажу на пример. Имеем следующий запрос, который генерирует спиллы:
select aef.name ,aef.value ,aef.id ,a.* from prod_wrk.applications_extra_fields as aef left join prod_wrk.applications as a on aef.id = a.idИспользуем вместе с ним команду EXPLAIN ANALYZE, а во время выполнения запроса параллельно будем вызывать gp_toolkit.gp_workfile_usage_per_query. Используя постоянный спам запроса с gp_toolkit.gp_workfile_usage_per_query выясняем, что во время запроса было сгенерировано около 344 Гб спиллов:

Теперь изучим план запроса от EXPLAIN ANALYZE, спускаемся в самый низ, в секцию Slice statistic. Обратите внимание на слайс № 1:

Если хотя бы один слайс помечен звездочкой *, значит, при выполнении запроса происходила генерация спилл-файлов. При этом примерный объем сгенерированных спиллов одним сегментом написан возле bytes wanted. В данном случае сгенерировано 4 014 945 Кб, то есть примерно 3,82 Гб, а так как сегментов у нас 144, то выходит объем примерно в 550 Гб. Если слайсов со звездочкой больше одного, то нужно суммировать все значения bytes wanted. За счет слайсов со звездочкой можно понять, из-за какой таблицы происходит генерация спиллов. Это очень удобно, если джойнов у вас больше двух.
Способ № 1 нам показал объем спиллов 344 Гб, а по способу № 2 — 550 Гб. Почему же так? Дело в том, что EXPLAIN ANALYZE делает лишь примерную оценку требуемой памяти. Подсчет вторым способом можно принять как нижнюю оценку требуемого объема памяти, то есть можно утверждать, что для выполнения данного запроса потребуется сгенерировать минимум 550 Гб спилл-файлов.
Плюсы
- Можно с достаточно высокой точностью узнать проблемное место в запросе.
Минусы
- EXPLAIN ANALYZE требует полного выполнения запроса. Если запрос ужасный и убивается администраторами, способ не сработает.
- Позволяет примерно оценить объем спиллов.
Основные причины генерации spill-файлов и их устранение
Причина возникновения спиллов всегда одна — нехватка оперативной памяти. Способов вызвать дефицит существует несколько. Вот несколько замеченных:
- обработка огромного объема данных без фильтров;
- создание хэш-таблицы на основе таблицы большого объема;
- DISTINCT на большом количестве полей;
- использование ORDER BY.
Каждый случай разберу подробнее и объясню, как правильно в них поступать.
Кейс № 1. Обработка огромного объема данных без фильтров
Один из простых случаев обнаружения и устранения спиллов.
Когда происходит джоин, данные из одной таблицы помещаются в хэш-таблицу, которая занимает место в оперативной памяти.
Если данные помещаемой таблицы никак не отфильтрованы, по сути, вы будете пытаться затолкать всю витрину данных в оперативную память. Не факт, что она поместится в память. А даже если и поместится, нужно будет куда-то записать результаты джоина, опять же, места может не хватить — и начнется генерация спиллов.
Как решается. Используйте фильтры, особенно фильтры на даты и время. Очень сомнительно, что может возникнуть необходимость провести аналитику по всему объему данных за всё время. Если нужна аналитика от начала времен, создайте несколько запросов, в которых будут обрабатываться разные временные промежутки, и их результаты объедините при помощи UNION ALL. Серия запросов на ограниченных промежутках данных будет эффективнее, чем попытка обработать все разом.
Кейс № 2. Создание хэш-таблицы на основе таблицы большого объема
Отчасти данный кейс схож с предыдущим кейсом, однако он может возникнуть и при фильтрации таблиц.
Объем данных, помещаемых в хэш-таблицу зависит от двух вещей: количества строк и кол-ва вытаскиваемых полей.
При INNER JOIN хэш-таблица формируется на основе таблицы с меньшим объемом строк. Логично, ведь лучше держать в оперативной памяти меньший объем данных. Однако это правило не работает при LEFT JOIN — при таком соединении хэш-таблица всегда строится на основе правой таблицы, несмотря на ее объем.

Таким образом, мы можем ненароком поместить в оперативную память большую таблицу, если пропишем конструкцию вида «маленькая_таблица LEFT JOIN большая_таблица», чем забьем оперативную память и начнем генерировать спиллы.
Также все зависит от вызываемых в SELECT, WHERE и условии джойна количества полей в большой таблице. Чем их больше — тем больший объем оперативной памяти будет занят.
Рассмотрим запрос из примера № 1:
select aef.name ,aef.value ,aef.id ,a.* from prod_wrk.applications_extra_fields as aef left join prod_wrk.applications as a on aef.id = a.idВ начале статьи я упоминал, что объем строк в таблице prod_wrk.applications — 1 831 606 562, а в таблице prod_wrk.applications_extra_fields 4 328 017 строк. EXPLAIN ANALYZE данного запроса представлен ниже:
QUERY PLAN Gather Motion 144:1 (slice1; segments: 144) (cost=0.00..238481.48 rows=8656034 width=654) Rows out: 4328017 rows at destination with 24367 ms to first row, 65561 ms to end. -> Hash Left Join (cost=0.00..225847.13 rows=60112 width=654) Hash Cond: applications_extra_fields.id = applications.id Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 33702 ms to first row, 48803 ms to end. Executor memory: 1003773K bytes avg, 1005792K bytes max (seg97). Work_mem used: 1003773K bytes avg, 1005792K bytes max (seg97). Workfile: (144 spilling) Work_mem wanted: 4011233K bytes avg, 4014945K bytes max (seg115) to lessen workfile I/O affecting 144 workers. (seg115) Initial batch 0: (seg115) Wrote 2899696K bytes to inner workfile. (seg115) Wrote 1248K bytes to outer workfile. (seg115) Initial batches 1..3: (seg115) Read 2899005K bytes from inner workfile: 966335K avg x 3 nonempty batches, 967097K max. (seg115) Read 1261K bytes from outer workfile: 421K avg x 3 nonempty batches, 423K max. (seg115) Hash chain length 3.2 avg, 16 max, using 3991901 of 4194304 buckets. -> Table Scan on applications_extra_fields (cost=0.00..431.84 rows=30056 width=37) Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 29 ms to first row, 37 ms to end. -> Hash (cost=4845.30..4845.30 rows=12719490 width=617) Rows in: Avg 3180162.9 rows x 144 workers. Max 3185478 rows (seg83) with 38691 ms to end, start offset by 15 ms. -> Table Scan on applications (cost=0.00..4845.30 rows=12719490 width=617) Rows out: Avg 12719490.0 rows x 144 workers. Max 12719888 rows (seg57) with 8.758 ms to first row, 16397 ms to end. Slice statistics: (slice0) Executor memory: 582K bytes. (slice1) * Executor memory: 1471761K bytes avg x 144 workers, 1471867K bytes max (seg117). Work_mem: 1005792K bytes max, 4014945K bytes wanted. Statement statistics: Memory used: 2555904K bytes Memory wanted: 4015344K bytes Settings: gp_enable_relsize_collection=on; optimizer_join_arity_for_associativity_commutativity=18 Optimizer status: PQO version 3.111.0 Total runtime: 65731.204 msИз плана видно, что:
- хэш строится на огромную таблицу applications;
- генерируются спиллы на первом слайсе;
- время выполнения — 65 секунд.
Как решается. Способов избавиться от спиллов несколько. Первый из них и самый наивный — уменьшить объем таблицы, которая помещается в хэш. Этого можно добиться путем уменьшения количества строк с помощью фильтрации либо уменьшения извлекаемых полей, так как вряд ли для анализа требуется весь атрибутный состав витрины. Изменим запрос, уменьшив количество извлекаемых полей из таблицы applications:
select aef.name ,aef.value ,aef.id ,a.dt_created ,a.product_category ,a.some_foreign_key_1 from prod_wrk.applications_extra_fields as aef left join prod_wrk.applications as a on aef.id = a.idПлан данного запроса представлен ниже:
QUERY PLAN Gather Motion 144:1 (slice1; segments: 144) (cost=0.00..24457.91 rows=8656034 width=74) Rows out: 4328017 rows at destination with 8567 ms to first row, 18771 ms to end. -> Hash Left Join (cost=0.00..23028.33 rows=60112 width=74) Hash Cond: applications_extra_fields.id = applications.id Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 9182 ms to first row, 9849 ms to end. Executor memory: 561745K bytes avg, 561825K bytes max (seg118). Work_mem used: 561745K bytes avg, 561825K bytes max (seg118). Workfile: (0 spilling) (seg125) Hash chain length 1.9 avg, 11 max, using 6547487 of 8388608 buckets. -> Table Scan on applications_extra_fields (cost=0.00..431.84 rows=30056 width=37) Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 13 ms to first row, 18 ms to end. -> Hash (cost=4845.30..4845.30 rows=12719490 width=45) Rows in: Avg 12719490.0 rows x 144 workers. Max 12719888 rows (seg57) with 16865 ms to end, start offset by 292 ms. -> Table Scan on applications (cost=0.00..4845.30 rows=12719490 width=45) Rows out: Avg 12719490.0 rows x 144 workers. Max 12719888 rows (seg57) with 4.584 ms to first row, 6608 ms to end. Slice statistics: (slice0) Executor memory: 514K bytes. (slice1) Executor memory: 1180565K bytes avg x 144 workers, 1180565K bytes max (seg0). Work_mem: 561825K bytes max. Statement statistics: Memory used: 2555904K bytes Settings: gp_enable_relsize_collection=on; optimizer_join_arity_for_associativity_commutativity=18 Optimizer status: PQO version 3.111.0 Total runtime: 18920.442 msИз плана видно, что:
- хэш по-прежнему строится на таблицу applications;
- спиллы не генерируются;
- время выполнения уменьшилось — 18 секунд.
Очевидный вывод: чем меньше колонок вы указали в запросе, тем быстрее он выполнится. GreenPlum — это база с поколоночным хранением. Чем меньше указано колонок, тем меньший объем данных читается и хранится в оперативной памяти.
Другой вариант решения применяется, если вы уже по максимуму урезали количество строк и колонок. Тут мы должны заставить оптимизатор строить хэш на меньшую таблицу. Это можно сделать двумя способами: либо поменять LEFT JOIN на INNER JOIN, либо поменять местами таблицы при LEFT JOIN. Заменим LEFT на INNER в начальном запросе:
select aef.name ,aef.value ,aef.id ,a.* from prod_wrk.applications_extra_fields as aef inner join prod_wrk.applications as a on aef.id = a.idПлан данного запроса представлен ниже:
QUERY PLAN Gather Motion 144:1 (slice1; segments: 144) (cost=0.00..33280.61 rows=4328017 width=654) Rows out: 1952503 rows at destination with 3301 ms to first row, 34665 ms to end. -> Hash Join (cost=0.00..26963.43 rows=30056 width=654) Hash Cond: applications.id = applications_extra_fields.id Rows out: Avg 13559.0 rows x 144 workers. Max 13878 rows (seg127) with 483 ms to first row, 20343 ms to end. Executor memory: 2034K bytes avg, 2067K bytes max (seg125). Work_mem used: 2034K bytes avg, 2067K bytes max (seg125). Workfile: (0 spilling) (seg127) Hash chain length 1.0 avg, 3 max, using 29968 of 4194304 buckets. -> Table Scan on applications (cost=0.00..4845.30 rows=12719490 width=617) Rows out: Avg 12719490.0 rows x 144 workers. Max 12719888 rows (seg57) with 114 ms to first row, 26154 ms to end. -> Hash (cost=431.84..431.84 rows=30056 width=37) Rows in: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 26 ms to end, start offset by 70 ms. -> Table Scan on applications_extra_fields (cost=0.00..431.84 rows=30056 width=37) Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 2.260 ms to first row, 9.303 ms to end. Slice statistics: (slice0) Executor memory: 590K bytes. (slice1) Executor memory: 75065K bytes avg x 144 workers, 75067K bytes max (seg117). Work_mem: 2067K bytes max. Statement statistics: Memory used: 2555904K bytes Settings: gp_enable_relsize_collection=on; optimizer_join_arity_for_associativity_commutativity=18 Optimizer status: PQO version 3.111.0 Total runtime: 34748.601 msИз плана видно, что:
- хэш строится на меньшую таблицу applications_extra_fields;
- спиллы не генерируются;
- время выполнения — 34 секунд.
При этом мы смогли даже извлечь все колонки из таблицы applications!
Однако можно заметить, что замена LEFT на INNER или перестановка таблиц местами меняет логику запроса. Если важно ее сохранить, запрос можно переписать через CTE, подзапрос или временную таблицу. Ниже показан пример запроса, переписанный при помощи CTE:
with pre_join as ( select a.* from prod_wrk.applications_extra_fields as aef inner join prod_wrk.applications as a on aef.id = a.id ) select aef.name ,aef.value ,aef.id ,a.* from prod_wrk.applications_extra_fields as aef left join pre_join as a on aef.id = a.idПлан данного запроса:
QUERY PLAN Gather Motion 144:1 (slice1; segments: 144) (cost=0.00..40573.86 rows=8656034 width=654) Rows out: 4385665 rows at destination with 11395 ms to first row, 26902 ms to end. -> Hash Left Join (cost=0.00..27939.50 rows=60112 width=654) Hash Cond: prod_wrk.applications_extra_fields.id = applications.id Rows out: Avg 30456.0 rows x 144 workers. Max 30966 rows (seg125) with 12956 ms to first row, 13011 ms to end. Executor memory: 28739K bytes avg, 29410K bytes max (seg121). Work_mem used: 28739K bytes avg, 29410K bytes max (seg121). Workfile: (0 spilling) (seg125) Hash chain length 1.0 avg, 4 max, using 13291 of 262144 buckets. -> Table Scan on applications_extra_fields (cost=0.00..431.84 rows=30056 width=37) Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 0.593 ms to first row, 10 ms to end. -> Hash (cost=26938.13..26938.13 rows=30056 width=617) Rows in: Avg 13559.0 rows x 144 workers. Max 13878 rows (seg127) with 13689 ms to end, start offset by 6.996 ms. -> Hash Join (cost=0.00..26938.13 rows=30056 width=617) Hash Cond: applications.id = prod_wrk.applications_extra_fields.id Rows out: Avg 13559.0 rows x 144 workers. Max 13878 rows (seg127) with 372 ms to first row, 13628 ms to end. Executor memory: 940K bytes avg, 956K bytes max (seg125). Work_mem used: 940K bytes avg, 956K bytes max (seg125). Workfile: (0 spilling) (seg127) Hash chain length 1.0 avg, 3 max, using 29968 of 4194304 buckets. -> Table Scan on applications (cost=0.00..4845.30 rows=12719490 width=617) Rows out: Avg 12719490.0 rows x 144 workers. Max 12719888 rows (seg57) with 7.392 ms to first row, 20819 ms to end. -> Hash (cost=431.84..431.84 rows=30056 width=8) Rows in: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 15 ms to end, start offset by 69 ms. -> Table Scan on applications_extra_fields (cost=0.00..431.84 rows=30056 width=8) Rows out: Avg 30055.7 rows x 144 workers. Max 30572 rows (seg125) with 1.150 ms to first row, 4.730 ms to end. Slice statistics: (slice0) Executor memory: 582K bytes. (slice1) Executor memory: 126241K bytes avg x 144 workers, 126243K bytes max (seg117). Work_mem: 29410K bytes max. Statement statistics: Memory used: 2555904K bytes Settings: gp_enable_relsize_collection=on; optimizer_join_arity_for_associativity_commutativity=18 Optimizer status: PQO version 3.111.0 Total runtime: 27070.592 ms Из плана видно, что:
- хэш строится на меньшую таблицу applications_extra_fields;
- спиллы не генерируются;
- время выполнения — 27 секунд.
При этом мы смогли даже извлечь все колонки из таблицы applications!
Стоит заметить, что при INNER JOIN хэш-таблица формируется на основе статистики. Если оптимизатор строит хэш на большую таблицу, проверьте статистики таблиц, участвующих в джоине.
Кейс № 3. DISTINCT на большом количестве полей
Почему в данном случае возникают спиллы? Каждое уникальное сочетание значений полей сохраняется в оперативную память. Соответственно, чем больше таких сочетаний, тем быстрее забивается оперативная память и начинают генерироваться спиллы.
Скорость заполнения оперативной памяти также зависит от размера полей, которые участвуют в DISTINCT. То есть четыре поля размером по 8 байта каждое потребуют больше памяти, чем 12 полей по 1 байту каждое, при условии равного количества строк.
Как решается. Сокращайте количество полей в DISTINCT. Дополнительно можно сделать оценки сверху и снизу по требуемому объему памяти для операции DISTINCT. На основе оценок можно принять решение о запуске запроса. Если верхняя граница начинает превышать «штрафной» порог, имеет смысл воздержаться от запуска данного запроса. Метод оценки показан в примере ниже:
Пусть в нашем DISTINCT участвуют три колонки: C1, C2 и C3.
Каждая колонка имеет размерность в байтах (Ai) и количество уникальных значений (count(distinct Ci) = Di).
Допустим, наши колонки имеют следующие Ai и Di:
В первую очередь нужно узнать объем, занимаемый одной строкой. Он равен сумме Ai:
В нашем случае А = 16 + 8 + 4 = 28 байт — столько будет занимать одна строка.
Теперь нужно оценить количество строк D.
Минимальное значение строк равно максимуму из уникальных значений D = max(Di), то есть D = D2 = 832. Почему именно столько? Минимум может быть только 832 строки, это случай, когда во всех возможных сочетаниях все значения из столбца C2 повторяются лишь по одному разу. Меньше быть не может.
Максимальное значение строк равно произведению всех Di, то есть:
Это случай декартового произведения, когда каждое уникальное значение сочетается с каждыми уникальными значениями всех столбцов.
В нашем случае D = 156 × 832 × 16 = 2 076 672 строк. Теперь посчитаем объем данных, получаемый сверху и снизу:
- оценка снизу: A × D = (A1 + A2 + A3) × MAX(Di) = (16 + 8 + 4) × 832 = 23 296 байта ≈ 22,75 Кб;
- оценка сверху: A × D = (A1 + A2 + A3) × (D1 × D2 × D3) = (16 + 8 + 4) × (156 × 832 × 16) = 58 146 816 байт ≈ 55,45 Мб.
Таким образом, требуемый объем памяти будет в пределах от 22,75 Кб до 55,45 Мб. Общая формула:
где n — количество колонок, Ai — размерность i-ой колонки, Di — количество уникальных значений i-ой колонки (count(distinct Ci)).
С ростом количества колонок сильно растет оценка сверху. Давайте в пример выше добавим еще одну колонку размерностью A4 = 4 байта и количеством уникальных значений D4 = 60.
Таким образом, оценка сверху станет:
A × D = (A1 + A2 + A3 + A4) × (D1 × D2 × D3 × D4) = (16 + 8 + 4 + 4) × (156 × 832 × 16 × 60) = 3 987 210 240 байт ≈ 3,71 Гб! То есть потенциальный необходимый объем вырос почти в 68,5 раза!
Самый дикий случай, который ни в коем случае нельзя запускать:
select distinct * from some_tableЕсли в таблице имеется уникальный ключ или сочетания ключей, то в данном случае вы пытаетесь поместить всю таблицу в оперативную память. А когда она не влезает, то начинается генерация огромного количества спиллов.
Чтобы узнать размерность колонок, можно применить функцию pg_column_size(column). Она вернет размерность колонки в байтах.
Кейс № 4. Использование ORDER BY
А там-то откуда спиллы? Все очень просто. Когда вы даете команду сортировки, GreenPlum должен где-то хранить промежуточный результат сортировки. Сначала место хранения — оперативная память, затем — жесткий диск, то есть начнется генерация спиллов. Особенно быстро переход к генерации спиллов совершается тогда, когда вы хотите отсортировать большой объем данных.
Попробуем запустить сортировку и посмотреть на спиллы:
explain analyze select * from prod_wrk.applications order by dt_created ,idК сожалению (или к счастью администраторов), я не дождался выполнения этого запроса и отменил его. Однако всего за пару секунд работы получилось сгенерировать почти половину терабайта:

Как решается. Не используйте ORDER BY, совсем! В GreenPlum конструкция ORDER BY работает крайне медленно (во многом благодаря спиллам). Если вам требуется сортировка, то сортируйте данные уже в приемнике данных (например, в dBeaver, Excel, Tableau), а не в самом запросе. Для конструкции DISTINCT ON и оконных выражений может потребоваться наличие ORDER BY. В этом случае максимально уменьшите объем строк, так как на большом объеме данных запрос не отработает (или будет работать долго) и cгенерирует большое количество спиллов.
Заключение
Я рассмотрел не все возможные кейсы, однако большинство частных случаев так или иначе будут основываться на кейсах, описанных в статье.
- Основа всех случаев генерации спиллов — попытка поместить большой объем данных в оперативную память.
- Следите за объемами данных и оценивайте их.
- Следите за джоинами.
- Не увлекайтесь DISTINCT.
- Избегайте ORDER BY.
Полезные ссылки и источники.

- Чтение плана запроса
- Что такое spill-files
- Размеры типов данных в Postgres
- Проверка наличия spill-файлов
Исправление ошибки #ПЕРЕНОС!
Excel для Microsoft 365 Excel для Microsoft 365 для Mac Excel для Интернета Excel 2021 Excel 2021 для Mac Excel 2019 Excel 2019 для Mac Excel 2016 Excel для iPad Excel Web App Excel для iPhone Excel для планшетов с Android Excel для телефонов с Android Еще. Меньше
Ошибки #ПЕРЕНОС! возникают, когда формула возвращает несколько результатов, а Excel не может вернуть результаты в сетку. Дополнительные сведения об этих типах ошибок см. в следующих разделах справки.
Диапазон для переноса данных не пустой
Эта ошибка возникает, если диапазон переноса для формулы массива с переносом не является пустым.
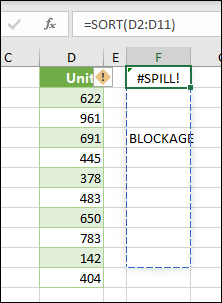
При выборе формулы пунктирная граница будет указывать на намеченный диапазон переноса.
Вы можете щелкнуть плавающий элемент «Ошибка» и выбрать параметр Выделить препятствующие ячейки, чтобы сразу перейти к препятствующим ячейкам. Затем вы можете очистить ошибку, удалив или переместив запись препятствующей ячейки. Как только препятствие будет очищено, формула массива выполнит перенос намеченным образом.
Неопределенный размер
Excel не удалось определить размер массива с переносом, так как он является переменным и меняет размер между этапами вычислений. Например, следующая формула вызывает эту ошибку #ПЕРЕНОС! :
Динамическое изменение размера массива может вызвать дополнительные этапы вычислений, чтобы обеспечить полное вычисление таблицы. Если размер массива продолжает изменяться во время этих дополнительных этапов и не стабилизируется, Excel разрешит динамический массив ошибкой #ПЕРЕНОС!.
Это значение ошибки обычно связано с использованием функций СЛЧИС, СЛМАССИВи СЛУЧМЕЖДУ. Другие переменные функции, например СМЕЩ, ДВССЫЛ и СЕГОДНЯ, не возвращают разные значения на каждом этапе вычисления.
Выходит за границу листа
Например, при размещении в ячейке E2 формулы =ВПР(A:A;A:C;2;ЛОЖЬ) (как в примере ниже) ранее выполнялся поиск ИД только в ячейке A2. Однако в динамическом массиве Excel формула вызывает ошибку #ПЕРЕНОС!, так как Excel выполняет поиск во всем столбце, возвращает 1 048 576 результатов и достигает конца сетки Excel.
Эту проблему можно устранить 3 простыми способами:
Ссылайтесь только на нужные значения поиска. Этот стиль формулы возвращает динамический массив, но не работает с таблицами Excel.
=ВПР(A2:A7;A:C;2;ЛОЖЬ)
Сошлитесь на значение в той же строке, а затем скопируйте формулу. Этот традиционный стиль формулы работает в таблицах, но не возвращает динамический массив.
=ВПР(A2;A:C;2;ЛОЖЬ)
Создайте в Excel запрос неявного пересечения с помощью оператора @, а затем скопируйте формулу. Этот стиль формулы работает в таблицах, но не возвращает динамический массив.
=ВПР(@A:A;A:C;2;ЛОЖЬ)
Формула таблицы
Формулы массивов с переносом не поддерживаются в таблицах Excel. Попробуйте переместить формулу из таблицы или преобразовать таблицу в диапазон (нажмите Конструктор таблиц > Инструменты > Преобразовать в диапазон).
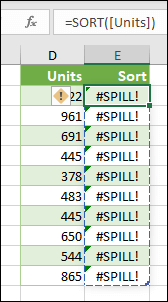
Недостаточно памяти
Формула массива с переносом, которую вы пытаетесь ввести, привела к нехватке памяти в Excel. Попробуйте сослаться на меньший массив или диапазон.
Перенос в объединенные ячейки
Формулы массива с переносом не могут выполнять перенос в объединенные ячейки. Отмените объединение ячеек или переместите формулу в другой диапазон, который не пересекается с объединенными ячейками.
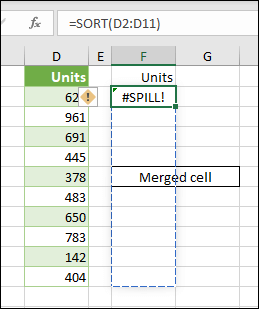
При выборе формулы пунктирная граница будет указывать на намеченный диапазон переноса.
Вы можете щелкнуть плавающий элемент «Ошибка» и выбрать параметр Выделить препятствующие ячейки, чтобы сразу перейти к препятствующим ячейкам. Как только объединенные ячейки будут устранены, формула массива выполнит перенос намеченным образом.
Неизвестно/откат
Excel не распознает или не может согласовать причину этой ошибки. Убедитесь, что формула содержит все необходимые аргументы для вашего сценария.
Дополнительные сведения
См. также
Вы всегда можете задать вопрос эксперту в Excel Tech Community или получить поддержку в сообществах.
Спиливаем spill-ы
Меня зовут Александр Маркачев, я 3,5 года работаю на позиции Data Engineer в билайне и люблю открывать для себя что-то новое и интересное в работе. Так случилось и с темой, которой я сегодня хочу с вами поделиться — со spill-ами.
Под катом мы поговорим о том, что такое Spill-ы в контексте Spark, и почему именно для Spark это не такая уж сильно плохая штука. Рассмотрим, из-за чего Spill-ы в принципе возникают, разберем несколько видов Spill-ов (и даже вызовем их намеренно), а затем будем решать эту проблему.
Что такое spill-ы в Spark
Вообще, Spill — это термин для обозначения процесса перемещения данных из памяти на диск, а затем снова обратно в память. По крайней мере, именно так гласит официальная трактовка. Если проще, то дело вот в чем — когда у Spark не хватает ресурсов для обработки, он перемещает данные на диск.
В процессе обработки существуют разные участки — есть Executor Memory, есть Storage Memory, и когда эти участки оба целиком заполнены, то они начинают переполняться и вызывать утечку данных. Причем в отличие от утечки в C, Java или еще где-то, в Spark это преднамеренное действие для того, чтобы ваша задача не падала. Собственно, именно поэтому при нехватке ресурсов данные и «проливаются».
Можно ещё сильнее упростить аналогию.
Представьте, что вам надо вскипятить кастрюлю воды. Обычный процесс, ничего сложного — налили воды, поставили на плиту, вскипятили, все ОК.

А теперь представьте, что вам надо вскипятить ведро воды, но с помощью кастрюли — кипятить кастрюлю, выливать воду в ведро, кипятить следующую. Получится ли у вас таким образом вскипятить ведро? Вряд ли.
Spark фактически решает эту проблему — он заливает воду в ведро, нагревает ее снова и снова, пока все ведро целиком у вас не будет вскипячено (читай — обработано).
Виды spill-ов
Spill «потому что»
Возникает, как правило, непредвиденно, вообще непонятно почему, зачем и как, но у него все же есть причина (как и остальных Spill-ов) — ему недостаточно ресурсов для обработки этих данных. Он возникает при попытке прочитать большое количество данных, сделать COALESCE и при подобной активности.
Как воспроизвести
Для примера я сделал небольшой датафрейм на 3 миллиарда строк и сделал на нем COALESCE.
val t1 = spark.range(30000000).toDF("num") .withColumn("id", lit(1)) t1.coalesce(1).sortWithinPartitions($"id").show()На картинке видно, что в логах заметны UnsafeExternalSorter и 308 мегабайт.
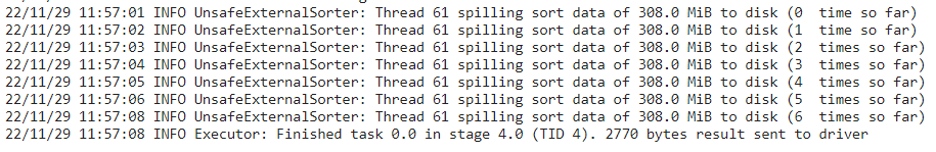
Тут штука вот в чем. Все расчеты делались на одном гигабайте на драйвер и на экзекьютор. External Spill в данном случае 300 мегабайт, потому что мы взяли общий объем 1 гигабайт, от него отняли 300 мегабайт обязательно зарезервированной памяти. У нас осталось 700 мегабайт, из них мы отняли еще 40% и у нас осталось как раз 420 мегабайт. Часть из них зарезервирована для Storage Memory, часть как раз используется в качестве обработки.
Когда все это заполнено, происходит пролив.
Как устранить
Прежде всего, никогда не стоит делать COALESCE один, в том случае, если мы работаем с большими данными. Для получения идентичного поведения можно использовать просто сортировку, а уже потом сжать.
t1.orderBy($"id").coalesce(1).show()В итоге получится, что за счет того, что мы сначала данные отсортировали так, как нам надо, а потом уже уменьшили это до одной партиции, мы не получим проблем.
И можно увидеть на картинке — время обработки увеличилось из-за spill-а приблизительно в 14 раз.

Как же тогда обрабатывать большие объемы данных?
- Делать Repartition. Это разобьет большую таблицу на много маленьких блоков и позволит Spark итеративно их обрабатывать, не перегружая систему.
- Как можно раньше фильтровать данные. Таким образом получится вместо терабайта данных на начальном этапе обработать всего 100 гигабайт.
- Делить таблицы на маленькие блоки, в принципе, это то же самое, что Repartition, с той лишь разницей, что мы не разбиваем это с помощью Repartition, а берем отдельные сегменты и итеративно их обрабатываем.
Spill оконный

Достаточно неприятный, потому что замедление оконных функций будет происходить в любом случае при стандартном поведении окна, даже если там не будет вызван Spill. Все потому, что по умолчанию в Spark выставлен такой параметр как ограничение блока данных в 4096 элементов. Если это значение превышается, то он начинает скидывать на диск и обрабатываться медленнее.
Как воспроизвести
Создадим небольшой DataFrame на 200 тысяч элементов и сделаем на нем оконную функцию для подсчета количества элементов. Тут мы специально сделали все с одним номером для того, чтобы показать, как будет работать оконная функция.
val t1 = spark.range(200000).toDF("num").withColumn("id", lit(1)) .withColumn("c1", lit("одна длинная фраза которая никогда не кончится").withColumn("c2", И вызовем spill.
t1.withColumn("rn", max($"num").over(Window.partitionBy($"id"))).withColumn("rn", row_number().over(Window.partitionBy($"id").orderBy($"num".desc))).show() В логах видно, что Spill активируется на 4096 элементах. Если у вас достаточно большой объем памяти, то Spill вы не увидите, но строка с активацией Unsafe External Sorter в логах все равно будет, при условии, что вы выйдете за количество элементов.

Как устранить
Для устранения в Spark есть специальные функции — spark.sql.windowExec.buffer.spill.threshold на, допустим, 200 тысяч элементов. Максимальное число элементов, Int Max Value, -15. То есть, порядка двух миллиардов элементов в принципе можно в одну оконную функцию закинуть. После устранения видно, что никаких Spill-ов нет, но в то же время тут есть определенные риски.
Если мы говорим именно про оконную функцию для датафреймов с небольшим количеством колонок, то данная опция будет вредна при увеличении объема данных.
Например, тут был сделан датафрейм на 300 тысяч элементов.
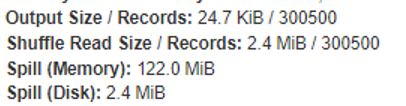
На скрине стандартное поведение — Spill на 122 мегабайта при увеличении до 300 тысяч строк. В то время как при изменении параметра оконной функции до 200 тысяч элементов Spill оконной функции становится 182 мегабайта, то есть больше.
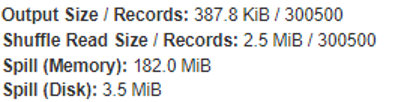
Учитывайте, что данное поведения актуальны только при датафреймах с небольшим количеством колонок. Таким образом, при увеличении до 300 тысяч элементов в логах вы также увидите, что Spill теперь стартует с 200 тысяч строк, а в остальном никаких отличий от варианта без настройки, то есть было 4096, а стало 200 тысяч строк. Потом начинаются Spill-ы.

Чем больше у вас будет колонок, тем меньше будет эта разница, и в определенный момент настройка оконной функции превзойдет стандартное поведение.
Если у вас мало колонок, то либо настраивайте параметр Spill-а для оконных функций на большее количество элементов, которые точно никогда не возникнет, либо не настраивайте, и стандартное поведение будет немного лучше.
Рекомендации
- Перед оконной функцией, как всегда, отсеките лишние строки, лишние колонки. Чем меньше колонок, тем позже будет вызван Spill при стандартном поведении.
- Если у вас много колонок — указывайте параметры для настройки оконной функции.
- Если 2-3-4, не беспокойтесь и рассчитывайте стандартное поведение (что там Spill будет меньше).
Spill перекошенный
Перекос данных — это когда у вас какого-либо ключа очень много. Например, у вас миллион одного ключа, а остальных — по сотне. В результате один поток будет обрабатывать все эти ключи. На этот экзекьютор скинутся все данные по данному ключу и будут очень долго обрабатываться.
Возникает при join, возникает при groupBy. Скорее всего, возникает еще при каких-то операциях, если помните или сталкивались — напишите в комментах, пожалуйста.
Как воспроизвести
Можете воспользоваться данным кодом — создать таблицу на миллиард записей или 10 миллионов и вторую маленькую таблицу, допустим, по 100 строк.
val t1 = spark.range(10000000).toDF("num").withColumn("id", lit(1)).union(spark.range(100).toDF("num").withColumn("id", lit(2))).union(spark.range(100).toDF("num").withColumn("id", lit(3))).union(spark.range(100).toDF("num").withColumn("id", lit(4))) val t2 = spark.range(100).toDF("num2").withColumn("id2", lit(1)).union(spark.range(100).toDF("num2").withColumn("id2", lit(2))).union(spark.range(100).toDF("num2").withColumn("id2", lit(3)))После чего попробуйте их соединить.
t1.join(t2, $"id" === $"id2", "inner") В логах вы увидите (на таймере выполнения), что работает всего лишь один экзекьютор и на нем будет spill memory.

Как устранить
В стандартной практике создаются искусственные ключи, допустим, при соединении какого-либо элемента либо соединением нескольких строк колонки, и потом все это соединяется. У нас в билайне есть функция Salted для устранения данной проблемы. Она достаточно легко пишется — высчитывается количество элементов в датафрейме, после чего берется среднее от него, делится, и для всего, что больше, добавляется искусственный ключ, чтобы перемножать не все данные в датафреймах, а именно перекошенные.
import ru.beeline.dmp.tools.spark.utils.skewjoin.SkewJoin._ salted(t1, t2, List($"id"), List($"id2"), "inner")()()(50000)
В результате мы увидим ситуацию получше — распараллеливание запроса и намного более быструю обработку. Естественно, скорость будет зависеть от того, насколько сильно были перекошены данные.
Рекомендации
- Добавлять больше условий при соединениях или агрегациях. Чем больше условий, тем ниже вероятность того, что какой-либо из ключей будет перекошен, и тем больше параллельных потоков сможет запуститься.
- Если вы знаете, что есть перекос, то можете добавить искусственный ключ, либо придумать какую-либо другую обработку, допустим, разделить это на отдельные блоки и обработать итеративно.
- Если вы работаете в билайне (если хотите, приходите к нам в бигдату), можете воспользоваться Salted-функцией, а если не работаете, то можете написать свою функцию и внедрить ее в своей компании.
Spill соединительный
В целом, это тот же самый Spill, что в самом начале — когда очень много данных, но в то же время он не возникает на этапе считывания, он возникает именно при попытке каких-либо действий.
Как воспроизвести
Создадим DataFrame по 100 миллионов записей и соединим его с другим датафреймом по 100.
val t1 = spark.range(100000000).toDF("num").withColumn("id", lit(1)).union(spark.range(100000000).toDF("num").withColumn("id", lit(2))) val t2 = spark.range(100).toDF("num2").withColumn("id2", lit(1)).union(spark.range(100).toDF("num2").withColumn("id2", lit(2))) t1.join(t2, $"id" === $"id2", "inner“) Видно, что в первом случае мы обрабатывали, условно, в два потока и есть Spill Memory. В логах мы точно так же, как и при других типах Spill-ов, видим UnsafeExternalSorter, видим 308 мегабайт Spill-а.


Снова нам на выручку придет функция Salted (которую вы, наверное, уже написали после предыдущей главы?), но в данном случае мы разделим наши большие блоки по 100 миллионов на маленькие блоки — по 5 миллионов записей (а если вы не написали функцию для “соления” — можно просто с помощью rand добавить число от 1 до 20).
В случае же с функцией Salted мы опять-таки параллелим запрос точно так же, как было с перекошенным join. Для groupBy придется писать самим под каждый тип группировки, потому что для Max, допустим, и для среднего это будут абсолютно разные условия.
import ru.beeline.dmp.tools.spark.utils.skewjoin.SkewJoin._ salted(t1, t2, List($"id"), List($"id2"), "inner")(0.05)()()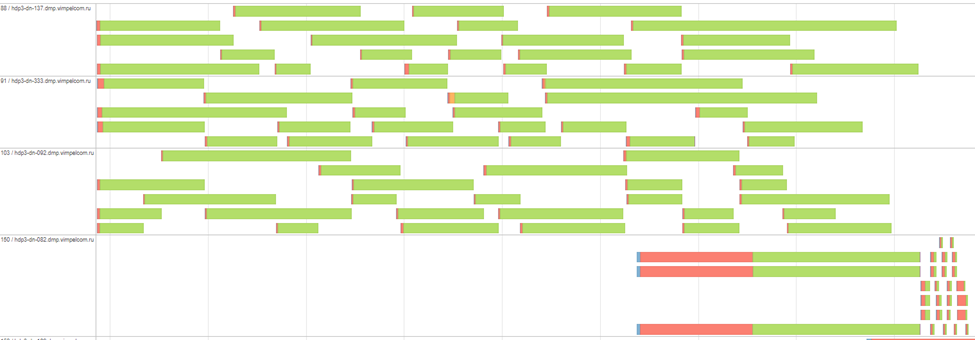
Как устранить
Разделить на более маленькие блоки в результате и обрабатывать параллельно, как и в случае с любым Spill-ом.
Spill зашафленный

Это снова комбинация предыдущих Spill-ов, но возникает при работе с большим объемом данных малыми ресурсами. Можем наблюдать при попытке разбить большое количество данных на большое количество блоков. В результате будет происходить shuffle External Sorter. В отличие от unsafeExternal Sorter, он возникает именно в случае перемешивания данных между разными нодами.
Как воспроизвести
На вход подаем большое количество записей (5 миллиардов) и потом на нем пытаемся выяснить максимальное число. В результате, так как там у нас 2000 партиций, при перемешивании между нодами происходит большой шафл. Как следствие — происходит Spill.

Как устранить
- Настроить Spark Memory Fraction и Storage Fraction. Так вы увеличите доступную память для Spark, но делать я это крайне не рекомендую, потому что мы повышаем риск Out of Memory Exception. Тогда все может упасть.
- Более надежный способ — разделить нашу таблицу по какому-нибудь ключу. В примере — это Market Code.
Как видно на картинке, началась параллельная обработка по городам (мы не могли разделить по месяцам и разделили по городам). Все запараллелилось, проблема исчезла.

Что важно. Все параметры были Shuffle Partition 2000. В случае, если мы сделаем Shuffle Partition 200, мы получим похожую проблему, но только уже не из-за шаффла, а из-за того, что мы пытаемся обработать большое количество данных на малом количестве экзекьюторов. Проблема не устраняется ни так, ни так.
Самый надежный способ — это разделить по городам. Всегда можно найти какой-либо дополнительный ключ, по которому можно произвести разделение.
Рекомендации
- Смотреть применимость параметров в случае каждого расчета. Если у вас мало данных, то действительно можно использовать первый способ и настроить Memory Fraction.
- Если у вас много действий, то есть большой расчет, то нужно искать выходы. В данном случае, допустим, разделить по городам. В ваших случаях это может быть какой-либо другой способ.
- Возможно, решение проблемы решит вообще не в области ресурсов, и дело в том, что вы пытаетесь забрать слишком много данных, которые вам реально не нужны. Это нужно рассматривать и помнить всегда.
Spill Декарта (Cartesian Join)
Возникает в случае Cross Join.
В логах видно, что произошло падение.


В принципе, со всеми другими Spill-ами мы тоже можем увидеть падение, но с Cartesian это наиболее вероятно. По умолчанию там так же, как с оконными функциями, настройка на 4096 элементов.
Как воспроизвести
val t1 = spark.range(1000000).toDF("num").withColumn("id", lit(1)) val t2 = spark.range(1000).toDF("num").withColumn("id", lit(1)) spark.conf.set("spark.sql.cartesianProductExec.buffer.spill.threshold", 10)t2.crossJoin(t1) Я уменьшил размер буфера для Cartesian Join до 10 элементов. И у нас очень быстро всё упало, так как произошел очень большой Spill на 2 ГБ.

Как устранить
Можно изменить порядок джоинов. Ведь проблема возникла именно из того, что мы маленький DataFrame пытались сджойнить с большим. В итоге большой DataFrame перемещался между экзекьюторами и вызывал Spill. А если мы поменяем и будем к большому DataFrame джойнить маленький, проблема исчезнет.
t1.crossJoin(t2)Это относится вообще ко всем видам джойна — всегда джойните к большому DataFrame малый DataFrame.
А можно установить больший размер буфера — spark.conf.set(«spark.sql.cartesianProductExec.buffer.spill.threshold», 100000)
Возможно, в вашей практике spill-ы встречались и в других ситуациях, при которых вы нашли необычный или обычный способ их устранить— будет здорово, если поделитесь этим в комментариях.