
SQL AUTO INCREMENT Field
Auto-increment allows a unique number to be generated automatically when a new record is inserted into a table.
Often this is the primary key field that we would like to be created automatically every time a new record is inserted.
Syntax for MySQL
The following SQL statement defines the «Personid» column to be an auto-increment primary key field in the «Persons» table:
CREATE TABLE Persons (
Personid int NOT NULL AUTO_INCREMENT,
LastName varchar(255) NOT NULL,
FirstName varchar(255),
Age int,
PRIMARY KEY (Personid)
);
MySQL uses the AUTO_INCREMENT keyword to perform an auto-increment feature.
By default, the starting value for AUTO_INCREMENT is 1, and it will increment by 1 for each new record.
To let the AUTO_INCREMENT sequence start with another value, use the following SQL statement:
ALTER TABLE Persons AUTO_INCREMENT=100;
To insert a new record into the «Persons» table, we will NOT have to specify a value for the «Personid» column (a unique value will be added automatically):
INSERT INTO Persons (FirstName,LastName)
VALUES (‘Lars’,’Monsen’);
The SQL statement above would insert a new record into the «Persons» table. The «Personid» column would be assigned a unique value. The «FirstName» column would be set to «Lars» and the «LastName» column would be set to «Monsen».
Syntax for SQL Server
The following SQL statement defines the «Personid» column to be an auto-increment primary key field in the «Persons» table:
CREATE TABLE Persons (
Personid int IDENTITY(1,1) PRIMARY KEY,
LastName varchar(255) NOT NULL,
FirstName varchar(255),
Age int
);
The MS SQL Server uses the IDENTITY keyword to perform an auto-increment feature.
In the example above, the starting value for IDENTITY is 1, and it will increment by 1 for each new record.
Tip: To specify that the «Personid» column should start at value 10 and increment by 5, change it to IDENTITY(10,5) .
To insert a new record into the «Persons» table, we will NOT have to specify a value for the «Personid» column (a unique value will be added automatically):
INSERT INTO Persons (FirstName,LastName)
VALUES (‘Lars’,’Monsen’);
The SQL statement above would insert a new record into the «Persons» table. The «Personid» column would be assigned a unique value. The «FirstName» column would be set to «Lars» and the «LastName» column would be set to «Monsen».
Syntax for Access
The following SQL statement defines the «Personid» column to be an auto-increment primary key field in the «Persons» table:
CREATE TABLE Persons (
Personid AUTOINCREMENT PRIMARY KEY,
LastName varchar(255) NOT NULL,
FirstName varchar(255),
Age int
);
The MS Access uses the AUTOINCREMENT keyword to perform an auto-increment feature.
By default, the starting value for AUTOINCREMENT is 1, and it will increment by 1 for each new record.
Tip: To specify that the «Personid» column should start at value 10 and increment by 5, change the autoincrement to AUTOINCREMENT(10,5) .
To insert a new record into the «Persons» table, we will NOT have to specify a value for the «Personid» column (a unique value will be added automatically):
INSERT INTO Persons (FirstName,LastName)
VALUES (‘Lars’,’Monsen’);
The SQL statement above would insert a new record into the «Persons» table. The «Personid» column would be assigned a unique value. The «FirstName» column would be set to «Lars» and the «LastName» column would be set to «Monsen».
Syntax for Oracle
In Oracle the code is a little bit more tricky.
You will have to create an auto-increment field with the sequence object (this object generates a number sequence).
Use the following CREATE SEQUENCE syntax:
CREATE SEQUENCE seq_person
MINVALUE 1
START WITH 1
INCREMENT BY 1
CACHE 10;
The code above creates a sequence object called seq_person, that starts with 1 and will increment by 1. It will also cache up to 10 values for performance. The cache option specifies how many sequence values will be stored in memory for faster access.
To insert a new record into the «Persons» table, we will have to use the nextval function (this function retrieves the next value from seq_person sequence):
INSERT INTO Persons (Personid,FirstName,LastName)
VALUES (seq_person.nextval,’Lars’,’Monsen’);
The SQL statement above would insert a new record into the «Persons» table. The «Personid» column would be assigned the next number from the seq_person sequence. The «FirstName» column would be set to «Lars» and the «LastName» column would be set to «Monsen».
Всё, что вы хотели знать об автоинкременте, но стеснялись спросить
Автоинкремент — это функция в базах данных SQL, которая автоматически генерирует уникальный номер для каждой новой строки в таблице.
Автоинкремент — это функция в базах данных, которая автоматически генерирует уникальный номер для каждой новой строки, добавленной в таблицу.
Этот номер обычно используется в качестве первичного ключа для уникальной идентификации каждой строки в таблице.
Система базы данных автоматически присваивает каждому новому ряду следующий доступный номер, избавляя пользователя от необходимости вручную управлять значениями первичного ключа. Это упрощает процесс добавления новых строк и гарантирует, что каждая строка имеет уникальный идентификатор.
Если вы хотите попрактиковаться в создании таблиц с автоинкрементными столбцами и выполнении операторов SQL, вы можете попробовать использовать онлайн-редактор SQL, такой как SQLize.online, который позволяет создавать таблицы, вставлять данные и выполнять SQL-запросы в действующей базе данных.
Ниже показано, как создать таблицу с автоинкрементным столбцом в различных РСУБД.
CREATE TABLE example_table ( id INTEGER PRIMARY KEY AUTOINCREMENT, name VARCHAR(50), age INT ); В этом примере столбец id определен как целочисленный тип данных с ключевым словом AUTOINCREMENT. Он также задан как первичный ключ таблицы.
MySQL и MariaDB:
CREATE TABLE example_table ( id INT AUTO_INCREMENT PRIMARY KEY, name VARCHAR(50), age INT ); В этом примере столбец id определен как столбец с автоматическим инкрементом с помощью ключевого слова AUTO_INCREMENT. Он также установлен в качестве первичного ключа таблицы.
CREATE TABLE example_table ( id INT IDENTITY(1,1) PRIMARY KEY, name VARCHAR(50), age INT ); В этом примере столбец id определен как столбец идентичности с помощью ключевого слова IDENTITY. Он также задан как первичный ключ таблицы. Числа 1,1 задают начальное значение и значение инкремента автоинкрементного столбца. Например мы можем начать нумерацию с 100 и даждый раз прибавлять 10 (100, 110, 120, 130…) заменив IDENTITY(1,1) на IDENTITY(100, 10). Больше того, в качестве начала и шага можно использовать отрицательные числа. Попробуйте сами здесь.
CREATE SEQUENCE example_table_seq; CREATE TABLE example_table ( id NUMBER DEFAULT example_table_seq.nextval PRIMARY KEY, name VARCHAR2(50), age INT ); В этом примере сначала создается последовательность с помощью оператора CREATE SEQUENCE. Затем столбец id определяется как числовой тип данных со значением по умолчанию, равным следующему значению последовательности. Он также задается в качестве первичного ключа таблицы. В приведенном примере будет создана последовательность с начальным значением 1 и шагом 1. Если нам нужен другой вариант мы можем указать параметры INCREMENT BY и START WITH при создании
CREATE SEQUENCE example_table_seq INCREMENT BY 10 START WITH 10; PostgreSQL имеет несколько вариантов определения автоинкрементного столбца. Наиболее популярным является ключевое слово `SERIAL`.
CREATE TABLE example_table ( id SERIAL PRIMARY KEY, name VARCHAR(50), age INT ); В этом примере столбец id определен как последовательный тип данных, что эквивалентно столбцу с автоматическим инкрементом в других СУБД. Он также задан как первичный ключ таблицы.
Кроме того, для создания автоинкрементного столбца в PostgreSQL можно использовать как синтаксис `IDENTITY`, так и синтаксис `SEQUENCE`. Вот примеры создания автоинкрементного столбца с использованием синтаксиса IDENTITY и SEQUENCE в PostgreSQL:
CREATE TABLE example_table ( id INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY, name VARCHAR(50), age INT ); CREATE SEQUENCE example_table_seq; CREATE TABLE example_table ( id INT DEFAULT nextval('example_table_seq') PRIMARY KEY, name VARCHAR(50), age INT ); Как и в примере с Oracle DB, вариант с SEQUENCE предлагает возможности гибкой конфигурации автоинкремента в отличии от SERIAL
Чтобы вставить новую строку в таблицу с автоинкрементным столбцом, мы можем использовать оператор INSERT INTO, указав для всех столбцов, кроме автоинкрементного:
INSERT INTO example_table (name, age) VALUES ('John Smith', 30); Большинство диалектов SQL позволяет вставлять несколько строк в один запрос.
INSERT INTO example_table (name, age) VALUES ("Джейн Доу", 25), ('Боб Джонсон', 40), ('Элис Браун', 35); Если сейчас сделать выборку из таблицы Мы увидим что столбец `id` был автоматически заполнен последовательными числами:
SELECT * FROM example_table; +====+=============+=====+ | id | name | age | +====+=============+=====+ | 1 | Джейн Доу | 25 | | 2 | Боб Джонсон | 40 | | 3 | Элис Браун | 35 | +----+-------------+-----+ SQLite, MySQL & MariaDB позволяет вставлять произвольные значения в столбец с автоматическим увеличением и обновлять последовательность.
INSERT INTO example_table (id, name, age) VALUES (11, 'John Smith', 30); INSERT INTO example_table (name, age) VALUES ('Jane Doe', 25), ('Bob Johnson', 40), ('Alice Brown', 35); SELECT * FROM example_table; В приведенном выше примере мы вставляем ’John Smith’ с id = 11 и затем ещё три строки без указания значений `id`. Эти строки будут вставлены со следующими значениями последовательности 12, 13, 14 Проверьте это здесь.
+====+=============+=====+ | id | name | age | +====+=============+=====+ | 11 | John Smith | 30 | | 12 | Jane Doe | 25 | | 13 | Bob Johnson | 40 | | 14 | Alice Brown | 35 | +----+-------------+-----+ MS SQL Server по умолчанию не допускает такого волюнтаризма. Поэтому, если нам нужно вставить значение в столбец identity, мы должны установить IDENTITY_INSERT в нашей таблице:
SET IDENTITY_INSERT example_table ON INSERT INTO example_table (id, name, age) VALUES (11, 'John Smith', 30) SET IDENTITY_INSERT example_table OFF; Приведенный выше запрос вставляет запись с id = 11 и перемещает вверх счетчик для вставки последующих записей.
А как насчет Oracle? Эта DB позволяет вставлять значения в столбец id, без влияния на последовательности, поэтому мы можем вставлять строку с произвольным id, но это может привести к конфликту, как в следующем примере:
CREATE SEQUENCE example_table_seq; CREATE TABLE example_table ( id NUMBER DEFAULT example_table_seq.nextval PRIMARY KEY, name VARCHAR2(50), age NUMBER ); --вставляем строку с INTO example_table (id, name, age) VALUES (3, 'John Smith', 30); -- следующие запросы вставят строки с id 1 и 2 INSERT INTO example_table (name, age) VALUES ('Jane Doe', 25); -- 1 INSERT INTO example_table (name, age) VALUES ('Bob Johns', 40); -- 2 -- здесь получаем ошибку OCIStmtExecute: -- ORA-00001: unique constraint (0c7690dacb6b.SYS_C009760) violated INSERT INTO example_table (name, age) VALUES ('Alice Brown', 35); SELECT * FROM example_table; PostgreSQL с синтаксисом SERIAL или SEQUENCE для столбца с автоматическим увеличением показывают нам такое же поведение, как и Oracle (строка вставлена, последовательность не обновлена, ошибка при дублировании). Но при использовании синтаксиса IDENTITY вставка строки с произвольным идентификатором не допускается. Это ограничение может быть обойдено переопределением системного значения, как в следующем примере, но опять же это не обновляет последовательность и может вызвать конфликт.
CREATE TABLE example_table ( id INT GENERATED ALWAYS AS IDENTITY PRIMARY KEY, name VARCHAR(50), age INT ); INSERT INTO example_table (id, name, age) OVERRIDING SYSTEM VALUE VALUES (3, 'John Smith', 30); INSERT INTO example_table (name, age) VALUES ('Jane Doe', 25); INSERT INTO example_table (name, age) VALUES ('Bob Johnson', 40); INSERT INTO example_table (name, age) VALUES ('Alice Brown', 35); SELECT * FROM example_table; Давайте двигаться дальше! Как изменить значение автоинкремента?
В SQLite можно сбросить значение автоматического увеличения для таблицы с помощью таблицы sqlite_sequence.
Таблица sqlite_sequence — это внутренняя таблица, используемая SQLite для отслеживания следующего значения автоинкремента для каждой таблицы в базе данных. Каждая строка в таблице sqlite_sequence представляет таблицу в базе данных, а в столбце seq хранится следующее значение автоматического увеличения для этой таблицы. Поэтому, когда нам нужно изменить его, просто попробуйте следующее:
UPDATE sqlite_sequence SET seq = 100 WHERE name = 'example_table'; INSERT INTO example_table (name, age) VALUES ('John Gold', 30); Приведенный выше код изменит значение автоприращения на 100, а следующая вставленная строка получит >
Мы можем удалить автоинкремент следующим запросом:
DELETE FROM sqlite_sequence WHERE name = 'example_table'; или установить его меньше максимального значения в автоматически увеличиваемом столбце, но после вставки новой строки sqlite_sequence будет исправлен автоматически. Просто посмотрите следующий фрагмент кода:
CREATE TABLE example_table ( id INTEGER PRIMARY KEY AUTOINCREMENT, name VARCHAR(50), age INT ); INSERT INTO example_table (name, age) VALUES ('Jane Doe', 25), ('Bob Johnson', 40), ('Alice Brown', 35); SELECT * FROM sqlite_sequence WHERE name = 'example_table'; данный код вернет следующий результат:
+===============+=====+ | name | seq | +===============+=====+ | example_table | 3 | +---------------+-----+ Удалим его и убедимся что данные исчезли:
DELETE FROM sqlite_sequence WHERE name = 'example_table'; SELECT * FROM sqlite_sequence WHERE name = 'example_table'; но после следующей записи вставленное значение последовательности также будет восстановлено. Попробуйте здесь.
MySQL & MariaDB также позволяет изменять автоинкремент с помощью запроса ALTER TABLE, но оно не может быть меньше максимального значения в автоматически увеличенном столбце:
ALTER TABLE example_table AUTO_INCREMENT = 100; В Oracle можно изменить последовательность с помощью инструкции ALTER SEQUENCE. Этот оператор позволяет изменять характеристики последовательности, такие как минимальное и максимальное значения, шаг и начальное значение. Если необходимо внести более существенные изменения в последовательность, например изменить ее тип данных или полностью удалить ее, может потребоваться удалить и пересоздать последовательность.
DROP SEQUENCE example_table_seq; CREATE SEQUENCE example_table_seq INCREMENT BY 1 START WITH 100; Обратите внимание, что в Oracle нет проверки конфликтов между новым значением последовательности и существующими записями. Поэтому важно проявлять осторожность и использовать эту функцию ответственно, чтобы избежать непредвиденных последствий.
В PostgreSQL не имеет значения, как создается столбец с автоматическим увеличением (SERIAL, GENERATED ALWAYS AS IDENTITY или с помощью CREATE SEQUENCE), поскольку для изменения последовательности можно использовать инструкцию ALTER SEQUENCE. Однако данная СУБД не гарантирует отсутствие конфликтов после модификации последовательности, поэтому важно проявлять осторожность.
ALTER SEQUENCE example_table_id_seq RESTART WITH 100; Автоинкремент — это функция баз данных, которая генерирует уникальный номер для каждой новой строки, добавляемой в таблицу, избавляя пользователя от необходимости вручную управлять значениями первичного ключа.
Эта функция поддерживается большинством СУБД и может быть легко реализована с использованием разного синтаксиса в каждой базе данных. SQLite, MySQL и MariaDB поддерживают столбцы с автоинкрементом, а также PostgreSQL и Oracle, которые также допускают более продвинутые параметры, такие как последовательности и последовательные типы данных.
Хотя каждая база данных имеет свой собственный синтаксис для реализации и управления автоинкрементом.
В целом функция автоинкремента значительно упрощает процесс добавления новых строк и гарантирует, что каждая строка будет иметь уникальный идентификатор, что необходимо для многих операций с базой данных.
Если Вам понравилась статья, Вы можете поддержать автора.
Первичный ключ – GUID или автоинкремент?
Зачастую, когда разработчики сталкиваются с созданием модели данных, тип первичного ключа выбирается «по привычке», и чаще всего это автоинкрементное целочисленное поле. Но в реальности это не всегда является оптимальным решением, так как для некоторых ситуаций более предпочтительным может оказаться GUID. На практике возможны и другие, более редкие, типы ключа, но в данной статье мы их рассматривать не будем.
Ниже приведены преимущества каждого из вариантов.
- Занимает меньший объем
- Теоретически, более быстрая генерация нового значения
- Более быстрая десериализация
- Проще оперировать при отладке, поддержке, так как число гораздо легче запомнить
- При репликации между несколькими экземплярами базы, где добавление новых записей происходит более, чем в одну реплику, GUID гарантирует отсутствие коллизий
- Позволяет генерировать идентификатор записи на клиенте, до сохранения ее в базу
- Обобщение первого пункта — обеспечивает уникальность идентификаторов не только в пределах одной таблицы, что для некоторых решений может быть важно
- Делает практически невозможным «угадывание» ключа в случаях, когда запись можно получить, передав ее идентификатор в какой-нибудь публичный API
GUID можно генерировать как на клиенте, так и самой базой данных — уже два варианта. К тому же, в MS SQL есть две функции для получения уникального идентификатора — NEWID и NEWSEQUENTIALID. Давайте разберемся, в чем их отличие и может ли оно быть существенным на практике.
Привычная генерация уникальных идентификаторов в том же .NET через Guid.NewGuid() дает множество значений, не связанных друг с другом никакой закономерностью. Если ряд GUID-ов, полученных из этой функции, держать в отсортированном списке, то каждое новое добавляемое значение может «попадать» в любую его часть. Функция NEWID() в MS SQL работает аналогично — ряд ее значений весьма хаотичен. В свою очередь, NEWSEQUENTIALID() дает те же уникальные идентификаторы, только каждое новое значение этой функции больше предыдущего, при этом идентификатор остается «глобально уникальным».
Если использовать Entity Framework Code First, и объявить первичный ключ вот таким образом
[Key, DatabaseGenerated(DatabaseGeneratedOption.Identity)] public Guid Id
в базе данных будет создана таблица с первичным кластерным ключом, который имеет значение по умолчанию NEWSEQUENTIALID(). Сделано это из соображений производительности. Опять же, в теории, вставлять новое значение в середину списка более накладно, чем добавление в конец. База данных, конечно же, не массив в памяти, и вставка новой записи в середину списка строк не приведет к физическому сдвигу всех последующих. Тем не менее, дополнительные накладные расходы будут — разделение страниц (page split). По итогу также будет сильная фрагментация индексов, которая может отразиться на производительности выборки данных. Неплохое объяснение того, как происходит вставка данных в кластеризованую таблицу, можно найти в ответах форума по этой ссылке.
Таким образом, для GUID мы имеем 4 варианта, которые стоит проанализировать в плане производительности: последовательный и непоследовательный GUID с генерацией на клиенте, и та же пара вариантов, но с генерацией на стороне базы. Остается вопрос, как получать последовательные GUID на клиенте? К сожалению, стандартной функции в .NET для этих целей нет, но ее можно сделать, воспользовавшись P/Invoke:
internal static class SequentialGuidUtils < public static Guid CreateGuid() < Guid guid; int result = NativeMethods.UuidCreateSequential(out guid); if (result == 0) < var bytes = guid.ToByteArray(); var indexes = new int[] < 3, 2, 1, 0, 5, 4, 7, 6, 8, 9, 10, 11, 12, 13, 14, 15 >; return new Guid(indexes.Select(i => bytes[i]).ToArray()); > else throw new Exception("Error generating sequential GUID"); > > internal static class NativeMethods
Обратите внимание на то, что без специальной перестановки байт, GUID нельзя отдавать. Идентификаторы получатся корректные, но с точки зрения SQL сервера — непоследовательные, поэтому никакого выигрыша по сравнению с «обычным» GUID даже теоретически не получится. К сожалению, ошибочный код приведен во многих источниках.
К списку остается добавить пятый вариант — автоинкрементный первичный ключ. Других вариантов у него нет, так как на клиенте его генерировать нормально не получится.
С вариантами определились, но есть еще один параметр, который следует учесть при написании теста — физический размер строк таблицы. Размер страницы данных в MS SQL — 8 килобайт. Записи близкого или даже большего размера могут показать более сильный разброс производительности для каждого из вариантов ключа, чем на порядок меньшие записи. Чтобы обеспечить возможность варьировать размер записи, достаточно добавить в каждую из тестовых таблиц NVARCHAR поле, которое затем заполнять нужным количеством символов (один символ в NVARCHAR поле занимает 2 байта).
Тестирование
По этой ссылке находится проект с программой, которая была разработана с учетом указанных выше соображений.
- Всего три серии тестов с длиной текстового поля в записи 80, 800 и 8000 байт соответственно (количество символов в тестовой программе будет в два раза меньше в каждом из случаев, так как один символ в NVARCHAR занимает два байта).
- В каждой из серий — по 5 запусков, каждый из которых добавляет по 10000 записей в каждую из таблиц. По результатам каждого из запусков можно будет проследить зависимость времени вставки от количества строк, уже находящихся в таблице.
- Перед началом каждой из серий таблицы полностью очищаются.
What is Auto Increment in SQL and How to Set Up Auto Increment
While working with vast databases in SQL, several tables and data fields will require unique numbers. For instance, a column of the table with a PRIMARY KEY or UNIQUE constraint will always require a new number. You might be able to do it manually to a limited extent. But, when it comes to enormous databases, you might forget the last unique number you entered, or merely include the same number twice as it isn’t easy to remember everything. Besides the memory issue, providing a unique number to all the records is also a tedious task. That’s where auto increment in SQL comes in to play its part.
What is Auto Increment in SQL?
The auto increment in SQL is a feature that is applied to a field so that it can automatically generate and provide a unique value to every record that you enter into an SQL table. This field is often used as the PRIMARY KEY column, where you need to provide a unique value for every record you add. However, it can also be used for the UNIQUE constraint columns.
Basics to Advanced — Learn It All!
Caltech PGP Full Stack Development Explore Program
How to Set Up Auto Increment in SQL?
Now, since you know what the SQL auto increment field does, let’s set it up to automatically generate unique numbers for the records you enter in the database table. Several databases support SQL auto increment fields. You will be going through some primary DBMS systems and look at how to set up an auto increment column. You will have to create a Students table in all the DBMS and set auto increment in SQL.
Auto Increment in SQL: Setup for MySQL
In the MySQL server, it applies an auto increment field with the keyword AUTO_INCREMENT. By default, it starts with the number one and increases the value by one for each new record. In the example below, you will use the CREATE TABLE command to create a Students table and apply PRIMARY KEY and AUTO_INCREMENT to the ID column. After making the table, you will use the INSERT INTO command to add rows without providing the ID column’s value.
CREATE TABLE Students(
ID int PRIMARY KEY AUTO_INCREMENT,
FirstName varchar(25) NOT NULL,
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Rahul’, ‘Kumar’, 24);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Aakash’, ‘Roy’, 25);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Nick’, ‘Chopra’, 23);
SELECT * FROM Students;
Output:
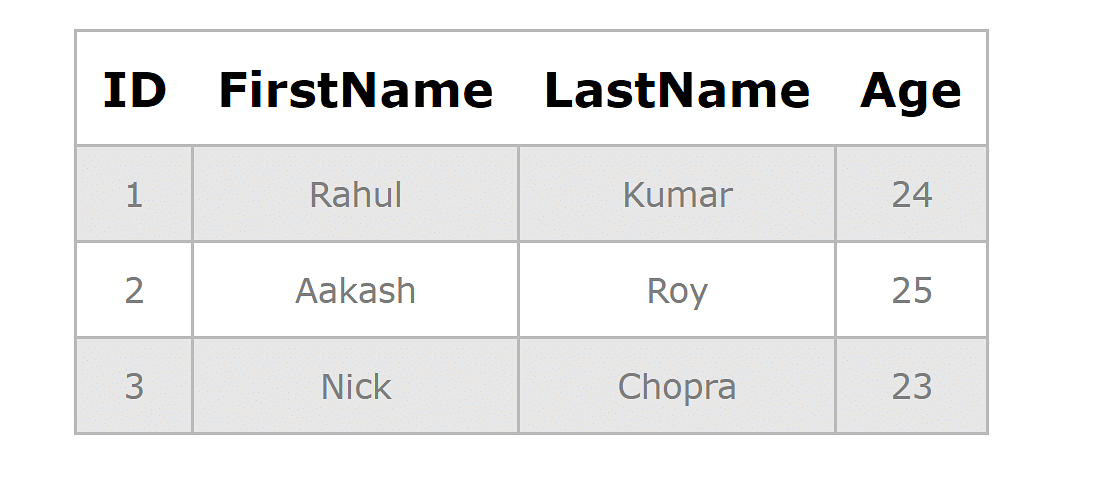
As you can see in the output, auto increment in SQL provided the ID column with unique numbers as expected.
You can also make an auto increment in SQL to start from another value with the following syntax:
ALTER TABLE table_name AUTO_INCREMENT = start_value;
In the syntax above:
- start_value: It is the value from where you want to begin the numbering
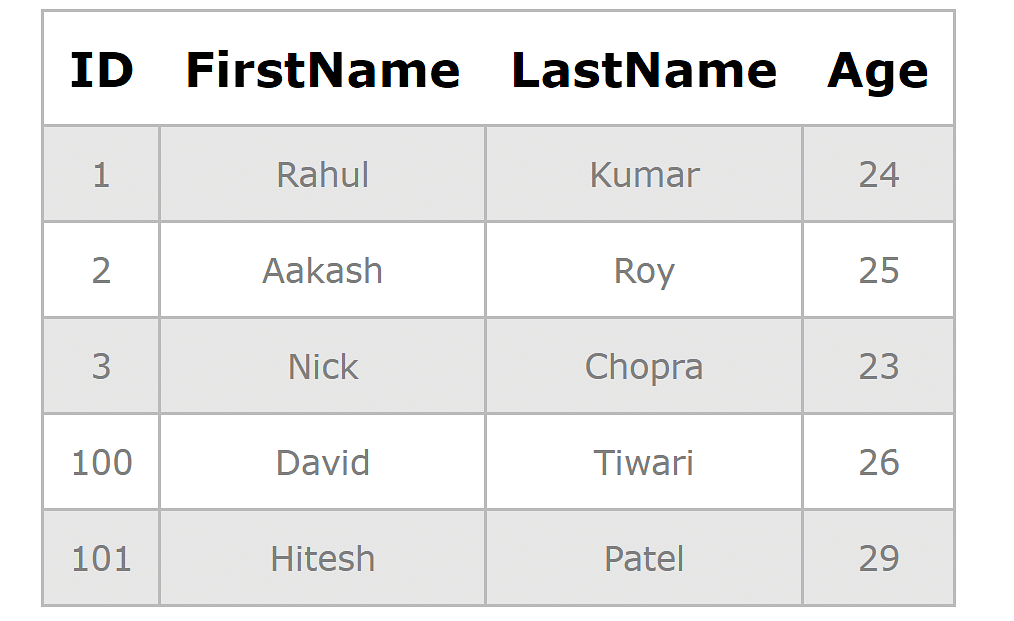
Use the syntax to start the numbering from 100 in the Students table and then add more rows to see it in action.
ALTER TABLE Students AUTO_INCREMENT = 100;
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘David’, ‘Tiwari’, 26);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Hitesh’, ‘Patel’, 29);
SELECT * FROM Students;
Output:
Basics to Advanced — Learn It All!
Caltech PGP Full Stack Development Explore Program
Auto Increment in SQL: Setup for SQL Server
The SQL Server uses the IDENTITY keyword to set auto increment with the following syntax while creating a table:
IDENTITY (initial_value, increment_value);
In the above syntax:
- initial_value: It is the value from where you want the numbering to begin
- increment_value: It is the increment between each auto-generated number
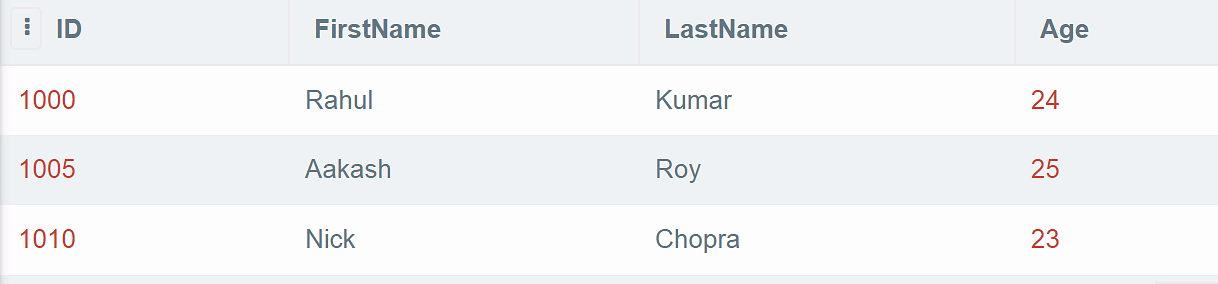
Let’s create the same Students table in the SQL Server and use the IDENTITY keyword to set auto increment. This time you will directly start with 1000 and have an interval of 5 between each row’s number.
CREATE TABLE Students(
ID int IDENTITY(1000, 5) PRIMARY KEY,
FirstName varchar(25) NOT NULL,
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Rahul’, ‘Kumar’, 24);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Aakash’, ‘Roy’, 25);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Nick’, ‘Chopra’, 23);
SELECT * FROM Students;
Output:
Basics to Advanced — Learn It All!
Caltech PGP Full Stack Development Explore Program
Auto Increment in SQL: Setup for MS Access
The AUTOINCREMENT keyword is used to set up auto increment in MS Access. The default starting and increment values for AUTOINCREMENT are 1 and 1, respectively. However, you can easily change it while setting the auto increment with the following syntax:
In the above syntax:
- start_value: It is the value from where you want the numbering to begin
- increment_value: It is the increment between each auto-generated number
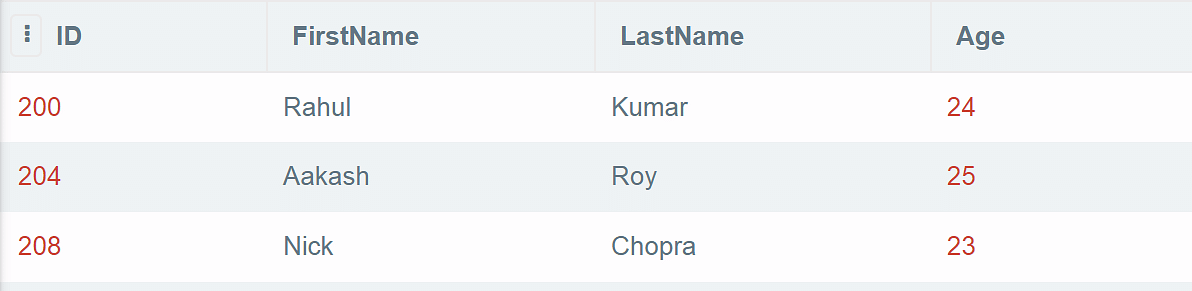
This time you will create a Students1 table in the example below with the MS Access server and set up auto increment in SQL with the same input values. In this case, you have to set the start_value to 200 and increment_value to 4.
CREATE TABLE Students1(
ID int AUTOINCREMENT(200,4) PRIMARY KEY,
FirstName varchar(25) NOT NULL,
INSERT INTO Students1 (FirstName, LastName, Age) VALUES (‘Rahul’, ‘Kumar’, 24);
INSERT INTO Students1 (FirstName, LastName, Age) VALUES (‘Aakash’, ‘Roy’, 25);
INSERT INTO Students1 (FirstName, LastName, Age) VALUES (‘Nick’, ‘Chopra’, 23);
SELECT * FROM Students1;
Output:
Basics to Advanced — Learn It All!
Caltech PGP Full Stack Development Explore Program
Auto Increment in SQL: Setup for Oracle
To set up auto increment in Oracle, you will have to create a sequence object first. This object is used to generate a number sequence. Here’s how you can use the CREATE SEQUENCE statement in Oracle to create a sequence object for the Students’ table.
CREATE SEQUENCE seq_Students
The syntax above will create a sequence object named seq_Students that starts with 20 and increases by 2 with a cache of 20 (the number of sequence values stored in memory). You will now use the built-in nextval function to add values with the auto increment feature and see it in action. Let’s create the table Students and insert the values.
CREATE TABLE Students(
ID number(10) PRIMARY KEY,
FirstName varchar2(50) NOT NULL,
INSERT INTO Students (ID, FirstName, LastName, Age) VALUES (seq_Students.nextval, ‘Rahul’, ‘Kumar’, 24);
INSERT INTO Students (ID, FirstName, LastName, Age) VALUES (seq_Students.nextval, ‘Aakash’, ‘Roy’, 25);
INSERT INTO Students (ID, FirstName, LastName, Age) VALUES (seq_Students.nextval, ‘Nick’, ‘Chopra’, 23);
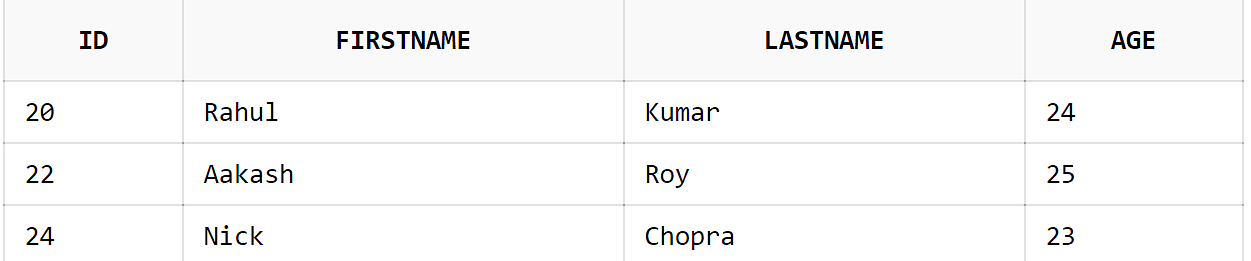
SELECT * FROM Students;
Output:
Learn From The Best Mentors in the Industry!
Automation Testing Masters Program Explore Program
Auto Increment in SQL: Setup for PostgreSQL
In PostgreSQL, the SERIAL keyword is used to set up an auto increment column. SERIAL in PostgreSQL is a data type, like BIGSERIAL and SMALLSERIAL. But it works similar to the auto increment in SQL. However, you cannot set a starting value or the increment value of your choice explicitly. Here’s how you can create a table and use the SERIAL keyword to set auto increment in PostgreSQL.
CREATE TABLE Students(
ID SERIAL PRIMARY KEY,
FirstName TEXT NOT NULL,
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Rahul’, ‘Kumar’, 24);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Aakash’, ‘Roy’, 25);
INSERT INTO Students (FirstName, LastName, Age) VALUES (‘Nick’, ‘Chopra’, 23);
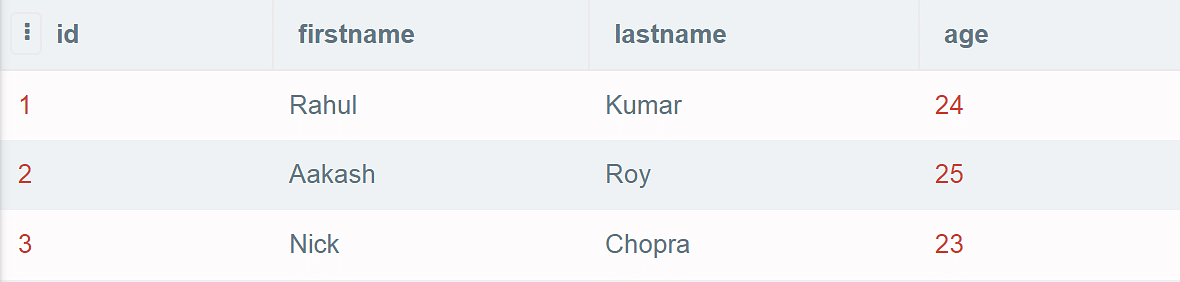
SELECT * FROM Students;
Output:
Conclusion:
In this article, you learned everything about auto increment in SQL. You have gone through the use of auto increment and how to set it up in different DBMS servers. Knowing how and where to use auto increment will help you efficiently manage enormous databases, especially while working with PRIMARY KEY constraint tables. Do you have any questions related to this article on Auto Increment in SQL? In case you do, then please put them in the comments section. Our team will help you solve them.
About the Author
Simplilearn
Simplilearn is one of the world’s leading providers of online training for Digital Marketing, Cloud Computing, Project Management, Data Science, IT, Software Development, and many other emerging technologies.