
Индексы
В следующей таблице перечислены типы индексов, доступные в SQL Server, и ссылки на дополнительные сведения.
В документации по SQL Server термин «сбалансированное дерево» обычно используется в отношении индексов. В индексах rowstore SQL Server реализует B+-дерево. Это не относится к индексам columnstore или хранилищам данных в памяти. Дополнительные сведения см. в руководстве по архитектуре и проектированию индексов SQL Sql Server и Azure.
Далее
- Руководство по проектированию индексов SQL Server
- Параметр SORT_IN_TEMPDB для индексов
- Отключение индексов и ограничений
- Включение индексов и ограничений
- Переименование индексов
- Установка параметров индекса
- Disk Space Requirements for Index DDL Operations
- Реорганизация и перестроение индексов
- Указание коэффициента заполнения для индекса
- Руководство по архитектуре страниц и экстентов
- Описание кластеризованных и некластеризованных индексов
SQL-Ex blog
Производительность запросов. Взять запрос и заставить его выполняться быстрей, чем прежде, или потреблять меньше ресурсов — достаточная мотивация. В большинстве случаев улучшения производительности можно достичь добавлением индекса к столбцам, используемым в предикате запроса. Направление дает либо предложение WHERE, либо ORDER BY, или даже просто столбцы в предложении SELECT. Если вы новичок в SQL Server с его различными типами имеющихся индексов, бывает трудно решить, какой из них лучше всего подошел бы в вашем конкретном случае. Здесь мы пройдемся по всем типам доступных индексов, чтобы дать вам обзор, а также совет относительно применения того или иного индекса в конкретном случае использования.
Решение
Таблицы кучи в SQL Server
Что такое куча (heap) в SQL Server?
Прежде чем мы погрузимся в различные типы индексов SQL Server, сначала следует описать базовую структуру таблицы. Таблицы, на которых не определен кластеризованный индекс (об этом позже), сохраняются в структурах «кучи», что означает, главным образом, отсутствие порядка хранения наборов данных на каждой странице.
Преимущества и использование кучи в SQL Server
Основной вариант использования для реализации структуры кучи состоит в требовании быстрой вставки данных в вашу таблицу. Подумайте о журнализации или аудите таблицы, в которую постоянно записываются новые данные. Со структурой кучи движку базы данных нет необходимости выяснять куда вставлять новые данные. Он просто добавляет данные на последнюю страницу, а если она заполнена, добавляет новую страницу и записывается данные туда.
Недостатки кучи в SQL Server
Запросы к таблице кучи могут быть очень медленными. Особенно тогда, когда отсутствуют также и некластеризованные индексы на этой таблице. При отсутствии каких-либо индексов каждый запрос, который обращается к таблице кучи, должен выполнять полное сканирование таблицы, а мы все знаем, насколько дорого это обходится, если таблица имеет большой размер.
Базовый синтаксис кучи в SQL Server
CREATE TABLE TestData (TestId integer, TestName varchar(255), TestDate date,
TestType integer, TestData1 integer,
TestData2 varchar(100), TestData3 XML,
TestData4 varbinary(max), TestData4_FileType varchar(3));
ALTER TABLE TestData REBUILD;
DROP TABLE TestData;
Кластеризованный индекс в SQL Server
Что такое кластеризованный индекс?
Кластеризованный индекс один из главных типов индекса в SQL Server. Кластеризованный индекс сохраняет индексный ключ в структуре B-Tree, наряду с фактическими данными таблицы в каждом листовом узле индекса. Задание кластеризованного индекса на таблице аннулирует структуру кучи, которая описывалась выше. Поскольку остальные данные таблицы (например, неключевые столбцы) сохраняются на листовых узлах индексной структуры, таблица может иметь только один кластеризованный индекс.
Преимущества и использование кластеризованного индекса
Наличие кластеризованного индекса на таблице приносит много пользы, но главным преимуществом является ускорение производительности запроса. Запросы, которые содержат столбцы ключа индекса в предложении WHERE, используют структуру индекса для прямого доступа к данным таблицы. Кластеризованный индекс также устраняет необходимость в лишнем поиске для получения данных остальных столбцов в запросах на основе значений ключа индекса. Это зачастую не справедливо для индексов других типов. Вы также можете избавиться от необходимости сортировать данные. Если предложение ORDER BY запроса основывается на значениях ключа индекса, то сортировка не потребуется, поскольку данные уже упорядочены по этим значениям.
Недостатки кластеризованного индекса
Имеется пара недостатков, связанных с кластеризованными индексами. Это некоторые накладные расходы на поддержание индексной структурой, связанные с любыми операциями DML (INSERT, UPDATE, DELETE). Это особенно справедливо, если вы обновляете фактические значения ключа в индексе, т.к. в этом случае все связанные табличные данные также должны быть перемещены, поскольку они хранятся на листовом узле записи индекса. В каждом случае это окажет определенное влияние на производительность вашего DML-запроса.
Основной синтаксис кластеризованного индекса в SQL Server
CREATE CLUSTERED INDEX IX_TestData_TestId ON dbo.TestData (TestId);
ALTER INDEX IX_TestData_TestId ON TestData REBUILD WITH (ONLINE = ON);
DROP INDEX IX_TestData_TestId on TestData WITH (ONLINE = ON);
Некластеризованный индекс в SQL Server
Что такое некластеризованный индекс?
Некластеризованный индекс — это еще один главный тип индексов, используемых в SQL Server. Подобно своей противоположности, кластеризованному индексу, столбцы ключа индекса сохраняются в структуре B-Tree; исключение составляет то, что фактические данные не сохраняются на листочных узлах. В индексах этого типа на листовых узлах сохраняется указатель на фактические данные. Он может указывать на данные в кластеризованном индексе или на структуру кучи, в зависимости от того, как хранятся данные.
Преимущества и использование некластеризованных индексов
Преимущества некластеризованного индекса подобны упомянутым выше преимуществам кластеризованного. Главным образом, это ускорение производительности запроса. Тем не менее, есть два отличия. Во-первых, вы можете иметь множество некластеризованных индексов, определенных на одной таблице. Это позволяет вам индексировать различные столбцы, что может помочь запросам с различными столбцами в предложении WHERE более быстро извлекать данные и избежать необходимости сортировки, заданной в предложении ORDER BY. Во-вторых, хотя имеются накладные расходы в обслуживании некластеризованных индексов при выполнении операторов DML, они меньше, чем для кластеризованного индекса.
Недостатки некластеризованного индекса
Главным недостатком, как и для кластеризованного индекса, является избыточная нагрузка, требуемая для поддержания индекса при операциях DML. Иногда может быть сложно сбалансировать производительность запросов, если таблица имеет слишком много некластеризованных индексов. Помогая всем запросам на выборку, они, в то же время, могут реально замедлить выполнение запросов DML.
Основной синтаксис некластеризованного индекса в SQL Server
CREATE INDEX IX_TestData_TestDate ON dbo.TestData (TestDate);
ALTER INDEX IX_TestData_TestDate ON TestData REBUILD WITH (ONLINE = ON);
DROP INDEX IX_TestData_TestDate on TestData;
Индексы поколоночного хранения в SQL Server
Что такое индекс поколоночного хранения?
Поколоночный индекс является другим типом некластеризованного индекса, который использует формат хранения на базе столбца для индексирования данных. Индексы поколоночного хранения могут создаваться как кластеризованными, так и некластеризованными.
Преимущества и использование поколоночного индекса
Индексы поколоночного хранения были спроектированы для использования при индексировании очень больших объемов данных в приложениях хранилищ данных, в частности, для фактологических таблиц. В зависимости от индексируемых данных вы можете наблюдать до 100-кратного улучшения производительности запроса. Поколоночные индексы также обладают возможностью сжатия данных. В зависимости от ваших данных можно получить 10-кратную экономию пространства хранения. Чем меньше селективность вашего столбца, тем больше он может быть сжат.
Недостатки индексов поколоночного хранения
Как и для каждой возможности, имеются некоторые недостатки при использовании поколоночных индексов. Они не могут использоваться со всеми типами данных: типы varchar(max)/nvarchar(max), xml и text/ntext, image и CLR не поддерживаются в индексах поколоночного хранения. Их также нельзя использовать, если включены такие функции, как репликация, сбор данных об изменениях или отслеживание изменений. Что касается производительности, хотя запросы SELECT могут показать большое улучшение, это не относится к операциям DML. В силу накладных расходов, связанных с обновлением поколоночного индекса, любые операции DML будут выполняться хуже, чем их построчные аналоги. Наконец, хотя это уже не должно быть проблемой, если вы пользуетесь последней версией SQL Server, но до SQL Server 2014 индексы поколоночного хранения не были обновляемыми, поэтому наличие одного такого индекса делало соответствующую таблицу доступной только на чтение.
Основной синтаксис поколоночных индексов в SQL Server
CREATE CLUSTERED COLUMNSTORE INDEX CIX_TestData_TestType ON TestData.TestType
WITH (DATA_COMPRESSION = COLUMNSTORE);
ALTER INDEX CIX_TestData_TestType ON TestData REORG IX_TestData_TestDate;
DROP INDEX CIX_TestData_TestType;
XML индексы в SQL Server
Что такое XML индекс?
Индексы XML представляют собой специальный тип индекса, который может быть создан на столбцах типа XML. Имеется два типа индексов XML, первичный и вторичный, которые индексируют все теги, значения, пути и свойства XML данных в столбце. На таблице, для которой вы хотите создать XML индекс, требуется наличие кластеризованного первичного ключа, т.к. этот первичный ключ используется для корреляции строк в первичном XML индексе со строками в таблице, которая содержит столбец XML.
Преимущества и использование индекса XML
Вообще говоря, вы можете получить выгоду из использования XML индекса, когда XML значения столбца велики, но извлекаемые части малы. Это будет препятствовать загрузке всего XML значения в память и парсинга для каждого запроса. Первичный XML индекс будет индексировать все теги, значения и пути вашего столбца XML и может вернуть скалярные значения или поддеревья XML. Вторичные индексы могут быть трех разных типов. Вторичный XML-индекс PATH выгоден, если ваши запросы используют выражения пути. Если ваши запросы не знают имен атрибутов в XML значениях, то вторичный XML-индекс VALUE может ускорить эти запросы. Запросы, для которых первичный ключ объекта значения известен, и вы используете метод value() типа XML, могут получить преимущество с индексом PROPERTY.
Недостатки XML индексов
Главным недостатком при использовании XML индексов является то, что они могут использовать большое количество дискового пространства, поскольку каждый тег в XML значении создает множество строк в индексе. Как и для всех индексов, здесь также имеются накладные расходы при обновлении/поддерживании индекса, что вызывает замедление операций DML на XML столбце.
Основной синтаксис индекса XML в SQL Server
-- первичный индекс
CREATE PRIMARY XML INDEX PXML_TestData_TestData3 ON TestData (TestData3);
-- вторичные индексы
CREATE XML INDEX XMLPATH_TestData_TestData3 ON TestData (TestData3)
USING XML INDEX PXML_TestData_TestData3 FOR PATH;
CREATE XML INDEX XMLPROPERTY_TestData_TestData3 ON TestData (TestData3)
USING XML INDEX PXML_TestData_TestData3 FOR PROPERTY;
CREATE XML INDEX XMLVALUE_TestData_TestData3 ON TestData (TestData3)
USING XML INDEX PXML_TestData_TestData3 FOR VALUE;
Полнотекстовые индексы в SQL Server
Что такое полнотекстовый индекс?
Полнотекстовый индекс представляет собой специальный тип индекса, который предоставляет индексирование, поддерживающее полнотекстовые запросы. Эти специальные индексы также могут быть созданы на двоичном или символьном столбце. Они отличаются от стандартных индексов тем, что вместо использования всего столбца в качестве ключа индекса, данные в столбце разбиваются на токены, и именно эти токены используются для построения индекса и служат в качестве предиката при навигации по структуре индекса. Сама структура индекса также сохраняется в своем собственном каталоге, а не в файлах данных базы данных.
Преимущества и использование полнотекстового индекса
Как упоминалось выше, это возможность полнотекстового поиска с созданием индексов на столбцах, которые не индексируются с помощью индексов стандартных типов. В помощью полнотекстовых индексов мы можем проиндексировать большие столбцы varchar(max) и nvarchar(max), а также столбцы любых следующих типов данных: char, varchar, nchar, nvarchar, text, ntext, image, xml и FILESTREAM. После создания индекса вы можете писать запросы, которые выполняют индексный поиск, используя функции полнотекстовых запросов, которые будут искать данные, связанные с любыми из следующих условий.
. Одно или больше конкретных слов или фраз (простой термин).
. Слово или фраза, когда слова начинаются с конкретного текста (префиксный термин).
. Флективные формы конкретного слова (термин рода).
. Слово или фраза, близкие к другому слову или фразе (термин близости).
. Синонимические формы конкретного слова (тезаузус).
. Слова или фразы, использующие взвешенные значения (взвешенный термин).
Недостатки полнотекстовых индексов
Большинство недостатков использования полнотекстовых индексов связано с потреблением ресурсов. Поскольку поиск в полнотекстовом индексе выполняется службой MSFTESQL, а не службой SQL Server, эти две службы могут конкурировать за ресурсы на вашем сервере. Если не сконфигурировать правильно эти две службы, могут возникнуть проблемы. Кроме того, хотя дисковое пространство становится все более дешевым с годами, все еще есть нагрузка, связанная с количеством операций ввода/вывода для ваших файлов данных, поэтому для относительно большого каталога может иметь смысл размещать этот каталог на отдельном диске, чтобы две службы (SQL Server и MSFTESQL) не конкурировали за этот ресурс.
Основной синтаксис полнотекстового индекса в SQL Server
-- перед созданием индекса требуется создать каталог
CREATE FULLTEXT CATALOG fulltextCatalog AS DEFAULT;
CREATE FULLTEXT INDEX ON dbo.TestData (TestData4 TYPE COLUMN TestData4_FileType)
KEY INDEX PK_TestData WITH STOPLIST = SYSTEM;
ALTER FULLTEXT CATALOG fulltextCatalog REBUILD;
DROP FULLTEXT INDEX ON dbo.TestData;
Вариации индексов в SQL Server
Включенные в индекс столбцы
Это не тип индекса, а фактически предложение, которое может быть добавлено в некластеризованный индекс, в котором содержатся значения столбцов, перечисленных в предложении, на листовых узлах индекса. Это придает некластеризованному индексу поведение, подобное кластеризованному индексу, а именно, что он может извлекать данные этих столбцов, не обращаясь к данным таблицы. Он также позволяет включать в индекс больше такие столбцы, которые, в противном случае, не могли быть включены в ключ индекса. Все типы данных, за исключением устаревших типов text, ntext и image могут использоваться в предложении включения столбцов.
CREATE NONCLUSTERED INDEX IX_TestData_TestDate_incTestData3 ON TestData (TestDate)
INCLUDE (TestData3);
Индекс на базе функций SQL Server (вычисляемые столбцы)
Индексы на основе функций создаются на значениях, полученных в результате применения функции к ряду столбцов. К сожалению, SQL Server не имеет непосредственной поддержки индексов на базе функций, но вы можете эмулировать эту функциональность с помощью вычисляемых столбцов. Единственным требованием возможности создания индекса на вычисляемом столбце является детерминированность функции и сохраняемость вычисляемого столбца. Ниже приведен пример.
ALTER TABLE TestData ADD TestDatePlus7Days AS DATEADD(DAY,7,TestDate) PERSISTED;
CREATE NONCLUSTERED INDEX IX_TestData_TestDate_Plus7Days ON TestData (TestDatePlus7Days);
Фильтрованный индекс в SQL Server
Фильтрованный индекс — это некластеризованный индекс, который включает предложение WHERE. Они полезны, когда создаются на больших таблицах для того, чтобы уменьшить размер индекса, сократить время обслуживания и улучшить производительность конкретных запросов. Заметим, что этот тип индекса будет использоваться только тогда, если его предложение WHERE совпадает с предложением WHERE запроса.
CREATE INDEX IX_TestData_TestDate_TestTypeEq1 on TestData (TestDate) WHERE TestType=1;
Покрывающий индекс SQL Server
Покрывающий индекс — это некластеризованный индекс, когда все столбцы, на которые есть ссылки в запросе, являются либо частью ключа индекса, либо указаны в предложении включенных столбцов оператора создания индекса. Покрывающие индексы улучшают производительность, поскольку они устраняют необходимость поиска дополнительных данных в столбцах самой таблицы. Ниже приведен пример покрывающего индекса, который покрывает все столбцы нижеследующего запроса.
CREATE INDEX IX_TestData_TestDate_TestType_AllData on TestData (TestDate,TestType)
INCLUDE (TestData1,TestData2,TestData3,TestData4);
SELECT TestData1,TestData2,TestData3,TestData4 FROM TestData WHERE TestDate > current_timestamp-1 and TestType=1;
Обслуживание индексов в SQL Server
Хотя индексы хороши для улучшения производительности вашей базы данных, они требуют некоторого обслуживания для поддержания их оптимальной работы. Спустя некоторое время после выполнения операторов INSERT, UPDATE и DELETE на вашей таблице, связанные с ней индексы могут стать фрагментированными. Существует много факторов, которые влюяют на то, насколько быстро индекс становится фрагментированным, но к счастью у нас есть несколько встроенных в SQL Server инструментов, которые покажут точную фрагментацию индекса. Динамическое представление sys.dm_db_index_physical_stats даст вам размер и статистику фрагментации по каждому их ваших индексов. Приведенный ниже запрос может быть использован как исходная точка в списке фрагментации ваших индексов. Обратите внимание на последний параметр, SAMPLED. Этот параметр определяет уровень сканирования при сборе статистики индекса. Я обычно использую SAMPLED, т.к. большинство систем, с которыми я работаю, довольно большие, но существуют и другие варианты, которые дают более или менее подробную информацию в зависимости от ваших потребностей. Другими вариантами являются DEFAULT, NULL, LIMITED, DETAILED.
SELECT t.name AS TableName,i.name AS IndexName,
ROUND(avg_fragmentation_in_percent,2) AS avg_fragmentation_in_percent
FROM sys.dm_db_index_physical_stats(DB_ID(), NULL, NULL, NULL, 'SAMPLED') ips
INNER JOIN sys.tables t on t.[object_id] = ips.[object_id]
INNER JOIN sys.indexes i ON (ips.object_id = i.object_id) AND (ips.index_id = i.index_id)
ORDER BY avg_fragmentation_in_percent DESC;
Как только вы определили уровень фрагментации ваших индексов, у вас есть два варианта для её устранения. Вы можете использовать либо REORGANIZE (реорганизовать индекс) либо REBUILD (перестроить индекс). Майкрософт рекомендует ничего не предпринимать, если уровень фрагментации менее 10%, от 10% до 30% использовать REORG, а свыше 30% перестраивать (REBUILD). Эти числа выбраны на основе времени, котрое требуется для выполнения каждой операции. REBUILD создает новый индекс с нуля, в то время как REORGпросто работает над устранением фрагментации. Индекс с небольшой фрагментацией может быть реогранизован довольно быстро. Но когда фрагментация превышает 30%, индекс обычно может быть перестроен за то же время, что и REORG, поэтому имеет смысл просто перестроить его. Есть и другие факторы, которые следует принять во внимание при выборе варианта. Вот они.
| REBUILD | REORG |
|---|---|
| требуется достаточно пространства для создания нового индекса | работает на месте, поэтому никакого дополнительного пространства не требуется |
| если процесс прерывается, требуется начинать заново | может продолжиться с того места, на котором процесс прервался |
| может выполняться онлайн или офлайн | всегда выполняется онлайн |
| генерирует больше записей в журнал, чем reorg | записывает в журнал только блоки, которые были реорганизованы |
| статистика обновляется автоматически | обновление статистики должно быть выполнено вручную |
Обзор типов индексов Oracle, MySQL, PostgreSQL, MS SQL
В одном из комментариев здесь была просьба рассказать подробнее об индексах, и так как, в рунете практически нет сводных данных о поддерживаемых индексах различных СУБД, в данном обзоре я рассмотрю, какие типы индексов поддерживаются в наиболее популярных СУБД
B-Tree
Семейство B-Tree индексов — это наиболее часто используемый тип индексов, организованных как сбалансированное дерево, упорядоченных ключей. Они поддерживаются практически всеми СУБД как реляционными, так нереляционными, и практически для всех типов данных.
Так как большинство, наверное, их хорошо знает(или могут прочесть о них например, здесь), то единственное, что, пожалуй, следует здесь отметить, это то, что данный тип индекса оптимален для множества с хорошим распределением значений и высокой мощностью(cardinality-количество уникальных значений).
Пространственные индексы
В данный момент все данные СУБД имеют пространственные типы данных и функции для работы с ними, для Oracle — это множество типов и функций в схеме MDSYS, для PostgreSQL — point, line, lseg, polygon, box, path, polygon, circle, в MySQL — geometry, point, linestring, polygon, multipoint, multilinestring, multipolygon, geometrycollection, MS SQL — Point, MultiPoint, LineString, MultiLineString, Polygon, MultiPolygon, GeometryCollection.
В схеме работы пространственных запросов обычно выделяют две стадии или две ступени фильтрации. СУБД, обладающие слабой пространственной поддержкой, отрабатывают только первую ступень (грубая фильтрация, MySQL). Как правило, на этой стадии используется приближенное, аппроксимированное представление объектов. Самый распространенный тип аппроксимации – минимальный ограничивающий прямоугольник (MBR – Minimum Bounding Rectangle) [100].
Для пространственных типов данных существуют особые методы индексирования на основе R-деревьев(R-Tree index) и сеток(Grid-based Spatial index).
Spatial grid
Spatial grid(пространственная сетка) index – это древовидная структура, подобная B-дереву, но используется для организации доступа к пространственным(Spatial) данным, то есть для индексации многомерной информации, такой, например, как географические данные с двумерными координатами(широтой и долготой). В этой структуре узлами дерева выступают ячейки пространства. Например, для двухмерного пространства: сначала вся родительская площадь будет разбита на сетку строго определенного разрешения, затем каждая ячейка сетки, в которой количество объектов превышает установленный максимум объектов в ячейке, будет разбита на подсетку следующего уровня. Этот процесс будет продолжаться до тех пор, пока не будет достигнут максимум вложенности (если установлен), или пока все не будет разделено до ячеек, не превышающих максимум объектов.
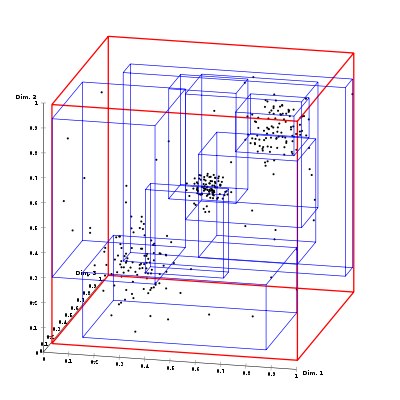
В случае трехмерного или многомерного пространства это будут прямоугольные параллелепипеды (кубоиды) или параллелотопы.
Quadtree
Quadtree – это подвид Grid-based Spatial index, в котором в родительской ячейке всегда 4 потомка и разрешение сетки варьируется в зависимости от характера или сложности данных.
R-Tree
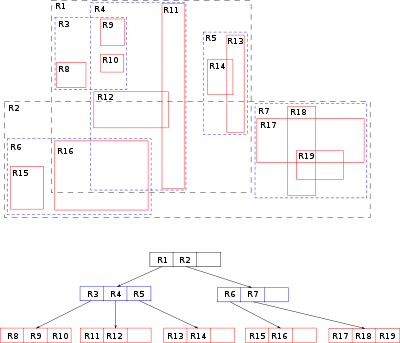
R-Tree (Regions Tree) – это тоже древовидная структура данных подобная Spatial Grid, предложенная в 1984 году Антонином Гуттманом. Эта структура данных тоже разбивает пространство на множество иерархически вложенных ячеек, но которые, в отличие от Spatial Grid, не обязаны полностью покрывать родительскую ячейку и могут пересекаться.
Для расщепления переполненных вершин могут применяться различные алгоритмы, что порождает деление R-деревьев на подтипы: с квадратичной и линейной сложностью(Гуттман, конечно, описал и с экспоненциальной сложностью — Exhaustive Search, но он, естественно, нигде не используется).
Квадратичный подтип заключается в разбиении на два прямоугольника с минимальной площадью, покрывающие все объекты. Линейный – в разбиении по максимальной удаленности.
HASH
Hash-индексы были предложены Артуром Фуллером, и предполагают хранение не самих значений, а их хэшей, благодаря чему уменьшается размер(а, соответственно, и увеличивается скорость их обработки) индексов из больших полей. Таким образом, при запросах с использованием HASH-индексов, сравниваться будут не искомое со значения поля, а хэш от искомого значения с хэшами полей.
Из-за нелинейнойсти хэш-функций данный индекс нельзя сортировать по значению, что приводит к невозможности использования в сравнениях больше/меньше и «is null». Кроме того, так как хэши не уникальны, то для совпадающих хэшей применяются методы разрешения коллизий.
Bitmap
Bitmap index – метод битовых индексов заключается в создании отдельных битовых карт (последовательность 0 и 1) для каждого возможного значения столбца, где каждому биту соответствует строка с индексируемым значением, а его значение равное 1 означает, что запись, соответствующая позиции бита содержит индексируемое значение для данного столбца или свойства.
| EmpID | Пол |
|---|---|
| 1 | Мужской |
| 2 | Женский |
| 3 | Женский |
| 4 | Мужской |
| 5 | Женский |
Битовые карты
| Значение | Начало | Конец | Битовая маска |
|---|---|---|---|
| Мужской | Адрес первой строки | Адрес последней строки | 10010 |
| Женский | Адрес первой строки | Адрес последней строки | 01101 |
Основное преимущество битовых индексов в том, что на больших множествах с низкой мощностью и хорошей кластеризацией по их значениям индекс будет меньше чем B*-tree. (Подробнее стоит прочесть здесь или здесь)
Reverse index
Reverse index – это тоже B-tree индекс но с реверсированным ключом, используемый в основном для монотонно возрастающих значений(например, автоинкрементный идентификатор) в OLTP системах с целью снятия конкуренции за последний листовой блок индекса, т.к. благодаря переворачиванию значения две соседние записи индекса попадают в разные блоки индекса. Он не может использоваться для диапазонного поиска.
Пример:
| Поле в таблице(bin) | Ключ reverse-индекса(bin) |
|---|---|
| 00000001 | 10000000 |
| … | … |
| 00001001 | 10010000 |
| 00001010 | 01010000 |
| 00001011 | 11010000 |
Как видите, значение в индексе изменяется намного больше, чем само значение в таблице, и поэтому в структуре b-tree, они попадут в разные блоки.
Inverted index
Инвертированный индекс – это полнотекстовый индекс, хранящий для каждого лексемы ключей отсортированный список адресов записей таблицы, которые содержат данный ключ.
| 1 | Мама мыла раму |
| 2 | Папа мыл раму |
| 3 | Папа мыл машину |
| 4 | Мама отполировала машину |
В упрощенном виде это будет выглядеть так:
| Мама | 1,4 |
| Мыла | 1 |
| Раму | 1,2 |
| Папа | 2,3 |
| Отполировала | 4 |
| Машину | 3,4 |
Partial index
Partial index — это индекс, построенный на части таблицы, удовлетворяющей определенному условию самого индекса. Данный индекс создан для уменьшения размера индекса.
Function-based index
Самим же гибким типом индексов являются функциональные индексы, то есть индексы, ключи которых хранят результат пользовательских функций. Функциональные индексы часто строятся для полей, значения которых проходят предварительную обработку перед сравнением в команде SQL. Например, при сравнении строковых данных без учета регистра символов часто используется функция UPPER. Создание функционального индекса с функцией UPPER улучшает эффективность таких сравнений.
Кроме того, функциональный индекс может помочь реализовать любой другой отсутствующий тип индексов данной СУБД(кроме, пожалуй, битового индекса, например, Hash для Oracle)
Сводная таблица типов индексов
| MySQL | PostgreSQL | MS SQL | Oracle | |
| B-Tree index | Есть | Есть | Есть | Есть |
| Поддерживаемые пространственные индексы(Spatial indexes) | R-Tree с квадратичным разбиением | Rtree_GiST(используется линейное разбиение) | 4-х уровневый Grid-based spatial index (отдельные для географических и геодезических данных) | R-Tree c квадратичным разбиением; Quadtree |
| Hash index | Только в таблицах типа Memory | Есть | Нет | Нет |
| Bitmap index | Нет | Есть | Нет | Есть |
| Reverse index | Нет | Нет | Нет | Есть |
| Inverted index | Есть | Есть | Есть | Есть |
| Partial index | Нет | Есть | Есть | Нет |
| Function based index | Нет | Есть | Есть | Есть |
Стоит упомянуть, что в PostgreSQL GiST позволяет создать для любого собственного типа данных индекс основанный на R-Tree. Для этого нужно реализовать все 7 функций механизма R-Tree.
PS. Возможно я что-либо забыл упомянуть, пишите на личку или в комментарии — добавлю.
Какие бывают индексы sql
После прочтения многочисленной литературы по СУБД, некоторого опыта работы с MongoDB и листанию статей по базам данных у меня созрело желание сделать cheatsheet по индексам применительно к БД. А индексирование – достаточно интересный раздел теории баз данных, а главное – нужный в практике. Вообще-то говоря, золотое правило индексирования – иметь индекс под каждый запрос.
По порядку сортировки
- Упорядоченные – индексы, в которых элементы поля(столбца) упорядочены.
- Возрастающие
- Убывающие
По источнику данных
- Индексы по представлению (view).
- Индексы по выражениям – например в PostgreSQL.
По воздействию на источник данных
- Некластерный индекс – наиболее типичные представители семейства индексов. В отличие от кластерных, они не перестраивают физическую структуру таблицы, а лишь организуют ссылки на соответствующие строки. Для идентификации нужной строки в таблице некластерный индекс организует специальные указатели, включающие в себя: информацию об идентификационном номере файла, в котором хранится строка; идентификационный номер страницы соответствующих данных; номер искомой строки на соответствующей странице; содержимое столбца.
- Кластерный индекс – Принципиальным отличием кластерного индекса от индексов других типов является то, что при его определении в таблице физическое расположение данных перестраивается в соответствии со структурой индекса. Логическая структура таблицы в этом случае представляет собой скорее словарь, чем индекс. Данные в словаре физически упорядочены, например по алфавиту. Кластерные индексы могут дать существенное увеличение производительности поиска данных даже по сравнению с обычными индексами. Увеличение производительности особенно заметно при работе с последовательными данными.
По структуре
По количественному составу
- Простой индекс (индекс с одним ключом) – строится по одному полю.
Составной (многоключевой, композитный) индекс – строится по нескольким полям. Важен порядок следования полей (например в MongoDB).
Индекс с включенными столбцами – Некластеризованный индекс, дополнительно содержащий кроме ключевых столбцов еще и неключевые. - Главный индекс (индекс по первичному ключу) – это тот индексный ключ, под управлением которого в данный момент находится таблица. Таблица не может быть отсортирована по нескольким индексным ключам одновременно. Хотя, если одна и та же таблица открыта одновременно в нескольких рабочих областях, то у каждой копии таблицы может быть назначен свой главный индекс.
По характеристике содержимого
- Уникальный индекс – состоит из множества уникальных значений поля.
Плотный индекс (NoSQL) – индекс, при котором, каждом документе в индексируемой коллекции соответствует запись в индексе, даже если в документе нет индексируемого поля. - Разреженный индекс (NoSQL) – тот, в котором представлены только те документы, для которых индексируемый ключ имеет какое-то определённое значение (существует).
- Пространственный индекс – оптимизирован для описания географического местоположения. Представляет из себя многоключевой индекс состоящий из широты и долготы.
- Составной пространственный индекс – индекс, включающий в себя кроме широты и долготы ещё какие-либо мета-данные (например теги). Но географические координаты должны стоять на первом месте.
- Полнотекстовый (инвертированный) индекс – словарь, в котором перечислены все слова и указано, в каких местах они встречаются. При наличии такого индекса достаточно осуществить поиск нужных слов в нём и тогда сразу же будет получен список документов, в которых они встречаются.
- Хэш-индексы – предполагают хранение не самих значений, а их хэшей, благодаря чему уменьшается размер(а, соответственно, и увеличивается скорость их обработки) индексов из больших полей. Таким образом, при запросах с использованием HASH-индексов, сравниваться будут не искомое со значения поля, а хэш от искомого значения с хэшами полей.
Из-за нелинейнойсти хэш-функций данный индекс нельзя сортировать по значению, что приводит к невозможности использования в сравнениях больше/меньше и «is null». Кроме того, так как хэши не уникальны, то для совпадающих хэшей применяются методы разрешения коллизий. - Битовый индекс (bitmap index) – метод битовых индексов заключается в создании отдельных битовых карт (последовательность 0 и 1) для каждого возможного значения столбца, где каждому биту соответствует строка с индексируемым значением, а его значение равное 1 означает, что запись, соответствующая позиции бита содержит индексируемое значение для данного столбца или свойства.
- Обратный индекс (reverse index) – это тоже B-tree индекс но с реверсированным ключом, используемый в основном для монотонно возрастающих значений(например, автоинкрементный идентификатор) в OLTP системах с целью снятия конкуренции за последний листовой блок индекса, т.к. благодаря переворачиванию значения две соседние записи индекса попадают в разные блоки индекса. Он не может использоваться для диапазонного поиска.
- Функциональный (function-based) индекс (индекс по вычисляемому полю) – индекс, ключи которого хранят результат пользовательских функций. Функциональные индексы часто строятся для полей, значения которых проходят предварительную обработку перед сравнением в команде SQL. Например, при сравнении строковых данных без учета регистра символов часто используется функция UPPER. Создание функционального индекса с функцией UPPER улучшает эффективность таких сравнений. Кроме того, функциональный индекс может помочь реализовать любой другой отсутствующий тип индексов данной СУБД(кроме, пожалуй, битового индекса, например, Hash для Oracle)
- Первичный индекс – уникальный индекс по полю первичного ключа.
- Вторичный индекс – индекс по другим полям (кроме поля первичного ключа).
- XML-индекс – вырезанное материализованное представление больших двоичных XML-объектов (BLOB) в столбце с типом данных xml.
По механизму обновления
- Полностью перестраиваемый – при добавлении элемента заново перестраивается весь индекс.
- Пополняемый (балансируемый) – при добавлении элементов индекс перестраивается частично (например одна из ветви) и периодически балансируется.
По покрытию индексируемого содержимого
- Полностью покрывающий (полный) индекс – покрывает всё содержимое индексируемого объекта.
- Частичный (partial) индекс – это индекс, построенный на части таблицы, удовлетворяющей определенному условию самого индекса. Данный индекс создан для уменьшения размера индекса.
- Инкрементный (Delta) индекс – индексируется малая часть данных(дельта), как правило, по истечении определённого времени. Используется при интенсивной записи. Например, полный индекс перестраивается раз в сутки, а дельта-индекс строится каждый час. По сути это частичный индекс по временной метке.
- Real-time индекс – особый вид delta индекса в Sphinx, характеризующийся высокой скоростью построения. Предназначен для часто-меняющихся данных.
Индексы в кластерных системах
- Глобальный индекс – индекс по всему содержимому всех shard’ов (секций).
- Сегментный индекс – глобальный индекс по полю-сегментируемому ключу (shard key). Используется для быстрого определения сегмента(shard’а), на котором хранятся данные в процессе маршрутизации запроса в кластере БД.
- Локальный индекс – индекс по содержимому только одного shard’а.
Если есть неточности, коррективы – пишите в комменты. Надеюсь кому-то будет полезным эта “шпаргалка”.