
СТАНДОТКЛОНА (функция СТАНДОТКЛОНА)
Excel для Microsoft 365 Excel для Microsoft 365 для Mac Excel для Интернета Excel 2021 Excel 2021 для Mac Excel 2019 Excel 2019 для Mac Excel 2016 Excel 2016 для Mac Excel 2013 Excel 2010 Excel 2007 Excel для Mac 2011 Excel Starter 2010 Еще. Меньше
В этой статье описаны синтаксис формулы и использование функции СТАНДОТКЛОНА в Microsoft Excel.
Описание
Оценивает стандартное отклонение по выборке. Стандартное отклонение — это мера того, насколько широко разбросаны точки данных относительно их среднего.
Синтаксис
Аргументы функции СТАНДОТКЛОНА описаны ниже.
- Значение1,значение2. Аргумент «значение1» является обязательным, последующие значения необязательные. От 1 до 255 значений, соответствующих выборке из генеральной совокупности. Вместо аргументов, разделяемых точкой с запятой, можно использовать массив или ссылку на массив.
Замечания
- Функция СТАНДОТКЛОНА предполагает, что аргументы являются только выборкой из генеральной совокупности. Если данные представляют всю генеральную совокупность, то стандартное отклонение следует вычислять с помощью функции СТАНДОТКЛОНПА.
- Стандартное отклонение вычисляется с использованием «n-1» метода.
- Допускаются следующие аргументы: числа; имена, массивы или ссылки, содержащие числа; текстовые представления чисел; логические значения, такие как ИСТИНА и ЛОЖЬ, в ссылке.
- Аргументы, содержащие значение ИСТИНА, интерпретируются как 1; аргументы, содержащие текст или значение ЛОЖЬ, интерпретируются как 0 (ноль).
- Если аргументом является массив или ссылка, учитываются только значения массива или ссылки. Пустые ячейки и текст в массиве или ссылке игнорируются.
- Аргументы, представляющие собой значения ошибок или текст, не преобразуемый в числа, вызывают ошибку.
- Чтобы не включать логические значения и текстовые представления чисел в ссылку как часть вычисления, используйте функцию СТАНДОТКЛОН.
- Функция СТАНДОТКЛОНА вычисляется по следующей формуле: где x — выборочное среднее СРЗНАЧ(значение1,значение2,…), а n — размер выборки.
Пример
Скопируйте образец данных из следующей таблицы и вставьте их в ячейку A1 нового листа Excel. Чтобы отобразить результаты формул, выделите их и нажмите клавишу F2, а затем — клавишу ВВОД. При необходимости измените ширину столбцов, чтобы видеть все данные.
Как рассчитать среднее и стандартное отклонение в Excel
Среднее значение представляет собой среднее значение в наборе данных. Это дает нам хорошее представление о том, где находится центр набора данных.
Стандартное отклонение показывает, насколько разбросаны значения в наборе данных. Это дает нам представление о том, насколько близко наблюдения сгруппированы вокруг среднего значения.
Используя только эти два значения, мы можем многое понять о распределении значений в наборе данных.
Чтобы вычислить среднее значение набора данных в Excel, мы можем использовать функцию = СРЗНАЧ (диапазон) , где диапазон — это диапазон значений.
Чтобы вычислить стандартное отклонение набора данных, мы можем использовать функцию =STDEV.S(Range) , где Range — это диапазон значений.
В этом руководстве объясняется, как использовать эти функции на практике.
Техническое примечание
Обе функции СТАНДОТКЛОН() и СТАНДОТКЛОН.С() вычисляют стандартное отклонение выборки .
Вы можете использовать функцию STDEV.P() для вычисления стандартного отклонения совокупности , если ваш набор данных представляет всю совокупность значений.
Однако в большинстве случаев мы работаем с выборочными данными, а не со всей совокупностью, поэтому мы используем функцию СТАНДОТКЛОН.С().
Пример 1: Среднее и стандартное отклонение одного набора данных
На следующем снимке экрана показано, как рассчитать среднее значение и стандартное отклонение одного набора данных в Excel:
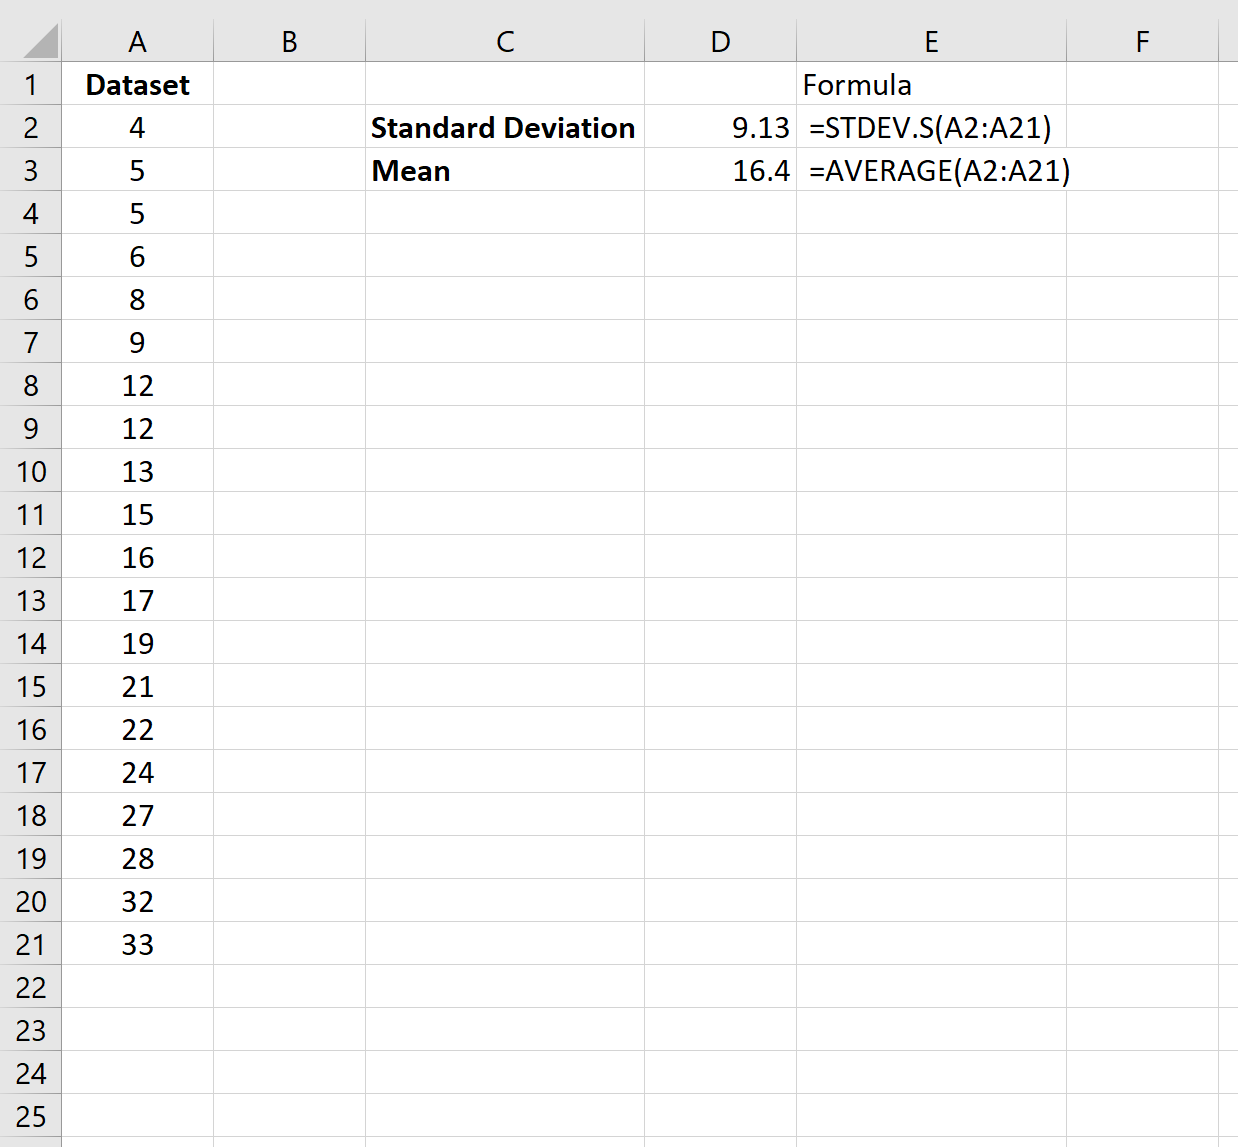
Среднее значение набора данных составляет 16,4 , а стандартное отклонение — 9,13 .
Пример 2: Среднее и стандартное отклонение нескольких наборов данных
Предположим, у нас есть несколько наборов данных в Excel:
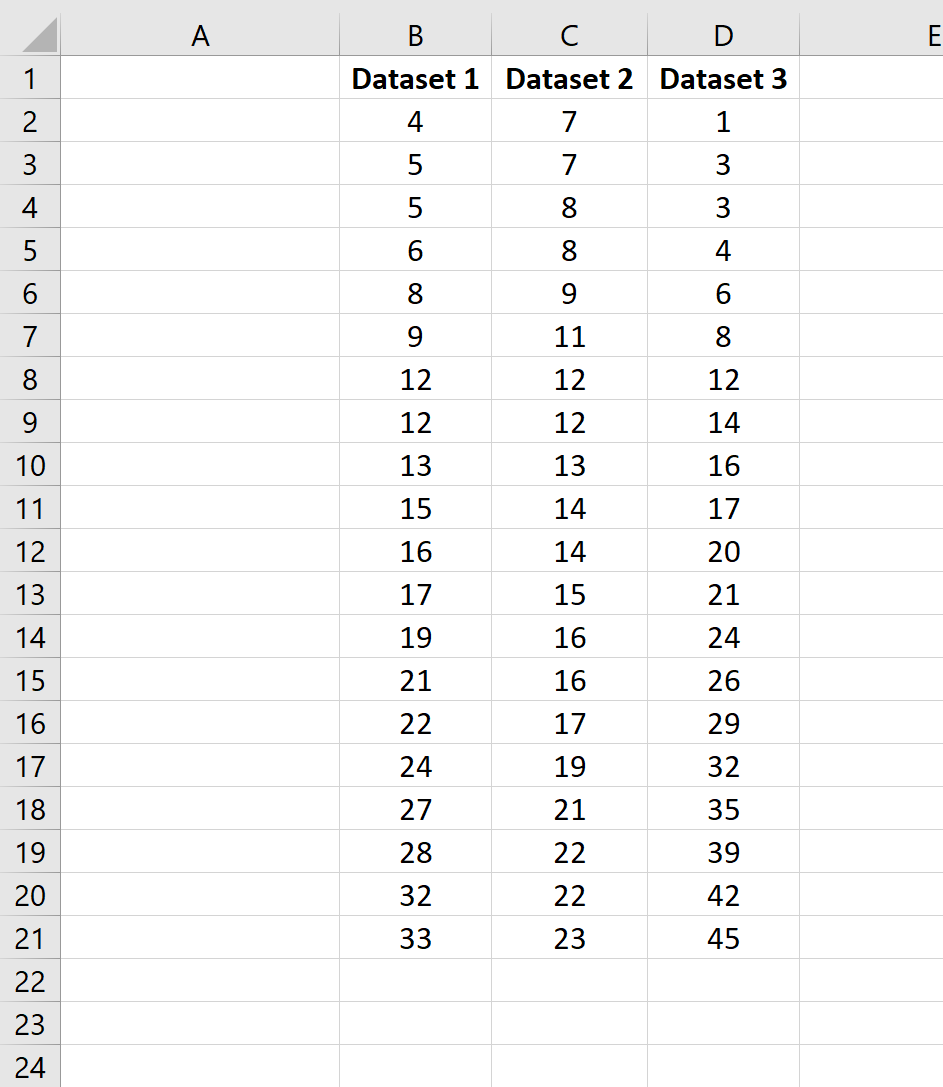
Чтобы вычислить среднее значение и стандартное отклонение первого набора данных, мы можем использовать следующие две формулы:
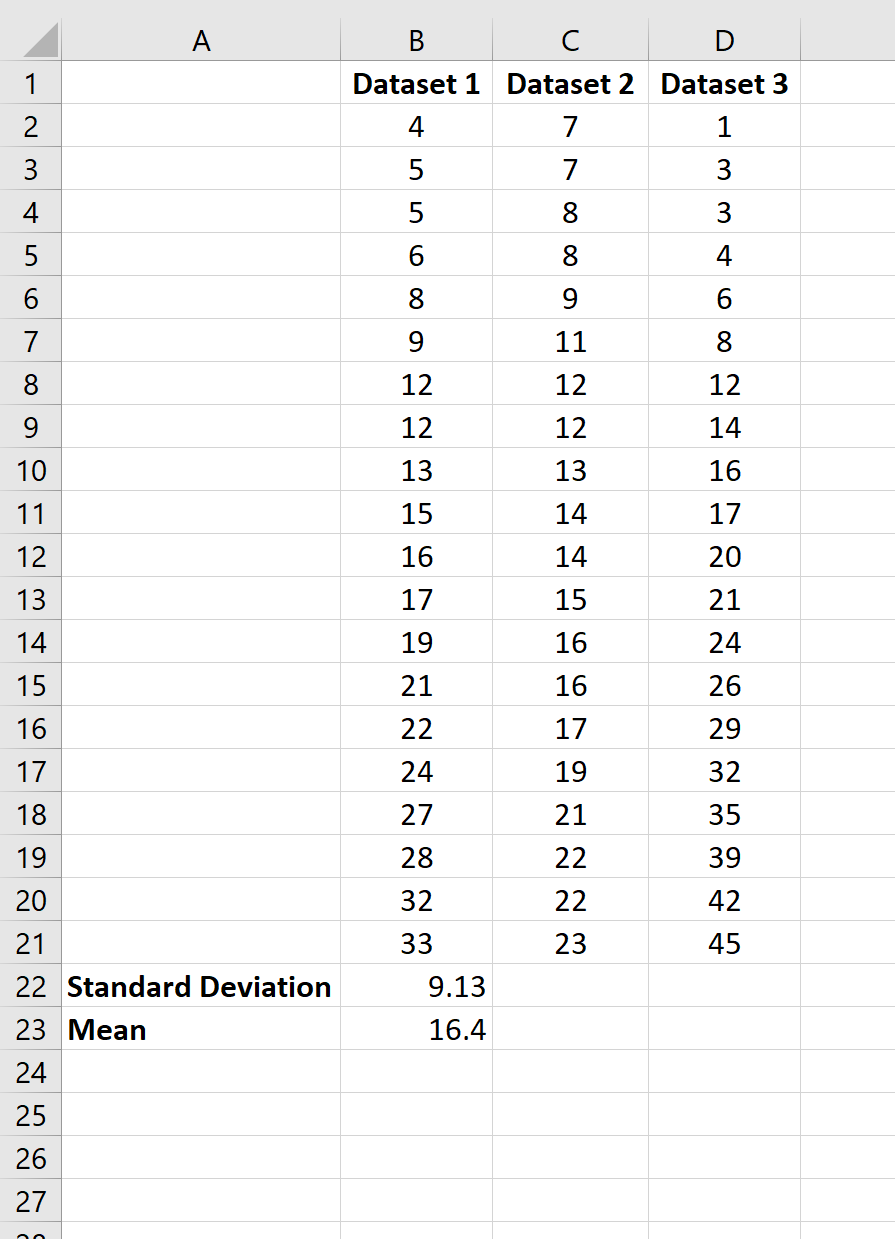
- Среднее значение: =СРЗНАЧ(B2:B21)
- Стандартное отклонение: =STDEV.S(B2:B21)
Затем мы можем выделить ячейки B22: B23 и навести указатель мыши на правый нижний угол ячейки B23, пока не появится крошечный +.Затем мы можем щелкнуть и перетащить формулы в следующие два столбца:
Как рассчитать относительное стандартное отклонение в Excel

Относительное стандартное отклонение — это мера стандартного отклонения выборки относительно среднего значения выборки для данного набора данных.
Он рассчитывается как:
Относительное стандартное отклонение = s / x * 100%
Эта метрика дает нам представление о том, насколько близко наблюдения сгруппированы вокруг среднего значения.
Например, предположим, что стандартное отклонение набора данных равно 4. Если среднее значение равно 400, то относительное стандартное отклонение равно 4/400 * 100% = 1%. Это означает, что наблюдения плотно сгруппированы вокруг среднего значения.
Однако набор данных со стандартным отклонением 40 и средним значением 400 будет иметь относительное стандартное отклонение 10%. Это означает, что наблюдения гораздо более разбросаны вокруг среднего значения по сравнению с предыдущим набором данных.
В этом руководстве приведен пример расчета относительного стандартного отклонения в Excel.
Пример: относительное стандартное отклонение в Excel
Предположим, у нас есть следующий набор данных в Excel:

Следующие формулы показывают, как рассчитать выборочное среднее, выборочное стандартное отклонение и относительное выборочное стандартное отклонение набора данных:
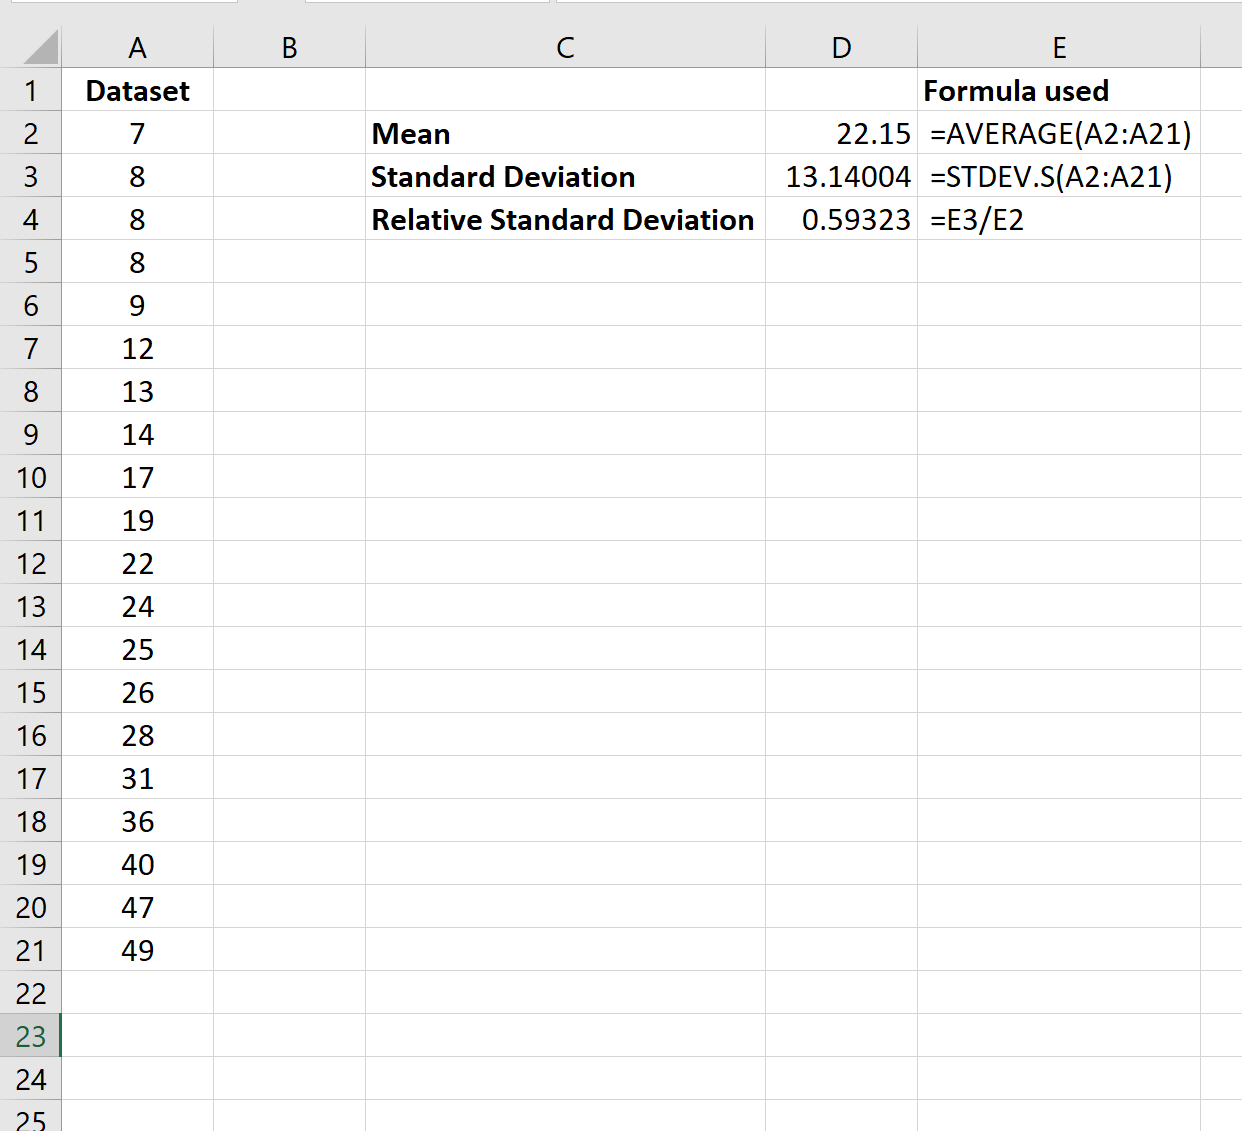
Относительное стандартное отклонение оказывается равным 0,59 .
Это говорит нам о том, что стандартное отклонение набора данных составляет 59% от размера среднего значения набора данных. Это число довольно велико, что указывает на то, что значения довольно сильно разбросаны вокруг среднего значения выборки.
Если у нас есть несколько наборов данных, мы можем использовать одну и ту же формулу для расчета относительного стандартного отклонения (RSD) для каждого набора данных и сравнения RSD по наборам данных:
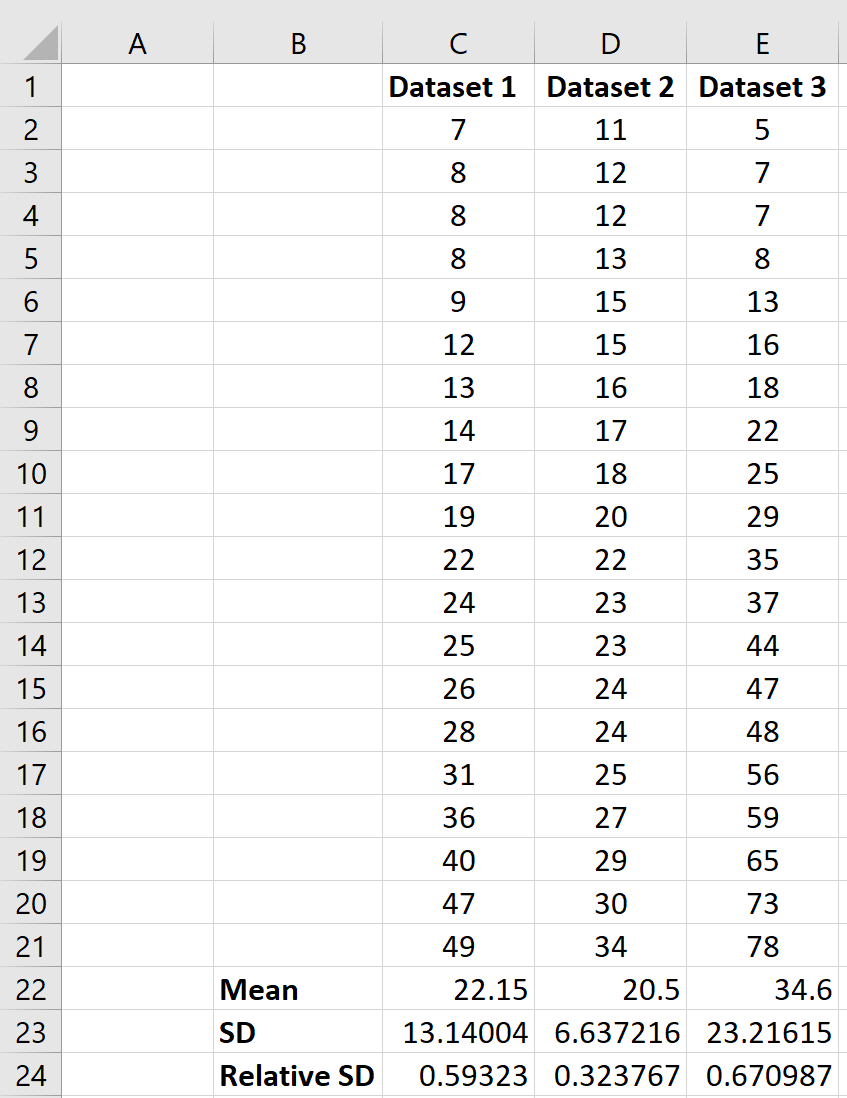
Мы видим, что набор данных 3 имеет наибольшее относительное стандартное отклонение, что указывает на то, что значения в этом наборе данных наиболее разбросаны по отношению к среднему значению набора данных.
И наоборот, мы видим, что набор данных 2 имеет наименьшее относительное стандартное отклонение, что указывает на то, что значения в этом наборе данных наименее разбросаны по отношению к среднему значению этого конкретного набора данных.
Вы можете найти больше руководств по Excel здесь .
Дисперсия и стандартное отклонение в EXCEL
Сначала рассмотрим дисперсию , затем стандартное отклонение .
Дисперсия выборки
Дисперсия выборки ( выборочная дисперсия, sample variance ) характеризует разброс значений в массиве относительно среднего .
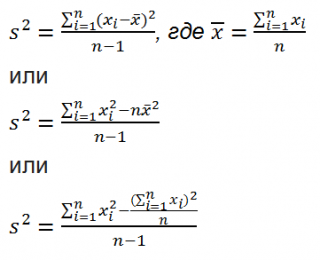
Все 3 формулы математически эквивалентны.
Из первой формулы видно, что дисперсия выборки это сумма квадратов отклонений каждого значения в массиве от среднего , деленная на размер выборки минус 1.
Для вычисления дисперсии выборки нужно:
- вычислить среднее значение выборки;
- вычислить «расстояния» от каждого значения до среднего (x i -x ср. );
- возвести «расстояния» в квадрат, чтобы отклонения в разные стороны от среднего не компенсировали друг друга;
- вычислить среднее значение квадратов «расстояний»)
Примечание : в знаменателе формулы стоит n-1, а не n т.к. дисперсия выборки — это оценка дисперсии случайной величины (вычитаем 1, чтобы оценка была несмещенной).
В MS EXCEL 2007 и более ранних версиях для вычисления дисперсии выборки используется функция ДИСП() , англ. название VAR, т.е. VARiance. С версии MS EXCEL 2010 рекомендуется использовать ее аналог ДИСП.В() , англ. название VARS, т.е. Sample VARiance. Кроме того, начиная с версии MS EXCEL 2010 присутствует функция ДИСП.Г(), англ. название VARP, т.е. Population VARiance, которая вычисляет дисперсию для генеральной совокупности . Все отличие сводится к знаменателю: вместо n-1 как у ДИСП.В() , у ДИСП.Г() в знаменателе просто n. До MS EXCEL 2010 для вычисления дисперсии генеральной совокупности использовалась функция ДИСПР() .
Дисперсию выборки можно также вычислить непосредственно по нижеуказанным формулам (см. файл примера ) =КВАДРОТКЛ(Выборка)/(СЧЁТ(Выборка)-1) =(СУММКВ(Выборка)-СЧЁТ(Выборка)*СРЗНАЧ(Выборка)^2)/ (СЧЁТ(Выборка)-1) – обычная формула =СУММ((Выборка -СРЗНАЧ(Выборка))^2)/ (СЧЁТ(Выборка)-1 ) – формула массива
Дисперсия выборки равна 0, только в том случае, если все значения равны между собой и, соответственно, равны среднему значению . Обычно, чем больше величина дисперсии , тем больше разброс значений в массиве.
Дисперсия выборки является точечной оценкой дисперсии распределения случайной величины, из которой была сделана выборка . О построении доверительных интервалов при оценке дисперсии можно прочитать в статье Доверительный интервал для оценки дисперсии в MS EXCEL .
Дисперсия случайной величины
Чтобы вычислить дисперсию случайной величины, необходимо знать ее функцию распределения .
Для дисперсии случайной величины Х часто используют обозначение Var(Х). Дисперсия равна математическому ожиданию квадрата отклонения от среднего E(X): Var(Х)=E[(X-E(X)) 2 ]
Если случайная величина имеет дискретное распределение , то дисперсия вычисляется по формуле:
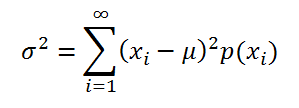
где x i – значение, которое может принимать случайная величина, а μ – среднее значение ( математическое ожидание случайной величины ), р(x) – вероятность, что случайная величина примет значение х.
Если случайная величина имеет непрерывное распределение , то дисперсия вычисляется по формуле:
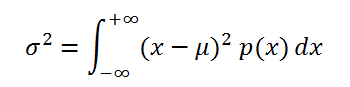
Для распределений, представленных в MS EXCEL , дисперсию можно вычислить аналитически, как функцию от параметров распределения. Например, для Биномиального распределения дисперсия равна произведению его параметров: n*p*q.
Примечание : Дисперсия, является вторым центральным моментом , обозначается D[X], VAR(х), V(x). Второй центральный момент — числовая характеристика распределения случайной величины, которая является мерой разброса случайной величины относительно математического ожидания .
Примечание : О распределениях в MS EXCEL можно прочитать в статье Распределения случайной величины в MS EXCEL .
Размерность дисперсии соответствует квадрату единицы измерения исходных значений. Например, если значения в выборке представляют собой измерения веса детали (в кг), то размерность дисперсии будет кг 2 . Это бывает сложно интерпретировать, поэтому для характеристики разброса значений чаще используют величину равную квадратному корню из дисперсии – стандартное отклонение .
Некоторые свойства дисперсии :
Var(Х+a)=Var(Х), где Х — случайная величина, а — константа.
Var(Х)=E[(X-E(X)) 2 ]=E[X 2 -2*X*E(X)+(E(X)) 2 ]=E(X 2 )-E(2*X*E(X))+(E(X)) 2 =E(X 2 )-2*E(X)*E(X)+(E(X)) 2 =E(X 2 )-(E(X)) 2
Это свойство дисперсии используется в статье про линейную регрессию .
Var(Х+Y)=Var(Х) + Var(Y) + 2*Cov(Х;Y), где Х и Y — случайные величины, Cov(Х;Y) — ковариация этих случайных величин.
Если случайные величины независимы (independent), то их ковариация равна 0, и, следовательно, Var(Х+Y)=Var(Х)+Var(Y). Это свойство дисперсии используется при выводе стандартной ошибки среднего .
Покажем, что для независимых величин Var(Х-Y)=Var(Х+Y). Действительно, Var(Х-Y)= Var(Х-Y)= Var(Х+(-Y))= Var(Х)+Var(-Y)= Var(Х)+Var(-Y)= Var(Х)+(-1) 2 Var(Y)= Var(Х)+Var(Y)= Var(Х+Y). Это свойство дисперсии используется для построения доверительного интервала для разницы 2х средних .
Примечание : квадратный корень из дисперсии случайной величины называется Среднеквадратическое отклонение (или другие названия — среднее квадратическое отклонение, среднеквадратичное отклонение, квадратичное отклонение, стандартное отклонение, стандартный разброс).
Стандартное отклонение выборки
Стандартное отклонение выборки — это мера того, насколько широко разбросаны значения в выборке относительно их среднего .
По определению, стандартное отклонение равно квадратному корню из дисперсии :
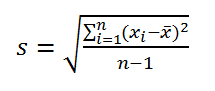
Стандартное отклонение не учитывает величину значений в выборке , а только степень рассеивания значений вокруг их среднего . Чтобы проиллюстрировать это приведем пример.
Вычислим стандартное отклонение для 2-х выборок: (1; 5; 9) и (1001; 1005; 1009). В обоих случаях, s=4. Очевидно, что отношение величины стандартного отклонения к значениям массива у выборок существенно отличается. Для таких случаев используется Коэффициент вариации (Coefficient of Variation, CV) — отношение Стандартного отклонения к среднему арифметическому , выраженного в процентах.
В MS EXCEL 2007 и более ранних версиях для вычисления Стандартного отклонения выборки используется функция =СТАНДОТКЛОН() , англ. название STDEV, т.е. STandard DEViation. С версии MS EXCEL 2010 рекомендуется использовать ее аналог =СТАНДОТКЛОН.В() , англ. название STDEV.S, т.е. Sample STandard DEViation.
Кроме того, начиная с версии MS EXCEL 2010 присутствует функция СТАНДОТКЛОН.Г() , англ. название STDEV.P, т.е. Population STandard DEViation, которая вычисляет стандартное отклонение для генеральной совокупности . Все отличие сводится к знаменателю: вместо n-1 как у СТАНДОТКЛОН.В() , у СТАНДОТКЛОН.Г() в знаменателе просто n.
Стандартное отклонение можно также вычислить непосредственно по нижеуказанным формулам (см. файл примера ) =КОРЕНЬ(КВАДРОТКЛ(Выборка)/(СЧЁТ(Выборка)-1)) =КОРЕНЬ((СУММКВ(Выборка)-СЧЁТ(Выборка)*СРЗНАЧ(Выборка)^2)/(СЧЁТ(Выборка)-1))
Другие меры разброса
Функция КВАДРОТКЛ() вычисляет с умму квадратов отклонений значений от их среднего . Эта функция вернет тот же результат, что и формула =ДИСП.Г( Выборка )*СЧЁТ( Выборка ) , где Выборка — ссылка на диапазон, содержащий массив значений выборки ( именованный диапазон ). Вычисления в функции КВАДРОТКЛ() производятся по формуле:
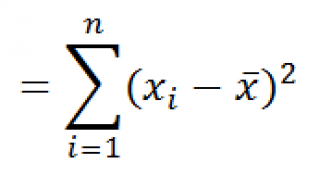
Функция СРОТКЛ() является также мерой разброса множества данных. Функция СРОТКЛ() вычисляет среднее абсолютных значений отклонений значений от среднего . Эта функция вернет тот же результат, что и формула =СУММПРОИЗВ(ABS(Выборка-СРЗНАЧ(Выборка)))/СЧЁТ(Выборка) , где Выборка — ссылка на диапазон, содержащий массив значений выборки.
Вычисления в функции СРОТКЛ () производятся по формуле: