
Как вывести файл PHP, чтобы «замутить» чужой код
От автора: мне всегда было интересно, как работают чужие сайты. Так и хочется подсмотреть код стороннего скрипта, чтоб и себе такой «замутить». Вот только PHP – это серверный язык, поэтому «списать» чужой код не удастся. Но все-таки, как вывести файл PHP?
О чем это я?
Согласен, заголовок статьи больше ориентирован на продвинутых юзеров. Если вы таким не являетесь (пока), я сейчас поясню, почему скрипт PHP просто так не получится «подсмотреть».
Этот программный язык является серверным. То есть, выполняется на стороне сервера (на хостинге), а не на стороне клиента (в пользовательском браузере). Чтобы все это продемонстрировать, я вставлю в HTML несколько строк кода PHP.
Как посмотреть чужой php код?
Benson1994, канай отсюда редиска! Маргалы выкалю, рога поотшибаю! Если бы это возможно было сделать, то можно легко было бы любой сайт нахрен скопировать.
# MARAZM (31.07.2016 / 19:34)
ДоХтор, пхп нет.ну а html легко) если я правильно понял
Ну в названии темы же про пхп написано:
Как посмотреть чужой php код?
Если конечно ТС пхп с хтмл’ем не перепутал )
Oewgo, скрытый мат запрещён наряду с открытым матом.
# ДоХтор (31.07.2016 / 19:45)
Oewgo, скрытый мат запрещён наряду с открытым матом.
ВАС ПОНЯЛ ДЯДЕНЬКА МИЛИЦИОНЕР, А ДА ДЯДЕНЬКА пАлицейский
(\/)____o_O____(\/)
на самом деле если поломать пых, и он начнет пхп текстом отдавать, то иногда исходники уплывают
intelligent
# Koenig (31.07.2016 / 22:39)
на самом деле если поломать пых, и он начнет пхп текстом отдавать, то иногда исходники уплывают
Как утащить простой сайт за 5 минут
Когда начинаешь практиковаться в вёрстке сайтов, может быть очень полезно разобраться, как устроены сайты у других ребят. Вот как это сделать.
�� Всё, что мы делаем в этой статье, мы делаем в учебных целях. Если вы просто скопируете себе чужой сайт и будете выдавать его за свой, это может плохо кончиться.
�� На самом деле всё сказанное в этой статье нужно для тех, кто боится отключения интернета и хочет сохранить у себя на компьютере самую важную информацию. Но эта мысль бредовая сразу на стольких уровнях, что мы стесняемся её произносить вслух. Разве что шёпотом.
В чём идея
Мы будем копировать чужой сайт, чтобы его можно было запустить на своём сервере или на домашнем компьютере. Задача — не просто открыть сайт в браузере и посмотреть его код, а забрать из него все важные файлы — и стили, и скрипты, и изображения. Чтобы было проще, мы будем практиковаться на одностраничном сайте, но всё то же самое будет работать и на многостраничном.
❌ Мы не сможем утащить чужие PHP-скрипты и страницы, связанные с данными пользователя (например, не сможем утащить из интернет-магазина рабочую версию корзины с покупками). Для этого нужен доступ к файлам сервера, а этого у нас нет.
Главный принцип этой работы: когда ваш браузер запрашивает страницу чужого сайта, веб-сервер отправляет ему эту страницу, в буквальном смысле. То же с картинками, стилями и скриптами: каждый раз, когда вы посещаете сайт, вы как будто делаете его копию у себя на компьютере. Браузер получает страницу от сервера и выводит её копию на экран, а в памяти держит исходный код. Разве что он не сохраняет эту страницу на диск, чтобы вы могли её редактировать.
Вот этот последний этап мы и исправим: теперь мы будем сохранять чужие сайты к себе на диск.
Весь процесс покажем на примере сайта ux-posters.ru – простом одностраничном сайте, где есть картинки, стили и скрипты. Автору этого текста пришлось помогать авторам этого сайта с похожей задачей, так что пример свеженький.
Быстрый путь: грабберы
Есть категория программ под названием «веб-грабберы», или «веб-рипперы». Они работают так:
- Ты говоришь программе, на какую страницу сайта зайти.
- Программа собирает все ссылки с этой страницы, переходит по этим ссылкам и строит себе виртуальную карту сайта — то есть пытается понять, сколько на этом сайте страниц и как они связаны.
- Потом граббер начинает ползать по этим страницам подряд, запрашивать их у сервера, получать ответы и сохранять ответы на вашем жёстком диске.
- В какой-то момент граббер останавливается, потому что он скачал все доступные ему страницы с этого сайта.
После работы граббер оставляет у вас на диске гору файлов, которые представляют собой статичный отпечаток чужого сайта. Эту гору можно загрузить на собственный сервер, и издалека это будет похоже на чужой сайт.
✅ Плюсы: граббер может быстро охватить много страниц и скачать из них огромное количество стилей, картинок и всего подряд. Работа очень быстрая и хорошо автоматизирована.
❌ Минусы: часто он качает всё без разбора, оставляя на диске много дублей. Также он бессилен с сайтами, в которых контент выводится динамически или имеет нестандартную систему адресации.
�� В целом грабберы можно использовать, чтобы скачивать сайты библиотек, архивов и других мест, где документов много и всё устроено логично. Например, с помощью граббера можно скачать какую-нибудь классическую книгу из онлайн-библиотеки.
Вот ссылки на грабберы для разных платформ:
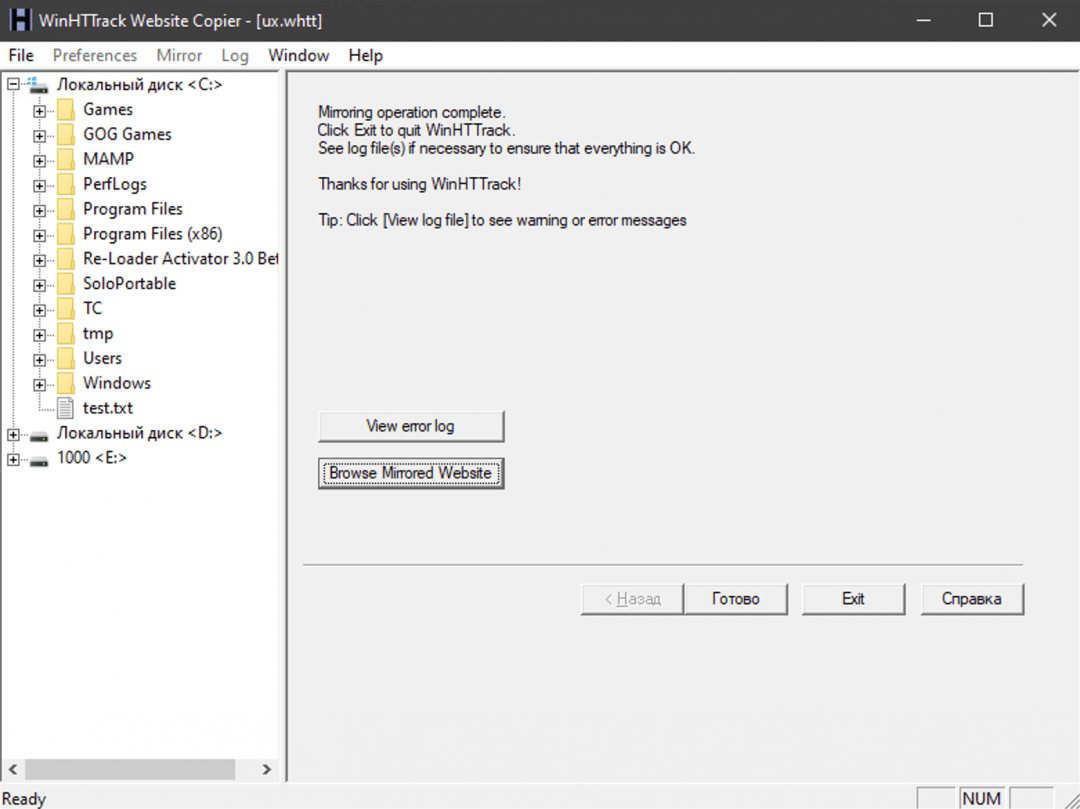
- HTTrack — старый интерфейс из нулевых, но свою задачу выполняет полностью. Бесплатный и надёжный, работает везде.
- Getleft — мультиплатформенный граббер, который пытается выкачивать всё, до чего дотянется, включая PHP-скрипты.
- Cyotek WebCopy — для тех, кто любит только Windows, тоже бесплатный.
Сложный путь: ручное сохранение
Допустим, мы хотим сохранить какую-то отдельную страницу сайта или конкретные её части (например, картинки). Но эти картинки как-то так хитро встроены, что вы не можете просто нажать «Сохранить картинку как. ». Тогда потребуется ручной метод.
Заходим на страницу и нажимаем в браузере Ctrl + I (в Виндоус) или ⌥ + ⌘ + I (если у вас мак). Появляется окно «Инспектора», где видна внутренняя структура страницы:
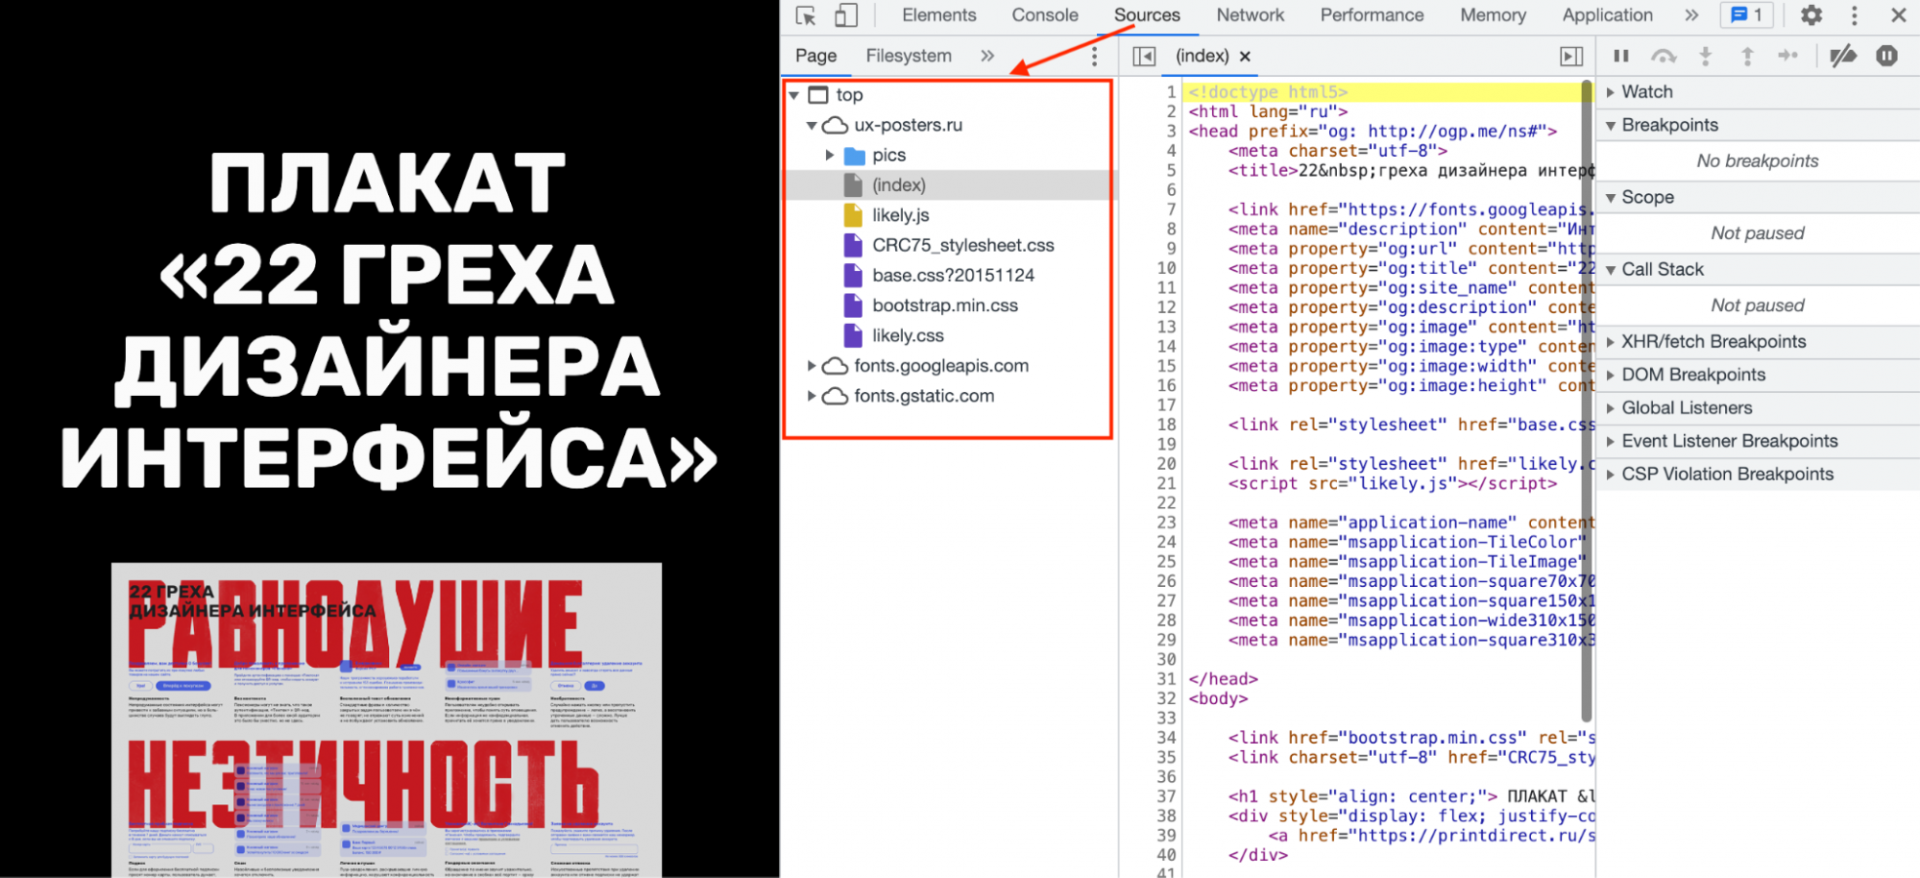
Мы видим, что текущий документ в браузере состоит:
- из страницы index.html;
- скрипта likely.js;
- четырёх таблиц стилей;
- шрифтов, подключённых через сервис Google;
- папки с картинками.
Шрифты нам скачивать необязательно — сайт и так их подключит с сервера гугла, а всё остальное скачать нужно. Чтобы не создавать хаос на компьютере, создадим сначала папку ux-posters — в ней будет храниться наш сайт. Потом в эту папку сохраняем все файлы таким способом:
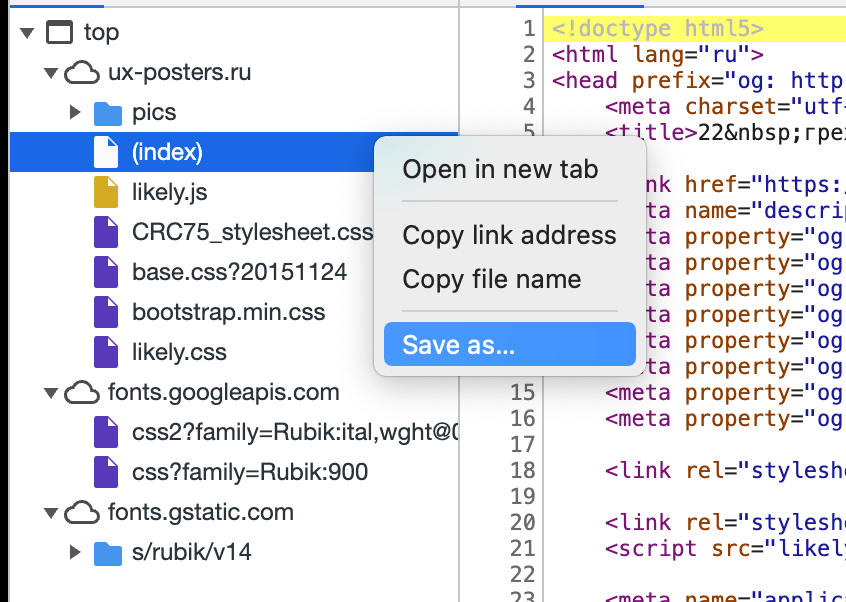
- Нажимаем правой кнопкой мыши на очередной файл.
- Выбираем пункт Save as, или «Сохранить как».
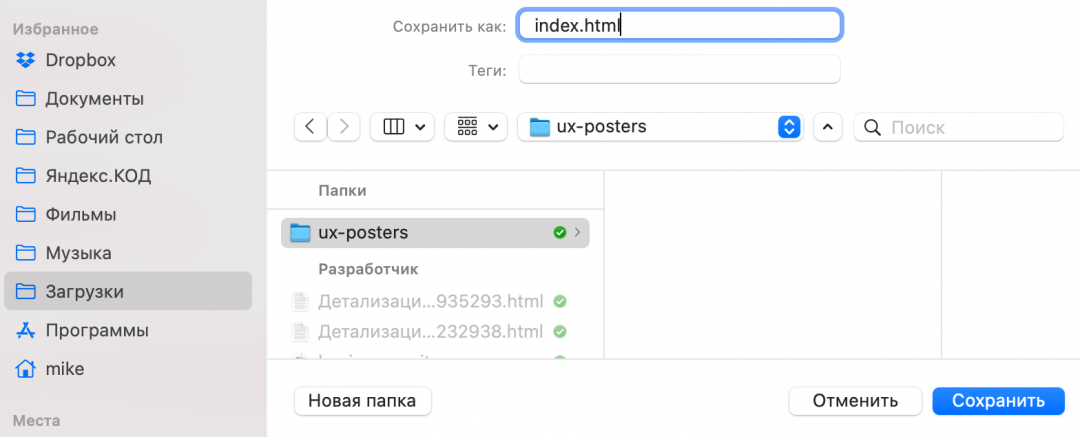
- Пишем имя и расширение файла — точно так, как указано в списке.
- Если лень писать самому — скопируйте перед этим название файла, нажав правую кнопку мыши и выбрав Copy file name, или «Скопировать имя файла».
- Чаще всего название файла подставится само, но если нет — смотрите пункт 4.
Исключения в названии файлов два:
- (index) — это index.html.
- В любом файле знак вопроса и всё, что после него, писать не нужно.
Скачать можно всё, а можно только то, что вам нужно для работы и экспериментов. Например, если вам нужны только стили и код страницы, сохраняйте файлы .css и (index). Если нужны картинки, заходите в папку pics и сохраняйте всё оттуда.
Что в итоге
Если мы пройдёмся по всем папкам и сохраним в них всё нужное нам, у нас получится локальный слепок сайта. Теперь можно:
- Изучить, как он устроен, что-то отредактировать и увидеть результат у себя на компьютере.
- Открыть файл index.html в браузере, и будет ощущение, что вы зашли на сайт, но с локального компьютера. Сайт откроется по протоколу file:// — это так браузер говорит нам, что файл взялся с нашего компьютера, а не из интернета.
- Запустить MAMP и завести на нём локальную копию сайта для экспериментов. Тогда браузер будет думать, что ходит за этим сайтом в интернет. Можно написать какие-нибудь php-скрипты и оживить сайт.
�� Важно понимать, что перед нами именно «слепок» — то, что мы бы увидели, если бы сервер сегодня ответил на наш запрос. Если завтра сервер будет отвечать по-другому, мы этого в своей локальной копии не увидим.
Когда ещё это пригодится
Защитить сайт перед наплывом пользователей. С помощью грабберов можно быстро создать неубиваемую статическую копию сайта и временно подменить ей динамическую версию сайта. Это полумера, но может сработать. А вообще вместо этого есть специальные надстройки, которые делают почти то же самое, но более умно, — поищите слово «кеширование».
Сделать копию своего блога, личного сайта или ещё чего-то важного вам, если вы потеряли к нему доступ, но сайт всё ещё на ходу.
Если вы едете туда, где не будет интернета, а вам нужна информация с сайта (например, путеводитель по чужой стране). Помните, что динамические карты и видеоролики так не сохранятся.
Сделать собственный «веб-архив» — это сервис, который ползает по сайтам и делает их «слепки» для истории. Благодаря этому сервису можно посмотреть, как выглядели ваши любимые сайты много лет назад — например, Яндекс.
Как научиться читать код сайта и зачем это нужно, если вы не программист
Кажется, что программирование — это сложно, особенно если никогда не приходилось с ним сталкиваться. На самом деле всё зависит от задачи. Чтобы вносить небольшие изменения на сайт, хватит и азов, а их может освоить даже человек без технического образования. Об этих азах и пойдет речь в статье. Расскажем об устройстве исходного кода, о том, как начать в нём немного разбираться, и ответим на вопрос, зачем всё это вам нужно. Примечание: мы не будем лезть в дебри и подробно описывать процесс программирования. Расскажем о том минимуме, что пригодится в работе над вашим сайтом.
Зачем понимать исходный код
- Больше понимать в SEO-продвижении.
Если просто смотреть на страницу сайта, вы не сможете проанализировать, правильно ли настроено SEO-продвижение, а инструменты для анализа не всегда могут быть под рукой. Только в коде проверяют, на месте ли метаданные и обязательные элементы — основная информация для успешного SEO. Поэтому заглядывать в исходный код становится обычной практикой маркетологов или владельцев бизнеса, которые сами занимаются продвижением.
Плюс вам больше не будет казаться магией работа SEO-специалиста. Вы будете говорить на одном языке и понимать, как поисковики видят ваш сайт и что можно улучшить.
- Анализировать сайты конкурентов на более глубоком уровне.
Если вы решите проанализировать сайты конкурентов, немного разбираясь в коде, вы сможете оценить не только визуальную и контентную стороны страниц. У вас получится определить, с помощью каких ключевых слов продвигается сайт, на какой CMS работает и немного больше понять стратегию продвижения конкурентов.
- Составлять грамотные ТЗ для разработчика самостоятельно.
Вам будет легче представить и объяснить разработчику, как вы видите свою задумку. А значит, на финальной стадии работ не окажется, что всё сделано не так, а деньги и время уже потрачены.
Когда программист будет объяснять вам, в каких правках нуждается сайт компании, вы всё поймёте и сможете на равных обсудить это с сотрудником. Вам будет проще нанимать человека на IT-должность и разбираться в сметах на обслуживание сайта.
- Экономить, самостоятельно внося изменения в сайт.
Экономнее изучить азы программирования и быстро устранять проблемы самостоятельно вместо того, чтобы нанимать программиста для выполнения небольших, но частых задач. Например, менять размеры баннеров или цвет текста на странице.
Что такое исходный код сайта
Национальная библиотека им. Н. Э. Баумана говорит, что исходный код — это текст компьютерной программы, который может прочитать человек, на языке программирования или языке разметки.
Именно код скрывается за внешней стороной любой интернет-страницы. Он выглядит как список пронумерованных строк с информацией о том или ином элементе страницы.
Как посмотреть код любого сайта
Расскажем, как посмотреть исходный код страницы в браузере Google Chrome*. В остальных браузерах этот процесс примерно такой же.
Код вызывается одной из комбинаций:
- комбинация клавиш Ctrl + U или правая кнопка мыши → «Просмотр кода страницы» — вызывает «полотно» кода в отдельном окне браузера. Вы сможете увидеть структуру всей страницы. Вот как это выглядит:
- комбинация клавиш Ctrl + Shift + I или правая кнопка мыши → «Просмотреть код» — удобная команда, чтобы посмотреть не весь исходный код страницы сразу, а код отдельных элементов на странице.
Панель с кодом откроется на этой же странице, а не в другом окне. При наведении мышки на код будет подсвечиваться соответствующая ему область на текущей странице.
Дальше в статье мы будем пользоваться именно этим инструментом — он нагляднее.
Чтобы не утонуть в огромном количестве новых символов, нужно разобраться, что такое HTML, CSS и JavaScript.
Что такое HTML
HTML — язык гипертекстовой разметки. На нём написано большинство сайтов в интернете.
Что можно узнать о сайте из исходного кода
Код сайта предназначен в первую очередь для браузера и поисковых систем. Браузеру он говорит, что и в каком порядке выводить на странице. Поисковые системы берут из исходного кода всю информацию о странице: заголовок, описание, метаданные — всё то, что потребуется, чтобы показать страницу в выдаче поисковика. Обычный пользователь тоже может прочитать этот специальный текст — достаточно знать, как он устроен.
Все элементы кода нужны для правильного расположения разделов и деталей страницы. Всё это вы сможете найти и проанализировать, внимательно изучив исходный код сайта:
- текст, который есть на странице;
- цвета, шрифты и размеры элементов страницы;
- иллюстрации, фотографии и другие детали;
- ссылки;
- важные теги, метатеги и атрибуты кода;
- скрипты, счётчики, генераторы заявок, коды идентификации в системах и пр.;
- данные JavaScript;
- ошибки и поломки в коде и прочее.
Чтобы лучше понять теорию, разберёмся в коде страниц блога RU-CENTER: найдём теги, картинки и другую информацию.
Для начала открываем страницу и вызываем интерактивный код (Ctrl + Shift + I). Откроется интерактивная панель с кодом, поделённая на две области. Слева — HTML-код (вкладка Elements), справа — CSS (вкладка Styles). Нам пока нужна левая часть с HTML.
Основные теги
HTML-страница состоит из набора тегов, которые вместе с содержимым называются элементами — это строительный материал веб-страницы. Другими словами, теги — команды для браузера, чтобы он понял, как нужно показывать сайт пользователю. Указывая в коде определенные теги, вы говорите браузеру: «Это текст, а это картинка, это ссылка, а это кнопка или форма». И браузер показывает все элементы интерфейса так, как вы их разместили.
Теги обычно открываются и закрываются так:
Теги делятся на два вида: блочные и строчные.
- Блочные теги всегда занимают отдельную строку в коде и обозначают целый элемент страницы сайта. Пример: заголовки или параграфы.