
Какой язык программирования выбрать для работы с данными?
У начинающего специалиста по данным (data scientist) есть возможность выбрать один из множества языков программирования, который поможет ему быстрее освоить данную науку.
Тем не менее, никто точно не скажет вам, какой язык программирования лучше всего подходит для этой цели. Ваш успех как специалиста в данной области будет зависить от множества факторов и сегодня мы постараемся их рассмотреть, а в конце статьи вы сможете проголосовать за тот язык программирования, который вы считаете наиболее подходящим для работы с данными.
Специфичность
Будьте готовы к тому, что по мере углубления в область науки о данных, вам раз за разом прийдется заново «изобретать велосипед». Кроме того, вам необходимо будет в совершенстве овладеть различными пакетами программ и модулями для выбранного вами языка программирования. Насколько хорошо вы сможете все это усвоить, зависит, в первую очередь, от наличия предметно-ориентированных пакетов программ для выбранного ЯП.
Универсальность
Ведущий специалист по данным обладает хорошими всесторонними навыками программирования, а также умением проводить расчеты и анализировать. Большая часть повседневной работы в области науки о данных направлена на поиск и обработку исходных данных или корректировку данных. К сожалению, никакие новороченные пакеты для машинного обучения вам не помогут для данных целей.
Эффективность
В быстро развивающемся мире коммерческой науки о данных есть множество возможностей быстро получить желаемую работу. Тем не менее, именно благодаря быстрому развитию области науки о данных ее постоянно сопровождают технические недароботки, и только упорная практика сможет свести к минимуму такие недочеты.
Производительность
В некоторых случаях очень важно оптимизировать производительность вашего кода, тем более при работе с большими объемами особо важных данных. Однако скомпилированные языки обычно намного быстрее, чем интерпретируемые. Аналогично, статически типизированные языки значительно более отказоустойчивы, чем динамически типизированные. Таким образом, единственным компромиссом является снижение производительности.
В некоторой степени, каждый из представленных ниже языков программирования обладает одним параметром в каждой из двух групп: универсальность — специфичность; производительность — удобство.
Учитывая эти основные принципы, давайте рассмотрим некоторые из наиболее популярных языков программирования, которые используются в науке о данных. Вся информация, о приведенных ниже языках программирования, основывается на моих собственных наблюдениях и опыте, а также опыте моих друзей и коллег.

R, который является прямым потомком старшего языка программирования S, был выпущен в далеком 1995 году и с тех пор становится все совершеннее. Написанный на таких языках как C и Fortran данный проект сегодня поддерживается Фондом языка R для статистических вычислений (R Foundation for Statistical Computing).
Преимущества:
- Отличный набор высококачественных предметно-ориентированных пакетов с открытым исходным кодом. R имеет в своем распоряжении пакеты практически для любого количественного и статистического применения, которое можно только себе представить. Сюда входят нейронные сети, нелинейная регрессия, филогенетика, построение сложных диаграмм, графиков и многое-многое другое.
- Вместе с базовой установкой в довесок нам предоставляется возможность установки обширных встроенных функций и методов. Кроме того, R прекрасно обрабатывает данные матричной алгебры.
- Возможность визуализации данных является немаловажным преимуществом наряду с возможностью использования различных библиотек, например ggplot2.
- Низкая производительность. Здесь нечего сказать: R не является быстрым ЯП.
- Специфичность. R прекрасно подходит для статистических исследований и науки о данных, но он не так хорош, когда дело доходит до программирования для общих целей.
- Другие особенности. R имеет несколько необычных особенностей, которые могут сбить с толку программистов, привыкших работать с другими ЯП: индексирование начинается с 1, использование нескольких операторов присваивания, нетрадиционные структуры данных.
R – мощный язык, который отличается наличием огромного выбора приложений для сбора статистических данных и визуализации данных, а тот факт, что он является ЯП с открытым исходным кодом, позволяет ему собрать большое количество поклонников среди разработчиков. Именно благодаря своей эффективности для первоначальных целей этому языку программирования удалось достичь широкой популярности.
Python

В 1991 году Гвидо ван Россум представил язык программирования Python. С тех пор этот язык стал чрезвычайно популярным ЯП общего назначения и широко используется в сообществе специалистов по данным. В настоящее время основными версиями являются Python 3,6 и Python 2,7.
Преимущества:
- Python – это очень популярный, широко используемый язык программирования общего назначения. Он имеет обширный набор специально разработанных модулей и широко используется разработчиками. Многие онлайн-сервисы предоставляют API для Python.
- Python очень прост в изучении. Низкий порог вхождения делает его идеальным первым языком для тех, кто занимается программированием.
- Такие программные пакеты как pandas, scikit-learn и Tensorflow, делают Python надежным вариантом для современных приложений в области машинного обучения.
- Типобезопасность. Python – это динамически типизированный язык, а это значит, что вы должны быть осторожными при работе с ним. Ошибки несоответствия типов (например, передача строки (string) в качестве аргумента методу, который ожидает целое число (integer)) могут время от времени случаться.
- Например, в случае если имеются конкретные цели статистического анализа и анализа данных, то обширный набор пакетов языка R дает ему преимущество перед Python. Кроме того, существуют более быстрые и безопасные альтернативы Python среди языков программирования.
Python является хорошим вариантом для целей науки о данных (data science), и это утверждение справедливо как для начального, так и для продвинутого уровней работы в данной области. Большая часть науки о данных сосредоточена вокруг процесса ETL (извлечение-преобразование-загрузка). Эта особенность делает Python идеально подходящим для таких целей языком программирования. Библиотеки, такие как Tensorflow от Google, делают Python очень интересным языком для работы в области машинного обучения.
SQL

SQL («язык структурированных запросов») определяет, управляет и запрашивает реляционные базы данных. Язык появился в 1974 году и с тех пор претерпел множество видоизменений, но основные его принципы остаются неизменными.
Есть бесплатные и платные варианты.
Преимущества
- Очень эффективен при работе с запросами, обновлениями, а также при обработке реляционных баз данных.
- Декларативный синтаксис делает SQL очень читаемым языком. Нет никакой неопределенности в том, что SELECT name FROM users WHERE age > 18 должен делать!
- SQL очень часто используется в различных приложениях, так что знакомство с ним может очень пригодиться. Модули, такие как SQLAlchemy, упрощают интеграцию SQL с другими языками.
- Синтаксис SQL может показаться достаточно сложной задачей для тех, кто привык к императивному программированию.
- Существует множество различных вариаций SQL, таких как PostgreSQL, SQLite, MariaDB. Все они достаточно разные, поэтому ни о какой совместимости не может быть и речи.
SQL более полезен в качестве языка для обработки данных, чем в качестве передового аналитического инструмента. Тем не менее, так много процессов в области науки о данных зависит от ETL, а долговечность и эффективность SQL лишний раз свидетельствуют о том, что такой ЯП должен знать каждый специалист по данным (data scientist).
Java

Java – это чрезвычайно популярный язык общего назначения, который работает на виртуальной машине Java Virtual Machine (JVM). Это абстрактная вычислительная система, которая обеспечивает плавную переносимость между платформами. В настоящее время поддерживается корпорацией Oracle.
8-я версия – бесплатная
Преимущества:
- Универсальность. Многие современные системы и приложения разработаны с помощью языка Java. Огромным преимуществом такого ЯП является способность интегрировать методы науки о данных непосредственно в существующую кодовую базу.
- Строгая типизация. Обеспечение типобезопасности не пустой звук для Java, и в случае разработки критически важных приложений для работы с большими данными эта особенность как никогда важна.
- Java – это высокопроизводительный, скомпилированный язык общего назначения. Это делает его пригодным для написания эффективного производственного кода ETL, а также алгоритмов машинного обучения с использованием вычислительных средств.
- «Многословность» языка Java делает его не лучшим вариантом для проведения специальных анализов и разработки более специализированных статистических приложений.
- Java не имеет большого количества библиотек для передовых статистических методов по сравнению с некоторыми предметно-ориентированными языками, например R.
Много чего можно сказать в пользу изучения Java как языка для работы в области науки о данных. Многие компании оценят возможность беспрепятственной интеграции готового кода программного продукта в собственную кодовую базу, а производительность и типобезопасность Java являются его неоспоримыми преимуществами. Тем не менее, к недостаткам такого языка можно отнести тот факт, что у него отсутствуют наборы специфических пакетов, которые доступны для других языков. Несмотря на такой недостаток, Java является языком программирования, которому обязательно стоит уделить внимание, особенно если вы уже знаете R или Python.
Scala
Функционирующий на JVM язык программирования Scala был разработан Мартином Одерски в 2004 году. Это язык с несколькими парадигмами, позволяющий использовать как объектно-ориентированные, так и функциональные подходы. Кроме того, структура кластерных вычислений Apache Spark написана на Scala.
Преимущества:
- Используя Scala и Spark, у вас появляется возможность работать с высокопроизводительными кластерными вычислениями. Scala – это идеальный выбор для тех, кто работает с большими объемами данных.
- Мультипарадигматический. Для программистов, работающих со Scala, доступны как объектно-ориентированные, так и функциональные парадигмы программирования.
- Scala компилируется в байт-код Java и работает на JVM. Это позволяет ему взаимодействовать с языком Java, делая Scala очень мощным языком общего назначения. Кроме того, он также хорошо подходит для работы в области науки о данных.
- Если вы только-только собрались работать со Scala, то будьте готовы изрядно «поломать» голову. Лучше всего загрузить sbt и настроить IDE, например Eclipse или IntelliJ, с помощью специального плагина Scala.
- Есть мнение, что синтаксис и система типов Scala являются достаточно сложными. Таким образом, программистам, привыкшим работать с динамическими языками, например Python, придется несладко.
Julia

Выпущенный чуть более 5 лет назад, Julia произвела впечатление на мир вычислительных методов. Язык добился такой популярности благодаря тому, что несколько крупных организаций, включая некоторые в финансовой отрасли, почти сразу начали использовать его для своих целей.
Преимущества:
- Julia – это скомпилированный язык JIT («точно в срок»), благодаря которому удается достичь хорошей производительности. Этот язык является достаточно простым, он предусматривает возможности динамической типизации и сценариев интерпретируемого языка, такого как Python.
- Julia был предназначен для проведения численного анализа, он также может рассматриваться в качестве языка программирования общего назначения.
- Читаемость. Многие программисты, работающие с данным языком, считают, что такая особенность является его наибольшим преимуществом.
- Незрелость. Поскольку Julia является достаточно новым языком, некоторые разработчики сталкиваются с нестабильностью во время работы с его пакетами. Тем не менее, базовые средства языка считаются стабильными.
- Еще одним признаком незрелости языка является ограниченное количество пакетов программ, а также небольшое число поклонников среди разработчиков. В отличие от устоявшихся R и Python язык программирования Julia не располагает большим количеством пакетов программ (пока что).
Да, главная проблема языка Julia – это его молодость, однако его нельзя за это винить. Поскольку Julia был создан лишь недавно, он пока что не может конкурировать со своими основными конкурентами, Python и R. Будьте терпеливыми и вы поймете, что существует множество причин обратить пристальное внимание на этот язык, который, непременно, сделает выдающиеся шаги в ближайшем будущем.
MATLAB

MATLAB – это признанный язык для численных расчетов, используемый как в научных целях, так и в индустрии. Он был разработан и лицензирован MathWorks, компанией, созданной в 1984 году, основной целью которой являлось коммерциализация программного обеспечения.
Цены варьируются в зависимости от выбранного вами варианта языка
Преимущества:
- MATLAB, предназначенный для численных вычислений, хорошо подходит для использования количественного анализа со сложными математическими требованиями, такими как обработка сигналов, преобразования Фурье, матричная алгебра и обработка изображений.
- Визуализация данных. MATLAB имеет ряд встроенных возможностей построения графиков и диаграмм.
- MATLAB часто можно встретить во многих курсах бакалавриата по точным наукам, таким как физика, инженерия и прикладная математика. Таким образом, он широко используется в этих областях.
- Платная лицензия. Вне зависимости от выбранного вами варианта (для научных, личных целей или целей компании) вам придется раскошелиться на дорогостоящую лицензию. Наш совет: обратите внимание на бесплатную альтернативу – Octave.
- MATLAB – это не лучший язык программирования для общего назначения.
Благодаря своему широкому использованию в различных количественных вычислениях как для научных целей, так и для целей индустрии, MATLAB стал достойным вариантом для применения в области науки о данных. Он прийдется вам как нельзя кстати, если для ваших ежедневных целей необходима интенсивная, продвинутая математическая функциональность, собственно, для чего MATLAB и был разработан.
Другие языки
Существуют и другие популярные ЯП, которые могут представлять интерес для специалистов по данным. В этом разделе представлен их краткий обзор.
C++
Зачастую, C++ не используется в области науки о данных. Тем не менее, он имеет молниеносную производительность и широкую популярность. Главной причиной, по которой C++ не обрел популярности в области науки о данных, является его неэффективность для такой цели.
Как написал один из участников форума:
«Предположим, что вы пишете код для проведения какого-либо специального анализа, который, вероятно, будет запускаться только один раз. Так вот, вы предпочли бы потратить 30 минут на создание программы, которая будет работать в течение 10 секунд или потратить 10 минут на программу, которая будет работать в течение 1 минуты?»
И этот парень прав! Тем не менее, C++ станет отличным выбором для реализации алгоритмов машинного обучения, оптимизированных на низком уровне.
Наш вердикт – не лучший выбор для повседневной работы, но если дело касается производительности.
JavaScript
Ввиду того, что за последние несколько лет платформа Node.js активно развивалась, язык программирования JavaScript все больше и больше обретал черты серверного языка. Однако его возможности в области науки о данных и машинного обучения на сегодняшний день достаточно скромны (тем не менее, не стоит забывать про brain.js и synaptic.js!). К недостаткам JavaScript можно отнести:
- Слишком рано для него, чтобы вступить в игру (Node.js всего 8 лет!).
- Платформа Node.js и вправду быстрая, но всегда найдутся те, кто будет активно критиковать JavaScript.
Наш вердикт – предстоит еще много чего сделать, для того чтобы JavaScript считался достойным языком для работы в области науки о данных
Perl
Perl известен как «швейцарский армейский нож языков программирования» из-за его универсальности как языка сценариев общего назначения. Он имеет много общего с Python, являясь динамически типизированным языком сценариев. Но ему еще очень далеко до той популярности, которую имеет Python в области науки о данных.
Это немного удивительно, учитывая его применение в областях, в которых используются методы количественного анализа, например в биоинформатике. Что касается науки о данных, то у Perl есть несколько недостатков: у него не получится быстро стать популярным в данной области, а его синтаксис считается недружелюбным. Кроме того, со стороны его разработчиков не наблюдается никаких попыток создания библиотек, которые могли бы быть использованы в области науки о данных. А как мы с вами знаем: зачастую все решают правильные действия в подходящий момент.
Наш вердикт – полезный язык сценариев общего назначения, но с его помощью вам уж точно не устроится на работу специалиста по данным.
Ruby
Ruby – это еще один динамически типизированный интерпретируемый язык общего назначения. Тем не менее, похоже, что у его создателей нет никакого желания сделать его пригодным для работы в области науки о данных, как в случае с Python.
Это может показаться странным, но все вышеуказанное так или иначе связано с доминирующим положением Python в области научных исследований, а также с положительными отзывами людей, пишущих на этом языке. Чем больше людей выбирают Python, тем больше разрабатывается для него модулей и фреймворков, и тем больше программистов отдают свое предпочтение Python. Проект SciRuby был создан для того, чтобы внедрить в Ruby функциональность научных вычислений, например, матричной алгебры. Но, несмотря на все эти потуги, Python на данный момент по-прежнему лидирует.
Наш вердикт – не совсем правильный выбор для науки о данных, но в вашем резюме знание Ruby не помешает
Заключение
Ну вот мы с вами и рассмотрели короткое руководство по языкам программирования, которые ближе всего подступили к области науки о данных. Важным моментом здесь является понимание того, что вам больше нужно: специфичность или универсальность языка, его удобство или эффективность.
Я регулярно использую R, Python и SQL, так как моя текущая работа в основном сосредоточена на разработке существующих конвейеров данных и ETL-процессов. Эти языки совмещают правильный баланс общности и эффективности для выполнения этой работы с возможностью использования более совершенных статистических пакетов R, когда это необходимо.
Однако, возможно, вы уже неплохо набили руку в Java, или вам не терпится испробовать в действии Scala для работы с большими данными, или, может быть, вы без ума от проекта Julia.
А может вы зубрили MATLAB на парах в институте или не прочь дать SciRuby шанс показать себя? Да у вас могут быть сотни разных причин! Если так, то оставьте свой комментарий внизу – ведь для нас действительно важно знать мнение каждого из вас!
Что такое SQL: как устроен, зачем нужен и как с ним работать
Рассказываем о языке, на котором «говорят» большинство баз данных.
Иллюстрация: Оля Ежак для Skillbox Media
Иван Стуков
Журналист, изучает Python. Любит разбираться в мелочах, общаться с людьми и понимать их.
Вся информация, с которой вы сталкиваетесь в интернете, содержится в базах данных. В них же хранятся данные о сотрудниках и клиентах крупных компаний, научных и социологических исследованиях, расписании рейсов ближайшего к вам аэропорта и много о чём ещё.
Работать с этими циклопическими массивами информации вручную было бы долго, муторно и непродуктивно. Поэтому придумали SQL — специальный язык для общения с БД.
Что такое SQL
SQL (Structured Query Language, или язык структурированных запросов) — это декларативный язык программирования (язык запросов), который используют для создания, обработки и хранения данных в реляционных БД.
На чистом SQL нельзя написать программу — он предназначен только для взаимодействия с базами данных: получения, добавления, изменения и удаления информации в них, управления доступом и так далее.
Поэтому перед изучением SQL нужно разобраться, как устроены базы данных.
В каких базах данных используют SQL
Все БД можно поделить на два вида: реляционные и нереляционные. Язык SQL нужен для работы с первыми.
SQL настолько тесно связан с реляционными БД, что все нереляционные БД в противовес стали называть NoSQL. Вот и получилось, что SQL — это язык программирования, а NoSQL — тип баз данных.
Про реляционные БД часто говорят, что это набор двумерных таблиц. Прямо как в Excel: со столбцами, строками и ячейками. Это понятная визуализация, хотя и не совсем точная.
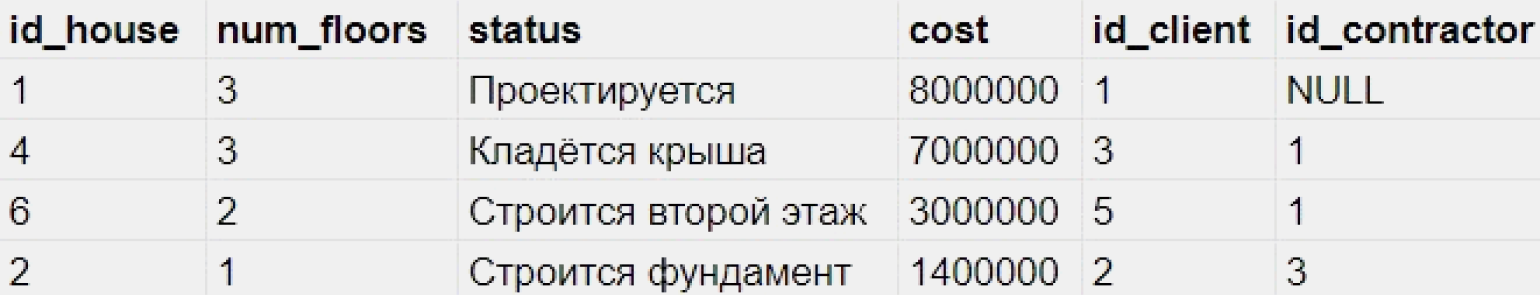
Представим, что мы создаём базу данных для небольшой строительной фирмы. Она проектирует загородные дома и передаёт проекты подрядчикам, которые занимаются самим строительством:
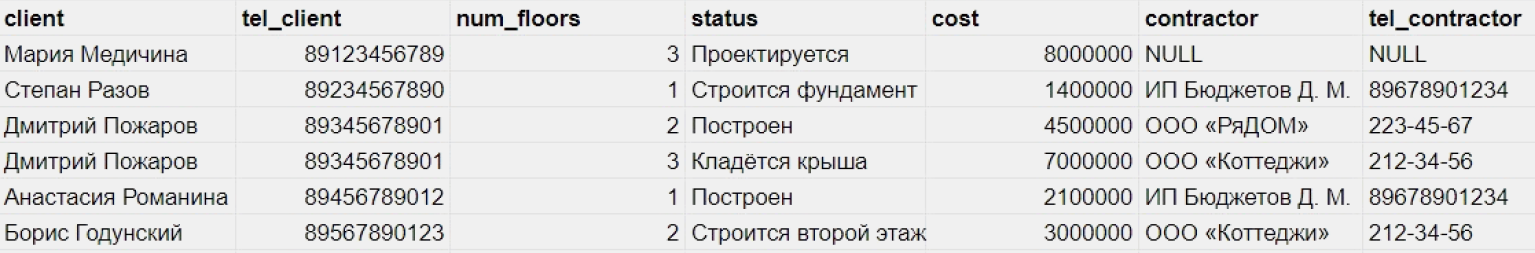
Чем же база данных отличается от таблицы? Тем, что в базе:
- У столбцов и строк нет определённого положения. Нельзя сказать, что столбец status находится до или после столбца num_floors, а имя Анастасии Романиной — до или после имени Дмитрия Пожарова.
- Каждый столбец диктует свой домен, то есть тип данных, к которому могут относиться его значения. Например, в столбцах cost и num_floors могут храниться только числа, а в столбце client — только строки.
- Каждая строка должна быть уникальной и не может повторять какую-то другую строку.
Из-за этих отличий применительно к базам данных используют другую терминологию. Столбец называется атрибутом, строка — записью или кортежем, а сама БД — их отношением друг к другу.
Нормализация в реляционных базах данных
Вернёмся к БД нашей строительной фирмы. Она может казаться удобной, но на самом деле не лишена недостатков.
Возьмём дом, который строится для Марии Медичиной. Сейчас он только проектируется, и мы ещё не выбрали для него подрядчика. Поэтому значение атрибута contractor равно NULL, то есть поле пустое. Но рано или поздно мы выберем подрядчика — например, ООО «Коттеджи». Тогда, кроме имени подрядчика, нам нужно будет заново указать его телефон. Сейчас значение этого атрибута тоже NULL. Пока что сделать это несложно.
В реальной же базе данных о подрядчике будет храниться гораздо больше информации: адрес, почта, ИНН, банковские реквизиты и так далее. Чтобы каждый раз переписывать всю эту информацию, придётся делать много лишних движений — а это не наш метод.
Если подрядчик вдруг сменит номер телефона, во всех старых записях останется устаревшая информация. А таких записей могут быть сотни и тысячи (если наша компания станет совсем успешной). Ровно та же ситуация с данными клиентов. Уследить за таким числом нюансов проблемно, и наша БД рискует превратиться в хранилище фейков.
Чтобы этого не происходило, в реляционных БД используют нормализацию. Это когда одну таблицу разбивают (декомпозируют) на несколько, а каждой записи присваивают уникальный ключ, по которому её можно идентифицировать.
Всего существует шесть нормальных форм. Чем выше номер формы, тем большему количеству правил она должна подчиняться. Приведём базу данных нашей строительной фирмы в соответствие с третьей нормальной формой.
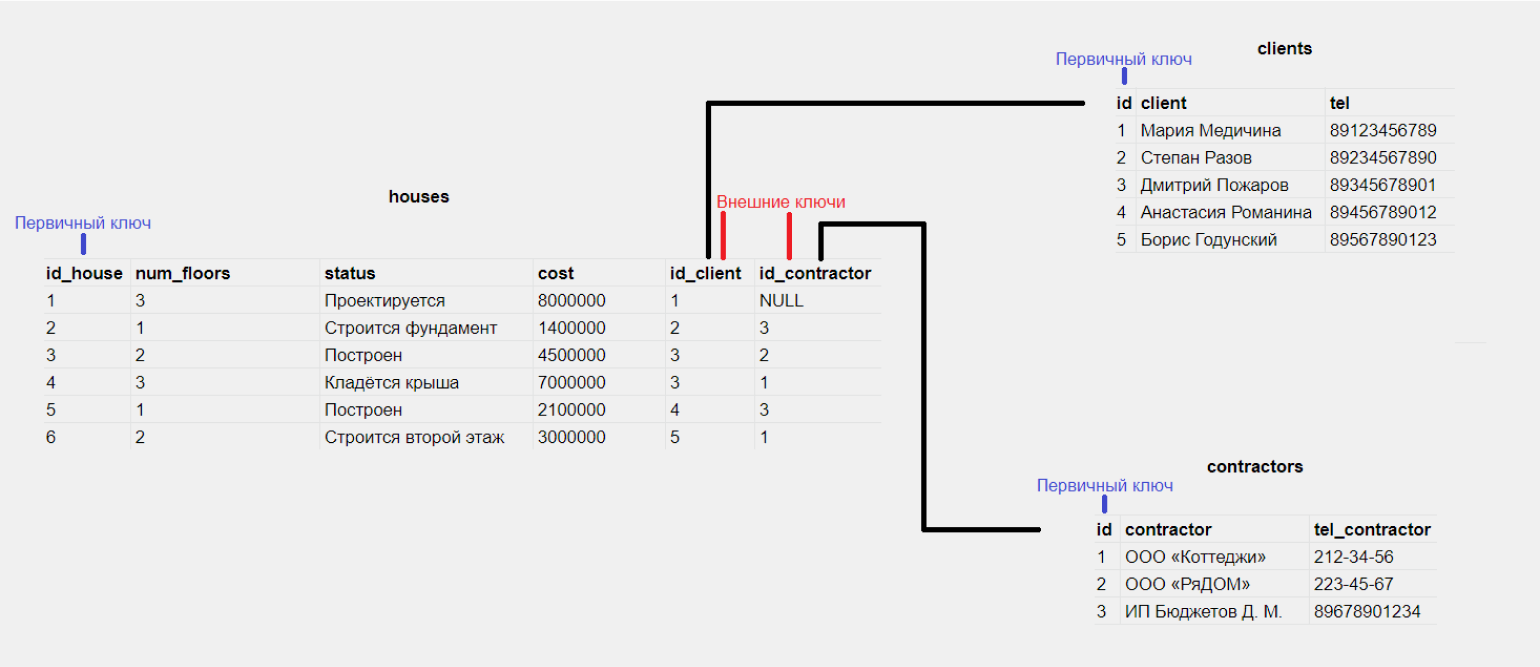
Теперь, если у любого клиента или подрядчика сменится телефон, нужно будет внести изменения всего один раз. Добавлять новые записи теперь тоже будет проще.
Таблицы связывают между собой ключами. Они бывают трёх видов.
Первичный — указывает на запись, к которой он относится. В одном отношении не может быть нескольких записей с одним и тем же первичным ключом, и значение первичного ключа не может быть NULL. Первичным ключом может быть любое уникальное значение. Например, в таблице contractors так можно было бы использовать ИНН, если б он был в нашей базе.
Внешний — содержит ссылку на первичный ключ из другой таблицы и привязывает одну таблицу к другой.
Родительский — это первичный ключ, на который ссылается внешний ключ.
Язык программирования SQL: как управлять базами данных
Ещё одно отличие реляционных БД от обычных таблиц — в них нельзя вносить изменения напрямую. Для этого нужны СУБД, или системы управления базами данных.
СУБД — это посредник, который получает от пользователя команды, что сделать с базой данных, и выполняет их. Эти-то команды и написаны на языке SQL.
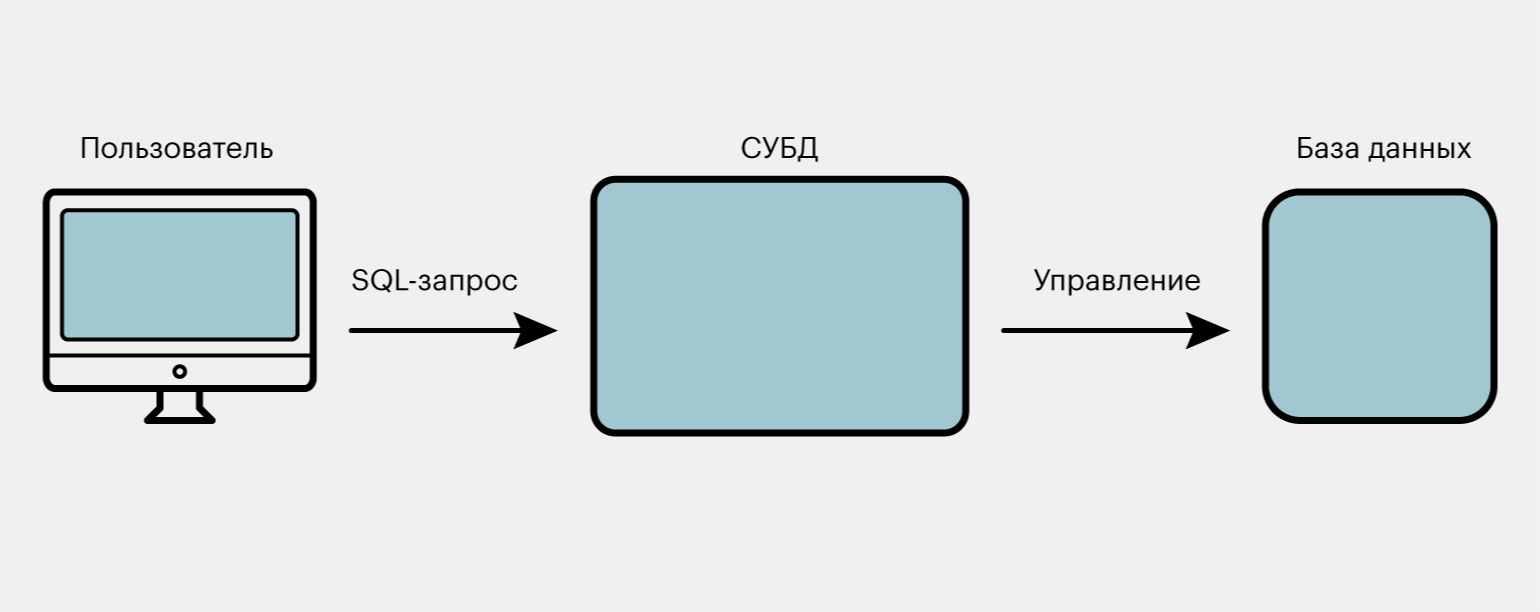
SQL — декларативный язык. Это значит, что при написании кода мы говорим, что хотим получить от программы. Логика того, как именно СУБД будет выполнять поставленную задачу, скрыта от нас.
Конечно, если вы хотите сделать свои запросы более быстрыми и эффективными или обезопасить базы данных, знать алгоритмы СУБД полезно. Но даже не разбираясь в этих тонкостях, вы сможете писать на SQL.
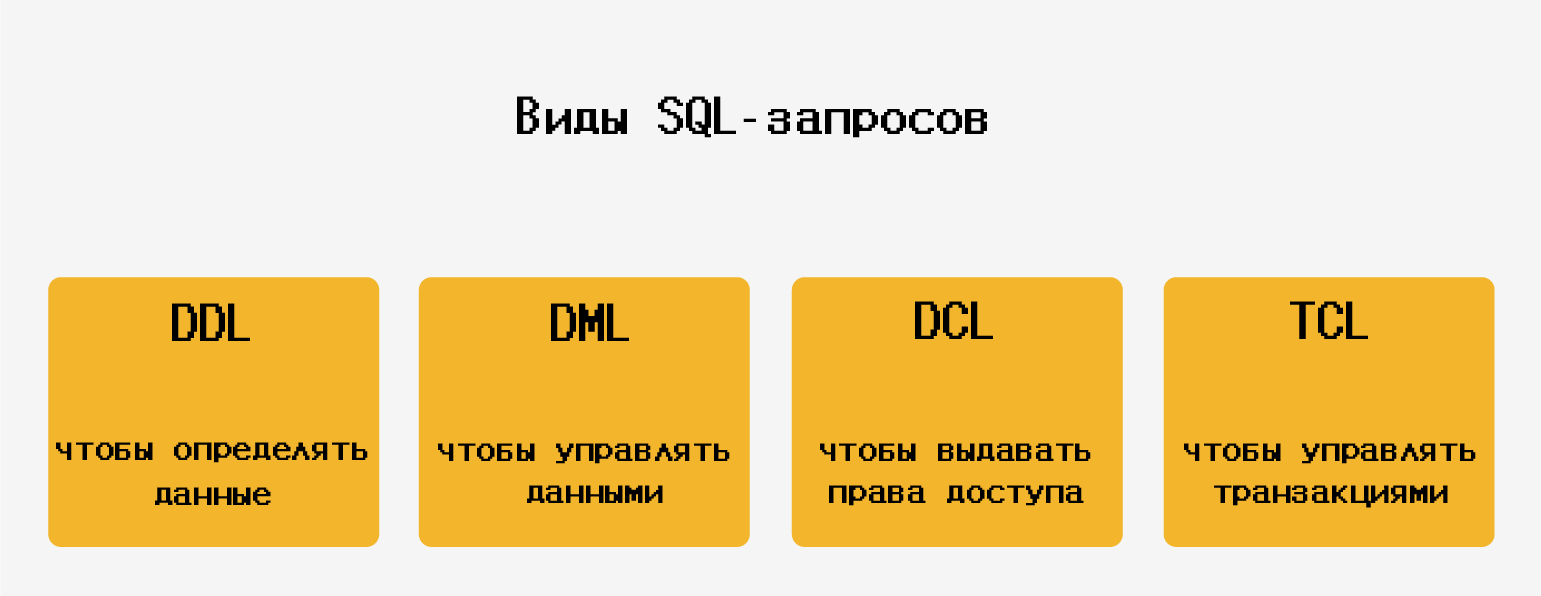
Все SQL-команды делятся на четыре вида:
- DDL (Data Definition Language, или язык описания данных). Их используют, чтобы создавать, изменять и удалять целые таблицы.
- DML (Data Manipulation Language, или язык управления данными). Их применяют к содержимому таблиц, чтобы создавать, изменять, удалять атрибуты и записи. Если нужно получить какую-то информацию из базы данных, то пользуются именно DML-операторами.
- DCL (Data Control Language, или язык контроля данных). Они нужны, чтобы выдавать конкретным пользователям доступ к базам данных и отзывать его.
- TCL (Transaction Control Language, или язык контроля транзакций). Позволяет управлять транзакциями. Транзакция — это набор из нескольких команд, которые выполняются поочерёдно. Если одна из команд внутри транзакции не срабатывает, то все уже совершённые действия отменяются. То есть транзакция может быть совершена либо полностью, либо никак.
Где применяют SQL
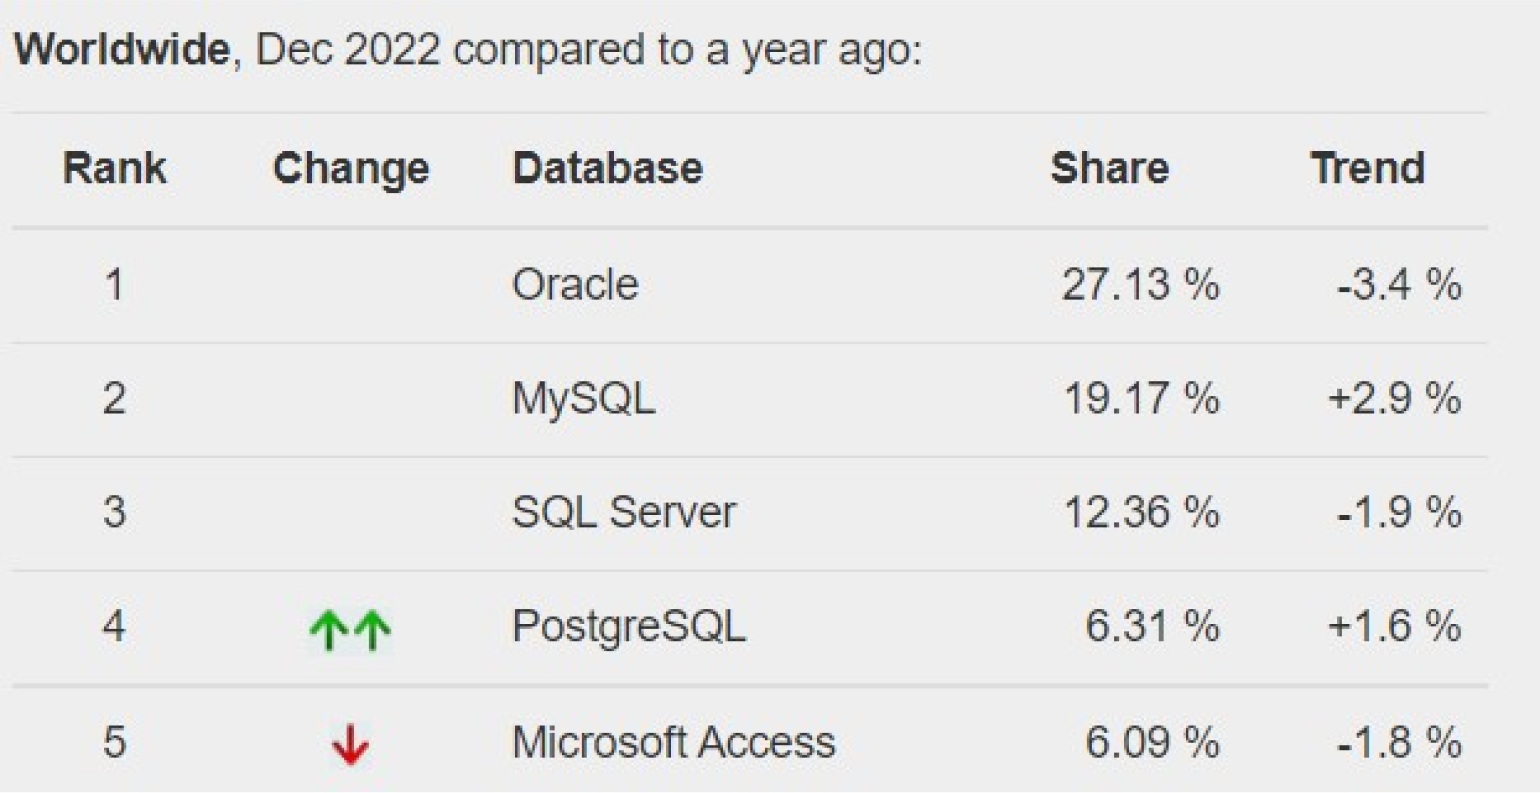
В индексе TOPDB популярность СУБД определяется по тому, как часто их гуглят. В декабре 2022 года первые пять мест в нём занимают именно реляционные СУБД — вместе они дают больше 70% поисковых запросов.
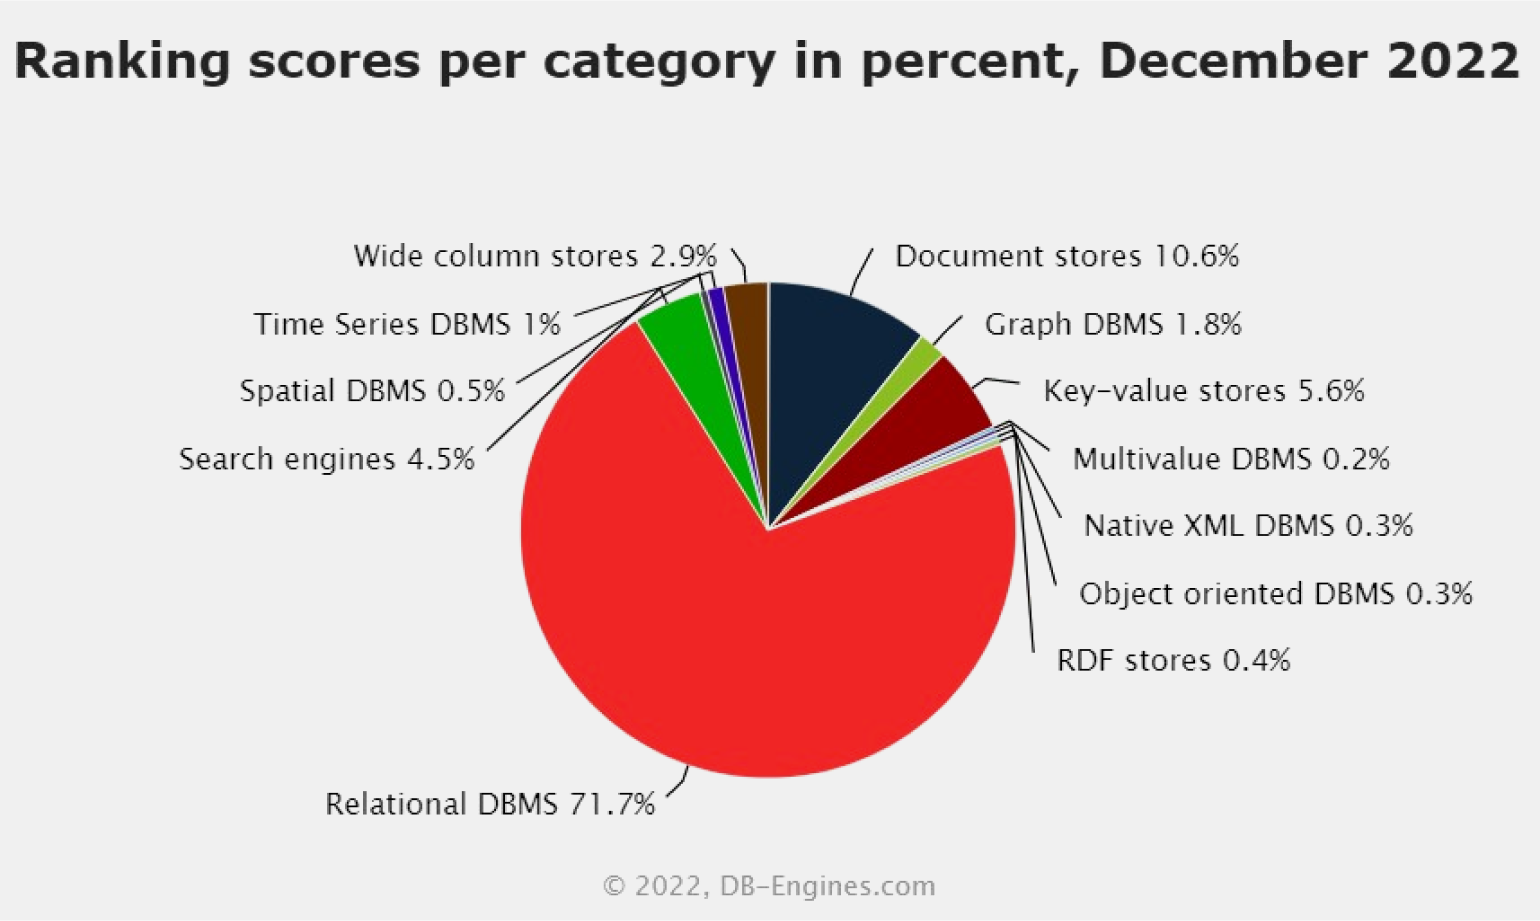
Рейтинг DB-Engines даёт похожие цифры. В декабре 2022 года доля реляционных СУБД составляет 71,7%.
Без баз данных не будет ни сайтов, ни сетевых приложений, ни крупных информационных систем — нужно же где-то хранить всю информацию. При этом реляционных БД — большинство, а чтобы управлять ими, нужен SQL. Поэтому мало какая вакансия бэкенд-разработчика обходится без требования владеть SQL. По крайней мере, мы такой не нашли.
Но умение работать с базами данных пригодится не только программисту.
Аналитики данных напрямую работают с «сырой» информацией. Чем лучше и свободнее они общаются с БД, тем проще им добывать и обрабатывать нужные данные в нужном виде.
Маркетологам SQL тоже будет полезен для решения аналитических задач.
Тестировщикам понадобится обращаться к БД, потому что это важный компонент любого информационного продукта.
Руководители, менеджеры и бизнес-консультанты благодаря информации из БД смогут лучше понимать, как функционирует их бизнес, и принимать более взвешенные решения.
Как работать с SQL: основные операторы
Запросы в SQL похожи на естественный английский язык и выглядят как полноценные предложения.
Например, если мы захотим в базе данных нашей строительной фирмы получить номер телефона ООО «Коттеджи», нам нужно написать такую команду:
Также в SQL существуют агрегатные функции. Они позволяют производить с данными дополнительные операции и указываются вместо атрибутов. Агрегатные функции записываются в формате FUNCTION(ATTRIBUTE).
Вот некоторые из них.
COUNT — считает количество записей в колонке.
SUM — складывает содержимое значений колонки.
MIN — указывает на минимальное значение в колонке.
MAX — указывает на максимальное значение в колонке.
AVG — считает среднее значение в колонке.
ROUND — округляет значение в колонке.
Для работы с инструкциями, которые содержат агрегатные функции, есть специальные операторы.
GROUP BY — группирует выходные значения для колонок, к которым применили агрегатную функцию.
HAVING — работает как WHERE, но может применяться к агрегатным функциям.
Конечно, это далеко не все операторы, функции и ключевые слова, которые есть в SQL. Но уже этот набор даёт широкие возможности для работы с базами данных.
Что запомнить
- SQL — это язык программирования для работы с реляционными базами данных.
- Самые распространённые базы данных — реляционные. Их можно представить как набор двумерных таблиц, связанных друг с другом ключами.
- SQL обращается к базам данных не напрямую, а через системы управления базами данных, илиСУБД.
- Производители СУБД пишут для языка SQL собственные расширения — диалекты. Но базовый синтаксис у всех них одинаковый.
- SQL-запросы состоят из операторов и складываются в полноценные предложения, которые похожи на естественный английский язык.
Больше интересного про код в нашем телеграм-канале. Подписывайтесь!
Язык SQL: что это такое и зачем его учить в 2023 году
Международная исследовательская компания IDC и крупнейший конгломерат Hitachi в прошлом году проводили исследование по аналитике данных. Оказалось, что 78% российских компаний постоянно обращаются к аналитике больших данных и более половины из этих фирм выделили бюджет на ближайший год под интеграцию аналитических решений и выделение отдельных новых рабочих мест. Востребованность специалистов со знанием SQL подтверждает и hh.ru, на котором открыто более 11 тысяч вакансий с упоминанием SQL.
Знание языка SQL позволит вам повысить свою ценность на рынке труда и освоить новые профессиональные горизонты. В этой статье расскажем, как использовать SQL, что такое СУБД и как в короткие сроки освоить язык запросов.
Содержание статьи скрыть
Что такое SQL
Весь мир ежесекундно генерирует огромное количество цифровой информации: денежные переводы, новости, лайки, сообщения в мессенджерах, поисковые запросы и др. Все эти данные рано или поздно пригодятся аналитикам, маркетологам, разработчикам, программистам и др. Быстро превратить рандомные цифры и слова в полезные сведения позволяет язык запросов SQL.
Прежде чем углубляться в терминологию SQL, приведём один пример. Представьте большую таблицу, в которой есть информация обо всех ресторанах и кафе в городе, готовящих суши и роллы. Из неё можно узнать адреса заведений, ассортимент, прайс на конкретную продукцию, наличие и стоимость доставки, состав блюд и др.
Предположим, вам необходимо понять, какие кафе и рестораны готовят роллы «Филадельфия» и доставляют круглосуточно. Вы можете потратить несколько дней, чтобы вручную сверить все данные и найти правильный, ответ либо составить корректный SQL-запрос и за пару минут узнать, в каких заведениях можно в любое время заказать «Филадельфию».
Подобные цифровые таблицы, где все данные структурированы по определённым типам так, чтобы легче было оперировать информацией, называются базами данных. А SQL — это язык запросов, который помогает находить нужную информацию в конкретной базе данных.
Ежедневные советы от диджитал-наставника Checkroi прямо в твоем телеграме!
Подписывайся на канал
Подписаться
Особенности SQL
В первую очередь SQL необходим для описания и сохранения данных, а также для их извлечения из базы, интерпретации и обработки. Многие ошибочно считают, что SQL— это один из языков программирования наравне с C#, JavaScript или Python, но это не совсем так. Если быть точными, SQL — это непроцедурный язык программирования, то есть с его помощью вы не создадите приложение, не разработаете игру и не соберёте сайт. SQL взаимодействуют только с базами данных, поэтому во всём мире его называют не языком программирования, а языком запросов.
Где используется SQL
Вы уже поняли, что язык SQL — это удобный инструмент для поиска важной информации среди большого объёма данных. Теперь разберёмся со сферами применения языка SQL: в основном это аналитика, маркетинг, разработка, программирование и управление проектами и компаниями.
Вот какие специалисты облегчают свою работу через SQL:
- аналитики — это довольно большая категория людей, в которую входят аналитики данных, бизнес-аналитики, системные аналитики, финансовые аналитики и др. Цели, задачи и итоговый результат у них разные, но все эти специалисты работают с большими массивами данных: запрашивают, обрабатывают, изучают и интерпретируют информацию. Их работа невозможна без знания SQL;
- д ата-сайе нтисты — эти специалисты тоже работают с большими данными. Они ищут связи и закономерности, чтобы создать модель или алгоритм, которые помогут спрогнозировать события и предсказать результат. Для поиска и анализа данных они используют не только SQL, но и математические алгоритмы;
- маркетологи — если маркетологи умеют корректно составлять SQL-запросы и направлять их в базу данных, им будет проще проводить исследования и принимать решения при разработке маркетинговых стратегий;
- разработчики — знание SQL позволяет таким специалистам создавать и внедрять новые базы данных, а также использовать язык запросов для разработки веб-сайтов, игр и приложений;
- тестировщики — используют SQL для создания автоматизированных модульных тестов, которые проверяют правильность работы базы данных;
- руководители — могут применять SQL, чтобы без сторонней помощи обращаться к базе данных и таким образом получать данные о работе отдела или целой компании и контролировать положение дел.
В упрощённом виде именно по такой схеме и работает специалист, знающий SQL, с базой данных
Как устроена база данных
В зависимости от того, какие данные нужно хранить и как с ними работать, все базы данных принято делить на реляционные и нереляционные. При этом нереляционные, в свою очередь, делятся на сетевые и иерархические. Проще всего их различия показать на схеме.
Схематический способ упорядочивания информации в различных типах баз данных
SQL-запросы составляют для реляционных баз данных. Иначе эти базы называют табличными, все данные в них представлены в виде разных таблиц, которые связаны друг с другом.
В реляционной базе данных есть несколько важных понятий, расскажем о них подробнее:
- отношение — так называют одну из таблиц, состоящую из строк и столбцов;
- атрибут — уникальный параметр группы объектов. В нашем примере про кафе, в которых готовят роллы «Филадельфия», атрибутами будут: название заведения, адрес, график работы и др. Если мы имеем дело с реляционной базой данных, атрибуты будут сохраняться в отдельном поле каждого столбца;
- домен — у любого атрибута есть свои допустимые значения. Так, в столбце «Название» все данные будут записаны только буквенными символами, а столбце «График работы» — цифровыми;
- кортеж — так называют строку с определённым порядковым номером, в которой можно найти все данные об одном конкретном объекте, в нашем случае об одном кафе или ресторане;
- значение — данные, содержащиеся в одной конкретной ячейке, которая находится на пересечении строк и столбцов;
- ключ — так обозначают столбец, в котором сохраняется уникальный идентификатор записи. Именно ключ позволяет обращаться к одной конкретной записи для её чтения, обновления или удаления. Также ключи связывают несколько таблиц.
Показываем на схеме, где искать те или иные понятия в реляционной базе данных
SQL-операторы: зачем нужны и какие бывают
В языке запросов есть своеобразные помощники — SQL-операторы. Это не люди, как может показаться из названия, а слова и символы, которые выполняют конкретные действия. В зависимости от решаемых задач и итогового результата операторы в SQL делятся на несколько видов — расскажем о каждом далее.
Data Definition Language
Операторы определения данных, в сокращении DDL, работают с целыми таблицами. Такие операторы могу добавить новую таблицу, внести изменения в существующую или удалить ненужную.
Набор команд для операторов определения данных: без этих команд невозможна одновременная работа с несколькими таблицами в базе данных
Data Manipulation Language
Операторы манипуляции данными, или сокращённо DML, работают со строками, атрибутами и значениями. Например, такой оператор поможет изменить адрес, если одно из заведений в нашей таблице сменит локацию.
Основные команды и их значения для операторов манипуляции данных. Если нашли ошибку в таблице, смело используйте команды «DELETE» и «UPDATE» для стирания и замены информации
Data Control Language
Оператор определения доступа к данным, или DCL, помогают открывать, изменять или отзывать пользовательский доступ к базе данных.
Команды для операторов определения доступа к данным позволяют одновременно работать над одной таблицей в базе данных сразу нескольким пользователям. Подобный принцип совместной работы реализован в Google Docs
Transaction Control Language
Язык управления транзакциями, или TCL, — это набор команд, которые выполняются друг за другом и позволяют контролировать обработку транзакций в базе данных. Транзакция считается успешной, когда все команды выполнены.
Чтобы понять суть транзакции, представьте, как вы онлайн оплачиваете заказанные роллы «Филадельфия». На странице оплаты вы введёте данные своей банковской карты, затем проверите их правильность, подтвердите операцию и введёте одноразовый код.
Если на каком-то из этих этапов вы передумаете оплачивать заказ — произойдёт откат транзакции. Тогда TCL заметит это и откатит транзакцию, убрав ранее совершённые операции из базы данных. А если пользователь не передумает оплачивать, TCL зафиксирует в базе все успешно выполненные команды.
Именно эти команды позволяют управлять транзакциями в базе данных
Что такое СУБД
Введём ещё один важный для этой темы термин — СУБД. Если база данных — это набор слов и чисел, организованных определённым способом, то системы управления базой данных или СУБД — это совокупность программ и инструментов, которые позволяют этой базой данных управлять.
СУБД помогает создавать новые таблицы, удалять и заменять неправильную информацию, настраивать ключи и обрабатывать запросы. Существует большое количество разных СУБД — такие системы создают и крупные технологические гиганты вроде Google или Microsoft, и небольшие IT-компании.
Выделяют два вида СУБД:
- коммерческие — с такими системами нужно работать по подписке;
- общедоступные — иначе их называют системы с открытым кодом, такой инструмент можно бесплатно использовать в любых проектах.
Выбор определённого вида СУБД зависит от конкретных целей компании. Крупные корпорации, работающие с масштабными проектами обычно используют коммерческие системы, а рядовые пользователи или небольшие фирмы — общедоступные СУБД.
Программы для работы с SQL
Мы расскажем про наиболее популярные инструменты c открытым исходным кодом для работы с SQL и объясним, в чём заключаются их различия.
SQL Fiddle . Редактор SQL с открытым исходным кодом, который поддерживает различные типы баз данных. Этот инструмент позволяет проводить онлайн-тестирование и определять проблемы в определённой базе данных.
MySQL. Удобная СУБД с быстрым порогом входа: освоить эту систему сможет даже новичок в SQL. MySQL работает с сайтами и веб-приложениями, а также используется в системах управления контентом сайтов. Эту СУБД используют разработчики фейсбука, твиттера ютуба и др.
PostgreSQL. Свободная объектно-реляционная система управления базами данных, которая обрабатывает информацию, как абстрактные объекты. Поэтому система PostgreSQL может обрабатывать более сложные структуры данных и выполнять многоэтапные процедуры. Эту СУБД используют разработчики «Яндекс.Почты», Skype, Avito и др.
Google Cloud Spanner. Облачная система управления данными. Изначально она была доступна только разработчикам Google, но уже несколько лет открыта и позволяет обрабатывать как реляционные, так и нереляционные базы данных. Google Cloud Spanner используют разработчики PayPal.
SQLite. Упрощённая версия СУБД, которая позволяет обрабатывать запросы в однопользовательских приложениях и сайтах с низким трафиком. Используется разработчиками Adobe Photoshop, Opera, Lightroom и др.
Как освоить SQL
Изучить язык запросов и на практике понять, как использовать SQL можно двумя способами: самостоятельно и на онлайн-курсах. Первый вариант подходит тем, кто привык учиться в спокойном темпе, у кого много свободного времени и всё хорошо с дисциплиной. Второй вариант для тех, кто не хочет учиться методом проб и ошибок, а желает быстро освоить SQL.
Мы не отрицаем пользы самообучения, но всегда рекомендуем проходить онлайн-курсы, чтобы получить систематические знания и учиться у профессионалов.
Расскажем о четырёх образовательных программах, на которых вы не просто найдёте ответы на вопросы «SQL-запросы, что это» и «таблица SQL — это как», а получите углублённые знания по поиску, интерпретации и визуализации данных, отточите навыки на практических заданиях и пополните портфолио. Также после обучения у вас останется сертификат, подтверждающий вашу квалификацию.
Курс «SQL для начинающих» от Международной школы профессий
Пятинедельный курс для новичков в аналитике. Вы научитесь обрабатывать и анализировать большие объёмы информации. Вы узнаете, из чего состоит синтаксис SQL-запроса, как создавать запросы и отправлять их в базу данных. Вы поймёте, как работать с различными СУБД, проводить когортный анализ данных и ускорять поиск информации с помощью индексов и идентификаторов.
Фишки: рассрочка и возможность начать обучение в любой момент, не дожидаясь, пока наберётся группа
Стоимость обучения: 15 800 ₽
Курс «SQL для анализа данных» от SkillFactory
Курс для новичков. За 2,5 месяца вы поймёте, как устроен язык SQL, базы данных и СУБД. Вы научитесь грамотно составлять SQL-запросы, получать, обрабатывать и анализировать любые данные, работать с повторяющимися значениями, объединять отдельные значения и целые таблицы. На онлайн-тренажёре вы отработаете полученные знания, а в конце курса защитите итоговый проект, решив реальную рабочую задачу.
Фишки: несколько тарифов, рассрочка, большое количество практических заданий
Стоимость обучения: 18 000 ₽
Курс «Основы SQL для анализа данных» от Skypro
Этот курс для начинающих аналитиков длится 4 месяца, за это время вы научитесь извлекать информацию из баз данных и грамотно её анализировать. Вы поймёте, как фильтровать, изменять и объединять данные из разных таблиц и создавать отчёты на основе полученной информации. В конце обучения вы защите курсовую работу, создав аналитический проект в SQL.
Фишки: командная работа с другими студентами, поддержка куратора, рассрочка и возможность возврата денег, если передумаете учиться.
Стоимость обучения: 24 000 ₽
Курс «PHP и MySQL» от FructCode
Всего за месяц вы с нуля освоите язык программирования PHP и научитесь писать чистый код и работать с системой управления базы данных MySQL. Вы узнаете, как устроено объектно-ориентированное программирование и сможете самостоятельно составлять простые и сложные SQL-запросы.
Фишки: тесты по пройденным урокам и сертификат об окончании курса на пяти языках
Стоимость обучения: бесплатно
Если пока с выбором курса определиться сложно и вам нужно больше вариантов — не беда. Сегодня многие образовательные платформы предлагают обучение по SQL. О других дистанционных программах мы писали в статье «Как изучить язык запросов SQL с нуля». Также в этом материале вы найдёте ссылки на бесплатные видеоуроки, телеграм-сообщества и каналы, профильную литературу и другие ресурсы для самообучения.
Подведём итог
Количество цифровой информации постоянно растёт, именно большие данные помогают людям разных специальностей решать профильные задачи: проводить анализ конкурентов, оценивать ситуацию в мире, собирать потребительские запросы и др. Искать, обрабатывать и анализировать такие данные помогает язык запросов SQL.
Если вы дочитали эту статью до конца, значит, ваш интерес к SQL высок и, скорее всего, вы продолжите дальше изучать эту тему. Мы желаем вам не останавливаться на достигнутом и постоянно осваивать новые инструменты. Знание SQL точно поможет вам выйти на новый профессиональный уровень, браться за более интересные задачи и значительно повысить свой заработок.
SQL-запросы: основные команды для управления базами данных
Эти команды нужны разработчикам, аналитикам, маркетологам и всем, кто хочет выжимать из данных максимум пользы.

Иллюстрация: Оля Ежак для Skillbox Media
Дмитрий Зверев
Любитель научной фантастики и технологического прогресса. Хорошо сочетает в себе заумного технаря и утончённого гуманитария. Пишет про IT и радуется этому.
SQL — это язык запросов для управления реляционными базами данных. «Реляционные» означает, что все данные хранятся в виде взаимосвязанных таблиц. А SQL как раз используют для того, чтобы как-то влиять на элементы внутри этих таблиц: добавлять, удалять, изменять и так далее.
Язык SQL лежит в основе систем управления реляционными базами данных, таких как MySQL, PostgreSQL, Oracle и т.д. Таким образом, чтобы работать, скажем, с базой данных MySQL, нужно сперва изучить язык запросов SQL.
По синтаксису SQL-запросы максимально похожи на обычные предложения:
Теперь перейдём к тому, как SQL-запросы составляются и из каких элементов состоят.
Как выглядит структура SQL-запроса
Перед вами — пример классического SQL-запроса, который состоит из шести самых популярных операторов: два из них обязательные, а другие четыре — используются по обстоятельствам. Вместе они выглядят так:
- SELECT — выбирает отдельные столбцы или всю таблицу целиком (обязательный);
- FROM — из какой таблицы получить данные (обязательный);
- WHERE — условие, по которому SQL выбирает данные;
- GROUPBY — столбец, по которому мы будут группироваться данные;
- HAVING — условие, по которому сгруппированные данные будут отфильтрованы;
- ORDERBY — столбец, по которому данные будут отсортированы;
Давайте разберём каждую из частей этого запроса по порядку.
SELECT
Любая команда должна начинаться с ключевого слова — или действия, которое должно произойти. Например, выбрать строку, вставить новую, изменить старую или удалить таблицу целиком.
Одно из таких ключевых слов — SELECT. Оно выбирает отдельные столбцы или таблицу целиком, чтобы потом передать данные другим запросам на обработку.
В качестве примера выберем столбцы Name и Age из таблицы Clients:
SELECT (Name, Age) FROM Clients
На выходе будут все строки таблицы, принадлежащие столбцам Name и Age.
FROM
Эта часть ставится после SELECT и нужна затем, чтобы указать, из какой таблицы или источника данных приходит информация. Здесь прописывается имя таблицы, с которой мы хотим работать.
Например, ранее мы уже выбирали данные из таблицы Clients:
SELECT (Name, Age) FROM Clients
В SQL всё построено на таблицах. Поэтому, если нужно получить данные из другого места — указываем другую таблицу.
WHERE
Если нужно отфильтровать данные, используем слово WHERE. После него указывается условие, которому должны удовлетворять строки, чтобы они попали в результат выполнения запроса.
Например, этот запрос вернёт все строки из таблицы, где значения Age больше 20:
SELECT (Name, Age) FROM Clients WHERE Age > 20
GROUP BY
Этот оператор помогает нам сгруппировать данные по определённым столбцам. В результате получим новую таблицу, составленную на основе выбранных данных.
Например, сгруппируем результат предыдущего запроса по городам:
SELECT (Name, Age) FROM Clients WHERE Age > 20 GROUP BY City
Запрос вернёт клиентов старше 20 лет и сгруппирует их по городам. Главное — чтобы столбец City присутствовал в таблице.
HAVING
Нужен, чтобы собирать группы по определённым условиям. Его обычно используют в паре с GROUP BY, а по своей функциональности он похож на WHERE.
Например, укажем, чтобы в группы добавлялись только клиенты с суммой заказа от 1000 рублей:
SELECT (Name, PaymentAmount, Age) FROM Clients WHERE Age > 20 GROUP BY City HAVING PaymentAmount > 1000
Так как наш запрос растёт, будем каждую его часть выносить на новую строку — чтобы не запутаться. На корректность запроса это не повлияет, а читать его станет куда удобнее.
ORDER BY
Позволяет сортировать полученные строки по возрастанию или убыванию. Работает как с числами, так и с символами. В качестве параметра нужно указать столбец, по которому надо выполнить сортировку.
Допустим, если хотим отсортировать клиентов по возрасту — от младшего к старшему, — добавляем команду ORDER BY Age:
SELECT (Name, PaymentAmount, Age) FROM Clients WHERE Age > 20 GROUP BY City HAVING PaymentAmount > 1000 ORDER BY Age
А чтобы отсортировать по убыванию, просто добавляем слово DESC:
SELECT (Name, PaymentAmount, Age) FROM Clients WHERE Age > 20 GROUP BY City HAVING PaymentAmount > 1000 ORDER BY Age DESC
Кроме этих шести операторов есть масса дополнительных — например, VIEW, UNION, LIKE. Они уникальны для каждого запроса и используются в зависимости от ситуации. Конечно, в этой статье мы не успеем разобрать все — если вам нужен полный список, можно заглянуть в эту шпаргалку по SQL.
Примеры SQL-запросов: создаём первую базу данных
Со структурой запросов разобрались, пришло время посоздавать таблицы. В качестве примера будем наполнять базу данных с котами, живущими в разных городах России.
CREATE DATABASE
Первым делом создаём базу данных. Делается это с помощью команды CREATE DATABASE:
CREATE DATABASE CatsCatsCats;
Внутри пока ничего нет. Но это пока.
CREATE TABLE
Запрос создаёт таблицу в базе данных. В общем виде команда выглядит так:
CREATE TABLE table_name ( column1 datatype, column2 datatype, column3 datatype );
Чтобы задать свои параметры таблицы, на месте table_name пишем название, а в скобках указываем названия колонок и типы данных, которые они будут содержать.
В SQL много типов данных. Вот примеры самых популярных:
- INT — целое число;
- DATETIME — дата;
- VARCHAR — строка;
- FLOAT — десятичное число.
В нашей таблице используется два типа: строки (VARCHAR) и целые числа (INT):
CREATE TABLE CatsAndOwners ( CatID int(6) NOT NULL, CatName varchar(255) NOT NULL, CatAge int(6) NOT NULL, CatColor varchar(255) NOT NULL, CatOwnerName varchar(255) NOT NULL );
В примере выше мы добавили пять столбцов: уникальный номер кота CatID, его имя CatName, возраст CatAge, цвет CatColor и имя владельца CatOwnerName. А ещё задали, чтобы ни одно из полей не было пустым — NOT NULL.
Цифры рядом с типами данных обозначают, сколько бит выделяется для поля. Например, varchar (255) значит, что строка может принимать размер от 0 до 255 бит — по объёму данных это приблизительно соответствует фразе «Я люблю язык SQL».
Созданная таблица пока выглядит пустовато. Читайте дальше, чтобы узнать, как наполнить её данными и научиться группировать их по своему усмотрению.
| CatID | CatName | CatAge | CatColor | CatOwnerName |
|---|---|---|---|---|
| | | | | |
ALTER TABLE
Если вдруг забыли добавить столбец во время создания таблицы — ничего страшного. Новые колонки можно добавлять с помощью команды ALTER TABLE. Давайте добавим город проживания кота:
ALTER TABLE CatsAndOwners ADD City varchar(255);
В запросе указываем, в какую таблицу хотим внести изменения, а затем с помощью ключевого слова ADD добавляем название столбца и его тип данных.
Теперь таблица выглядит так:
| CatID | CatName | CatAge | CatColor | CatOwnerName | City |
|---|---|---|---|---|---|
| | | | | | |
Вообще, возможности команды ALTER TABLE немного шире, чем мы разобрали в этом примере. Она заточена не только на добавление новых колонок, но и на удаление и редактирование существующих. Подробнее об этом поговорим чуть дальше, а пока — продолжим наполнять таблицу.
INSERT
Позволяет добавить новую строку в таблицу. Для этого нужно указать, какие столбцы мы хотим заполнить и передать значения для них с помощью команды VALUES. Добавим несколько котов:
INSERT INTO CatsAndOwners(CatID, CatName, CatAge, CatColor, CatOwnerName, City) VALUES (1, 'Мурка', 3, 'Чёрная', 'Дмитрий', 'Москва'); INSERT INTO CatsAndOwners(CatID, CatName, CatAge, CatColor, CatOwnerName, City) VALUES (2, 'Белла', 7, 'Белая', 'Максим', 'Саратов'); INSERT INTO CatsAndOwners(CatID, CatName, CatAge, CatColor, CatOwnerName, City) VALUES (3, 'Симба', 5, 'Рыжий', 'Екатерина', 'Санкт-Петербург'); INSERT INTO CatsAndOwners(CatID, CatName, CatAge, CatColor, CatOwnerName, City) VALUES (4, 'Лео', 2, 'Полосатый', 'Александр', 'Екатеринбург'); INSERT INTO CatsAndOwners(CatID, CatName, CatAge, CatColor, CatOwnerName, City) VALUES (5, 'Мася', 1, 'Серый', 'Анна', 'Москва');
Обратите внимание: строки указываются в одинарных кавычках, а числа — без них. И, к сожалению, нельзя добавить несколько строк одной командой.
Блеск! Таблица наконец-то обзавелась данными:
| CatID | CatName | CatAge | CatColor | CatOwnerName | City |
|---|---|---|---|---|---|
| 1 | Мурка | 3 | Чёрная | Дмитрий | Москва |
| 2 | Белла | 7 | Белая | Максим | Саратов |
| 3 | Симба | 5 | Рыжий | Екатерина | Санкт-Петербург |
| 4 | Лео | 2 | Полосатый | Александр | Екатеринбург |
| 5 | Мася | 1 | Серый | Анна | Москва |
SELECT
Запрос нужен, чтобы доставать данные из таблицы. Ранее мы уже успели познакомиться с этой командой, — давайте немного освежим память. Достанем из таблицы список котов и их владельцев:
SELECT CatName, CatOwnerName FROM CatsAndOwners;
| CatName | CatOwnerName |
|---|---|
| Мурка | Дмитрий |
| Белла | Максим |
| Симба | Екатерина |
| Лео | Александр |
| Мася | Анна |
Если нужно выбрать все столбцы из таблицы, после слова SELECT добавим символ *. В этом случае на выходе получим всю таблицу целиком.
SELECT * FROM CatsAndOwners;
WHERE
Нужен, чтобы задавать условия для фильтрации строк. Например, можем выбрать только те, у которых значение CatAge больше 5:
SELECT CatName, CatAge FROM CatsAndOwners WHERE CatAge > 5
Результатом будет одна строка с двумя столбцами:
| CatName | CatAge |
|---|---|
| Белла | 7 |
AND, OR, BETWEEN
Оператор WHERE интересен тем, что внутри него можно указывать условия — причём сразу несколько. Делается это с помощью логических конструкций AND, OR и BETWEEN.
AND — это логическое И. Оно означает, что должны выполняться оба условия запроса одновременно. Например, кошка должна быть чёрной И проживать в Москве.
SELECT CatName FROM CatsAndOwners WHERE CatColor = 'Чёрная' AND City = 'Москва'
| CatName |
|---|
| Мурка |
OR — это логическое ИЛИ. Оно означает, что должно выполниться или одно условие, или второе. Например, кошка должна быть ИЛИ старше пяти лет, ИЛИ быть чёрной.
SELECT CatName FROM CatsAndOwners WHERE CatAge > 5 OR CatColor = 'Чёрная'
| CatName |
|---|
| Мурка |
| Белла |
BETWEEN — это оператор, который выбирает все элементы внутри заданного диапазона. Например, можно запросить всех кошек в возрасте от двух до шести лет.
SELECT CatName, CatAge FROM CatsAndOwners WHERE CatAge BETWEEN 2 AND 6
| CatName | CatAge |
|---|---|
| Мурка | 3 |
| Симба | 5 |
| Лео | 2 |
Все вышеуказанные операторы можно использовать одним пакетом:
SELECT CatName, CatAge FROM CatsAndOwners WHERE CatAge BETWEEN 2 AND 8 AND (City = 'Саратов' OR City = 'Санкт-Петербург') OR CatName = 'Мурка'
| CatName | CatAge |
|---|---|
| Мурка | 3 |
| Белла | 7 |
| Симба | 5 |
ORDER BY
Сортирует полученные строки в заданном столбце по убыванию или по возрастанию. Например, можем выбрать всех кошек и отсортировать их от самых старших к самым младшим:
SELECT CatName, CatAge FROM CatsAndOwners ORDER BY CatAge DESC
| CatName | CatAge |
|---|---|
| Белла | 7 |
| Симба | 5 |
| Мурка | 3 |
| Лео | 2 |
| Мася | 1 |
Чтобы отсортировать записи по возрастанию, нужно просто убрать из запроса параметр DESC:
SELECT CatName, CatAge FROM CatsAndOwners ORDER BY CatAge
| CatName | CatAge |
|---|---|
| Мася | 1 |
| Лео | 2 |
| Мурка | 3 |
| Симба | 5 |
| Белла | 7 |
GROUP BY
Выбранные строки можно сгруппировать по столбцам. Например, можем посмотреть, сколько кошек живёт в разных городах.
SELECT City, COUNT(*) AS CatCount FROM CatsAndOwners GROUP BY City;
В этом примере мы применили агрегатную функцию COUNT, которая посчитала количество строк в каждой группе. К функциям-агрегаторам мы вернёмся позже, а пока — насладимся результатом:
| CatName | CatCount |
|---|---|
| Москва | 2 |
| Саратов | 1 |
| Санкт-Петербург | 1 |
| Екатеринбург | 1 |
Также мы использовали оператор AS, чтобы задать название для новой колонки, в которую мы и собрали количество котов в разных городах.
LIMIT
Запрос позволяет ограничить количество строк в финальной выдаче. Например, можем указать, чтобы выводились только первые две строки из таблицы:
SELECT * FROM CatsAndOwners LIMIT 2;
| CatID | CatName | CatAge | CatColor | CatOwnerName | City |
|---|---|---|---|---|---|
| 1 | Мурка | 3 | Чёрная | Дмитрий | Москва |
| 2 | Белла | 7 | Белая | Максим | Саратов |
UPDATE
Позволяет изменить данные в таблице. Допустим, кошка Симба сходила в парикмахерскую для животных и сменила цвет шёрстки на пурпурный. Отражаем эти изменения в таблице с помощью такого кода:
UPDATE CatsAndOwners SET CatColor = 'Пурпурный' WHERE CatName = 'Симба';
Всё просто: рядом с командой UPDATE пишем название таблицы, которую нужно обновить, затем рядом с SET указываем, какой именно столбец меняем и на какое значение, а в конце — определяем конкретную ячейку.
| CatID | CatName | CatAge | CatColor | CatOwnerName | City |
|---|---|---|---|---|---|
| 1 | Мурка | 3 | Чёрная | Дмитрий | Москва |
| 2 | Белла | 7 | Белая | Максим | Саратов |
| 3 | Симба | 5 | Пурпурный | Екатерина | Санкт-Петербург |
| 4 | Лео | 2 | Полосатый | Александр | Екатеринбург |
| 5 | Мася | 1 | Серый | Анна | Москва |
DELETE
Удаляет строку. Например, можем удалить из таблицы всех кошек, которые живут в Саратове:
DELETE FROM CatsAndOwners WHERE City = 'Саратов';
| CatID | CatName | CatAge | CatColor | CatOwnerName | City |
|---|---|---|---|---|---|
| 1 | Мурка | 3 | Чёрная | Дмитрий | Москва |
| 3 | Симба | 5 | Пурпурный | Екатерина | Санкт-Петербург |
| 4 | Лео | 2 | Полосатый | Александр | Екатеринбург |
| 5 | Мася | 1 | Серый | Анна | Москва |
DROP COLUMN
Удаляет столбец. Например, можно удалить имена кошачьих хозяев:
ALTER TABLE CatsAndOwners DROP COLUMN CatOwnerName;
Заметьте, что сначала нужно применить команду ALTER TABLE. Как мы помним, она заточена на то, чтобы добавлять, менять или удалять колонки в таблице.
| CatID | CatName | CatAge | CatColor | City |
|---|---|---|---|---|
| 1 | Мурка | 3 | Чёрная | Москва |
| 3 | Симба | 5 | Пурпурный | Санкт-Петербург |
| 4 | Лео | 2 | Полосатый | Екатеринбург |
| 5 | Мася | 1 | Серый | Москва |
DROP TABLE
Если таблица больше не нужна, можем удалить её. Сделать это просто:
DROP TABLE CatsAndOwners;
Применяйте команду на свой страх и риск. Предварительно советуем всё-таки сохранить таблицу — вдруг пригодится.
Агрегатные функции
Агрегатные функции используют для того, чтобы производить вычисления с данными в таблице: считать количество строк, суммировать значения в столбце, найти среднее значение и так далее.
В SQL доступны пять агрегатных функций:
- COUNT — посчитать количество строк;
- SUM — посчитать сумму значений в столбце;
- AVG — получить среднее значение в столбце;
- MIN — получить минимальное значение в столбце;
- MAX — получить максимальное значение в столбце.
Попробуем вычислить совокупный возраст всех кошек:
SELECT SUM(CatAge) AS TotalAge FROM CatsAndOwners;
| TotalAgeCatName |
|---|
| 11 |
Теперь найдём наименьший возраст кошки:
SELECT MIN(CatAge) AS MinAge FROM CatsAndOwners;
| MinAge |
|---|
| 1 |
А теперь высшая математика — вычислим средний возраст кошек для каждого города:
SELECT City, AVG(CatAge) AS AverageAge FROM CatsAndOwners GROUP BY City;
| City | AverageAgeCatCount |
|---|---|
| Москва | 2 |
| Санкт-Петербург | 5 |
| Екатеринбург | 2 |
Что запомнить
Выделим важные пункты из этой статьи, которые стоит запомнить:
- SQL — это язык структурированных запросов. Он нужен, чтобы управлять информацией в реляционных базах данных — то есть тех, которые состоят из связанных между собой таблиц.
- Каждый запрос нацелен на то, чтобы совершать какое-то действие с данными в таблице: выводить на экран, добавлять новые, считать средние значения, удалять и так далее.
- Все запросы делятся на четыре группы: DDL, DML, DCL и TCL. DDL отвечает за определение данных. DML — за управление данными. DCL — за выдачу прав доступа. TCL — за управление транзакциями.
- Классический запрос состоит из шести операторов. Два из них обязательные: SELECT и FROM. Остальные четыре — используются в зависимости от задачи: WHERE, GROUP BY, HAVING и ORDER BY.
- Помимо базовых команд, в SQL существует множество дополнительных — изучить их можно, например, в шпаргалке от W3Schools. А ещё лучше — берите эти команды на вооружение и экспериментируйте, ведь теория без практики мертва.
Читайте также:
- SQL и NoSQL: инь и ян в мире баз данных
- Тест: угадай известного программиста по его рабочему столу
- База данных: что это такое и зачем она нужна