
Создание голосового ассистента на Python, часть 1
Добрый день. Наверное, все смотрели фильмы про железного человека и хотели себе голосового помощника, похожего на Джарвиса. В этом посте я расскажу, как сделать такого ассистента с нуля. Моя программа будет написана на python 3 в операционной системе windows. Итак, поехали!
Работать наш ассистент будет по такому принципу:
- Постоянно «слушать» микрофон
- Распознавать слова в google
- Выполнять команду, либо отвечать
Для начала мы установим в систему windows русские голоса. Для этого переходим по ссылке и скачиваем голоса в разделе SAPI 5 -> Russian. Там есть 4 голоса, можно выбрать любой, какой вам понравится. Устанавливаем и идём дальше.
Нам нужно поставить библиотеку pyttsx3 для синтеза речи:
pip install pyttsx3Затем можно запустить тестовую программу и проверить правильность её выполнения.
import pyttsx3 text = 'какой-нибудь текст' tts = pyttsx3.init() rate = tts.getProperty('rate') #Скорость произношения tts.setProperty('rate', rate-40) volume = tts.getProperty('volume') #Громкость голоса tts.setProperty('volume', volume+0.9) voices = tts.getProperty('voices') # Задать голос по умолчанию tts.setProperty('voice', 'ru') # Попробовать установить предпочтительный голос for voice in voices: if voice.name == 'Anna': tts.setProperty('voice', voice.id) tts.say(text) tts.runAndWait()2) Распознавание речи
Существует много инструментов для распознавания речи, но они все платные. Поэтому я пытался найти бесплатное решение для моего проекта и нашёл её! Это библиотека speech_recognition.
pip install SpeechRecognitionТакже для работы с микрофоном нам необходима библиотека PyAudio.
pip install PyAudioУ некоторых людей возникает проблема с установкой PyAudio, поэтому следует перейти по этой ссылке и скачать нужную вам версию PyAudio. Затем ввести в консоль:
pip instal название скачанного файлаЗатем запускаете тестовую программу. Но перед этим вы должны исправить в ней device_index=1 на своё значение индекса микрофона. Узнать индекс микрофона можно с помощью этой программы:
import speech_recognition as sr for index, name in enumerate(sr.Microphone.list_microphone_names()): print("Microphone with name \"\" found for `Microphone(device_index=)`".format(index, name))Тест распознавания речи:
import speech_recognition as sr def record_volume(): r = sr.Recognizer() with sr.Microphone(device_index = 1) as source: print('Настраиваюсь.') r.adjust_for_ambient_noise(source, duration=0.5) #настройка посторонних шумов print('Слушаю. ') audio = r.listen(source) print('Услышала.') try: query = r.recognize_google(audio, language = 'ru-RU') text = query.lower() print(f'Вы сказали: ') except: print('Error') while True: record_volume()Если всё отлично, переходим дальше.
Если вы хотите, чтобы ассистент просто общался с вами (без ИИ), то это можно сделать с помощью бесплатного инструмента DialogFlow от Google. После того, как вы залогинетесь, вы увидите экран, где уже можно создать своего первого бота. Нажмите Create agent. Придумайте боту имя (Agent name), выберете язык (Default Language) и нажмите Create. Бот создан!
Чтобы добавить новые варианты ответов на разные вопросы, нужно создать новый intent. Для этого в разделе intents нажмите Create intent. Заполните поля «Название» и Training phrases, а затем ответы. Нажмите Save. Вот и всё.
Чтобы управлять ботом на python, нужно написать такой код. В моей программе бот озвучивает все ответы.
import apiai, json, re import pyttsx3 import speech_recognition as sr tts = pyttsx3.init() rate = tts.getProperty('rate') tts.setProperty('rate', rate-40) volume = tts.getProperty('volume') tts.setProperty('volume', volume+0.9) voices = tts.getProperty('voices') tts.setProperty('voice', 'ru') for voice in voices: if voice.name == 'Anna': tts.setProperty('voice', voice.id) def record_volume(): r = sr.Recognizer() with sr.Microphone(device_index = 1) as source: print('Настраиваюсь.') r.adjust_for_ambient_noise(source, duration=1) print('Слушаю. ') audio = r.listen(source) print('Услышала.') try: query = r.recognize_google(audio, language = 'ru-RU') text = query.lower() print(f'Вы сказали: ') textMessage( text ) except: print('Ошибка распознавания.') def talk( text ): tts.say( text ) tts.runAndWait() def textMessage( text ): request = apiai.ApiAI('ваш токен').text_request() # Токен API к Dialogflow request.lang = 'ru' # На каком языке будет послан запрос request.session_id = 'ваш id' # ID Сессии диалога (нужно, чтобы потом учить бота) request.query = text # Посылаем запрос к ИИ с сообщением от юзера responseJson = json.loads(request.getresponse().read().decode('utf-8')) response = responseJson['result']['fulfillment']['speech'] # Разбираем JSON и вытаскиваем ответ # Если есть ответ от бота - присылаем пользователю, если нет - бот его не понял if response: request.audio_output = response talk(response) else: talk('Простите. Я Вас не совсем поняла.') while True: record_volume()На сегодня всё. В следующей части я расскажу как сделать умного бота, т.е. чтобы он мог не только отвечать, но и что-либо делать.
- голосовой ассистент
- голосовой помощник
- python
- Python
- Программирование
- Разработка под Windows
Python: как создать простейшего голосового помощника?
Для создания голосового помощника не нужно обладать большими знаниями в программировании, главное понимать каким функционалом он должен владеть. Многие компании создают их на первой линии связи с клиентом для удобства, оптимизации рабочих процессов и наилучшей классификации звонков.
19K открытий
В данной статье представлена программа, которая может стать основой для Вашего собственного чат-бота, а если точнее – голосового помощника для распознавания голоса и последующего выполнения команд. С ее помощью мы сможем понять принцип работы наиболее часто встречаемых голосовых помощников.
Для начала объявим необходимые нам библиотеки:
#Необходимые библиотеки import speech_recognition as sr import os import sys import webbrowser import pyttsx3 as p from datetime import datetime import time import datetime import random
Также не забудем вести лог файл, который понадобится нам, если же мы все-таки решим улучшить бота для работы с нейронной сетью. Многие компании использую нейронную сеть в своих голосовых помощниках для понимания эмоций клиента и соответствующего реагирования на них. Также стоит не забывать, что с помощью анализа логов, мы сможем понять слабые места алгоритма бота и улучшить взаимодействие с клиентами.
#Создаем лог chat_log = [[‘SESSION_ID’, ‘DATE’, ‘AUTHOR’, ‘TEXT’, ‘AUDIO_NUM’]] #Узнаем номер сессии i = 1 exit = 0 while exit == 0: session_id = str(i) if session_id not in os.listdir(): os.mkdir(session_id) exit = 1 else: i = i + 1 #Первое сообщение пишет bot author = ‘Bot’ text = ‘Привет! Чем я могу вам помочь?’
В лог файл мы записываем время сообщения, автора (бот или пользователь) и собственно сам сказанный текст.
#Добавляем данные к логу с помощью этой процедуры def log_me(author, text, audio): now = datetime.datetime.now() i = 1 exit = 0 while exit == 0: audio_num = str(i)+’.wav’ if audio_num not in os.listdir(session_id): exit = 1 else: i = i + 1 os.chdir(session_id) with open(audio_num , «wb») as file: file.write(audio.get_wav_data()) chat_log.append([now.strftime(«%Y-%m-%d %H:%M:%S»), author, text, audio_num])
Выводим первое сообщение за авторством бота: Привет! Чем я могу вам помочь?
# Выводим первое сообщение на экран и записываем в лог print(«Bot: «+ text) log_me(author, text, audio)
А с помощью такой процедуры в Jupyter Notebook мы можем озвучить через устройство воспроизведения, настроенное по умолчанию, сказанные слова:
#Произношение words def talk(words): engine.say(words) engine.runAndWait()
Как озвучивать текст мы рассмотрели выше, но как же мы свой голос сможем превратить в текст? Тут нам поможет распознавание речи от Google и некоторые манипуляции с микрофоном.
#Настройка микрофона def command(): rec = sr.Recognizer() with sr.Microphone() as source: #Бот ожидает нашего голоса print(‘Bot: . ‘) #Небольшая задержка в записи rec.pause_threshold = 1 #Удаление фонового шума с записи rec.adjust_for_ambient_noise(source, duration=1) audio = rec.listen(source) try: #Распознание теста с помощью сервиса GOOGLE text = rec.recognize_google(audio, language=»ru-RU»).lower() #Вывод сказанного текста на экран print(‘Вы: ‘ + text[0].upper() + text[1:]) log_me(‘User’, text, audio) #Если не распознался тест из аудио except sr.UnknownValueError: text = ‘Не понимаю. Повторите.’ print(‘Bot: ‘ + text) talk(text) #Начинаем заново слушать text = command() log_me(‘Bot’, text, , Null) return text
Что может сделать наш помощник кроме того, чтобы нас слушать? Все ограничено нашей фантазией! Рассмотрим несколько интересный примеров.
Начнем с простого, пусть при команде открыть сайт – он откроет сайт (не ожидали?).
#Тут расписаны действия, которые будут выполнятся при наличии некоторых словосочетаний def makeSomething(text): if ‘открой сайт’ in text: print(‘Bot: Открываю сайт NewTechAudit.’) talk(‘Открываю сайт NewTechAudit.’) log_me(‘Bot’,’Открываю сайт NewTechAudit.’, Null) webbrowser.open(‘https://newtechaudit.ru/’)
Иногда полезно послушать свои слова, да чужими устами. Пусть бот еще умеет и повторять за нами:
#Повторение фразы пользователя elif ‘произнеси’ in text or ‘скажи’ in text or ‘повтори’ in text: print(‘Bot: ‘ + text[10].upper() + text[11:]) talk(text[10:]) log_me(‘Bot’, text[10].upper() + text[11:] , Null)
Пусть еще и собеседником будет, но начнем мы пока только со знакомства:
#Ответ на вопрос elif ‘своё имя’ in text or ‘как тебя зовут’ in text or ‘назови себя’ in text: print(‘Bot: Меня зовут Bot.’) talk(‘Меня зовут Bot’) log_me(‘Bot’, ‘Меня зовут Bot’, Null)
Мы также можем попросить голосового помощника назвать случайное число в выбранных нами пределах в формате: Назови случайное число от (1ое число) до (2ое число).
#Определение случайного числа elif ‘случайное число’ in text: ot=text.find(‘от’) do=text.find(‘до’) f_num=int(text[ot+3:do-1]) l_num=int(text[do+3:]) r=str(random.randint(f_num, l_num)) print(‘Bot: ‘ + r) talk(r) log_me(‘Bot’, r, Null)
Для того, чтобы завершить программу, достаточно только попрощаться с ботом:
#Завершение программы elif ‘пока’ in text or ‘до свидания’ in text: print(‘Bot: До свидания!’) talk(‘До свидания’) log_me(‘Bot’, ‘Конец сессии’, Null) os.chdir(session_id) log_file = open( session_id + «.txt», «w») for row in chat_log: np.savetxt(log_file, row) log_file.close() sys.exit()
А чтобы все это работало беспрерывно, мы создаем бесконечный цикл.
#Бесконечный цикл для работы while True: makeSomething(command())
Проведем тестовый диалог:
Пишем голосового ассистента на Python
Технологии в области машинного обучения за последний год развиваются с потрясающей скоростью. Всё больше компаний делятся своими наработками, тем самым открывая новые возможности для создания умных цифровых помощников.
В рамках данной статьи я хочу поделиться своим опытом реализации голосового ассистента и предложить вам несколько идей для того, чтобы сделать его ещё умнее и полезнее.
Что умеет мой голосовой ассистент?
| Описание умения | Работа в offline-режиме | Требуемые зависимости |
| Распознавать и синтезировать речь | Поддерживается | pip install PyAudio (использование микрофона) |
pip install pyttsx3 (синтез речи)
Для распознавания речи можно выбрать одну или взять обе:
- pip install SpeechRecognition (высокое качество online-распознавания, множество языков)
- pip install vosk (высокое качество offline-распознавания, меньше языков)
Шаг 1. Обработка голосового ввода
Начнём с того, что научимся обрабатывать голосовой ввод. Нам потребуется микрофон и пара установленных библиотек: PyAudio и SpeechRecognition.
Подготовим основные инструменты для распознавания речи:
import speech_recognition if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи voice_input = record_and_recognize_audio() print(voice_input) Теперь создадим функцию для записи и распознавания речи. Для онлайн-распознавания нам потребуется Google, поскольку он имеет высокое качество распознавания на большом количестве языков.
def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит выброс ошибки except speech_recognition.RequestError: print("Check your Internet Connection, please") return recognized_data А что делать, если нет доступа в Интернет? Можно воспользоваться решениями для offline-распознавания. Мне лично безумно понравился проект Vosk.
На самом деле, необязательно внедрять offline-вариант, если он вам не нужен. Мне просто хотелось показать оба способа в рамках статьи, а вы уже выбирайте, исходя из своих требований к системе (например, по количеству доступных языков распознавания бесспорно лидирует Google).
Теперь, внедрив offline-решение и добавив в проект нужные языковые модели, при отсутствии доступа к сети у нас автоматически будет выполняться переключение на offline-распознавание.
Замечу, что для того, чтобы не нужно было два раза повторять одну и ту же фразу, я решила записывать аудио с микрофона во временный wav-файл, который будет удаляться после каждого распознавания.
Таким образом, полученный код выглядит следующим образом:
Полный код для работы распознавания речи
from vosk import Model, KaldiRecognizer # оффлайн-распознавание от Vosk import speech_recognition # распознавание пользовательской речи (Speech-To-Text) import wave # создание и чтение аудиофайлов формата wav import json # работа с json-файлами и json-строками import os # работа с файловой системой def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) with open("microphone-results.wav", "wb") as file: file.write(audio.get_wav_data()) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит попытка # использовать offline-распознавание через Vosk except speech_recognition.RequestError: print("Trying to use offline recognition. ") recognized_data = use_offline_recognition() return recognized_data def use_offline_recognition(): """ Переключение на оффлайн-распознавание речи :return: распознанная фраза """ recognized_data = "" try: # проверка наличия модели на нужном языке в каталоге приложения if not os.path.exists("models/vosk-model-small-ru-0.4"): print("Please download the model from:\n" "https://alphacephei.com/vosk/models and unpack as 'model' in the current folder.") exit(1) # анализ записанного в микрофон аудио (чтобы избежать повторов фразы) wave_audio_file = wave.open("microphone-results.wav", "rb") model = Model("models/vosk-model-small-ru-0.4") offline_recognizer = KaldiRecognizer(model, wave_audio_file.getframerate()) data = wave_audio_file.readframes(wave_audio_file.getnframes()) if len(data) > 0: if offline_recognizer.AcceptWaveform(data): recognized_data = offline_recognizer.Result() # получение данных распознанного текста из JSON-строки # (чтобы можно было выдать по ней ответ) recognized_data = json.loads(recognized_data) recognized_data = recognized_data["text"] except: print("Sorry, speech service is unavailable. Try again later") return recognized_data if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) Возможно, вы спросите «А зачем поддерживать offline-возможности?»
Я считаю, что всегда стоит учитывать, что пользователь может быть отрезан от сети. В таком случае, голосовой ассистент всё еще может быть полезным, если использовать его как разговорного бота или для решения ряда простых задач, например, посчитать что-то, порекомендовать фильм, помочь сделать выбор кухни, сыграть в игру и т.д.
Шаг 2. Конфигурация голосового ассистента
Поскольку наш голосовой ассистент может иметь пол, язык речи, ну и по классике, имя, то давайте выделим под эти данные отдельный класс, с которым будем работать в дальнейшем.
Для того, чтобы задать нашему ассистенту голос, мы воспользуемся библиотекой для offline-синтеза речи pyttsx3. Она автоматически найдет голоса, доступные для синтеза на нашем компьютере в зависимости от настроек операционной системы (поэтому, возможно, что у вас могут быть доступны другие голоса и вам нужны будут другие индексы).
Также добавим в в main-функцию инициализацию синтеза речи и отдельную функцию для её проигрывания. Чтобы убедиться, что всё работает, сделаем небольшую проверку на то, что пользователь с нами поздоровался, и выдадим ему обратное приветствие от ассистента:
Полный код основы голосового ассистента (синтез и распознавание речи)
from vosk import Model, KaldiRecognizer # оффлайн-распознавание от Vosk import speech_recognition # распознавание пользовательской речи (Speech-To-Text) import pyttsx3 # синтез речи (Text-To-Speech) import wave # создание и чтение аудиофайлов формата wav import json # работа с json-файлами и json-строками import os # работа с файловой системой class VoiceAssistant: """ Настройки голосового ассистента, включающие имя, пол, язык речи """ name = "" sex = "" speech_language = "" recognition_language = "" def setup_assistant_voice(): """ Установка голоса по умолчанию (индекс может меняться в зависимости от настроек операционной системы) """ voices = ttsEngine.getProperty("voices") if assistant.speech_language == "en": assistant.recognition_language = "en-US" if assistant.sex == "female": # Microsoft Zira Desktop - English (United States) ttsEngine.setProperty("voice", voices[1].id) else: # Microsoft David Desktop - English (United States) ttsEngine.setProperty("voice", voices[2].id) else: assistant.recognition_language = "ru-RU" # Microsoft Irina Desktop - Russian ttsEngine.setProperty("voice", voices[0].id) def play_voice_assistant_speech(text_to_speech): """ Проигрывание речи ответов голосового ассистента (без сохранения аудио) :param text_to_speech: текст, который нужно преобразовать в речь """ ttsEngine.say(str(text_to_speech)) ttsEngine.runAndWait() def record_and_recognize_audio(*args: tuple): """ Запись и распознавание аудио """ with microphone: recognized_data = "" # регулирование уровня окружающего шума recognizer.adjust_for_ambient_noise(microphone, duration=2) try: print("Listening. ") audio = recognizer.listen(microphone, 5, 5) with open("microphone-results.wav", "wb") as file: file.write(audio.get_wav_data()) except speech_recognition.WaitTimeoutError: print("Can you check if your microphone is on, please?") return # использование online-распознавания через Google # (высокое качество распознавания) try: print("Started recognition. ") recognized_data = recognizer.recognize_google(audio, language="ru").lower() except speech_recognition.UnknownValueError: pass # в случае проблем с доступом в Интернет происходит # попытка использовать offline-распознавание через Vosk except speech_recognition.RequestError: print("Trying to use offline recognition. ") recognized_data = use_offline_recognition() return recognized_data def use_offline_recognition(): """ Переключение на оффлайн-распознавание речи :return: распознанная фраза """ recognized_data = "" try: # проверка наличия модели на нужном языке в каталоге приложения if not os.path.exists("models/vosk-model-small-ru-0.4"): print("Please download the model from:\n" "https://alphacephei.com/vosk/models and unpack as 'model' in the current folder.") exit(1) # анализ записанного в микрофон аудио (чтобы избежать повторов фразы) wave_audio_file = wave.open("microphone-results.wav", "rb") model = Model("models/vosk-model-small-ru-0.4") offline_recognizer = KaldiRecognizer(model, wave_audio_file.getframerate()) data = wave_audio_file.readframes(wave_audio_file.getnframes()) if len(data) > 0: if offline_recognizer.AcceptWaveform(data): recognized_data = offline_recognizer.Result() # получение данных распознанного текста из JSON-строки # (чтобы можно было выдать по ней ответ) recognized_data = json.loads(recognized_data) recognized_data = recognized_data["text"] except: print("Sorry, speech service is unavailable. Try again later") return recognized_data if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() # инициализация инструмента синтеза речи ttsEngine = pyttsx3.init() # настройка данных голосового помощника assistant = VoiceAssistant() assistant.name = "Alice" assistant.sex = "female" assistant.speech_language = "ru" # установка голоса по умолчанию setup_assistant_voice() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) # отделение комманд от дополнительной информации (аргументов) voice_input = voice_input.split(" ") command = voice_input[0] if command == "привет": play_voice_assistant_speech("Здравствуй") На самом деле, здесь бы хотелось самостоятельно научиться писать синтезатор речи, однако моих знаний здесь не будет достаточно. Если вы можете подсказать хорошую литературу, курс или интересное документированное решение, которое поможет разобраться в этой теме глубоко — пожалуйста, напишите в комментариях.
Шаг 3. Обработка команд
Теперь, когда мы «научились» распознавать и синтезировать речь с помощью просто божественных разработок наших коллег, можно начать изобретать свой велосипед для обработки речевых команд пользователя 😀
В моём случае я использую мультиязычные варианты хранения команд, поскольку у меня в демонстрационном проекте не так много событий, и меня устраивает точность определения той или иной команды. Однако, для больших проектов я рекомендую разделить конфигурации по языкам.
Для хранения команд я могу предложить два способа.
1 способ
Можно использовать прекрасный JSON-подобный объект, в котором хранить намерения, сценарии развития, ответы при неудавшихся попытках (такие часто используются для чат-ботов). Выглядит это примерно вот так:
config = < "intents": < "greeting": < "examples": ["привет", "здравствуй", "добрый день", "hello", "good morning"], "responses": play_greetings >, "farewell": < "examples": ["пока", "до свидания", "увидимся", "до встречи", "goodbye", "bye", "see you soon"], "responses": play_farewell_and_quit >, "google_search": < "examples": ["найди в гугл", "search on google", "google", "find on google"], "responses": search_for_term_on_google >, >, "failure_phrases": play_failure_phrase > Такой вариант подойдёт тем, кто хочет натренировать ассистента на то, чтобы он отвечал на сложные фразы. Более того, здесь можно применить NLU-подход и создать возможность предугадывать намерение пользователя, сверяя их с теми, что уже есть в конфигурации.
Подробно этот способ мы его рассмотрим на 5 шаге данной статьи. А пока обращу ваше внимание на более простой вариант
2 способ
Можно взять упрощенный словарь, у которого в качестве ключей будет hashable-тип tuple (поскольку словари используют хэши для быстрого хранения и извлечения элементов), а в виде значений будут названия функций, которые будут выполняться. Для коротких команд подойдёт вот такой вариант:
commands =
Для его обработки нам потребуется дополнить код следующим образом:
def execute_command_with_name(command_name: str, *args: list): """ Выполнение заданной пользователем команды с дополнительными аргументами :param command_name: название команды :param args: аргументы, которые будут переданы в функцию :return: """ for key in commands.keys(): if command_name in key: commands[key](*args) else: pass # print("Command not found") if __name__ == "__main__": # инициализация инструментов распознавания и ввода речи recognizer = speech_recognition.Recognizer() microphone = speech_recognition.Microphone() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() os.remove("microphone-results.wav") print(voice_input) # отделение комманд от дополнительной информации (аргументов) voice_input = voice_input.split(" ") command = voice_input[0] command_options = [str(input_part) for input_part in voice_input[1:len(voice_input)]] execute_command_with_name(command, command_options) В функции будут передаваться дополнительные аргументы, сказанные после командного слова. То есть, если сказать фразу «видео милые котики«, команда «видео» вызовет функцию search_for_video_on_youtube() с аргументом «милые котики» и выдаст вот такой результат:
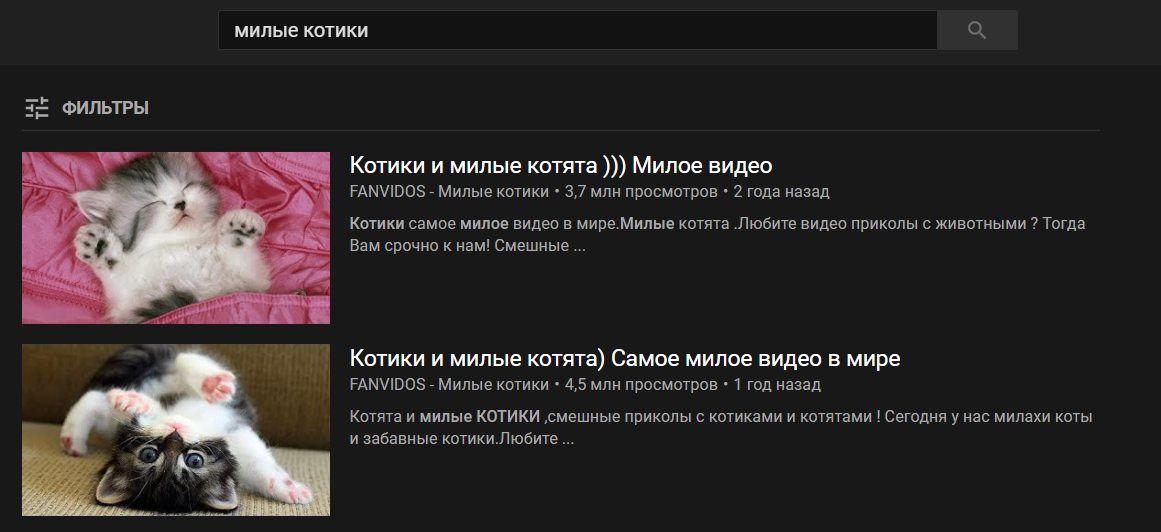
Пример такой функции с обработкой входящих аргументов:
def search_for_video_on_youtube(*args: tuple): """ Поиск видео на YouTube с автоматическим открытием ссылки на список результатов :param args: фраза поискового запроса """ if not args[0]: return search_term = " ".join(args[0]) url = "https://www.youtube.com/results?search_query=" + search_term webbrowser.get().open(url) # для мультиязычных голосовых ассистентов лучше создать # отдельный класс, который будет брать перевод из JSON-файла play_voice_assistant_speech("Here is what I found for " + search_term + "on youtube") Ну вот и всё! Основной функционал бота готов. Далее вы можете до бесконечности улучшать его различными способами. Моя реализация с подробными комментариями доступна на моём GitHub.
Ниже мы рассмотрим ряд улучшений, чтобы сделать нашего ассистента ещё умнее.
Шаг 4. Добавление мультиязычности
Чтобы научить нашего ассистента работать с несколькими языковыми моделями, будет удобнее всего организовать небольшой JSON-файл с простой структурой:
< "Can you check if your microphone is on, please?": < "ru": "Пожалуйста, проверь, что микрофон включен", "en": "Can you check if your microphone is on, please?" >, "What did you say again?": < "ru": "Пожалуйста, повтори", "en": "What did you say again?" >, > В моём случае я использую переключение между русским и английским языком, поскольку мне для этого доступны модели для распознавания речи и голоса для синтеза речи. Язык будет выбран в зависимости от языка речи самого голосового ассистента.
Для того, чтобы получать перевод мы можем создать отдельный класс с методом, который будет возвращать нам строку с переводом:
class Translation: """ Получение вшитого в приложение перевода строк для создания мультиязычного ассистента """ with open("translations.json", "r", encoding="UTF-8") as file: translations = json.load(file) def get(self, text: str): """ Получение перевода строки из файла на нужный язык (по его коду) :param text: текст, который требуется перевести :return: вшитый в приложение перевод текста """ if text in self.translations: return self.translations[text][assistant.speech_language] else: # в случае отсутствия перевода происходит вывод сообщения # об этом в логах и возврат исходного текста print(colored("Not translated phrase: <>".format(text), "red")) return text В main-функции до цикла объявим наш переводчик таким образом: translator = Translation()
Теперь при проигрывании речи ассистента мы сможем получить перевод следующим образом:
play_voice_assistant_speech(translator.get( "Here is what I found for <> on Wikipedia").format(search_term)) Как видно из примера выше, это работает даже для тех строк, которые требуют вставки дополнительных аргументов. Таким образом можно переводить «стандартные» наборы фраз для ваших ассистентов.
Шаг 5. Немного машинного обучения
А теперь вернёмся к характерному для большинства чат-ботов варианту с JSON-объектом для хранения команд из нескольких слов, о котором я упоминала в пункте 3. Он подойдёт для тех, кто не хочет использовать строгие команды и планирует расширить понимание намерений пользователя, используя NLU-методы.
Грубо говоря, в таком случае фразы «добрый день«, «добрый вечер» и «доброе утро» будут считаться равнозначными. Ассистент будет понимать, что во всех трёх случаях намерением пользователя было поприветствовать своего голосового помощника.
С помощью данного способа вы также сможете создать разговорного бота для чатов либо разговорный режим для вашего голосового ассистента (на случаи, когда вам нужен будет собеседник).
Для реализации такой возможности нам нужно будет добавить пару функций:
def prepare_corpus(): """ Подготовка модели для угадывания намерения пользователя """ corpus = [] target_vector = [] for intent_name, intent_data in config["intents"].items(): for example in intent_data["examples"]: corpus.append(example) target_vector.append(intent_name) training_vector = vectorizer.fit_transform(corpus) classifier_probability.fit(training_vector, target_vector) classifier.fit(training_vector, target_vector) def get_intent(request): """ Получение наиболее вероятного намерения в зависимости от запроса пользователя :param request: запрос пользователя :return: наиболее вероятное намерение """ best_intent = classifier.predict(vectorizer.transform([request]))[0] index_of_best_intent = list(classifier_probability.classes_).index(best_intent) probabilities = classifier_probability.predict_proba(vectorizer.transform([request]))[0] best_intent_probability = probabilities[index_of_best_intent] # при добавлении новых намерений стоит уменьшать этот показатель if best_intent_probability > 0.57: return best_intent А также немного модифицировать main-функцию, добавив инициализацию переменных для подготовки модели и изменив цикл на версию, соответствующую новой конфигурации:
# подготовка корпуса для распознавания запросов пользователя с некоторой вероятностью # (поиск похожих) vectorizer = TfidfVectorizer(analyzer="char", ngram_range=(2, 3)) classifier_probability = LogisticRegression() classifier = LinearSVC() prepare_corpus() while True: # старт записи речи с последующим выводом распознанной речи # и удалением записанного в микрофон аудио voice_input = record_and_recognize_audio() if os.path.exists("microphone-results.wav"): os.remove("microphone-results.wav") print(colored(voice_input, "blue")) # отделение команд от дополнительной информации (аргументов) if voice_input: voice_input_parts = voice_input.split(" ") # если было сказано одно слово - выполняем команду сразу # без дополнительных аргументов if len(voice_input_parts) == 1: intent = get_intent(voice_input) if intent: config["intents"][intent]["responses"]() else: config["failure_phrases"]() # в случае длинной фразы - выполняется поиск ключевой фразы # и аргументов через каждое слово, # пока не будет найдено совпадение if len(voice_input_parts) > 1: for guess in range(len(voice_input_parts)): intent = get_intent((" ".join(voice_input_parts[0:guess])).strip()) if intent: command_options = [voice_input_parts[guess:len(voice_input_parts)]] config["intents"][intent]["responses"](*command_options) break if not intent and guess == len(voice_input_parts)-1: config["failure_phrases"]() Однако, такой способ сложнее контролировать: он требует постоянной проверки того, что та или иная фраза всё ещё верно определяется системой как часть того или иного намерения. Поэтому данным способом стоит пользоваться с аккуратностью (либо экспериментировать с самой моделью).
Заключение
На этом мой небольшой туториал подошёл к концу.
Мне будет приятно, если вы поделитесь со мной в комментариях известными вам open-source решениями, которые можно внедрить в данный проект, а также вашими идеями касательно того, какие ещё online и offline-функции можно реализовать.
Документированные исходники моего голосового ассистента в двух вариантах можно найти здесь.
P.S: решение работает на Windows, Linux и MacOS с незначительными различиями при установке библиотек PyAudio и Google.
Кстати, тех, кто планирует строить карьеру в IT, я буду рада видеть на своём YouTube-канале IT DIVA. Там вы сможете найти видео по тому, как оформлять GitHub, проходить собеседования, получать повышение, справляться с профессиональным выгоранием, управлять разработкой и т.д.
- голосовой ассистент
- python
- offline
- мультиязычный
- natural language understanding
Создаем собственную Alexa в 20 строках Python
У всех моих друзей есть Alexa, а у меня нет, из-за чего они надо мной смеются. Натерпевшись вдоволь, я решил: “Хватит!”.
Я связался со своей командой, и как только с моих уст прозвучало “Alexa”, кто-то из ребят выкрикнул: “Не покупай Alexa! Создай свою. Это можно сделать в 20 строк кода”.
О чем этот проект?
Его цель — сэкономить деньги и создать собственную Alexa, способную выполнять для вас массу полезных вещей.
Ваша бабушка будет в восторге! Ей ничего не придется делать вручную, достаточно будет голосовых команд, и виртуальный помощник сделает все, что нужно.
Немного терминологии
Модуль/библиотека:
Предопределенный или предварительно написанный кем-то код, который можно бесплатно использовать в своем проекте.
Класс:
Концепция из ООП, которая позволяет группировать код и в некотором смысле является схемой для создания объектов. Классы позволяют использовать код повторно.
Объект:
Экземпляр класса, который можно задействовать для обращения к атрибутам и методам класса.
У Alexa есть две задачи
1. Слушать
Прослушивание команд является основной функциональностью любого виртуального помощника. Команды бывают различные, например: “Алекса, включи музыку” или “Алекса, сколько время?”
Помощник должен прослушать команду, понять ее и выполнить действие.
2. Говорить
Прослушивая и понимая команды, Alexa выполняет определенные действия. В ходе этого процесса она предоставляет голосовую обратную связь.
Реализация этих функций
Нам понадобятся два модуля Python:
- SpeechRecognition.
- Python Text-To-Speech (pyttsx3).
1. SpeechRecognition
Эта библиотека реализует распознавание речи: она помогает помощнику слушать ваши команды, понимать их и выполнять нужные действия.
Любой сторонний продукт нужно так или иначе устанавливать. Для этого выполните в терминале:
pip install SpeechRecognition
После установки можно использовать библиотеку в проекте. В процессе работы с модулем нам понадобятся три важных компонента.
1) Класс Recognizer: это основной класс модуля, который содержит все ключевые функции, нужные для создания приложения распознания речи.
Для начала нужно создать этот класс, а также его объекты:
r = sr.Recognizer()
Здесь r представляет просто произвольное имя, заданное для объекта. В его качестве можно использовать любую допустимую переменную Python.
2) Доступ к микрофону: так как помощнику нужно прослушивать команды, вам потребуется предоставить ему доступ к микрофону устройства. Для этого можно использовать класс Microphone :
# открываем микрофон и начинаем запись
with Microphone() as source:
# выполнение действий - ``source`` - это экземпляр микрофона, #созданный выше
pass
3) Прослушивание речи пользователя: после организации доступа к микрофону останется прописать прослушивание команд. Это можно сделать с помощью метода listen() , предоставляемого классом Recognizer :
# Прослушивает речь пользователя
# Принимает аудио-источник в качестве параметра
r.listen(source)
Таким образом происходит работа с распознаванием речи в Python. Разобравшись с основами этого модуля, можно переходить к следующему.
2. Python Text-To-Speech (pyttsx3)
Это библиотека Text-to-Speech (TTS) для Python 2 и Python 3, которая работает без обращения к интернету и каких-либо задержек.
Поскольку это сторонний модуль, сначала его нужно также установить:
pip install pyttsx3
Теперь с помощью этого модуля ваш помощник обретет дар речи.
Секрет: здесь мы просто преобразуем текст в речь.
Все остальное будет очень легко. Сначала нужно инициализировать модуль pyttsx3 с помощью метода init() и создать его объект. Затем можно использовать его функции для преобразования текста в речь:
engine = pyttsx3.init()
engine.say("Text to Speak Here")
engine.runAndWait()
Здесь say() выполняет основную работу по преобразованию текста в речь, а runAndWait() ожидает, пока модуль закончит проговаривать конкретное предложение, после чего переходит к следующей задаче.
Разобравшись и с этим модулем, пора переходить к самому интересному.
Самое интересное
Мы создадим три разных функции, каждая из которых будет отвечать за одну задачу. Но прежде давайте подготовим шаблонный код.
Шаг 1. Импорт модулей
Это всегда будет первым шагом:
import speech_recognition as sr
import pyttsx3
Шаг 2. Инициализация модулей
Для использования импортированных модулей нужно их инициализировать и создать объекты:
listener = sr.Recognizer()
engine = pyttsx3.init()
voices = engine.getProperty(’voices’)
engine.setProperty(’voice’, voices[1].id)
Здесь listener является объектом класса Recognizer .
Модуль pyttsx3 — это похититель голосов. Он крадет разные голоса и сохраняет их в свойстве voice .
Мужской голос установлен по умолчанию с индексом 0. Нам нужен приятный женский голос. Для его получения мы используем метод getProperty() . Женский голос хранится в индексе 1.
Теперь перейдем далее и создадим методы, которые помогут ассистенту говорить и слушать.
Шаг 3. Создание метода talk() для преобразования текста в речь
def talk(text):
engine.say(text)
engine.runAndWait()
Здесь talk() — это имя метода, который получает параметр text . Текстом может быть любая строка, которую нам нужно преобразовать в речь, чтобы помощник заговорил.
Далее мы просто передаем его в метод say() и вызываем метод runAndWait() через созданный выше объект engine . Принцип действия должен быть вам понятен, потому что вы уже знаете основы pyttsx3 . Теперь ваш помощник получил возможность говорить.
Теперь мы наделим его даром слушать и понимать наши команды, создав для этого метод, который будет обрабатывать распознавание речи.
Шаг 4. Создание метода take_command() для распознавания речи
def take_command():
try:
with sr.Microphone() as source:
print('listening. ')
voice = listener.listen(source)
command = listener.recognize_google(voice)
print(command)
except:
pass
return command
Для обработки возможных ошибок микрофона и прочих мы обертываем его в блок try-except .
Остальное очень похоже на то, что мы делали ранее. Модуль speech recognition предоставляет различные механизмы распознавания речи, которые и делают всю работу. Здесь мы применили механизм от Google, для чего был использован метод recognize_google() из класса Recognizer .
Мы уже на полпути к цели, и основная часть проекта у нас позади.
Как видно из функции выше, распознанная речь сохраняется и возвращается в переменной command . Теперь нужно только проверить, что хранится в этой переменной и выполнить соответствующее действие.
Шаг 5. Создание метода run_alexa() для ответа
def run_alexa():
command = take_command()
print(command)
if 'play' in command:
song = command.replace(’play’, '’)
talk(’playing ' + song)
pywhatkit.playonyt(song)
elif 'time' in command:
time = datetime.datetime.now().strftime(’%I:%M %p’)
talk(’Current time is ' + time)
elif 'who the heck is' in command:
person = command.replace(’who the heck is’, '’)
info = wikipedia.summary(person, 1)
print(info)
talk(info)
elif 'date' in command:
talk(’sorry, I have a headache’)
elif 'are you single' in command:
talk(’I am in a relationship with wifi’)
elif 'joke' in command:
talk(pyjokes.get_joke())
else:
talk(’please say the command again’)
Здесь нужно понять несколько моментов:
1) Получение требуемой части: предположим, что вас преследует навязчивая строчка из песни, и вы решили ее послушать, приказав Alexa: “Play song_name ”. Для этой команды в данном проекте мы просто удаляем слово Play и получаем часть song_name :
song = command.replace('play', '')
Результат мы просто сохраняем в переменной song .
2) pywhatkit.playonyt(): для его использования понадобится установить и импортировать модуль pywhatkit . PyWhatKit — это библиотека Python для отправки сообщений WhatsApp в определенное время, но в ней есть и ряд других функций, которые помогут нам с автоматизацией. Этот модуль предоставляет метод playonyt() , который позволит воспроизводить желаемые песни прямо на YouTube.
Модуль этот тоже сторонний и требует установки:
pip install pywhatkit
И последующего импорта:
import pywhatkit
3) datetime.datetime.now(): для использования этого метода сначала нужно импортировать модуль datetime . Он является встроенным модулем Python, который позволит нам управлять датами и временем. Метод now() возвращает текущее время.
import datetime
4) wikipedia.summary(): для применения этого метода потребуется установить и импортировать модуль Wikipedia. Wikipedia — это библиотека Python, предоставляющая возможность доступа и парсинга данных из Википедии. Она поможет нам находить нужную информацию и возвращать ее в качестве вывода. Метод summary() запрашивает данные из сводного раздела этого ресурса.
Опять же, это сторонний модуль, который нужно установить:
pip install wikipedia
import wikipedia
5) pyjokes.get_joke(): для использования этого метода нужно установить и импортировать модуль Pyjokes. Он позволит генерировать случайные однострочные шутки для программистов, которые помощник сможет обработать.
Этот сторонний модуль мы также устанавливаем:
pip install pyjokes
import pyjokes
Аналогичным образом можно добавить и другие библиотеки, расширив возможности помощника.
В функции выше сначала происходит вызов метода talk_command() , который начинает прослушивать команды и сохранять их в переменной command :
command = take_command()
print(command)
Помимо этого, чтобы помощник заговорил, мы вызываем метод talk() и передаем ему нужные данные.
Шаг 6. Начальный вызов функции
while True:
run_alexa()
В завершении мы вызываем метод run_alexa() , который запускает нашего помощника.
Теперь у вас есть собственная Alexa!
Аналогичным образом, обладая минимальными навыками работы с Python и используя другие модули, можно добавлять дополнительные возможности, сделав ее не просто умным, но также интересным и красивым виртуальным помощником.
Весь код
import speech_recognition as sr
import pyttsx3
import pywhatkit
import datetime
import wikipedia
import pyjokeslistener = sr.Recognizer()
engine = pyttsx3.init()
voices = engine.getProperty('voices')
engine.setProperty('voice', voices[1].id)def talk(text):
engine.say(text)
engine.runAndWait()def take_command():
try:
with sr.Microphone() as source:
print('listening. ')
voice = listener.listen(source)
command = listener.recognize_google(voice)
print(command)
except:
pass
return commanddef run_alexa():
command = take_command()
print(command)
if 'play' in command:
song = command.replace('play', '')
talk('playing ' + song)
pywhatkit.playonyt(song)
elif 'time' in command:
time = datetime.datetime.now().strftime('%I:%M %p')
talk('Current time is ' + time)
elif 'who the heck is' in command:
person = command.replace('who the heck is', '')
info = wikipedia.summary(person, 1)
print(info)
talk(info)
elif 'date' in command:
talk('sorry, I have a headache')
elif 'are you single' in command:
talk('I am in a relationship with wifi')
elif 'joke' in command:
talk(pyjokes.get_joke())
else:
talk('please say the command again')while True:
run_alexa()
- Создание собственной симуляции активной материи на Python
- Насколько С++ быстрее Python
- 9 Уровней применения функции zip в Python