
SQL-Ex blog
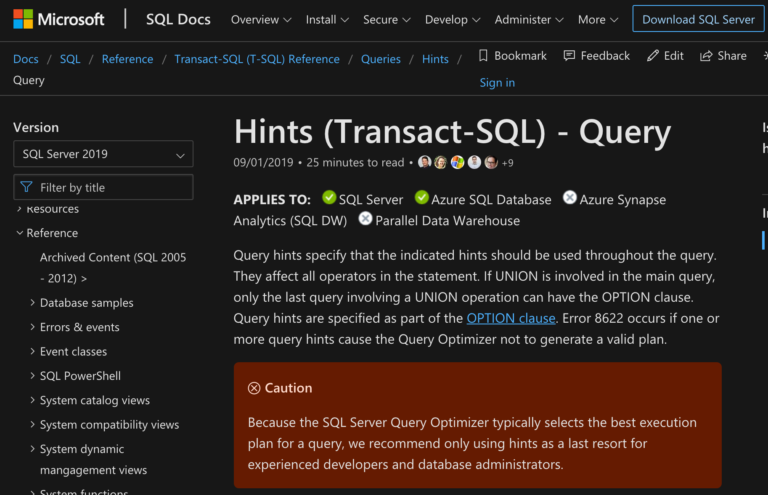
Документация SQL Server содержит довольно крутой список хинтов запросов:
Но что там за цветной ящик? Смотрим.
Поскольку оптимизатор запросов SQL Server обычно выбирает наилучший план выполнения запроса, мы рекомендуем использовать хинты только как последнее средство для опытных разработчиков и администраторов баз данных.
Я мог бы пошутить, но. каждая отдельная вещь в этом предупреждении верна. SQL Server действительно обычно выбирает лучший план выполнения для запроса, примерно 99,999% времени, и вы если вы используете хинт запроса, то вероятно допускаете ошибку.
Однако следует сказать, что если вы читаете этот блог, то вы уже более опытны, чем большинство пользователей SQL Server. Нет, серьезно, я знаю, у вас все хорошо, и что давно пора подумать об использовании нескольких из них, когда ситуация с настройкой запросов становится действительно ужасной.
Подробнее о каждом из них, включая версии, когда они появились, читайте в документации на хинты запросов.
OPTION (MIN_GRANT_PERCENT = 5) или OPTION (MAX_GRANT_PERCENT = 10) — когда планы выполнения ваших запросов запрашивают слишком много (или недостаточно) памяти, а вы уже пытались настроить запросы и индексы, этот хинт является последним полезным средством.
OPTION (FORCE ORDER) — если вы боретесь с планом выполнения, который не вполне понимает, какая из таблиц наиболее селективна или должна быть обработана первой, этот хинт вынуждает SQL Server обрабатывать таблицы в том порядке, в котором они записаны в запросе. Этот хинт мне нравится больше, чем индексные хинты, поскольку он все же предоставляет SQL Server свободу действий при выборе метода доступа к каждой таблице.
OPTION (MAXDOP 0) — если вы уперлись в сервер поставщика третьей стороны, требующего, чтобы вы установили MAXDOP = 1, знали ли вы, что можете установить значение MAXDOP выше для вашего собственного запроса, используя хинт? Хорошо, теперь вы знаете: этот хинт уровня запроса переписывает серверную установку MAXDOP. Замечательно для построения индексов или таблиц для отчетов.
Документация содержит еще много того, что вы определенно не будете использовать часто — но сегодня, похоже, хороший день, чтобы вернуться и посмотреть, какие новые варианты доступны для используемой вами версии SQL Server.
Oracle 12c: опция in-Memory Column Store и технологии кэширования

инструктор УКЦ ФОРС,
Oracle Certified Master
Введение
Версия 12с (12.1.0.1) базы данных компании Oracle появилась несколько лет назад. Основное новшество в этой версии, заявленное при её выходе — Multitenant container database (CDB/PDB). Несколько позже вышло обновление к версии 12c Release 1 (12.1.0.2.0). Ко времени выхода обновленной версии новые возможности 12с были описаны на конференциях пользователей, описаны в white papers, в курсе Oracle University D77758GC10 — Oracle Database 12c: New Features for Administrators, вышедшем в мае 2013 года. Мало кто ожидал, что в обновлении 12c появится что-то новое, так как в предыдущих версиях базы данных сколько-нибудь существенных новшеств в обновлениях не появлялось. Однако, в версии 12.1.0.2.0 появилось новшество, которое может существенно ускорить работу с данными в базе. Опция называется «in-Memory Column Store». Oracle интегрировал в свою базу данных технологии, которые до этого использовались в Oracle TimesTen In-Memory Database. Сейчас и флагманский продукт Oracle имеет функционал In-Memory Database. Появление версии 12c Release 1 прошло не так заметно, как выпуск 12c, и новая технология освещалась не так широко. Oracle University выпустил обновление курса D77758GC20 — Oracle Database 12c: New Features for Administrators, добавив в него главы по новым возможностям версии 12.1.0.2. В этой статье мы рассмотрим использование новой технологии и обзор других возможностей по кэшированию данных, которые появились начиная с версии 11g. Технологии ускорения выполнения команд с помощью кэширования данных в оперативной памяти стали появляться в предыдущих версиях. В 11 версии — SQL Query Result Cache, OCI Client Query Cache и PL/SQL Function Cache. В 12 версии — in-Memory Column Store, Full Database In-Memory Caching и Automatic Big Table Caching. Каждую из этих опций можно использовать отдельно от других опций. Наибольший интерес представляет in-Memory Column Store, её использование прозрачно для приложений и позволяет ускорить работу не только аналитических запросов, но и DML-команд. Опция может применяться и в хранилищах данных и в OLTP-системах.
Кэшрование в Oracle Database 11g
SQL Query Result Cache
SQL Query Result Cache кэширует результат выборки данных в SGA. Результат доступен другим сессиям. Команда, которая использует результат не обязательно должна быть такой же. Например, запрос:
SELECT prod_subcategory, revenue FROM (SELECT /*+ RESULT_CACHE */ p.prod_category, p.prod_subcategory, sum(s.amount_sold) revenue FROM products p, sales s WHERE s.prod_id = p.prod_id AND s.time_id BETWEEN to_date('01-JAN-2006','dd-MON-yyyy') AND to_date('31-DEC-2006','dd-MON-yyyy') GROUP BY ROLLUP(p.prod_category, p.prod_subcategory)) WHERE prod_category = 'Women';
сможет использовать кэшированные данные, если выбирать данные по prod_category = 'Man'. Результат in-line view будет браться из кэша. Также кэш будет наполняться выборками, использующими binding variables, результат будет кэшироваться для каждого набора значений переменных привязки отдельно. Использование этого типа кэширования в OLTP-системах требует аккуратности, так как может привести к замедлению работы. Например, при первом выполнении вышеприведенного запроса оптимизатор не сможет использовать view merging, predicate push-down, column projection. Это может привести к деградации скорости первого выполнения запроса. Замедлением можно было бы пренебречь, но после внесения изменений в таблицы результат кэширования инвалидируется и количество повторных запросов, которые успеют воспользоваться кэшем может быть небольшим. В DSS-системах, обрабатывающих большие объемы данных также есть особенности. На каждом экземпляре RAC кэш приватный и не передается процессам других экземпляров. Параллельные запросы могут заполнять кэш на экземпляре, где работает процесс-координатор, но отдельные параллельные процессы не могут использовать результаты кэширования.
OCI Client Query Cache
Эта опция работает аналогично SQL Query Result Cache, только кэш выделяется на стороне клиента. Может быть полезным для использования на промежуточном уровне — серверах приложений. Эффективен для запросов, часто повторяющихся за короткое время. Например, сотня запросв за несколько секунд. Кэш может использоваться несколькими сессиями, созданными одним процессом в операционной системе клиента. Включить этот тип кэширования можно параметрами инициализации экземпляра базы данных CLIENT_RESULT_CACHE_SIZE, CLIENT_RESULT_CACHE_LAG или параметрами OCI_RESULT_CACHE_MAX_SIZE и OCI_RESULT_CACHE_MAX_RSET_ROWS в файле sqlnet.ora конкретных клиентов.
PL/SQL Function Cache
Эта опция позволяет кэшировать результаты выполнения функций PL/SQL в SGA и использовать для разных сессий. Результат функции должен определяться только параметрами, передаваемыми в неё и данными в таблицах, которые могут использоваться для вычисления результата. В качестве параметров функции и результата не поддерживаются LOBs, REF CURSOR, записи и объектные типы. Наибольшее ускорение работы достигается, если функция обрабатывает данные из таблиц. Для использования этой опции нужно добавить метку в определение пакета или функции:
CREATE OR REPLACE FUNCTION func (emp_no NUMBER) RETURN VARCHAR2 RESULT_CACHE RELIES_ON (emp) IS result VARCHAR2(50); BEGIN SELECT name INTO result FROM emp WHERE empno = emp_no; RETURN result; END;
Эффект от использования этой опции высок. Однако, функций в приложении может быть немного, а подходящих для этой опции функций ещё меньше.
Кэширование в Oracle Database 12с
In-Memory Column Store (IMCS)
- может применяться и с OLTP-системами и в хранилищах данных
- существенное ускорение выполнения произвольных запросов на больших таблицах с любым набором столбцов при отсутствии индексов
- более быстрое выполнение DML-команд за счет отсутствия не нужных для этой опции индексов
- полная прозрачность для приложений, в том числе Oracle e-Business Suite, Siebel
- простота применения, конфигурирования и оценки результата использования
- полная поддержка в RAC и при параллельной обработке без необходимости дублирования содержимого пула в разных экземплярах RAC
- полная поддержка в CDB/PDB
- отсутствие необходимости настройки плана выполнения SQL команд, в случае если все объекты, используемые командой, обслуживаются новой опцией
- нет необходимости перестраивать объекты или менять процедуры резервирования базы данных.
- heap-organized таблицы, наборы их столбцов, секции и подсекции;
- материализованные представления.
Эта опция не обслуживает:
- столбцы LONG, LONG ROW, out-of-line LOB
- объекты небольшого размера (до 64 Кб)
- объекты схемы SYS, располагающиеся в табличных пространствах SYSTEM или SYSAUX
- физические резервные базы данных в режиме Active Data Guard.
Скорость выборки, соединения, фильтрации данных на больших объемах может увеличиться в сотни раз. Использование опции не накладывает ограничения на внесение изменений в таблицы. Скорость операций DML может увеличиться в несколько раз за счет удаления аналитических индексов, которые становятся не нужны для операций выборки, если таблица обслуживается этой опцией.
Тестирование производительности
В статье Query Optimization in Oracle 12c Database In-Memory приведены оценки эффективности использования IM на реально используемых данных объемом 1Тб, размещенных в IM-пуле размером 156Гб с уровнем компрессии 1:7 с рабочей нагрузкой из 32 аналитических запросов на одном экземпляре и 4 экземплярах RAC. При чтении данных с диска среднее время выполнения составило 12037 на одном экземпляре, 12284 на 4-экземплярах с распараллеливанием. При чтении данных из памяти 12011 и 12278 соответственно. При использовании IM-пула 4233 и 4230 соответственно. Без использования IM-опции время выполнения запросов дольше примерно в 3 раза.
На искусственных тестах с выборкой 20 столбцов из одной таблицы SELECT '20 столбцов' FROM tab WHERE столбец < значение:

На соединении таблицы самой с собой SELECT '5 столбцов' FROM tab a, tab b WHERE a.col1 < значение AND a.col50=b.col51:

Механизм работы
Опция не влияет на способ хранения данных в табличных пространствах. Данные хранятся в блоках базы данных в обычном виде. При внесении изменений используется кэш буферов и прямые вставки. Администратор баз данных конфигурирует пул в SGA, в который помещаются данные, которые должна обслуживать новая опция и выборка данных идет из этого пула. Изменения в данные вносятся в блоки таблиц, которые располагаются в кэше буферов. Синхронизация изменений в блоках с данными в новом пуле выполняется автоматически. Новая опция может обслуживать часть таблиц, при этом одна команда SQL может работать с таблицами, использующими новую опцию и не использующими её без деградации производительности.
После выделения нового пула параметром инициализации INMEMORY_SIZE можно указать какие таблицы, столбцы, секции таблиц будут обслуживаться новой опцией. Недостаток этого пула в том, что он не поддерживается опцией ASMM: его размер не подстраивается автоматически и администратор базы данных должен сам указывать его размер.
Новый пул не использует алгоритм LRU при работе с объектами и если в пуле недостаточно места, то объект может частично поместиться в пуле, поэтому администратору нужно следить за свободным местом в пуле. Если запрос не может получить все данные объекта из пула, оставшаяся часть будет выбираться из кэша буферов, флэш-кэша или из файлов табличных пространств. Запрос при этом будет выполнен без ошибки, но время выполнения запроса может увеличиться. Если нужно изменить размер пула, то для инициализации пула придётся перегрузить экземпляр. Новая опция работает в конфигурации CDB/PDB и можно указать объем памяти, который будет использовать объекты для каждой PDB.
Объекты для обслуживания новой опцией могут располагать в пуле только часть столбцов, при этом могут использоваться разные алгоритмы сжатия данных при размещении в пуле, позволяющие достичь компрессии в 2-10 раз. Объем места, занимаемого объектом можно оценить процедурой DBMS_COMPRESSION.GET_COMPRESSION_RATIO. Также можно получить данные по объему памяти в пуле, занимаемому объектами через представление V$IM_SEGMENTS.
Администратор базы данных может решить на основе тех запросов, которые существуют в базе данных какие объекты или их части — столбцы, секции таблиц ввести под обслуживание новой опцией, а какие не вводить. Если большинство запросов к таблицам идут в OLTP-стиле: выборка одной или нескольких строк, то более эффективным является использование индексов и выборка данных из кэша буферов. Если запросы идут в стиле DSS: в выборке используется большое количество строк, соединений с другими таблицами, то использование новой опции будет более эффективным.

Для введение объекта под обслуживание новой опцией можно использовать команду ALTER TABLE tab INMEMORY. При первом обращении к таблице (атрибут PRIORITY=NONE) или при запуске экземпляра базы данных (атрибут PRIORITY=LOW,MEDIUM,HIGH,CRITICAL), из блоков таблицы выбираются строки и размещаются в IM-пуле. В пуле выделяются области памяти, называемые In-Memory Colomn Units (IMCU) экстентами размером 1Мб. Количество IMCU можно получить запросом:
SELECT COUNT(IMCU_ADDR) FROM V$IM_HEADER WHERE IS_HEAD_PIECE=1;
Сколько строк размещено в каждом IMCU можно увидеть в представлении V$IM_HEADER. Распределение памяти IM-пула можно увидеть в представлении V$INMEMORY_AREA. Для одного объекта может быть выделено несколько IMCU, они образуют в пуле in-memory column store segment. Данные из каждого столбца таблицы хранятся слитно. Размер IMCU минимального размера 1Мб, что больше размера блока базы данных (обычно 8-32Кб) и сканирование IMCU более быстро, чем выборка данных из блоков в кэше буферов. Так как один IMCU не может хранить данные из нескольких объектов, то имеет смысл использовать новую опцию с объектами, размер которых не сильно меньше 1Мб. Размер IMCU и количество строк, которое они хранят, выбирается динамически на основе размера таблицы, её структуры и объема свободной памяти в пуле. Данные в IMCU могут помещаться в сжатом виде, который задаётся на уровне объекта, секции, столбца.
В IM-пуле также выделяется память под хранение Transactional Snapshot Metadata Units (SMU) с экстентами размером 64Кб. SMU хранят метаданные об IMCU.
Выделением IMCU занимается фоновый процесс-координатор IMCO, работающий циклами в 2 минуты. Наполнением IMCU данными занимаются фоновые процессы SMCO и Wnnn. Если данные в объектах меняются, то изменения отражаются в SMU на основе тех изменений, которые были внесены в блоки объекта. Записи в IMCU, соответствующие изменившимся строкам помечаются как устаревшие. Процессы IMCO/SMCO/Wnnn выполняют обновление IMCU на основе журнала изменений. Обновление IMCU происходит, если:
- имеется большое количество изменений строк, относящихся к IMCU
- размер журнала изменений вырос
- получено уведомление от других экземпляров RAC.
Если в пуле недостаточно свободного места, то в пуле размещается только часть объекта. При обращении к такому объекту часть данных выбирается из пула, часть из кэша буферов, флэш-кэша или из файлов данных.
Информацию о статусе загрузки данных объекта в IM-пул объекта (STARTED, COMPLETED) можно узнать так:
SELECT SEGMENT_NAME, POPULATE_STATUS, INMEMORY_SIZE, BYTES_NOT_POPULATED FROM V$IM_SEGMENTS;
Работа DML операций
Если на объекте проводится операция DML, то записи в IMCU, затронутые DML-операцией, помечаются как stale в SMU. Данные об изменениях в объекте сохраняются в SMU-части IM-пула и называется журналом изменений. При последующих запросах, которые должны видеть изменившиеся данные, неизменившиеся данные считываются из IMCU, а при выборке stale записей используется журнал изменений или блоки сегмента объекта, в том числе находящиеся в кэше буферов. IM-пул обеспечивает режим целостности по чтению на основе SCN.
Оценить количество stale-записей можно так:
SELECT OBJD, (SUM(INVALID_ROWS)/SUM(TOTAL_ROWS))*100 PCT_INVALID FROM V$IM_SMU_HEAD GROUP BY OBJD ORDER BY 2 DESC;
Stale-записи обрабатывается фоновыми процессами Wnnn. Такая обработка называется trickle repopulation. Процент от общего количества процессов Wnnn, которые будут использоваться только для обработки stale-записей, а не только для формирования IMCU в режимах population и repopulation, устанавливается параметром инициализации INMEMORY_TRICKLE_REPOPULATE_SERVERS_PERCENT. Диапазон значений от 0 до 50, то есть не больше половины всех процессов Wnnn. Общее количество процессов Wnnn устанавливается параметром инициализации INMEMORY_MAX_POPULATE_SERVERS.
Обработка stale-записей после обновлений строк может быть довольно тяжелой операцией, поэтому рекомендуется располагать данные в таблицах, например, путем выбора опций секционирования так, чтобы изменения вносились не по всем блокам таблицы. При большом объеме изменений также рекомендуется выбирать подходящий тип сжатия: MEMCOMPRESS FOR DML. Если объем обновления значений строк в таблице командами UPDATE большой, то, возможно, стоит отказаться от обслуживания столбцов или настраивать количество фоновых процессов Wnnn, выделенных для trickle repopulation параметром инициализации INMEMORY_TRICKLE_REPOPULATE_SERVERS_PERCENT.
Также поддерживаются операции прямой загрузки в таблицы. Прямые вставки в таблицы формируют блоки в сегменте таблицы. Журнал изменений IM-пула не заполняется. После прямой вставки объем данных, который отсутствует в IM-пуле отражается в столбце BYTES_NOT_POPULATED представления V$IM_SEGMENTS. Заполнение IMCU новыми данными будет выполнено процессами Wnnn в режиме, называемом repopulation, по правилам PRIORITY — либо в порядке приоритета, либо после первого обращения к данным, если приоритет не установлен.
DDL операции над объектами, использующими пул работают без ограничений. Команды ALTER TABLE MOVE, SPLIT / MERGE PARTITION приводят к удалению IMCU, затрагиваемых командой. Они начнут создаваться и заполняться в зависимости от свойства PRIORITY: либо при обращении к данным, либо в следующем цикле IMCO в соответствии с приоритетом. Удаление или добавление столбцов в таблице приведет к обновлению (repopulation) соответствующих IMCU.
Параметры инициализации
SQL> show parameter inmem NAME TYPE VALUE ------------------------------------ ----------- ------- inmemory_clause_default string inmemory_force string DEFAULT inmemory_max_populate_servers integer 2 inmemory_query string ENABLE inmemory_size big integer 304M inmemory_trickle_repopulate_servers_ integer 1 percent optimizer_inmemory_aware boolean TRUE
Если нужно, чтобы вновь создаваемые таблицы по умолчанию обслуживались новой опцией с желаемыми параметрами, это можно сделать динамическим параметром инициализации:
ALTER SYSTEM SET INMEMORY_CLAUSE_DEFAULT = "INMEMORY MEMCOMPRESS FOR QUERY LOW PRIORITY CRITICAL NO DUPLICATE";
Также можно указать опции по умолчанию, которые будут устанавливаться для вновь создаваемых таблиц, если при их создании явно указать опцию INMEMORY:
ALTER SYSTEM SET INMEMORY_CLAUSE_DEFAULT = "MEMCOMPRESS FOR QUERY LOW";
Также можно установить это значение на уровне сессии командой ALTER SESSION.
Также можно установить опции на уровне табличного пространства, которые будут использоваться по умолчанию для объектов, создаваемых в этом табличном пространстве:
ALTER TABLESPACE tbs INMEMORY MEMCOMPRESS FOR CAPACITY HIGH PRIORITY LOW;
Динамическим параметром inmemory_force можно отключить опцию. У этого параметра два значения: DEFAULT и OFF. Установка значения в OFF очищает IM-пул.
Если нужно отключить только использование опции для выполнения запросов без очистки IM-пула и изменения работы фоновых процессов, то это можно сделать на уровне сессии или системы (всех экземпляров) динамическим параметром inmemory_query. У этого параметра инициализации два значения ENABLE и DISABLE.
Параметр inmemory_max_populate_servers по умолчанию устанавливается на основе количества процессоров или размера PGA_AGGEGATE_TARGET.
Также имеется большое количество параметров, контролирующих работу IM. Посмотреть их можно так:
set linesize 1000 set pagesize 50000 SELECT KSPPINM, KSPPDESC FROM x$ksppi WHERE KSPPINM LIKE '%inmem%';
Оценка эффективности применения с помощью in-Memory Advisor
Для оценки того, какие объекты имеет смысл ввести под обслуживание новой опцией, можно использовать in-Memory Advisor, который входит в лицензию на Database Tuning Pack. Скачать набор скриптов для установки этого адвайзера можно по ссылке со страницы документа технической поддержки 1965343.1 Адвайзер может быть установлен на базы данных начиная с версии 11.2.0.3, что может помочь оценить возможность использования IM-пула перед миграцией на версию 12c.
Адвайзер захватит рабочую нагрузку, которая есть на базе данных, выделит из неё аналитические запросы из общей активности на базе данных на основе SQL plan cardinality, использования parallel query, повторяемости запросов и других характеристик. Также можно использовать SQL Tuning Sets, данные по рабочей нагрузке из AWR (в AWR сохраняются не все аналитические запросы, а только топовые).
Адвайзер выдаёт отчёт в формате HTML с рекомендуемым размером IM-пула, списком таблиц, которые можно разместить в IM-пуле, параметры компрессии для них и оценку прироста производительности. Также генерируется sql-скрипт c набором команд ALTER TABLE . INMEMORY . которым можно применить рекомендации в 12с.
Пример отчёта. Красным прямоугольником выделено суммарное время выполнения команд, которые были проанализированы, синим время запросов, которые адвайзер отнёс к аналитическим и по которым сформировал результат анализа:

После реализации рекомендаций можно будет использовать SQL Performance Analyzer для практической проверки рекомендаций.
Ввод объектов под обслуживание IMCS
В командах создания объекта CREATE или изменения ALTER можно указать опцию INMEMORY или NO INMEMORY. Опционально можно задать следующие опции:
-
Приоритет, в соответствии с которым, данные объекта помещаются в IM-пул.
- дублирования IMCU на экземплярах RAC. Эта опция работает только на программно-аппаратных комплексах Oracle Exadata, Oracle SuperCluster и т.п. и игнорируется на остальных системах.
- NO DUPLICATE: IMCU не дублируются на экземплярах RAC
- DUPLICATE: IMCU зеркалируются на один из экземпляров. В случае падения/остановки одного из экземпляров RAC это поможет уменьшить влияние падения/остановки экземпляра на работоспособность новой опции.
- AUTO (значение по умолчанию): данные объекта распределяются между IM-пулами экземпляров в зависимости от свойств объекта
- BY PARTITION или BY SUBPARTITION
- BY ROWID RANGE
- Oracle Database In-Memory: In-Memory Aggregation
Oracle Whitepaper, январь 2015 - Oracle Database In-Memory Advisor Best Practices
Oracle Whitepaper, февраль 2015 - Oracle Database In-Memory
Oracle Whitepaper, июль 2015 - Oracle Database In-Memory Advisor
Oracle Whitepaper, 2015 - Oracle Database In-Memory Configuration, Population & Querying
Maria Colgan, Master Product Manager, Oracle, 2014 - Oracle Database In-Memory & The Optimizer
Maria Colgan, Master Product Manager, Oracle, 2014 - Oracle In-Memory Database
Calgary Oracle Users Group, 11 декабря 2014 - Query Optimization in Oracle 12c Database In-Memory
Dinesh Das, Jiaqi Yan, Mohamed Zait, Satyanarayana R Valluri, Nirav Vyas, Ramarajan Krishnamachari, Prashant Gaharwar, Jesse Kamp, Niloy Mukherjee // Proceedings of the VLDB Endowment, Vol. 8, No. 12 - In-Memory Series
Hatem Mahmoud Oracle's Blog, 23 декабря 2015 - Запрос не использует индексы.
- Соединение устанавливается не по правильным полям.
- Выбираемые данные отбираются слишком поздно.
- Operation Mode(Actual) — текущий режим работы.
- Operation Mode(Requested) — желаемый режим работы.
- Off — Query Store выключен.
- Read Only — режим только чтения, т. е. новые планы не пишутся в память.
- Read Write — чтение и запись планов.
Monitoring
- Data Flush Interval(Minutes) — периодичность в минутах, с которой данные планов записываются на диск, так же в момент записи проверяется достижение предельного объема памяти для Query Store.
- Statistics Collection Interval — определяет длительность временного окна, в течение которого собирается статистика времени выполнения для планов запросов. Чем меньше значение этого интервала, тем чаще будет сохранение статистики, но учтите, что это потребует больше дискового пространства.
Query Store Retention
- Max Size (MB) — объем памяти, отводимый под хранилище запросов. информация хранится непосредственно в базе. Если достигнут предельный объем то хранилище переходит в режим Read Only.
- Query Store Capture Mode — режим записи текущего активного запроса.
- Auto — Записываются соответствующие запросы на основе показателя выполнения и объема потребления ресурсов.
- All — все запросы.
- None — новые запросы не пишутся, только обновляется информация по уже ранее записанным запросам.
- Auto — при достижении потребляемой памяти 90% от максимального объема памяти удаляются самые дешевые и старые запросы, пока объем не снизится до 80%.
- Off — автоматическая очистка не выполняется.
Так же это можно сделать запросом:
ALTER DATABASE
SET QUERY_STORE = ON (OPERATION_MODE = READ_WRITE);Где — это имя базы для которой хотим включить хранилище запросов.
После включения хранилища запросов в дереве объектов нашей базы появится соответствующая папка Query Store:

Которая содержит следующие варианты срезов:
- Regressed Queries — запросы, по которым показатели ухудшились.
- Overall Resource Consumption — общее потребление ресурсов для базы в целом.
- Top Resource Consuming Queries — самые затратные запросы.
- Queries With Forced Plans — запросы по которым используется принудительное использование форсированных планов.
- Queries With High Variation — запросы, по которым высокий разброс показателей производительности.
- Tracked Queries — монитор показателей выбранных запросов.
Настраиваем использование Force plan
Возьмем пример с периодическим регистром сведений «Цены номенклатуры». Ранее мы разобрались, что в зависимости от первоочередности запроса кэшировался первый или второй план. Давайте форсируем оптимальный план для обоих случаев и посмотрим, что получится.
После включения Query Store выполним оба запроса с очисткой кэша ещё раз и найдем наш запрос в хранилище запросов.
План запроса для 999000 записей:

План запроса для 1000 записей:

Сформировалось два плана, как и ожидалось: 6132404 и 6132420.
Теперь форсируем план, который использует Clustered Index Scan, т. к. его применение вернет результат за приемлемое время на любом объеме выборки в отличии от второго плана.
Для этого нажимаем Force Plan и у нашего плана появляется признак закрепления:

Теперь проверим в Extended Events какой план будет выполняться по различным параметрам запроса с очисткой кэша:


Как видим, для любых входных параметров будет использоваться закрепленный план.
Да, можно сказать, что для 1000 записей план не оптимален, но мы будем точно уверены, что не получим зависаний у пользователя на 40 минут.
Как будет вести себя PostgreSQL в аналогичной ситуации
В теории
Кэширование в системе управления базами данных PostgreSQL устроено иначе, чем в MSSQL Server. Как такового понятия процедурного кэша в данной СУБД не существует.
Этапы выполнения запроса в PostgreSQL
Каждый запрос, даже если он повторяется из раза в раз, проходит все перечисленные этапы заново:
- Разбор
- Синтаксический разбор текста запроса.
Текст запроса разбирается на лексемы и представляется в виде дерева. - Семантический анализ.
Определяется на какие объекты базы данных ссылается данный запрос и есть ли у пользователя доступ к ним.
Такой подход имеет ряд как недостатков, так и преимуществ:
- С одной стороны, при повторении одного и того же запроса он будет полностью разбираться каждый раз заново.
- С другой стороны, глобальный кэш обычно становится узким местом из-за необходимости блокировок, и сеансы, выполняющие множество мелких команд, могут повлиять на производительность всего экземпляра сервера.
Оптимизация построения планов планировщиком
Если построение не требует больших вычислений, оптимизатор запросов будет перебирать все возможные варианты планов, чтобы в итоге выбрать тот, который должен выполниться быстрее остальных.
Но в ситуациях, когда рассмотрение всех возможных вариантов выполнения запросов занимает слишком много времени и памяти, планировщик запросов в PostgreSQL имеет ряд особенностей для ускорения и «удешевления» построения плана.
Например, такие оптимизации имеют место при выполнении запросов с большим количеством операций соединения. Чтобы выбрать разумный (но не обязательно наилучший) план запроса за приемлемое время, PostgreSQL использует генетический оптимизатор запросов, когда количество соединений превышает некоторый предел. Более подробно об этом можно прочитать в документации (https://postgrespro.ru/docs/postgrespro/14/planner-optimizer).
Предварительная подготовка запроса
В том случае, когда нам все же необходимо запомнить дерево разбора запроса, это можно сделать, подготавливая запрос командой PREPARE.
Подготовка запроса (https://postgrespro.ru/docs/postgrespro/14/sql-prepare) разбирает и трансформирует его обычным образом, но полученное дерево разбора сохраняется в памяти сеанса. При последующем выполнении команды EXECUTE подготовленный оператор планируется и исполняется. Такое разделение труда исключает повторный разбор запроса, при этом позволяет выбрать наилучший план выполнения в зависимости от определенных значений параметров. Более подробно мы уже рассказывали о данном механизме в сравнении с MSSQL в статье об очистке процедурного кэша.
Отмечу лишь то, что из-за отсутствия глобального кэша, даже если запрос уже был разобран одним сеансом, другой будет вынужден разобрать его заново. Поэтому, при использовании 1С в связке с postgres, данный механизм, на наш взгляд, не является приоритетным.
Варианты не «из коробки»
Для PostgreSQL написано достаточно большое количество различных плагинов и расширений. И если нас не устраивает время работы планировщика/оптимизатора запросов, то тут стоит упомянуть такие расширения, как:
- Adaptive Query Optimizer (https://github.com/postgrespro/aqo) — расширение, которое дает обратную связь планировщику от реального выполнения запроса, по результатам которого, планировщик корректирует свои планы в будущем.
- Pg_hint_plan (https://github.com/ossc-db/pg_hint_plan) — расширение, которое позволяет управлять планом выполнения запроса с помощью специальных указаний, записываемых в комментариях.
Из вышеописанного поведения планировщика запросов в PostgreSQL можем сделать вывод, что проблемы с переиспользованием неоптимального для текущего набора параметров плана запроса, которая порой наблюдается при включенном механизме parameter sniffing в MSSQL, не должно происходить.
На практике
Проверим на практическом примере, как PostgreSQL справляется с построением планов запросов и их исполнением для одинаковых запросов с разным значением передаваемых параметров.
Для проведения эксперимента будем использовать тестовую копию базы «1С:УНФ 8. Управление предприятием общепита», в которой проводилось расследование в первой части статьи.
Базу развернем на виртуальной машине под управлением Ubuntu 20.04 в связке с 1С 8.3.20.1710 и PostgreSQL 14. План эксперимента будет следующий:
- Настроить сбор логов технологического журнала 1С на события выполнения запросов в СУБД с выводом планов запросов.
- Воспроизвести ситуацию с выполнением запроса, который был виновником ситуации с неоптимальным переиспользованием планов в первой части статьи.
- Воспроизвести выполнение того же самого запроса, но с меньшим количеством данных.
- Сравнить полученные планы запросов.
Настройка сбора логов
Для начала создадим каталог, в который 1С будет собирать логи технологического журнала:
mkdir -p /var/log/log_tj
Далее нам необходимо назначить пользователя, от имени которого запущен сервер 1С владельцем созданной директории:
chown usr1cv8 /var/log/log_tj
После этого создаем/открываем существующий файл настроек сбора логов, например, при помощи nano:
nano /opt/1cv8/conf/logcfg.xml
Настраиваем сбор на события DBPOSTGRS, которое фиксирует исполнение операторов SQL в postgres, а также SDBL, которое фиксирует исполнение запросов к модели базы данных платформы 1С. Также не забываем указать необходимость сбора планов запросов при помощи тега plansql:
После выполненных действий необходимо убедиться, что в каталоге сбора логов создаются подкаталоги по именам процессов:
ls /var/log/log_tj

Воспроизведение проблемного запроса
Нам известно, что проблемный запрос исполняется при обращении к остаткам при заполнении производственных таблиц фактическим количеством в документах «Выпуск блюд» и «Инвентаризация товаров». Текст запроса до оптимизаций приведен ниже:

Корнем длительного выполнения в MSSQL было использование одного и того же плана запроса при разном количестве строк во временной таблице ВТ_ОстаткиТоваров.
Возьмем два документа «Выпуск блюд». В одном будет готовиться всего несколько блюд, а в другом несколько сотен блюд. В каждом из этих документов выполним заполнение производственных таблиц:

Заполнение производства выполняем со включенным сбором логов технологического журнала 1С. После чего останавливаем его, переименовав файл настроек:
mv /opt/1cv8/conf/logcfg.xml /opt/1cv8/conf/_logcfg.xml
И проверим наличие собранных логов при помощи команды tree:

Анализ логов и просмотр планов запросов
После того, как мы собрали логи технологического журнала, нам необходимо найти событие DBPOSTGRS, соответствующее запросу к остаткам при заполнении производства и проанализировать планы выполнения данного запроса.
Для этого, нам необходимо сопоставить текст запроса в 1С с текстом запроса в postgres. Воспользуемся обработкой, которая выводит структуру хранения метаданных и найдем в ней имена интересующих нас таблиц, а именно регистра накопления «Запасы»:

И регистра сведений «УОП_ОбработкаСырьяПартионная»:

Далее, при большом объеме логов технологического журнала 1С мы можем воспользоваться инструментами bash или же специальными инструментами, например «1С-Рарус: СОК (анализ лога технологического журнала)».
В нашем случае, мы собирали логи точечно и объем совсем небольшой, поэтому просто попробуем выполнить поиск по имени таблиц регистров:

В результате нашли 2 события DBPOSTGRS с искомым текстом запроса и 2 события SDBL для все того же запроса:

Первый найденный запрос соответствует первому заполнению производственных таблиц в документе «Выпуск блюд» с несколькими строчками приготовляемых блюд, а второй соответственно принадлежит большому выпуску.
План запроса лог технологического журнала собирает ровно в таком же виде, как он выводится командой EXPLAIN ANALYZE:

Производить анализ в текстовом виде неудобно, существует несколько неплохих сторонних инструментов визуализации, например, explain.tensor.ru. Воспользуемся данным инструментом и взглянем на собранные планы запроса.
В первом случае, когда временная таблица остатков содержит небольшое количество записей, видим следующий план запроса:

Оптимизатор выбрал план запроса, в котором соединение временной таблицы остатков с таблицей регистра сведений выполняется оператором nested loops.
А вот для второго плана для запроса с большим количеством записей во временной таблице остатков оптимизатор уже подбирает другой, более оптимальный с его точки зрения план с использованием оператора hash join для соединения таблиц:

Какой вывод можно сделать из увиденного? Оптимизатор запросов в postgres выбирает разные планы запросов для одного и того же запроса с разными значениями параметров исходя из имеющейся у него статистической информации и алгоритмов подбора планов.
В целом, теория подтверждается практикой, ведь PostgreSQL не имеет глобального кэша запросов и без дополнительной настройки будет каждый раз заново строить и выбирать планы запросов. Это является как плюсом, так и минусом, ведь в том числе благодаря этому, а также использованию специальных оптимизационных алгоритмов, описанных выше, разбор запросов обходится относительно «дешево» и никак не влияет на соседние сеансы.
Подведем небольшие итоги
Перво-наперво надо признать, что случаются, да и будут случаться ситуации, когда не будет простого и ясного понимания с чего начать и с чем связано. Эту мысль мы пытаемся провести почти каждый раз 🙂
Второе, если говорить собственно о проблематике, то следует обратить внимание, что «прибить» гвоздиком план бывает не так просто. Вспомните ситуацию, когда оптимизатор платформы преобразовывал guid в секции ВЫБРАТЬ в параметр и придется поискать решение, например, воспользовавшись force plan.
Ну и наконец, следует внимательно изучать тонкости работы с планами и их построением и дальнейшим использованием. Для разных СУБД они совершенно разные. Со своими плюсами и минусами в подходах, но не об этом речь, главное, что они разные и именно это важно для эксперта.
Всем удачи на нелегком пути экспертизы!
Saved searches
Use saved searches to filter your results more quickly
Cancel Create saved search
You signed in with another tab or window. Reload to refresh your session. You signed out in another tab or window. Reload to refresh your session. You switched accounts on another tab or window. Reload to refresh your session.
Коллекция готовых SQL запросов для PostgreSQL по часто возникающим задачам (получение и модификация данных, ускорение запросов, обслуживание БД)
License
rin-nas/postgresql-patterns-library
This commit does not belong to any branch on this repository, and may belong to a fork outside of the repository.
Switch branches/tags
Branches Tags
Could not load branches
Nothing to show
Could not load tags
Nothing to showName already in use
A tag already exists with the provided branch name. Many Git commands accept both tag and branch names, so creating this branch may cause unexpected behavior. Are you sure you want to create this branch?
Cancel Create
- Local
- Codespaces
HTTPS GitHub CLI
Use Git or checkout with SVN using the web URL.
Work fast with our official CLI. Learn more about the CLI.Sign In Required
Please sign in to use Codespaces.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching Xcode
If nothing happens, download Xcode and try again.
Launching Visual Studio Code
Your codespace will open once ready.
There was a problem preparing your codespace, please try again.
Latest commit
Rinat Mukhtarov compress and decompress examples result added
f3a7876 Nov 17, 2023Git stats
Files
Failed to load latest commit information.
Latest commit message
Commit time
October 20, 2023 02:41
June 8, 2023 13:01
November 11, 2023 19:16
November 18, 2023 00:56
November 18, 2023 00:39
March 25, 2023 14:02
August 23, 2023 10:05
September 25, 2023 00:45
January 25, 2023 12:58
November 16, 2023 12:59
March 12, 2023 12:42
July 2, 2023 15:07
January 14, 2022 12:08
January 14, 2022 12:13
December 30, 2022 13:50
November 15, 2023 23:23
November 11, 2023 13:57
November 15, 2023 22:17
March 21, 2019 16:07
August 8, 2022 12:53README.md
�� Коллекция готовых SQL запросов для PostgreSQL
- Валидация и домены
- Как проверить email на валидность?
- Как найти все невалидные email в таблице?
- Как удалить все невалидные email из большой таблицы?
- Как проверить CSS цвет на валидность?
- Как проверить реквизиты компании (ИНН, КПП, ОГРН, ОГРНИП) на валидность?
- Как проверить банковские реквизиты (БИК, расчётный счёт, корреспондентский счёт) на валидность?
- Как проверить СНИЛС на валидность?
- Как проверить номер телефона на валидность?
- Как провалидировать значение поля, только если оно явно указано в UPDATE запросе?
- Как сделать аналог функции group_concat() из MySQL
- Как сделать аналог типа set из MySQL?
- Как сделать аналог функции make_set() из MySQL?
- Как транслитерировать русские буквы на английские?
- Как распарсить CSV строку в таблицу?
- Как загрузить в таблицу большой файл-архив в формате csv.xz ?
- Как определить пол по ФИО (фамилии, имени, отчеству) на русском языке?
- Как заквотировать строку для использования в регулярном выражении?
- Как заквотировать строку для использования в операторе LIKE?
- Как получить записи, которые удовлетворяют условиям из JSON массива?
- Как сравнить 2 JSON объекта и получить отличия?
- Агрегатная функция конкатенации (объединения) массивов
- Как получить одинаковые элементы массивов (пересечение массивов)?
- Как получить уникальные элементы массива или отсортировать их?
- Как получить отличающиеся элементы двух массивов?
- Как сделать внешний ключ на элементы массива?
- Как найти список строк, совпадающих со списком шаблонов?
- Как получить названия сущностей по поисковой фразе с учётом начала слов (поисковые подсказки)?
- Как для слова с опечаткой (ошибкой) получить наиболее подходящие варианты слов для замены (исправление опечаток)?
- Как получить список названий предков и наследников для каждого узла дерева (на примере регионов)?
- Как получить циклические связи в графе?
- Как защититься от циклических связей в графе?
- Как получить названия всех уровней сферы деятельности 4-го уровня?
- Как посмотреть на план выполнения запроса (EXPLAIN) в наглядном графическом виде?
- Как ускорить SELECT запросы с тысячами значений в IN(. )?
- Как использовать вывод EXPLAIN запроса в другом запросе?
- Как ускорить SELECT запрос после переезда с PostgreSQL v10 на v12?
- Как ускорить SELECT COUNT(*) запрос?
- Как выполнить функцию N тысяч раз и измерить скорость выполнения?
- Как добавить или обновить записи одним запросом (UPSERT)?
- Как сделать INSERT . ON CONFLICT . без увеличения последовательности для дубликатов?
- Как модифицировать данные в нескольких таблицах и вернуть id затронутых записей в одном запросе?
- Как модифицировать данные в связанных таблицах одним запросом?
- Как добавить запись с id, значение которого нужно сохранить ещё в другом поле в том же INSERT запросе?
- Как сделать несколько последующих запросов с полученным при вставке id из первого запроса?
- Как не обновлять запись, если данные из UPDATE запроса и в БД совпадают?
- Как обновить запись так, чтобы не затереть чужие изменения, уже сделанные кем-то?
- Как обновить несколько записей разными данными в одном запросе?
- Как обновить или удалить миллионы записей в таблице не блокируя все записи и не нагружая БД?
- Как удалить десятки тысяч записей в таблице не блокируя все записи и не нагружая БД?
- Как для одной сущности сделать ограничение на количество вставляемых зависимых сущностей?
- Как сделать журналирование изменений таблицы?
- Как сделать автоматически обновляемое поле updated_at ?
- Как добавить колонку в существующую таблицу без её блокирования?
- Как добавить ограничение таблицы, если оно ещё не существует?
- Как изменить ограничение внешнего ключа без блокирования таблицы?
- Как проверить, что при добавлении или обновлении записи заполнены N полей из M возможных?
- Как из enum типа удалить значение?
- Как найти все упоминания названия объекта БД по всей БД?
- Как изменить тип колонки с int на bigint ?
- Как восстановить значение последовательности, если оно отстало?
- Как создать или пересоздать индекс в существующей таблице без её блокирования?
- Как сделать составной уникальный индекс, где одно из полей может быть null?
- Как починить сломаный уникальный индекс, имеющий дубликаты?
- Как временно отключить индекс?
- Как сделать компактный уникальный индекс на текстовое поле?
- Как получить список процессов с SQL запросами, выполняющихся сейчас?
- Как остановить или завершить работу процессов?
- Как получить список всех функций БД, включая триггерные процедуры?
- Как получить список всех зависимостей (внешних ключей) между таблицами БД?
- Как получить статистику использования индексов?
- Как получить список установленных расширений (extensions)?
- Как получить список таблиц с размером занимаемого места и примерным количеством строк?
- Как получить список самых ресурсоёмких SQL запросов?
- Как получить список SQL запросов, создающих временные файлы?
- Как получить и изменить значения параметров конфигурации выполнения?
- Как получить все активные в данный момент процессы автовакуумa и время их работы?
- Как узнать, почему время ответа от базы периодически падает?
- Как обезопасить приложение от тяжёлых миграций, приводящих к блокированию запросов?
- Simple index checking
- Как скопировать таблицы из одной базы данных в другую?
- Как выгрузить таблицы из БД?
- Как выгрузить результат SELECT запроса в CSV?
- Как проверить синтаксис SQL кода без его выполнения?
- Как откатить часть транзакции внутри функции или процедуры?
- Как терминировать долгие простаивающие без дела подключения к БД?
- Как терминировать заблокированные одинаковые запросы, образующие очередь?
- Как журналировать DDL команды в таблицу БД?
- Как узнать, какие самые частые действия в таблице совершаются?
- Как узнать отставание реплики?
- Как узнать процент достижения своего максимального значения для последовательностей?
Получение пользовательских данных
Валидация и домены
Как проверить email на валидность?
Домен email.sql (валидация базовая минимальная, но быстрая) и функция is_email.sql (валидация почти по спецификации, но медленная)
Как найти все невалидные email в таблице?
SELECT email FROM person_email WHERE email IS NOT NULL -- skip NULL AND email !~ '^\s*$' -- skip empty (similar NULL for NOT NULL column) NOT( AND octet_length(email) BETWEEN 6 AND 320 -- https://en.wikipedia.org/wiki/Email_address AND email LIKE '_%@_%.__%' -- rough, but quick check email syntax AND is_email(email) -- accurate, but slow check email syntax )
Как удалить все невалидные email из большой таблицы?
Если строк в таблице немного и запрос работает относительно быстро, то подойдёт простой DELETE FROM table_name WHERE . . Если в таблице миллионы строк, то процесс может занятуться надолго. При этом записи в таблице так же заблокируются надолго, а конкурентные запросы на модификацию записей, которые связаны с этой таблицей, выстроятся в очередь. Решение — удалять нужно не всё сразу, а по частям. Пример см. loop_execute
Как проверить CSS цвет на валидность?
Как проверить реквизиты компании (ИНН, КПП, ОГРН, ОГРНИП) на валидность?
Как проверить банковские реквизиты (БИК, расчётный счёт, корреспондентский счёт) на валидность?
Банковский расчётный (клиентский) счёт (р/с)
Банковский корреспонденткий счёт (к/с)
Как проверить СНИЛС на валидность?
Как проверить номер телефона на валидность?
Домен phone.sql для валидации номера телефона в международном формате E.164
- phone_normalize.sql
- phone_parse.sql
- phone_format.sql
- phone_format_record.sql
Как провалидировать значение поля, только если оно явно указано в UPDATE запросе?
Ограничения CHECK() для каждого поля таблицы срабатывают каждый раз при добавлении или обновлении записи таблицы. При добавлении записи всё логично — значение нужно проверить, даже если это значение по-умолчанию. Однако, в запросе на обновление даных даже неважно, изменилось значение поля на самом деле или нет (ну почему так сделано?). Если в CHECK проверка ресурсоёмая, то она может существенно замедлить обновление большого количества записей в таблице. Пример ресурсоёмкой проверки — валидация синтаксиса email функцией is_email() .
Обойти данную проблему можно с использованием триггеров. Предположим, есть таблица person с колонкой email .
CREATE OR REPLACE FUNCTION person_email_check() RETURNS TRIGGER LANGUAGE plpgsql AS $$ BEGIN IF NOT is_email(NEW.email) THEN RAISE EXCEPTION 'Email % is not valid', NEW.email; END IF; RETURN NEW; END; $$; -- добавление DROP TRIGGER IF EXISTS person_email_check_insert ON person_email; CREATE TRIGGER person_email_check_insert BEFORE INSERT ON person FOR EACH ROW WHEN (NEW.email IS NOT NULL AND NEW.email !~ '^\s*$') EXECUTE PROCEDURE person_email_check(); --обновление DROP TRIGGER IF EXISTS person_email_check_update ON person_email; CREATE TRIGGER person_email_check_update BEFORE UPDATE OF email ON person -- поле явно указано в UPDATE запросе! FOR EACH ROW WHEN (NEW.email IS NOT NULL AND NEW.email !~ '^\s*$' AND NEW.email IS DISTINCT FROM OLD.email) -- значение изменилось EXECUTE PROCEDURE person_email_check();
Переезд из MySQL в PostgreSQL
There isn’t anything MySQL can do that PostgreSQL can’t do. However, there are things that PostgreSQL can do that MySQL can’t do. http://mysqltopgsql.com/
Как сделать аналог функции group_concat() из MySQL
SELECT STRING_AGG(DISTINCT s, ', ' ORDER BY s) AS field_alias FROM (VALUES ('b'), ('a'), ('b')) AS t(s); -- a, b SELECT ARRAY_TO_STRING(ARRAY_AGG(DISTINCT s ORDER BY s), ', ') AS field_alias FROM (VALUES ('b'), ('a'), ('b')) AS t(s); -- a, b
Как сделать аналог типа set из MySQL?
Используйте комбинацию перечисляемого типа и массива. Пример:
CREATE TYPE finger_type AS ENUM ('one', 'two', 'three', 'four', 'five'); CREATE TABLE my_table ( fingers finger_type[] CHECK(/*cardinality(fingers) > 0 and*/ cardinality(array_unique(fingers)) = cardinality(fingers) --проверка на уникальность ) );
Как сделать аналог функции make_set() из MySQL?
select to_json(array_agg(name)) from unnest(array['a','b','c', 'd']::text[]) with ordinality as s(name, num) where 10 & (1 (num::int-1)) > 0; select array_agg(name) from unnest(string_to_array('a,b,c,d', ',')) with ordinality as s(name, num) where 10 & (1 (num::int-1)) > 0;
Как транслитерировать русские буквы на английские?
Современные функции транслитерации по правилам библиотеки "Юлия":
- iuliia_translate_mosmetro.sql
- iuliia_translate_wikipedia.sql
Устаревшая функции транслитерации slugify_ru.sql
Как распарсить CSV строку в таблицу?
PostgreSQL умеет читать и писать CSV в файл на сервере БД. А это парсер CSV из строки. Смотри csv_parse.sql
Область применения — массовое добавление и обновление записей в таблицах БД через SQL миграции БД и административные интерфейсы.
select CASE WHEN row[1] ~ '^\d+$' THEN row[1]::integer ELSE NULL END AS id, row[2] AS kladr_id, row[3] AS name from csv_parse($$ id; kladr_id; name 501 ; 8300000000000 ; ";Автономный ;"";округ"" ""Ненецкий"";";unknown 751;8600800000000; " Автономный округ ""Ханты-Мансийский"", Район Советский" ; 1755;8700300000000; Автономный округ Чукотский, Район Билибинский 1725;7501900000000;Край Забайкальский, Район Петровск-Забайкальский ;; 711;2302100000000;Край Краснодарский, Район Лабинский 729;2401600000000;Край Красноярский, Район Иланский 765;2700700000000;Край Хабаровский, Район Вяземский 765;; $$, ';', false) as row;
id kladr_id name kladr_id name 501 8300000000000 ;Автономный ;";округ"\n"Ненецкий"; 751 8600800000000 Автономный округ "Ханты-Мансийский" 1755 8700300000000 Автономный округ Чукотский 1725 7501900000000 Край Забайкальский 711 2302100000000 Край Краснодарский 729 2401600000000 Край Красноярский 765 2700700000000 Край Хабаровский 765 Как загрузить в таблицу большой файл-архив в формате csv.xz ?
Воспользуйтесь утилитой psql . Особенность мета-команды \copy в том, что она читает файл из локальной файловой системы и пересылает его на сервер на вход SQL команде COPY .
\copy test.regions from program 'xzcat regions.csv.xz' with (format csv, header false);
Как определить пол по ФИО (фамилии, имени, отчеству) на русском языке?
Как заквотировать строку для использования в регулярном выражении?
Как заквотировать строку для использования в операторе LIKE?
Как получить записи, которые удовлетворяют условиям из JSON массива?
SELECT * FROM ( VALUES ('[, ]'::jsonb), ('[, ]'::jsonb) ) AS t WHERE EXISTS( SELECT * FROM jsonb_to_recordset(t.column1) AS x(id int, created_at timestamp, name text) WHERE x.id IN (1, 3) AND x.created_at > '2000-01-01' AND name NOT LIKE 'P%' )
Как сравнить 2 JSON объекта и получить отличия?
Агрегатная функция конкатенации (объединения) массивов
Как получить одинаковые элементы массивов (пересечение массивов)?
-- для 2-х массивов select array_agg(a) from unnest(array[1, 2, 3, 4, 5]) a where a = any(array[4, 5, 6, 7, 8]); -- -- для N массивов select array_agg(a1) from unnest(array[1, 2, 3, 4, 5]) a1 inner join unnest(array[3, 4, 5, 6, 7]) a2 on a1 = a2 inner join unnest(array[4, 5, 6, 7, 8]) a3 on a1 = a3; --
Как получить уникальные элементы массива или отсортировать их?
Для int[] лучше воспользоваться готовыми функциями uniq() и sort() из модуля intarray.
-- способ 1 SELECT ARRAY_AGG(DISTINCT a ORDER BY a) FROM UNNEST(ARRAY[1,2,3,2,1]) t(a); -- -- способ 2 SELECT ARRAY(SELECT DISTINCT UNNEST(ARRAY[1,2,3,2,1]) ORDER BY 1); -- -- готовая функция CREATE FUNCTION array_unique(anyarray) RETURNS anyarray AS $$ SELECT array_agg(DISTINCT x ORDER BY x) FROM unnest($1) t(x); $$ LANGUAGE SQL IMMUTABLE;
Как получить отличающиеся элементы двух массивов?
create or replace function array_diff(anyarray, anyarray) returns anyarray language sql as $$ select array( select * from (select unnest($1) as element) t where element not in (select unnest($2)) ); $$; -- поведение одинаковое с одноимённой функцией на PHP select array_diff(array[2, 4, 7, 8], array[1, 2, 3, 4, 5]); --
Как сделать внешний ключ на элементы массива?
Нельзя использовать колонку-массив для хранения элементов, значения которых ссылаются на значения колонки из другой таблицы по внешнему ключу (FK). Это не соответствует первой нормальной форме в реляционной модели данных. Необходимо использовать дополнительную таблицу в отношении "один ко многим". Так же в этом случае для поддержки целостности данных по внешним ключам и исключению дубликатов доступны штатные механизмы.
Однако, технически это возможно. Ниже пример проверки значений массива без триггеров. Протестировано на PostgreSQL 10.5. Т.к. FK для массивов делать нельзя, код функции годится как шаблон для разработки сложных ограничений для проверки элементов массива (например ltree).
create schema if not exists test; CREATE OR REPLACE FUNCTION test.check_foreign_key_array(data anyarray, ref_schema text, ref_table text, ref_column text) RETURNS BOOL RETURNS NULL ON NULL INPUT LANGUAGE plpgsql AS $body$ DECLARE fake_id text; sql text default format($$ select id::text from unnest($1) as x(id) where id is not null and id not in (select %3$I from %1$I.%2$I where %3$I = any($1)) limit 1; $$, ref_schema, ref_table, ref_column); BEGIN EXECUTE sql USING data INTO fake_id; IF (fake_id IS NOT NULL) THEN RAISE NOTICE 'Array element value % does not exist in column %.%.%', fake_id, ref_schema, ref_table, ref_column; RETURN false; END IF; RETURN true; END $body$; drop table if exists test.t1, test.t2; create table test.t1 ( id integer generated by default as identity primary key ); create table test.t2 ( id integer generated by default as identity primary key, t1_ids integer[] not null check (test.check_foreign_key_array(t1_ids, 'test', 't1', 'id')) ); insert into test.t1 (id) values (default), (default), (default); --ok insert into test.t2 (id, t1_ids) values (default, array[1,2,3]); --ok insert into test.t2 (id, t1_ids) values (default, array[1,2,3,555]); --error
Пример добавления ограничения для типа поля ltree:
alter table region add constraint region_tree_path_ids_check check ( tree_path_ids::text ~ '^\d+(\.\d+)*$|^$' -- список родительских id через точку and check_foreign_key_array(string_to_array(tree_path_ids::text, '.')::int[], 'public', 'region', 'id') ) not valid; --при необходимости
Поиск по фразе (точный и неточный)
Как найти список строк, совпадающих со списком шаблонов?
-- было SELECT * FROM (VALUES ('foo bar zap bing'), ('man foo'), ('bar zap'), ('bing'), ('foo bar')) AS t(words) WHERE words LIKE '%bar%' OR words LIKE '%zap%' OR words LIKE '%fix%' OR words LIKE '%new%'; -- стало SELECT * FROM (VALUES ('foo bar zap bing'), ('man foo'), ('bar zap'), ('bing'), ('foo bar')) AS t(words) WHERE words LIKE ANY (ARRAY['%bar%', '%zap%', '%fix%', '%new%']);
Как получить названия сущностей по поисковой фразе с учётом начала слов (поисковые подсказки)?
CREATE INDEX /*CONCURRENTLY*/ t_name_trigram_index ON t USING GIN (lower(name) gin_trgm_ops); WITH normalize AS ( SELECT ltrim(REGEXP_REPLACE(LOWER('бар '), '[^а-яёa-z0-9]+', ' ', 'gi')) AS query ), vars AS ( SELECT CONCAT('%', REPLACE(quote_like(trim(normalize.query)), ' ', '_%'), '%') AS query_like, --CONCAT('(? CONCAT('\m', REPLACE(quote_regexp(normalize.query), ' ', '(?:[^а-яёa-z0-9]+|$)')) AS query_regexp FROM normalize ) SELECT t.name, lower(t.name) LIKE RTRIM(normalize.query) AS is_leading FROM t, vars, normalize WHERE length(rtrim(normalize.query)) > 0 -- для скорости AND lower(t.name) LIKE vars.query_like -- для скорости AND lower(t.name) ~* vars.query_regexp -- для точности ORDER BY is_leading DESC, LENGTH(name), name LIMIT 100
Как для слова с опечаткой (ошибкой) получить наиболее подходящие варианты слов для замены (исправление опечаток)?
Пример результата запроса
word_num word_from is_mistake can_correct words_to words_details 1 вадитль true true ["водитель"] NULL 2 дифектолог true false ["дефектолог", "директолог", "диетолог"] NULL 3 формовшица true true ["формовщица"] NULL 4 фрмовщица true true ["формовщица"] NULL 5 бхугалтер true true ["бухгалтер"] NULL 6 лктор true true ["лектор"] NULL 7 дикто true true ["диктор"] NULL 8 вра true true ["врач"] NULL 9 прагромист true true ["программист"] NULL 10 затейник false false NULL NULL 11 смотритель false false NULL NULL 12 unknown true false NULL NULL Описание запроса
- Запрос так же подходит для получения поисковых подсказок (с учётом начала слов), если его немного модернизировать. Практики пока нет, а в теории нужно убрать ограничение по дистанции Левенштейна.
- Запрос использует GIN индекс, поэтому работает быстро.
- Среди пользователей, которые делают опечатки, есть те, которые делают грамматические ошибки. Поэтому, при расчёте расстояния Левенштейна, цена вставки и удаления буквы должна быть выше, чем замены. Цены операций являеются целочисленными числами, которые нам не очень подходят, поэтому приходится делать дополнительный расчёт.
- Пороговые значения подобраны опытным путём.
- Если у нескольких кандидатов подряд рейтинг отличается незначительно, то это не точное исправление (автоисправлять нельзя, только предлагать варианты)
Алгоритм исправления ошибок и опечаток основан поиске совпадающих триграмм (учитывается "похожесть" слова) и на вычислении расстояния Левенштейна. Точность исправления слова зависит в т.ч. от количества букв в слове. Получать слова-кандидаты для исправления ошибок необходимо для R > 0.55 и D < 5
Длина слова, букв (L) Максимальная дистанция Левенштейна (D) Доля R = (1 − (D ÷ L)) 2 0 1 3 1 0.6666 4 1 0.75 5 2 0.6 6 2 0.6666 7 3 0.5714 8 3 0.625 9 3 0.6666 10 4 0.6 11 4 0.6363 12 4 0.6666 13 4 0.6923 14 и более 4 0.7142 Деревья и графы
Как получить список названий предков и наследников для каждого узла дерева (на примере регионов)?

SELECT id, nlevel(ltree_path) AS level, ltree_path AS id_path, (SELECT array_agg(st.name ORDER BY nlevel(st.ltree_path)) FROM region AS st WHERE st.ltree_path @> t.ltree_path AND st.ltree_path != t.ltree_path) AS ancestors, name AS self, (SELECT array_agg(st.name ORDER BY nlevel(st.ltree_path)) FROM region AS st WHERE st.ltree_path @ t.ltree_path AND st.ltree_path != t.ltree_path) AS descendants --, t.* FROM region AS t WHERE nlevel(ltree_path) >= 2 ORDER BY nlevel(ltree_path) ASC, ancestors LIMIT 1000;
Как получить циклические связи в графе?
WITH paths_with_cycle(depth, path) AS ( WITH RECURSIVE search_graph(parent_id, child_id, depth, path, cycle) AS ( SELECT g.parent_id, g.child_id, 1, ARRAY[g.parent_id], false FROM custom_query_group_relationship AS g UNION ALL SELECT g.parent_id, g.child_id, sg.depth + 1, path || g.parent_id, g.parent_id = ANY(path) FROM custom_query_group_relationship AS g, search_graph sg WHERE g.parent_id = sg.child_id AND cycle IS FALSE ) SELECT depth, path FROM search_graph WHERE cycle IS TRUE ORDER BY depth ) SELECT DISTINCT path FROM paths_with_cycle WHERE depth = (SELECT MIN(depth) FROM paths_with_cycle)
Как защититься от циклических связей в графе?
SQL-запросы WITH RECURSIVE. должны иметь защиту от зацикливания! Когда запрос зациклится, он будет выполняться очень долго, съедая ресурсы БД. А ещё таких запросов будет много. Повезёт, если сработает защита самого PostgreSQL.
Как получить названия всех уровней сферы деятельности 4-го уровня?
SELECT ot1.name AS name_1, ot2.name as name_2, ot3.name as name_3, ot4.id as id FROM offer_trade ot4 INNER JOIN offer_trade ot3 ON ot4.order_tree @ ot3.order_tree AND nlevel(ot3.order_tree) = 3 INNER JOIN offer_trade ot2 ON ot4.order_tree @ ot2.order_tree AND nlevel(ot2.order_tree) = 2 INNER JOIN offer_trade ot1 ON ot4.order_tree @ ot1.order_tree AND nlevel(ot1.order_tree) = 1
Оптимизация выполнения запросов
Как посмотреть на план выполнения запроса (EXPLAIN) в наглядном графическом виде?
- Человекопонятное отображение EXPLAIN и советы
- Postgres Explain Visualizer (Pev) is a tool I wrote to make EXPLAIN output easier to grok. It creates a graphical representation of the query plan
- PostgreSQL's explain analyze made readable
Как использовать вывод EXPLAIN запроса в другом запросе?
Смотри [ explain_json.sql ](functions/ explain_json.sql)
Как ускорить SELECT запросы c тысячами значений в IN(. )?
Сортировка значений по возрастанию увеличит читабельность кода (TODO: как это повлияет на скорость выполнения запроса?).
-- было SELECT * FROM t WHERE id 1000 AND val IN (1, . 10000); -- стало (способ 1) SELECT * FROM t WHERE id 1000 AND val IN (VALUES (1), . (10000)); -- стало (способ 2) SELECT * FROM t JOIN (VALUES (1), . (10000)) AS t(val) UGING(val) WHERE id 1000; -- стало (способ 3) SELECT * FROM t JOIN UNNEST(ARRAY[1, . 10000]) AS t(val) UGING(val) WHERE id 1000;
Как ускорить SELECT запрос после переезда с PostgreSQL v10 на v12?
-- исходный медленный запрос SELECT id FROM t1 WHERE id NOT IN ( SELECT DISTINCT t2.entity_id FROM t2 WHERE . ); -- ключевое слово MATERIALIZED добавлено только в PostgreSQL 12, а у нас пока 10, поэтому см. следующий запрос WITH t AS MATERIALIZED ( SELECT DISTINCT t2.entity_id FROM t2 WHERE . ) SELECT id FROM t1 WHERE id NOT IN (SELECT entity_id FROM t); -- используем массив вместо колонки SELECT id FROM t1 WHERE id != ALL(ARRAY( --performance workaround for PostgreSQL 12 SELECT DISTINCT t2.entity_id FROM t2 WHERE . ));
Как ускорить SELECT COUNT(*) запрос?
Сценарий использования: SQL запрос, вычисляющий кол-во записей по условию или среднее числовое значение.
Объём данных растёт, а ответ клиенту всегда нужно отдавать очень быстро. Если SQL запрос оптимизиции уже не поддаётся или очень много данных, то его можно ускорить через приближённые вычисления. В таком запросе будет погрешность вычислений. Чем быстрее вычисление, тем больше погрешность. На количествах > 1,000 уже можно использовать приближённые вычисления для задач, требующих немедленного ответа (задачи реального времени). 1,000 или 1,050 - не так важно. При таких значениях у пользователей сохраняется возможность оценки и принятия решения. А в GUI перед значениями, при необходимости, значение можно показывать так: 1,000+ или ≈1,050 или 1 тыс. .
create schema if not exists test; drop table if exists test.count_approximate; create table if not exists test.count_approximate as select md5(i::text) as s from generate_series(1, 10000000) as t(i); create unique index on test.count_approximate (i); select count(*) from ( select from test.count_approximate where s ~ 'aa$' LIMIT 1000 + 1 ) t; --1 row retrieved starting from 1 in 273 ms (execution: 218 ms, fetching: 55 ms) -- если предыдущий запрос вернул -- иначе считаем приближённое количество запией select count(*) * 100 --39200 from test.count_approximate tablesample bernoulli(1) repeatable (37) where s ~ 'aa$'; --1 row retrieved starting from 1 in 528 ms (execution: 489 ms, fetching: 39 ms) select count(*) * 100 --42500 from test.count_approximate tablesample system(1) repeatable (37) where s ~ 'aa$'; --1 row retrieved starting from 1 in 139 ms (execution: 100 ms, fetching: 39 ms) -- PostgreSQL < 9.5 ?select (count(*) filter (where s ~ 'aa$')) * 100 --38300 from test.count_approximate where (i % 100) = 0; --1 row retrieved starting from 1 in 1 s 790 ms (execution: 1 s 767 ms, fetching: 23 ms) -- для сравнения, подсчёт точного кол-ва записей работает медленно: select count(*) --38823 from test.count_approximate where s ~ 'aa$'; --1 row retrieved starting from 1 in 6 s 941 ms (execution: 6 s 899 ms, fetching: 42 ms)
PostgreSQL extension adding HyperLogLog data structures as a native data type.
Как выполнить функцию N тысяч раз и измерить скорость выполнения?
Аналог функции benchmark() в MySQL. Смотри benchmark.sql
Как получить записи-дубликаты по значению полей?
-- через подзапрос с EXISTS этой же таблицы SELECT ROW_NUMBER() OVER w AS duplicate_num, -- номер дубля * FROM person AS d WHERE EXISTS(SELECT FROM person AS t WHERE t.name = d.name -- в идеале на это поле должен стоять индекс -- если нет первичного ключа, замените "id" на "ctid" AND d.id != t.id -- оригинал и дубликаты -- AND d.id > t.id -- только дубликаты ) WINDOW w AS (PARTITION BY name ORDER BY id) ORDER BY name, duplicate_num
-- получить ID записей, имеющих дубликаты по полю lower(name) SELECT id_original, unnest(id_doubles) AS id_double FROM ( SELECT min(id) AS id_original, (array_agg(id order by id))[2:] AS id_doubles FROM skill GROUP BY lower(name) HAVING count(*) > 1 ORDER BY count(*) DESC ) AS t;
-- получить ID записей, НЕ имеющих дубликаты по полю slugify(name) SELECT max(id) AS id FROM region GROUP BY slugify(name) HAVING count(*) = 1;
-- получить разные названия населённых пунктов с одинаковыми kladr_id SELECT ROW_NUMBER() OVER(PARTITION BY kladr_id ORDER BY address ASC) AS duplicate_num, -- номер дубля * FROM ( SELECT kladr_id, unnest(array_agg(address)) AS address FROM d GROUP BY kladr_id HAVING count(*) > 1 ) AS t ORDER BY kladr_id, duplicate_num
Как получить длительность выполнения запроса в его результате?
SELECT extract(seconds FROM clock_timestamp() - now()) AS execution_duration FROM pg_sleep(1.5);
Это работает, потому что now() вычислится ещё на этапе планирования запроса, а clock_timestamp() на этапе выполнения.
Как разбить большую таблицу по N тысяч записей?
Применение: выгрузка из БД большого количества данных примерно одного объёма в каждой пачке. Например, индексирование данных в поисковых движках типа Manticore, Sphinx, Solr, Elastic Search и других. Или выгрузка данных в DWH.
Вариант 1
Способ, когда не нужно заранее вычислять диапазоны id.
SELECT * FROM resume WHERE is_publish_status = TRUE AND is_spam = FALSE AND id > :id --AND use_parallel(id, :core_num, :core_max) -- если нужно распараллелить запрос по ядрам процессора ORDER BY id LIMIT 10000
Обязательное условие — для колонки id должен быть первичный или уникальный индекс и он должен использоваться в плане запроса. Значения id могут быть числовыми или текстовыми. Запрос выполняется в приложении в бесконечном цикле. На первой итерации для числового типа вместо :id подставляем 0 (или другое значение, меньше минимального в таблице); для текстового типа вместо :id подставляем пустое зачение ( '' ). На второй и последующих итерациях вместо :id подставляем id из последней записи последнего результата запроса (это значение будет являться максимальным в рамках результата запроса). На каждой итерации цикла проверяем: если количество возвращёных записей меньше, чем указано в LIMIT, то цикл прерываем. Для распараллеливания запроса используйте функцию use_parallel.sql .
Вариант 2a
Способ, когда нужно заранее вычислять диапазоны id. Этот способ работает медленнее и выглядит сложнее. Но может подойти, если по каким-то причинам первый вариант не подходит (например, когда план запроса упорно не хочет использовать первичный или уникальный индекс по колонке id).
WITH -- отфильтровываем лишние записи и оставляем только колонку id result1 AS ( SELECT id FROM resume WHERE is_publish_status = TRUE AND is_spam = FALSE ), -- для каждого id получаем номер пачки result2 AS ( SELECT id, ((row_number() OVER (ORDER BY id) - 1) / 100000)::integer AS part FROM result1 ) -- группируем по номеру пачки и получаем минимальное и максимальное значение id SELECT MIN(id) AS min_id, MAX(id) AS max_id, -- ARRAY_AGG(id) AS ids, -- список id в пачке, при необходимости COUNT(id) AS total -- кол-во записей в пачке (для отладки, можно закомментировать эту строку) FROM result2 GROUP BY part ORDER BY 1;
Пример результата выполнения
№ min_id max_id total 1 162655 6594323 100000 2 6594329 6974938 100000 3 6974949 7332884 100000 . . . . 83 24276878 24427703 100000 84 24427705 24542589 77587 Далее можно последовательно или параллельно выполнять SQL запросы для каждого диапазона, например:
SELECT * FROM resume WHERE id BETWEEN 162655 AND 6594323 AND is_publish_status = TRUE AND is_spam = FALSE;
Вариант 2b
Если условие в фильтрации данных очень тяжёлое, то лучше выбирать по спискам id для каждого диапазона, например:
--отфильтровываем лишние записи и оставляем только колонку id, для каждого id получаем номер пачки CREATE TABLE _ AS SELECT id, ((row_number() OVER (ORDER BY id) - 1) / 100000)::integer AS part FROM company WHERE is_check_moderator = TRUE AND is_spam = FALSE; --строим индекс для ускорения выборок в последующих запросах CREATE UNIQUE INDEX __uniq ON _ (part, id); --далее можно последовательно или параллельно выполнять SQL запросы для каждого диапазона, например: select * from company as c where id in (select id from _ where part = 0)
Как выполнить следующий SQL запрос, если предыдущий не вернул результат?
-- how to execute a sql query only if another sql query has no results WITH r AS ( SELECT * FROM film WHERE length = 120 ) SELECT * FROM r UNION ALL SELECT * FROM film WHERE length = 130 AND NOT EXISTS (SELECT * FROM r)
Как развернуть запись в набор колонок?
SELECT (a).*, (b).* -- unnesting the records again FROM ( SELECT a, -- nesting the first table as record b -- nesting the second table as record FROM (VALUES (1, 'q'), (2, 'w')) AS a (id, name), (VALUES (7, 'e'), (8, 'r')) AS b (id, name) ) AS t;
Как получить итоговую сумму и процент для каждой записи в одном запросе?
SELECT array_agg(x) over() as frame, x, sum(x) over() as total_sum, round(x * 100 / sum(x) over(), 2) as percent FROM generate_series(1, 4) as t (x);
Как получить возраст по дате рождения?
SELECT EXTRACT(YEAR FROM age('1977-09-10'::date))
Как получить дату или дату и время в формате ISO-8601?
-- format date or timestamp to ISO 8601 SELECT trim(both '"' from to_json(birthday)::text), trim(both '"' from to_json(created_at)::text) FROM ( SELECT '1977-10-09'::date AS birthday, now() AS created_at ) AS t
Пример результата выполнения:
birthday created_at 1977-10-09 2019-10-24T13:34:38.858211+00:00 Как вычислить дистанцию между 2-мя точками на Земле по её поверхности в километрах?
Если есть модуль earthdistance, то (point(lon1, lat1) point(lon2, lat2)) * 1.609344 AS distance_km . Иначе gc_dist(lat1, lon1, lat2, lon2) AS distance_km , смотри gc_dist.sql
-- select * from pg_available_extensions where installed_version is not null; with t as ( SELECT 37.61556 AS msk_x, 55.75222 AS msk_y, -- координаты центра Москвы 30.26417 AS spb_x, 59.89444 AS spb_y, -- координаты центра Санкт-Петербурга 1.609344 AS mile_to_kilometre_ratio ) select (point(msk_x, msk_y) @> point(spb_x, spb_y)) * mile_to_kilometre_ratio AS dist1_km, gc_dist(msk_y, msk_x, spb_y, spb_x) AS dist2_km from t;
Пример результата выполнения:
dist1_km dist2_km 633.045646835722 633.0469500660282 Как найти ближайшие населённые пункты относительно заданных координат?
-- координаты (долготу, широту) лучше сразу хранить не в 2-х отдельных полях, а в одном поле с типом point create index region_point_idx on region using gist(point(map_center_x, map_center_y)); --explain with t as ( SELECT 37.61556 AS msk_x, 55.75222 AS msk_y, -- координаты центра Москвы 1.609344 AS mile_to_kilometre_ratio ) select (point(msk_x, msk_y) @> point(map_center_x, map_center_y)) * mile_to_kilometre_ratio AS dist_km, name from region, t order by (select point(msk_x, msk_y) from t) -> point(map_center_x, map_center_y) limit 10;
Как вычислить приблизительный объём данных для результата SELECT запроса?
SELECT pg_size_pretty(SUM(OCTET_LENGTH(t::text) + 1)) FROM ( -- сюда нужно поместить ваш запрос, например: SELECT * FROM region LIMIT 50000 ) AS t
Почему запрос с подзапросом в NOT IN() возвращает 0 записей?
SELECT COUNT(*) FROM unnest(ARRAY[1,2,3,4,5,6]) as x(id) WHERE id IN ( SELECT id FROM unnest(ARRAY[1,2,NULL]) as y(id) ); --2 SELECT COUNT(*) FROM unnest(ARRAY[1,2,3,4,5,6]) as x(id) WHERE id NOT IN ( SELECT id FROM unnest(ARRAY[1,2,NULL]) as y(id) ); --0 . SELECT COUNT(*) FROM unnest(ARRAY[1,2,3,4,5,6]) as x(id) WHERE id NOT IN ( SELECT id FROM unnest(ARRAY[1,2,NULL]) as y(id) WHERE id IS NOT NULL ); --4 SELECT COUNT(*) FROM unnest(ARRAY[1,2,3,4,5,6]) as x(id) WHERE NOT EXISTS( SELECT FROM unnest(ARRAY[1,2,NULL]) as y(id) WHERE x.id = y.id ); --4
Вместо NOT IN(. ) лучше использовать NOT EXISTS(. )
Особенности сравнения record и NULL
Testing a ROW expression with IS NULL only reports TRUE if every single column is NULL. Нужно об этом знать, чтобы на напороться на ошибки в своём коде.
SELECT (NULL, NULL) IS NULL as "(NULL, NULL) IS NULL", --true (NULL, NULL) IS NOT NULL as "(NULL, NULL) IS NOT NULL", --false NOT (NULL, NULL) IS NULL as "NOT (NULL, NULL) IS NULL", --false (1, NULL) IS NULL as "(1, NULL) IS NULL", --false (1, NULL) IS NOT NULL as "(1, NULL) IS NOT NULL", --false --. NOT (1, NULL) IS NULL as "NOT (1, NULL) IS NULL" --true --.
Как очень быстро получить количество записей в большой таблице?
Применение: отображение общего кол-ва записей в админках.
-- возвращает точное количество записей, но медленно select count(*) as exact_count from table_name; -- возвращает приблизительное количество записей, но быстро -- точность больше, чем в следующем запросе, но от БД требуется актуальная статистика по таблице select reltuples::bigint as estimate_count from pg_class where oid = 'public.table_name'::regclass; -- возвращает приблизительное количество записей, но быстро -- точность меньше, чем в предыдущем запросе, но от БД не требуется актуальная статистика по таблице -- преимущество этого подхода в том, что можно задавать условие выборки select 100 * count(*) as estimate_count from table_name tablesample system (1) where . ;
Как сделать рекурсивный запрос?
with recursive t (x) as ( select 27 --начальное значение --select 989345275647 union all select case x % 2 when 0 then x / 2 else 3 * x + 1 end from t where x > 1 ) select max(x), count(x) from t
Модификация пользовательских данных (DML)
Как добавить или обновить записи одним запросом (UPSERT)?
- См. INSERT . ON CONFLICT DO NOTHING/UPDATE (Habr)
- Элегантная реализация на PL/pgSQL из официальной документации PostgreSQL
Как сделать INSERT . ON CONFLICT . без увеличения последовательности для дубликатов?
drop table if exists t1; --truncate t1; --alter sequence t1_id_seq restart with 1; create table t1 ( id integer GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY, -- последовательность t1_id_seq name varchar(255) NOT NULL UNIQUE ); insert into t1 (name) values ('a'), ('b'); table t1_id_seq; -- "last_value" is 2 -- БЫЛО - при дубликатах последовательность всегда увеличивается, -- при активной вставке можно достичь её предела, на практике такое бывает! -- здесь будет ошибка insert into t1 (name) values ('c'), ('a'); table t1_id_seq; -- "last_value" is 4 (зря увеличили последовательность на 2) -- здесь ошибки не будет insert into t1 (name) values ('c'), ('a') on conflict do nothing returning id; -- 1 row affected table t1_id_seq; -- "last_value" is 6 (зря увеличили последовательность на 1) -- СТАЛО insert into t1 as t (name) select * from (values ('c'), ('a')) as v(name) -- при дубликатах последовательность зря не увеличивается, но только в той же транзакции where not exists (select from t1 as d where d.name = v.name) -- при параллельном выполнении возможно увеличение последовательности, но это уже редкая ситуация on conflict do nothing -- id возвращаются только для добавленных записей returning id; -- 1 row affected table t1_id_seq; -- "last_value" is 3
Как модифицировать данные в нескольких таблицах и вернуть id затронутых записей в одном запросе?
WITH updated AS ( UPDATE table1 SET x = 5, y = 6 WHERE z > 7 RETURNING id ), inserted AS ( INSERT INTO table2 (x, y, z) VALUES (5, 7, 10) RETURNING id ) SELECT 'table1_updated' AS action, id FROM updated UNION ALL SELECT 'table2_inserted' AS action, id FROM inserted;
Как модифицировать данные в связанных таблицах одним запросом?
При сохранении сущностей возникает задача сохранить данные не только в основную таблицу БД, но ещё в связанные. В запросе ниже "старые" связи будут удалены, "новые" — добавлены, а существующие останутся без изменений. Счётчики последовательностей для полей-идентификаторов (id) зря не увеличатся. Приведён пример сохранения регионов вакансии.
WITH -- у таблицы vacancy_region должен быть уникальный ключ vacancy_id+region_id -- сначала удаляем все не переданные (несуществующие) регионы размещения для вакансии -- для ?l в конец массива идентификаторов регионов нужно добавить 0, чтобы запросы не сломались deleted AS ( DELETE FROM vacancy_region WHERE vacancy_id = ?0 AND region_id NOT IN (?l1) -- AND ROW(region_id, some_field) NOT IN (ROW(3, 'a'), ROW(8, 'b'), . ) -- пример для случая, если уникальный ключ состоит из нескольких полей RETURNING id ), -- потом добавляем все регионы размещения для вакансии -- несуществующие id регионов и дубликаты будут проигнорированы, ошибки не будет -- select нужен, чтобы запрос не сломался по ограничениям внешний ключей, если в списке region_id есть "леваки", они просто проигнорируются inserted AS ( INSERT INTO vacancy_region (vacancy_id, region_id) SELECT ?0 AS vacancy_id, id AS region_id FROM region WHERE id IN (?l1) ON CONFLICT DO NOTHING RETURNING id ) SELECT -- последовательность пречисления полей важна: сначала удаление, потом добавление, иначе будет ошибка (SELECT COUNT(*) FROM deleted) AS deleted, -- количество удалённых записей (SELECT COUNT(*) FROM inserted) AS updated -- количество добавленных записей
Как добавить запись с id, значение которого нужно сохранить ещё в другом поле в том же INSERT запросе?
По материалам Stackoverflow: Reference value of serial column in another column during same INSERT. А вообще это ошибка проектирования (нарушение нормальной формы)!
WITH t AS ( SELECT nextval(pg_get_serial_sequence('region', 'id')) AS id ) INSERT INTO region (id, ltree_path, ?r) SELECT id, CAST(?s || '.' || id AS ltree) AS ltree_path, ?l FROM t RETURNING ltree_path
Как сделать несколько последующих запросов с полученным при вставке id из первого запроса?
DO $$ DECLARE t1Id integer; BEGIN INSERT INTO t1 (a, b) VALUES ('a', 'b') RETURNING id INTO t1Id; INSERT INTO t2 (c, d, t1_id) VALUES ('c', 'd', t1Id); END $$;
Как не обновлять запись, если данные из UPDATE запроса и в БД совпадают?
Запрос типа UPDATE t SET WHERE > по сути ничего не обновит, но технически БД всё равно удалит старую версию записи и создаст новую. При этом отработают все триггеры (если они есть), а запись на время обновления будет заблокирована. В случае большого количества конкурентных UPDATE запросов они могут встать в очередь. Старые неиспользуемые версии записей некоторое время ещё хранятся в БД, их окончательно удаляет процедура вакуумизации. Всё это лишнее потребление ресурсов, которого можно избежать. Для этого нужно проверить, отличаются ли значения полей, указанные в UPDATE запросе, со значениями, которые хранятся в записи таблицы БД.
WITH v (col1, col2) AS ( SELECT 'text1', 'text2' ) UPDATE t AS u SET col1 = v.col1, col2 = v.col2 FROM v WHERE u.id = 123 AND (u.col1, u.col2) IS DISTINCT FROM (v.col1, v.col2);
Как обновить запись так, чтобы не затереть чужие изменения, уже сделанные кем-то?
Получаем запись для последующего редактирования в GUI:
SELECT col1, col2, updated_at --, md5(t::text) AS record_md5 -- если нет колонки updated_at, вычисляем хеш от данных всей записи FROM t WHERE id = 123
После редактирования в GUI обновляем запись в БД:
UPDATE t SET col1 = 'val1', col2 = 'val2', . WHERE id = 123 AND updated_at = '2019-11-08 00:58:33' -- сравниваем со значением из предыдущего SELECT запроса --AND md5(t::text) = '1BC29B36F623BA82AAF6724FD3B16718' -- если нет колонки updated_at, вычисляем хеш от данных всей записи и сравниваем со значением из предыдущего SELECT запроса RETURNING *
Если запрос вернул результат (одну строку), значит обновление было. Иначе обновления не было, значит кто-то обновил запись в БД раньше.
Как обновить несколько записей разными данными в одном запросе?
UPDATE users AS u SET email = v.email, first_name = v.first_name, last_name = v.last_name FROM (VALUES (1, 'hollis@weimann.biz', 'Hollis', 'O''Connell'), (2, 'robert@duncan.info', 'Robert', 'Duncan') ) as v(id, email, first_name, last_name) WHERE u.id = v.id;
Как обновить или удалить миллионы записей в таблице не блокируя все записи и не нагружая БД?
Используйте процедуру loop_execute() для обработки строк в больших таблицах (тысячи и миллионы строк) с контролируемым временем блокировки строк на запись. Принцип работы — выполняет в цикле CTE DML запрос, который добавляет, обновляет или удаляет записи в таблице. В завершении каждого цикла изменения фиксируются (либо откатываются для целей тестирования, это настраивается). Автоматически адаптируется под нагрузку на БД. На реплику данные передаются постепенно небольшими порциями, а не одним огромным куском.
В процессе обработки показывает в psql консоли:
- количество модифицированных и обработанных записей в таблице
- сколько времени прошло, сколько примерно времени осталось до завершения, прогресс выполнения в процентах
Прогресс выполнения в процентах для работающего процесса отображается ещё в колонке pg_stat_activity.application_name !
Процедура не предназначена для выполнения в транзакции, т.к. сама делает много маленьких транзакций.
Как удалить десятки тысяч записей в таблице не блокируя все записи и не нагружая БД?
Данный запрос хорошо подходит для:
- обработки большого количества записей в "админках" (программа или веб-страница для администрирования чего-то)
- периодически выполняемых задач по расписанию
- небольших миграций БД
Он будет бережно работать, даже если его запустить параллельно (например, запустить в веб-админке из нескольких вкладок браузера одновременно).
Выполнять этот запрос необходимо в цикле приложения. Исходный лимит 4096 (подобран опытным путём). Лимит для следующей итерации цикла возвращается в поле next_limit . Если next_limit = 0 , то прерываем цикл.
Как для одной сущности сделать ограничение на количество вставляемых зависимых сущностей?
Например, как ограничить клиента максимум N заказами?
Взято и адаптировано из доклада Ивана Фролкова (презентация, видео)
-- предположим, есть 2 таблицы client(id int, . ) и order(id, client_id, . ) create or replace function trg_only_5() returns trigger as $code$ begin if tg_op = 'DELETE' or (tg_op = 'UPDATE' and old.client_id = new.client_id) then return; end if; -- важный момент с блокировкой параллельных транзакций (они встают в очередь): perform pg_advisory_xact_lock('order'::regclass::oid::int, new.client_id); --perform from client c where c.id = new.client_id for update; -- или альтернативный вариант с блокировкой записи, но более медленный, т.к. бликирует строку в таблице от изменений в параллельных транзакциях (они встают в очередь) if (select count(*) from order o where o.client_id = new.client_id) > 5 then /* https://postgrespro.ru/docs/postgresql/14/errcodes-appendix - это коды ошибок в БД БД умеет кидать ошибки с произвольными кодами, поэтому для 23U01 получается так: 23 - это класс, U - user defined, 01 - порядковый номер Польза таких кодов ошибок в том, что по ним можно быстро найти проблемное место в программном коде приложения. */ raise sqlstate '23U01' using message='Too many orders'; end if; return new; end $code$ language plpgsql; create trigger only5 before insert or update on order for each row execute procedure trg_only_5();
Как сделать журналирование изменений таблицы?
Для сохранения истории изменения записей в таблице-журнале используется подход со следующими преимуществами:
- Данные в таблице-журнале хранятся в наглядном формате "было-стало"
- При обновлении данных в основной таблице в таблицу-журнал записываются только старые и новые данные, значения которых отличаются
- Простая схема таблицы-журнала, простой код триггерной функции, только один триггер
- Схему основной таблицы можно менять в любой момент, журналирование не сломается
drop table if exists test; create table test ( id integer generated always as identity primary key, t text, i integer ); drop table if exists test_history; create table test_history ( id integer generated always as identity primary key, reference_id integer not null, -- идентификатор связанной сущности, FK быть не должно, т.к. запись м.б. удалена created_at timestamp(0) with time zone not null default now() check (created_at now() + interval '10m'), old_data jsonb check(jsonb_typeof(old_data) = 'object'), new_data jsonb check(jsonb_typeof(new_data) = 'object'), check (not (old_data is null and new_data is null)) ); create index on test_history (reference_id); create index on test_history using brin (created_at); comment on column test_history.id is 'ID'; comment on column test_history.reference_id is 'ID в таблице test (существующий или удалённый)'; comment on column test_history.created_at is 'Дата-время действия'; comment on column test_history.old_data is 'Старые данные (для INSERT всегда NULL)'; comment on column test_history.new_data is 'Новые данные (для DELETE всегда NULL)'; CREATE OR REPLACE FUNCTION test_history_save() RETURNS TRIGGER LANGUAGE plpgsql AS $$ BEGIN IF TG_OP = 'INSERT' THEN INSERT INTO test_history (reference_id, new_data) VALUES (NEW.id, to_jsonb(NEW)); ELSIF TG_OP = 'DELETE' THEN INSERT INTO test_history (reference_id, old_data) VALUES (OLD.id, to_jsonb(OLD)); ELSIF TG_OP = 'UPDATE' AND OLD IS DISTINCT FROM NEW THEN INSERT INTO test_history (reference_id, old_data, new_data) select OLD.id, jsonb_object_agg(o.key, o.value) as old_data, jsonb_object_agg(n.key, n.value) as new_data from jsonb_each(to_jsonb(OLD)) as o, jsonb_each(to_jsonb(NEW)) as n where o.key = n.key and o.value is distinct from n.value; END IF; RETURN NULL; END; $$; DROP TRIGGER IF EXISTS test_history_save ON test; CREATE TRIGGER test_history_save AFTER INSERT OR UPDATE OR DELETE ON test FOR EACH ROW EXECUTE FUNCTION test_history_save(); insert into test (t, i) values ('one', 1), ('two', 2); update test set t = 'three', i = null where t = 'one'; delete from test where t = 'two'; select * from test; select * from test_history;
Данные в таблицах после выполнения SQL кода:
test
id t i 1 three NULL test_history
id reference_id triggered_at old_data new_data 1 1 2022-03-29 17:29:58 +03:00 NULL 2 2 2022-03-29 17:29:58 +03:00 NULL 3 1 2022-03-29 17:29:58 +03:00 4 2 2022-03-29 17:29:58 +03:00 NULL Замечание. Для использования этого типа журналирования колонки с типом json нужно заменить на колонки с типом jsonb , потому что для 2-х json не работает оператор сравнения ( = , != ) и ломается триггер на событие BEFORE UPDATE с проверкой NEW IS DISTINCT FROM OLD , а UPDATE запрос возвращает ошибку: [42883] ERROR: could not identify an equality operator for type json. Where: PL/pgSQL function updated_at_set_now() line 4 at IF
Как сделать автоматически обновляемое поле updated_at ?
Чтобы в поле updated_at хранилась настоящая дата-время последнего обновления строки, независимо от того, какое значение пришло от клиента:
CREATE OR REPLACE FUNCTION updated_at_set_now() RETURNS TRIGGER LANGUAGE plpgsql AS $$ BEGIN -- Обновляем только в случае настоящих изменений в данных -- ВНИМАНИЕ! Эта функция вернёт ошибку, если в таблице имеется колонка с типом JSON (он не поддерживает оператор сравнения) IF (TG_OP = 'INSERT' OR NEW IS DISTINCT FROM OLD) THEN NEW.updated_at = transaction_timestamp(); --Текущая дата и время (на момент начала транзакции) = now() --NEW.updated_at = statement_timestamp(); --Текущая дата и время (на момент начала текущего оператора) --NEW.updated_at = clock_timestamp(); --Текущая дата и время (меняется в процессе выполнения операторов) END IF; RETURN NEW; END; $$; -- 1 единый триггер CREATE TRIGGER _updated_at_set_now BEFORE INSERT OR UPDATE ON FOR EACH ROW EXECUTE PROCEDURE updated_at_set_now(); -- или 2 отдельных триггера CREATE TRIGGER _bi_updated_at_set_now BEFORE INSERT ON FOR EACH ROW EXECUTE PROCEDURE updated_at_set_now(); --чтобы не подсунули updated_at = null CREATE TRIGGER _bu_updated_at_set_now BEFORE UPDATE ON FOR EACH ROW EXECUTE PROCEDURE updated_at_set_now();
Модификация схемы данных (DDL)
Как добавить колонку в существующую таблицу без её блокирования?
Как добавить ограничение таблицы, если оно ещё не существует?
Способ 1. Реализация команды ALTER TABLE . ADD CONSTRAINT IF NOT EXISTS . , которая отсутствует в PostgreSQL 11.
-- Add constraint if it doesn't already exist DO $$ DECLARE exception_message text; exception_context text; BEGIN BEGIN ALTER TABLE company_awards ADD CONSTRAINT company_awards_year CHECK(year between 1900 and date_part('year', CURRENT_DATE)) NOT VALID -- чтобы БД не проверяла ограничение на всех записях в таблице (закомментируйте, при необходимости) ; EXCEPTION WHEN duplicate_object THEN GET STACKED DIAGNOSTICS exception_message = MESSAGE_TEXT, exception_context = PG_EXCEPTION_CONTEXT; RAISE NOTICE '%', exception_context; RAISE NOTICE '%', exception_message; END; END $$;
ALTER TABLE company_awards DROP CONSTRAINT IF EXISTS company_awards_year, ADD CONSTRAINT company_awards_year CHECK(year between 1900 and date_part('year', CURRENT_DATE)) NOT VALID -- чтобы БД не проверяла ограничение на всех записях в таблице (закомментируйте, при необходимости) ;
Как изменить ограничение внешнего ключа без блокирования таблицы?
ALTER TABLE group DROP CONSTRAINT group_company_id_fk, ADD CONSTRAINT group_company_id_fk FOREIGN KEY (company_id) REFERENCES company (id) ON UPDATE CASCADE ON DELETE CASCADE NOT VALID; -- https://postgrespro.ru/docs/postgresql/12/sql-altertable#SQL-ALTERTABLE-NOTES ALTER TABLE group VALIDATE CONSTRAINT group_company_id_fk;
Как проверить, что при добавлении или обновлении записи заполнены N полей из M возможных?
CREATE TABLE table1 ( field1 integer DEFAULT NULL, field2 integer DEFAULT NULL, field3 integer DEFAULT NULL, -- check that any N fields is required on INSERT or UPDATE CONSTRAINT table1 CHECK ( -- в массиве должны быть данные одного типа! array_length(array_remove(ARRAY[field1, field2, field3], null), 1) = 1 ) );
Как из enum типа удалить значение?
# rename the existing type ALTER TYPE status_enum RENAME TO status_enum_old; # create the new type CREATE TYPE status_enum AS ENUM('queued', 'running', 'done'); # update the columns to use the new type ALTER TABLE job ALTER COLUMN job_status TYPE status_enum USING job_status::text::status_enum; # if you get an error, see bottom of post # remove the old type DROP TYPE status_enum_old;
Errors
- invalid input value for enum : "" - One or more rows have a value ("") that is not in your new type. You must handle these rows before you can update the column type.
- default for column "" cannot be cast automatically to type - The default value for the column is not in your new type. You must change or remove the default value for the column before you can update the column type.
Как найти все упоминания названия объекта БД по всей БД?
Используется в задаче удаления неиспользуемых объектов БД (таблиц, колонок, функций и т.д.), чтобы найти зависимые объекты БД. Т.о. минимизируются риски сломать что-либо в БД после накатывания миграции.
Выгружаем схему БД в файл:
$ pg_dump --user=postgres --dbname=my_database --schema-only > schema.sql
Ищем упоминания в файле:
$ reset && cat schema.sql | sed -E 's/^\-\-[^\r\n]*//g' | grep -P -A1 '\btable_name\b'
Как изменить тип колонки с int на bigint ?
Если простой alter запрос будет работать > 1-3 секунд, это может привести к очереди запросов, пул которых в БД может закончиться. А это приведёт к отказу в обслуживании.
Поэтому есть обходныек пути:
- https://stackoverflow.com/questions/54795701/migrating-int-to-bigint-in-postgressql-without-any-downtime
- http://zemanta.github.io/2021/08/25/column-migration-from-int-to-bigint-in-postgresql/
- https://engineering.silverfin.com/pg-zero-downtime-bigint-migration/
Как восстановить значение последовательности, если оно отстало?
select setval(pg_get_serial_sequence('.', 'id'), max(id), true) from .;
Как создать или пересоздать индекс в существующей таблице без её блокирования?
Создание или удаление индекса без блокировки обеспечивается конкурентным режимом и флагом CONCURRENTLY . Но у этого способа есть несущественные недостатки:
- Индекс создаётся/удаляется дольше (2 сканирования таблицы вместо одного).
- Запускать эти запросы нужно НЕ в транзакции, а вручную последовательно.
- В случае неудачи построения индекса или его принудительного терминирования будет создан "нерабочий/битый" индекс. В этом случае его нужно удалить и создать заново.
Если процесс создания индекса убить из другого процесса, то индекс точно будет "нерабочий/битый".
Получить список всех "нерабочих/битых" индексов в БД:
SELECT n.nspname AS schemaname, c.relname AS tablename, i.relname AS indexname, t.spcname AS tablespace, pg_get_indexdef(i.oid) AS indexdef FROM pg_index x JOIN pg_class c ON c.oid = x.indrelid JOIN pg_class i ON i.oid = x.indexrelid LEFT JOIN pg_namespace n ON n.oid = c.relnamespace LEFT JOIN pg_tablespace t ON t.oid = i.reltablespace WHERE (c.relkind = ANY (ARRAY ['r', 'm', 'p'])) AND (i.relkind = ANY (ARRAY ['i', 'I'])) AND not x.indisvalid;
В момент работы create index concurrently в списке будут присутствовать "нерабочие/битые" индексы!
Удалить все "нерабочие/битые" индексы в БД:
do $$ declare rec record; begin for rec in select indrelid::regclass table_name, indexrelid::regclass index_name from pg_index where not indisvalid order by 1, 2 loop raise notice 'Table "%", drop index "%"', rec.table_name, rec.index_name; execute format('drop index %I', rec.index_name); end loop; end; $$;
Если БД в SQL запросе упорно не хочет использовать индекс, хотя должна, то нужно проверить, что индекс небитый.
Цель перестроения индекса - уменьшить занимаемый размер из-за фрагментации. Команда REINDEX имеет опцию CONCURRENTLY, которая появилась только в PostgreSQL 12. В более ранних версиях можно сделать так (неблокирующая альтернатива команде REINDEX):
-- для неуникального индекса: CREATE INDEX CONCURRENTLY tmp_index ON . ; -- делаем дубликат индекса my_index DROP INDEX CONCURRENTLY my_index; ALTER INDEX tmp_index RENAME TO my_index; -- для первичного ключа: CREATE UNIQUE INDEX CONCURRENTLY tmp_unique_index ON distributors (dist_id); ALTER TABLE table_name DROP CONSTRAINT my_unique_index, ADD CONSTRAINT my_unique_index PRIMARY KEY USING INDEX tmp_unique_index; -- для уникального индекса (если на ограничение есть ссылающиеся записи по внешнему ключу из других таблиц, то будет ошибка): CREATE UNIQUE INDEX CONCURRENTLY tmp_unique_index ON . ; ALTER TABLE table_name DROP CONSTRAINT my_unique_index, ADD CONSTRAINT my_unique_index UNIQUE USING INDEX tmp_unique_index;
Как сделать составной уникальный индекс, где одно из полей может быть null?
create table test ( a varchar not null, b varchar default null ); -- Решение 1. Если есть внешние ключи на колонки a и b, то дополнительных индексов делать уже не нужно. create unique index on test (b, a) where b is not null; create unique index on test (a) where b is null; -- Решение 2. Есть зависимость от типа данных, но один индекс вместо двух. create unique index on test(a, coalesce(b, '')) -- для чисел вместо '' напишите невозможное значение: 0 или -1
Как починить сломаный уникальный индекс, имеющий дубликаты?
Чиним битый уникальный индекс на поле skill.name
-- EXPLAIN WITH skill AS ( SELECT min(id) AS id_original, (array_agg(id order by id))[2:] AS id_doubles FROM skill GROUP BY lower(concat(name)) --используем concat, чтобы не использовался "битый" уникальный индекс по lower(name) HAVING count(*) > 1 ), repair_resume_work_skill AS ( -- собираем связи с дублями в таблицу SELECT t.resume_id, t.work_skill_id AS id_double, skill.id_original FROM skill INNER JOIN resume_work_skill AS t ON t.work_skill_id = ANY (skill.id_doubles) ), deleted_resume_work_skill AS ( -- удаляем связи с дублями из таблицы DELETE FROM resume_work_skill USING repair_resume_work_skill AS t WHERE resume_work_skill.resume_id = t.resume_id AND resume_work_skill.work_skill_id = t.id_double RETURNING id ), inserted_resume_work_skill AS ( -- добавляем новые правильные связи, при этом такая связь уже может существовать INSERT INTO resume_work_skill (resume_id, work_skill_id) SELECT t.resume_id, t.id_original FROM repair_resume_work_skill AS t ON CONFLICT DO NOTHING RETURNING id ), -- удаляем дубликаты deleted_skill AS ( DELETE FROM skill USING skill AS t WHERE skill.id = ANY (t.id_doubles) RETURNING id ) SELECT 'resume_work_skill' AS table_name, 'deleted' AS action, COUNT(*) FROM deleted_resume_work_skill UNION ALL SELECT 'resume_work_skill' AS table_name, 'inserted' AS action, COUNT(*) FROM inserted_resume_work_skill UNION ALL SELECT 'skill' AS table_name, 'deleted' AS action, COUNT(*) FROM deleted_skill ; -- создаём новый уникальный индекс CREATE UNIQUE INDEX uniq_skill_name2 ON skill (lower(name)); -- удаляем старый битый индекс DROP INDEX IF EXISTS skill.uniq_skill_name;
Как временно отключить индекс?
Способ 1 (от пользователя postgres, но без блокировки)
--Is it possible to temporarily disable an index in Postgres? update pg_index set indisvalid = false where indexrelid = 'test_pkey'::regclass
Способ 2 (в отдельной транзакции, но с блокировкой)
begin; drop index foo_ndx; explain analyze select * from foo; rollback;
CAUTION: Dropping an index inside a transaction will lock out concurrent selects, inserts, updates, and deletes on the table while the transaction is active. Use with caution in test environments, and avoid on production databases.
Как сделать компактный уникальный индекс на текстовое поле?
-- для поля с типом TEXT -- md5, приведённый к типу uuid занимает 16 байт вместо 32 байт create unique index on table_name (cast(md5(lower(column_name)) as uuid)); -- для поля с типом TEXT -- в этом индексе будут учитываться слова (буквы, цифры, точка, дефис) и их позиции в тексте, -- но не будет учитываться регистр слов и любые другие символы create unique index on table_name (cast(md5(cast(to_tsvector('simple', column_name) as text)) as uuid)); -- для поля с типом JSONB create unique index on table_name (cast(md5(lower(cast(column_name as text))) as uuid));
Как получить список процессов с SQL запросами, выполняющихся сейчас?
В PHPStorm есть возможность настроить для результата запроса значения в колонке application_name и вписать туда ПО и свою фамилию для своих SQL запросов. Для этого нужно открыть окно "Data Sources and Drivers", выбрать нужное соединение с БД из секции "Project Data Sources", перейти на вкладку "Advanced", отсортировать таблицу по колонке "Name", для "Name" равному "Application Name", изменить значение в колонке "Value" на что-то типа"PhpStorm Petrov Ivan" (строго на английском языке).
select e.*, pg_blocking_pids(pid), a.* --, pg_cancel_backend(pid) -- Остановить все SQL запросы, работающие более 1 часа, сигналом SIGINT. Подключение к БД для процесса сохраняется. --, pg_terminate_backend(pid) -- Принудительно завершить работу всех процессов, работающих более 1 часа, сигналом SIGTERM, если не помогает SIGINT. Подключение к БД для процесса теряется. from pg_stat_activity as a cross join lateral ( select statement_timestamp() - xact_start as xact_elapsed, --длительность транзакции или NULL, если транзакции нет case when a.state ~ '^idle\M' --idle, idle in transaction, idle in transaction (aborted) then state_change - query_start else statement_timestamp() - query_start end as query_elapsed, --длительность выполнения запроса всего statement_timestamp() - state_change as state_change_elapsed --длительность после изменения состояния (поля state) ) as e where true and state_change is not null --исключаем запросы для которых нехватило прав доступа --and query ~ 'WITH base_fcu_table' --and application_name ilike '%RINAT_TEST%' and state not in ('idle', 'idle in transaction', 'idle in transaction (aborted)') --and wait_event = 'ClientRead' --https://postgrespro.ru/docs/postgresql/12/monitoring-stats#WAIT-EVENT-TABLE --and (state_change_elapsed > interval '1 minutes' or xact_elapsed > interval '1 minutes') order by greatest(state_change_elapsed, query_elapsed, xact_elapsed) desc;
Как остановить или завершить работу процессов?
Из предыдущего запроса раскомментируйте строки:
--, pg_cancel_backend(pid) -- ИЛИ --, pg_terminate_backend(pid) --and (state_change_elapsed > interval '1 minutes' or xact_elapsed > interval '1 minutes')
Как получить список всех функций БД, включая триггерные процедуры?
SELECT n.nspname AS "Schema", p.proname AS "Name", CASE WHEN p.proretset THEN 'setof ' ELSE '' END || pg_catalog.format_type(p.prorettype, NULL) AS "Result data type", CASE WHEN proallargtypes IS NOT NULL THEN pg_catalog.array_to_string( ARRAY(SELECT CASE WHEN p.proargmodes[s.i] = 'i' THEN '' WHEN p.proargmodes[s.i] = 'o' THEN 'OUT ' WHEN p.proargmodes[s.i] = 'b' THEN 'INOUT ' END || CASE WHEN COALESCE(p.proargnames[s.i], '') = '' THEN '' ELSE p.proargnames[s.i] || ' ' END || pg_catalog.format_type(p.proallargtypes[s.i], NULL) FROM pg_catalog.generate_series(1, pg_catalog.array_upper(p.proallargtypes, 1)) AS s(i) ), ', ' ) ELSE pg_catalog.array_to_string( ARRAY(SELECT CASE WHEN COALESCE(p.proargnames[s.i+1], '') = '' THEN '' ELSE p.proargnames[s.i+1] || ' ' END || pg_catalog.format_type(p.proargtypes[s.i], NULL) FROM pg_catalog.generate_series(0, pg_catalog.array_upper(p.proargtypes, 1)) AS s(i) ), ', ' ) END AS "Argument data types", CASE WHEN p.provolatile = 'i' THEN 'immutable' WHEN p.provolatile = 's' THEN 'stable' WHEN p.provolatile = 'v' THEN 'volatile' END AS "Volatility", r.rolname AS "Owner", l.lanname AS "Language", p.prosrc AS "Source code", pg_catalog.obj_description(p.oid, 'pg_proc') AS "Description" FROM pg_catalog.pg_proc p LEFT JOIN pg_catalog.pg_namespace n ON n.oid = p.pronamespace LEFT JOIN pg_catalog.pg_language l ON l.oid = p.prolang JOIN pg_catalog.pg_roles r ON r.oid = p.proowner WHERE p.prorettype <> 'pg_catalog.cstring'::pg_catalog.regtype AND (p.proargtypes[0] IS NULL OR p.proargtypes[0] <> 'pg_catalog.cstring'::pg_catalog.regtype) AND NOT p.proisagg AND pg_catalog.pg_function_is_visible(p.oid) AND r.rolname <> 'pgsql';
Как получить список всех зависимостей (внешних ключей) между таблицами БД?
Запрос возвращает колонки from_table , from_cols , to_table , to_cols и другие.
Для какой-либо таблицы можно получить:
- список исходящих связей (таблицы, которые зависят от текущей таблицы)
- список входящих связей (таблицы, от которых зависит текущая таблица)
SELECT c.conname AS constraint_name, (SELECT n.nspname FROM pg_namespace AS n WHERE n.oid=c.connamespace) AS constraint_schema, tf.name AS from_table, ( SELECT STRING_AGG(QUOTE_IDENT(a.attname), ', ' ORDER BY t.seq) FROM ( SELECT ROW_NUMBER() OVER (ROWS UNBOUNDED PRECEDING) AS seq, attnum FROM UNNEST(c.conkey) AS t(attnum) ) AS t INNER JOIN pg_attribute AS a ON a.attrelid=c.conrelid AND a.attnum=t.attnum ) AS from_cols, tt.name AS to_table, ( SELECT STRING_AGG(QUOTE_IDENT(a.attname), ', ' ORDER BY t.seq) FROM ( SELECT ROW_NUMBER() OVER (ROWS UNBOUNDED PRECEDING) AS seq, attnum FROM UNNEST(c.confkey) AS t(attnum) ) AS t INNER JOIN pg_attribute AS a ON a.attrelid=c.confrelid AND a.attnum=t.attnum ) AS to_cols, CASE confupdtype WHEN 'r' THEN 'restrict' WHEN 'c' THEN 'cascade' WHEN 'n' THEN 'set null' WHEN 'd' THEN 'set default' WHEN 'a' THEN 'no action' --ELSE NULL END AS on_update, CASE confdeltype WHEN 'r' THEN 'restrict' WHEN 'c' THEN 'cascade' WHEN 'n' THEN 'set null' WHEN 'd' THEN 'set default' WHEN 'a' THEN 'no action' --ELSE NULL END AS on_delete, CASE confmatchtype::text WHEN 'f' THEN 'full' WHEN 'p' THEN 'partial' WHEN 'u' THEN 'simple' WHEN 's' THEN 'simple' --ELSE NULL END AS match_type, -- In earlier postgres docs, simple was 'u'nspecified, but current versions use 's'imple. text cast is required. pg_catalog.pg_get_constraintdef(c.oid, true) as condef FROM pg_catalog.pg_constraint AS c INNER JOIN ( SELECT pg_class.oid, QUOTE_IDENT(pg_namespace.nspname) || '.' || QUOTE_IDENT(pg_class.relname) AS name FROM pg_class INNER JOIN pg_namespace ON pg_class.relnamespace=pg_namespace.oid ) AS tf ON tf.oid=c.conrelid INNER JOIN ( SELECT pg_class.oid, QUOTE_IDENT(pg_namespace.nspname) || '.' || QUOTE_IDENT(pg_class.relname) AS name FROM pg_class INNER JOIN pg_namespace ON pg_class.relnamespace=pg_namespace.oid ) AS tt ON tt.oid=c.confrelid WHERE c.contype = 'f' ORDER BY 1;
Как получить статистику использования индексов?
Запрос отображает использование индексов. Что позволяет увидеть наиболее часто использованные индексы, а также и наиболее редко (у которых будет index_scans_count = 0).
Учитываются только пользовательские индексы и не учитываются уникальные, т.к. они используются как ограничения (как часть логики хранения данных).
В начале отображаются наиболее часто используемые индексы (отсортированы по колонке index_scans_count)
SELECT idstat.schemaname AS schema_name, -- название схемы idstat.relname AS table_name, -- название таблицы indexrelname AS index_name, -- название индекса idstat.idx_scan AS index_scans_count, -- число сканирований по этому индексу pg_size_pretty(pg_relation_size(indexrelid))AS index_size, -- размер индекса pg_size_pretty(pg_relation_size(idstat.relid)) AS table_size, -- размер таблицы tabstat.idx_scan AS table_reads_index_count, -- индексных чтений по таблице tabstat.seq_scan AS table_reads_seq_count, -- последовательных чтений по таблице tabstat.seq_scan + tabstat.idx_scan AS table_reads_count, -- чтений по таблице n_tup_upd + n_tup_ins + n_tup_del AS table_writes_count -- операций записи FROM pg_stat_user_indexes AS idstat JOIN pg_indexes ON indexrelname = indexname AND idstat.schemaname = pg_indexes.schemaname JOIN pg_stat_user_tables AS tabstat ON idstat.relid = tabstat.relid WHERE indexdef !~* 'unique' ORDER BY idstat.idx_scan DESC, pg_relation_size(indexrelid) DESC
Как получить список установленных расширений (extensions)?
select * from pg_available_extensions --where installed_version is not null order by installed_version is null, name
Как получить список таблиц с размером занимаемого места и примерным количеством строк?
В результате вы получите примерно такую таблицу:
relation table_size_pretty toast_size_pretty indexes_size_pretty total_size_pretty total_size_percent rows_estimate_count_pretty rows_estimate_count_percent public.table_a 25 GB 2455 MB 24 GB 51 GB 7.6 21,213,390 0.72 public.table_b 26 GB 7568 kB 21 GB 48 GB 7.06 330,934,528 11.27 public.table_c 21 GB 12 GB 14 GB 47 GB 6.97 9,149,683 0.31 public.table_d 35 GB 324 MB 3648 MB 39 GB 5.76 10,418,124 0.35 public.table_e 28 GB 5317 MB 3035 MB 36 GB 5.31 33,890,060 1.15 … … … … … … … … Как получить список самых ресурсоёмких SQL запросов?
Медленные запросы могут работать в разы быстрее, если их переписать по-другому и/или добавить индексы. Гораздо более важным параметром оценки SQL запросов является их ресурсоёмкость, т.е. % потребляемых ресурсов конкретным запросом в рамках всего сервера БД. Для принятия решения об оптимизации (ускорения) запросов нужно учитывать:
- длительность выполнения одного запроса
- кол-во запросов за единицу времени
- объём передаваемых и возвращаемых данных, их структуру и наличие дублирующих значений
create extension if not exists pg_stat_statements; SELECT a.rolname, t.total_time / 1000 / 60 as total_time_minutes, round((t.total_time * 100 / sum(t.total_time) over())::numeric, 2) as percent, d.datname, s.query, s.calls, t.mean_time, t.stddev_time, s.rows, s.shared_blks_hit, s.shared_blks_read FROM pg_stat_statements as s INNER JOIN pg_database as d ON d.oid = s.dbid INNER JOIN pg_authid as a ON a.oid = s.userid --Add CROSS JOIN LATERAL for PG14+ CROSS JOIN LATERAL ( SELECT s.total_plan_time + s.total_exec_time AS total_time, s.mean_plan_time + s.mean_exec_time AS mean_time, s.stddev_plan_time + s.stddev_exec_time AS stddev_time ) AS t --WHERE query ~* '(^|\n)\s*\m(insert\s+into|update|delete|truncate)\M' --только DML запросы WHERE s.query !~* '(^|\n)\s*\m(insert\s+into|update|delete|truncate)\M' --исключая DML запросы ORDER BY t.total_time DESC -- самые долгие запросы по общему времени выполнения --ORDER BY calls DESC -- самые популярные по кол-ву --ORDER BY mean_time DESC -- самые медленные в среднем (total_time / calls) --ORDER BY max_time DESC -- самые медленные в пике --ORDER BY rows DESC -- больше всего возвращают строк LIMIT 100;
SELECT pg_stat_statements_reset(); -- для представления pg_stat_statements SELECT pg_stat_reset(); -- все представления по этому расширению
Как получить список SQL запросов, создающих временные файлы?
SELECT запросы, которые активно пишут на диск десятками и сотнями мегабайт потребляют лишние ресурсы БД и замедляют выполнение других запросов, которые выполняются параллельно.
Сначала посмотрим по каждой БД
select datname, temp_files, pg_size_pretty(temp_bytes) as temp_file_size FROM pg_stat_database WHERE temp_files > 0 ORDER BY temp_bytes DESC;
Теперь посмотрим на SQL запросы
create extension if not exists pg_stat_statements; SELECT (SELECT datname FROM pg_database as d WHERE d.oid = s.dbid) AS dbname, interval '1 ms' * total_time AS exec_time_total, interval '1 ms' * (total_time / calls) AS exec_time_avg, rows, calls, pg_size_pretty(temp_blks_written * current_setting('block_size')::int) AS temp_written_total, pg_size_pretty(temp_blks_written * current_setting('block_size')::int / calls) AS temp_written_avg, query FROM pg_stat_statements AS s --Add CROSS JOIN LATERAL for PG14+ CROSS JOIN LATERAL ( SELECT s.total_plan_time + s.total_exec_time AS total_time, s.mean_plan_time + s.mean_exec_time AS mean_time, s.stddev_plan_time + s.stddev_exec_time AS stddev_time ) AS t WHERE temp_blks_written > 0 ORDER BY temp_blks_written / calls DESC LIMIT 20;
Как получить и изменить значения параметров конфигурации выполнения?
получение значений параметров
-- способ 1 SHOW pg_trgm.word_similarity_threshold; SHOW pg_trgm.similarity_threshold; -- способ 2 SELECT name, setting AS value FROM pg_settings WHERE name IN ('pg_trgm.word_similarity_threshold', 'pg_trgm.similarity_threshold'); -- способ 3 SELECT current_setting('pg_trgm.word_similarity_threshold'), current_setting('pg_trgm.similarity_threshold');
изменение значений параметров
-- способ 1 SET pg_trgm.similarity_threshold = 0.3; SET pg_trgm.word_similarity_threshold = 0.3; -- способ 2 SELECT set_config('pg_trgm.word_similarity_threshold', 0.2::text, FALSE), set_config('pg_trgm.similarity_threshold', 0.2::text, FALSE);
Как получить все активные в данный момент процессы автовакуумa и время их работы?
Вакуумирование — важная процедура поддержания хорошей работоспособности вашей базы. Если вы видите, что автовакуум процессы всё время работают, это значит что они не успевают за количеством изменений в системе. А это в свою очередь сигнал того что надо срочно принимать меры, иначе есть большой риск “распухания” таблиц и индексов — ситуация когда физический размер объектов в базе очень большой, а при этом полезной информации там в разы меньше.
SELECT (clock_timestamp() - xact_start) AS ts_age, state, pid, query FROM pg_stat_activity WHERE query ilike '%autovacuum%' AND NOT pid=pg_backend_pid()Как узнать, почему время ответа от базы периодически падает?
При неправильно настроенных контрольных точках база будет генерировать избыточную дисковую нагрузку. Это будет происходить с высокой частотой, что будет замедлять общее время отклика системы и базы данных. Для того, чтобы понять правильность настройки, надо обратить внимание на следующие отклонения в поведении базы данных: в мониторинге приложения или базы будут видны пики во времени ответа, с хорошо прослеживаемой периодичностью; в моменты "пиков" в логе базы будет отслеживаться большое количество медленных запросов (в случае если логирование таких запросов настроено).
Запрос покажет статистику по контрольным точкам с момента, когда она в последний раз обнулялась. Важными показателями будут минуты между контрольными точками и объем записываемой информации. Большое кол-во данных за короткое время — это серьезная нагрузка на систему ввода-вывода. Если это ваш случай, то ситуацию нужно однозначно менять!
SELECT now()-pg_postmaster_start_time() "Uptime", now()-stats_reset "Minutes since stats reset", round(100.0*checkpoints_req/checkpoints,1) "Forced checkpoint ratio (%)", round(min_since_reset/checkpoints,2) "Minutes between checkpoints", round(checkpoint_write_time::numeric/(checkpoints*1000),2) "Average write time per checkpoint (s)", round(checkpoint_sync_time::numeric/(checkpoints*1000),2) "Average sync time per checkpoint (s)", round(total_buffers/pages_per_mb,1) "Total MB written", round(buffers_checkpoint/(pages_per_mb*checkpoints),2) "MB per checkpoint", round(buffers_checkpoint/(pages_per_mb*min_since_reset*60),2) "Checkpoint MBps" FROM ( SELECT checkpoints_req, checkpoints_timed + checkpoints_req checkpoints, checkpoint_write_time, checkpoint_sync_time, buffers_checkpoint, buffers_checkpoint + buffers_clean + buffers_backend total_buffers, stats_reset, round(extract('epoch' from now() - stats_reset)/60)::numeric min_since_reset, (1024.0 * 1024 / (current_setting('block_size')::numeric))pages_per_mb FROM pg_stat_bgwriter ) bg
Как обезопасить приложение от тяжёлых миграций, приводящих к блокированию запросов?
Этот код не даёт 100% гарантии, а только уменьшает количество заблокированных запросов. После того, как блокировка взята, другие запросы, могут встать в очередь, ожидая отпускания блокировки.
Вначале каждой миграции, которая выполняется внутри транзакции, нужно изменить настройки конфигурации lock_timeout и statement_timeout и idle_in_transaction_session_timeout командой SET LOCAL. Действие SET LOCAL продолжается только до конца текущей транзакции, независимо от того, фиксируется она или нет. При выполнении такой команды вне блока транзакции выдаётся предупреждение и больше ничего не происходит.
/* Здесь SQL команды для наката (или отката), которые не могут работать внутри транзакции */ BEGIN; DO $$ DECLARE exception_message text; exception_context text; BEGIN /* Задаёт максимальную длительность ожидания любым оператором получения блокировки таблицы, индекса, строки или другого объекта базы данных. Если ожидание не закончилось за указанное время, оператор прерывается. Это ограничение действует на каждую попытку получения блокировки по отдельности и применяется как к явным запросам блокировки (например, LOCK TABLE или SELECT FOR UPDATE без NOWAIT), так и к неявным. Если это значение задаётся без единиц измерения, оно считается заданным в миллисекундах. */ SET LOCAL lock_timeout TO '3s'; -- Максимальное время выполнения любого SQL запроса в этой транзакции. Если будет превышено, то транзакция откатится. SET LOCAL statement_timeout TO '30min'; -- Максимальное время простаивания транзакции, PostgreSQL >= 10. Если будет превышено, то транзакция откатится. SET LOCAL idle_in_transaction_session_timeout TO '10s'; EXCEPTION WHEN undefined_object THEN GET STACKED DIAGNOSTICS exception_message = MESSAGE_TEXT, exception_context = PG_EXCEPTION_CONTEXT; RAISE NOTICE '%', exception_context; RAISE NOTICE '%', exception_message; END $$; /* Здесь SQL команды для наката (или отката) внутри транзакции */ COMMIT; /* Здесь SQL команды для наката (или отката), которые не могут работать внутри транзакции */
Если транзакция откатится, то есть 2 варианта: запустить повторно во время меньших нагрузок или оптимизировать код миграции, чтобы свести к минимуму блокировки.
- запрос для получения дерева заблокированных запросов
- execute_attempt.sql
Simple index checking
with table_stats as ( select psut.relname, psut.n_live_tup, 1.0 * psut.idx_scan / greatest(1, psut.seq_scan + psut.idx_scan) as index_use_ratio from pg_stat_user_tables psut order by psut.n_live_tup desc ), table_io as ( select psiut.relname, sum(psiut.heap_blks_read) as table_page_read, sum(psiut.heap_blks_hit) as table_page_hit, sum(psiut.heap_blks_hit) / greatest(1, sum(psiut.heap_blks_hit) + sum(psiut.heap_blks_read)) as table_hit_ratio from pg_statio_user_tables psiut group by psiut.relname order by table_page_read desc ), index_io as ( select psiui.relname, psiui.indexrelname, sum(psiui.idx_blks_read) as idx_page_read, sum(psiui.idx_blks_hit) as idx_page_hit, 1.0 * sum(psiui.idx_blks_hit) / greatest(1.0, sum(psiui.idx_blks_hit) + sum(psiui.idx_blks_read)) as idx_hit_ratio from pg_statio_user_indexes psiui group by psiui.relname, psiui.indexrelname order by sum(psiui.idx_blks_read) desc ) select ts.relname, ts.n_live_tup, ts.index_use_ratio, ti.table_page_read, ti.table_page_hit, ti.table_hit_ratio, ii.indexrelname, ii.idx_page_read, ii.idx_page_hit, ii.idx_hit_ratio from table_stats ts left outer join table_io ti on ti.relname = ts.relname left outer join index_io ii on ii.relname = ts.relname order by ti.table_page_read desc, ii.idx_page_read desc
Как скопировать таблицы из одной базы данных в другую?
pg_dump -U postgres -h 127.0.0.1 --dbname=my_database_src --verbose \ | psql -U postgres -h 127.0.0.1 --dbname=my_database_dst 2> errors.txt
Двумя командами, через промежуточный сжатый файл.
#на сервере A: pg_dump -U postgres -h 127.0.0.1 --clean --if-exists my_database_src | pv | pzstd -9 > my_table.sql.zst #копируем my_table.sql.zst с сервера A на сервер B #на сервере B: pv my_table.sql.zst | zstd -dcq | psql --username=postgres --host=127.0.0.1 --dbname=my_database_dst --set=ON_ERROR_STOP=1 --echo-errors
Как выгрузить таблицы из БД?
Выгружаем: pg_dump -U postgres --db=my_database --table=public.my_table1 --table=public.my_table2 > my_tables.sql
Cжимаем: zstd -19 -T8 my_tables.sql -o my_tables.sql.zst
Одной командой: pg_dump -U postgres --db=my_database --table=public.my_table1 --table=public.my_table2 | zstd -19 -T8 > my_tables.sql.zst
Как выгрузить результат SELECT запроса в CSV?
copy ( select id, send_date::timestamp(0), message from my_table where send_date > now() - interval '2 month' --limit 100 ) to stdout csv;
cat select.sql | psql -U postgres --dbname=my_database | zstd -19 -T8 > select.csv.zst
Как проверить синтаксис SQL кода без его выполнения?
-- PostgreSQL syntax check without running the query DO $SYNTAX_CHECK$ BEGIN RETURN; -- insert your SQL code here END; $SYNTAX_CHECK$;
Как откатить часть транзакции внутри функции или процедуры?
На SQL вы можете сделать так:
BEGIN; INSERT INTO table1 VALUES (1); SAVEPOINT my_savepoint; INSERT INTO table1 VALUES (2); ROLLBACK TO SAVEPOINT my_savepoint; --rollback previous command INSERT INTO table1 VALUES (3); COMMIT;
Внутри функции или процедуры код выше завершится с ошибкой, например в is_sql.sql . Но вы можете откатить часть SQL команд в транзакции через подтранзакции:
DO $TEST$ BEGIN -- here you can write DDL commands, for example, adding or deleting a table or its section -- and/or -- here you can write DML commands that modify data in tables and, thus, check the operation of triggers -- rollback all test queries raise exception using errcode = 'query_canceled'; EXCEPTION WHEN query_canceled THEN --don't do anything END $TEST$;
Как терминировать долгие простаивающие без дела подключения к БД?
Цель — защита тестовой БД или производственной реплики БД от сбоев из-за ошибок в коде приложений.
Чтобы реплике забрать изменения с мастера, она принудительно терминирует по таймауту все очень долгие запросы и транзакции, которые выполняются на реплике.
Пример команд, которые нужно выполнить на мастере (под суперпользователем):
alter system set idle_session_timeout = '20m'; --PostgreSQL v14+ alter system set idle_in_transaction_session_timeout = '50m'; --PostgreSQL v9.6+
Пример команд, которые нужно выполнить на реплике (под суперпользователем):
alter system set max_standby_archive_delay = '1h'; alter system set max_standby_streaming_delay = '1h';
Не забудьте внести изменения в файл конфигурации postgresql.conf (узнать, где он находится можно командой show config_file ).
Параметр idle_session_timeout появился только PostgreSQL v14+. В PgBouncer есть параметр server_idle_timeout , который по сути является аналогом idle_session_timeout . Для PostgreSQL версий < 14 cоздайте файл pg_terminate_idle_timeout.sql . Запрос необходимо выполнять 1 раз в минуту (например, из крона).
$ crontab -l # m h dom mon dow command * * * * * psql -U postgres --file=/path/to/pg_terminate_idle_timeout.sqlКак терминировать заблокированные одинаковые запросы, образующие очередь?
Цель — защита тестовой БД или производственной реплики БД от сбоев из-за ошибок в коде приложений.
Одинаковые запросы могут блокировать друг-друга и образовывать очередь. Когда кол-во допустимых соединений к БД будет превышено, она принудительно терминирует все запросы и транзакции. Среди этих запросов могут быть "невиновные" запросы. Но можно терминировать только проблемные запросы и транзакции.
Запрос необходимо выполнять 1 раз в 15 секунд (например, из крона).
$ crontab -l # m h dom mon dow command * * * * * psql -U postgres --file=/path/to/pg_terminate_duplicate_locked.sql * * * * * ( sleep 15 && psql -U postgres --file=/path/to/pg_terminate_duplicate_locked.sql ) * * * * * ( sleep 30 && psql -U postgres --file=/path/to/pg_terminate_duplicate_locked.sql ) * * * * * ( sleep 45 && psql -U postgres --file=/path/to/pg_terminate_duplicate_locked.sql )Как журналировать DDL команды в таблицу БД?
Как узнать, какие самые частые действия в таблице совершаются?
Одна из целей — установить значение fillfactor для таблиц с частыми UPDATE, чтобы задействовать Heap-Only Tuple update для увеличения скорости работы.
Колонка usage содержит набор букв:
Действие Много Мало Чтение S (>80%) s (>50%) Вставка I (>90%) i (>30%) Обновление U (>90%) u (>30%) Удаление D (>90%) d (>30%) Как узнать отставание реплики?
Запускать на реплике:
select now() - pg_last_xact_replay_timestamp() as replication_lag_interval, current_setting('max_standby_archive_delay') as max_standby_archive_delay, current_setting('max_standby_streaming_delay') as max_standby_streaming_delay
Как узнать процент достижения своего максимального значения для последовательностей?
select schemaname as schema, sequencename as sequence_name, data_type, used_percent from pg_sequences cross join round(last_value * 100.0 / max_value, 2) as used_percent where last_value is not null /*null means access denied*/ and used_percent > 33 order by used_percent desc;
schema sequence_name data_type used_percent public table_a_id_seq integer 100 public table_b_id_seq integer 37.13 About
Коллекция готовых SQL запросов для PostgreSQL по часто возникающим задачам (получение и модификация данных, ускорение запросов, обслуживание БД)
- Синтаксический разбор текста запроса.
-
PRIORITY NONE: означает, что данные попадут в пул после первого обращения к объекту. Серверный процесс не занимается заполнением IM-пула. Данные в пул помещают фоновые процессы IMCO/SMCO/Wnnn, и на это может потребоваться время.
При этом план выполнения запроса уже будет использовать IM-пул (TABLE ACCESS INMEMORY FULL), даже если он ещё не заполнен. Запрос будет выбирать данные с диска или кэша буферов, а из IM-пула только ту часть, которая успела в него загрузиться. Эффективность выполнения такого запроса может быть низкой, пока начальная загрузка объекта в IM-пул не завершится. Если бы объект не обслуживался IM-пулом (NO INMEMORY), то план выполнения запроса мог использовать индексы (если они есть) и, возможно, выполнялся бы более эффективно, чем полное сканирование таблицы когда её большая часть ещё не загружена в IM-пул.
Ещё нужно принять во внимание следующее: при использовании PRIORITY NONE и использовании менеджера ресурсов базы данных загрузка данных в IM-пул выполняется из под группы потребителей ресурсов того пользователя, который первым обратился к объекту и инициировал начало загрузки объекта в IM-пул. Загрузка данных из этого объекта в IM-пул и выполнение запросов пользователя могут выполняться медленнее, если сработают ограничения менеджера ресурсов, наложенные на группу пользователя.
Для других значений PRIORITY загрузка данных в IM-пул выполняется из-под группы потребителей ресурсов ORA$AUTOTASK.
Можно поменять группу потребителей ресурсов для операций заполнения IM-пула:
exec DBMS_RESOURCE_MANAGER.SET_CONSUMER_GROUP_MAPPING( attribute => 'ORACLE_FUNCTION', value => 'INMEMORY', consumer_group => 'BATCH_GROUP');
Тип сжатия можно выбирать разным для разных столбцов или секций. Уровень сжатия зависит от данных и варьируется от 2 до 20 раз.
Уровень компрессии можно оценить заранее на основе анализа части данных объекта процедурой DBMS_COMPRESSION.GET_COMPRESSION_RATIO.
Уровень компрессии для объектов в IM-пуле можно узнать так:
SELECT SEGMENT_NAME, BYTES, INMEMORY_SIZE, INMEMORY_COMPRESSION, BYTES/INMEMORY_SIZE COMP_RATIO FROM V$IM_SEGMENTS;
Тип сжатия, установленный на уровне столбца можно узнать из столбца INMEMORY_COMPRESSION представления V$IM_COLUMN_LEVEL.

Данные распределяются между экземплярами RAC, это позволяет экономить память. Параллельные запросы используют данные из всех экземпляров путем запуска параллельных процессов на этих экземплярах. Нужно использовать автоматическое определение уровня параллелизма (AUTO DOP), так как при ручном задании уровня параллелизма, параллельные процессы могут запуститься только на части экземпляров и IM-пулы на оставшихся экземплярах не будут использоваться.
Значения параметров, установленных на уровне таблиц, можно узнать так:
SELECT table_name, inmemory_compression, inmemory_priority, inmemory_distribute, inmemory_duplicate FROM dba_tables;
Использование IMCS с частью объекта
Можно использовать IM-пул для ханения данных по части столбцов. Для этого нужно на уровне таблицы указать опцию INMEMORY и исключить часть столбцов. Пример:
CREATE TABLE tab1 (c1 NUMBER, c2 CHAR(2), c3 DATE) INMEMORY NO INMEMORY (c1);
Можно включить или исключить столбцы, а также изменить свойства INMEMORY отдельно для каждого столбца:
ALTER TABLE tab1 NO INMEMORY (c2); ALTER TABLE tab1 INMEMORY MEMCOMPRESS FOR DML (c3); ALTER TABLE tab1 INMEMORY MEMCOMPRESS FOR QUERY HIGH (c2);
Изменение типа компрессии не приводит к пересозданию существующих IMCU и действует только для создаваемых вновь и repopulated IMCU.
Аналогично для секций секционированной таблицы:
CREATE TABLE countries_part . PARTITION BY LIST .. ( PARTITION p1 .. INMEMORY PRIORITY HIGH, PARTITION p2 .. INMEMORY MEMCOMPRESS FOR CAPACITY LOW);
Аналогично для материализованных представлений:
ALTER MATERIALIZED VIEW mv INMEMORY;
После того, как объект введён под обслуживание опции можно удалить аналитические индексы, то есть те, которые не используются декларативными ограничениями целостности. При доступе к объектам в IM-пуле индексы не используются. Перед удалением индексов можно пометить их INVISIBLE, убедиться, что на обычной нагрузке нет деградации производительности и удалить индексы. Удаление аналитических индексов повысит производительность операций DML над таблицей, так как их не нужно обновлять.
Анализ эффективности применения
Эффективность выполнения запроса можно оценить так:
set timing on set autotrace on SELECT max(prod_id) FROM sales; ALTER SESSION SET INMEMORY_QUERY=DISABLE; SELECT max(prod_id) FROM sales; ALTER SESSION SET INMEMORY_QUERY=ENABLE;
Оценка использования пула по плану выполнения:

Если запрос обращается к IM и не-IM таблицам, то IM-пул используется по возможности:

Если в SELECT во фразе WHERE используется фильтрация по значению столбца, по которому создан индекс, оптимизатор может выбрать план, который не использует IM-пул несмотря на то, что данные из таблицы в нём размещены. Удаление индекса по столбцу поможет оптимизатору создавать план выполнения, использующий IM-пул.
Использование IM-пула не означает, что будет идти сканирование всех IMCU, относящихся к объекту. При работе с IMCU используются алгоритмы, позволяющие исключать из сканирования IMCU, в которых находятся данные, не удовлетворяющие условиям запроса. Для этого используются данные по минимальным и максимальным значениям для каждого столбца в каждом IMCU. Эти данные видны в столбцах MINIMUM_VALUE, MAXIMUM_VALUE представления V$IM_COL_CU. Также используются техники bloom-фильтрации, in-Memory Aggregation (Vector group-by, Key vector, Vector transform).
Опции Adaptive plans, Adaptive Cursor Sharing, SQL Plan Management, Parallel Query работают с новой опцией.
Анализ эффективности с помощью SPA
Для проверки эффективности настроек IMCS можно использовать SQL Performance Analyzer (SPA). На входе SPA принимает SQL Tuning Set (STS), содержащий команды, которые нужно проанализировать; имя параметра инициализации действие которого нужно проанализировать — inmemory_query с двумя анализируемыми значениями disable и enable; в качестве анализируемой метрики можно указать Elapsed time:

Дальше SPA выполняет два прохода по каждой команде из STS. Результат можно посмотреть на странице SPA:

Загрузка базы данных в rкэш буферов 12с
Full Database in-Memory Caching
В 12c появилась ещё одна техника кэширования данных, которая не связана с IMCS. Если кэш буферов каждого экземпляра больше примерно 80% размера базы данных (используемых блоков данных), за исключением SYSAUX и временных табличных пространств, то блоки загруженные в кэш буферов, из него не вытесняются. LOB'ы с атрибутом NOCACHE (значение по умолчанию для LOB) в кэш буферов не загружаются. Большие таблицы в этом режиме могут полностью размещаться в кэше буферов, даже если их размер превышает 10% кэша буферов. База данных 12c использует такой режим работы по умолчанию.
Найти размер базы данных можно так:
select sum(bytes) from cdb_segments where tablespace_name<>'SYSAUX';
Если не хочется менять атрибут NOCACHE для LOB'ов, можно его игнорировать:
STARTUP MOUNT; ALTER DATABASE FORCE FULL DATABASE CACHING;
Параметр инициализации DB_CACHE_SIZE необязательно устанавливать, можно использовать SGA_TARGET.
Вернуться в обычный режим командой:
ALTER DATABASE NO FORCE FULL DATABASE CACHING;
Узнать установленный режим работы можно так:
SELECT force_full_db_caching FROM v$database;
Режимы для основной и резервных баз данных устанавливаются независимо. Изменение режима сохраняется в control-файле.
В обоих режимах (FORCE FULL и NO FORCE FULL), предварительной загрузки блоков в кэш буферов не происходит, блоки подгружаются в кэш буферов по мере обращения к ним.
Большие таблицы и кэш буферов в 12с
Automatic Big Table Caching
Если оперативной памяти на компьютере недостаточно и условия использования Full Database in-Memory Caching не выполняются, в 12c можно использовать Automatic Big Table Caching. Она по умолчанию отключена. Эта опция позволяет выделить часть кэша буферов под хранение блоков больших таблиц параметром инициализации DB_BIG_TABLE_CACHE_PERCENT_TARGET. В зарезервированной этим параметром инициализации части кэша буферов блоки будут вытесняться не поблочно (по алгоритму LRU для каждого блока), а на основе частоты доступа к объекту (TEMPERATURE из представления V$BT_SCAN_OBJ_TEMPS). Если таблица не может полностью поместиться в зарезервированную часть, то помещается часть таблицы, оставшаяся часть будет считываться с диска.
Можно зарезервировать под кэширование блоков больших таблиц от 0 до 90% кэша буферов. Включение FORCE FULL DATABASE CACHING запрещает функционирование Automatic Big Table Caching.
Дополнительные материалы
Ссылки:
От экспертов «1С‑Рарус»: Зависание проведения документа при неоптимальных планах запросов из‑за Parameter sniffing в MS SQL. Сравнение с PostgreSQL
Непредсказуемое зависание сеанса пользователя при проведении документа в 1С
Сеть предприятий общественного питания ведет свою деятельность в «1С:УНФ 8. Управление предприятием общепита». После перехода на очередной релиз от пользователей стали поступать обращения, что при проведении документов в какой-то момент сеанс зависает и даже спустя 30–60 минут операции не завершаются. Зависание сеанса одного пользователя не вызывает замедление работы системы у остальных пользователей. Нагрузка на оборудование штатная и свободных ресурсов достаточно для нормальной работы.
Для решения проблемы выполняли принудительное завершение сеансов. После чего определенное все работало стабильно, а потом по новой. Если же в системе работает один сотрудник, то система работает стабильно. При этом есть ощущение мистичности происходящего, поскольку еще 10 минут назад этот же документ мог проводится совершенно нормально. Регулярности в экземпляре документа, который зависнет не наблюдается. Давайте разберемся, что же такое могло произойти.
Инфраструктура исследуемой системы
Программный продукт: 1С:УНФ 8. Управление предприятием общепита.
База данных: Microsoft SQL Server 2017 64х.
Платформа 1С:Предприятие 8: 8.3.20.1710 64х.
Операционная система: Windows Server 2012 R2.
Процессор: Intel(R) Xeon(R) Gold 6242R CPU @ 3.10GHz.
Оперативная память: 320 GB.
SSD: 3 TB.
Hypervisor: VMware ESXi, 7.0.3.
Прежде, чем мы пойдем дальше нужно уточнить, что весь учет сети ведется в одной информационной базе, а сама сеть состоит из более 30 организаций — от крупных заведений до небольших точек.
Основной процесс работы с программой является отражением фактов приготовления блюд и списания ингредиентов с помощью документов «Выпуск блюд». Для заполнения данных документов в решении поддерживается схема от чеков и от заказов на производство («Планы меню»). В режиме от чеков кассовые системы передают информацию о продажах и возвратах, затем данные за смену агрегируются и формируются учетные документы, одним из которых и является «Выпуск блюд».
Поиск причин зависания сеанса пользователя
Собираем и анализируем логи технологического журнала
Получив данное обращение, мы поначалу оказались в небольшой растерянности. Поэтому сказали, давайте соберём логи ТЖ по событиям CALL, SDBL, DBMSSQL и посмотрим нет ли чего-то такого длительного. Хотя надежды особо не было найти, так как нерегулярность зависания любого выпуска подсказывала, что дело не в этом. Впрочем, а вдруг кто нашалил так, что длительная операция срабатывает при каких-либо сложных условиях. Ничего не обнаружили.
Второй гипотезой являлись блокировки данных. И не просто блокировки, а множество мелких блокировок, каждая из которых не достигает порога в 20 секунд, но их много. Для их анализа был настроен сбор логов по событиям TLOCK, TTIIMEOUT, TDEADLOCK, EXCP.
Надо заметить, что взаимоблокировки и ожидания тут были добавлены так, на всякий случай, поскольку если бы они были в самом деле, то мы увидели бы служебную информацию об этом, а не зависал сеанс пользователя. Впрочем, вдруг кто-то нахулиганил, выставил неприлично долгий период ожидания. Еще раз повторимся, что по данным событиям мы хотели отсечь наличие большого количества мелких блокировок, длительность которых была меньше таймаута, но с общей длительностью, которая и вызывала ощущение зависания. Также несмотря на отсутствие обращений по обычным конфликтам блокировок данных, хоть они бы выпадали по таймауту, стоило убедиться в этом самостоятельно.
Полный текст файла logcfg.xml:
 create="1"
type="0"
externaldump="1"/>
За время сбора логов по словам администратора возникло несколько таких зависаний хоть перепроведения и не запускались.
Чтобы убедиться в корректности данного уточнения хитрые инструменты не нужны. Воспользовались обработкой регламентных заданий библиотеки стандартных подсистем и убедились, что все-таки перепроведения выполнялись. Потому отсеивать первую гипотезу пока рано.

Приступим к анализу собранных логов. Их размер превышал 40 ГБ, поэтому для анализа используем bash-скрипты. Сначала посмотрим на длительность максимальных блокировок. Для этого выполняем следующие команды:
grep -i 'tlock' rphost_*/*.log| gawk -F '-' '
В результате можно увидеть, что блокировки есть, но начиная от 4 строки их длительность меньше 1 секунды.
6125036,TLOCK,4,process=rphost,p:processName=base_name,OSThread=10440,t:clientID=47,t:applicationName=1CV8C,t:computerName=SRV rphost_2908/22062816.log:50:33.518093
4874942,TLOCK,4,process=rphost,p:processName=base_name,OSThread=3020,t:clientID=62,t:applicationName=1CV8C,t:computerName=SRV rphost_2908/22062816.log:23:23.296003
3078003,TLOCK,4,process=rphost,p:processName=base_name,OSThread=10328,t:clientID=62,t:applicationName=1CV8C,t:computerName=SRV rphost_2908/22062816.log:26:44.317009
718849,TLOCK,4,process=rphost,p:processName=base_name,OSThread=8444,t:clientID=5041,t:applicationName=BackgroundJob,t:computerName=SRV rphost_2908/22062816.log:26:45.95803
608859,TLOCK,4,process=rphost,p:processName=base_name,OSThread=12536,t:clientID=51,t:applicationName=1CV8C,t:computerName=SRV rphost_2908/22062816.log:50:34.283068
421943,TLOCK,4,process=rphost,p:processName=base_name,OSThread=9088,t:clientID=62,t:applicationName=1CV8C,t:computerName=SRV rphost_2908/22062816.log:21:39.959128
188005,TLOCK,4,process=rphost,p:processName=base_name,OSThread=3020,t:clientID=5990,t:applicationName=BackgroundJob,t:computerName=SRV rphost_2908/22062816.log:53:14.32102
А вот блокировки, которые ожидали друг друга, заполняя свойство waitConnections — есть.
cat rphost_*/*.log| perl -pe 's/\n/
При этом их небольшое количество с длительностью каждого меньше 0,5 секунды. Следовательно, гипотеза о множестве маленьких блокировок не подтвердилась.
10021:39.959128-421943,TLOCK,4,process=rphost,p:processName=base_name,OSThread=9088,t:clientID=62,t:applicationName=1CV8C,t:computerName=SRV,t:connectID=5887097,SessionID=12329,Usr=Пользователь2,AppID=1CV8C,DBMS=DBMSSQL,DataBase=10.1.0.64\base_name,Regions=AccumRg16825.DIMS,Locks='AccumRg16825.DIMS Exclusive Fld1254=0 Fld16826=226:8af5005056ad653711eafbc036d7d6d0 Fld16827=339:8afc005056ad653711eb674aacfbf722 Fld16828=67:81750050569766bb11e9c96ee9443ce3 Fld16829=216:81750050569766bb11e9d06b95cd9e33',WaitConnections=5892990,connectionID=6d456270-bdc8-4058-8f6d-af433763d226,Context='Форма.Записать : Документ.СборкаЗапасов.Форма.УОП_ФормаДокумента
Документ.СборкаЗапасов.МодульОбъекта : 687 : Документы.СборкаЗапасов.ИнициализироватьДанныеДокумента(Ссылка, ДополнительныеСвойства);
Документ.СборкаЗапасов.МодульМенеджера : 7511 : ИнициализироватьДанныеДокументаСборка(ДокументСсылкаСборкаЗапасов, СтруктураДополнительныеСвойства)
Документ.СборкаЗапасов.МодульМенеджера : 5856 : ИнициализироватьДанныеПоЗапасамСборка(ДокументСсылкаСборкаЗапасов, СтруктураДополнительныеСвойства, СуммаСборки);
Документ.СборкаЗапасов.МодульМенеджера : 2647 : СформироватьТаблицаЗапасыСборка(ДокументСсылкаСборкаЗапасов, СтруктураДополнительныеСвойства, СуммаСборки);
Документ.СборкаЗапасов.МодульМенеджера : 1050 : Блокировка.Заблокировать();'
Ранее длительные вызовы были проанализированы так:
cat rphost_*/*.log| perl -pe 's/\n/
Видим событие открытия формы документа «Инвентаризации запасов», которое выполнялось порядка 40 минут, а также еще ряд длительных операций по 30 и 13 минут. То есть в системе попутно обнаруживались неприятности, которые надо было исправлять, но пока речь не о них.
2468136943,CALL,1,process=rphost,p:processName=base_name,OSThread=9412,t:clientID=75,t:applicationName=1CV8C,t:computerName=SRV,t:connectID=5887148,callWait=0,first=true,Usr=Пользователь1,SessionID=12524,Context=Система.ПолучитьФорму : Документ.ИнвентаризацияЗапасов.ФормаОбъекта,Interface=bc15bd01-10bf-413c-a856-ddc907fcd123,IName=IVResourceRemoteConnection,Method=0,CallID=9991,MName=send,Memory=25590833,MemoryPeak=69635025,InBytes=49110,OutBytes=65730713,CpuTime=30812500
04:38.871038 1992482070,CALL,1,process=rphost,p:processName=base_name,t:clientID=66,t:applicationName=1CV8C,t:computerName=SRV,t:connectID=5887121,callWait=0
39:47.034087 838663041,CALL,1,process=rphost,OSThread=5296,t:clientID=6083,callWait=0,first=true,Usr=Пользователь2,SessionID=16772(12329),p:processName=base_name,Func=Backgroundjob,Module=ДлительныеОперации,Method=ВыполнитьСКонтекстомКлиента,Memory=-16050379,MemoryPeak=46637653,InBytes=420300,OutBytes=847449608,CpuTime=127828125
02:51.479100 785266020,CALL,1,process=rphost,OSThread=3020,t:clientID=5990,callWait=0,first=true,Usr=Пользователь3,SessionID=16744(12581),p:processName=base_name,Func=Backgroundjob,Module=ДлительныеОперации,Method=ВыполнитьСКонтекстомКлиента,Memory=-27457514,MemoryPeak=202644686,InBytes=35370305,OutBytes=1237823678,CpuTime=204593750
59:24.178038
Так, что же делать? Давайте соберем логи по запросам еще раз, вдруг мы что-то пропустили или собрали не в тот момент. Посмотрим на топ выполненных длительных запросов по событию SDBL:
cat rphost_*/*.log| perl -pe 's/\n/
В результате можно увидеть запрос, который выполнялся почти все 40 минут события CALL. А это уже зацепка за нужное направление!
2427575020,SDBL,2,process=rphost,p:processName=base_name,OSThread=9412,t:clientID=75,t:applicationName=1CV8C,t:computerName=SRV-TERMINAL2,t:connectID=5887148,SessionID=12524,Usr=Пользователь1,AppID=1CV8C,DBMS=DBMSSQL,DataBase=10.1.0.64\base_name,Trans=0,Func=HoldConnection,Context='Система.ПолучитьФорму : Документ.ИнвентаризацияЗапасов.ФормаОбъекта
Документ.ИнвентаризацияЗапасов.МодульОбъекта : 54 : УОП_ЗаполнитьНаОснованииВыпускаПродукции(ДанныеЗаполнения);
Документ.ИнвентаризацияЗапасов.МодульОбъекта : 156 : ВыпускПродукции.УОП_ЗаполнитьПроизводство();
Документ.СборкаЗапасов.МодульОбъекта : 4263 : МодульПроизводства.ЗаполнитьПроизводство(СтруктураОбъекта);
ОбщийМодуль.УОП_Производство.Модуль : 496 : ЗаполнитьПроизводствоДоИнтерактива(СтруктураОбъекта, ДопДанные);
ОбщийМодуль.УОП_Производство.Модуль : 600 : ЗаполнитьПроизводственыеТаблицы(ТаблицаПроизводства, ТаблицаЗамен, СтруктураОбъекта.ПартионныеПотери, СтруктураПараметров, СтруктураОбъекта.ВидПроизводства);
ОбщийМодуль.УОП_Производство.Модуль : 3162 : РезультатЗапроса = Запрос.Выполнить();'
Полный текст события с приведенным запросом:
2427419046,SDBL,3,process=rphost,p:processName=base_name,OSThread=9412,t:clientID=75,t:applicationName=1CV8C,t:computerName=SRV,t:connectID=5887148,SessionID=12524,Usr=Пользователь1,AppID=1CV8C,DBMS=DBMSSQL,DataBase=10.1.0.64\base_name,Trans=0,Sdbl='SELECT
Q_001_T_001.Q_000_F_000,
Q_001_T_001.Q_000_F_001,
CASE WHEN (Q_001_T_003.Fld20776 = 172:81750050569766bb11e9c96ee9443d96) THEN 99999999999.999 WHEN (Q_001_T_001.Q_000_F_002 < 0) THEN 0 ELSE Q_001_T_001.Q_000_F_002 END ,
Q_001_T_001.Q_000_F_003,
Q_001_T_001.Q_000_F_004,
ISNULL(Q_001_T_002.Fld15726, 1),
Q_001_T_004.Fld21496 sf_1,
CASE
WHEN Q_001_T_004.Fld21494 REFS Document537 THEN
CAST(Q_001_T_004.Fld21494 AS REF(Document537)).Date_Time
WHEN Q_001_T_004.Fld21494 REFS Document506 THEN
CAST(Q_001_T_004.Fld21494 AS REF(Document506)).Date_Time
WHEN Q_001_T_004.Fld21494 REFS Document594 THEN
CAST(Q_001_T_004.Fld21494 AS REF(Document594)).Date_Time
WHEN Q_001_T_004.Fld21494 REFS Document445 THEN
CAST(Q_001_T_004.Fld21494 AS REF(Document445)).Date_Time
WHEN Q_001_T_004.Fld21494 REFS Document466 THEN
CAST(Q_001_T_004.Fld21494 AS REF(Document466)).Date_Time
ELSE NULL END
sf_2
FROM
#Tf645a34eb03844fe9964aeede06c5784 Q_001_T_001 LEFT JOIN InfoRg15723 Q_001_T_002 ON (Q_001_T_001.Q_000_F_000 = Q_001_T_002.Fld15724) AND (Q_001_T_001.Q_000_F_003 = Q_001_T_002.Fld15725) LEFT JOIN Reference216 Q_001_T_003 ON (Q_001_T_001.Q_000_F_000 = Q_001_T_003.ID) LEFT JOIN Reference250 Q_001_T_004 ON (Q_001_T_001.Q_000_F_003 = Q_001_T_004.ID)
WHERE
(Q_001_T_001.Q_000_F_002 > 0)
ORDER BY
sf_1,
sf_2
',Rows=1,Context='Система.ПолучитьФорму : Документ.ИнвентаризацияЗапасов.ФормаОбъекта
Документ.ИнвентаризацияЗапасов.МодульОбъекта : 54 : УОП_ЗаполнитьНаОснованииВыпускаПродукции(ДанныеЗаполнения);
Документ.ИнвентаризацияЗапасов.МодульОбъекта : 156 : ВыпускПродукции.УОП_ЗаполнитьПроизводство();
Документ.СборкаЗапасов.МодульОбъекта : 4263 : МодульПроизводства.ЗаполнитьПроизводство(СтруктураОбъекта);
ОбщийМодуль.УОП_Производство.Модуль : 496 : ЗаполнитьПроизводствоДоИнтерактива(СтруктураОбъекта, ДопДанные);
ОбщийМодуль.УОП_Производство.Модуль : 600 : ЗаполнитьПроизводственыеТаблицы(ТаблицаПроизводства, ТаблицаЗамен, СтруктураОбъекта.ПартионныеПотери, СтруктураПараметров, СтруктураОбъекта.ВидПроизводства);
ОбщийМодуль.УОП_Производство.Модуль : 3162 : РезультатЗапроса = Запрос.Выполнить();'
Данный запрос в контексте 1С:
ВЫБРАТЬ
ВТ_ОстаткиТоваров.Ингредиент КАК Ингредиент,
ВТ_ОстаткиТоваров.Характеристика КАК Характеристика,
ВТ_ОстаткиТоваров.Количество КАК Количество,
&ПараметрСниффинг2 КАК ПараметрСниффинг,
ВТ_ОстаткиТоваров.Партия КАК Партия,
ВТ_ОстаткиТоваров.ЗаказПокупателя КАК ЗаказПокупателя,
ЕСТЬNULL(ОбработкаСырья.Коэффициент, 1) КАК КоэффициентПартионныхПотерь
ИЗ
ВТ_ОстаткиТоваров КАК ВТ_ОстаткиТоваров
ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.УОП_ОбработкаСырьяПартионная КАК ОбработкаСырья
ПО ВТ_ОстаткиТоваров.Ингредиент = ОбработкаСырья.Ингредиент
И ВТ_ОстаткиТоваров.Партия = ОбработкаСырья.Партия
ЛЕВОЕ СОЕДИНЕНИЕ Справочник.ПартииНоменклатуры КАК ПартииНоменклатуры
ПО ВТ_ОстаткиТоваров.Партия = ПартииНоменклатуры.Ссылка УПОРЯДОЧИТЬ ПО
ПартииНоменклатуры.УОП_СрокГодности
ПартииНоменклатуры.УОП_ДокументПартии.Дата
По тексту запросов можно увидеть, что временная таблица соединяется с регистром сведений «Обработка cырья» (InfoRg15723) и со справочниками «Номенклатура» (Reference216) и «Партии номенклатуры» (Reference250) левыми соединениями.
При этом регистр сведений «Обработка сырья» у клиента не содержит записей вообще, а к справочникам идет соединение по ссылкам и кажется, что запрос вполне обычный. Да и после завершения зависшего сеанса, данный запрос отрабатывает меньше, чем за одну секунду. Что вызывает чувство противоречия и непонимания, т. к. у нас есть запрос, который в один момент времени отрабатывает за секунду, а в другой за 40 минут.
Подозреваем 1С:СЛК
Почему этот запрос один раз выполняется быстро, а в другой раз медленно? Сам запрос выполняется в рамках логики, зашифрованной с помощью компоненты защиты 1С:СЛК, которую обновляли как раз в данном релизе, но так совпало, что после выхода релиза «1С:Управление предприятием общепита» была выпущена новая версия компоненты 1С:СЛК. Т. к. срок между крайними релизами компоненты оказался слишком маленьким, а мы имеем непонятную ситуацию с запросом, то появляется подозрение на причастность данной компоненты к непонятным зависаниям. Однако, по итогу ее обновление не помогло и версия не подтвердилась.


Наблюдаем за поведением кластера серверов 1С и СУБД
В тот момент пока обновление компоненты защиты еще не было выполнено, мы попросили подключить нас, когда повторится очередное зависание, чтобы посмотреть на состояние кластера серверов и системы управления базами данных.
Данная ситуация произошла буквально через несколько часов. В момент подключения снимаем значения показателей сеансов с периодом в 30–40 секунд и сохраняем в формате csv.

После чего выполняем сравнение результатов по зависшим пользователям и видим, что меняется только время вызова:
| Номер сеанса | Пользователь | Время вызова СУБД (всего) | Время вызовов (5 мин) | Время вызова (всего) |
|---|---|---|---|---|
| 12632 | Пользователь1 | 550,484 | 550,422 | 557,703 |
| 12632 | Пользователь1 | 723,609 | 723,547 | 730,828 |
| 12632 | Пользователь1 | 764,734 | 764,672 | 771,953 |
Принимаем решение заглянуть в Management Studio и с помощью следующего текста запроса посмотреть выполняемые запросы:
SELECT
session_id,
status,
wait_type,
command,
last_wait_type,
qt.text as sql_text,
total_elapsed_time/1000 as [total_elapsed_time, sec],
wait_time/1000 as [wait_time, sec],
(total_elapsed_time - wait_time)/1000 as [work_time, sec],
percent_complete
FROM sys.dm_exec_requests as qs
CROSS APPLY sys.dm_exec_sql_text(qs.sql_handle) as qt
where session_id >= 50 and session_id <> @@spid

В результате выполнения был обнаружен запрос, который совпадает с ранее обнаруженным в SDBL.
Стоит отметить, что информацию о выполняемых запросах также можно получить в Activity Monitor применив отборы по номеру процесса указанному в кластере серверов.

В результате расследования мы дважды натыкаемся на один и тот же запрос, а компонента защиты оказывается невиновной. Почему же данный запрос выполняется то медленно, то быстро?
Если спросить разработчиков почему запрос выполняется медленно, то наиболее популярные ответы будут:
Конечно, данные причины тоже приводят к медленному выполнению запросов. Если попробовать обобщить их, то главная причина — не оптимально подобранный план запросов!
Проверяем план запроса
В статье «Очистка процедурного кэша SQL для 1C. Мифы, реальность, практика» мы уже упоминали про план запросов, но давайте еще раз вспомним что это.
Язык запросов 1С, как и язык sql-запросов, является декларативным, т. е. мы говорим, что нам нужно найти, а не что нужно выполнять, чтобы найти. Задачей преобразования этого «что нужно» в «как это искать» занимается оптимизатор запросов. Данная компонента основываясь на информации о схеме базы данных, статистике и тексте выполняемого запроса формирует различные последовательности операций, которые приводят к требуемому результату.
Последовательность операций, которые приводят к получению результата запроса и называется планом выполнения запроса или планом запроса. Вариантов последовательностей может быть много. Потому при подборе последовательностей оптимизатор запросов сразу оценивает каждую операцию и по итогу предоставляет предполагаемую наиболее эффективную последовательность.
Почему предполагаемую? При выполнении запроса данная компонента Microsoft SQL Server отталкиваясь от статистики сначала формирует именно предполагаемый план запроса (estimated execution plan), который и помещается в кэш, а уже после выполнения формируется фактический план запроса (actual execution plan), который дополняет предполагаемый план уже фактическими данными. Например, такими как: среда выполнения, затраченное время, время ЦП, количество выбираемых строк и многое другое.
Определение предварительных планов является ресурсоемкой операцией. Чтобы не выполнять данное действие каждый раз, сформированные планы помещаются в буферный кэш планов и при повторном выполнении текста запроса используются уже готовые планы.
Для того, чтобы в этом убедиться давайте посмотрим на план запроса, который будет выбирать все номенклатурные позиции с именем, начинающимся на «Пельмешки»:
ВЫБРАТЬ
СпрНоменклатура.Ссылка КАК Номенклатура
ИЗ
Справочник.Номенклатура КАК СпрНоменклатура
ГДЕ
СпрНоменклатура.Наименование ПОДОБНО &НаименованиеНоменклатуры
Эксперимент будем проводить на клиент-серверной базе. В качестве системы управления базами данных выступит Microsoft SQL Server.
Сначала для чистоты эксперимента очистим кэш планов. Для этого воспользуемся инструкцией DBCC FREEPROCCACHE.

Для сбора планов запроса можно воспользоваться средствами СУБД или собрать лог технологического журнала. Чтобы включить сбор планов запроса в логе технологического журнала необходимо в файл logcfg.xml добавить тег . Подробнее про данную возможность по ссылке https://its.1c.ru/db/v8320doc/bookmark/adm/TI000000401.
Пример текста файла logcfg.xml с включенным сбором планов запроса:
В результате получим событие, где в Sql размещается выполняемый текст запроса на уровне СУБД, а в planSQLText — план запроса:
45:07.994004-1,DBMSSQL,5,Sql="SELECT
T1._IDRRef
FROM dbo._Reference141 T1
WHERE ((T1._Fld929 = ?)) AND ((T1._Description LIKE ?))
p_0: 0N
p_1: 'Пельмешки%'
",planSQLText='
0, 1, 1.95, 0.00313, 0.000159, 127, 0.00328, 1, |--Nested Loops(Inner Join, OUTER REFERENCES:([Expr1004], [Expr1005], [Expr1006]))
0, 0, 1, 0, 0, 8017, 0, 1, |--Compute Scalar(DEFINE:([Expr1004]=LikeRangeStart([@P2]), [Expr1005]=LikeRangeEnd([@P2]), [Expr1006]=LikeRangeInfo([@P2])))
1, 1, 1, 0, 0, 0, 0, 1, | |--Constant Scan
0, 1, 1.95, 0.00313, 0.000159, 127, 0.00328, 1, |--Index Seek(OBJECT:([grimut_upo3].[dbo].[_Reference141].[_Reference141_5] AS [T1]), SEEK:([T1].[_Fld929]=[@P1] AND [T1].[_Description] > [Expr1004] AND [T1].[_Description] < [Expr1005]), WHERE:([grimut_upo3].[dbo].[_Reference141].[_Description] as [T1].[_Description] like [@P2]) ORDERED FORWARD)
'
Если же выполнить сбор плана средствами Extended Events Microsoft SQL Server по событиям query_post_compilation_showplan, query_post_execution_showplan и sql_batch_completed:

То в результате можно получить такой предварительный план запроса:

И такой фактический план запроса:

Создадим новый элемент справочника, попадающий под условие, и попробуем перевыполнить запрос. В результате СУБД сформирует только фактический план запроса, а предполагаемый возьмет из кэша:

В этом также можно убедиться по значению свойства QueryPlanHash, которое можно увидеть в XML представлении плана и оно же будет сохраняться для данного запроса:

Стоит отметить, что если мы изменим значение параметра НаименованиеНоменклатуры, например, на «Пюрешка» то план запроса все равно не поменяется:

Связано это с тем, что в кэше планов будет находиться план, рассчитанный с учетом параметров запроса первого выполнения. Значения этих параметров можно увидеть в тегах ParameterCompiledValue, а значения, которые использовали при фактическом выполнении в ParameterRuntimeValue:

Механизм сканирования параметров parameter sniffing
Данное поведение объясняется включенным механизмом сканирования параметров (parameter sniffing), который позволяет оптимизатору запросов не учитывать параметры при подборе плана из кэша.
Данное поведение отлично оправдывает себя на равномерно распределенных данных, но если данные распределены неравномерно, то о стабильности выборок можно забыть. В экспертной среде также принято говорить о селективности, но это и есть то как распределены данные в таблице. Ведь планы запросов могут отличаться. В этом легко убедиться.
Представим себе периодический регистр сведений «Цены номенклатуры» с измерениями «Номенклатура» и «Организация». Измерение «Организация» будет дополнительно индексировано:


В данном регистре будут фиксироваться цены организаций ООО «Плюшка-пампушка» и ИП «Пюрюшка с котлеткой» в процентом соотношении записей 99,9% к 0,1% соответственно:

Выполним простой запрос на выборку всех записей по каждой из организации и запустим сбор планов запроса:
ВЫБРАТЬ
ЦеныНоменклатуры.Период КАК Период,
ЦеныНоменклатуры.Номенклатура КАК Номенклатура,
ЦеныНоменклатуры.Организация КАК Организация,
ЦеныНоменклатуры.Цена КАК Цена
ИЗ
РегистрСведений.ТЦ_ЦеныНоменклатуры КАК ЦеныНоменклатуры
ГДЕ
ЦеныНоменклатуры.Организация = &Организация
Перед выполнением каждого запроса будем сбрасывать кэш планов, чтобы увидеть наиболее оптимальный. В результате получим следующие планы для каждой из организации:


Как можно увидеть планы между собой отличаются. Для организации с меньшим количеством записей система приняла решение воспользоваться поиском по некластерном индексу с помощью Index seek, а потом дополняет информацию соединив с результатом поиска по кластерному индексу (Key lookup). Для организации с большим количеством записей система решила воспользоваться Clustered Index Scan, тем самым сразу просканировала по кластерному индексу.
Если же не выполнять сброс кэша, то система будет использовать либо первый, либо второй план в зависимости от порядка их выполнения. Так и получается, что в один момент времени запрос выполняется быстро из-за оптимального плана, в другой момент — долго из-за того, что план может вообще не подходить.
Можно ли отключать parameter sniffing?
Вы можете спросить, а можно ли отключить механизм сканирования параметров (parameter sniffing) и как?
Для этого необходимо отключить флаг трассировки 4136 или начиная с версии SQL Server 2016 (13.x) это можно сделать на уровне базы данных:

Отключение данного механизма будет работать только если в запросе не используются OPTION(RECOMPILE), WITH RECOMPILE или OPTIMIZE FOR, но их из платформы 1С:Предприятие 8 и не прилетит.
В результате отключения данного механизма из плана запроса пропадет свойство ParameterCompiledValue и планы будут формироваться заново после каждого выполнения запроса:

Что спровоцирует дополнительную нагрузку на оборудовании. Время выигранное на одном запросе к не равно распределенной таблице скорее всего будет не сопоставимо с затраченным временем для всех остальных запросов. Потому отключать данный механизм не рекомендуется. Как можно решить данную проблему, не отключив настройку parameter sniffing поговорим ниже.
Результат поиска причин зависания пользовательского сеанса
Мы приходим к следующим выводам: в системе включен механизм сканирования параметров, который кэширует планы запросов, не учитывая в дальнейшем параметры запроса. При выполнении запросов будет подбираться оптимальный план для первых параметров, а не для текущих, потому для текущих параметров план запросов может быть совсем не оптимальным. Данная причина вполне объясняла бы нашу ситуацию, когда сначала запрос отрабатывает мгновенно, а в какой-то момент начинает зависать по 40 минут.
Вставим простое логирование в журнал регистрации на количество элементов, передаваемых в параметре «Список номенклатуры» выполняемого запроса. Спустя время видим подтверждение нашей гипотезы. Когда в один момент времени данные будут анализироваться для маленького количества данных, а в другой — в сотни раз больше.
| Время выполнения | Операция | Количество элементов |
|---|---|---|
| 17:49:30 | f0a167fb-eff7-4d0a-a533-fca0f62e30d1 | 729 |
| 17:50:54 | fbbc2e75-b7d7-4b22-bf2d-12dbea06d70c | 686 |
| 17:51:18 | 55aa4559-dce7-4f2d-b907-4750987a77de | 5 |
| 17:51:20 | 3d49abf7-f7ce-42ca-a60c-27dfb09d0227 | 30 |
| 17:52:31 | 3d49abf7-f7ce-42ca-a60c-27dfb09d0227 | 2 |
Устраняем причины зависания сеансов пользователей
Как мы уже упомянули, вариант с отключением сканирования параметров на уровне всей базы не является хорошим. Однако это и не единственный вариант.
Самый простой способ, который доступен из платформы «1С:Предприятие 8» без дополнительных настроек СУБД — формировать текст запроса динамически. Тогда для СУБД данный запрос будет казаться новым и план запроса будет сформирован заново.
Ранее на проектах мы уже сталкивались с данной проблемой, потому решили воспользоваться простым изменением — в поля запроса добавляем тег, который перед выполнением заменяем на значение уникального идентификатора.
В упрощенном виде это выглядит приблизительно так:
ТекстЗапроса = "ВЫБРАТЬ
| ВТ_ОстаткиТоваров.Ингредиент КАК Ингредиент,
| ВТ_ОстаткиТоваров.Характеристика КАК Характеристика,
| ВТ_ОстаткиТоваров.Количество КАК Количество,
| &ПараметрСниффинг2 КАК ПараметрСниффинг,
| ВТ_ОстаткиТоваров.Партия КАК Партия,
| ЕСТЬNULL(ОбработкаСырья.Коэффициент, 1) КАК КоэффициентПартионныхПотерь
|ИЗ
| ВТ_ОстаткиТоваров КАК ВТ_ОстаткиТоваров
| ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.УОП_ОбработкаСырьяПартионная КАК ОбработкаСырья
| ПО ВТ_ОстаткиТоваров.Ингредиент = ОбработкаСырья.Ингредиент
| И ВТ_ОстаткиТоваров.Партия = ОбработкаСырья.Партия
| ЛЕВОЕ СОЕДИНЕНИЕ Справочник.ПартииНоменклатуры КАК ПартииНоменклатуры
| ПО ВТ_ОстаткиТоваров.Партия = ПартииНоменклатуры.Ссылка
|
|УПОРЯДОЧИТЬ ПО
| ПартииНоменклатуры.УОП_СрокГодности";
ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&ПараметрСниффинг2", Строка(Новый УникальныйИдентификатор));
Но когда мы решили проверить данный запрос, то на уровне СУБД увидели следующий текст запроса SQL:
(@P1 nvarchar(4000),@P2 numeric(10),@P3 numeric(10),@P4 numeric(10),@P5 numeric(10),@P6 numeric(10),@P7 numeric(10),@P8 numeric(10),@P9 numeric(10),@P10 numeric(10),@P11 numeric(10),@P12 numeric(10),@P13 numeric(10))
SELECT
T1._Q_000_F_000RRef,
T1._Q_000_F_001RRef,
T1._Q_000_F_003,
@P1,
T1._Q_000_F_004RRef,
T1._Q_000_F_005RRef,
ISNULL(CAST(T2._Fld19343 AS NUMERIC(8, 4)),1.0),
T3._Fld4356,
CASE WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001A6 THEN T4._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000018A THEN T5._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00006230 THEN T6._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000159 THEN T7._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000162 THEN T8._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001B3 THEN T9._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000019A THEN T10._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000174 THEN T11._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000015F THEN T12._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000185 THEN T13._Date_Time ELSE CAST(NULL AS DATETIME) END
FROM #tt34 T1 WITH(NOLOCK)
Платформа «1С:Предприятие 8» самостоятельно обернула данное поле в параметр запроса. Хотя еще пару релизов платформы назад этот вариант срабатывал «на ура». Причину почему разработчики платформы так сделали можно понять: все для того же сокращения количества формирования планов запросов и оптимизации их количества в буферном кэше.
Далее мы решили схитрить и попробовать передавать не какое-то значение, а целую арифметическую операцию. Для этого мы генерировали два случайных числа и выполняли их сложение:
ГСЧ = Новый ГенераторСлучайныхЧисел(ТекущаяУниверсальнаяДатаВМиллисекундах());
Слагаемое = ГСЧ.СлучайноеЧисло(0, 429496729) + ГСЧ.СлучайноеЧисло(0, 4294967295);
Слагаемое = ГСЧ.СлучайноеЧисло(0, 429496725) + ГСЧ.СлучайноеЧисло(0, 4294967295);

ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&Слагаемое1", Слагаемое1);
ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&Слагаемое2", Слагаемое2);
Однако выполнив этот запрос, мы увидели, что платформа выполняет данную арифметическую операции заранее, а результат передает все также через параметр. Следовательно, данный вариант не подойдет:
(@P1 numeric(10),@P2 numeric(10),@P3 numeric(10),@P4 numeric(10),@P5 numeric(10),@P6 numeric(10),@P7 numeric(10),@P8 numeric(10),@P9 numeric(10),@P10 numeric(10),@P11 numeric(10),@P12 numeric(10),@P13 numeric(10))
SELECT
T1._Q_000_F_000RRef,
T1._Q_000_F_001RRef,
T1._Q_000_F_003,
@P1,
T1._Q_000_F_004RRef,
T1._Q_000_F_005RRef,
ISNULL(CAST(T2._Fld19343 AS NUMERIC(8, 4)),1.0),
T3._Fld4356,
CASE WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001A6 THEN T4._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000018A THEN T5._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00006230 THEN T6._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000159 THEN T7._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000162 THEN T8._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001B3 THEN T9._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000019A THEN T10._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000174 THEN T11._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000015F THEN T12._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000185 THEN T13._Date_Time ELSE CAST(NULL AS DATETIME) END
FROM #tt34 T1 WITH(NOLOCK)
Мы не сдавались и попробовали выполнить арифметическую операцию с одним из полей временной таблицы. Например, с количеством:
ТекстЗапроса = "ВЫБРАТЬ
| ВТ_ОстаткиТоваров.Ингредиент КАК Ингредиент,
| ВТ_ОстаткиТоваров.Характеристика КАК Характеристика,
| ВТ_ОстаткиТоваров.Количество КАК Количество,
| ВТ_ОстаткиТоваров.Количество + &Слагаемое1 + &Слагаемое2 КАК ПараметрСниффинг,
| ВТ_ОстаткиТоваров.Партия КАК Партия,
| ЕСТЬNULL(ОбработкаСырья.Коэффициент, 1) КАК КоэффициентПартионныхПотерь
|ИЗ
| ВТ_ОстаткиТоваров КАК ВТ_ОстаткиТоваров
| ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.УОП_ОбработкаСырьяПартионная КАК ОбработкаСырья
| ПО ВТ_ОстаткиТоваров.Ингредиент = ОбработкаСырья.Ингредиент
| И ВТ_ОстаткиТоваров.Партия = ОбработкаСырья.Партия
| ЛЕВОЕ СОЕДИНЕНИЕ Справочник.ПартииНоменклатуры КАК ПартииНоменклатуры
| ПО ВТ_ОстаткиТоваров.Партия = ПартииНоменклатуры.Ссылка
|
|УПОРЯДОЧИТЬ ПО
| ПартииНоменклатуры.УОП_СрокГодности"; ГСЧ = Новый ГенераторСлучайныхЧисел(ТекущаяУниверсальнаяДатаВМиллисекундах());
Слогаемое1 = ГСЧ.СлучайноеЧисло(0, 429496729) + ГСЧ.СлучайноеЧисло(0, 4294967295);
Слогаемое1 = ГСЧ.СлучайноеЧисло(0, 429496725) + ГСЧ.СлучайноеЧисло(0, 4294967295); ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&Слогаемое1", Слогаемое1);
ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&Слогаемое2", Слогаемое2);
Выполнив данный запрос, мы получили долгожданный результат с изменением планов и текста запроса:

Основная часть текста запроса, которая была выполнена:
(@P1 numeric(10),@P2 numeric(10),@P3 numeric(10),@P4 numeric(10),@P5 numeric(10),@P6 numeric(10),@P7 numeric(10),@P8 numeric(10),@P9 numeric(10),@P10 numeric(10),@P11 numeric(10),@P12 numeric(10)) SELECT
T1._Q_000_F_000RRef,
T1._Q_000_F_001RRef,
T1._Q_000_F_003,
 ((T1._Q_000_F_003 + 23423.0) + 454631.0),
T1._Q_000_F_004RRef,
T1._Q_000_F_005RRef,
ISNULL(CAST(T2._Fld19343 AS NUMERIC(8, 4)),1.0),
T3._Fld4356,
CASE WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001A6 THEN T4._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000018A THEN T5._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00006230 THEN T6._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000159 THEN T7._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000162 THEN T8._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001B3 THEN T9._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000019A THEN T10._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000174 THEN T11._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000015F THEN T12._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000185 THEN T13._Date_Time ELSE CAST(NULL AS DATETIME) END FROM #tt34 T1 WITH(NOLOCK)
Мы выяснили, что арифметическая операция над полем решает данную проблему, а константы в полях преобразовываются в параметры, но что будет если просто вставить заранее верное условие в область ГДЕ? Т. е. когда значение параметров &Параметр1 и &Параметр2 равны. Тогда текст запроса выглядел бы так:
 ТекстЗапроса = "ВЫБРАТЬ
| ВТ_ОстаткиТоваров.Ингредиент КАК Ингредиент,
| ВТ_ОстаткиТоваров.Характеристика КАК Характеристика,
| ВТ_ОстаткиТоваров.Количество КАК Количество,
| &ПараметрСниффинг2 КАК ПараметрСниффинг,
| ВТ_ОстаткиТоваров.Партия КАК Партия,
| ЕСТЬNULL(ОбработкаСырья.Коэффициент, 1) КАК КоэффициентПартионныхПотерь
|ИЗ
| ВТ_ОстаткиТоваров КАК ВТ_ОстаткиТоваров
| ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.УОП_ОбработкаСырьяПартионная КАК ОбработкаСырья
| ПО ВТ_ОстаткиТоваров.Ингредиент = ОбработкаСырья.Ингредиент
| И ВТ_ОстаткиТоваров.Партия = ОбработкаСырья.Партия
| ЛЕВОЕ СОЕДИНЕНИЕ Справочник.ПартииНоменклатуры КАК ПартииНоменклатуры
| ПО ВТ_ОстаткиТоваров.Партия = ПартииНоменклатуры.Ссылка
|
|ГДЕ
| &ПараметрСниффинг1 = &ПараметрСниффинг2
|
|УПОРЯДОЧИТЬ ПО
| ПартииНоменклатуры.УОП_СрокГодности";
ЗначениеПараметра = Строка(Новый УникальныйИдентификатор);
ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&ПараметрСниффинг1", ЗначениеПараметра);
ТекстЗапроса = СтрЗаменить(ТекстЗапроса, "&ПараметрСниффинг2", ЗначениеПараметра);
Если посмотреть на выполняемый текст запроса, то можно увидеть, что условие преобразовалось в 1 = 1. Причем значения параметров не влияют на результат, т. е. можно передать ГУИД = ГУИД или Число = Число или АрифметическаяОперация1 = АрифметическаяОперация2 — все преобразовывается в 1 = 1. Даже если выполнять несколько пар с разными значениями.
Следовательно, динамическое изменение текста в данном случае не поможет:
(@P1 numeric(10),@P2 numeric(10),@P3 numeric(10),@P4 numeric(10),@P5 numeric(10),@P6 numeric(10),@P7 numeric(10),@P8 numeric(10),@P9 numeric(10),@P10 numeric(10),@P11 numeric(10),@P12 numeric(10))
SELECT
T1._Q_000_F_000RRef,
T1._Q_000_F_001RRef,
T1._Q_000_F_003,
T1._Q_000_F_004RRef,
T1._Q_000_F_005RRef,
ISNULL(CAST(T2._Fld19343 AS NUMERIC(8, 4)),1.0),
T3._Fld4356,
CASE WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001A6 THEN T4._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000018A THEN T5._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00006230 THEN T6._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000159 THEN T7._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000162 THEN T8._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001B3 THEN T9._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000019A THEN T10._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000174 THEN T11._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000015F THEN T12._Date_Time WHEN T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x00000185 THEN T13._Date_Time ELSE CAST(NULL AS DATETIME) END
FROM #tt34 T1 WITH(NOLOCK)
LEFT OUTER JOIN dbo._InfoRg19340 T2
ON ((T1._Q_000_F_000RRef = T2._Fld19341RRef) AND (T1._Q_000_F_004RRef = T2._Fld19342RRef)) AND (T2._Fld929 = @P1)
LEFT OUTER JOIN dbo._Reference181 T3
ON ((T1._Q_000_F_004RRef = T3._IDRRef)) AND (T3._Fld929 = @P2)
LEFT OUTER JOIN dbo._Document422 T4
ON (T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x000001A6 AND T3._Fld4354_RRRef = T4._IDRRef) AND (T4._Fld929 = @P3)
LEFT OUTER JOIN dbo._Document394 T5
ON (T3._Fld4354_TYPE = 0x08 AND T3._Fld4354_RTRef = 0x0000018A AND T3._Fld4354_RRRef = T5._IDRRef) AND (T5._Fld929 = @P4)
WHERE 1=1
ORDER BY (T3._Fld4356)
Несмотря на динамическое изменение текста запроса платформа «1С:Предприятие 8» дополнительно старается помочь оптимизировать количество построение планов. Из всех рассматриваемых нами вариантов лишь арифметическая операция над полем выборки позволила решить задачу принудительного перестроения планов запроса.
Выбрав данный вариант, мы сформировали патч, который исправлял исходное поведение и передали его клиенту. Спустя двое суток обращений от пользователей по зависанию сеансов не было. Как и замечаний по скорости выполнения.
Мы проанализировали события логирования в журнале регистрации и увидели, что все запросы, которые начинали выполняться — завершились. Что подтверждало факт отсутствия обращений от пользователей:

Исходя из этого можно сделать вывод, что причиной зависания сеансов оказались неверно подобранные планы, которые формируются в результате первого выполнения, затем кэшируются и уже не являются оптимальными для выполнения запроса с другими параметрами.
Стоит отметить, что в Microsoft SQL Server есть дополнительные возможности влияния на решения оптимизатора запроса. Одним из них является механизм хинтов.
Данных механизм переопределяет поведение оптимизатора запросов на время выполнения SQL-инструкции.
Однако, повлиять с помощью хинта со стороны платформы не получиться. Для этого потребуется настроить новое руководство планов (Plan Guides):


В результате оптимизатор запросов будет добавлять выбранный хинт к запросу. На картинке представлена команда запуска рекомпиляции плана, но в данное поле можно добавить уже фиксированный план. Подробнее про данный механизм можно прочитать в документации https://docs.microsoft.com/ru-RU/sql/relational-databases/performance/plan-guides?view=sql-server-ver15.
Альтернативный способ — Force plan
Альтернативным способом решения задачи может стать Force Plan от MS SQL. Таким подходом можно воспользоваться, например, когда нельзя вносить изменения в типовое решение, стоящее на поддержке.
Force plan это функционал блока Query Store, который появился в версии SQL Server 2016 CTP2. Query Store — это хранилище планов запросов и статистической информации для каждой базы данных в отдельности.
В отличие от кэша планов, оно может хранить несколько планов на запрос в течении времени, указанного в настройках. т. е. если план запроса менялся по одному и тому же запросу в течение этого времени, то мы увидим все эти планы, а также связанную статистику производительности для каждого из них. Затем, используя эту информацию, мы можем выбрать оптимальный план и «форсировать» его, что означает принудительное использование этого плана для выполняемого запроса.
Проведём подготовительные работы для использования Force plan
Для включения функции Query Store необходимо в настройках базы установить Operation mode в режим Read Write, т. е. сервер будет как собирать, так и сохранять данные запросов:

Коротко о настройках Query Store:
General