
6 текстовых редакторов на все случаи жизни
Подготовили обзор сервисов, незаменимых в работе с текстом.
Редактирование текста перед публикацией на сайте требует не только безупречного владения грамматикой. Чтобы процесс оформления статей отнимал минимум времени, а работа с HTML приносила удовольствие, стоит изначально изучить особенности десятков текстовых редакторов.
Представляем подборку популярных сервисов, способных упростить жизнь профессиональному автору, редактору, программисту и контент-менеджеру.
Оксана Корсун
Директор по маркетингу cтудии Дмитрия Димбровского
Графическое оформление
Sublime Text 3
Текстовый редактор, который поддерживает плагины на языке программирования Python. Работает под Linux, Windows и Mac OS X.
Основные преимущества софта заключаются в отличном юзабилити и расширенном функционале.
- Физическая «легкость» и техническая «мощность»: позволяет быстро писать код, сохраняя в качестве заготовок часто используемые конструкции.
- Подсветка синтаксиса и высокая контрастность: основные текстовые элементы выделяются разными цветами.
- Быстрый запуск и автоматическое сохранение: никаких проволочек и паники при внезапном отключении компьютера.
- Высокая организационная схема: существуют различные сплит-экраны для тестовой разработки (Python — на одном, текстовые скрипты — на другом) или front-end’а (HTML и CSS/Javascript).
- Поддержка большого количества языков программирования: C, C++, C#, CSS, D, Dylan, Erlang, HTML, Groovy, Haskell, Java, JavaScript, LaTeX, Lisp, Lua, Markdown, MATLAB, OCaml, Perl, PHP, Python, R, Ruby, SQL, TCL и XML.
Единственный недостаток — при расширении функциональности не обойтись без такой программы, как Package Control.
Boxer Text Editor
Создан для работы как в Windows, так и Linux или Mac.
Преимущества:
- Встроенный английский словарь на 140 тысяч слов.
- FTP- и HTML-поддержка.
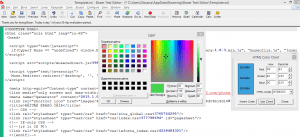
- Красочная диаграмма HTML-кода.
- Вариативность настроек.
Недостатки:
- 422 кнопки: такое разнообразие может считаться как плюсом, так и поводом для замешательства — на панель можно вынести лишь 22 из них.
- Непривычное диалоговое окно, что, впрочем, больше касается юзабилити, чем функциональности.
- Не поддерживает популярный нынче юникод UTF-8.
TextPad
Позволяет наладить работу с текстами, даже если вы часто отвлекаетесь и работаете «в режиме Наполеона»: открывайте несколько файлов и возвращайтесь в нужное место после каждого нового запуска.
Преимущества:
- Идеальная визуализация в виде подсветки тегов, атрибутов и их значений выбранными пользователем цветами.
- Удобное переключение между окнами.
- Предоставлен перечень популярных тегов, присутствуют блоки-заготовки — оптимально при написании кода новичком.
Недостатки:
- Проверка не является интеллектуальной, что часто влечет за собой ошибки при подсветке кода.
Грамматика и стилистика
Optima
Позволяет сфокусироваться на информативности статей, затем способен копировать текст с сохранением изначального форматирования.
Преимущества:
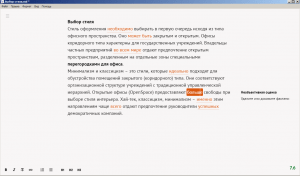
- Простота интерфейса: в вашем распоряжении понятное структурированное меню и заметные горячие клавиши.
- Удобство при создании объёмных черновиков: просто выбираете режим «Дзен» и излагаете свои мысли.
- Сохранение параметров текста при копировании: Optima распознает заголовки и подзаголовки, толщину шрифта, ссылки и списки.
- Быстрый экспорт HTML за счёт установки кода в один клик мышки.
- Минималистическое оформление: нет элементов, отвлекающих от работы с текстом.
- Тщательная проверка на ошибки: любой текст можно «исследовать» с помощью интегрированной программы «Главред» и даже найти больше недочетов, чем можно было ожидать.
Недостатки:
- Ограниченные возможности в оформлении текста, небольшой набор опций.
- Незначительные сложности в использовании: например, при переключении на другие вкладки программа немного «подвисает».
- Скудная графическая составляющая.
English Syntax Highlighter
Синтаксическая подсветка, широко используемая в программировании. Разные части речи она выделяет разными цветами. Стоп-слова, которые «загрязняют» текст, при этом остаются серыми.
Преимущества:
- Является превосходным лексическим анализатором.
- Проста в использовании, не требует установки.
- Эффективна в работе с текстами больших объёмов.
- Облегчает восприятие, предоставляет возможность повысить читабельность.
- Может использоваться при написании программных кодов и в разметке документов.
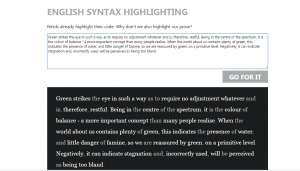
Недостатки: это узконаправленная программа, которая анализирует только лексику.
Читать также

профессия
Коммерческий редактор
Узнать больше
- Научитесь создавать полноценные информационные продукты и решать бизнес-задачи с помощью контента
- Освойте работу с текстом и изображениями, типографику и вёрстку, управление командой
- Две модуля на выбор — получите знания, необходимые именно вам
Универсальные программы
Crimson Editor
Кроме стандартных функций проверки орфографии и подсветки синтаксиса для работы с программным кодом, отличается перечнем «полезностей».
Преимущества:
- Структурирование на абзацы и мультиколоночный ввод.
- Интеграция с другими программами и возможность работать с файлами через FTP-соединение.
- Набор дополнительных инструментов, в том числе калькулятор.
- Удобный поиск по тексту и оперативный поиск сохранённых ранее проектов.
- Аккуратное оформление страницы при печати документа. Опция создания закладок.
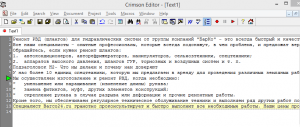
Недостатки:
- Форматировать текст в программе неудобно, с первых секунд вам захочется открыть привычный Word.
- Оптимальна лишь для решения сложных задач, связанных с программированием.
Читать также
Не забудьте про то, что машина — не человек
Порой человеческий фактор мешает объективно оценивать смысловую нагрузку статьи, а уставшие глаза пропускают опечатки. Что уж говорить об экспортировании материалов в программный код — здесь без точного и функционального сервиса не обойтись.
Но ни один текстовый редактор не заменит тщательную проверку, выполненную специалистом. Для профессиональной оценки текстов и их использования в разных целях стоит изучить как минимум 6 вышеперечисленных редакторов, подобрав главного «помощника» с учетом специфики своей работы.
Хотите написать колонку для Нетологии? Читайте наши условия публикации. Чтобы быть в курсе всех новостей и читать новые статьи, присоединяйтесь к Телеграм-каналу Нетологии.
Оксана Корсун
Директор по маркетингу cтудии Дмитрия Димбровского
Компилятор
Компилятор — это программа, которая переводит текст, написанный на языке программирования, в машинные коды. С помощью компиляторов компьютеры могут понимать разные языки программирования, в том числе высокоуровневые, то есть близкие к человеку и далекие от «железа».
«IT-специалист с нуля» наш лучший курс для старта в IT
Процесс работы компилятора с кодом называется компиляцией, или сборкой. По сути, компилятор — комплексный «переводчик», который собирает, или компилирует, программу в исполняемый файл. Исполняемый файл — это набор инструкций для компьютера, который тот понимает и может выполнить.
Языки программирования, для перевода которых используются компиляторы, называются компилируемыми.
Для чего нужен компилятор
Изначально компьютер не понимает смысл написанного на любом языке программирования. Язык компьютера — машинные коды, нули и единицы, в которых зашифрована информация и команды. Писать на машинных кодах программы практически невозможно: даже простейшее действие будет отнимать много часов работы программиста. Поэтому появились языки программирования, более понятные для людей, и специальные программы, которые переводят эти языки в машинные коды. Эти программы и есть компиляторы.
Без компилятора любой код на компилируемом языке программирования будет для компьютера просто текстом — он не распознает команды и не сможет их выполнить. Поэтому компилятор нужен, чтобы программы могли выполняться. Без него ничего не будет работать.
Еще одна задача компилятора — собрать все модули, например подключенные библиотеки, в единый файл. Нужно, чтобы исполняемый файл содержал в себе все необходимое для нормальной работы программы и полного выполнения инструкций.
Профессия / 8 месяцев
IT-специалист с нуля
Попробуйте 9 профессий за 2 месяца и выберите подходящую вам
Компилятор и интерпретатор: в чем разница
Компиляция — не единственный подход к «переводу» человекопонятного языка программирования на машинный. Еще есть интерпретаторы и байт-код, но там технологии совсем другие.
Интерпретатор — это тоже программа, которая «переводит» текст на высокоуровневом языке программирования, но делает это иначе. Она не собирает весь код в один исполняемый файл для последующего запуска, а исполняет код сразу, построчно. Это чуть медленнее, но иногда удобнее. Языки, использующие интерпретаторы, называются интерпретируемыми.
Байт-код — «промежуточное звено» между подходами компиляции и интерпретации. Программа преобразуется в особый код, который запускается под специальной виртуальной машиной. Языков, которые работают так, относительно немного, самый известный и яркий пример — Java.
В каких языках используются компиляторы
Среди популярных сегодня языков компилируемыми являются Swift и Go, а также C / C++ и Objective-C. Другие примеры — Visual Basic, Haskell, Pascal / Delphi, Rust, а также Lisp, Prolog и прочие менее известные языки. Разумеется, компилируемым является и язык ассемблера — очень низкоуровневый и написанный напрямую на машинных кодах.
Отдельно можно выделить языки, которые трансформируются в байт-код — это тоже своего рода компиляция. К ним относятся Java, Scala и Kotlin, а также C# и языки платформы .NET.
Курс для новичков «IT-специалист
с нуля» – разберемся, какая профессия вам подходит, и поможем вам ее освоить
На каких языках пишут компиляторы
Другие языки. Писать компилятор на машинном коде тяжело и долго, порой практически невозможно. Поэтому их пишут на уже существующих языках: получается, что большинство языков написано на других.
Например, один из компиляторов языка Go частично написан на C++, самый первый компилятор C++ — на ассемблере, а уже ассемблер — на машинных кодах.
Тот же язык. Написать компилятор для языка программирования можно на других версиях того же языка — такой подход разрешен и активно используется в разработке. Это нужно, чтобы компиляторы были более гибкими и «умными» и могли поддерживать больше возможностей, — ассемблер довольно примитивен и не решает всех задач.
Выглядит это так:
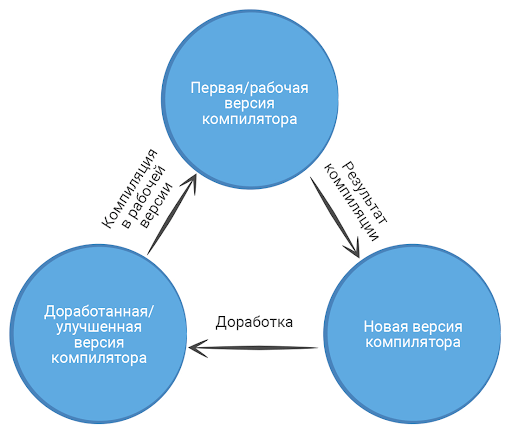
- первый, более простой компилятор пишется на ассемблере;
- второй пишется уже на нужном языке и компилируется первым компилятором;
- переведенный в машинные коды второй компилятор компилирует свои же исходники — получается более новая и мощная версия его же.
Например, большинство современных компиляторов для C / C++ написано на C / C++. Такие компиляторы называют самокомпилируемыми.
Почему у одного языка может быть несколько компиляторов
У большинства языков программирования несколько компиляторов. Их еще называют реализациями. Изначальную реализацию пишет создатель языка, потом со временем появляются альтернативные. Зачем это делается? Цели могут быть разными:
- написать более современный и функциональный компилятор, обновить язык;
- оптимизировать язык и сделать его эффективнее;
- создать свободную реализацию, которую сможет дополнять сообщество;
- исправить ошибки, которые есть в существующих реализациях;
- перенести язык на другую платформу, и так далее.
Подходы к оптимизации, портированию и выполнению других целей у всех групп разработчиков свои. Поэтому разные компиляторы одного и того же языка могут различаться скоростью, особенностями архитектуры, назначением и другими параметрами. Синтаксис языка при этом остается таким же, но есть особые ситуации, когда одна и та же строчка может выполняться по-разному в зависимости от компилятора.
Какими бывают компиляторы
Компиляторы очень многообразны. Есть такие, которые имеют узкую специализацию, например запускаются только под процессоры определенного семейства и оптимизированы под них. Есть и более широкие — так называемые кросс-компиляторы, которые могут поддерживать несколько операционных систем.
Один компилятор может «знать» несколько языков программирования. Яркий пример такого решения — GCC, или GNU Compiler Collection, кросс-компилятор для нескольких операционных систем и языков, полностью бесплатный и свободный. На нем написано программное обеспечение GNU.
Существуют и так называемые компиляторы компиляторов. Они генерируют компиляторы для языка на основе его формального описания.
Курс для новичков «IT-специалист
с нуля» – разберемся, какая профессия вам подходит, и поможем вам ее освоить
Как устроены и работают компиляторы
Простыми словами, они «читают» пришедшую к ним на вход программу и переводят ее команды в соответствующие им наборы машинных кодов. Детали уже сложнее и различаются в зависимости от реализации. Например, есть модульные гибкие компиляторы, написанные на высокоуровневых языках, есть отладочные компиляторы, способные устранять часть синтаксических ошибок, и так далее.
Сама компиляция может быть:
- построчной — в машинный код по очереди переводится каждая строка, что похоже на интерпретацию, но отличается технически;
- пакетной — код разбивается на блоки, или пакеты, и компилируется поблочно;
- условной — особенности компиляции зависят от условий, которые прописаны в исходном коде компилируемой программы.
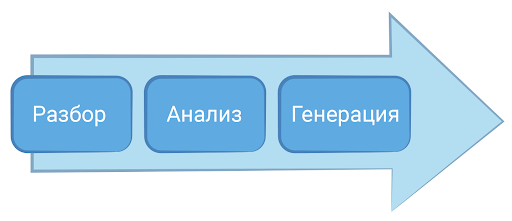
Сначала компилятор разбирает, что написано, потом анализирует команды, а потом генерирует машинные коды. Он не запускает программу, запуск — это отдельное действие.
Преимущества компилируемых языков
- Компилируемые языки обычно быстрее, чем интерпретируемые, и их легче оптимизировать.
- Итоговый размер кода у компилируемых языков, как правило, меньше, чем у интерпретируемых.
- В компилируемых языках намного шире возможность контролировать аппаратные ресурсы. Это не значит, что они все низкоуровневые, но обратное — верно: практически все низкоуровневые языки — компилируемые.
- Когда процессоры становятся мощнее, именно компилируемые языки могут в должной мере задействовать их преимущества.
- Код после компилятора лучше оптимизируется под конкретные устройства, архитектуру «железа», эффективно задействует память и не тратит лишних ресурсов.
- Компилируемые языки обычно мощные и высокопроизводительные, поэтому на них пишут игры и другие серьезно нагруженные приложения.
Недостатки компилируемых языков
- В отличие от интерпретируемых языков, компилируемые не выполняют код сразу — его сначала нужно собрать, а это лишний шаг и лишнее время.
- Код сложнее в отладке: приходится заново компилировать его при каждом, даже небольшом изменении. Сам процесс поиска и устранения ошибок бывает довольно неочевидным.
- Машинный код жестко связан с архитектурой платформы и различается в зависимости от системы. Поэтому компилируемые языки — по умолчанию не кроссплатформенные. Для переноса языка на другую операционную систему понадобится писать новый компилятор. Правда, есть исключения в виде универсальных кросс-компиляторов, работающих под разными платформами, но они подходят не для всего.
- Для новичков проблема еще и в том, что компилируемые языки часто сложнее, чем интерпретируемые. Изучать их с нуля может быть тяжело, хотя и тут есть исключения.
Как пользоваться компилятором
Начинающий разработчик редко взаимодействует с компилятором напрямую. Он скачивает язык программирования, в том числе его компилятор, а потом работает в редакторе кода или IDE. Среда разработки сама запускает компилятор каждый раз, когда пользователь кликает на кнопку сборки или выполнения программы. Для этого его не нужно вызывать вручную. Иногда среда может сама включать в себя несколько компиляторов и выбирать подходящий в каждом случае.
Поэтому трогать компилятор на ранних этапах не имеет смысла — просто стоит помнить, что он есть, чтобы лучше разбираться в происходящем. Но он может пригодиться, если вы захотите скомпилировать что-то без среды разработки, например прямо в командной строке. Тогда его придется вызвать с помощью специальной команды — она своя для каждого решения.
У любого ПО есть документация, так что, если вы хотите узнать больше о компиляторе, которым пользуетесь, можете прочитать ее.
Узнайте больше об устройстве и работе языков программирования на курсах — получите новую профессию и станьте востребованным IT-специалистом.
IT-специалист с нуля
Наш лучший курс для старта в IT. За 2 месяца вы пробуете себя в девяти разных профессиях: мобильной и веб-разработке, тестировании, аналитике и даже Data Science — выберите подходящую и сразу освойте ее.
Статьи по теме:
- Функциональные языки программирования
- Objective-C
- Синтаксис
О статистическом тестировании блочных шифров Текст научной статьи по специальности «Математика»
Блочные шифры образуют один из основных классов криптографических алгоритмов. Одной из важнейших задач, возникающих в процессе разработки блочных шифров, как и любых других криптографических алгоритмов, является анализ их криптостойкости. В процессе такого анализа часто применяется статистическое тестирование блочных шифров . Обзору литературы, связанной с вопросами статистического тестирования блочных шифров , посвящена настоящая работа.
i Надоели баннеры? Вы всегда можете отключить рекламу.
Похожие темы научных работ по математике , автор научной работы — Ключарёв П.Г.
Статистическое тестирование российского стандарта функции хэширования ГОСТ 34. 11-2012 («Стрибог»)
Статистический анализ поточных шифров
Метод оценки качества криптостойких генераторов псевдослучайных последовательностей
Построение псевдослучайных функций на основе обобщённых клеточных автоматов
Тесты псевдослучайных последовательностей и реализующее их программное средство
i Не можете найти то, что вам нужно? Попробуйте сервис подбора литературы.
i Надоели баннеры? Вы всегда можете отключить рекламу.
On Statistical Testing of Block Ciphers
Block ciphers form one of the main classes of cryptographic algorithms. One of the challenges in development of block ciphers, like any other cryptographic algorithms, is the analysis of their cryptographic security. In the course of such analysis, statistical testing of block ciphers is often used. The paper reviews literature on statistical testing of block ciphers.
Текст научной работы на тему «О статистическом тестировании блочных шифров»
Математика U Математическое
Сетевое научное издание http://mathmelpub.ru ISSN 2412-5911
УДК 004.056.55 О статистическом тестировании
Ссылка на статью:
// Математика и математическое моделирование. 2018. №5. С. 35-56.
Представлена в редакцию: 13.08.2018 © НП >
* pk.iu8@yandex.ru 1МГТУ им. Н.Э. Баумана, Москва, Россия
Блочные шифры образуют один из основных классов криптографических алгоритмов. Одной из важнейших задач, возникающих в процессе разработки блочных шифров, как и любых других криптографических алгоритмов, является анализ их криптостойкости. В процессе такого анализа часто применяется статистическое тестирование блочных шифров. Обзору текущего состояния области, связанной с таким тестированием, посвящена настоящая работа. Кратко упоминаются основные определения понятия случайной последовательности, дается обзор наборов статистических тестов. Рассматриваются методики статистического тестирования блочных шифров, в том числе, методика Ш8Т (использованная, в частности, для тестирования шифров на конкурсе ЛБ8). Делается вывод о том, что в настоящее время вопрос о построении методик статистического тестирования блочных шифров исследован недостаточно и необходима разработка новых методик такого тестирования.
Ключевые слова: статистическое тестирование; случайность; блочный шифр
Блочные шифры имеют очень широкое применение в различных задачах информационной безопасности и образуют один из основных классов криптоалгоритмов. В процессе разработки таких шифров возникает задача анализа их криптографических свойств, одним из этапов которого является статистическое тестирование. Надо сказать, что это, по-видимому, единственный этап анализа блочных шифров, который можно существенно автоматизировать. Однако для его выполнения нужна методика статистического тестирования. Причем для того, чтобы результаты такого тестирования различных шифров можно было сравнивать, желательно иметь стандартизованную методику. Обзору литературы, связанной с вопросами статистического тестирования блочных шифров, посвящена настоящая работа.
Основной метод статистического тестирования блочных шифров заключается в том, что на основе тестируемого блочного шифра создаются различные генераторы псевдослучайных последовательностей, посредством которых порождаются последовательности, которые и подвергаются статистическому тестированию. Здесь важным является то, как эти генераторы устроены и посредством каких тестов производится тестирование последовательностей.
Поэтому в данной статье кратко описываются различные наборы статистических тестов и рассматриваются различные методики статистического тестирования блочных шифров.
1. Случайные последовательности
Отметим, что в данной работе мы рассматриваем равномерно распределенные двоичные случайные (и псевдослучайные) последовательности, для краткости называя их просто случайными (соответственно, псевдослучайными) последовательностями.
Существуют разные определения понятия генератора псевдослучайных последовательностей (см., например, монографию [1]). Иногда говорят о генераторе псевдослучайных последовательностей в строгом смысле. Генератор псевдослучайных последовательностей в строгом смысле — это алгоритм, который принимая на вход ключ, генерирует двоичную последовательность, такую, что не существует полиномиального относительно длины ключа вероятностного алгоритма, отличающего ее от последовательности, сгенерированной генератором истинно случайных последовательностей, с вероятностью отличающейся от 2 более, чем на пренебрежительно малую величину.
К сожалению, не доказано существование генераторов псевдослучайных последовательностей в строгом смысле. Поэтому на практике в криптографии используется ослабленное определение генератора псевдослучайной последовательности, которым мы и будем пользоваться в настоящей работе: генератором псевдослучайной последовательности будем называть алгоритм, который принимая на вход ключ постоянной длины, генерирует такую двоичную последовательность, что лучший известный алгоритм, отличающий ее от последовательности, сгенерированной генератором истинно случайных последовательностей, имеет большую вычислительную сложность. Под большой вычислительной сложности могут пониматься разные вещи. В частности, часто (но не всегда) под ней понимается сложность перебора всех возможных ключей.
В определении генератора псевдослучайных последовательностей используется понятие генератора истинно случайных последовательностей. Однако с определением понятия случайной последовательности имеются большие сложности. Подходов к определению этого понятия известно не менее четырех: Колмогорова, Мартин-Лёфа, фон Мизеса и подход, связанных с непредсказуемостью. И все они таковы, что их нельзя использовать на практике.
В этом разделе мы кратко и неформально рассмотрим подходы к определению понятия случайной последовательности. Связанной с ними теории посвящены, в частности, монографии [2, 3, 1,4, 5]).
Колмогоровской сложностью слова над конечным алфавитом называется длина кратчайшего описания этого слова. К сожалению, колмогоровская сложность определена лишь с точностью до константы. Ситуация серьезно усугубляется тем, что колмогоровская сложность невычислима. Невычислима даже любая нетривиальная нижняя оценка колмогоров-ской сложности.
Рассматривая колмогоровскую сложность, можно ограничиться некоторым семейством языков описания. Языком описания называется множество пар (а, Ь), где слово а является описанием для слова Ь. Будем говорить, что слова г и в согласованы, если одно из них является началом другого. Язык описания называется монотонным, если он перечислим и для любых двух его элементов (а1, Ь\), (а2, Ь2), у которых слова а1 и а2 согласованы, слова Ь1 и Ь2 также являются согласованными. Длина кратчайшего описания слова х посредством языка из семейства монотонных языков описания называется монотонной колмогоровской сложностью слова х и обозначается КМ(х).
Несмотря на невычислимость колмогоровской сложности, именно на ней основан очень важный подход к определению понятия случайности. Бесконечная последовательность х\, х2, .. . символов двоичного алфавита называется случайной по Колмогорову [6] (или хаотической), если существует такая константа с, что КМ(х1, х2. хк) ^ к — с для любого к. Неформально говоря, последовательность случайна по Колмогорову, если лучшим способом ее описания является простое перечисление ее членов.
Множество случайных по Колмогорову последовательностей может быть введено и с помощью другого подхода — как множество типичных последовательностей, т.е. последовательностей, принадлежащих любому разумному большинству. Это определение принадлежит Мартин-Лёфу [7] (за строгим определением понятия «разумного большинства» отошлем заинтересованного читателя, например, к книге [5]).
Другой подход к определению понятия случайности был предложен фон Мизесом [8]. Бесконечная последовательность над алфавитом А называется случайной по фон Мизесу (или стохастической), если вероятности каждого символа в начальном отрезке Ь1, .. ., Ьк любой допустимой бесконечной подпоследовательности Ь1, Ь2. . этой последовательности стремятся к щ при к ^ то. Здесь важным является определение допустимости подпоследовательности (сам фон Мизес не дал строгого определения, но такие определения были даны Чёрчем и Колмогоровым, причем определения не эквивалентные).
Еще один подход к определению понятия случайности — непредсказуемость. Неформально говоря, последовательность является непредсказуемой, если в каком бы порядке мы не выбирали элементы этой последовательности, знание уже выбранных элементов не позволит предсказывать следующий выбираемый элемент. Строгое определение этого понятия, основанное на теории игр, предложено в работе [9].
Известен ряд теорем о том, как соотносятся между собой упомянутые подходы к определению случайности (см., например, [5]), но их подробное обсуждение выходит за рамки настоящей работы.
Вокруг каждого из этих подходов существует большая теория и множество нерешенных задач. Вместе с тем ясно, что все приведенные определения случайной последовательности являются неконструктивными в том смысле, что их невозможно напрямую применить для проверки данной последовательности на случайность. Поэтому на практике приходится ограничиваться тестированием статистических свойств последовательностей.
Тем не менее перечисленные выше подходы к определению случайности оказываются в некоторой степени полезными для практических целей. Например, несмотря на то, что нижние оценки колмогоровской сложности невычислимы, верхние ее оценки являются вычислимыми и их вполне можно использовать для оценки случайности последовательностей на практике. Например, сжатие последовательности тем или иным алгоритмом сжатия (например, Лемпеля — Зива) может рассматриваться как такая верхняя оценка — случайная последовательность не должна сжиматься. Другой пример такой верхней оценки — линейная сложность последовательности. Кроме того, подход фон Мизеса, связанный с вероятностями символов в подпоследовательностях, можно использовать, вычисляя частоты символов в тех или иных подпоследовательностях и оценивая с их помощью соответствующие распределения вероятностей.
2. Наборы статистических тестов двоичных последовательностей
Статистическое тестирование последовательности—задача, часто возникающая на практике. Особую важность эта задача имеет в области криптографии. Для ее решения на практике используют наборы статистических тестов. По-видимому, первый из таких наборов предложил Д. Кнут в 1969 г. (во втором томе известнейшей своей монографии «The Art of Computer Programming»; сошлемся здесь на современное русскоязычное издание: [10]).
Каждым статистическим тестом решается задача проверки гипотезы о случайности входной последовательности (это нулевая гипотеза; альтернативная гипотеза — то, что последовательность не является случайной). При этом задается уровень значимости а, т.е. вероятность ложноотрицательного результата. В качестве значения а часто используются значения 0.01; 0.001. Каждый статистический тест на основе данных вычисляет так называемое P-значение (P-value) — вероятность того, что идеальный генератор случайных последовательностей сгенерирует последовательность «менее случайную», чем данная, с точки зрения этого теста. Гипотеза о случайности принимается, если P-value ^ а, а в противном случае — отвергается.
При тестировании генератора псевдослучайных последовательностей тестируется большое число выработанных им последовательностей некоторой длины (например, в наборе NIST STS рекомендуемая длина последовательности составляет 1000000 битов). Если доля прошедших тест последовательностей достаточно велика и P-значения распределены равномерно, то делается вывод о том, что генератор проходит этот тест.
В настоящее время наиболее известны следующее наборы статистических тестов (реализованные в виде программного обеспечения), предназначенные для статистического тестирования двоичных последовательностей:
• DieHard [11] — набор статистических тестов, разработанный математиком из США Дж. Марсальей. Доступна также расширенная свободная реализация этих тестов DieHarder [12].
• NIST Statistical Test Suite (NIST STS) [13, 14, 15] — набор статистических тестов, разработанный в NIST.
• TestU01 [16] — набор статистических тестов, разработанный в Монреальском университете.
• RaBiGeTe [17] — набор статистических тестов, снабженный удобным GUI для Windows, разработанный в Италии.
• PractRand [18] — набор статистических тестов, разработанный программистом из США К. Доти-Хамфри.
Кроме перечисленных существует еще несколько наборов статистических тестов (например, Crypt-X, Ent и др.), которые в настоящее время по разным причинам редко используются и не поддерживаются.
Приведем здесь краткие описание принципов работы тестов, входящих в вышеупомянутые наборы.
Набор DieHard [11] состоит из следующих тестов:
• Тест промежутков между днями рождения (Birthday Spacings Test). Если случайно выбрать m дней рождений в «году» из n дней и рассмотреть список промежутков между днями рождения, то окажется, что число j элементов этого списка, встречающихся более чем один раз, асимптотически распределено по Пуассону. Тест состоит в том, что тестируемая последовательность интерпретируется как последовательность таких «дней рождения» и проверяется соответствие распределения значений j ожидаемому для случайной последовательности. Название теста связано с известным парадоксом дней рождения.
• Тест пересекающихся перестановок (Overlapping permutations). Рассматривает тестируемую последовательность как последовательность 32-разрядных чисел. Проверяет распределение всех возможных перестановок пяти последовательных чисел из этой последовательности (все 5! перестановок должны быть равновероятны).
• Тест рангов матриц (Ranks of matrices). Тестируемая последовательность трактуется как последовательность бинарных матриц (в разных вариантах теста используются матрицы разных размеров: 6 х 8, 31 х 31, 32 х 32). Вычисляются ранги этих матриц. Их распределение проверяется на соответствие ожидаемому.
• Обезьяньи тесты (Monkey Tests). Тестируемая последовательность интерпретируется как последовательность пересекающихся двоичных слов определенной длины. Последовательность этих слов делится на подпоследовательности. Для каждой из них вычисляется число слов, которые в нее не входят. Распределение этого значения проверяется на соответствие ожидаемому для случайной последовательности.
• Подсчет числа единиц в потоке байтов (The count-the-1’s test on a stream of bytes). Рассматривается последовательность весов байтов тестируемой последовательности. Из нее получается последовательность букв A, B, C, D, E, путем замены 0, 1, 2 на A, 3 на B, 4 на C, 5 на D, а 6, 7, 8 на E. Вычисляются частоты для каждого слова длины 5 (всего 55
слов). Полученные частоты проверяются на соответствие вероятностям слов ожидаемым для случайной последовательности.
• Подсчет числа единиц в некоторых байтах (The count-the-1’s test for specific bytes). Аналогичен предыдущему, однако выбирается не каждый байт последовательности, а некоторые указанные 8 бит из каждого 32-битного слова.
• Тест на парковку (Parking Lot Test) — В квадрате размера 100 х 100 случайным образом (случайные числа формируются из тестируемой последовательности) размещаются («паркуются») единичные окружности. Если очередная окружность пересекается с уже имеющейся в квадрате окружностью, то итерацию заканчивают. Всего производят 12000 таких итераций, после чего сравнивают распределение числа успешно припаркованных окружностей с ожидаемым (оно должно быть близким к нормальному).
• Тест на минимальное расстояние (Minimum Distance Test) — 8000 точек случайным образом (случайные числа формируются из тестируемой последовательности) размещаются в квадрате размера 10000 х 10000, после чего рассматриваются расстояния между каждой парой точек и выбирается минимальное среди них. Выполняется 100 таких итераций. Квадрат минимального расстояния должен иметь распределение близкое к экспоненциальному.
• Тест случайных сфер (Random Spheres Test). В кубе, ребро которого равно 1000, случайным образом выбираются 4000 точек (случайные числа формируются из тестируемой последовательности). В каждую из этих точек помещается центр сферы, радиус которой равен расстоянию до ближайшей точки. Таких итераций совершается определенное число и проверяется близость распределения объема шара, ограниченного минимальной из этих сфер, к ожидаемому для случайной последовательности.
• Тест сжатия (The Squeeze Test). Из тестируемой последовательности генерируются вещественные числа u Е [0, 1), далее находится такое минимальное i, что ti = 1, где ti+1 = \tiu], to = 231. Производится определенное число таких операций, после чего распределение величины i проверяется на соответствие ожидаемому.
• Тест пересекающихся сумм (Overlapping Sums Test). На основе тестируемой последовательности генерируется последовательность вещественных чисел u1, u2, . Е [0, 1).
Вычисляются значения si = J2 uj, i =1, 2, . Специальным образом проверяется соот-
ветствие их распределения ожидаемому.
• Тест последовательностей (Runs Test). На основе тестируемой последовательности генерируется последовательность вещественных чисел. В ней производится подсчет количества непрерывных монотонных (возрастающих и убывающих) подпоследовательностей. Проверяется соответствие распределений этих количеств ожидаемому.
• Тест игры в кости (The Craps Test) — на основе тестируемой последовательности берутся данные для игры в крэпс (craps, вид игры в кости). Для достаточно большого числа таких игр подсчитываются число побед и число бросков. Проверяется соответствие распределений этих чисел ожидаемым.
Отметим, что во многих тестах здесь и далее проверяется соответствие распределения некоторой выборки, вычисленной на основе тестируемой последовательности, распределению, которое ожидается в том случае, если тестируемая последовательность является случайной. В большинстве случаев эта проверка осуществляется либо на основе критерия X2, либо (реже) на основе критерия Колмогорова — Смирнова.
Набор тестов DieHard появился достаточно давно (в 1995 г.) и снискал большую известность, поскольку он является фактически первым широко известным набором статистических тестов, который можно было использовать для статистического тестирования криптографических алгоритмов. Однако он не свободен от недостатков — выбор входящих в него тестов довольно неоднозначный и интерпретация их результатов бывает подчас затруднительной, а программная реализация страдает ошибками.
Более новым и более широко используемым набором тестов является NIST STS [13, 14, 15]. Он состоит из 15 статистических тестов:
• Частотный побитовый тест (Frequency Monobit Test). Проверяет, что в тестируемой последовательности число единиц приблизительно равно числу нулей.
• Частотный блочный тест (Frequency Test within a Block). Делит последовательность на блоки одинаковой длины, и проверяет равномерность распределения числа единиц в этих блоках.
• Тест на последовательность одинаковых битов (Runs Test). Рассматривает отклонение числа непрерывных серий от ожидаемого для случайной последовательности (под непрерывной серией длины t понимается последовательность из t единиц, ограниченная нулями, либо последовательность из t нулей, ограниченная единицами).
• Тест на самую длинную последовательность единиц в блоке (Test for the Longest Run of Ones in a Block). Разбивает тестируемую последовательность на блоки фиксированной длины, и проверяет соответствие распределения максимальных длин непрерывных последовательностей из единиц внутри блоков ожидаемому для случайной последовательности.
• Тест рангов бинарных матриц (Binary Matrix Rank Test). Тестируемая последовательность разбивается на подпоследовательности некоторой длины, из которых составляется двоичная матрица. Тест проверяет соответствие количеств матриц максимального ранга и матриц ранга на единицу меньше максимального ожидаемым для случайной последовательности. Аналогичный тест имеется в наборе DieHard.
• Тест дискретного преобразования Фурье (спектральный тест, Discrete Fourier Transform (Spectral) Test). Биты последовательности рассматриваются как вещественные числа, при этом каждый 0 заменяется на -1. От полученной последовательности вычисляется дискретное преобразование Фурье. Проверяется близость числа спектральных компонент, амплитуда которых превышает 95% к ожидаемому для случайной последовательности.
• Тест на совпадение неперекрывающихся шаблонов (Non-overlapping Template Matching Test). Проверяется соответствие числа повторений некоторой фиксированной подпоследо-
вательности (ее называют шаблоном) в тестируемой последовательности ожидаемому. При этом для поиска шаблона длины t применяется скользящее окно: если шаблон не обнаружен, то окно сдвигается на одну позицию, а если обнаружен — на t позиций.
• Тест на совпадение перекрывающихся шаблонов (Overlapping Template Matching Test). Аналогичен тесту на совпадение неперекрывающихся шаблонов, за исключением того, что окно всегда сдвигается на одну позицию.
• Универсальный статистический тест Маурера (Maurer’s Universal Statistical Test). Вычисляет сумму логарифмов расстояний между одинаковыми шаблонами в последовательности и проверяет ее близость к ожидаемой для случайной последовательности. Фактически этот тест проверяет невозможность сжатия последовательности. Он позволяет выявлять широкий класс статистических дефектов, поэтому называется универсальным [19].
• Тест на линейную сложность (Linear Complexity Test). Линейной сложностью последовательности называется наименьшая длина регистра сдвига с линейной обратной связью, ее порождающего. Тестируемая последовательность разделяется на подпоследовательности определенной длины. Для каждой из них вычисляется линейная сложность с помощью алгоритма Берлекэмпа — Месси [20, 21]. Тест проверяет соответствие распределения линейной сложности этих подпоследовательностей ожидаемому.
• Тест на подпоследовательности (Serial Test) [22]. Определяет, соответствует ли ожидаемому количество вхождений каждого из 2* шаблонов длины t (в случайной последовательности такие шаблоны равновероятны).
• Тест приблизительной энтропии (Approximate Entropy Test) [23]. Проверяет близость соотношения числа вхождений перекрывающихся шаблонов длины t и длины t + 1 ожидаемому для случайной последовательности.
• Тест кумулятивных сумм (Cumulative Sums Test). Биты тестируемой последовательности трактуются как целые числа, причем все нули заменяются на — 1. Далее вычисляются суммы первых t членов последовательности. Тест проверяет соответствие значения максимальной по абсолютной величине суммы ожидаемому.
• Тест на произвольные отклонения (Random Excursions Test). Биты тестируемой последовательности трактуются как целые числа, причем все нули заменяются на — 1. Далее, пусть St — сумма первых t членов последовательности, t Е . Множество всех различных значений St рассматривается как множество вершин графа, а последовательность значений St — как блуждание по этому графу. Тестом оценивается соответствие распределения количества циклов в этой последовательности (под циклом в этом тесте понимается последовательность вершин, начинающаяся и заканчивающаяся нулем), в которых присутствуют определенные вершины определенное число раз, ожидаемому.
• Вариант теста на произвольные отклонения (Random Excursions Variant Test). Здесь рассматривается тот же граф, что и в предыдущем тесте, однако проверяется соответствие распределения числа проходов блуждания через каждую вершину ожидаемому.
Более подробное описание набора статистических тестов NIST STS выходит за рамки данной статьи. Заинтересованного читателя отошлем к официальной документации и работам коллектива авторов этого набора тестов: [13, 14, 15]. Ряд особенностей этого набора тестов обсуждается в работе [24].
Опишем также набор RaBiGeTe [17]. Он содержит следующие тесты:
• Тест «Улучшенная многоуровневая стратегия» (AMLS). Тестируемая последовательность разбивается на блоки. Для каждого из них применяются правила фон Неймана для «исправления» нечестной монеты (01 ^ 0; 10 ^ 1; 00 и 11 отбрасываются). Такое преобразование специальным образом производится несколько раз (образуя определенное число уровней). Распределение числа отброшенных битов в блоке сравнивается с ожидаемым.
• Тест на дискретное преобразование Фурье (DFT). Из тестируемой последовательности формируется матрица, над которой производится двухмерное дискретное преобразование Фурье. Сравнивается распределение мнимых частей полученных коэффициентов с нормальным, которое ожидается для случайной последовательности.
• Тест коротких блоков (Short blocks). Тестируемая последовательность преобразуется в последовательность блоков длины s, при этом первый блок формируется из битов 0, d, 2d, . (s — 1)d, второй блок — из битов 1, d +1, 2d + 1, . . (s — 1)d +1 и т.д., где d — некоторое число. Каждый блок рассматривается как число от 0 до 2s — 1. Распределение этих чисел сравнивается с ожидаемым (равномерным).
• SOB (Sparse Occupancy Bitstream). Представляет собой вариант обезьяньих тестов из DieHard.
• Оконный тест автокорреляции (Windowed autocorrelation). Тестируемая последовательность рассматривается как последовательность блоков 6Ь b2, .. ., bN. Распределение расстояний Хемминга между блоками Ь и bi+d, 0 ^ i < N — d, сравнивается с ожидаемым.
• Тест перестановок (Permutation). Тестируемая последовательность делится на блоки длиной от 2 до 12 двоичных разрядов каждый. Каждые t последовательных блоков группируются. Рассматриваются только те из этих групп, в которых нет совпадающих элементов. Элементы в группе могут быть различным образом упорядочены. Например, пусть группа состоит из блоков щ, . ut. Они могут быть упорядочены: щ < u2 < . < ut, u2 < щ < щ < . < ut и т.д. (всего n! различных порядков). Для каждого порядка подсчи-тывается число групп. Распределение полученных величин сравнивается с ожидаемым.
• Тест собирателя купонов (Coupon collector test). Тестируемая последовательность делится на блоки длины s. Последовательность блоков сканируется и подсчитываются величины r — сколько блоков надо просканировать, чтобы нашлись все 2s различных блоков. Проверяется соответствие распределения величин r ожидаемому.
• Тест Маурера (Maurer). Повторяет аналогичный тест NIST.
• Тест на наибольший общий делитель (GCD). На основе тестируемой последовательности генерируются пары целых чисел. Вычисляется наибольший общий делитель каждой
пары. Проверяются соответствие распределений значения наибольшего общего делителя и числа шагов алгоритма Евклида ожидаемым.
• Тест Blocks’n’gaps. Подсчитывает число подпоследовательностей различной длины, состоящих из одних единиц, либо одних нулей. Распределение этих величин сравнивается с ожидаемым.
• Частотный блочный тест (Long blocks). Повторяет аналогичный тест NIST.
• Тест на последовательность одинаковых битов (Runs). Повторяет аналогичный тест NIST.
• Тест кумулятивных сумм (Cumulative sum). Повторяет аналогичный тест NIST.
• Тест на подпоследовательности (Serial). Повторяет аналогичный тест NIST.
• Тест на совпадение неперекрывающихся шаблонов (Non overlapping template match-ings). Повторяет аналогичный тест NIST.
• Тесты рангов матриц. Повторяют аналогичные тесты Diehard.
i Не можете найти то, что вам нужно? Попробуйте сервис подбора литературы.
• Тест промежутков между днями рождения (Tough birthday spacings). Повторяют аналогичный тест Diehard.
RaBiGeTe обладает рядом преимуществ — снабжен удобным графическим интерфейсом пользователя, обладает многопоточной версией. В то же время, некоторые входящие в него тесты разработаны его автором (например, AMLS, DFT, Short blocks и др.) и ранее в таком виде не применялись. По ним отсутствуют какие-либо значимые независимые исследования. Ожидаемое распределение для некоторых тестов получено их автором эмпирически. Кроме того, некоторые тесты, взятые из других наборов, могут иметь отличающиеся параметры. Все это усугубляет трудности интерпретации результатов и без того присущие наборам статистических тестов и делает их не слишком надежными. Это ограничивает применимость данного набора тестов.
Еще один набор тестов PractRand, к сожалению, снабжен не слишком подробной документацией, в которой описаны лишь некоторые из входящих в него тестов, причем описаны очень скупо. В связи с этим, его рассмотрение невозможно.
Все перечисленные тесты направлены на проверку тех или иных свойств, характерных для случайной последовательности. Ряд тестов (например, частотный побитовый тест, частотный блочный тест, тест на последовательность одинаковых битов, тесты на совпадение перекрывающихся и неперекрывающихся шаблонов и др.) фактически можно трактовать, как использующие подходы, в чем-то аналогичного подходу фон Мизеса. Некоторые тесты (в частности, универсальный тест Маурера [19] и тест на линейную сложность) можно рассматривать как вычисление верхних оценок коломогоровской сложности.
Из рассмотренных здесь наборов статистических тестов наиболее исследованным и апробированным является NIST STS. Он разработан в серьезной правительственной организации (NIST), за ним стоит целая команда разработчиков — профессионалов в области математической статистики. Кроме того, он использовался для тестирования криптографических
алгоритмов на государственном уровне — в том числе для тестирования блочных шифров, представленных на конкурс AES. В него входят тесты, которые либо достаточно очевидны (как например, частотные тесты), либо имеют хорошее теоретическое обоснование (как, например, тест Маурера или тест на линейную сложность). Поэтому результаты, полученные с помощью этого набора, гораздо легче интерпретировать, по сравнению с результатами, полученными с помощью других наборов статистических тестов.
3. Режимы работы блочных шифров
Как известно, блочные шифры могут быть использованы различными способами, которые называются режимами работы блочных шифров или режимами шифрования. Таких режимов известно достаточно много. Описание классических режимов шифрования приведено, например, в монографии [25]. В нашей стране режимы работы блочных шифров регламентируются ГОСТ Р 34.13-2015 [26]. Здесь мы приведем краткие сведения лишь о некоторых режимах шифрования, которые могут использоваться в процессе статистического тестирования блочных шифров.
Самый простой режим работы, состоящий в том, что открытый текст делится на блоки, каждый из которых зашифровывается отдельно на одном и том же ключе, называется ECB (Electronic Code Book, режим электронной кодовой книги, в русскоязычной традиции — режим простой замены). Он используется редко, так как во многих случаях не является безопасным за счет того, что сохраняет структуру открытого текста (поскольку результат зашифрования одного и того же блока в разных частях текста одинаков). Чаще используются другие режимы работы. Нас будут интересовать режимы OFB и CTR, фактически превращающие блочных шифр в поточный, реализуя на основе блочного шифра генератор псевдослучайных последовательностей.
В режимах OFB и CTR генерируется последовательность блоков Yi, Y2. . Шифрование заключается в наложении этой последовательности на открытый текст с помощью побитового сложения по модулю 2. Пусть e(key,x) — функция зашифрования блочного шифра (key — ключ, x — блок открытого текста). Режим OFB (Output feedback, режим обратной связи по выходу) реализуется следующим образом: jl = e(key, IV); y% = e(key, Yi-l), i > 2. Здесь IV — вектор инициализации. Режим CTR (Counter mode, режим счетчика) реализуется следующим образом: Yi = e(key, ci), где значения ci формируются по некоторому правилу, например ci = L||ti; ti+l = (ti + 1) mod 2s; (L||to) = IV. Здесь s — длина to, а || означает конкатенацию.
Также в дальнейшем будет упоминаться режим CBC (Cipher Block Chaining), в котором происходит зашифрование на ключе key последовательности блоков открытого текста xl, x2, . .. в последовательность блоков шифртекста yl, y2, . следующим образом: yi = e(key, xi 0 IV); yi = e(key, xi 0 yi-i), i > 2.
4. Статистическое тестирование блочных шифров
Наиболее распространенный метод статистического тестирования блочных шифров заключается в генерации с помощью блочного шифра псевдослучайных последовательностей, которые подвергаются тестированию с помощью какого-либо набора статистических тестов. При этом для генерации этих последовательностей обычно используются следующие подходы:
• Создание генератора псевдослучайных последовательностей из блочного шифра посредством использования того или иного поточного режима шифрования (например, OFB, CTR). С помощью этого генератора и происходит генерация последовательностей.
• Шифрование (в том или ином режиме) некоторой заранее заданной последовательности.
• Шифрование последовательности, состоящей из пар блоков, таких, что расстояния Хемминга между блоками каждой пары мало (например, равно 1) с побитовым сложением по модулю 2 шифртекстов каждой пары. Статистическое тестирование полученной последовательности фактически проверяет выполнение строгого лавинного критерия. Напомним, что говорят, что функция f : n ^ m удовлетворяет строгому лавинному критерию (Strict avalanche criteria, SAC), если изменение одного бита входа приводит к тому, что каждый бит выхода меняется с вероятностью 1/2.
При этом распространенной практикой является исследование блочных шифров с уменьшенным числом раундов с целью определения номера раунда, начиная с которого функция зашифрования успешно проходит все статистические тесты набора.
Наиболее известной методикой статистического тестирования блочных шифров является разработанная NIST методика, которая описана в работах [27, 28], посвященных тестированию блочных шифров, представленных на конкурс AES. Приведем ее здесь.
Мы будем обозначать функцию зашифрования блочного шифра через e(key, x), где key — ключ, а x — блок открытого текста. Напомним, что в конкурсе AES участвовали блочные шифры, у которых длина блока составляла 128 двоичных разрядов, а длина ключа могла принимать значения 128, 192, 256 двоичных разрядов. Обозначим через bit(j) блок веса 1, единица у которого находится в разряде j.
Методика, посредством которой тестировали финалистов конкурса AES (в работе [28], в которой исследовано 5 криптоалгоритмов, вышедших в финал конкурса AES: Rijndael, Serpent, Twofish, RC6 и MARS), состоит в том, что восемью различными способами генерировались по 300 двоичных последовательностей. Все они тестировались набором статистических тестов NIST STS. Если последовательности не могли успешно пройти тесты, делался вывод о недостаточном качестве данного блочного шифра.
Перечислим способы генерации последовательностей для статистического тестирования, используемые в этой методике:
1. Для тестирования лавинного эффекта по открытому тексту. Проверяется чувствительность к изменениям открытого текста. Выбирается ключ key, состоящий из всех нулей.
Генерируется 19200 случайных 128-разрядных блоков открытого текста. Для каждого такого блока xi вычисляются выходные блоки yi,j = e(key, xi) ф e(key, xi ф bit(j)), j = 0, . 127. Далее все полученные блоки конкатенируются: y10 || . || y1,127 || y2,0 || . || y2,127 || . . || y19200,0 || . || y19200,127. Эта последовательность представляет собой двоичную последовательность длиной 314572800 двоичных разрядов. Она трактуется как 300 двоичных последовательностей длиной по 1048576 разрядов каждая.
2. Для тестирования лавинного эффекта по ключу. Здесь используется блок открытого текста x, состоящий из всех нулей. Генерируется 19200 случайных ключей (длиной либо 192, либо 256 двоичных разрядов). Для каждого такого ключа keyi вычисляются выходные блоки yi,j = e(keyi,x) ф e(keyi ф bit(j),x), j = 0, . 127. Далее все полученные блоки конкатенируются: y1,0 || . || yM27 || y2,0 || . || y2,127 || . || y19200,0 || . || y19200,127. Полученная последовательность трактуется как 300 двоичных последовательностей, длиной по 1048576 разрядов каждая.
3. Для тестирования корреляции между открытым текстом и шифртекстом. Выбирается случайный ключ key и 8192 случайных блоков открытого текста x1, . . x8192. Для каждого из них вычисляется выходной блок yi = e(key, xi) ф xi. Эти блоки конкатенируются и получается последовательность y1 || y2 || . || y81g2, которая трактуется как двоичная последовательность длиной в 1048576 двоичных разрядов. Всего генерируется 300 таких последовательностей (каждый раз выбирается новый случайный ключ key).
4. Для тестирования работы шифра в режиме сцепления блоков. Выбирается случайный ключ key и вектор инициализации IV, длиной в 128 двоичных разрядов, состоящий из нулей. Далее формируется выходная последовательность, состоящая из 8192 блоков y1, .. ., y8192 (по 128 двоичных разрядов в каждом блоке). Первый выходной блок вычисляется как y1 = e(key, IV). Остальные выходные блоки вычисляются как yi+1 = e(key, yi). Выходная последовательность трактуется как двоичная последовательность длиной 1048576 двоичных разрядов. Всего генерируется 300 таких последовательностей (каждый раз вырабатывается новый случайный ключ key).
5. Для тестирования работы шифра в случае низкой плотности открытого текста. Выбирается случайный ключ key и формируется 8257 блоков открытого текста: один блок веса 0; 128 различных блоков веса 1 и 8128 блоков веса 2. Все эти блоки зашифровываются на ключе key. Полученная последовательность блоков шифртекста трактуется как двоичная последовательность длиной 1056896 двоичных разрядов. Всего генерируется 300 таких последовательностей (каждый раз выбирается новый случайный ключ key).
6. Для тестирования работы шифра в случае ключей низкой плотности. Выбирается случайный блок открытого текста x и формируется 8257 ключей: один ключ веса 0, 128 различных ключей веса 1, в каждом из которых единица содержится в одном из первых 128 разрядов, и 8128 различных ключей веса 2, в каждом из которых обе единицы содержатся среди первых 128 разрядов. На каждом из этих ключей зашифровывается блок x. Полученная последовательность блоков шифртекста трактуется как двоичная последовательность
длиной 1О5б89б двоичных разрядов. Всего генерируется ЗОО таких последовательностей (каждый раз выбирается новый случайный блок x).
7. Для тестирования работы шифра в случае высокой плотности открытого текста. Выбирается случайный ключ key и формируются S257 блоков открытого текста: один блок веса 12S, 12S различных блоков веса 127 и S12S различных блока веса 12б. Все эти блоки зашифровываются на ключе key. Полученная последовательность блоков шифртекста трактуется как двоичная последовательность длиной 1О5б89б двоичных разрядов. Всего генерируется ЗОО таких последовательностей (каждый раз выбирался новый случайный ключ key).
8. Для тестирования работы шифра в случае ключей высокой плотности. Выбирается случайный блок открытого текста x и формируется S257 ключей: один ключ веса m, 12S различных ключей веса m — 1, в каждом из которых О содержится в одном из первых 12S разрядов, и S12S различных ключей веса m — 2, в каждом из которых оба нуля содержатся среди первых 12S разрядов (здесь m — длина ключа). На каждом из этих ключей шифруется блок x. Полученная последовательность блоков шифртекста трактуется как двоичная последовательность длиной 1О5б89б двоичных разрядов. Всего генерируется ЗОО таких последовательностей (каждый раз выбирался новый случайный блок x).
В более ранней работе [27] авторов набора NIST STS тестировались также последовательности, сгенерированные путем шифрования случайных блоков на случайных ключах (в этой работе протестировано 15 криптоалгоритмов, представленных на конкурс AES: CAST-25б, CRYPTON, DEAL, DFC, E2, FROG, HPC, LOKI97, MAGENTA, MARS, RC6, Rijndael, SAFER+, Serpent и Twofish). Но, как было замечено в работе [29], на результат такого теста существенное влияние оказывают статистические свойства генератора этих случайных блоков и случайных ключей, поэтому такое тестирование ненадежно. Вообще, в работе [29] ряд аспектов методики тестирования блочных шифров NIST подвергнут критике. В частности, указывается на то, что в документации недостаточно четко определены нулевые и альтернативные гипотезы, длины входных данных и уровни значимости недостаточно обоснованы, а ряд тестов не инвариантны по отношению к криптографически незначимым преобразованиям данных.
В статье [30] проведено статистическое тестирование блочных шифров Мухомор, Лабиринт, Калина и ADE, представленных на украинский конкурс по выбору претендента на национальный стандарт блочного симметричного шифрования. При этом использовалась значительно более простая методика, состоящая в статистическом тестировании с помощью набора тестов NIST STS результата зашифрования некоторого файла, размером более 1О Мб, в режиме CBC (о том, как этот файл был получен, в статье не сказано).
Существуют также другие подходы к статистическому тестированию блочных шифров, не получившие широкого распространения. Tак, в работе [31] предлагалось использовать два теста, один из которых основан на проверке распределения свободных членов алгебраических нормальных форм, описывающих функции зашифрования и расшифрования тестируемого блочного шифра, а другой основан на проверке распределения количества мономов
данной степени в этих алгебраических нормальных формах. В работе [32] предложен способ тестирования, заключающийся в том, что для случайного блока открытого текста x0 длины n (как правило, n = 128) формируется n различных блоков xi, . . xn, таких что lxi ф xo| = 1, i = 1, . n, где |x| — вес x. Из них формируются блоки yi = e(key,xi) ф e(key,x0), i = 1, . n. Далее из блоков yi формируется двоичная матрица A размера n x n, в строках которой записываются в двоичном виде блоки yi, i = 1, . n. Тест состоит в проверке соответствия соотношения частоты нулей в произведении двух различных таких матриц (полученных для различных x0 и/или различных ключей key) и частоты нулей в самих этих матрицах тому, которое ожидается для идеального блочного шифра. В работе [33] предложено просто тестировать шифртекст набором статистических тестов DieHard, причем о том, как формировать открытый текст, в этой работе почти ничего не говорится.
Несмотря на высокую степень актуальности методик автоматизированного тестирования криптографического качества блочных шифров, в настоящее время фактически единственной достаточно хорошо исследованной и проработанной, а также апробированной на практике методикой статистического тестирования блочных шифров является описанная выше методика, использованная NIST для тестирования криптоалгоритмов на конкурсе AES (где с ее помощью было протестировано 15 различных блочных шифров). Вместе с тем, к этой методике существует ряд нареканий [29]. Другие существующие методики не являются общепринятыми и недостаточно хорошо проработаны. Все это приводит к необходимости разработки новых методик статистического тестирования блочных шифров, свободных от замеченных недостатков. Кроме того, возникает задача разработки методик статистического тестирования других классов криптографических алгоритмов, в частности, криптографических хэш-функций.
Работа выполнена при финансовой поддержке РФФИ в рамках научного проекта № 1607-00542.
1. Vadhan S.P. Pseudorandomness. Boston: NowPubl., 2012. 338 p.
2. Downey R.G., Hirschfeldt D.R. Algorithmic randomness and complexity. N.Y.: Springer, 2010. 855 p.
3. Ming Li, Vitanyi P. An introduction to Kolmogorov complexity and its applications. N.Y.: Springer, 2014. 550 p.
4. Nies A. Computability and randomness. Oxf.; N.Y.: Oxf. Univ. Press, 2009. 433 p.
5. Верещагин Н.К., Успенский В.А., Шень А. Колмогоровская сложность и вычислительная случайность. М.: МЦНМО, 2013. 575 p.
6. Колмогоров А.Н. Три подхода к определению понятия «количество информации» // Проблемы передачи информации. 1965. Т. 1, № 1. С. 3-11.
7. Martin-Lof P. The definition of random sequences // Information and control. 1966. Vol.9, no. 6. Pp. 602-619. DOI: 10.1016/S0019-9958(66)80018-9
8. Mises R.v. Grundlagen der wahrscheinlichkeitsrechnung//Mathematische Zeitschrift. 1919. Vol. 5, no. 1-2. Pp. 52-99. DOI: 10.1007/BF01203155
9. Muchnik A.A., Semenov A.L., Uspensky V.A. Mathematical metaphysics of randomness // Theoretical Computer Science. 1998. Vol.207, no.2. Pp. 263-317. DOI: 10.1016/S0304-3975(98)00069-3
10. Кнут Д.Э. Искусство программирования: пер с англ. 3-е изд. Т. 2: Получисленные алгоритмы. М.: Вильямс, 2000. 828 с. [Knuth D.E. The art of computer programming. In 3 vol. 3rd ed. Reading: Addison-Wesley Publ. Co., 1997].
11. Marsaglia G. The Marsaglia random number CDROM including the DIEHARD battery of tests of randomness. Режим доступа: http://ftpmirror.your.org/pub/misc/diehard (дата обращения 22.11.2018).
12. Brown R.G.,EddelbuettelD., Bauer D. Dieharder: A random number test suite. Version 3.31.1. Режим доступа: http://webhome.phy.duke.edu/ rgb/General/dieharder.php (дата обращения 22.11.2018).
13. Rukhin A., Soto J., Nechvatal J., Smid M., Barker E., Leigh S., Levenson M., Vangel M., Banks D., Heckert A., Dray J., Vo S. A statistical test suite for random and pseudorandom number generators for cryptographic applications//NIST Spec. Publ. 2001. 800-22 revision 1a. Режим доступа: http://csrc.nist.gov/groups/ST/toolkit/rng/documents/SPS00-22b.pdf (дата обращения 22.11.2018).
14. Bassham L.E., Rukhin A.L., Soto J., Nechvatal J.R., Smid M.E., Leigh S.D., Levenson M., Vangel M., Heckert N.A., Banks D.L. A statistical test suite for random and pseudorandom number generators for cryptographic applications // NIST Spec. Publ. 2010. 800-22 revision 1a. Режим доступа: https://www.nist.gov/publication/statistical-test-suite-random-and-pseudorandom-number-generators-cryptographic (дата обращения 26.11.2018).
15. Soto J. Statistical testing of random number generators // 22nd National information systems security conf.: NISSC’1999 (Arlington, Virginia, USA, October 18-21, 1999): Proc. Vol. 10. 1999. 12 p. Режим доступа: https://csrc.nist.gov/csrc/media/publication/conference-paper/ 1999/10/21/proceedings-of-the-22nd-nisc-1999-documents/papers/p24.pdf (дата обращения 26.11.2018).
16. L’Ecuyer P., Simard R. TestU01: A C library for empirical testing of random number generators // ACM Trans. on Mathematical Software. 2007. Vol. 33, no. 4. Article 22. DOI: 10.1145/1268776.1268777
17. RaBiGeTe MT. Режим доступа: http://cristianopi.altervista.org/RaBiGeTe_MT/ (дата обращения 26.11.2018).
18. PractRand Documentation. Режим доступа: http://pracrand.sourceforge.net/ (дата обращения 26.11.2018).
19. Maurer U.M. A universal statistical test for random bit generators // J. of Cryptology. 1992. Vol. 5, no. 2. Pp. 89-105. DOI: 10.1007/BF00193563
20. Massey J. Shift-register synthesis and BCH decoding // IEEE Trans. on Information Theory. 1969. Vol. 15, no. 1. Pp. 122-127. DOI: 10.1109/TIT. 1969.1054260
21. Atti N.B., Diaz-Toca G.M., Lombardi H. The Berlekamp-Massey algorithm revisited // Applicable Algebra in Engineering, Communication and Computing. 2006. Vol. 17, no. 1. Pp. 75-82. DOI: 10.1007/s00200-005-0190-z
22. Good I.J. The serial test for sampling numbers and other tests for randomness // Math. Proc. of the Cambridge Philosophical Soc. 1953. Vol.49, no. 02. P. 276-284. DOI: 10.1017/S030500410002836X
23. Rukhin A.L. Approximate entropy for testing randomness // J. of Applied Probability. 2000. Vol. 37, no. 1. Pp. 88-100. DOI: 10.1239/jap/1014842270
24. Rukhin A.L. Statistical testing of randomness: New and old procedures//Randomness through computation: Some answers, more questions / Ed. by H. Zenil. Ch. 3. Singapore: World Scientific, 2011. Pp. 33-51. DOI: 10.1142/9789814327756,0003
25. Шнайер Б. Прикладная криптография: Протоколы, алгоритмы, исходные тексты на языке Си: пер. с англ. М.: Триумф, 2002. 815 с. [Schneier B. Applied cryptography: Protocols, algorithms and source code in C. 2nd ed. N.Y.: Wiley, 1996. 784 p.].
26. ГОСТ Р 34.13-2015. Информационная технология (ИТ). Криптографическая защита информации. Режимы работы блочных шифров. Введ. 2016-01-01. М.: Стандартинформ, 2016.
27. Soto J. Randomness tеsting of the advanced encryption standard candidate algorithms. U.S. Dep. of Commerce. Technology Administration. Nat. Inst. of Standards and Technology. 1999. Режим доступа: https://pdfs.semanticscholar.org/65e1/ccfe7d0e3b68c2bb2acdbc35 eb7b046f6430.pdf (дата обращения 26.11.2018).
28. Soto J., Bassham L. Randomness testing of the advanced encryption standard finalist candidates. U.S. Dep. of Commerce. Technology Administration. Nat. Inst. of Standards and Technology. 2000. Режим доступа: https://ws680.nist.gov/publication/get-pdf.cfm?pub-id= 151216 (дата обращения 26.11.2018).
29. Murphy S. The power of NIST’s statistical testing of AES candidates. 2000. Режим доступа: http://www.isg.rhbnc.ac.uk/~sean/StatsRev.pdf (дата обращения 26.11.2018).
30. Долгов В.И., Настенко А.А. Большие шифры — случайные подстановки. проверка статистических свойств шифров, представленных на украинский конкурс с помощью набора тестов nist sts // Системи обробки шформацп. 2012. № 7(105). С. 2-16.
31. Filiol E. A new statistical testing for symmetric ciphers and hash functions // Information and communications security: ICICS 2002: Intern. conf. on information and communications security. B.; Hdbl.: Springer, 2002. Pp. 342-353. DOI: 10.1007/ DOI: 3-540-36159-6-29
32. Katos V. A randomness test for block ciphers // Applied mathematics and computation. 2005. Vol. 162, no. 1. Pp. 29-35. DOI: 10.1016/j.amc.2003.12.122
33. Alani M.M. Testing randomness in ciphertext of block-ciphers using diehard tests // Intern. J. of Computer Science and Network Security. 2010. Vol. 10, no. 4. Pp. 53-57.
Mathematics and Mathematical Modeling, 2018, no. 5, pp. 35-56.
http://mathmelpub.ru ISSN 2412-5911
On statistical testing of block ciphers
Klyucharev P. G.1’* *pk.iu8@yandex.ru
1Bauman Moscow State Technical University, Russia
Keywords: statistical testing; randomness; block cipher
Block ciphers form one of the main classes of cryptographic algorithms. One of the challenges in development of block ciphers, like any other cryptographic algorithms, is the analysis of their cryptographic security. In the course of such analysis, statistical testing of block ciphers is often used. The paper reviews literature on statistical testing of block ciphers.
The first section of the paper briefly and informally discusses approaches to the definition of the concept of a random sequence, including the Kolmogorov, von Mises, and Martin-L?f approaches and the unpredictability-related approach. However, all these approaches to the definition of randomness are not directly applicable in practice.
The second section describes statistical tests of binary sequences. It provides brief descriptions of the tests included in the DieHard, NIST STS, RaBiGeTe statistical test suites.
The third section provides the appropriate information to present further the operation modes of block ciphers.
The fourth section deals with techniques for statistical testing of block ciphers. Usually such techniques lie in the fact that based on the block cipher under test, various generators of the pseudorandom sequences are built, with their output sequences being tested using any suite of statistical tests. The approaches to the construction of such generators are given.
The paper describes the most known statistical test technique for block ciphers among the submitted for the AES competition. It is a technique the NIST uses for statistical testing of ciphers. In addition, there are other techniques mentioned in the literature.
In conclusion the paper states that there is a need to develop new techniques for statistical testing of block ciphers.
The paper support was provided from the Russian Foundation for Basic Research in the framework of the research project No. 16-07-00542 supported
1. Vadhan S.P. Pseudorandomness. Boston: Now Publ., 2012. 338 p.
2. Downey R.G., Hirschfeldt D.R. Algorithmic randomness and complexity. N.Y.: Springer, 2010. 855 p.
3. Ming Li, Vitanyi P. An introduction to Kolmogorov complexity and its applications. N.Y.: Springer, 2014. 550 p.
4. Nies A. Computability and randomness. Oxf.; N.Y.: Oxf. Univ. Press, 2009. 433 p.
5. Vereshchagin N.K., Uspenskij V. A., Shen’ A. Kolmogorovskaia slozhnost’ i algoritmicheskaia sluchajnost’ [Kolmogorov complexity and algorithmic randomness]. Moscow: MTSNMO Publ., 2013. 575 p. (in Russian).
6. Kolmogorov A.N. Three approaches to the definition of «quantity of information». Problemy peredachi informatsii [Problems of Information Transmission], 1965, vol. 1, no. 1, pp. 3-11 (in Russian).
7. Martin-Lof P. The definition of random sequences. Information and control, 1966, vol. 9, no. 6, pp. 602-619. DOI: 10.1016/S0019-9958(66)80018-9
8. Mises R.v. Grundlagen der wahrscheinlichkeitsrechnung. Mathematische Zeitschrift, 1919, vol. 5, no. 1-2, pp. 52-99. DOI: 10.1007/BF01203155
9. Muchnik A.A., Semenov A.L., Uspensky V.A. Mathematical metaphysics of randomness. Theoretical Computer Science, 1998, vol.207, no.2, pp. 263-317. DOI: 10.1016/S0304-3975(98)00069-3
10. Knuth D.E. The art of computer programming. In 3 vol. 3rd ed. Reading: Addison-Wesley Publ. Co., 1997.
Reading: Addison-Wesley Publ. Co., 1997. (Russ. ed.: Knuth D.E. Iskusstvo program-mirovaniia. 3-e izd. Tom 2: Poluchislennye algoritmy. Moscow: Vil’iams Publ., 2000. 828 p.).
i Не можете найти то, что вам нужно? Попробуйте сервис подбора литературы.
11. Marsaglia G. The Marsaglia random number CDROM including the DIEHARD battery of tests of randomness. Available at: http://ftpmirror.your.org/pub/misc/diehard, accessed 22.11.2018.
12. Brown R.G.,EddelbuettelD., Bauer D. Dieharder: A random number test suite. Version 3.31.1. Available at: http://webhome.phy.duke.edu/ rgb/General/dieharder.php, accessed 22.11.2018.
13. Rukhin A., Soto J., Nechvatal J., Smid M., Barker E., Leigh S., Levenson M., Vangel M., Banks D., Heckert A., Dray J., Vo S. A statistical test suite for random and pseudorandom number generatorsfor cryptographic applications. NIST Spec. Publ., 2001, 800-22 revision 1a. Available at: http://csrc.nist.gov/groups/ST/toolkit/rng/documents/SPS00-22b.pdf, accessed 22.11.2018.
14. Bassham L.E., Rukhin A.L., Soto J., Nechvatal J.R., Smid M.E., Leigh S.D., Levenson M., Vangel M., Heckert N.A., Banks D.L. A statistical test suite for random and pseudorandom number generators for cryptographic applications. NIST Spec. Publ., 2010,
800-22 revision 1a. Available at: https://www.nist.gov/publication/statistical-test-suite-random-and-pseudorandom-number-generators-cryptographic, accessed 26.11.2018.
15. Soto J. Statistical testing of random number generators. 22nd National information systems security conf.: NISSC’1999 (Arlington, Virginia, USA, October 18-21, 1999): Proc. Vol. 10. 1999. 12 p. Available at: https://csrc.nist.gov/csrc/media/publication/conference-paper/1999/ 10/21/proceedings-of-the-22nd-nisc-1999-documents/papers/p24.pdf accessed 26.11.2018.
16. L’Ecuyer P., Simard R. TestU01: A C library for empirical testing of random number generators. ACM Trans. on Mathematical Software, 2007, vol. 33, no. 4, article 22. DOI: 10.1145/1268776.1268777
17. RaBiGeTe MT. Available at: http://cristianopi.altervista.org/RaBiGeTe_MT/, accessed 26.11.2018.
18. PractRand Documentation. Available at: http://pracrand.sourceforge.net/, accessed 26.11.2018.
19. Maurer U.M. A universal statistical test for random bit generators. J. of Cryptology, 1992, Vol. 5, no. 2, pp. 89-105. DOI: 10.1007/BF00193563
20. Massey J. Shift-register synthesis and BCH decoding. IEEE Trans. on Information Theory, 1969, vol. 15, no. 1, pp. 122-127. DOI: 10.1109/TIT.1969.1054260
21. Atti N.B., Diaz-Toca G.M., Lombardi H. The Berlekamp-Massey algorithm revisited. Applicable Algebra in Engineering, Communication and Computing. 2006, vol. 17, no. 1, pp. 75-82. DOI: 10.1007/s00200-005-0190-z
22. Good I.J. The serial test for sampling numbers and other tests for randomness. Math. Proc. of the Cambridge Philosophical Soc., 1953, vol.49, no. 02, pp. 276-284. DOI: 10.1017/S030500410002836X
23. Rukhin A.L. Approximate entropy for testing randomness. J. of Applied Probability, 2000, vol. 37, no. 1, pp. 88-100. DOI: 10.1239/jap/1014842270
24. Rukhin A.L. Statistical testing of randomness: New and old procedures. Randomness through computation: Some answers, more questions / Ed. by H. Zenil. Ch. 3. Singapore: World Scientific, 2011. Pp. 33-51. DOI: 10.1142/9789814327756.0003
25. Schneier B. Applied cryptography: Protocols, algorithms and source code in C. 2nd ed. N.Y.: Wiley, 1996. 784 p. (Russ. ed.: Schneier B. Prikladnaia kriptografiia: Protokoly, algoritmy, iskhodhye teksty na iazyke SI. Moscow: Triumf Publ., 2002. 815 p.).
26. GOSTR 34.13-2015. Informatsionnaia tekhnologiia. Kriptograficheskaia zashchita informat-sii. Rezhimy raboty blochnykh shifrov [State Standard R 34.13-2015. Information technology. Cryptographic data security. Block ciphers operation modes]. Moscow: Standartinform Publ., 2016 (in Russian).
27. Soto J. Randomness testing of the advanced encryption standard candidate algorithms. U.S. Dep. of Commerce. Technology Administration. Nat. Inst. of Standards and Technol-
ogy. 1999. Available at: https://pdfs.semanticscholar.org/65e1/ccfe7d0e3b68c2bb2acdbc35 eb7b046f6430.pdf, accessed 26.11.2018.
28. Soto J., Bassham L. Randomness testing of the advanced encryption standard finalist candidates. U.S. Dep. of Commerce. Technology Administration. Nat. Inst. of Standards and Technology. 2000. Available at: https://ws680.nist.gov/publication/get-pdf.cfm?pub-id= 151216, accessed 26.11.2018.
29. Murphy S. The power of NIST’s statistical testing of AES candidates. 2000. Available at: http://www.isg.rhbnc.ac.uk/~sean/StatsRev.pdf, accessed 26.11.2018.
30. Dolgov V.I., Nastenko A.A. Large ciphers — random permutations. Verification of statistical properties ciphers submitted for ukranian contest with a test suite NIST STS. Sistemi obrobki informatsii [Information Processing Systems], 2012, no. 7(105), pp. 2-16 (in Russian).
31. Filiol E. A new statistical testing for symmetric ciphers and hash functions. Information and communications security: ICICS 2002: Intern. conf. on information and communications security. B.; Hdbl.: Springer, 2002. Pp. 342-353. DOI: 10.1007/DOI: 3-540-36159-6,29
32. Katos V. A randomness test for block ciphers. Applied mathematics and computation, 2005, vol. 162, no. 1, pp. 29-35. DOI: 10.1016/j.amc.2003.12.122
33. Alani M.M. Testing randomness in ciphertext of block-ciphers using diehard tests. Intern. J. of Computer Science and Network Security, 2010, Vol. 10, no. 4, pp. 53-57.
Спрайты
Слово «спрайт» часто используется в программировании игр для обозначения фигурок героев и предметов. Такие фигурки – это на самом деле рисунки или фотографии, то есть компьютерная графика.
Однако спрайт – не только картинка, это объект, наделенный программным кодом и как следствие свойствами и способностями. Со спрайтом можно взаимодействовать как с виртуальной сущностью, отдавать ей команды и получать от нее данные.
Кот в Scratch – не единственный объект-спрайт. Добавить на сцену другие можно несколькими способами: загрузить картинку с компьютера, нарисовать в самой среде программирования, выбрать из библиотеки. Для всего этого в Scratch предусмотрено специальное меню, которое находится внизу справа на панели спрайтов:
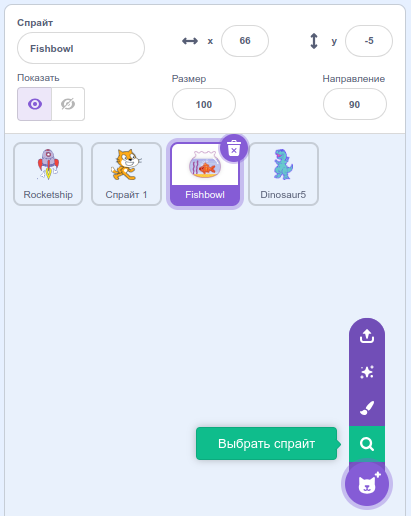
Пока ограничимся тем, что будем выбирать готовые спрайты из библиотеки. Для этого надо нажать лупу. Откроется библиотека, где можно найти подходящего героя.
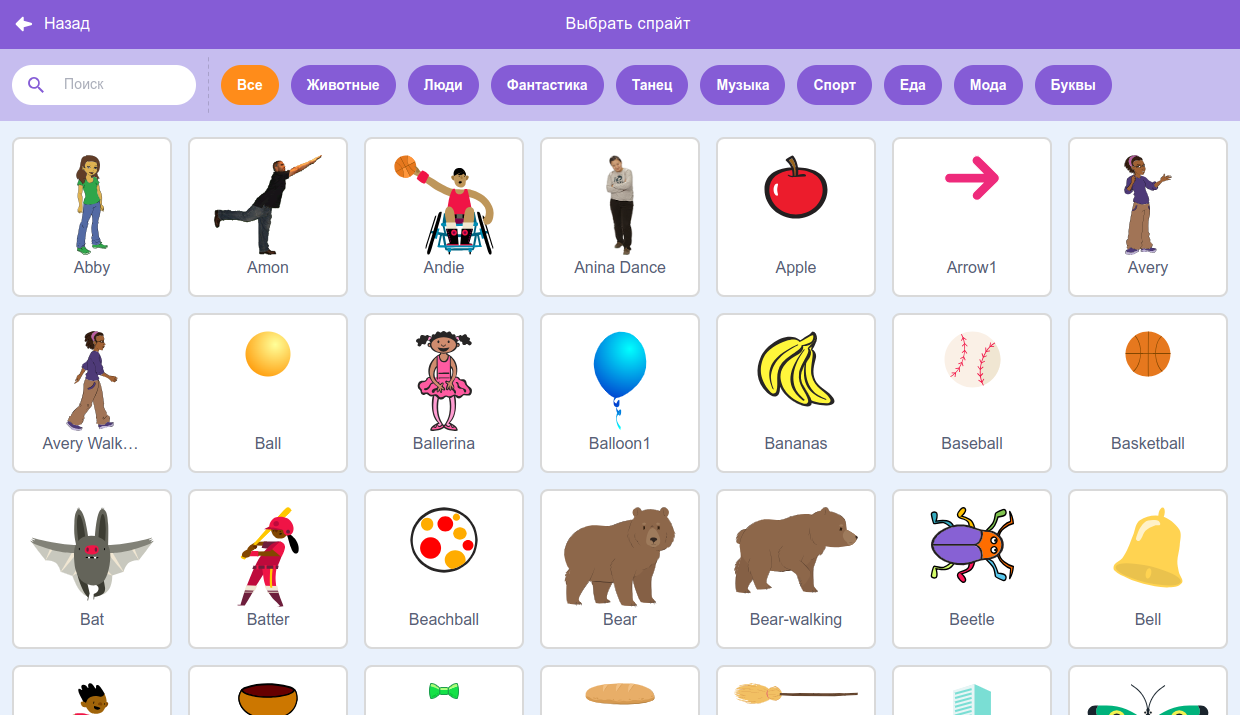
После клика по нему он появится на сцене. Также на панели спрайтов под свойствами появится его иконка. Рядом с иконкой кота. Свойства объекта, где вы задаете ему имя, положение, размер и поворот, отображаются только для того спрайта, который выделен.
Если вы захотите удалить один из спрайтов, кликните по его иконке под свойствами. Этот спрайт станет выделенным, выбранным, у него появится значок корзины с крестиком, кликнув по которому можно удалить спрайт из игры.
Когда в Scratch мы собираем блоки в программный код, этот код не существует в прострации сам по себе. Чаще всего он относится к какому-то спрайту. Другими словами, у каждого спрайта свой программный код, своя программа, свое предназначение. Герои могут «общаться» между собой через сигналы, которые посылают друг к другу. Но это другая история.
Сейчас надо запомнить, что когда мы работаем с блоками, следует обращать внимание на то, какой объект выделен. В Scratch появляется подсказка в верхнем правом углу поля редактора кода. Там бледным цветом отображается фигурка выделенного на данный момент спрайта. А значит весь код, который вы видите в рабочей области, относится только к данному герою.
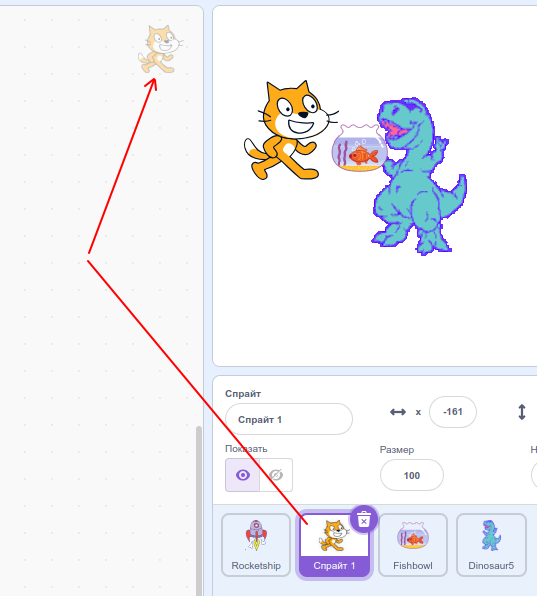
Когда выделяется другой спрайт, то код предыдущего становится невидимым.
Нередко код одного спрайта оказывается похожим на другой. Например, оба героя ходят по сцене, просто с разной скоростью и в разные направления. Собирать два раза почти одинаковую комбинацию блоков – не слишком удачное решение. Проще скопировать программу одного спрайта, добавить ее другому, а потом немного изменить.
В Scratch копировать собранные в программу блоки можно как в пределах одного проекта, так и переносить копию в «рюкзаке» из одного проекта в другой. Рюкзак находится внизу интерфейса среды разработки.
Допустим, у нас есть проект под названием «Проект 1», где мы составили программу движения кота туда-сюда. Мы хотим скопировать этот код в «Проект 2». Тогда мы заходим в первый проект, открываем рюкзак и перетаскиваем сюда конструкцию блоков.
При этом надо помнить правило: переносится участок кода от верхнего блока, за который мы держимся, и блоки, расположенные ниже него. Если вы взялись за блок, расположенный где-то в середине программы, то верхние блоки оторвутся и не будут захвачены.
Положив в рюкзак программу, мы возвращаемся во второй проект. Выделяем спрайт, которому хотим добавить код. Открываем рюкзак и достаем из него нашу программу.
Чтобы скопировать программу одного спрайта на другой в пределах одного проекта, достаточно захватить код и бросить его на иконку другого спрайта, которая расположена под свойствами на панели спрайтов.
Если надо скопировать код в пределах одного спрайта, надо кликнуть по конструкции правой кнопкой мыши и в контекстном меню выбрать «Дублировать».
Также обратите внимание на пункт «Добавить комментарий». Программисты часто пользуются комментариями, чтобы пояснить себе и остальным, что делает та или иная часть программы. Ведь при взгляде на сложный код не всегда сразу можно понять, для чего он, и как все это работает.
Когда на сцене обитают несколько спрайтов, становится важным их положение относительно друг друга, их место на сцене. Как вы уже должны были понять, изучая панель свойств спрайта, положение героя задается координатами, то есть точкой на плоскости.
В Scratch начало отсчета, то есть точка с координатами (0; 0), находится в центре сцены. Общая ширина сцены составляет 480 точек. Это значит, что координата x может принимать значения от -240 до 240. Общая высота сцены составляет 360 точек. Это значит, что координата y может принимать значения от -180 до 180.
Хотя работу с фонами мы будем изучать позже, добавим на сцену координатную сетку. Это поможет нам сориентироваться в системе координат Скретча. Чтобы выбрать фон из библиотеки, надо нажать на лупу в меню сцены, которое находится в нижнем правом углу окна, на панели «Сцена».
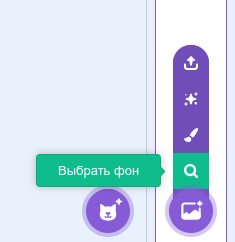
Откроется библиотека фонов, прокрутите ее в самый низ и выберите фон «Xy-grid». На сцене появится координатная сетка.
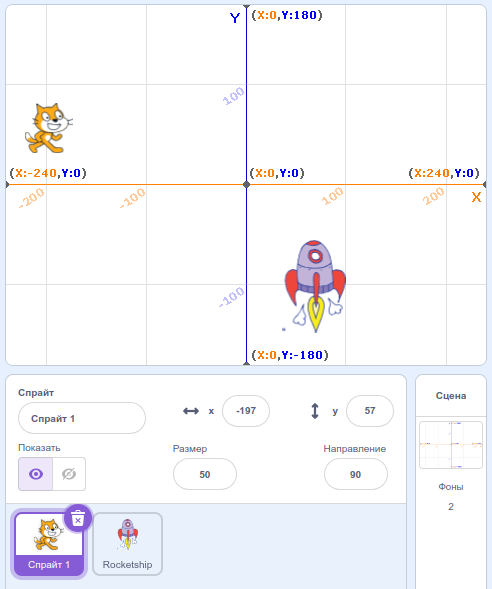
Давайте уменьшим размер наших спрайтов раза в два, то есть примерно до 50%, чтобы они не занимали большую площадь сцены, а больше походили на точку. Теперь поиграем с их координатами. Для этого можно менять значения x и y на панели свойств и смотреть, где после этого окажется герой. Или просто перетаскивать мышью спрайт на сцене и смотреть как меняются x и y в свойствах.
Например, если x = 0, y = 150, спрайт окажется в центре по горизонтали и вверху по вертикали. Если x = 200, y = 0, то спрайт окажется справа по горизонтали и в центре по вертикали.
На самом деле не обязательно до запуска программы устанавливать спрайты в нужное место с помощью мыши или панели свойств. Обычно это делают программно, с помощью специальных блоков кода, находящихся в разделе «Движение». Одним из управляющих местоположением блоков является команда «перейти в x: … y: …». Вместо точек указываются желаемые координаты.
Эта команда быстро перебрасывает спрайт в заданную точку, поэтому ее часто используют в начале программы:
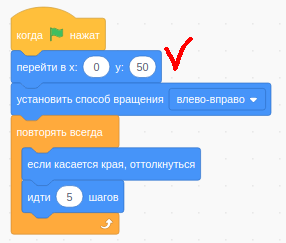
В приведенном примере, где бы ни стоял на сцене спрайт до запуска программы, как только будет нажат зеленый флажок, герой тут же окажется в точке (0; 50).
Отметим напоследок про слои. Наше пространство не двумерное, как плоскость, а трехмерное. У нас есть высота, ширина и длина. Хотя Scratch позволяет создавать только двумерные анимации, на самом деле даже в 2D-анимации есть своего рода третье измерение. Это слои.
Пусть по сцене перемещаются два спрайта. Что будет когда их координаты совпадут? Ничего. Они не столкнуться и не затормозят друг друга. Один спрайт пройдет как бы позади другого, а другой – поверх первого. Каждый живет на своем слое плоскости и ему нет дела до другого.
Однако бывает важно, слой какого спрайта расположен выше, то есть впереди. Посмотрите на рисунок:
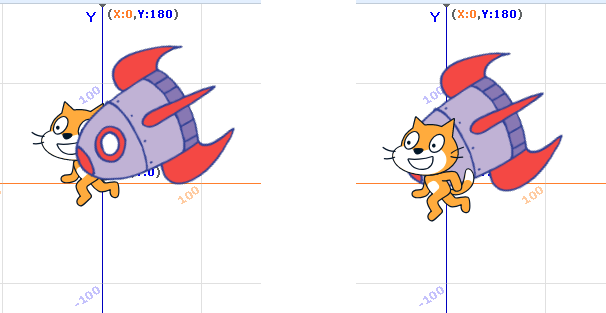
Слева слой ракеты расположен выше, слоя кота. Справа, наоборот, кот находится над ракетой.
В Scratch изменить очередность слоев можно как мышкой на сцене, так и с помощью блоков кода. Чтобы это сделать первым способом, надо взять тот спрайт, который должен быть над, и кинуть его на спрайт, чей слой должен быть под.
Блоки изменения очередности слоев находятся в фиолетовой секции «Внешний вид». Это команды «перейти на передний/задний фон» и «перейти вперед/назад на … слоя».
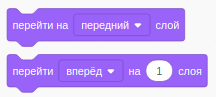
Составьте программу, в которой один спрайт постоянно ходит за указателем мыши, а второй – находится в центре сцены и, стоя на одном месте, медленно крутится по часовой стрелке. Слой первого объекта должен быть над слоем второго.
Для выполнения задания потребуются две дополнительные команды – «повернуться к указатель мыши», «повернуть по часовой стрелке на … градусов» (вместо слов «по часовой стрелке» на блоке изображена дуговая стрелка).
X Скрыть Наверх
Программирование в Scratch. Курс