
Как посмотреть историю сайта — домена?
Многие пользователи Интернета даже не подозревают, что у каждого ресурса есть своя история. Это общедоступная информация и узнать историю сайта может каждый пожелавший.
Часто бывает такое, что может измениться дизайн какого-либо ресурса, смениться логотип, доменное имя, структура, меню и многие другие параметры. В общем, меняется внешний вид и это нормально, ведь с каждым днем разрабатываются новые стили, новые шаблоны, грех не воспользоваться.
Все изменения, произведенные на площадке, будут сохранены на специальном ресурсе, название которому — машина времени для сайтов (или «веб архив»). К сожалению, у нее есть только функция перемещения в прошлое.
Суть работы сервиса в том, что он сохраняет все изменения на сайтах, реализованные в различные периоды времени. Как проверить историю домена? Допустим, вы захотели узнать, сколько лет дядьке Гуглу, и какая у него история. Клацаем сюда archive.org/web/web.php. В поисковой строке пишем Google.com и жмем BROWSE HISTORY!

Откроется специальный календарь с синими и зелеными отпечатками. Сверху панель с разными годами, а небольшой график черного цвета на ней показывает, в какие даты происходило больше изменений, а в какие меньше. G o o g l e было положено начало в 1998 году. Нажав на него, нам представится такая картина в 2002 году:

То же самое можно проделать с поисковой системой Я ндекс, а увидим мы следующее:

Подобным способом можно найти любую информацию о каждом сайте, интересующем вас. На сегодняшний день около 324 миллиардов веб страниц сохранено в архиве. И это еще не все площадки. Пригодиться веб архив может в различных ситуациях, а его бесплатное использование дает возможность любому человеку черпать знания из него.
Машина времени может понадобиться в таких ситуациях:
- Если необходимо узнать, какая была тематика. Покупая домен у его владельца, хорошо бы знать историю площадки, какое было содержимое, хороший контент или нет, и какая вообще была тематика ранее. Это поможет в дальнейшем продвижении.
- Узнать, что из себя представлял ресурс. Множество площадок остаются без присмотра, а история домена хранится, поэтому любители посидеть в архиве ведут охоту на такие доменные имена, дабы ими воспользоваться для повторного создания площадки, только уже своей.
Благодаря веб архиву вы всегда сможете оценить, какой была история сайта целиком, а потом уже решать, приобретать такой домен или нет.
Как выглядел сайт раньше?
Иногда хочется вспомнить те времена, когда по интернетам бродили динозавры, а одна песня загружалась 10 минут. Смотрим в прошлое и ностальгуем, спасибо за это онлайн-сервису: Wayback Machine – Internet Archive. Работает с 1996 года, за это время собрал в базе данных более 279 миллиардов веб-страниц.
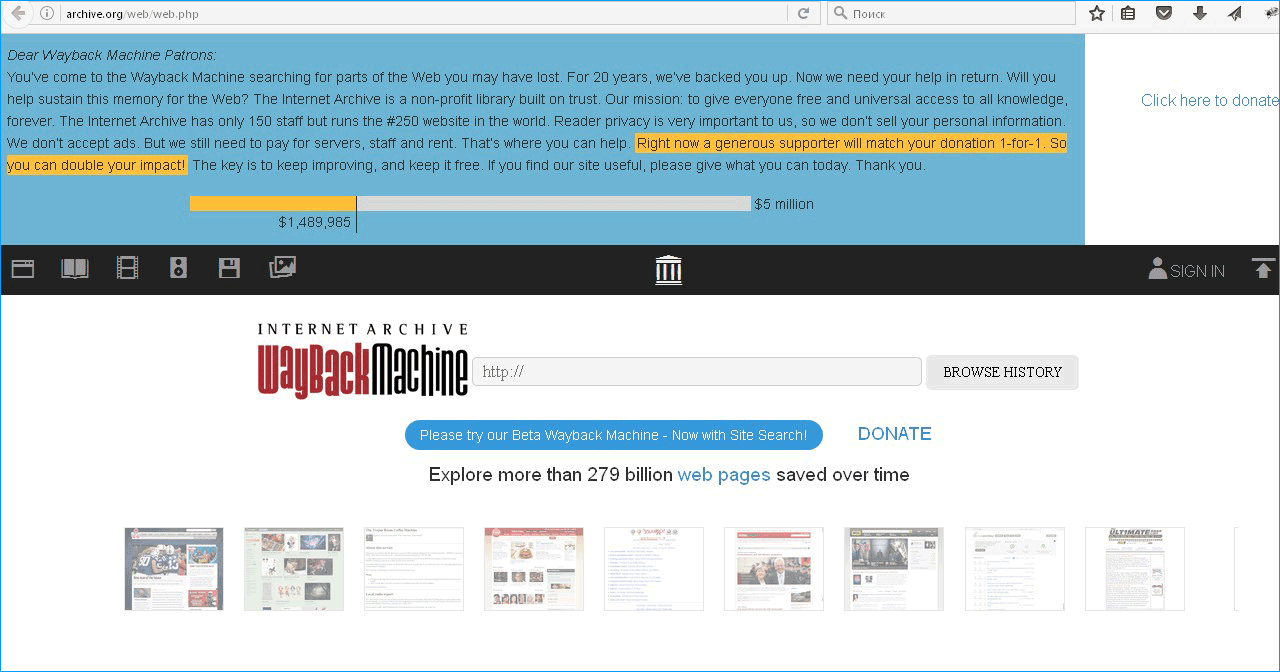
Переходим по ссылке: http://archive.org/web/web.php В строку вводим: адрес интересующего сайта и нажимаем «Browse History». Система выдаст всю историю по конкретному порталу.
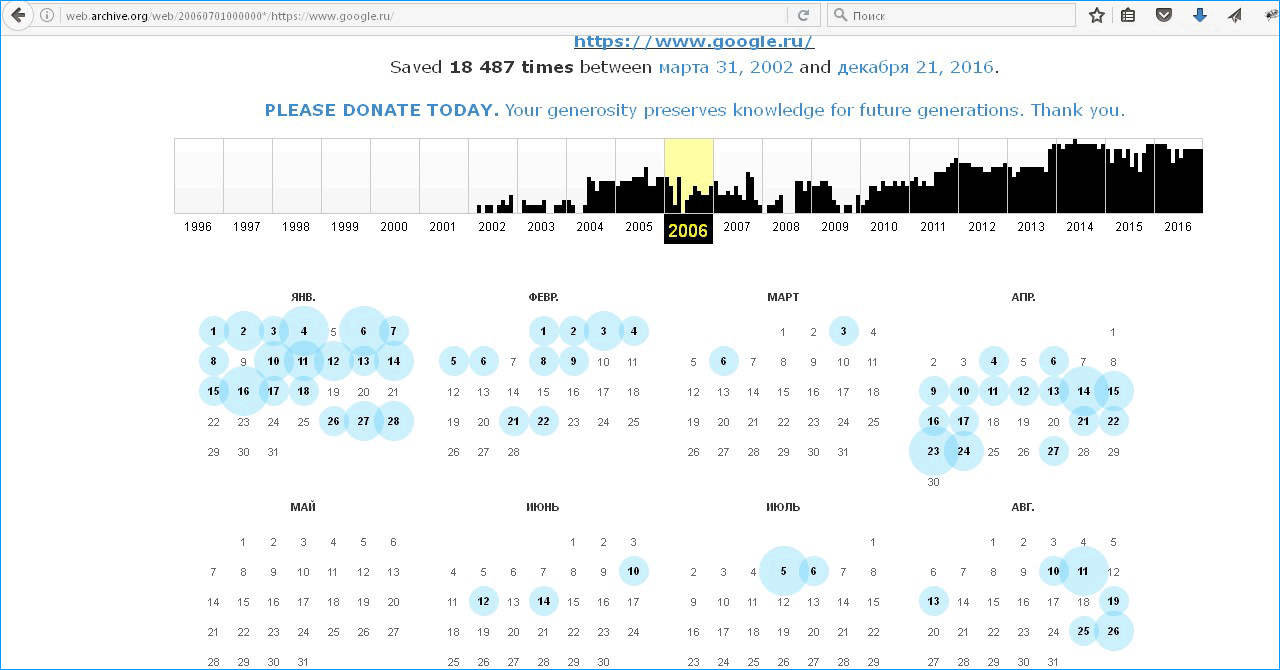
Синими кругами на календаре обведены даты резервных копий. Выбираем нужный год, дату и заглядываем в прошлое веб-страницы.
Где посмотреть, как выглядели страницы сайтов в разные годы
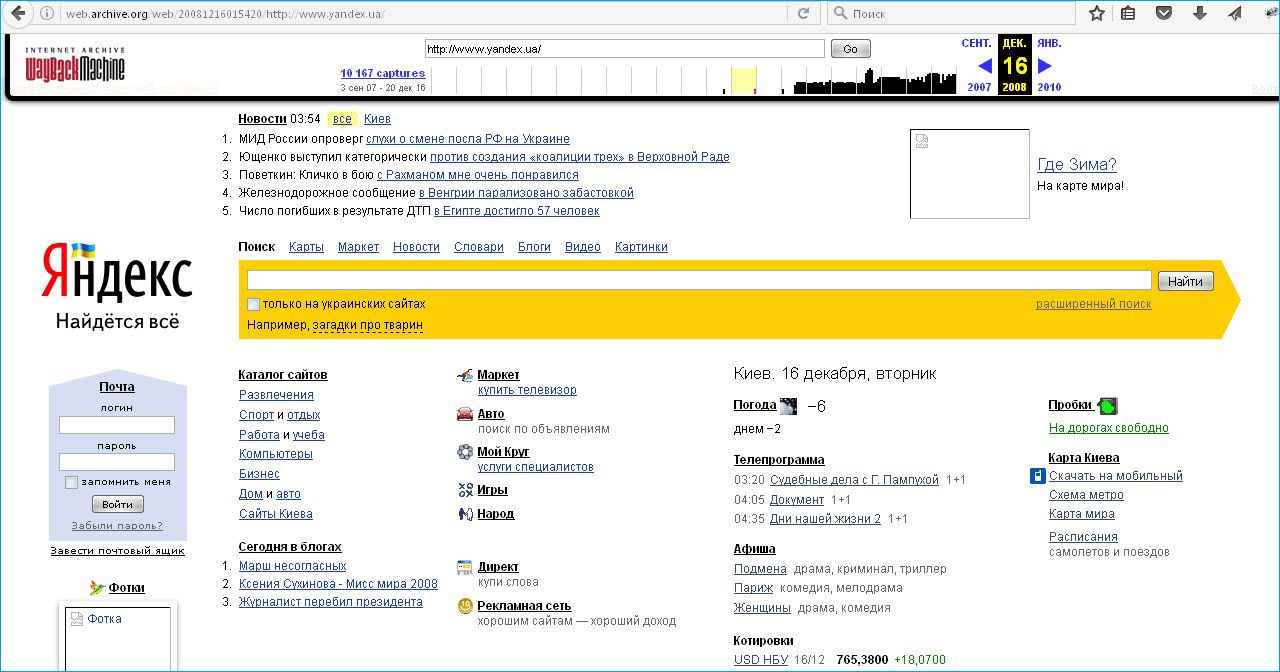
Яндекс в это время открыл первый удаленный офис в Питере, запустил Яндекс.пробки и «словари». А майл.ру начали использовать поисковик на своем портале. Через год Яндекс купит разработчика мобильного софта «Смартком» и соц. сеть «Мой круг». Запустит «Календари», блого-сервис Я.ру, портал Яндекс.Mirror и откроет школу анализа данных — бесплатный образовательный курс.
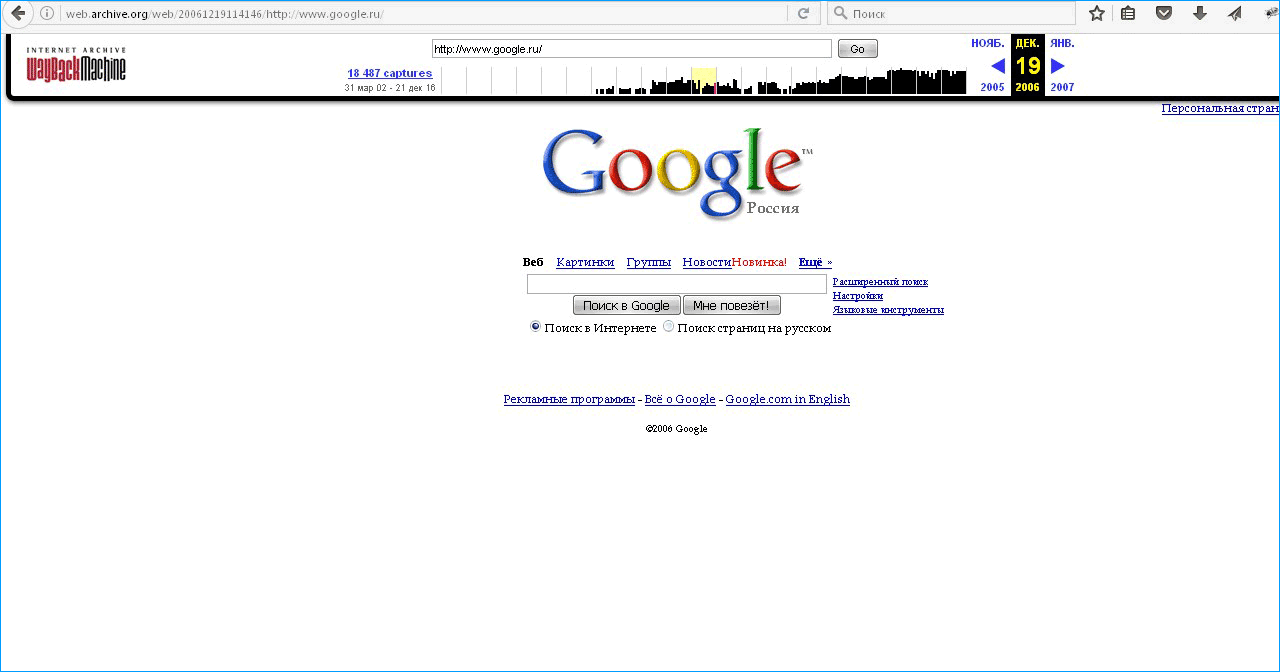
Google запускают календарь, финансы и переводчик. Открывают бесплатный хостинг изображений Picasa и объявляют о покупке YouTube. В 2007 компания установит крупнейшую систему солнечных батарей (Сейчас она обеспечивает энергией 30% офисов) и объявит о появлении Android. А сотрудники начинают ездить по офисам на велосипедах gBikes.
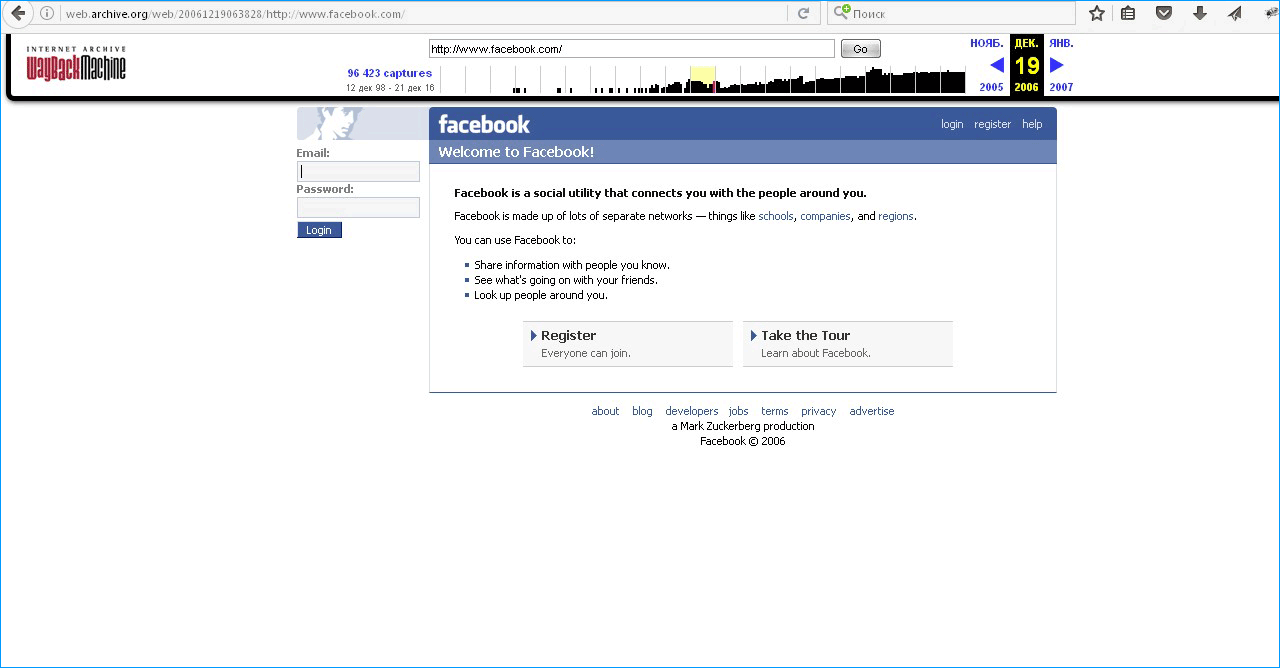
История Facebook уникальна. Только в 2004 году сервис вышел за стены Гарварда, а уже в 2008 вырос так, что количество пользователей перевалило за 50 млн. человек, а состояние Марка Цукерберга уже оценивалось в 1.5 млдр. долларов.
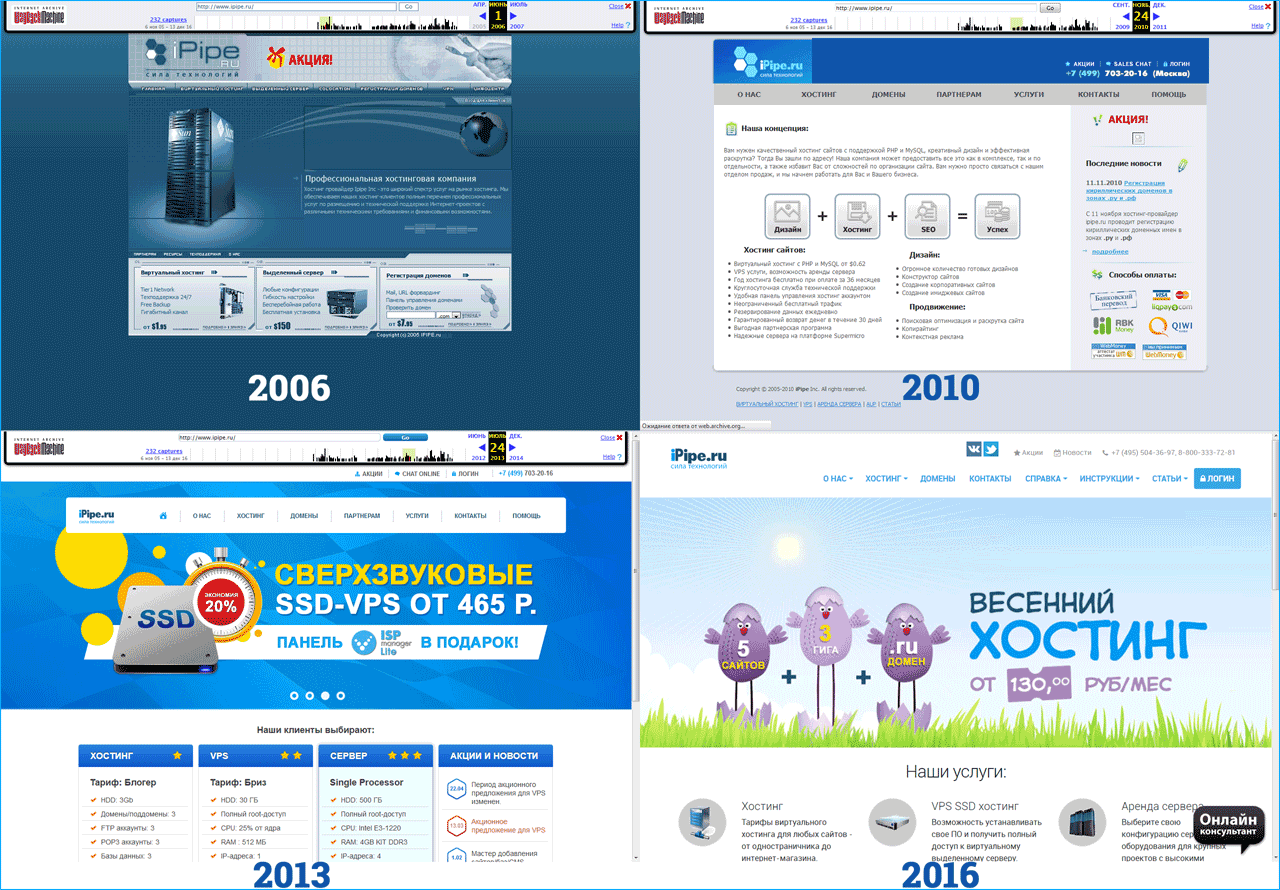
Как раньше выглядел наш сайт
А вот так менялся наш сайт с 2006 года:
iPipe – надёжный хостинг-провайдер с опытом работы более 15 лет.
- Виртуальные серверы с NVMe SSD дисками от 299 руб/мес
- Безлимитный хостинг на SSD дисках от 142 руб/мес
- Выделенные серверы в наличии и под заказ
- Регистрацию доменов в более 350 зонах
Как узнать историю сайта и восстановить его из веб-архива
История сайтов полезна вебмастерам при покупке доменов, чтобы вычислить возраст, узнать важные показатели и отделить хорошие от плохих. Ведь фильтры и баны в прошлом напрямую влияют на продвижение сайта в будущем. Поэтому стоит покупать новые домены либо домены с положительной историей.
1. Зачем нужна история сайта
Хронография домена зачастую выдаёт информацию о нём с момента создания. Виртуальные архивы сайтов также дают возможность узнать:
- сколько времени существует домен;
- как выглядел сайт раньше, вплоть до конкретной даты;
- тематику сайта в прошлом;
- наличие банов, фильтров, санкций в прошлом, действуют ли они сейчас;
- количество владельцев ресурса;
- другие домены в пределах сервера, на котором был сайт.
При помощи архивных данных, которые хранятся в интернет-архивах, можно восстановить информацию, которая была утеряна, и посмотреть, как сайт выглядел раньше. Например, если при обновлении баз данных либо смене шаблона сайт перестал работать, можно восстановить сайт из веб-архива по дате и скопировать оттуда старые тексты.
Бывает и так: анализ трафика показал, что при прошлом дизайне сайт приносил больше прибыли. Сравнение текущей и прошлой версий одного ресурса позволяет сделать соответствующие выводы и улучшить работу.
В отличие от старых доменов, новые всегда обладают чистой историей, ведь у них не было владельцев, и они не были зарегистрированы как сайты. Такие домены покупают, не боясь столкнуться с фильтрами и другими проблемами. Однако многие вебмастера предпочитают покупать готовые сайты с рук или на аукционах. Причина здесь одна: старый домен с хорошей историей легче продвинуть в поиске, чем начинать оптимизацию с чистого листа.
При покупке старого сайта нужно тщательно проверять его прошлое. Важно, чтобы на сайте не было ворованного контента, запрещённых тематик и банов по причине любых нарушений.
Чтобы убедиться, что вы покупаете не кота в мешке, вы можете пройтись по нашему чеклисту «Как проверить сайт перед покупкой».
2. Принципы работы веб-архивов
Веб-архивы время от времени посещают открытые к доступу сайты. При одном таком посещении автоматически создаются точные копии страниц, которые сохраняются на сервере архива. Под каждой копией отмечается дата. Дальше любой пользователь может восстановить нужную версию сайта через календарь.
2.1. Инструменты для проверки истории сайта, и как ими пользоваться
2.1.1. Webarchive
Самый крупный ресурс, на котором хранится история большинства сайтов, — Webarchive. Иногда этот сервис называют машиной времени сайтов или Wayback Machine. Здесь можно посмотреть даже историю тех ресурсов, которые давно прекратили существование.
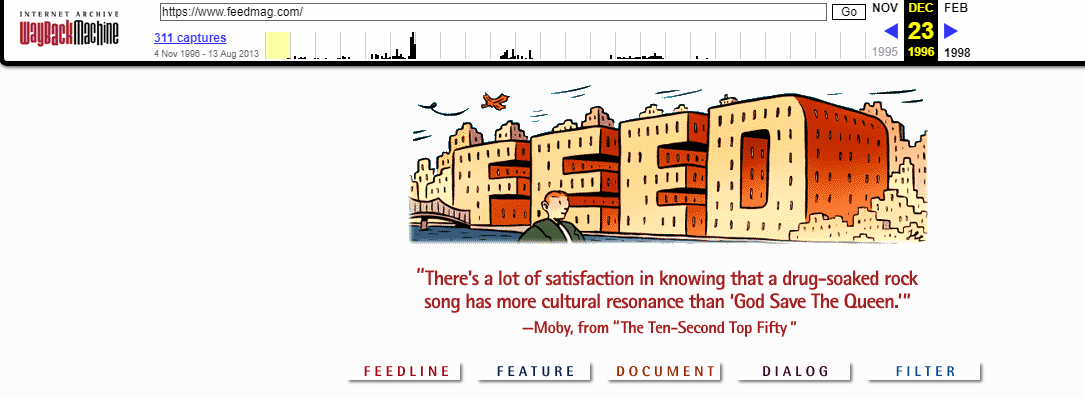
Чтобы проверить состояние домена, нужно ввести его в строку поиска и нажать Enter. Сервис выдаст информацию о сайте с момента его первой регистрации. В нижней части страницы отображается календарь с кликабельными датами. После нажатия на число архив покажет версию сайта, которая была актуальна в тот день.
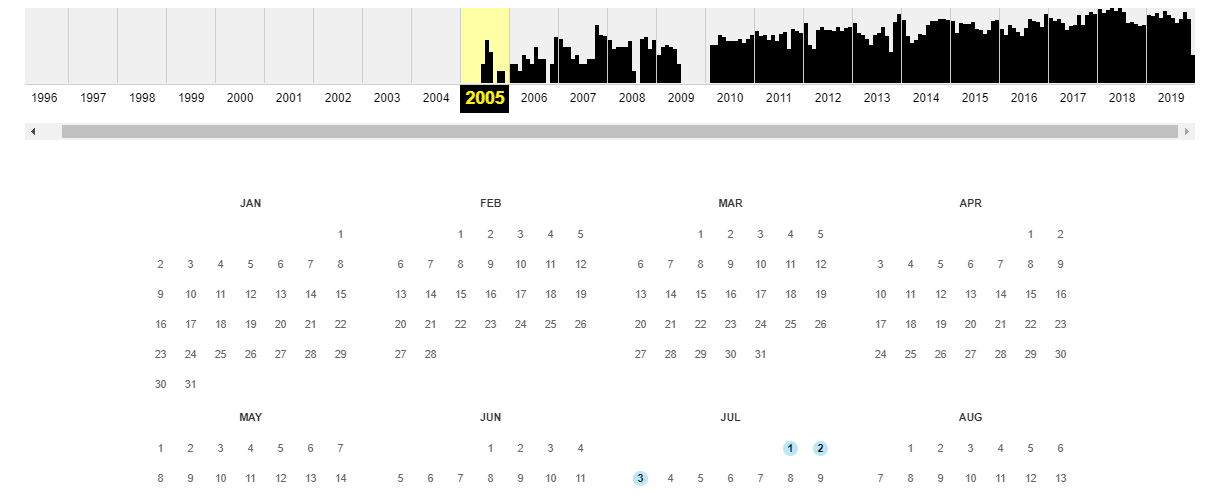
Синим цветом отмечены даты сохранения копий страниц сайта, зелёным — версии с редиректами. С помощью стрелок вверху можно проследить историю изменения сайта по хронологии.
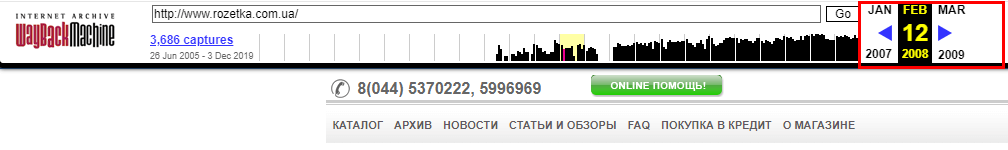
Бывает, что история сайта недоступна. Этому есть несколько причин:
- в файле robots.txt есть запрет на архивацию данных,
- владелец домена удалил сохраненные версии сайта,
- сайт был закрыт из-за нарушений прав собственности.
Чтобы запретить архивацию сайта, можно прописать в robots.txt директиву на запрет сохранения копий:
User-agent: ia_archiver Disallow: /
После этого никто не сумеет восстановить страницы вашего сайта в будущем. Но и вы сами не сможете сделать это, если потребуется.
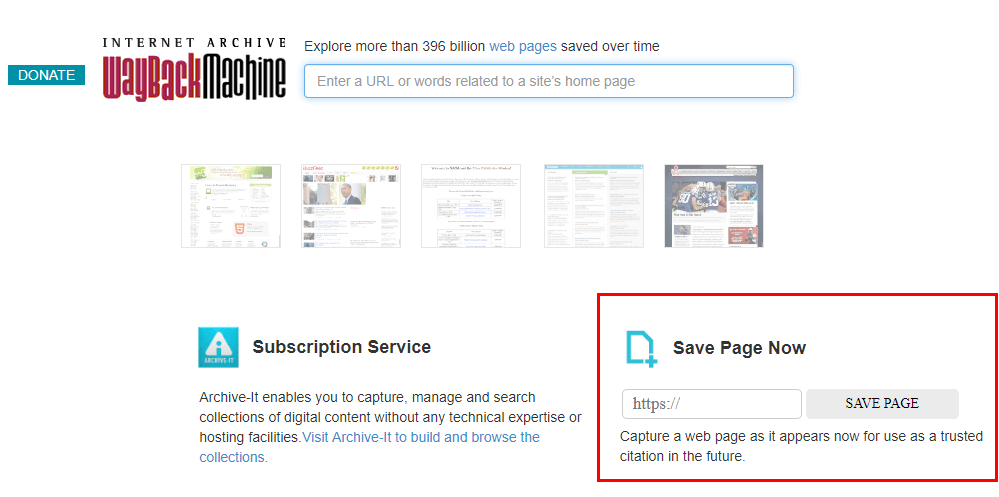
Если в Webarchive нет интересующего вас сайта, вы можете сами добавить его в сервис, сохранив актуальную копию любой страницы сайта. Для этого нужно ввести её текущий адрес и нажать «Save page».
Этот сервис также может быть полезен, когда необходимо восстановить неработающий сайт через инструмент RoboTools c большой базой уникальных текстов. Например, домен выставлен на продажу, а в его истории сохранены страницы с хорошими текстами. Так как сайта уже не существует — его страницы не индексируются. Поэтому старые тексты можно использовать для наполнения нового проекта.
2.1.2. Whois
Еще один инструмент для проверки доменных имён — Whois. С его помощью можно узнать:
- занят ли домен,
- был ли он забанен,
- количество регистраций,
- название и локацию серверов,
- дату основания и другую информацию.
Для этого нужно ввести URL в строку поиска.
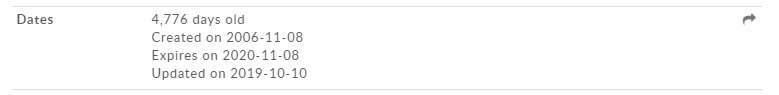
После анализа сайта при нажатии на стрелку в разделе «Dates» открывается более подробная информация о домене.
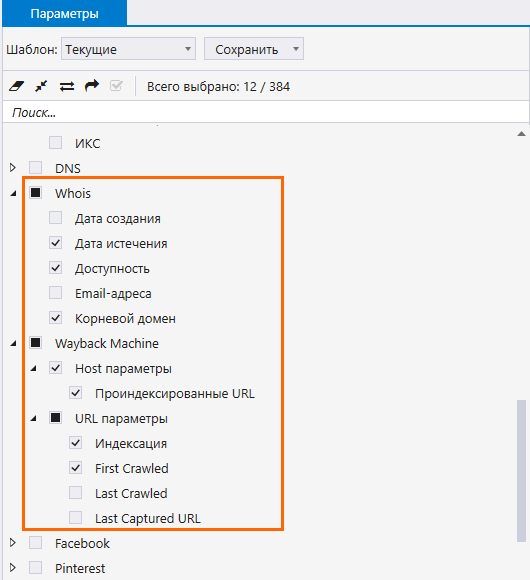
При необходимости проверить данные по Wayback Machine и Whois сразу нескольких сайтов, воспользуйтесь Netpeak Checker.
- Загрузите список доменов в программу.
- Отметьте нужные пункты из чекбоксов «Wayback Machine» и «Whois».
- Начните анализ.
- По окончании нужные данные попадут в основную таблицу.
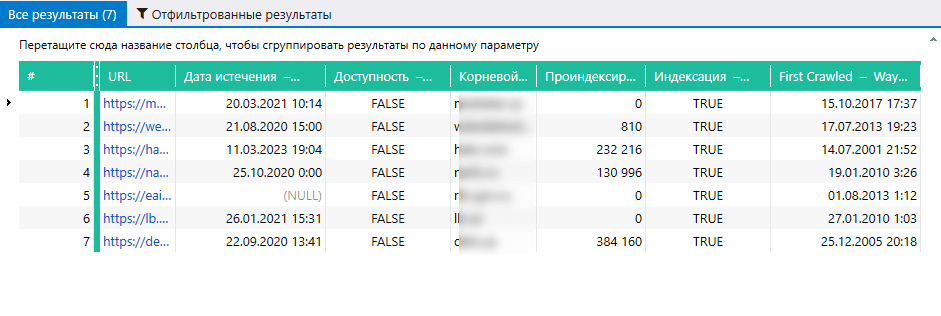
Тянуть данные из сервисов и делать массовую проверку URL вы можете даже в бесплатной версии Netpeak Checker без ограничений по времени и количеству URL, в которой также доступно много других базовых функций.
Чтобы начать пользоваться бесплатным Netpeak Checker, просто зарегистрируйтесь, скачайте и установите программу — и вперёд! ��
P.S. Сразу после регистрации у вас также будет возможность потестировать весь платный функционал, а затем сравнить все наши тарифы и выбрать для себя подходящий.
3. Как восстановить сайт из веб-архива
Для восстановления сайта из веб-архива используется сервис Аrchivarix.
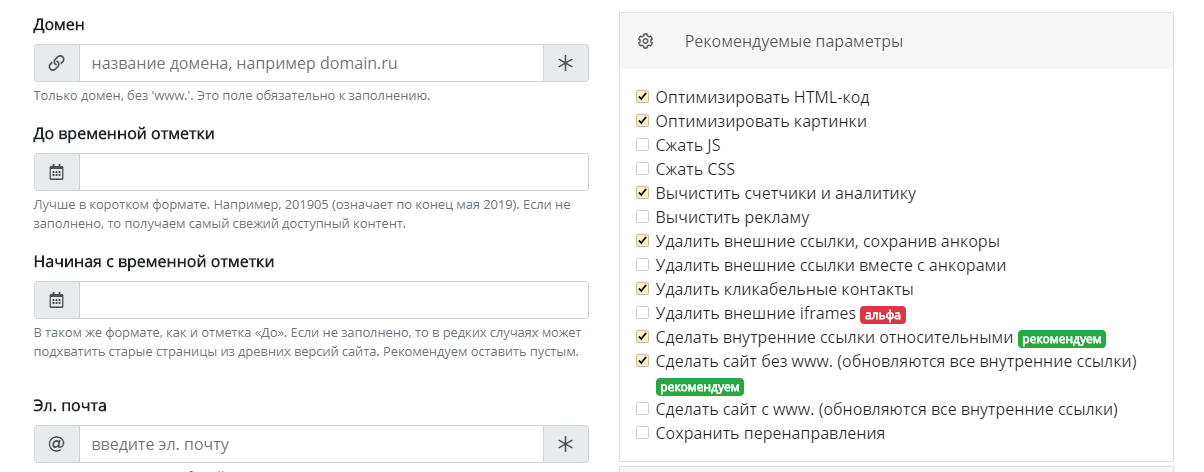
После введения информации появляется уведомление с подтверждением. Здесь же виден скриншот сайта и данные о нём. Параллельно на почту приходит письмо с архивными данными для восстановления. Остаётся загрузить эти файлы на сервер и проверить работоспособность сайта.
Подводим итоги
Посмотреть историю сайта можно при помощи веб-архивов — сервисов, которые создают копии страниц в разные периоды времени. Даже если сайт прекращает существование, информация о его предыдущих версиях может оставаться в открытом доступе.
Самым популярным сайтом для просмотра и восстановления истории считается Wayback Machine. В нём хранятся все данные о домене с момента его создания. Если нажать на определенную дату в календаре, можно посмотреть, как выглядел сайт в тот день.
Дополнительно вы можете сохранить текущую версию сайта, восстановить неработающий домен и проверить, был ли он когда-то использован. Также узнать информацию о сайте можно при помощи сервисов Whois, Whoishistory и аналогов.
А вы пользуетесь этими сервисами? Для каких задач? Поделитесь в комментариях 😊
Как посмотреть на сайт в прошлом: инструмент + способ восстановления

Сервис, который может показать, как выглядели сайты в прошлом, напоминает своеобразную машину времени в интернете. С его помощью можно перенестись на год, два или двадцать лет назад и увидеть, какими ресурсы были тогда. Зачем может понадобиться эта информация и как воспользоваться данным сервисом?
- 1 Для чего нужно искать старые версии сайтов
- 2 Как узнать прошлое веб-ресурса с помощью archive.org
- 2.1 Если это страница Вконтакте
- 3.1 Поисковик Яндекс
- 3.2 Поисковик Google
- 3.3 YouTube
- 3.4 Википедия
- 3.5 ВКонтакте
Для чего нужно искать старые версии сайтов
Причины, по которым может быть необходимо посмотреть сайт в прошлом времени, могут быть абсолютно разными. Часто это желание погрузиться в приятную ностальгию. Например, посмотреть, как раньше выглядели популярные площадки и соцсети. Или же посмотреть, как выглядел собственный сайт несколько лет назад. К счастью, существует инструмент, который позволяет это сделать, даже если сам ресурс уже давно не доступен.
Как это возможно? Если сайт существует в интернете хотя бы пару дней, он попадает в веб-архив. Инструмент сохраняет его код, благодаря чему, можно увидеть, как он выглядел даже много лет назад.
Причины, по которым возникает необходимость посмотреть порталы в прошлом времени:
- Отслеживание истории изменений. Такая потребность может возникать у копирайтеров или журналистов для подготовки нового контента. Также это может быть нужно для анализа конкурентов: можно проследить путь их развития и увидеть допущенные ошибки.
- Восстановление ресурса. Если пользователь забыл продлить домен или не сделал бэкап, веб-архив будет отличным вариантом восстановления.
- Поиск уникального контента. Если площадка больше не доступна, её контент становится уникальным. Можно использовать его полностью или частично, предварительно проверив уникальность.
- Увидеть необходимый контент, если страница уже недоступна. Например, пользователь добавил площадку в закладки, а через время оказалось, что её больше нет. Тогда посмотреть её содержимое можно только с помощью веб-архива.
Как узнать прошлое веб-ресурса с помощью archive.org
Чтобы узнать, как выглядел конкретный веб-ресурс ранее, можно воспользоваться сайтом для просмотра страниц в прошлом – a rchive.org. Для этого нужно выполнить следующее:
- Пройти по ссылке https://archive.org/.
- Ввести URL-адрес и нажать кнопку «Go».

- Выбрать интересующий период времени. Затем с помощью календаря найти нужную дату, навести на нее курсор мыши и выбрать время сохранения копии (в списке может быть как одна, так и несколько ссылок).

После этого откроется главная страница в том виде, какой она была в выбранный период.

Учитывайте, что кликабельными в календаре являются только дни, помеченные синим или зеленым цветом. Посмотреть, как выглядел сайт в даты без подсветки, не получится.
Если это страница Вконтакте
Аналогичным образом можно узнать содержимое страницы ВКонтакте. Достаточно указать на нее ссылку в соответствующем поле.
По сравнению с новостными или другими веб-ресурсами здесь будет меньше подсвеченных дат с сохранённым содержимым. Количество дат зависит от популярности страницы: у обычных пользователей их будет немного, в то время как у известных медиа-личностей – на порядок больше.

Дальнейшие действия такие же: надо выбрать любую из подсвеченных дат и перейти по кликабельной ссылке. В этой же вкладке откроется страница в ВКонтакте с актуальным на тот момент содержимым.
Как выглядели культовые сайты раньше
Для примера посмотрим, как выглядели популярные ресурсы раньше, а именно Яндекс, Google, YouTube, Википедия и VK. Все из них с течением времени претерпели кардинальные изменения в дизайне.
Поисковик Яндекс
Поисковую систему Яндекс официально анонсировали 23 сентября 1997 года. С тех прошло более 20 лет, и сегодня это одна из самых популярных поисковых систем в мире.
В веб-архиве первая сохраненная копия датируется 6 декабря 1998 года.

На тот момент выглядел Яндекс вот так:

Поисковик Google
Поисковая система Google была основа чуть позже – в 1998 году. Сейчас это самая популярная поисковая система в мире.
Первые сохраненные копии появились в веб-архиве в конце 1998 года. Например, 2 декабря Гугл выглядел вот так:

YouTube
Youtube начал свою работу в феврале 2005 года. Первые сохраненные в веб-архиве копии появились в конце апреля 2005 года. На то время сервис имел минималистичный дизайн, и видно, что он являлся не более, чем видеохостингом:

Википедия
Википедия появилась 15 января 2001 года. Сегодня она является наиболее крупным и популярным справочником в интернете и содержит более 40 миллионов статей, которые доступны на 301 языке.
В веб-архиве первая сохраненная копия Википедии датируется 27 июля 2001 года:

ВКонтакте
Популярная в России и других странах социальная сеть ВКонтакте была создана 10 октября 2006 года.
В веб-архиве первая сохраненная копия сайта датируется 8 ноября 2006 года. На нём видно, что сайт изначально был ориентирован на студентов и выпускников.

Можно ли восстановить сайт из вебархива?
При потере данных, восстановить свой сайт можно с помощью сайта https://webarchiveorg.ru/. Для этого нужно:
- ввести URL-адрес;
- выбрать нужный год, месяц и число;
- нажать кнопку «Восстановить сайт».

Услуга является платной, поэтому перед восстановлением рекомендуется ознакомиться с тарифами. Точная стоимость зависит от количества сайтов и его страниц.
Выводы
С помощью веб-архива можно посмотреть, какой дизайн и контент были у сайтов раньше, что может быть необходимо для восстановления данных, анализа конкурентов, поиска интересного контента с исчезнувших ресурсов или просто ради интереса.