
Использование плейлиста «Мой год» в Apple Music
Плейлист «Мой год» в Apple Music позволяет снова послушать музыку, которая сопровождала вас в уходящем году. С его помощью можно получить представление о музыке, которую вы слушали в течение года. Также можно составлять плейлисты из любимых композиций года — по одному на каждый год подписки на Apple Music.
Как работает плейлист «Мой год» в Apple Music
- История прослушивания в Apple Music.
- Количество воспроизведений песни, исполнителя, альбома, плейлиста, жанра и станции.
- Время прослушивания песни, исполнителя, альбома, плейлиста, жанра и станции.

Просмотр статистики прослушивания плейлиста «Мой год» в Apple Music
- Перейдите на веб-сайт replay.music.apple.com/ru.
- Выполните вход с помощью того же идентификатора Apple ID, который используется для подписки на Apple Music.
- Нажмите «Начало работы». Здесь вы можете выполнять следующие действия.
- Получать информацию за год: если вы прослушали достаточное количество музыки, вы можете просматривать песни, исполнителей и альбомы, которые слушали в этом году, а также количество воспроизведений и время прослушивания.
- Просматривать плейлист «Мой год» в конце года: в конце календарного года вы можете просмотреть свои любимые песни, исполнителей, альбомы, жанры, плейлисты и станции, а также количество воспроизведений, общее количество и время их прослушивания.
- Воспроизводить подборку лучших композиций в конце года: отпразднуйте конец вашего музыкального года с помощью подборки композиций, которые вы слушали чаще всего, и соответствующего видеоряда.
- Делиться информацией: нажмите кнопку «Поделиться», чтобы поделиться персонализированной информацией о прослушиваниях в сообщении или социальных сетях.
Переход к плейлисту «Мой год» и предоставление доступа к нему
- Откройте приложение Apple Music.
- Перейдите на вкладку «Слушать».
- Прокрутите вниз до раздела «Топ-песни плейлистов «Мой год»». Здесь вы сможете выполнить следующие действия.
- Открыть плейлист «Мой год» за текущий год, чтобы увидеть еженедельно обновляемый список наиболее полюбившихся композиций за текущий год.
- Просмотреть плейлисты «Мой год» за предыдущие годы.
- Добавить плейлист «Мой год» в медиатеку. Откройте плейлист «Мой год», затем нажмите кнопку или «+Добавить».
- Поделиться плейлистом «Мой год» в Instagram, Facebook или другой социальной сети.
Если плейлист «Мой год» не отображается
Возможно, необходимо прослушать больше композиций. Проверьте индикатор выполнения на сайте плейлиста «Мой год», чтобы узнать, сколько композиций необходимо прослушать. Когда вы прослушаете достаточно музыки, вы получите уведомление о готовности плейлиста «Мой год».
Если плейлист «Мой год» все еще не отображается, убедитесь, что использование истории прослушивания включено для всех ваших устройств.
- На iPhone или iPad: перейдите в «Настройки» > «Музыка» и включите параметр «Использование истории».
- На Mac: в приложении Apple Music выберите «Музыка» > «Настройки», перейдите на вкладку «Основные» и установите флажок «Использовать историю прослушивания».
- На устройстве Android: в верхней части приложения Apple Music нажмите кнопку «Еще» , перейдите в «Настройки», а затем включите параметр «История прослушивания».
Apple Music и конфиденциальность
Приложение Apple Music разработано с соблюдением требований к защите ваших данных и позволяет выбирать сведения, которыми вы хотите поделиться.
Доступность Apple Music может отличаться в зависимости от страны или региона. Узнайте, что доступно в вашей стране или регионе.
Информация о продуктах, произведенных не компанией Apple, или о независимых веб-сайтах, неподконтрольных и не тестируемых компанией Apple, не носит рекомендательного или одобрительного характера. Компания Apple не несет никакой ответственности за выбор, функциональность и использование веб-сайтов или продукции сторонних производителей. Компания Apple также не несет ответственности за точность или достоверность данных, размещенных на веб-сайтах сторонних производителей. Обратитесь к поставщику за дополнительной информацией.
Что сейчас с 5G в России? Уже есть или еще нет? Когда появится?

Вы могли слышать о том, что компании запускают в российских городах пилотные зоны 5G. А что там происходит? Зачем это нужно? И почему телефоны с поддержкой 5G выходят уже несколько лет, а применить их почти негде? Все по порядку.
Зачем нужна связь 5G? Почему нельзя остановиться на 4G?
1
Первое: 5G намного быстрее 4G.В прошлом году в России скорость мобильного интернета составила 21,7 Мб/с. Причем по сравнению с прошлым годом она снизилась на 3 Мб. Домашний интернет побыстрее. По данным сервиса Speedtest на январь 2022 года, средняя скорость загрузки в России — 69,8 Мб/с. Поэтому многие платят отдельно за домашний интернет, отдельно за мобильную связь. Но 5G обещает скорость гораздо больше — от 1 гигабайта в секунду. Платить отдельно за домашний интернет не понадобится. Для потребителя это значит, что фильм можно будет скачать меньше чем за секунду, а не за несколько секунд. Но потребителю такая скорость не требуется, для фильмов и игр хватает 4G. А 5G нужна для развития интернета вещей.
Второе: то, что продолжает предыдущий пункт, — сети 5G выдерживают большее количество устройств. Наверняка вы сталкивались с тем, что на стадионе или на концерте скорость мобильного интернета падает, потому что очень много человек в одном месте пользуются сетью и она перегружена. При покрытии 5G такого не должно быть. Для мира будущего важно, чтобы сети справлялись с большим количеством устройств, которым нужен интернет, так как их становится все больше.
Например?
2
За последние пять-десять лет мир сильно изменился. Вокруг нас стало гораздо больше гаджетов. Какие-то из них мы не замечаем. Пример: на дорогах камеры и разнообразные датчики передают по сети информацию о заторах, ДТП. На основании этой информации светофоры меняют режим работы. Скоро на дорогах станет больше беспилотных автомобилей, которые должны постоянно и очень быстро обмениваться данными. Но есть то, что нельзя не заметить в быту. В квартирах стало больше устройств, подключенных к сети, люди покупают смарт-колонки, загаджетованные бытовые приборы вроде чайника и пылесоса, которые можно включить удаленно через приложение. И так далее.
Еще одно важное применение 5G: удаленное управление сложными аппаратами. Это, например, проведение медицинских манипуляций на расстоянии. Такие эксперименты уже проводились как раз с использованием 5G. В 2019 году в Китае хирург удаленно имплантировал пациенту с болезнью Паркинсона нейростимулятор в головной мозг. Врач находился на расстоянии более 2700 км от клиники, где проводилась операция.
В конце концов, метавселенные, обещанные Марком Цукербергом и другими главами технологических компаний, тоже нуждаются в 5G. Полноценно все то, что там планируется делать, невозможно на текущей скорости.
В России сейчас есть сети 5G?
3
Нет коммерческих повсеместно распространенных 5G-сетей. Технологию тестируют в ограниченных пилотных зонах, преимущественно в крупных городах — Москве, Санкт-Петербурге, Нижнем Новгороде, Набережных Челнах, Томске, в техноградах Иннополис (рядом с Казанью) и Сколково. Такие сети операторов называются 5G-ready. Это характеризует этап развития 5G в России как подготовительный.
Что делают в этих пилотных зонах?
4
В них пробуются разные сценарии использования 5G. Примеры:
- в зоне 5G в Сколково тестируется удаленное управление роботами и беспилотниками, возможности видеонаблюдения, беспроводной офис;
- у МТС в Москве, Санкт-Петербурге, Московской и Ленинградской областях есть пилотные зоны, где к сети 5G могут подключиться обычные абоненты оператора, если их смартфоны поддерживают диапазон 4,9 ГГц (не все модели и не всех производителей);
- в конце 2021 года пилотная зона 5G создана в Москве на базе больницы им. Боткина. Здесь планируют вести прикладные исследования, испытывать прототипы и опытные образцы инновационных медицинских решений и работающих на базе 5G.
Кто создает эти пилотные зоны и в целом развивает 5G?
5
Операторы связи. Сегодня пилотные зоны для тестирования 5G есть у всех операторов «большой четверки»: МТС, «Билайн» («Вымпелком»), «Мегафон», Теле2 («Т2 Мобайл»). Но только МТС получила лицензию на оказание услуг мобильной связи стандарта 5G в России, по данным Минцифры РФ на январь 2022 года. У МТС больше всего пилотных зон. С начала тестирования количество устройств, подключавшихся в пилотных зонах оператора в Москве и Санкт-Петербурге, превысило 10 тыс.
Зачем это нужно?
6
В ближайшие годы 5G обгонит 4G по популярности. По прогнозам, люди будут выбирать связь нового поколения, когда она станет также доступна, как 4G. По данным Ericsson, который в своем докладе прогнозирует именно этот ход развития событий, за третий квартал 2021 года в мире появилось 98 млн новых 5G-подключений и 48 млн — 4G. Впрочем, стоит уточнить: не все эксперты придерживаются мнения, что потребители будут очень быстро уходить с 4G, вполне подходящего для бытового использования. Хотя бы потому, что для потребителей использование 5G, как правило, дороже. Но главное, чтобы получить доступ, потребуется телефон, который поддерживает сеть. Устройства старше трех-четырех лет, с высокой вероятностью, не поддерживают. Например, Apple выпустила первые iPhone c поддержкой 5G только в 2020 году.
А что с 5G в мире?
7
В некоторых странах уже есть коммерческие 5G-сети. В 72 странах уже запустили сервисы 5G, более 460 операторов из 137 стран инвестируют в пилотные разработки и проводят тестовые запуски.
«Проникновение 5G-услуг в Китае достигло 30% от общего размера населения, следом идут Южная Корея и США, также большую активность проявляет Европа. Самый крупный рынок, где пока отсутствует 5G, — это Индия. Ожидается, что там запуск сетей состоится к концу 2022 года», — уточняет Дмитрий Лаконцев, доцент Сколковского института науки и технологий, кандидат технических наук.
По уровню проникновения 5G-технологий сейчас лидирует Северо-Восточная Азия, за которой следуют страны Персидского залива и Западной Европы. В ближайшие годы, по прогнозу в докладе Ericsson, лидерство перейдет к Северной Америке.
Почему в России еще не запустили коммерческую сеть 5G?
8
Изначально операторы связи столкнулись с тем, что не смогли получить разрешение на использование частот 3,4–3,8 ГГц, используемых в большинстве стран для создания инфраструктуры для 5G. У каждой службы радиосвязи есть собственные диапазоны частот, где им разрешено работать. У спутников они одни, у эфирного телевидения — другие, а у домашнего Wi-Fi — третьи. Каждое поколение сотовой связи (2G, 3G и 4G) тоже получало свои частоты в России. Однако пятому поколению — 5G — их до сих пор не выдали. А частот для полноценного запуска новых сетей нужно много. «Мировой опыт показывает, что оптимальное решение для полноценного запуска 5G — это одновременное использование трех диапазонов частот: низкого, среднего и миллиметрового», — уточняет Дмитрий Лаконцев. В большинстве стран, где уже развернуты сети 5G, в первую очередь были выданы частоты в среднем диапазоне, в полосе 3,4–3,8 ГГц. Однако в России эти частоты используются для нужд Минобороны и Роскосмоса.
Как тогда работает 5G в пилотных зонах?
9
Государственная комиссия по радиочастотам выделила операторам связи другие частоты.
- В 2019 году — 4,8–4,99 ГГц (190 МГц) для создания пилотных зон сетей связи 5G.
«Диапазон 4,8–4,99 ГГц определен в России как приоритетный для развертывания 5G. Его используют ограниченное количество стран (Китай и Япония)», — говорит Дмитрий Лаконцев.
- В 2020-м — 24,25–24,65 ГГц (400 МГц), но при условии использования радиоэлектронных средств (РЭС) только российского происхождения. Такие РЭС должны быть включены в Единый реестр российской радиоэлектронной продукции.
В конце 2021 года добавлены отдельные полосы в диапазоне 4,4–4,99 ГГц (4400–4555 МГц и 4630–4990 МГц).
- В 2022 году НИИ Радио вместе с Huawei начали тестировать в Москве оборудование для 5G в диапазоне 6,4–7,1 ГГц. Как уточнили в НИИ Радио, частоты 6 ГГц с применением новейших технологий связи могут частично компенсировать недоступность диапазона 3,4–3,8 ГГц.
«Средний диапазон (ниже 6 ГГц) необходим для емкости и покрытия в крупных населенных пунктах, — уточняет Дмитрий Лаконцев. — В большинстве стран с развернутыми сетями 5G для этих целей используется диапазон 3,4–3,8 ГГц. Однако чем ниже полоса, тем лучше распространение сигнала и покрытие внутри зданий. К примеру, оператор T-Mobile — лидер по развертыванию 5G в США — использует для этих целей 2,5 ГГц.
- «Периодически появляется информация о возможном выделении диапазона 3,4–3,8 ГГц для строительства сетей 5G в Московском метрополитене», — добавляет Дмитрий Лаконцев.
Российское оборудование для 5G уже есть?
10
Сейчас нет серийного отечественного оборудования. Есть успешные рабочие прототипы, например, у Сколтеха. Ростех планирует начать выпуск базовых станций в 2024 году.
«В основном операторы используют в тестовых зонах оборудование иностранных поставщиков. В 2019 году, когда для тестирования 5G выделили диапазон 4,8–4,99 ГГц, его поддерживали только базовые станции китайской компании Huawei. Сейчас можно использовать также оборудование других вендоров, к примеру Nokia и Ericsson. Единственная площадка, где используется отечественное оборудование 5G, — тестовая зона на территории «Сколково». Это совместный проект Сколтеха, МТС и фонда «Сколково», — говорит Дмитрий Лаконцев.
То есть сервисы 5G в России не появятся еще два года? Это очень плохо, что мы отстаем?
11
Да, запуск планируется в 2024 году.
В феврале 2022 года Минэкономразвития опубликовало «Белую книгу» — сводный анализ развития высоких технологий в России и за рубежом. В ней говорится, что по уровню развития 5G Россия отстает от мировых лидеров на три-пять лет.
«Страны, уже начавшие внедрять 5G, обладают существенным преимуществом. С учетом отложенного запуска 5G в России образующийся к этому моменту разрыв может достичь критических значений как в отношении уровня развития инфраструктуры сетей 5G, так и степени готовности сервисов на их основе», — сказано в документе. При этом в Минэкономразвития отмечают, что «ряд отечественных решений для развертывания 5G можно считать успешными. В первую очередь это разработки программ для телеком-операторов».
Проблема ли то, что в России под создание сетей 5G выделены не те частоты, что в большинстве стран?
12
Экосистема оборудования, например, с поддержкой диапазона 4,8–4,99 ГГц хуже развита. «Далеко не все модели пользовательских устройств (смартфонов и пр.) и базовых станций смогут работать в российских 5G-сетях. Операторам и абонентам придется выбирать из меньшего количества моделей. Из этого вытекает проблема с роумингом — многие иностранные пользователи, приезжая в нашу страну, не смогут воспользоваться услугами 5G, так как их смартфоны не будут поддерживать работу в наших диапазонах. У диапазона 4,8–4,99 ГГц есть и другие недостатки. Во-первых, здесь смогут разместиться не более двух операторов с полосой 100 МГц. Во-вторых, обеспечить масштабное покрытие в этом диапазоне будет слишком дорого, он больше подходит для охвата центральных районов городов с наибольшей плотностью жителей», — уточняет Дмитрий Лаконцев.
Кому принадлежат радиочастоты? Их можно купить? Их выделяют бесплатно или за деньги?
13
Радиочастоты принадлежат государству и сдаются в аренду.
«В России существует два вида платы за доступ к этому ресурсу — разовая и ежегодная. Разовая взимается, когда компания или частное лицо получает разрешение на использование радиочастот. Ежегодная выплачивается регулярно. Размеры и той, и другой платы определяются по специальной методике и зависят от многих факторов: объема ресурса, диапазона, технологий, которые используются. Так что здесь все индивидуально для каждой компании. Зато есть данные в целом по российскому рынку. К примеру, в 2019 году объем платежей за использование спектра составил почти 18 млрд рублей. Кроме того, российским законодательством предусмотрено проведение частотных аукционов, участвуя в которых, компании платят за возможность использовать этот дефицитный ресурс. Такой вид торгов можно считать дополнительным способом взимания платы за спектр. В России успешно завершились всего два аукциона, еще два были объявлены, но не состоялись. Частотные аукционы отлично прижились в большинстве стран с рыночной экономикой. Обычно на торги выставляются участки спектра, необходимые для предоставления услуг мобильной связи, а участвуют в них сотовые операторы. Итоговая стоимость частот на аукционе может быть очень высокой. К примеру, в начале 2021 года в США завершились торги по продаже 280 МГц в полосе 3,7–3,98 ГГц, которые предназначены для развертывания сетей 5G. Выплаты операторов составили более $80 млрд, что является абсолютным мировым рекордом», — говорит Дмитрий Лаконцев.
А в других странах?
14
За использование радиочастот компании платят в большинстве стран. «Нужно учесть, что обычно за доступ к спектру платят гражданские пользователи, — добавляет Дмитрий Лаконцев. — Для правительственных служб такая плата может быть минимальна или полностью компенсироваться из бюджета. Отсутствие платы за спектр может привести к появлению так называемых бумажных сетей, когда компания получила частоты, но не использует их, чтобы потом продать. Установление платы стимулирует использовать спектр и освобождать его для других пользователей, уменьшая дефицит».
Анастасия Акулова
Фриланс: что это такое, что придётся делать и сколько вам будут платить
Какие плюсы и минусы есть у фриланса, кому он подойдёт и как кратно увеличить доходы, работая на себя.

Иллюстрация: Shyntartanya / Shutterstock / Miltiadis Fragkidis / Unsplash / Picsart / Annie для Skillbox Media

Дарья Чепурнова
Обозреватель Skillbox Media, отраслевой журналист. Работала с TexTerra, SMMplanner, «Нетологией», «ПланФактом», Semantica. Написала больше 60 текстов для рекламных кампаний в «Дзене». Вела нишевой канал на YouTube.
На фрилансе можно работать в комфортном режиме и зарабатывать кратно больше средней зарплаты в вашем регионе. Я сама была фрилансером восемь лет. На старте я зарабатывала 5–20 тысяч рублей в месяц, а в последние несколько лет — 120 тысяч рублей в месяц. При этом я живу в небольшой станице с населением 10 тысяч человек и ни дня не работала в офисе.
В этом материале расскажу о фрилансе, основываясь на своём опыте и на данных опросов и исследований.
- Что такое фриланс и кто такой фрилансер
- Кто может работать на фрилансе
- Какие у фриланса плюсы и минусы
- Кому подходит такая работа
- Сколько зарабатывают фрилансеры
- Как стать фрилансером
- Как узнать больше о фрилансе
Что такое фриланс и кто такой фрилансер
Фриланс — это удалённая кратковременная работа не по трудовому договору. Вы выполняете работу для клиента, а когда заканчиваете её, ищете следующего. Или постоянно работаете с несколькими клиентами, но не числитесь ни у кого в штате.
Фрилансер — это свободный специалист, человек, который работает на себя. Он сам организует своё рабочее время и решает, какие заказы брать, но и ищет работу тоже сам. У фрилансера нет руководителя, который обеспечивает работой, но есть ответственность перед клиентами. И эта ответственность даже больше, чем ответственность в работе по найму на аналогичной должности.
Работать на фрилансе могут люди многих профессий. Например, копирайтеры, маркетологи, SMM-специалисты. Подробнее об этом поговорим ниже.

Для одних фриланс — подработка. Его совмещают с работой, учёбой или декретом и уделяют ему пару часов в день. Люди, для которых фриланс — подработка, могут выполнять задачи ночью, по дороге на основную работу или днём, пока спит ребёнок.
Для других фриланс — единственный источник дохода. Ему могут уделять как два, так и 8–10 часов в день. Для меня фриланс был единственным источником дохода восемь лет, и я работала с 8:00 до 18:00 с перерывом 2–3 часа — почти как в офисе.
Фриланс — популярная форма занятости. В 2020 году в исследовании PricewaterhouseCoopers объём российского рынка фриланса оценили в 41 миллиард долларов. На тот момент Россия входила в первую десятку стран по выручке фрилансеров.
Всего четверть удалёнщиков в России работают на одного работодателя, а 40% — на нескольких или имеют основную работу и подработку. Это данные опроса биржи фриланса Finder.vc, в котором приняли участие более 1700 человек.
Кто может работать на фрилансе
На фрилансе могут трудиться все, кому не нужно лично присутствовать на рабочем месте. Продавцу в магазине это нужно — дистанционно разложить товары на полки и пробивать их на кассе не получится. А вот бухгалтер может работать с электронными документами и программами — для этого ему нужен только компьютер, а находиться он может где угодно.
Есть много сфер, в которых можно работать удалённо, — продажи, финансы, техподдержка, образование и другие. В этом разделе мы расскажем о нескольких специальностях, позволяющих брать заказы на фрилансе. Для работы по ним не нужно учиться в вузе, а начать получать хороший доход можно быстро.
Копирайтер. Это специалист, который создаёт контент — например, статьи в блог, цепочки писем для email-рассылок, посты для социальных сетей, тексты для лендингов. Есть авторы, которые пишут только в одном формате — например, только тексты для лендингов.
Чтобы создавать контент, копирайтер много работает с информацией: общается со спикерами, ищет первоисточники, проверяет факты. Для работы ему нужна только стандартная офисная программа Word или «Google Документы».
Узнать больше о профессии можно в этом обзоре. Рассказали в нём, сколько можно заработать и как стартовать в отрасли.
Ещё в Skillbox есть курс «Профессия Копирайтер с нуля до PRO» для полноценного старта в копирайтинге и курс «Копирайтинг от А до Я 2.0», позволяющий научиться писать тексты и понять, подходит ли вам эта сфера.
Таргетолог. Это специалист, который настраивает таргетированную рекламу, или рекламу в социальных сетях. Например, запускает кампании во «ВКонтакте».
Таргетолог изучает целевую аудиторию, ищет её в социальных сетях, создаёт креативы, настраивает кампанию, анализирует и оптимизирует рекламу. Он работает в рекламных кабинетах соцсетей и использует графические редакторы, чтобы создавать креативы.
В Skillbox Media есть обзор профессии таргетолога и статья о том, как стать таргетологом. Прочитайте их, чтобы узнать о работе таргетолога больше.
Если хотите попробовать себя в таргетинге, обратите внимание на курсы Skillbox. Курс «Профессия Таргетолог с нуля до PRO» подойдёт, если вы хотите найти работу уже во время обучения. Курс «Таргетолог с нуля» — если вы ничего не знаете о настройке рекламы и хотите научиться работать с ней.
Дизайнер. Дизайнеры занимаются визуальным оформлением и проектированием пользовательского опыта. Вот всего несколько примеров их работы: они создают вещи, оформляют разные объекты, разрабатывают логотипы и баннеры.
Направлений в дизайне много: графический, шрифтовой, веб, UX/UI, промышленный, интерьерный и так далее. Каждый вид дизайна требует для работы своего набора сервисов и программ. Но в большинстве случаев дизайнеры работают с «тяжёлыми» программами, поэтому им нужны мощные устройства.
SMM-специалист. Это человек, который продвигает бизнес в соцсетях. SMM-специалист ведёт страницы бизнеса и помогает компании достичь важных для неё показателей — например, привлечь клиентов из соцсетей.
SMM-специалист может настраивать таргетированную рекламу, составлять контент-план и писать посты, разрабатывать SMM-стратегию. В работе специалист использует только сами соцсети и сервисы — например, сервисы отложенного постинга или редакторы изображений.
Если вы хотите стартовать в SMM, обратите внимание на программу «Профессия SMM-специалист». Также в Skillbox есть курс «SMM-специалист с нуля» — на нём можно получить востребованные навыки и начать зарабатывать.
Разработчик. Это человек, который создаёт компьютерные программы, сайты, веб-сервисы и мобильные приложения с помощью языков программирования. Разработчик может создавать пользовательский интерфейс — это называют фронтендом — или внутреннюю логику работы программы: это называют бэкендом.
В работе разработчики используют разные инструменты. Чаще всего — редакторы кода и среды разработки, или IDE, — программы для разработки и тестирования приложений. Некоторые среды разработки разворачиваются в браузере, а некоторые устанавливаются на устройство и сильно нагружают его.
Чтобы лучше узнать о профессии, прочитайте статьи. Мы развенчивали пять мифов о программистах и давали советы по старту в разработке.
Если вас заинтересовала разработка, пройдите бесплатный курс «Введение в программирование». Он позволяет разобраться в разных технологиях и выбрать подходящую.
Профессий, которые позволяют работать на фрилансе, гораздо больше. Удалённо работать могут интернет-маркетологи, проджект-менеджеры, SEO-специалисты, тестировщики и многие другие.
Почти всем специалистам, которые работают удалённо, нужен только ноутбук или персональный компьютер. И хороший интернет, чтобы, например, пользоваться онлайн-сервисами, необходимыми для работы.
Плюсы и минусы фриланса
На фрилансе гораздо больше свободы, чем в штате. Но и работать сложнее. Расскажу о плюсах и минусах фриланса, отталкиваясь от своего опыта и данных опросов фрилансеров — опроса биржи фриланса Finder.vc, опроса ВЦИОМ и исследования HeadHunter.
Вот какие преимущества есть у фриланса:
Удобный график. Его легко подстроить под любые потребности — можно работать тогда, когда комфортно. Нет руководителя, у которого приходится отпрашиваться, если что-то произошло. Нужно на родительское собрание — просто идёшь на него, а с задачами можно закончить позже.
Работа из дома. Работать можно не только дома, но и в коворкинге, в библиотеке — да хоть на стереотипном пляже под пальмой. В любом случае не нужно тратить несколько часов в день, чтобы добраться до офиса, и думать, что надеть сегодня на работу.
Отсутствие обязательств. Фрилансер не обязан брать все проекты, которые ему предлагают. Он может сам выбирать заказы — и легко отказаться от того, что для него неудобно.
Повышать доход проще. Чтобы получать больше денег в штате, нужно договариваться с руководителем. Фрилансер может повысить цены на свои услуги или брать столько заказов, сколько может выполнить.
Фрилансеры также относят к плюсам то, что на фрилансе остаётся больше времени на себя, семью и близких. У меня другой опыт — времени оставалось столько же, сколько остаётся сейчас, когда я работаю в штате.
Вот какие у работы на фрилансе минусы:
Нет социальных гарантий. У фрилансеров, которые работают без договора, нет больничных, оплачиваемых отпусков и пенсии. Но если фрилансер — индивидуальный предприниматель, он платит взносы за себя и может рассчитывать на пенсию.
Нет стабильности. Может случиться так, что сегодня заказов много — даже больше, чем можно взять. А завтра заказов не будет — и найти их будет невозможно при всём желании. У меня бывали такие чёрные полосы — они проходят. Но на поиск заказов тратишь много сил, а отсутствие работы — повод для сильной тревоги.
Нужно искать работу самостоятельно. Это отнимает время — и сначала на поиск заказов может уходить больше времени, чем на их выполнение. Но если фрилансер хорошо делает свою работу и много общается с коллегами, со временем он начинает получать заказы благодаря сарафанному радио и нетворкингу.
Ответственность больше, чем в штате. Можно сказать, что фрилансер отвечает за качество головой. В штате ошибку может помочь исправить руководитель или более опытный коллега. А если фрилансер допускает ошибку, он всё переделывает сам. Если у него совсем ничего не получается и недовольный заказчик напишет негативный отзыв, может пострадать репутация.
Близкие думают, что у тебя нет нормальной работы. Им сложно объяснить, что фриланс — такая же работа, как в штате. Поэтому родственники и знакомые могут отвлекать — например, просить с чем-то помочь. Любимая фраза тех, кто не понимает сути фриланса: «Ты всё равно сидишь дома».
Фрилансеры упоминают и о других минусах — например, сложно заставить себя выйти из дома, не хватает общения с коллегами. Для меня это не минусы: я не люблю часто бывать в обществе, а общения мне хватает.

Кому подходит фриланс
Фриланс подходит самоорганизованным и ответственным людям, которые умеют управлять своим временем. Если с этим проблемы, лучше выбрать работу в штате — и желательно в офисе. Я поняла это на своём опыте, а ещё так считают многие специалисты и фрилансеры (один, два, три).
Почему важны ответственность, самоорганизованность и навыки тайм-менеджмента? Потому что фрилансер сам строит график работы: планирует, сколько времени займут задачи, и решает, в какой последовательности их выполнять.
Если построить график неправильно, возникнет хаос. Придётся быстро переключаться между задачами и перерабатывать, чтобы сдать проекты вовремя, а это сложно. Из-за хаоса можно упустить из виду задачи и не сделать вовремя необходимую работу.
По этой же причине важно уметь бороться с прокрастинацией. Из-за неё фрилансеры садятся за проект в последний момент — и не успевают к сроку сдачи заказа. Или успевают, но из-за спешки допускают ошибки или выполняют работу хуже, чем могли бы.
Неорганизованные люди без навыков в тайм-менеджменте тоже могут работать на фрилансе. Просто они, скорее всего, будут зарабатывать меньше, чем организованные. Будет больше стресса от прокрастинации и хаоса, больше неприятных разговоров с заказчиками.
Ещё для работы на фрилансе нужны хард-скиллы. Копирайтер должен уметь создавать тексты, таргетолог — настраивать рекламу, программист — писать код. Фриланс — это не стажировка, на которой вас всему научат: чтобы зарабатывать, нужны хотя бы минимальные навыки.
Сколько зарабатывают фрилансеры
Кто-то зарабатывает 5 тысяч рублей в месяц, а кто-то — 200 тысяч рублей. На доход влияет множество факторов: профессия, то, сколько времени фрилансер уделяет работе, насколько качественно он её делает, и даже то, как дорого он может продать свои услуги. Для примера посмотрим на результаты опроса Finder.vc: они показывают, насколько разным может быть доход.
Большинство фрилансеров, принявших участие в опросе, зарабатывают на проектах до 20 тысяч рублей в месяц. Например, в копирайтинге и дизайне таких фрилансеров 45%, в маркетинге и SMM — 32%.
Но есть и те, кто зарабатывает 150–250 тысяч рублей в месяц: 4% опрошенных назвали такие цифры. Больше всего специалистов, которые получают такую зарплату, в маркетинге и SMM — 6% от всех, кто занят в этой отрасли.


Вот другая статистика: фрилансеры, которые выводят деньги на российские карты, получают в среднем 100 тысяч рублей. Те, кто выводит деньги на иностранные карты, зарабатывают в среднем 319 тысяч рублей в месяц. Об этом пишут «Ведомости» со ссылкой на данные сервиса для аутсорс-сделок Solar Staff.
На мой взгляд, на доходы сильнее всего влияет квалификация — а следовательно, и качество работы. Чем лучше вы решаете задачи клиентов, тем дороже можете продать свои услуги. В первый год я получала 5–20 тысяч рублей в месяц. В последние годы работы на фрилансе мой доход был 90–120 тысяч рублей в месяц.


Как стать фрилансером
Если вы раньше не слышали о фрилансе, но хотите попробовать, нужно сначала выбрать профессию, взять первые заказы, а потом, если вас всё устроит, искать клиентов дальше. После этого можно подумать об официальном оформлении. Разберём каждый этап подробнее.
Какую профессию для фриланса выбрать
Если у вас уже есть навыки в какой-то области, проще всего развиваться в ней. Если вы бухгалтер, можно найти нескольких клиентов и вести для них бухгалтерский учёт удалённо. Если вы журналист, можно писать новости для СМИ. Если вы работаете дизайнером в штате, можно брать разовые заказы — например, на создание логотипов или на оформление сообществ во «ВКонтакте».
Также можно кардинально сменить сферу деятельности. Для этого не обязательно долго учиться — есть профессии с относительно низким порогом входа. Это значит, что можно стартовать с минимальным набором знаний и учиться на практике — или сначала пройти курсы, чтобы развить навыки и зарабатывать больше.
Например, чтобы стать копирайтером, не нужно учиться в вузе. Если вы умеете грамотно писать и понятно излагать мысли, можно научиться создавать тексты в основных форматах, наработать портфолио и искать клиентов. А для старта в рекрутменте не нужно никаких специальных навыков. Но людям, которые любят общаться, в рекрутменте будет проще, чем интровертам.

С чего начать фриланс
Если у вас не было опыта фриланса, лучше начать с малого, чтобы понять, подходит ли вам такой формат работы. Я советую брать небольшие недорогие заказы и не бросать работу, которая есть. То же самое советуют, например, основатель агрегатора курсов Checkroi.ru Иван Буявец и IT-копирайтер Диана Сиддикви.
Выполнив 5–10 простых заказов, вы поймёте, умеете ли организовывать свой рабочий день, интересна ли вам выбранная сфера, удобно ли вам работать дома. Фриланс может вам не понравиться — тогда можно продолжить заниматься тем, чем занимались раньше. А может случиться наоборот — фриланс понравится настолько, что станет основным источником дохода.
Где искать первые заказы? Проще всего — по знакомству. Если у вас нет знакомых, которые связаны с диджиталом, можно пойти на биржи фриланса. Это площадки, на которых заказчики ищут исполнителей.
Есть узкоспециализированные биржи и биржи, на которых много заказов по всем направлениям — от продаж до дизайна. Я начинала с биржи копирайтинга Advego — тогда там были заказы, которые можно было брать сразу, не подавая заявку и не дожидаясь одобрения этой заявки. Потом я несколько лет проработала на Etxt — цены там были выше, чем на Advego, а заказов больше.

Где брать клиентов на фрилансе
Стандартные каналы поиска клиентов — социальные сети, агрегаторы вакансий, биржи фриланса и знакомства. Популярность каналов со временем меняется. По данным опроса «Клуба фрилансеров», в 2020 году заказы чаще всего искали на бирже. В 2023 году биржи — уже не самый популярный канал.
Вот какие данные приводит Finder.vc:
- 46% опрошенных ищут заказы в телеграм-каналах и чатах;
- 18% используют агрегаторы вакансий — HeadHunter и SuperJob;
- 14% находят клиентов на российских фриланс-биржах;
- 14% ищут клиентов по знакомству и получают заказы благодаря «сарафанному радио»;
- 11% находят заказы в соцсетях, в том числе в группах для фрилансеров.
Также участники опроса говорили, что находят заказы на зарубежных биржах и на LinkedIn.
Что делать, чтобы было много заказов или чтобы вам платили много? Качественно выполнять свою работу. А для этого нужно думать над конечным продуктом. Так считаю не только я — об этом, например, говорит основатель агентства контент-маркетинга «Сделаем» Павел Молянов. Если вы качественно делаете свою работу, клиенты будут предлагать заказы и советовать вас своим знакомым.
Последние полтора года на фрилансе я не искала заказов. У меня было несколько постоянных проектов и небольшие задачи от клиентов, которые приходили ко мне по рекомендациям.

Как фрилансеру работать легально: про ГПХ, самозанятость и ИП
Работать на фрилансе легально могут физические лица, самозанятые и индивидуальные предприниматели. Разберёмся, сколько налогов они платят и какие договоры заключают.
Физические лица могут работать с другими физлицами, компаниями и индивидуальными предпринимателями по договорам ГПХ — гражданско-правового характера. По ним фрилансер не сдаёт отчётов и не платит налогов — это делает заказчик услуги. Он сам перечисляет государству НДФЛ фрилансера и страховые взносы.
Самозанятые — люди, которые работают на специальном налоговом режиме «Налог на профессиональный доход» (НПД). Фрилансеры на НПД не сдают отчётов и платят 4% налога, если оказывают услуги физическим лицам, и 6% налога, если оказывают услуги юридическим лицам или ИП. Но есть ограничение — их доход не должен превышать 2,4 миллиона рублей в год.
Индивидуальные предприниматели тоже платят налоги сами за себя, но ставка налога зависит от выбранной системы налогообложения. Популярная система налогообложения — упрощённая, или УСН. Налоги по ней можно платить двумя способами:
- По объекту налогообложения «Доходы». Стандартная ставка по ней — 6%. То есть ИП платят 6% от выручки. Большинство фрилансеров выбирают этот объект налогообложения.
- По объекту налогообложения «Доходы минус расходы». Стандартная ставка по ней — 15%. То есть ИП платят 15% от прибыли. Но у фрилансеров мало расходов, которые можно зачесть, — поэтому этот объект невыгоден.
В некоторых регионах действуют пониженные ставки. Полный список регионов и программ, по которым можно платить меньше налогов, можно посмотреть здесь.
Кроме того, индивидуальные предприниматели платят страховые взносы. В 2023 году размер взносов такой: на ОМС — 9119 рублей, а на ОПС — 36 723 рубля. Но ИП могут уменьшить налоги на сумму этих взносов.
Индивидуальный предприниматель также может перейти на НПД. Тогда ему не нужно будет сдавать отчётность и платить взносы, а ставка налога будет 4% или 6%.
Заказчикам выгодно работать с индивидуальными предпринимателями и самозанятыми, потому что те платят налоги сами. Например, я перешла на НПД почти сразу после того, как ввели этот режим.

Главное о фрилансе и фрилансерах в 4 пунктах
- Фриланс — кратковременная удалённая работа не по трудовому договору. Фрилансер — свободный специалист, который работает сам на себя. Стать фрилансером может любой, чья работа не предполагает личного присутствия: маркетолог, копирайтер, программист, дизайнер.
- У фриланса есть плюсы и минусы. Плюсы в том, что фрилансер сам строит себе график и работает из дома. Ещё у него нет обязательств — он может отказаться от проекта, а увеличивать доход ему проще, чем в штате. Минусы в том, что у фрилансеров нет социальных гарантий и стабильности. Они сами ищут заказы, у них больше ответственность, а ещё им бывает сложно объяснить суть своей работы знакомым.
- Доход на фрилансе зависит от множества факторов — даже от того, насколько дорого фрилансер может продать свои услуги. Некоторые получают до 20 тысяч рублей в месяц, некоторые — больше 250 тысяч рублей в месяц.
- Если хотите стать фрилансером, сначала нужно выбрать профессию — заняться тем, что уже умеете делать, или освоить новую специальность. Потом стоит попробовать выполнить несколько заказов, чтобы понять, подходит вам фриланс или нет. Если всё хорошо, можно искать клиентов: в телеграм-каналах, на агрегаторах вакансий, на биржах, в соцсетях и по знакомству.
Как узнать больше о фрилансе
- В Skillbox Media есть много статей о профессиях. Мы уже рассказывали о менеджерах маркетплейсов, SMM-специалистах, маркетологах, SEO-специалистах, аналитиках данных, веб-разработчиках. Прочитайте материалы, чтобы понять, чем занимаются эти специалисты.
- Если собираетесь зарабатывать на фрилансе, прочитайте эти материалы. Мы рассказывали о тайм-менеджменте на фрилансе и о том, как преуспеть на бирже фриланса. Ещё у нас есть подборка из 42 телеграм-каналов для тех, кто ищет работу.
- Если вы хотите работать на фрилансе, но пока не определились, какую сферу выбрать, обратите внимание на бесплатный курс по профориентации. На нём можно проанализировать свой опыт и желания — и подобрать четыре подходящие диджитал-профессии.
- Возможно, вам будут интересны курсы Skillbox «Профессия Маркетолог-фрилансер», «Профессия SMM-специалист», «Профессия Копирайтер с нуля до PRO» или другие — посмотреть их можно в каталоге. В программах многих курсов есть карьерные треки для тех, кто планирует работать на фрилансе.
Больше материалов Skillbox Media для тех, кто хочет зарабатывать — и не только на фрилансе
- Вся правда об удалённой работе на Wildberries: за что и сколько платят менеджерам
- Как всё успеть на удалёнке и никого не убить: опыт мамы-фрилансера с семилетним стажем
- Рассказываем про заработок в интернете: 14 способов получать до 100 тысяч рублей
- Можно ли зарабатывать на «Яндекс Дзене» 200 тысяч в месяц и что для этого нужно делать
- 13 профессий для удалённой работы с лёгким входом. Стартуем в диджитале, SMM, продажах и HR
Обязательное медицинское страхование.
Как работает ChatGPT: объясняем на простом русском эволюцию языковых моделей с T9 до чуда
В последнее время нам почти каждый день рассказывают в новостях, какие очередные вершины покорили языковые нейросетки, и почему они уже через месяц совершенно точно оставят лично вас без работы. При этом мало кто понимает — а как вообще нейросети вроде ChatGPT работают внутри? Так вот, устраивайтесь поудобнее: в этой статье мы наконец объясним всё так, чтобы понял даже шестилетний гуманитарий!
На всякий случай сразу оговоримся: у этой статьи два автора. За всю техническую часть (и за всё хорошее в статье) отвечал Игорь Котенков — широко известный чувак в узких кругах русскоязычной тусовки специалистов по искусственному интеллекту, а также автор канала Сиолошная про машинное обучение, космос и технологии. За мольбы «вот тут непонятно, давай как‑нибудь попроще!» и за добавление кринжовых неуместных мемов был ответственен Павел Комаровский — автор канала RationalAnswer про рациональный подход к жизни и финансам.
Собственно, статья так и родилась: Павел пришел к Игорю и возмутился — дескать, «почему никто еще не написал на русском нормальную статью про ChatGPT, объясняющую понятно даже для моей бабушки, как всё вот это нейроколдунство работает?». Так что заранее приносим свои извинения всем хардкорным технарям: при подготовке этого текста мы стремились к максимальному упрощению. Нашей задачей было — дать читателям общее понимание принципов работы языковых нейросетей на уровне концепций и аналогий, а не разобрать до последнего винтика все глубокие технические нюансы процесса.
В общем, наливайте себе кружечку горячего чая и устраивайтесь поудобнее — сейчас мы вам расскажем всё про то, что там крутится под капотом у языковых моделей, каким образом эти покемоны эволюционировали до текущих (местами поразительных) способностей, и почему взрывная популярность чат‑бота ChatGPT стала полным сюрпризом даже для его создателей. Поехали! (Кстати, этот материал есть еще и в формате видео.)
Навигатор
- T9: сеанс языковой магии с разоблачением
- Откуда нейросети берут вероятности слов?
- Парадокс Барака, или зачем языковым моделям уметь в творчество
- 2018: GPT-1 трансформирует языковые модели
- 2019: GPT-2, или как запихнуть в языковую модель семь тысяч Шекспиров
- Почему в мире языковых моделей больше ценятся именно модели «Plus Size»
- 2020: GPT-3, или как сделать из модели Невероятного Халка
- Промпты, или как правильно уламывать модель
- Январь 2022: InstructGPT, или как научить робота не зиговать
- Ноябрь 2022: ChatGPT, или маленькие секреты большого хайпа
- Подведем итоги
T9: сеанс языковой магии с разоблачением
Начнем с простого. Чтобы разобраться в том, что такое ChatGPT с технической точки зрения, надо сначала понять, чем он точно не является. Это не «Бог из машины», не разумное существо, не аналог школьника (по уровню интеллекта и умению решать задачи), не джинн, и даже не обретший дар речи Тамагочи. Приготовьтесь услышать страшную правду: на самом деле, ChatGPT — это Т9 из вашего телефона, но на бычьих стероидах! Да, это так: ученые называют обе этих технологии «языковыми моделями» (Language Models); а всё, что они по сути делают, — это угадывают, какое следующее слово должно идти за уже имеющимся текстом.
Ну, точнее, в совсем олдовых телефонах из конца 90-х (вроде культовой неубиваемой Nokia 3210) оригинальная технология Т9 лишь ускоряла набор на кнопочных телефонах за счет угадывания текущего вводимого, а не следующего слова. Но технология развивалась, и к эпохе смартфонов начала 2010-х она уже могла учитывать контекст (предыдущее слово), ставить пунктуацию и предлагать на выбор слова, которые могли бы идти следующими. Вот именно об аналогии с такой «продвинутой» версией T9/автозамены и идет речь.
Итак, и Т9 на клавиатуре смартфона, и ChatGPT обучены решать до безумия простую задачу: предсказание единственного следующего слова. Это и есть языковое моделирование – когда по некоторому уже имеющемуся тексту делается вывод о том, что должно быть написано дальше. Чтобы иметь возможность делать такие предсказания, языковым моделям под капотом приходится оперировать вероятностями возникновения тех или иных слов для продолжения. Ведь, скорее всего, вы были бы недовольны, если бы автозаполнение в телефоне просто подкидывало вам абсолютно случайные слова с одинаковой вероятностью.
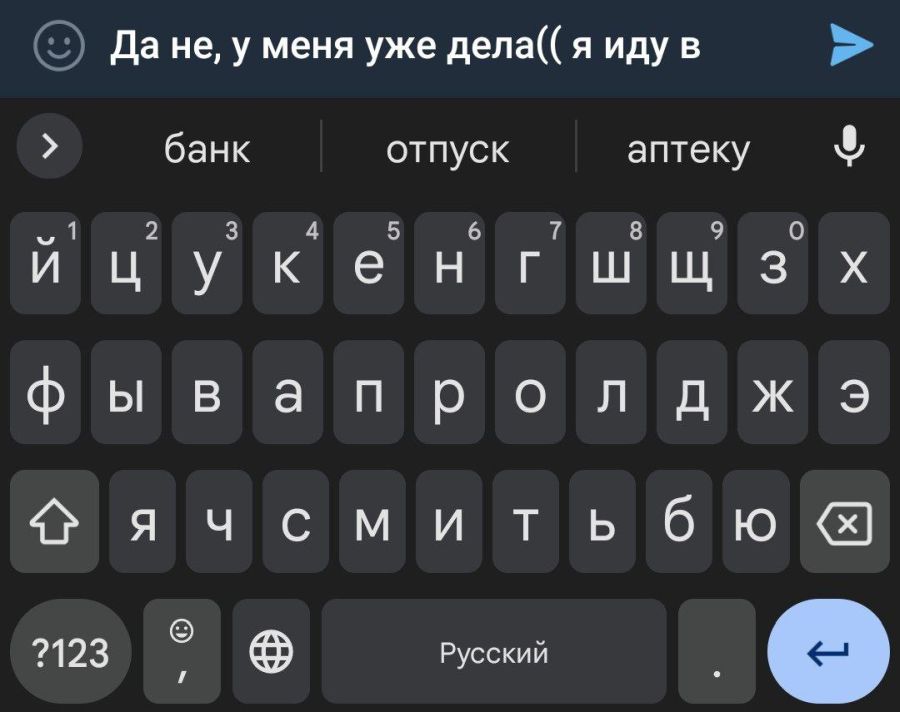
Представим для наглядности, что вам прилетает сообщение от приятеля: «Чё, го седня куда нить?». Вы начинаете печатать в ответ: «Да не, у меня уже дела(( я иду в. », и вот тут подключается Т9. Если он предложит вам закончить предложение полностью рандомным словом, типа «я иду в капибару» — то для такой белиберды, если честно, никакая хитрая языковая модель особо и не нужна. Реальные же модели автозаполнения в смартфонах подсказывают гораздо более уместные слова (можете сами проверить прямо сейчас).
Так, а как конкретно Т9 понимает, какие слова будут следовать за уже набранным текстом с большей вероятностью, а какие предлагать точно не стоит? Для ответа на этот вопрос нам придется погрузиться в базовые принципы работы самых простейших нейросеток.
Откуда нейросети берут вероятности слов?
Давайте начнем с еще более простого вопроса: а как вообще предсказывать зависимости одних вещей от других? Предположим, мы хотим научить компьютер предсказывать вес человека в зависимости от его роста — как подойти к этой задаче?
Здравый смысл подсказывает, что надо сначала собрать данные, на которых мы будем искать интересующие нас зависимости (для простоты ограничимся одним полом — возьмем статистику по росту/весу для нескольких тысяч мужчин), а потом попробуем «натренировать» некую математическую модель на поиск закономерности внутри этих данных.
Для наглядности сначала нарисуем весь наш массив данных на графике: по горизонтальной оси будем откладывать рост в сантиметрах, а по вертикальной оси — вес.
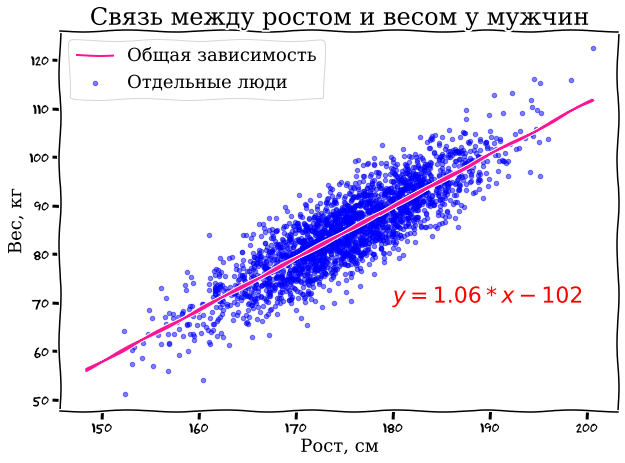
Даже невооруженным взглядом видна определенная зависимость: высокие мужики, как правило, больше весят (спасибо, кэп!). И эту зависимость довольно просто выразить в виде обычного линейного уравнения , знакомого нам всем с пятого класса школы. На картинке нужная нам линия уже проведена с помощью модели линейной регрессии — по сути, она позволяет подобрать коэффициенты уравнения и таким образом, чтобы получившаяся линия оптимально описывала ключевую зависимость в нашем наборе данных (можете для интереса подставить свой рост в сантиметрах вместо в уравнение на картинке и проверить, насколько точно наша модель угадает ваш вес).
Вы тут уже наверняка хотите воскликнуть: «Окей, с ростом/весом и так интуитивно всё было понятно, только причем тут вообще языковые нейросети?» А притом, что нейросети — это и есть набор примерно тех же самых уравнений, только куда более сложных и использующих матрицы (но не будем сейчас об этом).
Можно упрощенно сказать, что те же самые T9 или ChatGPT — это всего лишь хитрым образом подобранные уравнения, которые пытаются предсказать следующее слово (игрек) в зависимости от набора подаваемых на вход модели предыдущих слов (иксов). Основная задача при тренировке языковой модели на наборе данных — подобрать такие коэффициенты при этих иксах, чтобы они действительно отражали какую‑то зависимость (как в нашем примере с ростом/весом). А под большими моделями мы далее будем понимать такие, которые имеют очень большое количество параметров. В области ИИ их прямо так и называют — LLM, Large Language Models. Как мы увидим чуть дальше, «жирная» модель с множеством параметров — это залог успеха для генерации крутых текстов!
Кстати, если вы в этом месте уже недоумеваете, почему мы всё время говорим о «предсказании одного следующего слова», тогда как тот же ChatGPT бодро отвечает целыми портянками текста – то не ломайте зря голову. Языковые модели без всякого труда генерируют длинные тексты, но делают они это по принципу «слово за словом». По сути, после генерации каждого нового слова, модель просто заново прогоняет через себя весь предыдущий текст вместе с только что написанным дополнением – и выплевывает последующее слово уже с учетом него. В результате получается связный текст.
Парадокс Барака, или зачем языковым моделям уметь в творчество
На самом деле, в наших уравнениях в качестве «игрека» языковые модели пытаются предсказать не столько конкретное следующее слово, сколько вероятности разных слов, которыми можно продолжить заданный текст. Зачем это нужно, почему нельзя всегда искать единственное, «самое правильное» слово для продолжения? Давайте разберем на примере небольшой игры.
Правила такие: вы притворяетесь языковой моделью, а я вам предлагаю продолжить текст «44-й президент США (и первый афроамериканец на этой должности) — это Барак. ». Подставьте слово, которое должно стоять вместо многоточия, и оцените вероятность, что оно там действительно окажется.
Если вы сейчас сказали, что следующим словом должно идти «Обама» с вероятностью 100%, то поздравляю — вы ошиблись! И дело тут не в том, что существует какой‑то другой мифический Барак: просто в официальных документах имя президента часто пишется в полной форме, с указанием его второго имени (middle name) — Хуссейн. Так что правильно натренированная языковая модель должна, по‑хорошему, предсказать, что в нашем предложении «Обама» будет следующим словом только с вероятностью условно в 90%, а оставшиеся 10% выделить на случай продолжения текста «Хуссейном» (после которого последует Обама уже с вероятностью, близкой к 100%).
И тут мы с вами подходим к очень интересному аспекту языковых моделей: оказывается, им не чужда творческая жилка! По сути, при генерации каждого следующего слова, такие модели выбирают его «случайным» образом, как бы кидая кубик. Но не абы как — а так, чтобы вероятности «выпадения» разных слов примерно соответствовали тем вероятностям, которые подсказывают модели зашитые внутрь нее уравнения (выведенные при обучении модели на огромном массиве разных текстов).
Получается, что одна и та же модель даже на абсолютно одинаковые запросы может давать совершенно разные варианты ответа — прямо как живой человек. Вообще, ученые когда‑то пытались заставить нейронки всегда выбирать в качестве продолжения «наиболее вероятное» следующее слово — что на первый взгляд звучит логично, но на практике такие модели почему‑то работают хуже; а вот здоровый элемент случайности идет им строго на пользу (повышает вариативность и, в итоге, качество ответов).
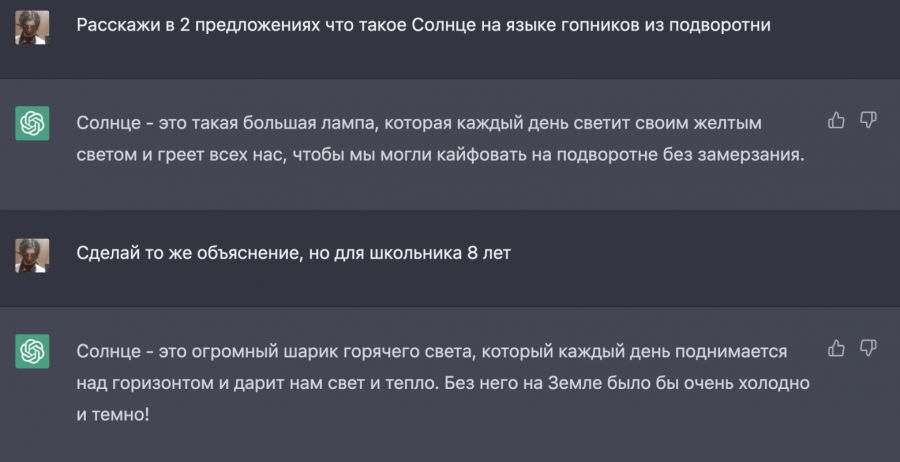
Вообще, наш язык — это особая структура с (иногда) четкими наборами правил и исключений. Слова в предложениях не появляются из ниоткуда, они связаны друг с другом. Эти связи неплохо выучиваются человеком «в автоматическом режиме» — во время взросления и обучения в школе, через разговоры, чтение, и так далее. При этом для описания одного и того же события или факта люди придумывают множество способов в разных стилях, тонах и полутонах. Подход к языковой коммуникации у гопников в подворотне и, к примеру, у учеников младшей школы будет, скорее всего, совсем разным.
Всю эту вариативность описательности языка и должна в себя вместить хорошая модель. Чем точнее модель оценивает вероятности слов в зависимости от нюансов контекста (предшествующей части текста, описывающей ситуацию) — тем лучше она способна генерировать ответы, которые мы хотим от нее услышать.
Краткое резюме: На текущий момент мы выяснили, что несложные языковые модели применяются в функциях «T9/автозаполнения» смартфонов с начала 2010-х; а сами эти модели представляют собой набор уравнений, натренированных на больших объемах данных предсказывать следующее слово в зависимости от поданного «на вход» исходного текста.
2018: GPT-1 трансформирует языковые модели
Давайте уже переходить от всяких дремучих T9 к более современным моделям: наделавший столько шума ChatGPT является наиболее свежим представителем семейства моделей GPT. Но чтобы понять, как ему удалось обрести столь необычные способности радовать людей своими ответами, нам придется сначала вернуться к истокам.
GPT расшифровывается как Generative Pre‑trained Transformer, или «трансформер, обученный на генерацию текста». Трансформер — это название архитектуры нейросети, придуманной исследователями Google в далеком 2017 году (про «далекий» мы не оговорились: по меркам индустрии, прошедшие с тех пор шесть лет — это целая вечность).
Именно изобретение Трансформера оказалось столь значимым, что вообще все области искусственного интеллекта (ИИ) — от текстовых переводов и до обработки изображений, звука или видео — начали его активно адаптировать и применять. Индустрия ИИ буквально получила мощную встряску: перешла от так называемой «зимы ИИ» к бурному развитию, и смогла преодолеть застой.

Концептуально, Трансформер — это универсальный вычислительный механизм, который очень просто описать: он принимает на вход один набор последовательностей (данных) и выдает на выходе тоже набор последовательностей, но уже другой — преобразованный по некоему алгоритму. Так как текст, картинки и звук (да и вообще почти всё в этом мире) можно представить в виде последовательностей чисел — то с помощью Трансформера можно решать практически любые задачи.
Но главная фишка Трансформера заключается в его удобстве и гибкости: он состоит из простых модулей‑блоков, которые очень легко масштабировать. Если старые, до‑трансформерные языковые модели начинали кряхтеть и кашлять (требовать слишком много ресурсов), когда их пытались заставить «проглотить» быстро и много слов за раз, то нейросети‑трансформеры справляются с этой задачей гораздо лучше.
Более ранним подходам приходилось обрабатывать входные данные по принципу «один за другим», то есть последовательно. Поэтому, когда модель работала с текстом длиной в одну страницу, то уже к середине третьего параграфа она забывала, что было в самом начале (прямо как люди с утра, до того как они «бахнув кофейку»). А вот могучие лапища Трансформера позволяют ему смотреть на ВСЁ одновременно — и это приводит к гораздо более впечатляющим результатам.
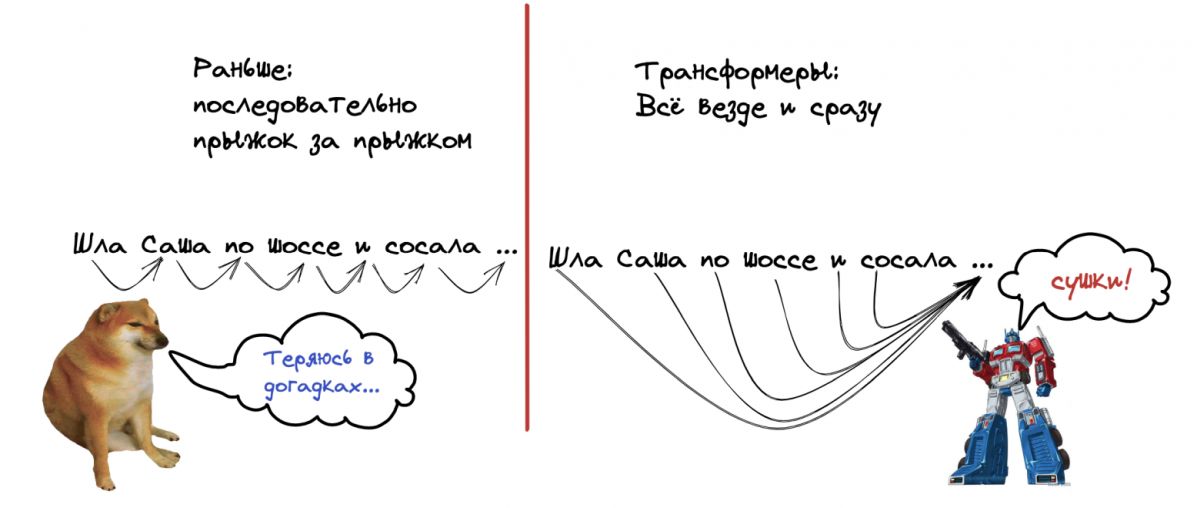
Именно это позволило сделать прорыв в нейросетевой обработке текстов (в том числе их генерации). Теперь модель не забывает: она переиспользует то, что уже было написано ранее, лучше держит контекст, а самое главное — может строить связи типа «каждое слово с каждым» на весьма внушительных объемах данных.
Краткое резюме: GPT-1 появилась в 2018 году и доказала, что для генерации текстов нейросетью можно использовать архитектуру Трансформера, обладающую гораздо большей масштабируемостью и эффективностью. Это создало огромный задел на будущее по возможности наращивать объем и сложность языковых моделей.
2019: GPT-2, или как запихнуть в языковую модель семь тысяч Шекспиров
Если вы хотите научить нейросетку для распознавания изображений отличать маленьких милых чихуабелей от маффинов с черничкой, то вы не можете просто сказать ей «вот ссылка на гигантский архив со 100 500 фотографий пёсов и хлебобулочных изделий — разбирайся!». Нет, чтобы обучить модель, вам нужно обязательно сначала разметить тренировочный набор данных — то есть, подписать под каждой фоткой, является ли она пушистой или сладкой.
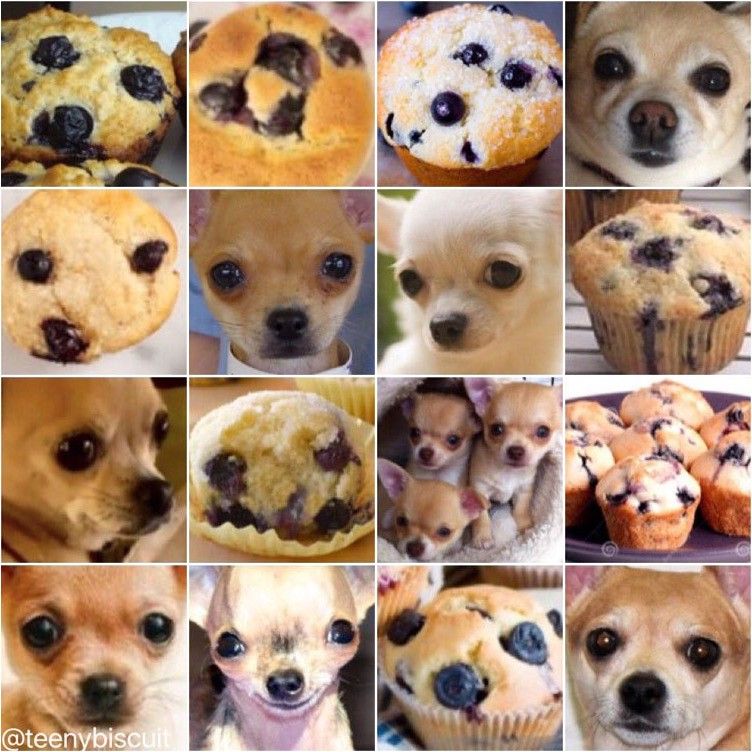
А знаете, чем прекрасно обучение языковых моделей? Тем, что им можно «скармливать» совершенно любые текстовые данные, и эти самые данные заблаговременно никак не надо специальным образом размечать. Это как если бы в школьника можно было просто бросать чемодан с самыми разными книгами, без какой‑либо инструкции, что там и в каком порядке ему нужно выучить — а он бы сам в процессе чтения кумекал для себя какие‑то хитрые выводы!
Если подумать, то это логично: мы же хотим научить языковую модель предсказывать следующее слово на основе информации о словах, которые идут перед ним? Ну дак совершенно любой текст, написанный человеком когда‑либо, — это и есть уже готовый кусочек тренировочных данных. Ведь он уже и так состоит из огромного количества последовательностей вида «куча каких‑то слов и предложений => следующее за ними слово».
А теперь давайте еще вспомним, что обкатанная на GPT-1 технология Трансформеров оказалась на редкость удачной в плане масштабирования: она умеет работать с большими объемами данных и «массивными» моделями (состоящими из огромного числа параметров) гораздо эффективнее своих предшественников. Вы думаете о том же, о чем и я? Ну вот и ученые из OpenAI в 2019 году сделали такой же вывод: «Пришло время пилить здоровенные языковые модели!»

В общем, было решено радикально прокачать GPT-2 по двум ключевым направлениям: набор тренировочных данных (датасет) и размер модели (количество параметров).
На тот момент не было каких‑то специальных, больших и качественных, публичных наборов текстовых данных для тренировки языковых моделей — так что каждой команде специалистов по ИИ приходилось извращаться согласно их собственной степени испорченности. Вот ребята из OpenAI и решили поступить остроумно: они пошли на самый популярный англоязычный онлайн‑форум Reddit и тупо выкачали все гиперссылки из всех сообщений, имевших более трех лайков (я сейчас не шучу — научный подход, ну!). Всего таких ссылок вышло порядка 8 миллионов, а скачанные из них тексты весили в совокупности 40 гигабайт.
Много это или мало? Давайте прикинем: собрание сочинений Уильяма Шекспира (всех его пьес, сонетов и стихов) состоит из 850’000 слов. В среднем на одной странице книги помещается около 300 английских слов — так что 2800 страниц чудесного, временами устаревшего английского текста за авторством величайшего англоязычного писателя займет в памяти компьютера примерно 5,5 мегабайт. Так вот: это в 7300 раз меньше, чем объем тренировочной выборки GPT-2. С учетом того, что люди в среднем читают по странице в минуту, даже если вы будете поглощать текст 24 часа в сутки без перерыва на еду и сон — вам потребуется почти 40 лет, чтобы догнать GPT-2 по эрудиции!
Но одного объема тренировочных данных для получения крутой языковой модели недостаточно: ведь даже если посадить пятилетнего ребенка перечитывать всё собрание сочинений Шекспира вместе с лекциями по квантовой физике Фейнмана впридачу, то вряд ли он от этого станет сильно умнее. Так и тут: модель еще и сама по себе должна быть достаточно сложной и объемной, чтобы полноценно «проглотить» и «переварить» такой объем информации. А как измерить эту сложность модели, в чем она выражается?
Почему в мире языковых моделей больше ценятся именно модели «Plus Size»
Помните, мы чуть раньше говорили, что внутри языковых моделей (в супер‑упрощенном приближении) живут уравнения вида , где искомый игрек — это следующее слово, вероятность которого мы пытаемся предсказать, а иксы — это слова на входе, на основе которых мы делаем это предсказание?
Так вот, как вы думаете: сколько было параметров в уравнении, описывающем самую большую модель GPT-2 в 2019 году? Может быть, сто тысяч, или пара миллионов? Ха, берите выше: таких параметров в формуле было аж полтора миллиарда (это вот столько: 1’500’000’000). Даже если просто записать такое количество чисел в файл и сохранить на компьютере, то он займет 6 гигабайт! С одной стороны, это сильно меньше, чем суммарный размер текстового массива данных, на котором мы тренировали модель (помните, который мы собирали по ссылкам с Reddit, на 40 Гб); с другой — модели ведь не нужно запоминать этот текст целиком, ей достаточно просто найти некие зависимости (паттерны, правила), которые можно вычленить из написанных людьми текстов.
Эти параметры (их еще называют «веса», или «коэффициенты») получаются во время тренировки модели, затем сохраняются, и больше не меняются. То есть, при использовании модели в это гигантское уравнение каждый раз подставляются разные иксы (слова в подаваемом на вход тексте), но сами параметры уравнения (числовые коэффициенты при иксах) при этом остаются неизменны.
Чем более сложное уравнение зашито внутрь модели (чем больше в нем параметров) — тем лучше модель предсказывает вероятности, и тем более правдоподобным будет генерируемый ей текст. И у этой самой большой на тот момент модели GPT-2 тексты внезапно стали получаться настолько хорошими, что исследователи из OpenAI даже побоялись публиковать модель в открытую из соображений безопасности. А ну как люди ринулись бы генерировать в промышленном масштабе реалистично выглядящие текстовые фейки, спам для соцсетей, и так далее?
Нет, серьезно — это был прямо существенный прорыв в качестве! Вы же помните: предыдущие модели T9/GPT-1 худо‑бедно могли подсказать — собираетесь ли вы пойти в банк или в аптеку, а также угадать, что шоссейная Саша сосет сушки, а не что‑то иное. А вот GPT-2 уже легко написала эссе от лица подростка с ответом на вопрос: «Какие фундаментальные экономические и политические изменения необходимы для эффективного реагирования на изменение климата?» (тут и иные взрослые прикурили бы от серьезности темы). Текст ответа был под псевдонимом направлен жюри соответствующего конкурса — и те не заметили никакого подвоха. Ну, окей, оценки этой работе поставили не сильно высокие и в финал она не прошла — но и «что за чушь вы нам отправили, постыдились бы!!» тоже никто не воскликнул.
«Эссе хорошо сформулировано и подкрепляет утверждения доказательствами, но идея не является оригинальной», – так один из кожаных мешков в жюри оценил работу нейросетки GPT-2.
Переход количества в качество (почти по Марксу)
Вообще, вот эта идея о том, что по мере наращивания размера модели у нее внезапно открываются качественно новые свойства (например, писать связные эссе со смыслом вместо простого подсказывания следующего слова в телефоне) — это довольно удивительная штука. Давайте поразбираем новоприобретенные скиллы GPT-2 чуть поподробнее.
Есть специальные наборы задач на разрешение двусмысленности в тексте, которые помогают оценить понимание текста (хоть человеком, хоть нейросетью). Например, сравните два утверждения:
- Рыба заглотила приманку. Она была вкусной.
- Рыба заглотила приманку. Она была голодной.
К какому объекту относится местоимение «она» в первом примере — к рыбе или к приманке? А во втором случае? Большинство людей легко понимают из контекста, что в одном случае «она» — это приманка, а в другом — рыба. Но для того, чтобы это осознать, нужно не просто прочитать предложение — а выстроить в голове целую картину мира! Ведь, например, рыба может быть в разных ситуациях и голодной, и вкусной (на тарелке в ресторане). Вывод о ее «голодности» в данном конкретном примере вытекает из контекста и ее, извините, кровожадных действий.
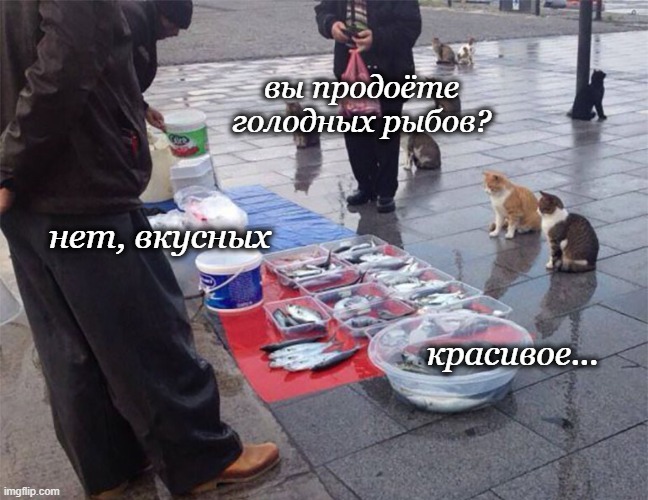
Люди решают такие задачи правильно примерно в 95% случаев, а вот ранние языковые модели справлялись только в половине случаев (то есть, пытались угадать практически рандомно «50 на 50» — как в том анекдоте про «какова вероятность встретить на улице динозавра?»).
Вы, наверное, подумали: «Ну, надо просто накопить большую базу таких задачек (на пару тысяч примеров) с ответами, прогнать через нейросеть — и натренировать ее на поиск правильного ответа». И со старыми моделями (с меньшим числом параметров) так и пытались сделать — но дотянуть их получалось только до примерно 60% успеха. А вот GPT-2 никто специально таким трюкам не учил; но она взяла, и сама неожиданно и уверенно превзошла своих «специализированных» предшественников — научилась определять голодных рыбов правильно в 70% случаев.
Это и есть тот самый переход количества в качество, про который нам когда‑то твердил старина Карл Маркс. Причем он происходит совершенно нелинейно: например, при росте количества параметров в три раза от 115 до 350 млн никаких особых изменений в точности решения моделью «рыбных» задач не происходит, а вот при увеличении размера модели еще в два раза до 700 млн параметров — происходит качественный скачок, нейросеть внезапно «прозревает» и начинает поражать всех своими успехами в решении совершенно незнакомых ей задач, которые она раньше никогда не встречала и специально их не изучала.
Краткое резюме: GPT-2 вышла в 2019 году, и она превосходила свою предшественницу и по объему тренировочных текстовых данных, и по размеру самой модели (числу параметров) в 10 раз. Такой количественный рост привел к тому, что модель неожиданно самообучилась качественно новым навыкам: от сочинения длинных эссе со связным смыслом, до решения хитрых задачек, требующих зачатков построения картины мира.
2020: GPT-3, или как сделать из модели Невероятного Халка
Поигравшись немного с располневшей (и от этого поумневшей) GPT-2, ребята из OpenAI подумали: «А почему бы не взять ту же самую модель, и не увеличить ее еще раз эдак в 100?» В общем, вышедшая в 2020 году следующая номерная версия, GPT-3, уже могла похвастаться в 116 раз большим количеством параметров — аж 175 миллиардов! Раскабаневшая нейросеть при этом сама по себе стала весить невероятные 700 гигабайт.
Набор данных для обучения GPT-3 тоже прокачали, хоть и не столь радикально: он увеличился примерно в 10 раз до 420 гигабайт — туда запихнули кучу книг, Википедию, и еще множество текстов с самых разных интернет‑сайтов. Живому человеку поглотить такой объем информации уже точно нереально — ну, разве что, если посадить с десяток Анатолиев Вассерманов, чтобы они читали буквально нон‑стоп по 50 лет подряд каждый.
Сразу бросается в глаза интересный нюанс: в отличие от GPT-2, сама модель теперь имеет размер больше (700 Гб), чем весь массив текста для ее обучения (420 Гб). Получается как будто бы парадокс: наш «нейромозг» в данном случае в процессе изучения сырых данных генерирует информацию о разных взаимозависимостях внутри них, которая превышает по объему исходную информацию.
Такое обобщение («осмысление»?) моделью позволяет еще лучше прежнего делать экстраполяцию — то есть, показывать хорошие результаты в задачах на генерацию текстов, которые при обучении встречались очень редко или не встречались вовсе. Теперь уже точно не нужно учить модель решать конкретную задачу — вместо этого достаточно описать словами проблему, дать несколько примеров, и GPT-3 схватит на лету, чего от нее хотят!
И тут в очередной раз оказалось, что «универсальный Халк» в виде GPT-3 (которую никто никаким «узким» задачам не обучал) с легкостью кладет на лопатки многие специализированные модели, которые существовали до нее: так, перевод текстов с французского или немецкого на английский сразу начал даваться GPT-3 легче и лучше, чем любым другим специально заточенным под это нейросетям. Как?! Напоминаю, что речь идет про лингвистическую модель, чье предназначение вообще‑то заключалось ровно в одном — пытаться угадать одно следующее слово к заданному тексту. Откуда здесь берутся способности к переводу?
Но это еще цветочки — еще более удивительно то, что GPT-3 смогла научить сама себя. математике! На графике ниже (источник: оригинальная статья) показана точность ответов нейросетей с разным количеством параметров на задачки, связанные со сложением/вычитанием, а также с умножением чисел вплоть до пятизначных. Как видите, при переходе от моделей с 10 миллиардами параметров к 100 миллиардам — нейросети внезапно и резко начинают «уметь» в математику.
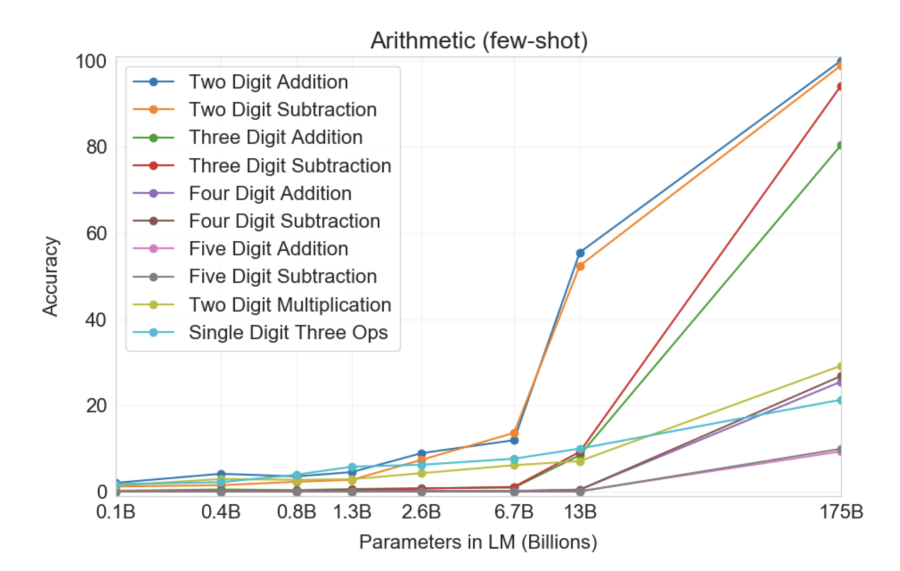
Еще раз, вдумайтесь: языковую модель обучали продолжать тексты словами, а она при этом как‑то смогла сама разобраться в том, что если ей печатают «378 + 789 =», то на это надо отвечать именно «1167», а не каким‑то другим числом. Магия, ей‑богу, магия! (Хотя, некоторые говорят «да это нейросетка просто все варианты успела увидеть и тупо запомнить в тренировочных данных» — так что дебаты о том, магия это или всего лишь попугайство, пока продолжаются.)
На графике выше самое интересное — это то, что при увеличении размера модели (слева направо) сначала как будто бы не меняется ничего, а затем — р‑раз! Происходит качественный скачок, и GPT-3 начинает «понимать», как решать ту или иную задачу. Как, что, почему это работает — никто точно не знает. Но работает как‑то; причем, не только в математике — но и вообще в самых разнообразных других задачах!
Анимация ниже как раз наглядно показывает, как с увеличением количества параметров модели в ней «прорастают» новые способности, которые никто туда специально не закладывал:
Кстати, задачу про «голодных рыбов», которой мы мучали GPT-2 в прошлом разделе, GPT-3 уже решает с точностью выше 90% — прямо как человек. Заставляет задуматься, правда: а какие новые скиллы обретет нейросеть, если увеличить ее объем еще раз в сто? Ну там, до десятков триллионов параметров, например.
Промпты, или как правильно уламывать модель
Давайте здесь сделаем небольшое отступление в сторону и обсудим, а что это вообще означает — «модель умеет решать задачи»? По сути, процесс выглядит так: мы подаем на вход модели некий текст с запросом, а она к нему дописывает свое продолжение. Если это продолжение (генерация) совпадает с нашими ожиданиями — то модель, получается, решила поставленную перед ней задачу.
Тот текст, что мы подаем на вход, называется prompt (промпт, или «запрос/затравка» по‑русски). Чем точнее он описывает, что мы хотим, тем лучше модель поймет, что ей нужно делать. А если мы ей еще и примеров отсыпем с десяток — то вообще шик!
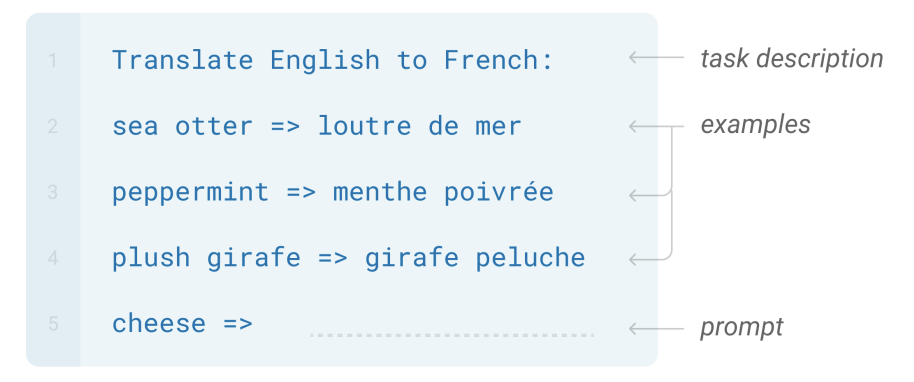
Без описания цели и без примеров в промпте, модель тоже обычно понимает проблему, но предлагает не такие хорошие решения (с точки зрения их качества). Можно сказать, что детализированный промпт позволяет GPT лучше оценить вероятности слов, которые нужно генерировать в качестве ответа, направляя ее в «требуемое русло».
Но насколько сложным должен быть промпт? И насколько модель по пониманию близка к нам? Вы не поверите, но совсем недавно исследователи выяснили, что для существенного улучшения результатов генерации нужно добавить в промпт простую советскую.
Окей, кроме шуток, но добавление всего одной фразы перед ответом на вопрос существенно улучшает качество модели. И эта магическая фраза — «пожалуйста» «let»s think step by step» (давай подумаем шаг за шагом). Внезапно оказалось, что это побуждает модель рассуждать последовательно, делать выводы на основе собственных суждений, и приходить к правильному ответу гораздо чаще, чем без этой фразы.
Как это работает? Давайте на примере детской задачки:
Вопрос: В среднем боксер Иван наносит 25 ударов в минуту. Бой длится 5 раундов по 3 минуты. Сколько ударов он нанес?
Ответ: 255
Текст, выделенный жирным – это ответ, сгенерированный языковой моделью. Легко проверить, что он – ну, немного неправильный.
Однако та же самая модель может ответить вот так:
Вопрос: В среднем боксер Иван наносит 25 ударов в минуту. Бой длится 5 раундов по 3 минуты. Сколько ударов он нанес?
Ответ: Давай подумаем шаг за шагом. За одну минуту Иван наносит 25 ударов. За три минуты Иван наносит 3 * 25 = 75 ударов. За пять раундов Иван наносит 5 * 75 = 375 ударов.
И снова текст выделенный жирным — это ответ модели. Видно, что он стал длиннее, решение задачи получилось прямо как у школьника — в три действия. Четко, последовательно — ровно так, как мы и попросили. И финальная цифра 375 является корректным ответом на исходный вопрос. Отдельно отмечу: мы никак не дообучали модель после того, как она ответила неправильно — это абсолютно та же самая модель. Мы просто дописали пять дополнительных слов в конец нашего промпта, и произошло чудо!
Причем вот этот «режим рассуждения» — это одна из качественно новых фишек, которые появились в «большой» модели GPT-3 после преодоления планки в сотню миллиардов параметров. Старые модели с меньшим количеством параметров такие фокусы показывать не умели, как их ни упрашивай специальными подсказками «ну подумой, братишка!».
Вообще, составление грамотных промптов для модели — это отдельная наука. Под эту задачу компании уже начали нанимать отдельных людей с должностью «промпт‑инженер» (то есть человек, сочиняющий запросы для языковых моделей) — вангую, что до появления онлайн‑курсов «������Научись промпт‑инжинирингу за 6 недель и вкатись в перспективную индустрию с зарплатой 300к в месяц!������» осталось всего ничего.
Краткое резюме: GPT-3 образца 2020 года была в 100 раз больше своей предшественницы по количеству параметров, и в 10 раз – по объему тренировочных текстовых данных. И снова рост количества привел к внезапному скачку в качестве: модель научилась переводу с других языков, арифметике, базовому программированию, пошаговым рассуждениям, и многому другому.
Январь 2022: InstructGPT, или как научить робота не зиговать
На самом деле, увеличение размеров языковых моделей само по себе еще не означает, что они будут отвечать на запросы именно так, как хочет их пользователь. Ведь часто мы, когда формулируем какой‑то запрос, подразумеваем очень много скрытых условий — которые в коммуникации между людьми считаются сами собой разумеющимися, что ли. Например, когда Маша просит своего мужа: «Вась, сходи выбрось мусор» — то вряд ли ей придет в голову прибавить к этому промпту «(только не из окна, плз!)». Ведь Вася это понимает и без уточнений — а всё потому, что их намерения и установки неплохо выравнены между собой.
А вот языковые модели, если честно, не очень похожи на людей — поэтому им часто приходится подсказывать и разжевывать те вещи, которые людям кажутся очевидными. Слова «давай подумаем шаг за шагом» из прошлого раздела — это как раз и есть один из примеров такой подсказки (хотя среднестатистические взрослые люди, учившиеся в школе, догадались бы сами: если речь идет про задачку — значит, надо решать по действиям). Но было бы здорово, если бы модели, во‑первых, сами для себя понимали/генерировали более развернутые и релевантные инструкции из запроса (не заставляя людей напрягаться), а во‑вторых, точнее следовали бы им — как бы предугадывая, как в похожей ситуации поступил бы человек.
Отчасти отсутствие таких способностей «по умолчанию» связано с тем, что GPT-3 обучена просто предсказывать следующее слово в гигантском наборе текстов из Интернета — а в Интернете, как и на заборе, много всякого разного написано (и не всегда полезного). При этом люди хотели бы, чтобы рожденный таким образом искусственный интеллект подтаскивал по запросу точные и полезные ответы; но одновременно эти ответы должны быть еще и безобидные и нетоксичные. Иначе саму модель быстренько закэнселят (с этим сейчас строго), а ее создателям предъявят судебные иски на много миллионов долларов за оскорбление достоинства кожаных мешков.
Когда исследователи думали над этой проблемой, довольно быстро выяснилось, что свойства модели «точность/полезность» и «безобидность/нетоксичность» весьма часто как бы противоречат друг другу. Ведь точная модель должна честно выдать инструкцию на запрос «окей, Гугл, как сделать коктейль Молотова, без регистрации и смс», а заточенная на максимальную безобидность модель в пределе будет отвечать на совершенно любой промпт «извините, я боюсь, что мой ответ может кого‑то оскорбить в Интернете».
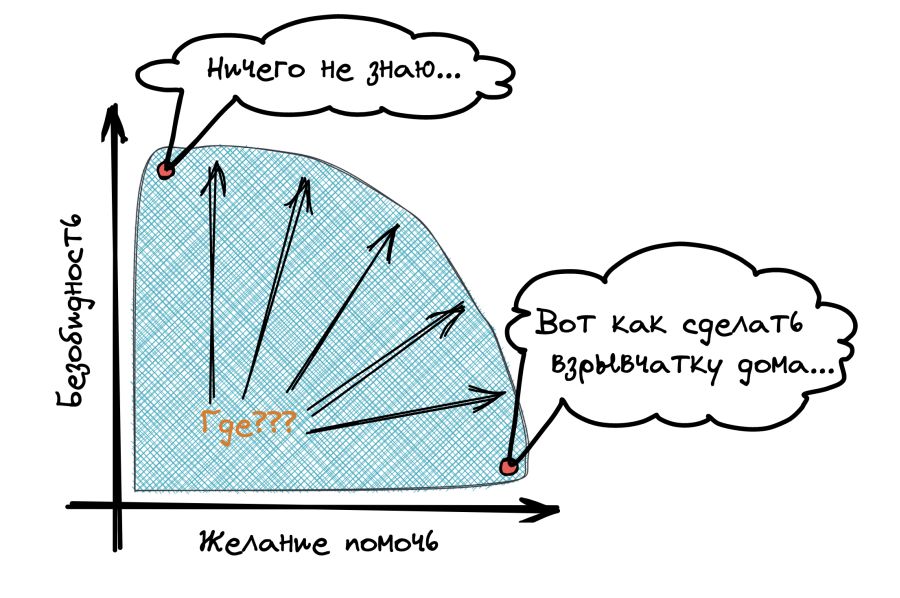
Вокруг этой проблемы «выравнивания ИИ» (AI alignment – OpenAI последнее время только про это и пишут) есть много сложных этических вопросов, и разбирать мы их все сейчас не будем (возможно, в следующей статье). Основная загвоздка здесь в том, что подобных спорных ситуаций – огромная куча, и как-то четко формализовать их просто не представляется возможным. Да что там, люди и сами между собой не могут толком последние несколько тысяч лет договориться – что хорошо, а что плохо. Не говоря уже о том, чтобы понятные для робота правила сформулировать (Айзек, к тебе вопросов нет).
В итоге исследователи не придумали ничего лучше, чем просто дать модели очень много обратной связи. В каком-то смысле, человеческие детеныши ведь именно так и обучаются морали: делают много всякого разного с самого детства, и при этом внимательно следят за реакцией взрослых – что можно делать, а что есть «кака, фу!».
Короче, InstructGPT (также известная как GPT-3.5) – это как раз и есть GPT-3, которую дообучили с помощью фидбека на максимизацию оценки живого человека. Буквально – куча людей сидели и оценивали кучу ответов нейросетки на предмет того, насколько они соответствуют их ожиданиям с учетом выданного ей запроса. Ну, на самом деле, всё было не совсем так просто (инструкции для членов такого «мясного жюри» занимали 26 страниц убористым почерком) – но суть именно такая. А языковая модель, получается, училась решать еще одну дополнительную задачу – «как мне поменять свой сгенерированный ответ таким образом, чтобы он получил наибольшую оценку от человека?» (подробнее процесс обучения по обратной связи разбирается в этом материале).
Причем с точки зрения общего процесса обучения модели, этот финальный этап «дообучения на живых людях» занимает не более 1%. Но именно этот финальный штрих и стал тем самым секретным соусом, который сделал последние модели из серии GPT настолько удивительными! Получается, GPT-3 до этого уже обладала всеми необходимыми знаниями: понимала разные языки, помнила исторические события, знала отличия стилей разных авторов, и так далее. Но только с помощью обратной связи от других людей модель научилась пользоваться этими знаниями именно таким образом, который мы (люди) считаем «правильным». В каком-то смысле, GPT-3.5 – это модель, «воспитанная обществом».
Краткое резюме: GPT-3.5 (также известная как InstructGPT) появилась в начале 2022 года, и главной ее фишкой стало дополнительное дообучение на основе обратной связи от живых людей. Получается, что эта модель формально вроде как больше и умнее не стала – но зато научилась подгонять свои ответы таким образом, чтобы люди от них дичайше кайфовали.
Ноябрь 2022: ChatGPT, или маленькие секреты большого хайпа
ChatGPT вышла в ноябре 2022 года — примерно через 10 месяцев после своей предшественницы, InstructGPT/GPT-3.5 — и мгновенно прогремела на весь мир. Кажется, что последние несколько месяцев даже бабушки на лавочке у подъезда обсуждают только одно — что там нового сказала эта ваша «ЧатЖПТ», и кого она по самым свежим прогнозам вот‑вот оставит без работы.
При этом с технической точки зрения, кажется, у нее нет каких‑то особо мощных отличий от InstructGPT (к сожалению, научной статьи с детальным описанием ChatGPT команда OpenAI пока так и не опубликовала — так что мы тут можем только гадать). Ну окей, про некоторые менее значимые отличия мы всё же знаем: например, про то, что модель дотренировали на дополнительном диалоговом наборе данных. Ведь есть вещи, которые специфичны именно для работы «ИИ‑ассистента» в формате диалога: например, если запрос пользователя неясен — то можно (и нужно!) задать уточняющий вопрос, и так далее.
Но это уже детали — нам здесь важно, что основные технические характеристики (архитектура, количество параметров. ) нейросетки не поменялись кардинально по сравнению с прошлым релизом. Отсюда возникает вопрос — как так? Почему мы не слышали никакого хайпа про GPT-3.5 еще в начале 2022-го? При том, что Сэм Альтман (исполнительный директор OpenAI) честно признался, что исследователи сами удивились такому бурному успеху ChatGPT — ведь сравнимая с ней по способностям модель к тому моменту тихо‑мирно лежала на их сайте уже более десяти месяцев, и никому не было до этого дела.
Это удивительно, но похоже, что главный секрет успеха новой ChatGPT — это всего лишь удобный интерфейс! К той же InstructGPT обращаться можно было лишь через специальный API‑интерфейс — то есть, сделать это заведомо могли только нёрды‑айтишники, а не обычные люди. А ChatGPT усадили в привычный интерфейс «диалогового окна», прямо как в знакомых всем мессенджерах. Да еще и открыли публичный доступ вообще для всех подряд — и люди массово ринулись вести диалоги с нейросетью, скринить их и делиться в соцсетях. Choo‑choo, all aboard the hype train!
Как и в любом технологическом стартапе, здесь оказалась важна не только сама технология — но и обертка, в которую она была завернута. У вас может быть самая лучшая модель или самый умный чат‑бот — но они будут никому не интересны, если к ним не прилагается простой и понятный интерфейс. И ChatGPT в этом смысле совершил прорыв, выведя технологию в массы за счет обычного диалогового окна, в котором дружелюбный робот «печатает» ответ прямо на глазах, слово за словом.
Неудивительно, что ChatGPT установил абсолютные рекорды по скорости привлечения новых пользователей: отметку в 1 миллион юзеров он достиг в первые пять дней после релиза, а за 100 миллионов перевалил всего за два месяца.

Ну а там, где есть рекордно быстрый приток сотен миллионов пользователей — конечно, тут же появятся и большие деньги. Microsoft оперативно заключила с OpenAI сделку по инвестированию в них десятка миллиардов долларов, инженеры Google забили тревогу и сели думать, как им спасти свой поисковый сервис от конкуренции с нейросетью, а китайцы в срочном порядке анонсировали скорый релиз своего собственного чат‑бота. Но это всё, если честно, уже совсем другая история — следить за которой вы можете сейчас сами «в прямом эфире».
Краткое резюме: Модель ChatGPT вышла в ноябре 2022-го и с технической точки зрения там не было никаких особых нововведений. Но зато у нее был удобный интерфейс взаимодействия и открытый публичный доступ — что немедленно породило огромную волну хайпа. А в нынешнем мире это главнее всего — так что языковыми моделями одномоментно начали заниматься вообще все вокруг!
Подведем итоги
Статья получилась не очень короткой — но надеемся, что вам было интересно, и просле прочтения вы чуть лучше стали понимать, что же конкретно творится под капотом этих самых нейросетей. Кстати, у Игоря Котенкова (одного из авторов этой статьи) есть еще один лонгрид на Хабре под названием «ChatGPT как инструмент для поиска: решаем основную проблему», в котором нюансы машинного обучения разбираются еще более подробно.
Для вашего удобства мы сделали небольшой сводный постер, который наглядно иллюстрирует основные вехи истории эволюции языковых моделей. Если какой‑то этап кажется вам не очень понятным — можете просто вернуться чуть назад к соответствующему разделу в тексте и перечитать его заново (ну или задать нам уточняющие вопросы в комментариях).

На самом деле, в первоначальном плане статьи у нас было гораздо больше пунктов: мы хотели подробнее обсудить и проблемы контроля за искусственным интеллектом, и жадность корпораций, которые в высококонкурентной погоне за прибылью могут случайно родить ИИ‑Франкенштейна, и сложные философские вопросы вроде «можно ли считать, что нейросеть умеет мыслить, или всё же нет?».
Если на эту статью будет много положительных отзывов, то все эти (на наш взгляд — супер‑захватывающие!) темы мы разберем в следующем материале. Если вы не хотите его пропустить — то приглашаем вас подписаться на ТГ‑каналы авторов: Сиолошная Игоря Котенкова (для тех, кто хочет шарить за технологии) и RationalAnswer Павла Комаровского (для тех, кто за рациональный подход к жизни, но предпочитает чуть попроще). Всё, всем спасибо за внимание — с нетерпением ждем ваших комментариев!
UPD: Следующую статью из серии с разбором GPT-4 можно прочитать здесь.
GPT-4: Чему научилась новая нейросеть, и почему это немного жутковато
В этой статье мы разберем новые удивительные способности последней языковой модели из семейства GPT .