
Сбор данных с помощью API Вконтакте
Давайте поговорим о том, как используя API, вы можете получить и отсортировать данные всего несколькими командами. В продолжение темы сбора данных из социальной сети Вконтакте, хотим поделиться своим опытом по поиску пользователей и их друзей.
15K открытий
Так вот, сделав несколько пробных выборок для анализа, мы поняли, что поиск по фамилии и имени дает слишком ненадежные результаты, т.к. даты рождения многих пользователей скрыты, и даже выгрузив все совпадения по ФИ, вы все равно не сможете потом идентифицировать нужные данные.
Важно: мы заметили, что при поиске по ФИ + ДР Вконтакте выдаст подходящих пользователей, даже если их дата рождения скрыта. Это можно было использовать, только нужно обеспечить связь с данными поискового запроса. Для работы с API VK мы решили использовать Python с библиотекой vk_api (установка: pip install vk_api). Итого нам потребуются 2 библиотеки:
import pandas as pd import vk_api
Далее – импорт входных данных в формате ID, Имя, Фамилия, Отчество (можно оставить пустым, так как Вконтакте отчество отсутствует), День рождения, Месяц рождения, Год рождения. Пример: (0,Пет, Петрови, ,1,1,1950)
data = pd.read_csv(‘in.txt’, encoding = ‘cp1251’)
Затем авторизация и получение токена VK:
vk_session = vk_api.VkApi(‘+79XXXXXXXXXX’, ‘password’) vk_session.auth() vk = vk_session.get_api()
После этого мы можем начинать выполнять запросы к API.
Разберем для примера использование метода users.search и сохранение полученных результатов. Основные параметры это q – строка поискового запроса, так же для поиска нам понадобятся birth_day, birth_month, birth_year, count – количество результатов (поставим максимум – 1000), fields – список дополнительных полей, в примере укажем ‘bdate, city’. Результат будет возвращен в виде словаря Python. Разберем подробно:
t=<> #создаем словарь для хранения данных, получаемых от API VK for j in range(0, len(data)): #запускаем поиск по массиву #Далее следует обращение к API с нашими параметрами: t[j]=vk.users.search(q = data[‘N’][j] + ‘ ‘ + data[‘F’][j], birth_day = data[‘D’][j], \ birth_month = data[‘M’][j], birth_year = data[‘Y’][j], count = 1000, fields=’bdate, city’) for h in (t[j][‘items’]): #Сохраняем результаты поиска в файл»users.txt» with open(‘users.txt’,’a’) as f1: f1.write((str(data[‘id’][j]) + ‘;’ #ID исходный + str(t[j][‘count’]) + ‘;’ #Количество найденных пользователей + str(h[‘id’]) + ‘;’ #ID пользователя VK + h[‘last_name’] + ‘;’ #Фамилия + h[‘first_name’] + ‘;’ #Имя + h.get(‘bdate’,») + ‘;’ #Дата рождения + h.get(‘city’,<>).get(‘title’,») #У города несколько параметров — нам нужно название: title + ‘;\n’).encode(‘cp1251’, ‘replace’).decode(‘cp1251’))#Для удаления нестандартных символов, которые могут вызывать ошибки
Далее мы можем в этом же цикле осуществить поиск и сохранение ID друзей пользователя, за это отвечает метод friends.get. Если друзей нет (или скрыты), метод вернет ошибку, поэтому используем try/except:
try: m=vk.friends.get(user_id = str(h[‘id’]), count = 50000) for q in m[‘items’]: #Сохраняем ID друзей в файл «friends.txt» with open(‘friends.txt’,’a’) as f2: f2.write(str(data[‘id’][j]) + ‘;’ + str(h[‘id’]) + ‘;’ + str(q) + ‘;\n’) except: #Если друзей нет (или скрыты) пишем в файл 0 для этого ID with open(‘friends.txt’,’a’) as f2: f2.write(str(data[‘id’][j]) + ‘;’ + str(h[‘id’]) + ‘;0;\n’)
Если мы хотим выполнить большое количество запросов, нужно добавить паузу между ними, например, команда sleep библиотеки time. Без этого учетная запись VK может быть заблокирована. Экспериментальным путем подобраны значения 9 секунд для поиска без друзей и 5 для поиска с друзьями (меньше, т.к. получение и сохранение списка друзей занимает несколько секунд). Производительность при использовании одной учетной записи Вконтакте составляет 8-10 тыс. пользователей в сутки. Полученные результаты сохраняются в файлы users.txt и friends.txt и могут в дальнейшем быть обработаны в БД или средствами Python.
Делаем многоуровневого бота для ВК с Long Poll VK API, Python, MySQL и решаем вопрос многопоточности c помощью threading
Создание ботов — довольно заезжанная тема, но все уроки, статьи и различного рода документация дают информацию только о том, как построить бота в один уровень без возможности создания древа из различных всплывающих меню (клавиатур).
А это нужно для создания:
- Сложных ботов с несколькими уровнями «глубины» (различные меню/клавиатуры)
- Ботов, созданных одновременно для групповых чатов и для лички сообщества
- Ботов, с повторяющимися ключевыми командами в различных меню, которые необходимо разделять
Можно сделать многоуровневого бота на Python сразу (без, например, библиотеки threading и без базы данных), но он будет адекватно работать только для одного пользователя в текущий момент времени, потому что одна клавиатура и текущее положение пользователя будет сохраняться в MainThread (основном треде) для всех.
Предварительная подготовка
Устанавливаем MySQL на необходимую машину:
Или через терминал (для Linux):
sudo apt install mysql-serverЕсли у Вас не установлены необходимые библиотеки — то устанавливаем их через терминал:
pip3 install vk_api pip3 install pymysqlВ базе данных нам предварительно нужно создать базу данных в MySQL с названием vktest с таблицей user и полями — iduser и position. Я создаю БД с кодировкой utf8mb4:
CREATE SCHEMA vktest DEFAULT CHARACTER SET utf8mb4 ; CREATE TABLE `vktest`.`user` ( `iduser` INT UNSIGNED NOT NULL, `position` TINYINT UNSIGNED NULL, PRIMARY KEY (`iduser`));Базовый алгоритм

Основная идея алгоритма в том, что основной тред будет занят слушанием longpoll, который при появлении нового сообщения будет создавать новый тред. В этот новый тред, как аргументы, будут отсылаться айди пользователя и текст сообщения и далее обрабатываться.
В новосозданном треде бот сразу берет текущее положение пользователя в БД, в зависимости от этого положения происходит обработка сообщения и после обновляется положение пользователя в БД на новое и выполняются нужные инструкции.
Для начала представим этот алгоритм для основной функции, которая и будет создавать эти треды (код составлен для сообщений в личку сообщества):
import vk_api from vk_api import VkUpload from vk_api.utils import get_random_id from vk_api.bot_longpoll import VkBotLongPoll, VkBotEventType import threading import requests import random import pymysql import pymysql.cursors if __name__ == '__main__': while True: session = requests.Session() vk_session = vk_api.VkApi(token="%Токен сообщества VK%") vk = vk_session.get_api() upload = VkUpload(vk_session) longpoll = VkBotLongPoll(vk_session, "%ID сообщества VK%") try: for event in longpoll.listen(): if event.type == VkBotEventType.MESSAGE_NEW and event.from_user: threading.Thread(target=processing_message, args=(event.obj.from_id, event.obj.text)).start() except Exception: pass Весь код в основной функции завернут в while True из-за того, что раньше каждую ночь (возможно также и сейчас) примерно в 4:30 по МСК переставал отвечать VK на запросы и бот падал (видимо перезагружали серверы).
Основная идея тренировочного бота — это сделать три меню, где Основное меню 1 будет иметь возможность попасть в Меню 2 и в Меню 3, а они, в свою очередь, могли вернуться обратно в Основное меню 1:

В формате меню в самом ВКонтакте хочется представить это так:

У нас 3 клавиатуры, которые нужно создать в виде файлов с расширением .json в папке с main.py. Первый файл keyboard_main.json будет с кодом:
< "one_time": false, "buttons": [ [< "action": < "type": "text", "label": "Цитаты Дурова" >, "color": "default" >], [ < "action": < "type": "text", "label": "Цитаты Цукерберга" >, "color": "default" >] ] >Второй файл keyboard_durov.json с кодом:
< "one_time": false, "buttons": [ [< "action": < "type": "text", "label": "Хочу ещё Дурова" >, "color": "positive" >], [ < "action": < "type": "text", "label": "Выйти в главное меню" >, "color": "default" >] ] >Третий, практически идентичный — keyboard_zuckerberg.json:
< "one_time": false, "buttons": [ [< "action": < "type": "text", "label": "Хочу ещё Цукерберга" >, "color": "positive" >], [ < "action": < "type": "text", "label": "Выйти в главное меню" >, "color": "default" >] ] >Значение target у нас processing_message, поэтому создаём функцию в main.py с именем processing_message и c аргументами в виде id юзера и его сообщения:
def processing_message(id_user, message_text): number_position = take_position(id_user) if number_position == 0: send_message(id_user, "keyboard_main.json", "Тебя приветствует бот!") add_new_line(id_user) elif number_position == 1: if message_text == "Цитаты Дурова": update_position(id_user, "2") send_message(id_user, "keyboard_durov.json", durov_quote()) elif message_text == "Цитаты Цукерберга": update_position(id_user, "3") send_message(id_user, "keyboard_zuckerberg.json", zuckerberg_quote()) else: send_message(id_user, "keyboard_main.json", "Непонятная команда") elif number_position == 2: if message_text == "Хочу ещё Дурова": send_message(id_user, "keyboard_durov.json", durov_quote()) elif message_text == "Выйти в главное меню": update_position(id_user, "1") send_message(id_user, "keyboard_main.json", "Мы в главном меню") else: send_message(id_user, "keyboard_durov.json", "Непонятная команда") elif number_position == 3: if message_text == "Хочу ещё Цукерберга": send_message(id_user, "keyboard_zuckerberg.json", zuckerberg_quote()) elif message_text == "Выйти в главное меню": update_position(id_user, "1") send_message(id_user, "keyboard_main.json", "Мы в главном меню") else: send_message(id_user, "keyboard_zuckerberg.json", "Непонятная команда") else: send_message(id_user, "keyboard_main.json", "Произошла какая-то ошибка")Весь алгоритм этой функции построен на том, что мы сразу берем текущую позицию пользователя и в зависимости от неё обрабатываем сообщение пользователя. Если number_position — это 0 (функция take_position(id_user) вернула 0, то есть в базе данных она не нашла пользователя), то она сразу добавляет его в БД с позицией 1 через функцию add_new_line(id_user), перемещая таким образом его в главное меню и открывая ему клавиатуру keyboard_main.json.
Если number_position от 1 до 3 — то бот выполняет код в соответствующем для него ветвлении if-elif-else.
Функция take_position(id_user) выглядит таким образом:
def take_position(id_user): connection = get_connection() try: with connection.cursor() as cursor: sql = "SELECT position FROM user WHERE iduser = %s" cursor.execute(sql, (id_user)) line = cursor.fetchone() if line is None: return_count = 0 else: return_count = line["position"] finally: connection.close() return return_countВ свою очередь add_new_line(id_user) выглядит так:
def add_new_line(id_user): connection = get_connection() try: with connection.cursor() as cursor: sql = "INSERT INTO user (iduser, position) VALUES (%s, %s)" cursor.execute(sql, (id_user, "1")) connection.commit() finally: connection.close() returnКогда пользователь имеет свою строку в БД — он уже может приступать к взаимодействию с ботом. И обновление его положения — это функция update_position(id_user, new_position), которая выглядит таким образом:
def update_position(id_user, new_position): connection = get_connection() try: with connection.cursor() as cursor: sql = "UPDATE user SET position = %s WHERE iduser = %s" cursor.execute(sql, (new_position, id_user)) connection.commit() finally: connection.close() returnЭти три функции не будут работать без основной функции для БД (которую необходимо добавить практически в самое начало, сразу после импорта библиотек) и вписать ваши данные от БД. Я изменяю только название БД и кодировку на те, которые мы создали в самом начале:
def get_connection(): connection = pymysql.connect(host="%name_host%", user="%name_user%", password="%password_user%", db="vktest", charset="utf8mb4", cursorclass=pymysql.cursors.DictCursor) return connectionИ одна из самых важных функций — отправка сообщения пользователю. Я вывел её в отдельную функцию send_message, так как это нерационально возить такую махину постоянно по всему коду:
def send_message(id_user, id_keyboard, message_text): try: vk.messages.send( user_id=id_user, random_id=get_random_id(), keyboard=open(id_keyboard, 'r', encoding='UTF-8').read(), message=message_text) except: print("Ошибка отправки сообщения у id" + id_user)Ничего не забыли? Ах да, нам же нужны крутые цитаты Дурова и Цукерберга:
durov_quote() и zuckerberg_quote()
def durov_quote(): durov = ['Лучшее решение из возможных — самое простое. И наоборот.', 'Что такое университет? Это же раздробленная структура с удельными княжествами.', 'Коммуникация переоценена. Час одиночества продуктивнее недели разговоров.', 'Проблемы — это спрятанные решения.', 'Врать вредно для духовной целостности.'] return random.choice(durov) def zuckerberg_quote(): zuckerberg = ['В мире, который меняется очень быстро, единственная стратегия, которая гарантированно ' 'провальна — не рисковать.', 'Двигайтесь быстро и разрушайте препятствия. Если вы ничего не разрушаете, ' 'Вы движетесь недостаточно быстро.', 'Вопрос не в том, что мы хотим знать о человеке. Вопрос стоит так:' '«Что люди хотят рассказать о себе?»', 'Люди могут быть очень умными или иметь отличные профессиональные навыки, ' 'но если они действительно не верят в свое дело, они не будут по-настоящему работать.', 'Вопрос, который я задаю себе почти каждый день: сделал ли я самую важную вещь, которую ' 'я мог бы сделать? Если я не чувствую, что я работаю над самой важной проблемой, где я ' 'могу помочь, я не буду чувствовать, что хорошо провожу свое время'] return random.choice(zuckerberg)Для них мы использовали встроенные списки Python и подключили библиотеку random.
И весь код main.py (целиком) под спойлером для удобства:
import vk_api from vk_api import VkUpload from vk_api.utils import get_random_id from vk_api.bot_longpoll import VkBotLongPoll, VkBotEventType import threading import random import pymysql import pymysql.cursors import requests def get_connection(): connection = pymysql.connect(host="%name_host%", user="%name_user%", password="%password_user%", db="vktest", charset="utf8mb4", cursorclass=pymysql.cursors.DictCursor) return connection def send_message(id_user, id_keyboard, message_text): try: vk.messages.send( user_id=id_user, random_id=get_random_id(), keyboard=open(id_keyboard, 'r', encoding='UTF-8').read(), message=message_text) except: print("Ошибка отправки сообщения у id" + id_user) def add_new_line(id_user): connection = get_connection() try: with connection.cursor() as cursor: sql = "INSERT INTO user (iduser, position) VALUES (%s, %s)" cursor.execute(sql, (id_user, "1")) connection.commit() finally: connection.close() return def take_position(id_user): connection = get_connection() try: with connection.cursor() as cursor: sql = "SELECT position FROM user WHERE iduser = %s" cursor.execute(sql, (id_user)) line = cursor.fetchone() if line is None: return_count = 0 else: return_count = line["position"] finally: connection.close() return return_count def update_position(id_user, new_position): connection = get_connection() try: with connection.cursor() as cursor: sql = "UPDATE user SET position = %s WHERE iduser = %s" cursor.execute(sql, (new_position, id_user)) connection.commit() finally: connection.close() return def durov_quote(): durov = ['Лучшее решение из возможных — самое простое. И наоборот.', 'Что такое университет? Это же раздробленная структура с удельными княжествами.', 'Коммуникация переоценена. Час одиночества продуктивнее недели разговоров.', 'Проблемы — это спрятанные решения.', 'Врать вредно для духовной целостности.'] return random.choice(durov) def zuckerberg_quote(): zuckerberg = ['В мире, который меняется очень быстро, единственная стратегия, которая гарантированно ' 'провальна — не рисковать.', 'Двигайтесь быстро и разрушайте препятствия. Если вы ничего не разрушаете, ' 'Вы движетесь недостаточно быстро.', 'Вопрос не в том, что мы хотим знать о человеке. Вопрос стоит так:' '«Что люди хотят рассказать о себе?»', 'Люди могут быть очень умными или иметь отличные профессиональные навыки, ' 'но если они действительно не верят в свое дело, они не будут по-настоящему работать.', 'Вопрос, который я задаю себе почти каждый день: сделал ли я самую важную вещь, которую ' 'я мог бы сделать? Если я не чувствую, что я работаю над самой важной проблемой, где я ' 'могу помочь, я не буду чувствовать, что хорошо провожу свое время'] return random.choice(zuckerberg) def processing_message(id_user, message_text): number_position = take_position(id_user) if number_position == 0: send_message(id_user, "keyboard_main.json", "Тебя приветствует бот!") add_new_line(id_user) elif number_position == 1: if message_text == "Цитаты Дурова": update_position(id_user, "2") send_message(id_user, "keyboard_durov.json", durov_quote()) elif message_text == "Цитаты Цукерберга": update_position(id_user, "3") send_message(id_user, "keyboard_zuckerberg.json", zuckerberg_quote()) else: send_message(id_user, "keyboard_main.json", "Непонятная команда") elif number_position == 2: if message_text == "Хочу ещё Дурова": send_message(id_user, "keyboard_durov.json", durov_quote()) elif message_text == "Выйти в главное меню": update_position(id_user, "1") send_message(id_user, "keyboard_main.json", "Мы в главном меню") else: send_message(id_user, "keyboard_durov.json", "Непонятная команда") elif number_position == 3: if message_text == "Хочу ещё Цукерберга": send_message(id_user, "keyboard_zuckerberg.json", zuckerberg_quote()) elif message_text == "Выйти в главное меню": update_position(id_user, "1") send_message(id_user, "keyboard_main.json", "Мы в главном меню") else: send_message(id_user, "keyboard_zuckerberg.json", "Непонятная команда") else: send_message(id_user, "keyboard_main.json", "Произошла какая-то ошибка") if __name__ == '__main__': while True: session = requests.Session() vk_session = vk_api.VkApi(token="%Токен сообщества VK%") vk = vk_session.get_api() upload = VkUpload(vk_session) longpoll = VkBotLongPoll(vk_session, "%ID сообщества VK%") try: for event in longpoll.listen(): if event.type == VkBotEventType.MESSAGE_NEW and event.from_user: threading.Thread(target=processing_message, args=(event.obj.from_id, event.obj.text)).start() except Exception: pass Заключение

Этой статьей я поделился с массами адекватным, как мне кажется, решением для создания многоуровневого бота. Надеюсь, это защитит многих на старте от решений в виде цикла longpoll в цикле longpoll и в ещё одном longpoll, из которых довольно трудно выйти. Всем удачи.
Как читать свои сообщения ВКонтакте через API
Я любитель использовать API для «общения» с повседневными сервисами. Например, моя статья о API Яндекс.Метрики как раз об этом: как без интерфейса получать нужные данные. Не так давно меня посетила мысль использовать API ВКонтакте, вместо привычного интерфейса. Зачем это может быть нужно? Например, чтобы прочитать свои сообщения, при этом не заходя на страницы vk.com, а значит не появляясь онлайн. У меня вот есть социофобская черта — я не люблю появляться Вконтакте онлайн, но иногда туда приходят сообщения, и было бы неплохо иметь возможность эти сообщения читать, при этом онлайн не появляясь.
Получить доступ к API для доступа к пользовательским данным можно в 3 шага:
- Создание приложение
- Получения токена для доступа к данным от имени пользователя
- Запрос для получения входящих сообщений
Первый и второй шаг нужно сделать 1 раз, а третий шаг придется выполнять каждый раз, когда захочется прочитать свои сообщения ВКонтакте.
Итак, первый шаг: создание своего приложения для API Вконтакте.
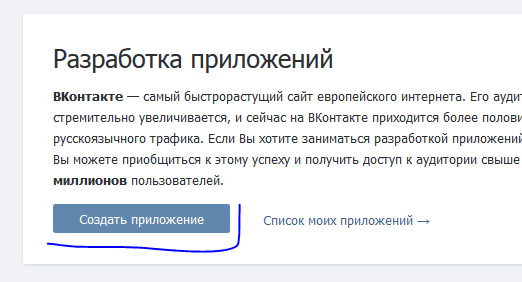
1 . Заходим на страницу http://vk.com/dev
2 . Выбираем «Создать приложение»
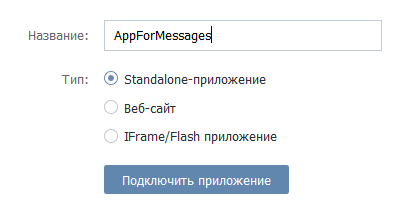
3 . Задаем название и выбираем тип «Standalone-приложение», после чего нажимаем «Подключить приложение»
4 . Потом нужно подтвердить приложение с помощью СМС-кода, отправленного на телефонный номер
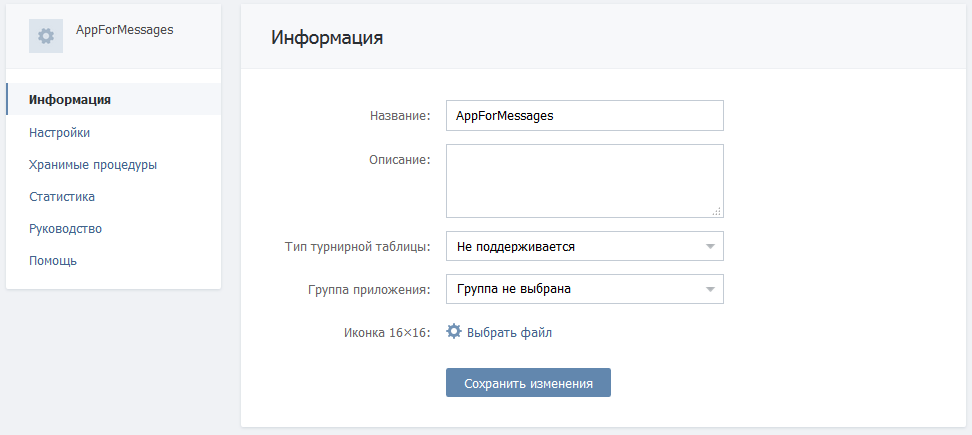
5 . Приложение создано и нас встречает страница с информацией о нашем приложении
6 . Переходим на страницу «Настройки» и в поле «Состояние» выбираем «Приложение включено и видно всем»
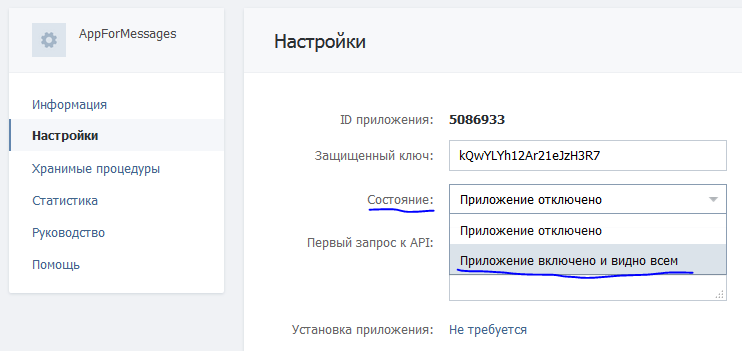
7 . Нажимаем «Сохранить изменения»
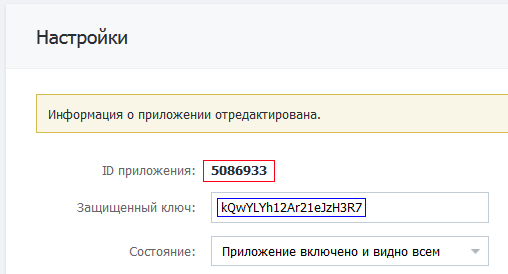
8 . Также на этой странице нам пригодятся ID приложения (в красной рамке на изображении ниже) и защищенный ключ (и в синей рамке на изображении ниже)
Второй шаг: получение токена для доступа к данным
Этот шаг надо делать будучи залогиненным Вконтакте под тем пользователем, к данным которого нужно получить доступ.
1 . Делаем в браузере запрос https://oauth.vk.com/authorize?client_id=5086933&display=page&redirect_uri=https://oauth.vk.com/blank.html&display=page&scope=messages,offline&response_type=code&v=5.37, где client_id — это ID нашего приложения со страницы настроек. В параметре «scope» перечисляются права доступа нашего приложения. В нашем случае, «messages» означает, что приложение будет иметь доступ к чтению сообщений пользователя. Разрешение «offline» дает нашему приложению доступ к данным пользователя в любое время, при этом доступ будет бессрочный. Помимо «messages» можно задать другие разрешения, которые надо также перечислять через запятую. Например, разрешение «friends» дает доступ к друзьям, тогда scope=messages,friends,offline. Про все возможные разрешения написано тут.
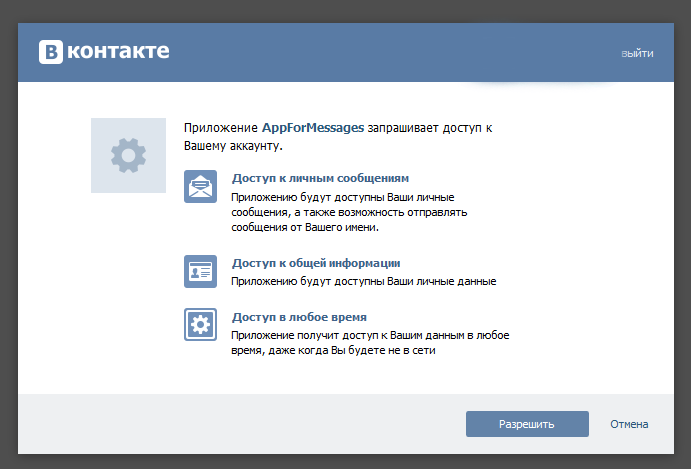
2 . Мы окажемся на странице, где должны разрешить созданному приложению доступ к аккаунту:
3 . Нажимаем «Разрешить»
4 . После этого нас перебросить на страницу вида https://oauth.vk.com/blank.html#code=ce72f6a9157bef81f6, где параметр code содержит верификационный код, действительный 1 час с момента его получения. Копируем этот код
5 . Делаем в браузере запрос https://oauth.vk.com/access_token?client_id=5086933&client_secret=kQwYLYh12Ar21eJzH3R7&redirect_uri=https://oauth.vk.com/blank.html&code=ce72f6a9157bef81f6, где client_id — ID приложения со страницы настроек, client_sercet — защищенный ключ (также со страницы настроек приложения), а code — верификационный код, который мы получили в предыдущем пункте

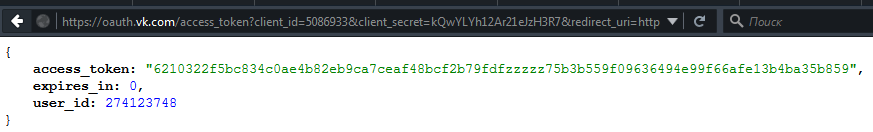
6 . На открывшейся странице будет в формате JSON представлен токен для доступа в значении ключа access_token:
P.S.: Чтобы JSON смотрелся в браузере также хорошо («pretty») как у меня на скриншоте надо установить какое-нибудь разрешение для браузера, позволяющее
Помимо кода доступа JSON содержит ключ expires_in, содержащий срок действия токена (у нас там 0, т. к. токен бессрочный) и user_id пользователя, доступ к данным которого возможен с помощью полученного токена. Копируем токен, он нам теперь будет нужен каждый раз, когда мы будем делать запрос к API.
Третий и последний шаг: получение списка входящих сообщений
Перечень всех методов для работы с API Вконтакте доступен по ссылке, но нам пока пригодится только метод messages.get, с помощью которого можно получить список входящих или исходящих сообщений. Вполне возможно, что захочется еще и отправлять сообщения, тут нужен метод messages.send.
Использовать метод messages.get предельно просто:
Просто делаем запрос вида https://api.vk.com/method/messages.get?access_token=f73dc057f8d81d96, где access_token — токен для доступа, который мы получили на втором шаге. Получаем приблизительно такую картину:
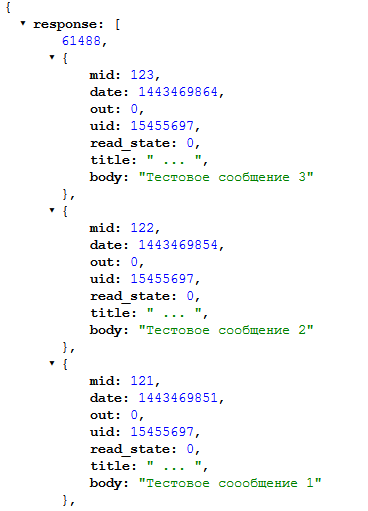
Каждый объект в массиве response — это отдельное сообщение, body — это текст сообщения, uid — идентификатор пользователя, отправившего сообщение, read_state — прочитано ли сообщение (1) или не прочитано (0), out — входящее сообщение (0) или исходящее (1), date — дата сообщения в формате posix, mid — идентификатор сообщения.
Вот такой нетривиальный способ читать свои сообщения Вконтакте.
Вступайте в группу на Facebook и подписывайтесь на мой канал в Telegram, там публикуются интересные статьи про анализ данных и не только.
Собираем данные по рекламным кампаниям ВКонтакте
В пятничном лонгриде проделаем большую работу: возьмём информацию по рекламным кампаниям ВКонтакте и сопоставим их с данными Google Analytics в Redash. Чтобы снова не поднимать сервер, будем передавать данные через Google Docs, используя Spreadsheet API.
Получение access token
Для получение пользовательского ключа ВКонтакте нужно создать приложение. Идём в раздел «Разработчики» по https://vk.com/apps?act=manage, жмём на кнопку «Создать приложение». В поле «Тип приложения» выбираем «Standalone-приложение» и даём любое название. После этого в меню слева идём в настройки и сохраняем себе ID приложения.
Актуальную информацию о ключах можно посмотреть в статье «Получение ключа доступа»

Теперь копируем себе эту ссылку:
https://oauth.vk.com/authorize?client_id=YourClientID&scope=ads&response_type=tokenНо вместо YourClientID вставляем ID своего созданного приложения. В scope у этой ссылки только ads, так что с этим ключом можно будет получать только информацию о рекламном кабинете. Вставляем её в браузер и нас скидывает на другую страницу — в адресе этой странице будет указан ваш сгенерированный access token.
Срок жизни токена — 86400 секунд: ровно сутки. Чтобы получить токен без временных ограничений можно добавить в scope параметр offline. Если токен понадобилось отозвать — смените пароль от страницы или в настройках безопасности завершите активные сессии.
Ещё для запросов к API нам пригодится ID рекламного кабинета — проходим по https://vk.com/ads?act=settings и копируем «номер кабинета».
Сбор данных через запросы к API
Напишем скрипт, который обращается к серверу ВКонтакте с нашим access token и номером рекламного кабинета и берёт информацию о всех кампаниях пользователя: количество просмотров на рекламах, кликов и затрат. Затем скрипт будет формировать из него DataFrame и отправлять в Google Docs.
from oauth2client.service_account import ServiceAccountCredentials from pandas import DataFrame import requests import gspread import timeЗададим несколько константных значений: access token, ID рекламного кабинета и версию API ВКонтакте, которую будем использовать. Актуальной является версия 5.103.
token = 'fa258683fd418fafcab1fb1d41da4ec6cc62f60e152a63140c130a730829b1e0bc' version = 5.103 id_rk = 123456789За получение статистики по рекламе отвечает метод ads.getStatistics , но один из обязательных параметров при его вызове — ’ids’, ID рекламного объявления, статистику по которому мы хотим получить. Так как ID у нас пока нет, придётся сначала воспользоваться методов ads.getAds , который возвращает ID объявлений и кампаний.
Подробнее со всеми методами ВКонтакте API можно ознакомиться в документации
Библиотекой requests отправляем запрос к серверу и передаём свои параметры. Полученный ответ сразу переведём в формат json
campaign_ids = [] ads_ids = [] r = requests.get('https://api.vk.com/method/ads.getAds', params=< 'access_token': token, 'v': version, 'account_id': id_rk >) data = r.json()['response']
Вот, как выглядит объект data : нам вернулся обычный список словарей, с которым мы уже имели дело в материале “Передаём и анализируем собранные данные по рекламным капманиям в Redash”.

Заполняем словарь ad_campaign_dict . Ключом будет ID объявления, а значением — ID кампании, к которой принадлежит объявление. Так будет удобнее присваивать к объявлению ID кампании, к которой оно принадлежало.
ad_campaign_dict = <> for i in range(len(data)): ad_campaign_dict[data[i]['id']] = data[i]['campaign_id']Теперь, имея ID каждого нужного объявления, можно обратиться к методу ads.getStatistics . Мы будем собирать количество просмотров, кликов, затрат и даты начала и конца объявления, поэтому заблаговременно заведём пустые списки.
ads_campaign_list = [] ads_id_list = [] ads_impressions_list = [] ads_clicks_list = [] ads_spent_list = [] ads_day_start_list = [] ads_day_end_list = []Вызывать getStatistics нужно отдельно для каждого объявления — будем делать это в итераторе по ad_campaign_dict . Отправляем запрос, передавая в ‘period’ значение ‘overall’ — берём данные за всё время. У некоторых объявлений могут отсутствовать данные по полю «Просмотры» или «Клики» если они не были запущены, и, потребовав их, мы словим KeyError — во избежание этого добавим обработчик try — except , который заставит скрипт не обращать внимания на эту ошибку.
for ad_id in ad_campaign_dict: r = requests.get('https://api.vk.com/method/ads.getStatistics', params=< 'access_token': token, 'v': version, 'account_id': id_rk, 'ids_type': 'ad', 'ids': ad_id, 'period': 'overall', 'date_from': '0', 'date_to': '0' >) try: data_stats = r.json()['response'] for i in range(len(data_stats)): for j in range(len(data_stats[i]['stats'])): ads_impressions_list.append(data_stats[i]['stats'][j]['impressions']) ads_clicks_list.append(data_stats[i]['stats'][j]['clicks']) ads_spent_list.append(data_stats[i]['stats'][j]['spent']) ads_day_start_list.append(data_stats[i]['stats'][j]['day_from']) ads_day_end_list.append(data_stats[i]['stats'][j]['day_to']) ads_id_list.append(data_stats[i]['id']) ads_campaign_list.append(ad_campaign_dict[ad_id]) except KeyError: continueТеперь сформируем из списков DataFrame и выведем первые 5 элементов:
df = DataFrame() df['campaign_id'] = ads_campaign_list df['ad_id'] = ads_id_list df['impressions'] = ads_impressions_list df['clicks'] = ads_clicks_list df['spent'] = ads_spent_list df['day_start'] = ads_day_start_list df['day_end'] = ads_day_end_list print(df.head())
Экспорт данных в Google Docs
Для экспорта DataFrame в таблицу Google Sheets необходим ключ доступа Google API. Пройдём по https://console.developers.google.com и создадим новый проект. Даём ему любое имя и в Dashboard жмём на кнопку “Подключить API и сервисы”. Нужно включить два API — Google Drive API и Google Sheets API. Ищем первый в поиске, нажимаем на “Включить API”, затем ищем второй и проделываем то же самое.

После включения нас отправят на панель управления API. Жмём на «Создать учётные данные» — по ним будем проводить авторизацию в скрипте. Отмечаем, что используем Google Sheets API из веб-сервера и обращаемся к данным пользователя. Нажимаем на «Выбрать тип учётных данных» и создаем сервисный аккаунт. В поле «Роль» выбираем Проект — Редактор, а тип ключа оставим JSON.

После этого нам отправят файл в формате JSON с нашими учетными данными — назовём его «credentials.json» — и перенаправят на страницу с сервисными аккаунтами. Ниже будет поле с почтой — копируем её себе.

Переходим по https://docs.google.com/spreadsheets и создаем пустой файл с названием data , в который будут отправляться данные из DataFrame. В настройках доступа даём доступ по почте, скопированной ранее из сервисных аккаунтов — от неё будут приходить данные из скрипта.
Закинем файл credentials.json в директорию со скриптом и продолжим писать код. Перечисляем область видимости в виде ссылок:
scope = ['https://spreadsheets.google.com/feeds', 'https://www.googleapis.com/auth/drive']И при помощи библиотек oauth2client и gspread проводим авторизацию методами ServiceAccountCredentials.from_json_keyfile_name и gspread.authorize , указывая в параметрах первого наш файл и переменную scope. Через переменную sheet будем обращаться к нашему файлу в Google Docs.
creds = ServiceAccountCredentials.from_json_keyfile_name('credentials.json', scope) client = gspread.authorize(creds) sheet = client.open('data').sheet1Для ввода значений в ячейку таблички есть метод update_cell . Важно: нумерация индексов ячеек при обращении начинается не с нуля, а с единицы. Первым циклом пройдём по первой строке и перенесем туда заголовки нашего DataFrame. Во втором будем идти по каждой ячейке и вставлять соответствующие значения DataFrame. По умолчанию стоит ограничение — 100 запросов в 100 секунд. Это ограничение может остановить наш скрипт на полпути: чтобы избежать ошибки пропишем time.sleep , чтобы после каждой вставки скрипт секунду выжидал.
count_of_rows = len(df) count_of_columns = len(df.columns) for i in range(count_of_columns): sheet.update_cell(1, i + 1, list(df.columns)[i]) for i in range(1, count_of_rows + 1): for j in range(count_of_columns): sheet.update_cell(i + 1, j + 1, str(df.iloc[i, j])) time.sleep(1)Если всё сделаем правильно — получим таблицу такого вида:

Экспорт данных в Redash
Подключение Google Analytics к Redash описано в статье «Как подключить Google Analytics как Redash?».
Имея в Redash таблицу с Google Analytics и рекламным кампаниям ВКонтакте, можем сопоставить их друг другу. Напишем такой запрос:
SELECT query_50.day_start, CASE WHEN ga_source LIKE '%vk%' THEN 'vk.com' END AS source, query_50.spent, query_50.impressions, query_50.clicks, SUM(query_49.ga_sessions) AS sessions, SUM(query_49.ga_newUsers) AS users FROM query_49 JOIN query_50 ON query_49.ga_date = query_50.day_start WHERE query_49.ga_source LIKE '%vk%' AND DATE(query_49.ga_date) BETWEEN '2020-05-16' AND '2020-05-20' GROUP BY query_49.ga_date, sourcega_source — источник, с которого человек пришел на сайт. Всё, что похоже на vk оператором CASE объединяем в столбец «vk.com». Оператором JOIN добавляем таблицу с данными из ВКонтакте, объединяя по полю даты. Отсеиваем данные — возьмём день последней рекламной кампании и посмотрим на несколько дней после него. На выходе получим таблицу такого вида:

Итоги
Получилась таблица, сообщающая, сколько всего было затрачено на объявления в этот день, сколько человек его посмотрели, зашли к нам на сайт и стали нашими новыми пользователями.