
Как работает группировка в sql
Конструкция GROUP BY в команде выборки позволяет разделить записи БД слоя на группы. Группировка записей может выполняться по значениям одного или нескольких полей записей, либо на основании значений столбцов таблицы результатов выборки.
Формат конструкции: GROUP BY | . При задании названии полей данных группировка выполняется по полям данных таблицы, если же номера столбцов — то по номерам столбцов выводимой таблицы (нумерация столбцов начинается с 1).
В команде выборки конструкция GROUP BY размещается непосредственно после конструкции WHERE , перед HAVING и ORDER .
Группировка записей всегда используется совместно с агрегирующими функциями. В таком случае агрегирующие функции применяются отдельно к каждой группе записей. Например, при группировке записей слоя Здания по полю Улица , все записи БД слоя будут разбиты на несколько групп, в каждой группе записи с одинаковой улицей. И, при применении функции COUNT в таком запросе, будет выведено количество записей в каждой группе.
Группировка одновременно может выполняться по нескольким полям (столбцам). Поля (столбцы) группировки перечисляются через запятую, после слов GROUP BY . Группировка сначала выполняется по первому полю, затем, уже сгруппированные записи разбиваются на подгруппы по второму полю и т.д.
При использовании в запросе группировки, среди выводимых столбцов выборки могут задаваться агрегирующие функции, и поля записей по которым выполняется группировка, либо выражения включающие эти поля.
Пример группировки записей
Группировка по полю данных
SELECT Улица, COUNT(*) FROM Здания GROUP BY Улица
Выводит список улиц и для каждой улицы количества записей.
Группировка по номеру столбца
SELECT FLOOR(Area/10)*10, SUM(Area) FROM Здания GROUP BY 1
Группирует записи по площади домов (с шагом 10, в первой группе с 0 до 10, во второй с 10 до 20 и т.д.) и выводит список групп площадей суммарную площадь для каждой группы.
Группировка по нескольким полям
SELECT COUNT(*) FROM Здания GROUP BY Квартал, Улица
Группирует записи по кварталам, а в кварталах по улицам и выводит количество записей для каждой подгруппы.
Как работает группировка в sql
Для группировки данных в T-SQL применяются операторы GROUP BY и HAVING , для использования которых применяется следующий формальный синтаксис:
SELECT столбцы FROM таблица [WHERE условие_фильтрации_строк] [GROUP BY столбцы_для_группировки] [HAVING условие_фильтрации_групп] [ORDER BY столбцы_для_сортировки]
GROUP BY
Оператор GROUP BY определяет, как строки будут группироваться.
Например, сгруппируем товары по производителю
SELECT Manufacturer, COUNT(*) AS ModelsCount FROM Products GROUP BY Manufacturer
Первый столбец в выражении SELECT — Manufacturer представляет название группы, а второй столбец — ModelsCount представляет результат функции Count, которая вычисляет количество строк в группе.
Стоит учитывать, что любой столбец, который используется в выражении SELECT (не считая столбцов, которые хранят результат агрегатных функций), должны быть указаны после оператора GROUP BY. Так, например, в случае выше столбец Manufacturer указан и в выражении SELECT, и в выражении GROUP BY.
И если в выражении SELECT производится выборка по одному или нескольким столбцам и также используются агрегатные функции, то необходимо использовать выражение GROUP BY. Так, следующий пример работать не будет, так как он не содержит выражение группировки:
SELECT Manufacturer, COUNT(*) AS ModelsCount FROM Products
Другой пример, добавим группировку по количеству товаров:
SELECT Manufacturer, ProductCount, COUNT(*) AS ModelsCount FROM Products GROUP BY Manufacturer, ProductCount
Оператор GROUP BY может выполнять группировку по множеству столбцов.
Если столбец, по которому производится группировка, содержит значение NULL, то строки со значением NULL составят отдельную группу.
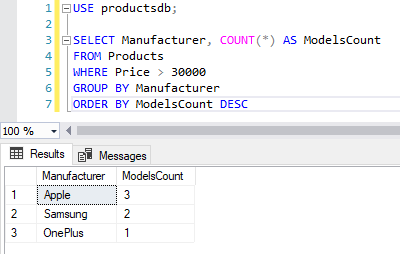
Следует учитывать, что выражение GROUP BY должно идти после выражения WHERE , но до выражения ORDER BY :
SELECT Manufacturer, COUNT(*) AS ModelsCount FROM Products WHERE Price > 30000 GROUP BY Manufacturer ORDER BY ModelsCount DESC
Фильтрация групп. HAVING
Оператор HAVING определяет, какие группы будут включены в выходной результат, то есть выполняет фильтрацию групп.
Применение HAVING во многом аналогично применению WHERE. Только есть WHERE применяется к фильтрации строк, то HAVING используется для фильтрации групп.
Например, найдем все группы товаров по производителям, для которых определено более 1 модели:
SELECT Manufacturer, COUNT(*) AS ModelsCount FROM Products GROUP BY Manufacturer HAVING COUNT(*) > 1
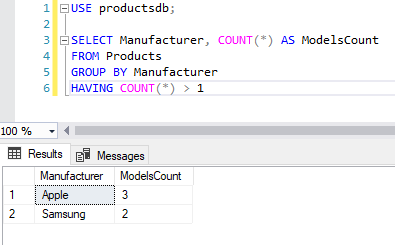
При этом в одной команде мы можем использовать выражения WHERE и HAVING:
SELECT Manufacturer, COUNT(*) AS ModelsCount FROM Products WHERE Price * ProductCount > 80000 GROUP BY Manufacturer HAVING COUNT(*) > 1
То есть в данном случае сначала фильтруются строки: выбираются те товары, общая стоимость которых больше 80000. Затем выбранные товары группируются по производителям. И далее фильтруются сами группы — выбираются те группы, которые содержат больше 1 модели.
Если при этом необходимо провести сортировку, то выражение ORDER BY идет после выражения HAVING:
SELECT Manufacturer, COUNT(*) AS Models, SUM(ProductCount) AS Units FROM Products WHERE Price * ProductCount > 80000 GROUP BY Manufacturer HAVING SUM(ProductCount) > 2 ORDER BY Units DESC
В данном случае группировка идет по производителям, и также выбирается количество моделей для каждого производителя (Models) и общее количество всех товаров по всем этим моделям (Units). В конце группы сортируются по количеству товаров по убыванию.
Оператор SQL GROUP BY для группировки в запросах
Оператор SQL GROUP BY служит для распределения строк — результата запроса — по группам, в которых значения некоторого столбца, по которому происходит группировка, являются одинаковыми. Группировку можно производить как по одному столбцу, так и по нескольким.
Часто оператор SQL GROUP BY применяется вместе с агрегатными функциями (COUNT, SUM, AVG, MAX, MIN). В этих случаях агрегатные функции служат для вычисления соответствующего агрегатного значения ко всему набору строк, для которых некоторый столбец — общий.
Оператор GROUP BY имеет следующий синтаксис:
SELECT ИМЕНА_СТОЛБЦОВ FROM ИМЯ_ТАБЛИЦЫ [ WHERE УСЛОВИЕ] GROUP BY ИМЕНА_СТОЛБЦОВ
Группировка по одному столбцу без агрегатных функций
Если в результате запроса требуется вывести один столбец и по этому же столбцу производится группировка, то оператор GROUP BY просто выбирает уникальные значения и убирает дубликаты, то есть выполняет те же задачи, что и ключевое слово DISTINCT.
Если вы хотите выполнить запросы к базе данных из этого урока на MS SQL Server, но эта СУБД не установлена на вашем компьютере, то ее можно установить, пользуясь инструкцией по этой ссылке .
Скрипт для создания базы данных библиотеки, её таблиц и заполения таблиц данными — в файле по этой ссылке .
В примерах работаем с базой данных библиотеки и ее таблицей «Книга в пользовании» (Bookinuse). Отметим, что оператор GROUP BY ведёт себя несколько по-разному в MySQL и в MS SQL Server. Эти различия будут показаны на примерах.
| Author | Title | Pubyear | Inv_No | Customer_ID |
| Толстой | Война и мир | 2005 | 28 | 65 |
| Чехов | Вишневый сад | 2000 | 17 | 31 |
| Чехов | Избранные рассказы | 2011 | 19 | 120 |
| Чехов | Вишневый сад | 1991 | 5 | 65 |
| Ильф и Петров | Двенадцать стульев | 1985 | 3 | 31 |
| Маяковский | Поэмы | 1983 | 2 | 120 |
| Пастернак | Доктор Живаго | 2006 | 69 | 120 |
| Толстой | Воскресенье | 2006 | 77 | 47 |
| Толстой | Анна Каренина | 1989 | 7 | 205 |
| Пушкин | Капитанская дочка | 2004 | 25 | 47 |
| Гоголь | Пьесы | 2007 | 81 | 47 |
| Чехов | Избранные рассказы | 1987 | 4 | 205 |
| Пушкин | Сочинения, т.1 | 1984 | 6 | 47 |
| Пастернак | Избранное | 2000 | 137 | 18 |
| Пушкин | Сочинения, т.2 | 1984 | 8 | 205 |
| NULL | Наука и жизнь 9 2018 | 2019 | 127 | 18 |
| Чехов | Ранние рассказы | 2001 | 171 | 31 |
Пример 1. Вывести авторов выданных книг, сгруппировав их. Пишем следующий запрос:
SELECT Author FROM BOOKINUSE GROUP BY Author
Этот запрос вернёт следующий результат:
| Author |
| NULL |
| Гоголь |
| Ильф и Петров |
| Маяковский |
| Пастернак |
| Пушкин |
| Толстой |
| Чехов |
Как видим, в таблице стало меньше строк, так как фамилии авторов остались каждая по одной.
В следующем примере увидим, что оператор GROUP BY не следует путать с оператором ORDER BY и поймём, чем эти операторы отличаются друг от друга.
Пример 2. Вывести авторов и названия выданных книг, сгруппировав по авторам. Пишем следующий запрос, который допустим в MySQL:
SELECT Author, Title FROM Bookinuse GROUP BY Author
Этот запрос вернёт следующий результат:
| Author | Title |
| NULL | Наука и жизнь 9 2018 |
| Гоголь | Пьесы |
| Ильф и Петров | Двенадцать стульев |
| Маяковский | Поэмы |
| Пастернак | Доктор Живаго |
| Пушкин | Капитанская дочка |
| Толстой | Война и мир |
| Чехов | Вишнёвый сад |
Как видим, в таблице каждому автору соответствует лишь одна книга, причём та, которая в таблице BOOKINUSE является первой по порядку записей.
Если бы нам требовалось вывести все книги, причём авторы должны были бы следовать не «вразброс», а по порядку: сначала Гоголь и все его книги, затем другие авторы и все их книги, то мы применили бы не оператор GROUP BY, а оператор ORDER BY.
Группировка по нескольким столбцам без агрегатных функций
И всё же вывести все записи, соответствующие значению столбца, по которому происходит группировка, можно. Но в этом случае в результирующей таблице должен появиться ещё один столбец. Такой случай проиллюстирован в следующем примере.
Пример 3. Вывести авторов, названия выданных книг, ID пользователя и инвентарный номер выданной книги. Сгруппировать по авторам, ID пользователя и инвентарному номеру. На MySQL запрос будет следующим:
SELECT Author, Title, Customer_ID, Inv_no FROM Bookinuse GROUP BY Author, Customer_ID, Inv_no
Этот запрос вернёт следующий результат:
| Author | Title | Customer_ID | Inv_no |
| Гоголь | Пьесы | 47 | 81 |
| Ильф и Петров | Двенадцать стульев | 31 | 3 |
| Маяковский | Поэмы | 120 | 2 |
| Пастернак | Избранное | 18 | 137 |
| Пастернак | Доктор Живаго | 120 | 69 |
| Пушкин | Капитанская дочка | 47 | 25 |
| Пушкин | Сочинения, т.1 | 47 | 6 |
| Пушкин | Сочинения, т.2 | 205 | 8 |
| Толстой | Воскресенье | 47 | 77 |
| Толстой | Война и мир | 65 | 28 |
| Толстой | Анна Каренина | 205 | 7 |
| Чехов | Вишневый сад | 31 | 19 |
| Чехов | Ранние рассказы | 31 | 171 |
| Чехов | Вишневый сад | 65 | 5 |
| Чехов | Избранные рассказы | 120 | 19 |
| Чехов | Избранные рассказы | 205 | 4 |
Как видим, в результирующей таблице присутствуют все книги всех авторов, причём авторы следуют по порядку, как если бы мы применили оператор ORDER BY. Кроме того, видно, что записи сгруппированы и по второму указанному столбцу — Customer_ID. Так, у автора Пушкина сначала перечисляются книги, выданные пользователю с Customer_ID 47, а затем — 205. У автора Чехова сначала перечисляются книги, выданные пользователю с Customer_ID 31, а затем — с другими номерами. Третий столбец, по которому происходит группировка — Inv_no — добавлен только для того, чтобы в результирующей таблице выводились все строки, соответствующие значениям ранее перечисленных столбцов для группировки, а не только уникальные.
По-другому ведёт себя оператор GROUP BY в MS SQL Server и в случае этого запроса.
- Группировка по одному столбцу без агрегатных функций
- Группировка по нескольким столбцам без агрегатных функций
- Группировка с агрегатными функциями
- Особенности применения группировки в MS SQL Server
SQL-Урок 8. Группировка данных (GROUP BY)
Группировка данных позволяет разделить все данные на логические наборы, благодаря чему становится возможным выполнение статистических вычислений по отдельности в каждой группе.
1. Создание групп (GROUP BY)
Группы создаются с помощью инструкции GROUP BY оператора SELECT. Рассмотрим на примере.
Run SQLSELECT Product, SUM(Quantity) AS Product_num FROM Sumproduct GROUP BY Product
Try it Yourself
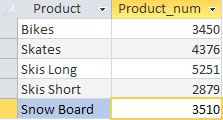
Данным запросом мы извлекли информацию о количестве реализуемой продукции в каждом месяце. Оператор SELECT приказывает вывести два столбца Product – название продукта и Product_num – расчетное поле, которое мы создали для отображения количества реализуемой продукции (формула поля SUM(Quantity)). Предложение GROUP BY указывает СУБД сгруппировать данные по столбцу Product.
Следует также отметить, что GROUP BY должно идти после предложения WHERE и перед ORDER BY.
2. Фильтрующие группы (HAVING)
Так же, как мы фильтровали строки в таблице, мы можем производить фильтрацию по сгруппированным данным. Для этого в SQL существует оператор HAVING. Возьмем предыдущий пример и добавим фильтрацию по группам.
Run SQLSELECT Product, SUM(Quantity) AS Product_num FROM Sumproduct GROUP BY Product HAVING SUM(Quantity) > 4000
Try it Yourself
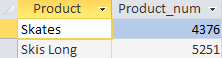
Видим, что после того, как было сочтено количество реализованного товара в разрезе каждого продукта, СУБД «отрубила» те продукты, которых было реализовано менее 4000 шт.
Как видим, оператор HAVING очень подобен оператору WHERE, однако между собой они имеют существенное отличие: WHERE фильтрует данные до того, как они будут сгруппированы, а HAVING — осуществляет фильтрацию после группировки. Таким образом, строки, которые были удалены предложением WHERE, не будут включены в группу. Итак, операторы WHERE и HAVING могут использоваться в одном предложении. Рассмотрим пример:
Run SQLSELECT Product, SUM(Quantity) AS Product_num FROM Sumproduct WHERE Product <> 'Skis Long' GROUP BY Product HAVING SUM(Quantity) > 4000
Try it Yourself
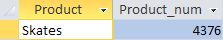
Мы к предыдущему примеру добавили оператор WHERE, где указали товар «Skis Long», что в свою очередь повлияло на группировку оператором HAVING. Как результат мы видим, что товар «Skis Long» не попал в перечень групп с количеством реализованной продукции более 4000 шт.
3. Группировка и сортировка
Как и при обычной выборке данных, мы можем отсортировать группы после группировки оператором HAVING. Для этого мы можем использовать уже знакомый нам оператор ORDER BY. В данной ситуации его применение аналогично предыдущим примерам. К примеру:
Run SQLSELECT Product, SUM(Quantity) AS Product_num FROM Sumproduct GROUP BY Product HAVING SUM(Quantity) > 3000 ORDER BY SUM(Quantity)
Try it Yourself
или просто укажем номер поля по порядку, по которому хотим посортировать:
Run SQLSELECT Product, SUM(Quantity) AS Product_num FROM Sumproduct GROUP BY Product HAVING SUM(Quantity) > 3000 ORDER BY 2
Try it Yourself
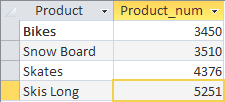
Видим, что для сортировки сводных результатов нам нужно просто прописать предложение из ORDER BY после оператора HAVING.
MS Access не поддерживает сортировку групп по псевдонимам колонок, то есть в нашем примере, чтобы посортировать значения, мы не сможем в конце запроса прописать ORDER BY Product_num.
- Изменение регистра букв в тексте
- Сумма прописью на украинском языке
- Поиск латиницы в кириллице и наоборот
- Транслитерация с украинского на английский