
Как сделать распараллеливание программы на GPU с использованием OpenAcc?
Как правильно сделать это? При компиляции делаю так: g++ -std=c++0x /* . */ -fopenmp -fopenacc Перед данным циклом поставил #pragma acc parallel — но ничего не работает. Компилится все без проблем, но работает в 1 CPU ядро. В самом начале заголовки подключил #include
C openmp использовал что-то вроде этого: #pragma omp parallel for reduction(+:similarity) num_threads(use_threads) Как заставить это пахать юзая GPU? Спасибо!
Отслеживать
задан 25 янв 2018 в 13:45
25 3 3 бронзовых знака
в теме Вы пишете «распараллелить на GPU«, а жалуетесь, что работает только на одном ядре CPU. Это же очевидно.
25 янв 2018 в 14:09
@KoVadim так я говорю о том что мне нужно обеспечить работу на GPU, а #pragma от ACC не работает, вот как ее настроить меня интересует.
25 янв 2018 в 14:16
а вот этого мы не знаем. может оно и грузит gpu.надо смотреть, грузит ли оно gpu. А cpu при этом может и не грузится
25 янв 2018 в 14:18
@KoVadim как лучше всего это делать, у меня Ubuntu 17.04? Просто задача выполняется очень долго, и я прикинул что все считается на gpu (прироста в производительности нет вообще, ну по времени)
25 янв 2018 в 14:51
думаю, надо начать с этого docs.computecanada.ca/wiki/OpenACC_Tutorial_-_Optimizing_loops (там есть ссылка на то, что есть профайлер от nvidia, который поможет)
25 янв 2018 в 14:56
1 ответ 1
Сортировка: Сброс на вариант по умолчанию
Поддержка OpenACC в gcc пока в экспериментальном состоянии. На данный момент(gcc-7.2) формально поддерживыется спецификация OpenACC-2.0a с двумя backend’ами: fallback для обычного выполнения в один поток на CPU и для устройств NVIDIA, nvptx. Последний требует отдельной самостоятельной (можно уже в принципе найти и пакеты) сборки двух компиляторов: разгрузочного(offloading), который генерирует ассемблерный код nvptx, и [пере]сборка хостового с поддержкой разгрузки. Пока что поддерживается генерация кода только для sm30(CUDA-3.0) (старшие версии обратно совместимы). В экспериментальной ветке ведётся работа над поддержкой sm35.
На сколько я знаю, единственным полноценным компилятором на сегодня для OpenACC является проприетарный PGI. Правда, если верить enSO, поддержку AMD из последних версий выкинули, так что придётся пользоваться веткой 16.x.
Код в первом приближении будет такой же простой, как и для OpenMP:
#pragma acc parallel loop reduction(+:similarity) for (int y = m; y < d; y++) < float local_sim = 0; for (int x = m; x < k; x++) < local_sim += func(x, y); >similarity += local_sim; > Отслеживать
ответ дан 25 янв 2018 в 18:39
23.1k 1 1 золотой знак 18 18 серебряных знаков 37 37 бронзовых знаков
Спасибо большое!
26 янв 2018 в 7:33
Т.е на amd, даже если будет параллелизм все будет на CPU выполняться??
26 янв 2018 в 17:46
@EKRE, если найдёшь компилятор, который будет генерировать код для amd карт, то он будет выгружен на GPU. Про то что старых версий PGI нет в открытом доступе я судя по всему наврал. И да, реальный директивы необходимые чтобы получить хороший прирост производительности будут, вероятно, сложнее.
Что такое CUDA
В статье мы подробно рассмотрим CUDA — что это за технология, как работает и в каких областях её можно использовать.
Облачные вычисления на базе GPU
Команда Рег.ру запустила облачные серверы на GPU. Вы можете самостоятельно испытать мощность нашего оборудования, которое заточено для Machine Learning и высокопроизводительных вычислений.
Что такое CUDA
CUDA (англ. Compute Unified Device Architecture) — это технология на базе программно-аппаратной архитектуры, которая позволяет повысить производительность параллельных вычислений. Параллельные вычисления — это вычисления, при которых процесс разработки программного обеспечения делится на потоки. Потоки обрабатываются параллельно и взаимодействуют между собой в процессе обработки. Это возможно благодаря процессорам компании NVIDIA, на которых построена работа CUDA. В их основе лежит технология GPGPU.
Прежде чем разобраться, в чём особенность этой технологии, посмотрим, какие бывают типы процессоров и как они работают.
Основные типы процессоров
CPU (англ. Central Processing Unit) — это центральный процессор, который ориентирован на обработку данных в максимально короткие сроки. Работает по следующему принципу: разбивает одну задачу на несколько потоков, каждый из которых обрабатывается отдельно. Затем эти потоки вновь объединяются и выстраиваются в нужном порядке. Такой подход позволяет увеличить скорость последовательной обработки задач. Подробнее читайте в статье Что такое процессор CPU.
GPU (англ. Graphics Processing Unit) — это специальный графический процессор, который заточен на обработку 2D или 3D-графики. Он размещается на видеокарте, что позволяет автоматически освободить основной процессор от лишней нагрузки при обработке данных. GPU состоит из нескольких тысяч ядер, которые в совокупности потребляют небольшое количество энергии. CUDA ядра «выигрывают» у CPU по производительности на 1 ватт потребляемой мощности.
На базе этих основных процессоров были разработаны различные специализированные инструменты. Например, технология GPGPU.
GPGPU (англ. General-purpose computing on graphics processing units) — это технология, которая позволяет использовать графический процессор GPU в операциях, которые обычно выполняет центральный процессор CPU. Например, в математических вычислениях. С помощью GPGPU можно использовать видеокарту для выполнения неграфических вычислений. При этом графический процессор будет работать не вместо центрального, а в качестве вычислительного блока.
CUDA является улучшенной вариацией GPGPU. Она позволяет работать на специальном диалекте — это значит, что программисты могут использовать алгоритмы, предназначенные для графических процессоров при обработке неспецифических задач. С помощью CUDA можно значимо ускорить процессы обработки. Например, можно сократить время ожидания конвертации видео до 20 раз, не задействуя основной процессор.
В каких областях можно использовать CUDA:
- вычислительная математика,
- физика,
- молекулярная биология,
- биоинформатика,
- финансовая аналитика,
- анализ баз данных,
- искусственный интеллект и другие.
В последнее время технология высокоскоростной обработки становится ближе к рядовому пользователю. Например, уже существуют плагины для Photoshop, которые используют мощности GPU. С другими программами и проектами можно познакомиться на официальном сайте.
История возникновения
Первые попытки использовать графические ускорители для нецелевых вычислений предпринимались еще с конца 90-х годов. Однако масштабная работа в этом направлении началась немного позже. В начале 2000-х годов два основных лидера в мире процессоров — компании AMD и Intel – решили побороться за производство самого мощного «мозга» компьютера. В период жесткой конкуренции производителям удалось значимо поднять планку обработки процессорами тактовых частот (например, в промежуток между 2001-м и 2003-м годом частоты подросли с 1,5 до 3 ГГц).
Вместе с этим разработчики из Стенфордского университета поставили перед собой конкретную цель — создать графический адаптер, который позволит проводить неграфические вычисления. Так появился Brook — специализированный язык программирования и реализации. Затем были запущены аналогичные проекты: библиотека Accelerator, Brahma, GPU++ и другие.
Немногим позже к исследовательской работе присоединился лидер индустрии NVIDIA. Компания решила разработать собственные программные платформы и видеокарты для неграфических вычислений. Так появилась CUDA.
NVIDIA СUDA toolkit
Архитектура
Архитектура CUDA базируется на взаимодействии между CPU и GPU процессорами. Это возможно благодаря работе шейдера — программы для исполнения видеокарты процессорами.
Взаимодействие происходит с помощью разноуровневых API. API на первом уровне — Runtime. Он позволяет сделать первичную разбивку задачи на потоки. Затем эти декомпозированные потоки переходят на второй уровень API — Driver. При этом работу API поддерживают библиотеки NVIDIA — Libraries CUBLAS (для алгебраических расчётов) и FFT (расчёт по алгоритму ускоренного вычисления Фурье).
Если говорить максимально упрощенно, то работа алгоритма CUDA выглядит следующим образом:
- Центральный процессор выделяет нужное количество памяти и отправляет её графическому процессору.
- Центральный процессор запускает ядро и также «делится» им с графическим.
- Графический процессор выполняет операции используя память и мощности ядра.
- После обработки данных центральный процессор принимает результаты.
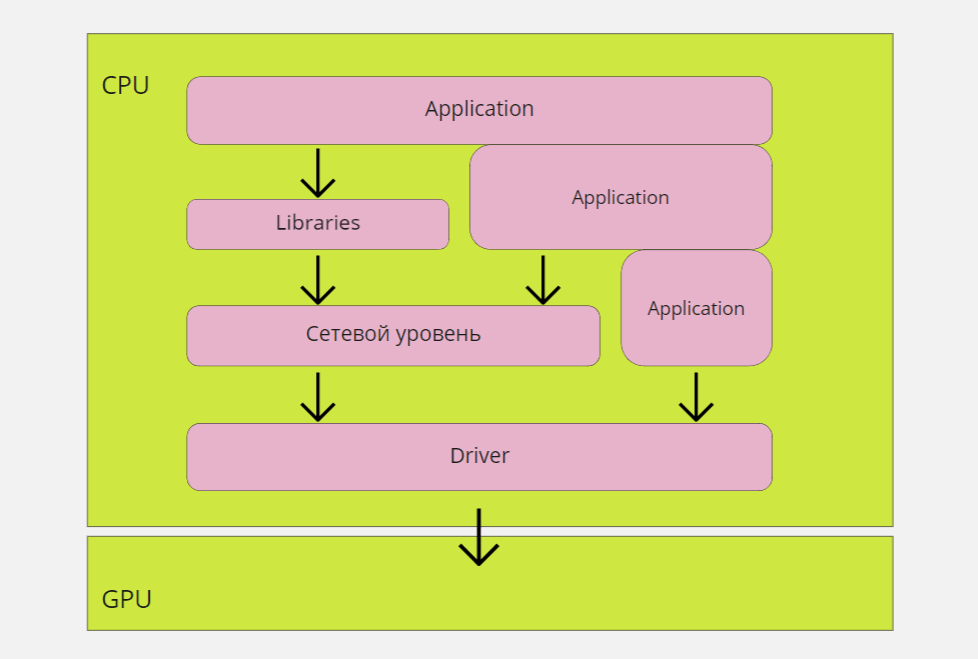
Взаимодействие CPU и GPU
Характеристики и среда разработки CUDA:
- компилятор nvcc,
- отладчик gdb для GPU,
- профилировщик,
- библиотеки численного анализа FFT и BLAS,
- поддержка 32- и 64-битных операционных систем: Linux, macOS, Windows XP, Vista и других,
- поддержка языков программирования: Java, Python, C++, Си, Фортран и других.
Недостатки и преимущества CUDA
CUDA имеет преимущества не только перед вычислениями на CPU, но и перед более ранними технологиями вычисления с помощью GPGPU. Рассмотрим, в чём они заключаются.
Преимущества
- Простой в применении интерфейс программирования на С,
- поддержка CUDA: битовые и целочисленные операции проводятся на аппаратном уровне, не требуя переноса алгоритмов в удобный для концепции графического конвейера вид,
- не ограничена графическими API,
- адресация памяти gather и scatter в линейном порядке,
- эффективный взаимообмен между видеопамятью и системной памятью,
- память размером 16 Кб на мультипроцессор: её можно разделить на потоки и настроить кеш с широкой полосой пропускания.
Как любая технология, CUDA имеет нюансы применения и ограничения.
Ограничения
- CUDA имеет архитектуру с закрытым исходным кодом, которым владеет NVIDIA,
- архитектура работает только на видеочипах компании NVIDIA, начиная с версии GeForce 8,
- для выполняемых функций нет поддержки рекурсии,
- 32 потока — минимально возможная ширина блока.
Несмотря на все достоинства этой технологии, нельзя сказать, что параллельные вычисления полностью заменят классические. Современный центральный процессор заточен под обработку целочисленных данных и данных с плавающей запятой в максимально короткие сроки. В то же время архитектура видеокарты позволяет быстро и без проблем «распараллелить» обработку данных. Поэтому CUDA — это скорее эффективный и необходимый инструментарий для конкретных областей применения.
Теперь вы знаете, что такое и для чего нужна CUDA, а также как устроена архитектура этой технологии.
Помогла ли вам статья?
Спасибо за оценку. Рады помочь ��
Python в три ручья: работаем с потоками (часть 1)
В каких случаях вам нужна многопоточность, как реализовать её на Python и что нужно знать о глобальной блокировке GIL.
04 мая 2018 8 минут 272691

Автор статьи
Мария Лисянская
Автор статьи
Мария Лисянская
https://gbcdn.mrgcdn.ru/uploads/post/1582/og_cover_image/b8f59e927c66e03053113b8036b95103

Из этой статьи вы узнаете, как с Python выполнять несколько операций одновременно и распределять нагрузку между ядрами процессора, какие особенности языка учитывать. Но главное — поймете, когда многопоточность в Python нужна, а когда только мешает.
Небольшое предупреждение для тех, кто впервые слышит о параллельных вычислениях. Что такое поток и чем он отличается от процесса, мы выяснили в статье «Внутри процесса: многопоточность и пинг-понг mutex’ом». Тогда мы приводили примеры на Java, но теоретические основы многопоточности верны и для Python. Совпадают, в том числе, механизмы синхронизации потоков: семафоры, взаимные исключения (mutex), условия, события. Поэтому сегодня сделаем акцент на особенностях Python, его механизмах и инструментах, связанных с многопоточностью.
Организовать параллельные вычисления в Python без внешних библиотек можно с помощью модулей:
- threading — для управления потоками.
- queue — для организации очередей.
- multiprocessing — для управления процессами.
Пока нас интересует только первый пункт списка.
Как создавать потоки в Python
Метод 1 — «функциональный»
Для работы с потоками из модуля threading импортируем класс Thread. В начале кода пишем:
from threading import Thread
После этого нам будет доступна функция Thread() — с ней легко создавать потоки. Синтаксис такой:
variable = Thread(target=function_name, args=(arg1, arg2,))
Первый параметр target — это «целевая» функция, которая определяет поведение потока и создаётся заранее. Следом идёт список аргументов. Если судьбу аргументов (например, кто будет делимым, а кто делителем в уравнении) определяет их позиция, их записывают как args=(x,y). Если же вам нужны аргументы в виде пар «ключ-значение», используйте запись вида kwargs=.
Ради удобства отладки можно также дать новому потоку имя. Для этого среди параметров функции прописывают name=«Имя потока». По умолчанию name хранит значение null. А ещё потоки можно группировать с помощью параметра group, который по умолчанию — None.
За дело! Пусть два потока параллельно выводят каждый в свой файл заданное число строк. Для начала нам понадобится функция, которая выполнит задуманный нами сценарий. Аргументами целевой функции будут число строк и имя текстового файла для записи.
#coding: UTF-8 from threading import Thread def prescript(thefile, num): with open(thefile, 'w') as f: for i in range(num): if num > 500: f.write('МногоБукв\n') else: f.write('МалоБукв\n') thread1 = Thread(target=prescript, args=('f1.txt', 200,)) thread2 = Thread(target=prescript, args=('f2.txt', 1000,)) thread1.start() thread2.start() thread1.join() thread2.join()
Что start() запускает ранее созданный поток, вы уже догадались. Метод join() останавливает поток, когда тот выполнит свои задачи. Ведь нужно закрыть открытые файлы и освободить занятые ресурсы. Это называется «Уходя, гасите свет». Завершать потоки в предсказуемый момент и явно — надёжнее, чем снаружи и неизвестно когда. Меньше риск, что вмешаются случайные факторы. В качестве параметра в скобках можно указать, на сколько секунд блокировать поток перед продолжением его работы.
Метод 2 — «классовый»
Для потока со сложным поведением обычно пишут отдельный класс, который наследуют от Thread из модуля threading. В этом случае программу действий потока прописывают в методе run() созданного класса. Ту же петрушку мы видели и в Java.
#coding: UTF-8 import threading class MyThread(threading.Thread): def __init__(self, num): super().__init__(self, name="threddy" + num) self.num = num def run(self): print ("Thread ", self.num), thread1 = MyThread("1") thread2 = MyThread("2") thread1.start() thread2.start() thread1.join() thread2.join()
Стандартные методы работы с потоками

Чтобы управлять потоками, нужно следить, как они себя ведут. И для этого в threading есть специальные методы:
current_thread() — смотрим, какой поток вызвал функцию;
active_count() — считаем работающие в данный момент экземпляры класса Thread;
enumerate() — получаем список работающих потоков.
Ещё можно управлять потоком через методы класса:
is_alive() — спрашиваем поток: «Жив ещё, курилка?» — получаем true или false;
getName() — узнаём имя потока;
setName(any_name) — даём потоку имя;
У каждого потока, пока он работает, есть уникальный идентификационный номер, который хранится в переменной ident.
thread1.start() print(thread1.ident)
Отсрочить операции в вызываемых потоком функциях можно с помощью таймера. В инициализаторе объектов класса Timer всего два аргумента — время ожидания в секундах и функция, которую нужно в итоге выполнить:
import threading print ("Waiting. ") def timer_test(): print ("The timer has done its job!") tim = threading.Timer(5.0, timer_test) tim.start()
Таймер можно один раз создать, а затем запускать в разных частях кода.
Потусторонние потоки
Обычно Python-приложение не завершается, пока работает хоть один его поток. Но есть особые потоки, которые не мешают закрытию программы и останавливается вместе с ней. Их называют демонами (daemons). Проверить, является ли поток демоном, можно методом isDaemon(). Если является, метод вернёт истину.
Назначить поток демоном можно при создании — через параметр “daemon=True” или аргумент в инициализаторе класса.
thread0 = Thread(target=target_func, kwargs=10>, daemon=True)
Не поздно демонизировать и уже существующий поток методом setDaemon(daemonic).
Всё бы ничего, но это даже не верхушка айсберга, потому что прямо сейчас нас ждут великие открытия.
Приключение начинается. У древнего шлюза

Питон слывёт дружелюбным и простым в общении, но есть у него причуды. Нельзя просто взять и воспользоваться всеми преимуществами многопоточности в Python! Дорогу вам преградит огромный шлюз… Даже так — глобальный шлюз (Global Interpreter Lock, он же GIL), который ограничивает многопоточность на уровне интерпретатора. Технически, это один на всех mutex, созданный по умолчанию. Такого нет ни в C, ни в Java.
Задача шлюза — пропускать потоки строго по одному, чтоб не летали наперегонки, как печально известные стритрейсеры, и не создавали угрозу работе интерпретатора.
Без шлюза потоки подрезали бы друг друга, чтобы первыми добраться до памяти, но это еще не всё. Они имеют обыкновение внезапно засыпать за рулём! Операционная система не спрашивает, вовремя или невовремя — просто усыпляет их в ей одной известный момент. Из-за этого неупорядоченные потоки могут неожиданно перехватывать друг у друга инициативу в работе с общими ресурсами.
Дезориентированный спросонок поток, который видит перед собой совсем не ту ситуацию, при которой засыпал, рискует разбиться и повалить интерпретатор, либо попасть в тупиковую ситуацию (deadlock). Например, перед сном Поток 1 начал работу со списком, а после пробуждения не нашёл в этом списке элементов, т.к. их удалил или перезаписал Поток 2.
Чтобы такого не было, GIL в предсказуемый момент (по умолчанию раз в 5 миллисекунд для Python 3.2+) командует отработавшему потоку: «СПАААТЬ!» — тот отключается и не мешает проезжать следующему желающему. Даже если желающего нет, блокировщик всё равно подождёт, прежде чем вернуться к предыдущему активному потоку.

Благодаря шлюзу однопоточные приложения работают быстро, а потоки не конфликтуют. Но, к сожалению, многопоточные программы при таком подходе выполняются медленнее — слишком много времени уходит на регулировку «дорожного движения». А значит обработка графики, расчет математических моделей и поиск по большим массивам данных c GIL идут неприемлемо долго.
В статье «Understanding Python GIL»технический директор компании Gaglers Inc. и разработчик со стажем Chetan Giridhar приводит такой пример:
from datetime import datetime import threading def factorial(number): fact = 1 for n in range(1, number+1): fact *= n return fact number = 100000 thread = threading.Thread(target=factorial, args=(number,)) startTime = datetime.now() thread.start() thread.join() endTime = datetime.now() print "Время выполнения: ", endTime - startTime
Код вычисляет факториал числа 100 000 и показывает, сколько времени ушло у машины на эту задачу. При тестировании на одном ядре и с одним потоком вычисления заняли 3,4 секунды. Тогда Четан создал и запустил второй поток. Расчет факториала на двух ядрах длился 6,2 секунды. А ведь по логике скорость вычислений не должна была существенно измениться! Повторите этот эксперимент на своей машине и посмотрите, насколько медленнее будет решена задача, если вы добавите thread2. Я получила замедление ровно вдвое.
Глобальный шлюз — наследие времён, когда программисты боролись за достойную реализацию многозадачности и у них не очень получалось. Но зачем он сегодня, когда есть много- и очень многоядерные процессоры? Как объяснил Гвидо ван Россум, без GIL не будут нормально работать C-расширения для Python. Ещё упадёт производительность однопоточных приложений: Python 3 станет медленнее, чем Python 2, а это никому не нужно.
«Нормальные герои всегда идут в обход»

Шлюз можно временно отключить. Для этого интерпретатор Python нужно отвлечь вызовом функции из внешней библиотеки или обращением к операционной системе. Например, шлюз выключится на время сохранения или открытия файла. Помните наш пример с записью строк в файлы? Как только вызванная функция возвратит управление коду Python или интерфейсу Python C API, GIL снова включается.
Как вариант, для параллельных вычислений можно использовать процессы, которые работают изолированно и неподвластны GIL. Но это большая отдельная тема. Сейчас нам важнее найти решение для многопоточности.
Если вы собираетесь использовать Python для сложных научных расчётов, обойти скоростную проблему GIL помогут библиотеки Numba, NumPy, SciPy и др. Опишу некоторые из них в двух словах, чтобы вы поняли, стоит ли разведывать это направление дальше.
Numba для математики
Numba — динамически, «на лету» компилирует Python-код, превращая его в машинный код для исполнения на CPU и GPU. Такая технология компиляции называется JIT — “Just in time”. Она помогает оптимизировать производительность программ за счет ускорения работы циклов и компиляции функций при первом запуске.
Суть в том, что вы ставите аннотации (декораторы) в узких местах кода, где вам нужно ускорить работу функций.
Для математических расчётов библиотеку удобно использовать в связке c NumPy. Допустим, нужно сложить одномерные массивы — элемент за элементом.
def arr_sum (x , y): result_arr = nupmy.empty_like ( x) for i in range (len (x)) : result_arr [i ] = x[i ] + y[i ] return result_arr
Метод nupmy.empty_like() принимает массив и возвращает (но не инициализирует!) другой — соответствующий исходному по форме и типу. Чтобы ускорить выполнение кода, импортируем класс jit из модуля numba и добавляем в начало кода аннотацию @jit:
from numba import jit @jit def arr_sum(x,y):
Это скромное дополнение способно ускорить выполнение операции более чем в 100 раз! Если интересно, посмотрите замеры скорости математических расчётов при использовании разных библиотек для Python.
PyCUDA и Numba для графики
В графических вычислениях Numba тоже кое-что может. Она умеет работать с программной моделью CUDA, чтобы визуализировать научные данные и работу алгоритмов, выдавать информацию о GPU и др. Подробнее о том, как работают графический процессор и CUDA — здесь. И снова мы встретимся с многопоточностью.
При работе с многомерными массивами в CUDA, чтобы понять, какой поток сейчас работает с элементами массива, нужно отследить, кто и когда вызывает функцию ядра. Например, поток может определять свою позицию в сетке блоков и рассчитать соответствующий элемент массива:
from numba import cuda @cuda.jit def call_for_kernel(io_arr): # Идентификатор потока в одномерном блоке thread_x = cuda.threadIdx.x # Идентификатор блока в одномерной сетке thread_y = cuda.blockIdx.x # Число потоков на блок (т.е. ширина блока) block_width = cuda.blockDim.x # Находим положение в массиве t_position = thread_x + thread_y * block_width if t_position io_arr.size: # Убеждаемся, что не вышли за границы массива io_arr[ t_position] *= 2 # Считаем
Главный плюс этого кода даже не в скорости исполнения, а в прозрачности и простоте. Снова сошлюсь на Хабр, где есть сравнение скорости GPU-расчетов при использовании Numba, PyCUDA и эталонного С CUDA. Небольшой спойлер: PyCUDA позволяет достичь скорости вычислений, сопоставимой с Cи, а Numba подходит для небольших задач.
Когда многопоточность в Python оправдана

Стоит ли преодолевать связанные c GIL сложности и тратить время на реализацию многопоточности? Вот примеры ситуаций, когда многопоточность несёт с собой больше плюсов, чем минусов.
- Для длительных и несвязанных друг с другом операций ввода-вывода. Например, нужно обрабатывать ворох разрозненных запросов с большой задержкой на ожидание. В режиме «живой очереди» это долго — лучше распараллелить задачу.
- Вычисления занимают более миллисекунды и вы хотите сэкономить время за счёт их параллельного выполнения. Если операции укладываются в 1 мс, многопоточность не оправдает себя из-за высоких накладных расходов.
- Число потоков не превышает количество ядер. В противном случае параллельной работы всех потоков не получается и мы больше теряем, чем выигрываем.
Когда лучше с одним потоком

- При взаимозависимых вычислениях. Считать что-то в одном потоке и передавать для дальнейшей обработки второму — плохая идея. Возникает лишняя зависимость, которая приводит к снижению производительности, а в случае ошибки — к ступору и краху программы.
- При работе через GIL. Это мы уже выяснили выше.
- Когда важна хорошая переносимость на разных устройствах. Правильно подобрать число потоков для машины пользователя — задача не из легких. Если вы пишете под известное вам «железо», всё можно решить тестированием. Если же нет — понадобится дополнительно создавать гибкую систему подстройки под аппаратную часть, что потребует времени и умения.
Анонс — взаимные блокировки в Python
Самое смешное, что по умолчанию GIL защищает только интерпретатор и не предохраняет наш код от взаимных блокировок (deadlock) и других логических ошибок синхронизации. Поэтому разводить потоки по углам, как и в Java, нужно принудительно — с помощью блокирующих механизмов. Об этом и о не упомянутых в статье компонентах модуля threading мы поговорим в следующий раз.
Как GPU-вычисления буквально спасли меня на работе. Пример на Python
Сегодня мы затрагиваем актуальнейшую тему — Python для работы с GPU. Автор рассматривает пример, тривиальный в своей монструозности, и демонстрирует решение, сопровождая его обширными листингами. Приятного чтения!

Никого из нас в той или иной форме не обошел хайп вокруг GPU-вычислений, развернувшийся в последнее время. Прежде, чем вы станете читать далее, поясню: я не эксперт по GPU. Мой путь в мире GPU только начинается. Но эта технология сегодня достигла такой мощи, что, вооружившись ею, можно решать целую уйму задач. Мне на работе поручили задачу, на выполнение которой машина тратила целые часы, а прогресса так и не было видно. Но, стоило мне взяться за GPU – и проблема стала решаться за секунды. Задачу, на выполнение которой ориентировочно требовалось 2 суток, я смог решить всего за 20 секунд.
В следующих разделах я детально опишу эту задачу. Также мы обсудим, как и когда использовать GPU для решения любых подобных задач. Итак, читаем внимательно – поверьте, вы не пожалеете. Сначала мы вникнем в детали задачи, затем освоимся с GPU и, наконец, воспользуемся GPU для решения этой задачи. Я буду пользоваться библиотекой Python Numba и графическим процессором Nvidia Volta V100 16GB GPU.
1. Подробное описание задачи
В сфере розничной торговли часто приходится искать похожие или наиболее близкие объекты. Мне дали список позиций, каждая из которых была представлена k латентными атрибутами. Итак, мне было поручено найти топ-3 наиболее схожих позиций к каждой из позиций списка. Метрикой схожести в данной задаче было выбрано косинусное сходство. Вот как выглядели мои данные.
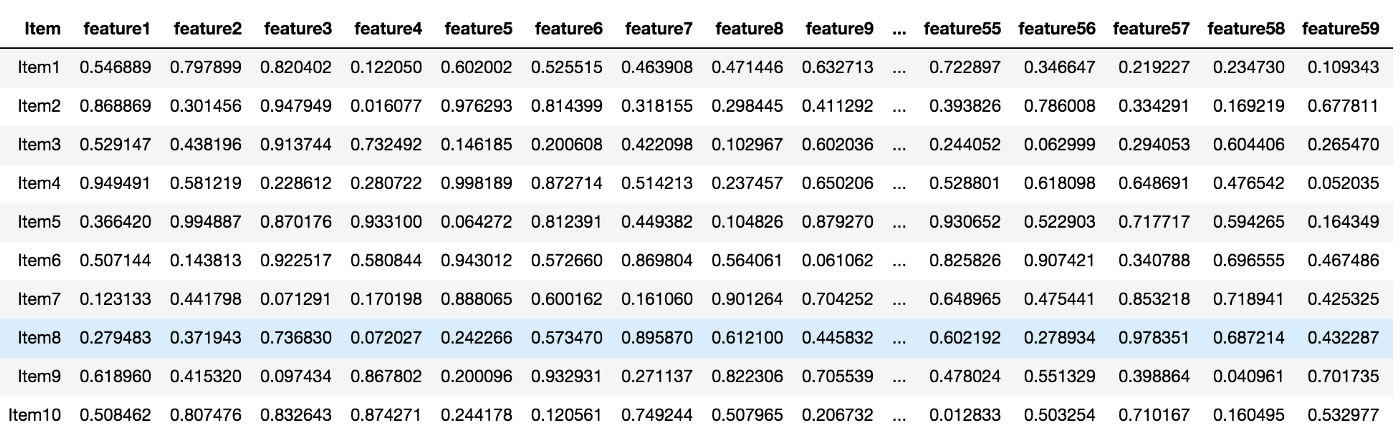
Список позиций данных с 64-латентными признаками
Сложность задачи
Мне дали список, в котором было около 10⁵ позиций. Поиск 3 наиболее схожих позиций для каждой из них потребовал бы проверить косинусное сходство с каждым без исключения элементов в списке. Получалось бы n * k операций, где n – количество позиций, а k – атрибуты на каждую позицию. Потребовалось бы получить скалярное произведение данной позиции с каждой из остальных позиций в списке.
def top_3_similar_items(X,mindex): # X это список позиций, нам требуется найти топ-3 позиций, наиболее похожих на позицию с индексом 'mindex' SMALL = -9999.0 # Просто для инициализации, поскольку нам нужно найти позицию с максимальным уровнем сходства(косинусный показатель) first_best_val = SMALL # индекс первой по схожести позиции будет храниться здесь first_best_index = -1 # косинусное сходство с первой по схожести позицией second_best_val = SMALL # индекс второй по схожести позиции будет храниться здесь second_best_index = -1 # косинусное сходство со второй по схожести позицией third_best_val = SMALL # индекс третьей по схожести позиции будет храниться здесь third_best_index = -1 # косинусное сходство с третьей по схожести позицией for j in range(n): # Всего n-позиций в списке if(mindex==j): continue tmp = np.dot(X[mindex],X[j])/(np.sqrt(np.sum(np.square(X[mindex]))) * np.sqrt(np.sum(np.square(X[j])))) # вычисление скалярного произведения if(tmp>=first_best_val): third_best_val = second_best_val third_best_index = second_best_index second_best_val = first_best_val second_best_index = first_best_index first_best_val = tmp first_best_index = j elif(tmp>=second_best_val): third_best_val = second_best_val third_best_index = second_best_index second_best_val = tmp second_best_index = j elif(tmp>third_best_val): third_best_val = tmp third_best_index = j return first_best_val,first_best_index,second_best_val,second_best_index,third_best_val,third_best_index # Возврат всех значенийКод для нахождения трех позиций, максимально подобных заданной
Теперь, при нахождении топ-3 схожих для всех позиций в списке, сложность умножается еще на n. Окончательная сложность оказывается равна O(n*n*k) = O(n²k).
def top_3_similar_all_items(X): # X это список позиций, из которого мы должны выбрать 3 наиболее схожих с каждой позицией SMALL = -9999.99 # Просто для инициализации, поскольку нам нужно найти позицию с максимальным уровнем сходства(косинусный показатель) first_best_index = np.zeros(n,dtype=int) # индекс первой по схожести позиции будет храниться здесь first_best_val = np.zeros(n,dtype=float) # косинусное сходство с первой по схожести позицией second_best_index = np.zeros(n,dtype=int) # индекс второй по схожести позиции будет храниться здесь second_best_val = np.zeros(n,dtype=float) # косинусное сходство со второй по схожести позицией third_best_index = np.zeros(n,dtype=int) # индекс третьей по схожести позиции будет храниться здесь third_best_val = np.zeros(n,dtype=float) # косинусное сходство с третьей по схожести позицией for i in range(n): # Initialisation first_best_val[i] = SMALL first_best_index[i] = -1 second_best_val[i] = SMALL second_best_index[i] = -1 third_best_val[i] = SMALL third_best_index[i] = -1 for j in range(n): if(i==j): continue tmp = np.dot(X[i],X[j])/(np.sqrt(np.sum(np.square(X[i]))) * np.sqrt(np.sum(np.square(X[j])))) # вычисление скалярного произведения if(tmp>=first_best_val[i]): third_best_val[i] = second_best_val[i] third_best_index[i] = second_best_index[i] second_best_val[i] = first_best_val[i] second_best_index[i] = first_best_index[i] first_best_val[i] = tmp first_best_index[i] = j elif(tmp>=second_best_val[i]): third_best_val[i] = second_best_val[i] third_best_index[i] = second_best_index[i] second_best_val[i] = tmp second_best_index[i] = j elif(tmp>third_best_val[i]): third_best_val[i] = tmp third_best_index[i] = j return first_best_val,first_best_index,second_best_val,second_best_index,third_best_val,third_best_index # Возврат всех значенийКод для нахождения трех наиболее схожих позиций для каждой позиции в списке
Тестовый прогон и оценка времени
Я запустил код, попробовав найти 3 наиболее похожие позиции из подмножества, содержащего n = 10³ позиций с k = 64. На выполнение этой задачи при помощи Python потребовалось около 17 секунд со средней скоростью 3.7 *10⁶ операций в секунду. Код был хорошо оптимизирован с применением операций и массивов Numpy. Отмечу, что все эти операции последовательно выполняются на CPU.
%time first_best_val,first_best_index,second_best_val,second_best_index,third_best_val,third_best_index = top_3_similar_all_items(X)Прогон для n = 10³ позиций

Вывод: время, потребовавшееся для n = 10³ позиций
Далее я увеличил тестовое подмножество до n =10⁴ позиций. Поскольку сложность равна O(n²k), длительность выполнения возросла в 100 раз (поскольку n возросла в 10 раз). На выполнение кода ушло 1700 секунд = 28,33 минуты.

Вывод: время, потребовавшееся на обработку n = 10⁴ позиций
Далее подходим к самому важному: оценке времени, которое потребуется на обработку полноценного списка из 10⁵ позиций. Посчитав, увидим, что временная сложность вновь возрастет в 100 раз, поскольку временная сложность алгоритма равна O(n²k).
Ориентировочное время = 1700 * 100 секунд = 2834 минуты = 47,2 часа ~ 2 дня.
О, Господи! Так долго.
Вероятно, вы уже догадываетесь, что на самом деле мне удалось все сделать очень быстро, воспользовавшись силой GPU. На самом деле, выигрыш во времени при использовании GPU просто шокирует. Цифры я оставлю на закуску, а пока предлагаю вам познакомиться с миром GPU.
2. Сравнение CPU и GPU
Центральный процессор (CPU), в сущности, является мозгом любого вычислительного устройства: он выполняет записанные в программе инструкции, осуществляя управляющие, логические операции, а также операции ввода/вывода.
Правда, у современных CPU по-прежнему не так много ядер, и базовая структура и назначение CPU – обработка сложных вычислений – в сущности, не изменились. На самом деле, CPU лучше всего подходит для решения задач, заключающихся в разборе или интерпретации сложной логики, содержащейся в коде.
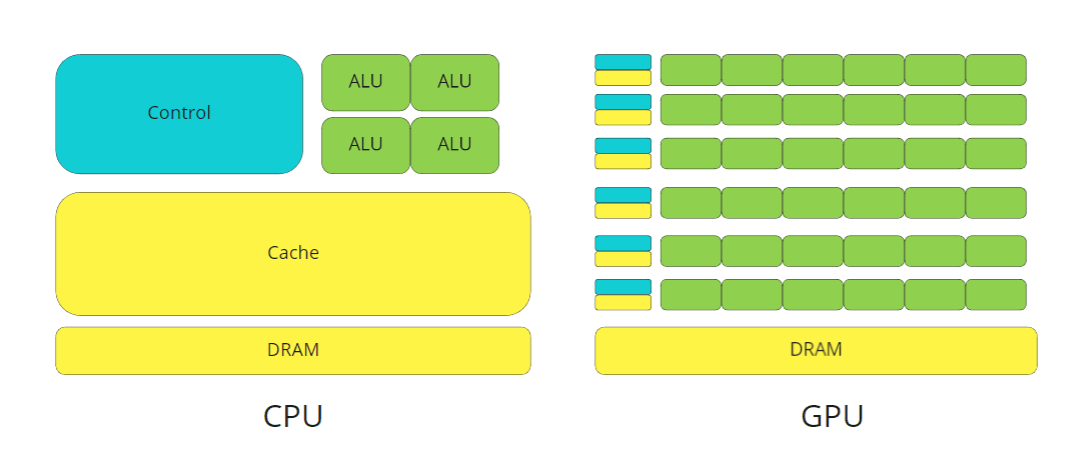
В свою очередь, графический процессор (GPU) обладает более мелкими логическими ядрами, которых, однако, гораздо больше (речь идет об арифметико-логических устройствах (АЛУ), управляющих элементах и кэш-памяти), которые спроектированы с расчетом на параллельную обработку в целом идентичных и сравнительно простых операций.
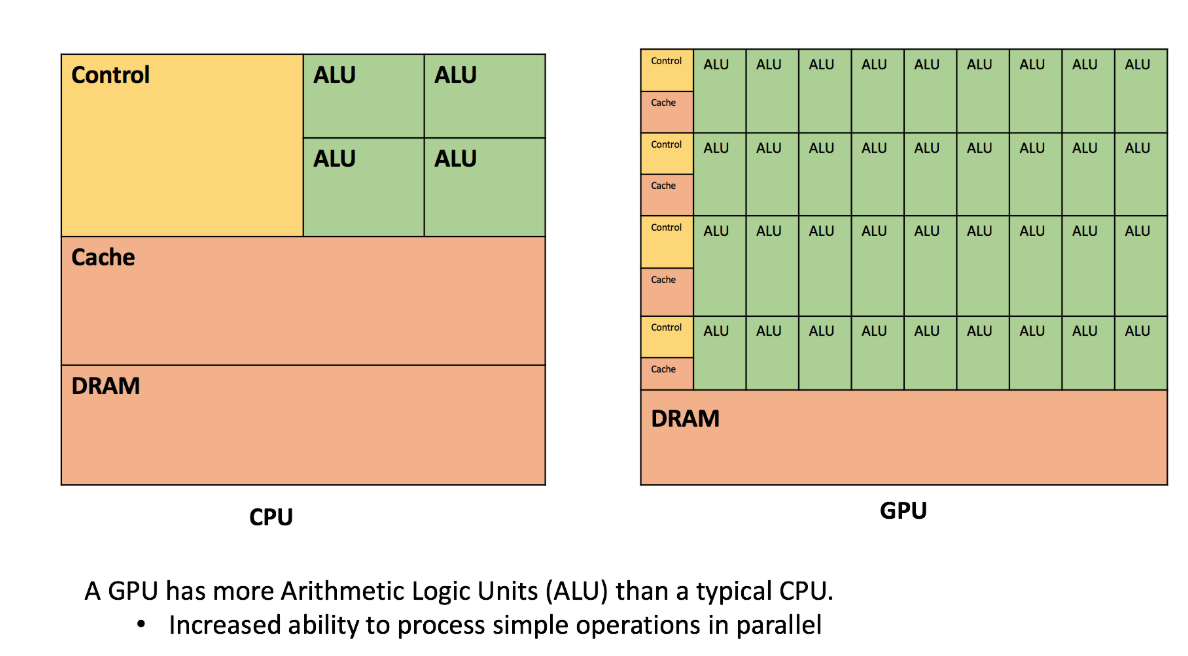
У GPU больше арифметических логических устройств (ALU), чем у типичного CPU, поэтому повышена способность параллельной обработки простых операций
Рисунок: сравнение CPU и GPU ~ Источник изображения
3. Когда использовать вычисления на GPU
CPU лучше подходит для выполнения сложных линейных задач. Несмотря на то, что ядра CPU мощнее, GPU позволяют эффективнее и быстрее обрабатывать задачи, связанные с ИИ, машинным и глубоким обучением. GPU справляется с рабочими нагрузками, распараллеливая схожие операции.
Представление об операциях с точки зрения GPU: возьмем, к примеру, операцию поиска слова в документе. Ее можно выполнить последовательно, перебрав одно за другим все слова в документе, либо параллельно, то есть, построчно, либо с поиском по конкретному слову.
Представление об операциях с точки зрения CPU — есть такие операции, например, расчет ряда Фибоначчи, которые нельзя распараллелить. Ведь найти очередное число можно лишь после того, как вычислишь предыдущие два. Такие операции лучше всего подходят для CPU.
В свою очередь, такие операции, как сложение и перемножение матриц, легко выполняются с применением GPU, поскольку большинство из этих операций в матричных ячейках являются независимыми друг от друга, схожи по природе, и поэтому могут быть распараллелены.
4. Кратко о CUDA
CUDA – это платформа для параллельных вычислений и модель API, созданная компанией Nvidia. С помощью этого API можно использовать процессор с поддержкой CUDA-графики для широкого спектра вычислений. Такой подход получил название GPGPU (неспециализированные вычисления на графических процессорах). Здесь о них рассказано подробнеe.
Numba – это свободно распространяемый JIT-компилятор, транслирующий подмножество Python и NumPy в быстрый машинный код при помощи LLVM, это делается средствами пакета llvmlite на Python. В этом пакете предлагается ряд вариантов по распараллеливанию кода на Python для CPU и GPU, в самом коде при этом зачастую достаточно минимальных изменений. См. подробнеe.
Работая с процессором Nvidia Volta V100 16GB GPU, я пользовался библиотекой Numba.
Детали архитектуры ~ потоки, блоки и гриды
CUDA организует параллельные вычисления при помощи таких абстракций как потоки, блоки и гриды.
Поток: поток CUDA – это назначенная цепочка инструкций, поступающих/текущих в ядро CUDA (на самом деле, это просто конвейер). На лету на одном и том же ядре CUDA может существовать до 32 потоков (в таком случае заполняются все звенья этого конвейера). Это выполнение ядра с заданным индексом. Каждый поток использует свой индекс для доступа элементов в массиве таким образом, что вся совокупность имеющихся потоков совместно обрабатывает все множество данных.
Блок: это группа потоков. Не так много можно рассказать о выполнении потоков внутри блока: они могут выполняться как последовательно, так и параллельно, так и без какого-либо определенного порядка. Можно координировать потоки, например, при помощи функции _syncthreads() , заставляющей поток остановиться в определенной точке в ядре и дождаться, пока все остальные потоки в том же блоке также достигнут этой же точки.
Грид: Это группа блоков. Между блоками отсутствует всякая синхронизация.

CUDA: потоки, блоки, гриды ~ Источник
Но где же именно выполняются потоки, блоки и гриды? В случае архитектуры G80 GPU от Nvidia, вычисления, по-видимому, распределены следующим образом:
Грид → GPU: Весь грид обрабатывается единственным GPU-процессором.
Блок → МП: Процессор GPU организован как коллекция мультипроцессоров, где каждый мультипроцессор отвечает за обработку одного или более блоков в гриде. Один блок никогда не делится между несколькими МП.
Поток → ПП: Каждый МП далее подразделяется на процессоры потоков (ПП), и каждый ПП обрабатывает один или более потоков в блоке.
Я позаимствовал некоторый материал из этой отлично написанной статьи. Рекомендую почитать ее внимательно.
5. Простая программа для сложения массивов на Python, использующая GPU
Как я уже говорил в самом начале, суть данной статьи – помочь широкой аудитории понять силу GPU и приобрести интуитивное представление, как применять GPU для решения повседневных задач. Перед тем, как начинать писать код для GPU, возможно, придется провести некоторые предварительные исследования. Для этого давайте разберем в качестве примера программу для сложения массивов.
Допустим, у нас есть два массива, ‘a’ и ‘b’ размера ‘n’. Мы хотим сгенерировать массив ‘c’, такой, чтобы каждый элемент массива c являлся суммой элементов с теми же индексами из массивов ‘a’ и ‘b’. Но в данном случае для решения задачи мы применим не последовательные вычисления, а параллельные, которые делаются при помощи GPU.
Мы запустим n потоков/ядер. Индекс, под которым работает каждый конкретный поток, можно вывести из следующей формулы:
index = cuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x
В случае с двумерной матрицей в индексе присутствует два компонента, означающих строку и столбец, которые можно вывести следующим образом:
row = cuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x
col = cuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x
Также нам придется определить количество потоков на блок, скажем, tpb и блоков на грид, допустим bpg. Воспользуемся стандартными числами для них.
Здесь важно отметить еще одну важную концепцию: когда какие-либо вычисления должны быть выполнены на GPU, соответствующие данные должны быть перенесены в глобальную память GPU, а результаты вычислений после этого могут быть перенесены обратно на хост. Эти операции выполняются при помощи функций cuda.to_device() и copy_to_host() , предоставляемых в библиотеке Numba на Python.
Ниже приведены реализации данного решения как для CPU, так и для GPU. Посмотрите оба листинга, чтобы уловить разницу.
c = np.zeroes(n) for i in range(n): c[i] = a[i] + b[i] return cПоследовательная реализация для CPU.
from numba import cuda # Библиотека Nvidia для работы с GPU import numpy as np @cuda.jit('void(float32[:], float32[:], float32[:])') #Динамический компилятор Cuda def cuda_addition(a,b,c): """Поток будет выполнять эту функцию ядра.""" i = cuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x # Отображение потока на индекс массива if i > c.size: return c[i] = a[i]+b[i] #Perform the addition # Подробности об устройстве device = cuda.get_current_device() # Перенос с хоста на устройство d_a = cuda.to_device(a) # Перенос данных в глобальную память GPU d_b = cuda.to_device(b) # Перенос данных в глобальную память GPU d_c = cuda.device_array_like(a) tpb = device.WARP_SIZE #blocksize или количество потоков на блок, стандартное значение = 32 bpg = int(np.ceil((n)/tpb)) # блоков на грид cuda_addition[bpg, tpb](d_a, d_b, d_c) # вызов ядра # Перенос вывода с устройства на хост c = d_c.copy_to_host() print(c) Параллельная реализация для GPU
6. Нахождение 3 наиболее похожих позиций для каждой позиции в списке при помощи GPU
Хорошенько вникнув в теорию и практику, возвращаемся к исходно поставленной задаче: найти топ-3 похожих позиции для каждой позиции в списке при помощи вычислений на GPU.
В данном случае основная идея заключается в том, что у нас n позиций, и мы запустим n потоков. Каждый поток будет работать параллельно с остальными и независимо от них, вычисляя по 3 наиболее похожие позиции для каждой позиции в списке. За каждую позицию будет отвечать один поток.
from numba import cuda # Nvidia's GPU Library import numpy as np import math #Выполнение математических вычислений, например, нахождение скалярного произведения, Numpy не поддерживается на GPU import random # Определение функции ядра @cuda.jit('void(float32[. ],float32[:],int32[:],float32[:],int32[:],float32[:],int32[:])') # CUDA Just-in-time Compiler def cuda_dist(X,first_best_val,first_best_index,second_best_val,second_best_index,third_best_val,third_best_index): """Поток будет выполнять эту функцию ядра.""" # Отображение потока на строку row = cuda.blockIdx.x * cuda.blockDim.x + cuda.threadIdx.x; if ((row >= n)): # Принимать потоки только в границах матриц return first_best_val[row] = SMALL # косинусное сходство с первой по схожести позицией first_best_index[row] = -1 # индекс первой по схожести позиции будет храниться здесь second_best_val[row] = SMALL # косинусное сходство со второй по схожести позицией second_best_index[row] = -1 # индекс второй по схожести позиции будет храниться здесь third_best_val[row] = SMALL # косинусное сходство с третьей по схожести позицией third_best_index[row] = -1 # индекс третьей по схожести позиции будет храниться здесь for i in range(n): if(i==row): # Тот же элемент continue # Переменные для вычисления скалярного произведения, так как мы не можем использовать операции numpy в контексте GPU tmp = 0.0 magnitude1 = 0.0 magnitude2 = 0.0 for j in range(k): tmp += X[row,j] * X[i,j] magnitude1 += (X[row,j]* X[row,j]) magnitude2 += (X[i,j]* X[i,j]) tmp /= (math.sqrt(magnitude1)*math.sqrt(magnitude2)) # Значение скалярного произведения Dot_product(a,b) = a.b/(|a|*|b|) if(tmp>=first_best_val[row]): third_best_val[row] = second_best_val[row] third_best_index[row] = second_best_index[row] second_best_val[row] = first_best_val[row] second_best_index[row] = first_best_index[row] first_best_val[row] = tmp first_best_index[row] = i elif(tmp>=second_best_val[row]): third_best_val[row] = second_best_val[row] third_best_index[row] = second_best_index[row] second_best_val[row] = tmp second_best_index[row] = i elif(tmp>third_best_val[row]): third_best_val[row] = tmp third_best_index[row] = i # Подробности об устройстве device = cuda.get_current_device() d_x = cuda.to_device(X) d_first_val = cuda.device_array_like(first_val) d_first_index = cuda.device_array_like(first_index) d_second_val = cuda.device_array_like(second_val) d_second_index = cuda.device_array_like(second_index) d_third_val = cuda.device_array_like(third_val) d_third_index = cuda.device_array_like(third_index) tpb = device.WARP_SIZE # blocksize или количество потоков на блок bpg = int(np.ceil((n)/tpb)) # блоков на грид %time cuda_dist[bpg,tpb](d_x,d_first_val,d_first_index,d_second_val,d_second_index,d_third_val,d_third_index) # вызов ядра # Перенос вывода с устройства на хост first_val = d_first_val.copy_to_host() print (first_val[:10]) # Первые 10 значений # Перенос вывода с устройства на хост first_index = d_first_index.copy_to_host() print (first_index[:10]) # Первые 10 индексов Реализация для GPU ~ Код для нахождения 3 позиций, наиболее похожих на данную
Затраченное время
Общее время, затраченное GPU для нахождения топ-3 схожих позиций для каждой позиции в списке, составило 481 мс (0,5 секунд). Еще 20 секунд потребовалось для копирования данных с устройства на хост и с хоста на устройство.
7. Вывод
Задача, решение которой на CPU потребовало бы около 2 дней, на GPU была решена за 20,5 секунд. Это оказалось возможно только благодаря природе задачи. Поиск 3 наиболее похожих позиций для ‘A’ не зависит от поиска 3 наиболее похожих позиций для ‘B’. Мы воспользовались этим фактом и применили параллелизм, предоставляемый GPU, для ускорения процесса. Также пример иллюстрирует, задачи какого типа удобнее всего решать при помощи могучего GPU.
8. Благодарности
Данное исследование было выполнено на MLP (платформе машинного обучения) компании Walmart Labs. Спасибо Аюшу Кумару за помощь в оптимизации рабочего процесса.